
こちらの続きです。
はじめに
前回作ったDecisionRAG(もどき)は、1検索に10秒くらいかかっていました。
さすがに実用性が低いので、レイテンシの改善を進めてみました。
オンライン用途なので本来であればPythonでの実行に切り替える手もありましたが、Genie Agentから使いたかったのでSQL UC関数の形は変えずに、レイテンシの改善に取り組んでみました。
結果、同じ質問で約10秒 → 3.6秒になりました。
改善に向けてai_decideの呼び出し回数削減もしましたが、結果的には探索の「段数」の削減の方が効きました、という内容になっています。
ai_decideはBeta機能です。また、後半で探索の段を1つ省いているため、精度への影響はまだ検証できていません。
前回の約10秒はXXSのSQLウェアハウス、今回はノートブック(サーバーレス)での計測なので、前回との比較は目安です。
前回の思い出し
前の記事の改善案として以下のようなことを書きました。
今回は
ai_decide関数を各レコードに対してバッチ的にNoul(Yes/No)で判定する設計にしたため、関数呼び出しの数が多く、またおそらくai_decide関数は現状並列実行されない(たぶん)ため呼び出し回数が多いほど時間がかかる構造になっています。特に最初のタグ探索をChoice方式判定にすれば呼び出しを1回に抑えられるのでレイテンシは削減できるはずです。
その他、関数呼び出し回数をどう減らすか、というところがレイテンシ(とコスト)に寄与するはずで、木構造の再設計含めて見直すことが改善のポイントかと思います。
これついては「たぶんこうじゃないかなー」という仮説だったのですが、これを基に改善に取り組んでみました。
結果の一覧
質問はすべてDatabricks ai_decide関数ってどう使うの?(threshold => 0.2、それ以外はデフォルト)です。
| 版 | 変更内容 | ai_decideの段 | 呼び出し回数 | 実行時間 |
|---|---|---|---|---|
| 前回 | 全層noul | 4段 | 200〜250回 | 約10秒(ちゃんと計測してなかった) |
| Step1 | L1をchoice 1回に | 4段 | 約76回 | 7.9秒 |
| Step2 | L2・L3もchoice 1回に | 4段 | 8回 | 6.6秒 |
| Step3 | 事前計算+L2を省略 | 3段 | 7回 | 3.6秒 |
Step1. L1のタグ判定をchoice 1回にする
前回はL1で全タグ(166個)をnoulで1個ずつ判定していました。ai_decideのchoiceは全ラベルの確率分布を返すので、タグを選択肢にすれば1回で済むはずです。
ただし、ai_decideの第2引数(questions)は定数でなければならず、タグ一覧から動的に作れませんでした。
そこで、ラベルはt001〜t255の番号として定数で書いておき、各番号の中身(タグの説明)はstate側のoptionsに毎回組み立てて渡すようにしてみました。
l1_decision AS (
  SELECT ai_decide(
    to_json(named_struct(
      'question', q,
      'options', map_from_entries(array_sort(collect_list(struct(
        slot,  -- t001, t002, …
        concat(tag, '(', n_articles, '件): ', array_join(slice(sample_titles, 1, 3), ' / '))
      ))))
    )),
    '{"tag": {"type": "choice",
              "instructions": "state の options から、question に答える情報がありそうな記事群を選び、そのスロット名を答えてください。…",
              "criteria": {"t001": null, "t002": null, …, "t255": null}}}'
  ) AS d
  FROM tag_slots
)
モデルは存在しない番号(t169以降)にも確率を返してくるので(選択肢として渡しているので当然)、実在するタグだけに絞って合計1に正規化しています。
これで7.9秒になりました。(複数回計測の平均)
Step2. L2・L3もchoice 1回にまとめる
同じ方式でL2(候補20記事)とL3(約50セクション)もchoice 1回ずつにしてみました。L4は閾値で判定したいのでnoulのままです。
ai_decideは呼び出しごとに結果が変わりうるので、同じCTEを2回参照して再計算されると層の間で食い違います。そこで、候補の配列とai_decideの結果を同じ集約行に入れて、その1行を展開しています。
l2_decision AS (
  SELECT
    collect_list(struct(slot, article_id, title, tag_score)) AS cands,
    ai_decide(
      to_json(named_struct('question', q,
        'options', map_from_entries(array_sort(collect_list(struct(slot, title)))))),
      '…L2用の choice 定数…'
    ) AS d
  FROM l2_opts
)
-- 後段で explode(cands) し、element_at(probabilities, c.slot) で確率を対応づける
呼び出しは1問あたり8回(約76回の1/10)になりましたが、実行時間は6.6秒。何度か実行して平均すると10%強の改善でした。
もうちょっと早くなると思っていました。
Step3. 事前計算と段の削減(fast版)
呼び出し回数を減らしても思ったより縮まらなかったので、ようやくクエリプロファイルでどこに時間がかかっているかを見てみました(最初に見ておけばよかった)。
choice版(6.51秒)の内訳はこうでした。
| 区分 | 時間 |
|---|---|
| ai_decideのステージ(4つ) | 3.47秒 |
| ステージ間の空き時間 | 約1.78秒 |
| コンパイル | 0.91秒 |
| 結合・ウィンドウ関数などの計算 | 約0.17秒 |
結合やウィンドウ関数の計算は一瞬で、ai_decide以外の約2.9秒はほぼ「待ち」でした。各層が前の層の結果を待つのでステージが直列に並び、切り替えのたびに空きが入ります。特にL1の前に、タグの集計を待つ空きが0.75秒ありました。
そこで改善の方針を「段とステージの切り替えを減らす」に決めて、次の3点を変えたdecision_rag_search_fastを作ってみました。
-
L1の選択肢を事前計算する:タグの番号と説明文をまとめた
optionsの1行を、パイプライン(SDP)でテーブルにしておく - tag_scoreを配列関数で計算する:記事のタグ配列とL1の確率マップから計算し、記事×タグの結合とウィンドウ関数をなくす
- L2を省く:tag_score上位10記事の全セクションを、L3のchoiceで直接選ぶ(L1 → L3 → L4の3段)
L1の選択肢を事前計算する
L1のoptionsは質問に依存しないので、前回のパイプラインに次の2つのマテリアライズドビューを追加しました。
| テーブル | 中身 |
|---|---|
tag_slots |
タグごとの番号(t001〜、記事数の多い順)と、選択肢の説明文(タグ名・件数・代表タイトル3件) |
tag_options |
L1にそのまま渡す1行。options(番号 → 説明文)とslot_to_tag(番号 → タグ)の2つのマップ |
変換処理は、ローカルでもテストできるようにutilitiesに関数として切り出しています。
from pyspark.sql import DataFrame, Window
from pyspark.sql import functions as F

MAX_SLOTS = 255  # ai_decide の choice の選択肢の上限


def build_tag_slots(tag_nodes: DataFrame, n_titles: int = 3) -> DataFrame:
    """記事数の多い順(同数はタグ名順)にスロット名を割り当てる。255 を超えたタグは載せない。"""
    order = Window.orderBy(F.col("n_articles").desc(), F.col("tag"))
    return (
        tag_nodes.withColumn("slot_no", F.row_number().over(order))
        .where(F.col("slot_no") <= MAX_SLOTS)
        .select(
            F.format_string("t%03d", "slot_no").alias("slot"),
            "slot_no",
            "tag",
            "n_articles",
            F.expr(
                f"concat(tag, '(', n_articles, '件): ', array_join(slice(sample_titles, 1, {int(n_titles)}), ' / '))"
            ).alias("option_text"),
        )
    )


def build_tag_options(tag_slots: DataFrame) -> DataFrame:
    """L1 の判定に使う1行。options はスロット名→説明文、slot_to_tag はスロット名→タグ名。"""
    return tag_slots.agg(
        F.expr("map_from_entries(array_sort(collect_list(struct(slot, option_text))))").alias("options"),
        F.expr("map_from_entries(array_sort(collect_list(struct(slot, tag))))").alias("slot_to_tag"),
        F.count("*").alias("n_tags"),
    )
パイプライン側では、これをマテリアライズドビューとして定義するだけです。
あわせて、L3の選択肢に使う説明文(記事タイトル / 見出し: 本文の冒頭)もsectionsにoption_text列として追加しました。
from utilities.tree_views import build_tag_options, build_tag_slots

OPTION_TITLES = int(spark.conf.get("decision_rag.option_titles", "3"))


@dp.materialized_view(
    name="tag_slots",
    comment="タグのスロット名(t001〜t255、記事数の多い順)と L1 選択肢の説明文",
)
def tag_slots():
    return build_tag_slots(spark.read.table("tag_nodes"), OPTION_TITLES)


@dp.materialized_view(
    name="tag_options",
    comment="L1 の ai_decide(choice)にそのまま渡す1行",
)
def tag_options():
    return build_tag_options(spark.read.table("tag_slots"))


# sections には次の列を追加
#   F.concat_ws("", "title", F.lit(" / "), "s.heading", F.lit(": "), "s.head_text").alias("option_text")
できあがるtag_optionsはこんな1行です。
options     : {"t001": "databricks(…件): …", "t002": "…", …}
slot_to_tag : {"t001": "databricks", "t002": "…", …}
n_tags      : 168
関数側のL1は、この1行を読んでai_decideに渡すだけになります。返ってきた確率も、map_filterで実在する番号だけに絞り、1行のまま「タグ → 確率」のマップ(tag_p)に変換します。探索時のタグの集計やウィンドウ関数がなくなるので、L1の前の空きが減るはず、という狙いです。
l1_decision AS (
  SELECT o.slot_to_tag,
         ai_decide(to_json(named_struct('question', q, 'options', o.options)), '…L1用の choice 定数…') AS d
  FROM tag_options o
),
l1 AS (
  SELECT map_from_entries(transform(
           map_entries(probs),
           e -> struct(slot_to_tag[e.key] AS tag, e.value / nullif(total, 0) AS p)
         )) AS tag_p
  FROM (
    SELECT slot_to_tag, probs, aggregate(map_values(probs), 0D, (acc, x) -> acc + x) AS total
    FROM (
      SELECT slot_to_tag,
             map_filter(d:response.answers.tag.probabilities::map<string, double>,
                        (k, v) -> map_contains_key(slot_to_tag, k)) AS probs
      FROM l1_decision
    )
  )
)
tag_scoreを配列関数で計算する
記事のタグ配列と、L1の確率マップ(1行)から計算します。記事×タグの結合とウィンドウ関数は不要になります。
scored AS (
  SELECT
    article_id, title, url,
    aggregate(slice(ts, 1, 2), 0D, (acc, x) -> acc + x.p) / nullif(least(size(ts), 2), 0) AS tag_score,
    transform(slice(ts, 1, 2), x -> x.t) AS top_tags
  FROM (
    SELECT a.article_id, a.title, a.url,
      array_sort(
        transform(array_distinct(a.tags), t -> named_struct('p', coalesce(l1.tag_p[t], 0D), 't', t)),
        (x, y) -> CASE WHEN x.p > y.p THEN -1 WHEN x.p < y.p THEN 1
                       WHEN x.t < y.t THEN -1 WHEN x.t > y.t THEN 1 ELSE 0 END
      ) AS ts
    FROM articles a CROSS JOIN l1   -- l1 は「タグ → 確率」のマップ1行
  )
)
L2を省いてL3に直接進む
tag_score上位10記事の全セクション(今回は103個)を選択肢にして、L3のchoiceを1回呼びます。書き方はStep2のL2と同じく、候補の配列とai_decideの結果を1行にまとめる形です。
decision_rag_search_fastの全体(長いので折り畳み)
CREATE OR REPLACE FUNCTION decision_rag_search_fast(
  q            STRING COMMENT '質問文',
  n_candidates INT    DEFAULT 10  COMMENT 'tag_score で残す候補記事数(この記事のセクションが L3 の選択肢になる)',
  k_sections   INT    DEFAULT 5   COMMENT 'L3 で残すセクション数',
  threshold    DOUBLE DEFAULT 0.5 COMMENT 'L4(本文)で返す確率の下限'
)
RETURNS TABLE (
  result_rank INT           COMMENT 'p_body の高い順の順位',
  article_id  STRING,
  title       STRING,
  url         STRING,
  section_id  STRING,
  heading     STRING,
  body        STRING        COMMENT 'セクション本文',
  top_tags    ARRAY<STRING> COMMENT 'tag_score の計算に使った上位2タグ',
  tag_score   DOUBLE        COMMENT 'L1: 上位2タグの確率(choice の分布)の平均',
  p_title     DOUBLE        COMMENT 'この版では L2 を省略するため常に NULL',
  p_head      DOUBLE        COMMENT 'L3: 候補セクションの中での確率(choice の分布)',
  p_body      DOUBLE        COMMENT 'L4: 本文で答えられる確率(noul)'
)
COMMENT 'Qiita の自分の記事から、質問に答えられるセクションを探す。タグ→セクション→本文の順に ai_decide で絞り込む DecisionRAG 検索(高速版)'
RETURN
WITH
-- L1: タグ(choice 1回)。選択肢は事前計算済みの1行
l1_decision AS (
  SELECT
    o.slot_to_tag,
    ai_decide(
      to_json(named_struct('question', q, 'options', o.options)),
      '…tag 用の choice 定数(ラベル t001〜t255)…'
    ) AS d
  FROM tag_options o
),
-- スロットの確率をタグの確率マップ(1行)に変換。実在するスロットだけ残して合計 1 に正規化
l1 AS (
  SELECT
    map_from_entries(transform(
      map_entries(probs),
      e -> struct(slot_to_tag[e.key] AS tag, e.value / nullif(total, 0) AS p)
    )) AS tag_p
  FROM (
    SELECT
      slot_to_tag, probs,
      aggregate(map_values(probs), 0D, (acc, x) -> acc + x) AS total
    FROM (
      SELECT
        slot_to_tag,
        map_filter(
          d:response.answers.tag.probabilities::map<string, double>,
          (k, v) -> map_contains_key(slot_to_tag, k)
        ) AS probs
      FROM l1_decision
    )
  )
),
-- 記事ごとに、タグを確率の高い順に並べて上位2タグの平均を取る(配列関数だけで計算)
scored AS (
  SELECT
    article_id, title, url,
    aggregate(slice(ts, 1, 2), 0D, (acc, x) -> acc + x.p) / nullif(least(size(ts), 2), 0) AS tag_score,
    transform(slice(ts, 1, 2), x -> x.t) AS top_tags
  FROM (
    SELECT
      a.article_id, a.title, a.url,
      array_sort(
        transform(array_distinct(a.tags), t -> named_struct('p', coalesce(l1.tag_p[t], 0D), 't', t)),
        (x, y) -> CASE WHEN x.p > y.p THEN -1 WHEN x.p < y.p THEN 1
                       WHEN x.t < y.t THEN -1 WHEN x.t > y.t THEN 1 ELSE 0 END
      ) AS ts
    FROM articles a
    CROSS JOIN l1
  )
),
-- L3: tag_score 上位 n_candidates 記事のセクション(choice 1回)
l3_opts AS (
  SELECT *
  FROM (
    SELECT
      format_string('t%03d', row_number() OVER (ORDER BY c.cand_rank, s.seq)) AS slot,
      row_number() OVER (ORDER BY c.cand_rank, s.seq) AS slot_no,
      c.article_id, c.title, c.url, c.top_tags, c.tag_score,
      s.section_id, s.heading, s.body, s.option_text
    FROM (
      SELECT *
      FROM (
        SELECT *, row_number() OVER (ORDER BY tag_score DESC, article_id) AS cand_rank
        FROM scored
      )
      WHERE cand_rank <= n_candidates
    ) c
    JOIN sections s ON s.article_id = c.article_id
  )
  WHERE slot_no <= 255
),
-- 候補の配列と ai_decide の結果を1行にまとめる(候補の CTE を2回参照しないため)
l3_decision AS (
  SELECT
    collect_list(struct(slot, article_id, title, url, top_tags, tag_score,
                        section_id, heading, body)) AS cands,
    ai_decide(
      to_json(named_struct(
        'question', q,
        'options', map_from_entries(array_sort(collect_list(struct(slot, option_text))))
      )),
      '…section 用の choice 定数(ラベル t001〜t255)…'
    ) AS d
  FROM l3_opts
),
l3 AS (
  SELECT
    y.*,
    row_number() OVER (ORDER BY y.p_head DESC, y.tag_score DESC, y.section_id) AS rn
  FROM (
    SELECT x.*, x.p_raw / nullif(sum(x.p_raw) OVER (), 0) AS p_head
    FROM (
      SELECT
        c.article_id, c.title, c.url, c.top_tags, c.tag_score,
        c.section_id, c.heading, c.body,
        coalesce(element_at(probs, c.slot), 0.0) AS p_raw
      FROM (
        SELECT d:response.answers.section.probabilities::map<string, double> AS probs, explode(cands) AS c
        FROM l3_decision
      )
    ) x
  ) y
),
-- L4: 本文(noul × k_sections 回。長すぎる本文は先頭 6000 文字で判定)
l4 AS (
  SELECT
    l3.article_id, l3.title, l3.url, l3.section_id, l3.heading, l3.body,
    l3.top_tags, l3.tag_score, l3.p_head,
    coalesce(ai_decide(
      to_json(named_struct('question', q, 'title', l3.title, 'heading', l3.heading, 'body', left(l3.body, 6000))),
      '{"rel": {"type": "noul",
                "instructions": "body(記事 title の heading セクションの本文)を根拠に、question に答えられるか判定してください。",
                "criteria": {"true": "body に回答の根拠となる具体的な記述がある",
                             "false": "話題は近いが回答の根拠にはならない、または無関係"}}}'
    ):response.answers.rel.probability::double, 0.0) AS p_body
  FROM l3
  WHERE l3.rn <= k_sections
)
SELECT
  CAST(row_number() OVER (ORDER BY p_body DESC, p_head DESC, section_id) AS INT) AS result_rank,
  article_id, title, url, section_id, heading, body,
  top_tags, tag_score, CAST(NULL AS DOUBLE) AS p_title, p_head, p_body
FROM l4
WHERE p_body >= threshold;
使ってみる
ノートブックから以下のように作成したUC関数を実行します。(変数Sにはカタログ.スキーマの文字列が入っている)
display(spark.sql(f"""
    SELECT result_rank, title, heading, top_tags,
           round(tag_score, 3) AS tag_score, round(p_head, 3) AS p_head, round(p_body, 3) AS p_body, url
    FROM {S}.decision_rag_search_fast(q => :q, threshold => :threshold)
    ORDER BY result_rank
    """,
    args={"q": "Databricks ai_decide関数ってどう使うの?", "threshold": 0.2},
))
結果は4件、実行時間は3.64秒でした。プロファイルで比べるとこうなります。
| 区分 | choice版 | fast版 |
|---|---|---|
| 合計 | 6.51秒 | 3.64秒 |
| ai_decideのステージ | 3.47秒(4段) | 1.80秒(3段) |
| ステージ間の空き時間 | 約1.78秒 | 約0.95秒 |
| コンパイル | 0.91秒 | 0.67秒 |
L1の前の空きは0.75秒から0.27秒に減りました。L3は選択肢が103個に増えて少し遅くなりましたが、L2を丸ごと省いた効果のほうが大きいです。
SQL関数のままだと3秒前後が下限かなーと思います。Genie Agent側でも数秒かかるので、個人的には一区切りとしてよさそうです。
Genie Agentから使ってみる
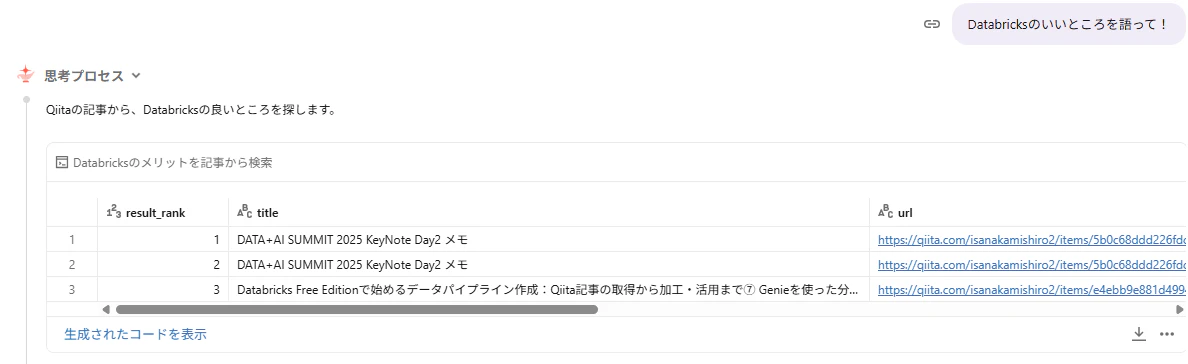
前回と同じGenie Agentに、decision_rag_search_fastをSQL関数として追加(前のものと入れ替え)してみました。
以下のような質問と、思考プロセスが出てきます。
得られた回答はこちら。
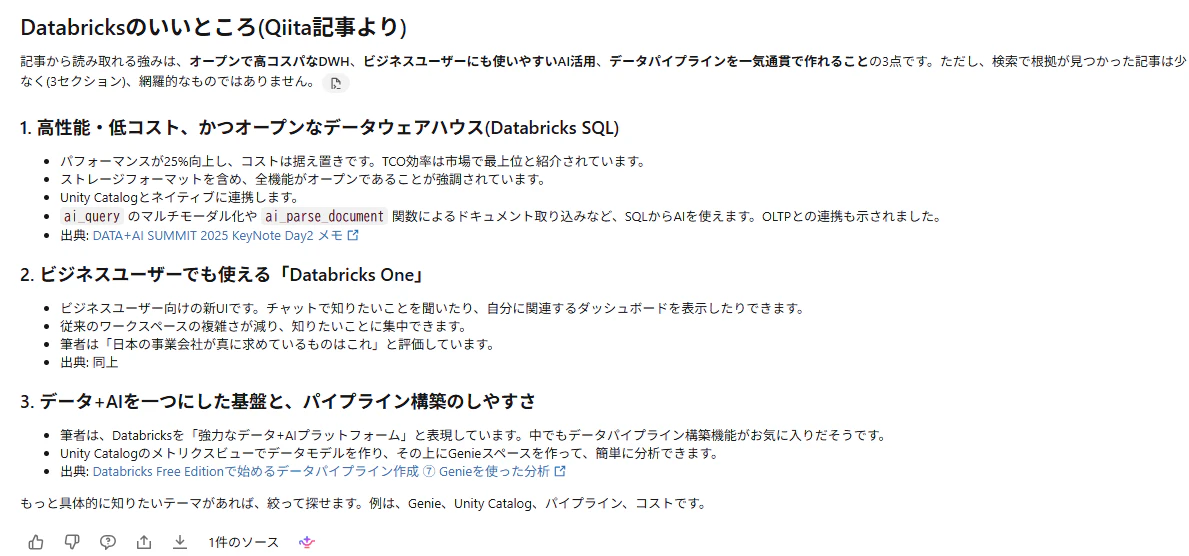
ふーむ、あまりDatabricksを褒める記事って書いてこなかったっけ・・・。
気になったので、もっと掘り下げてみました。
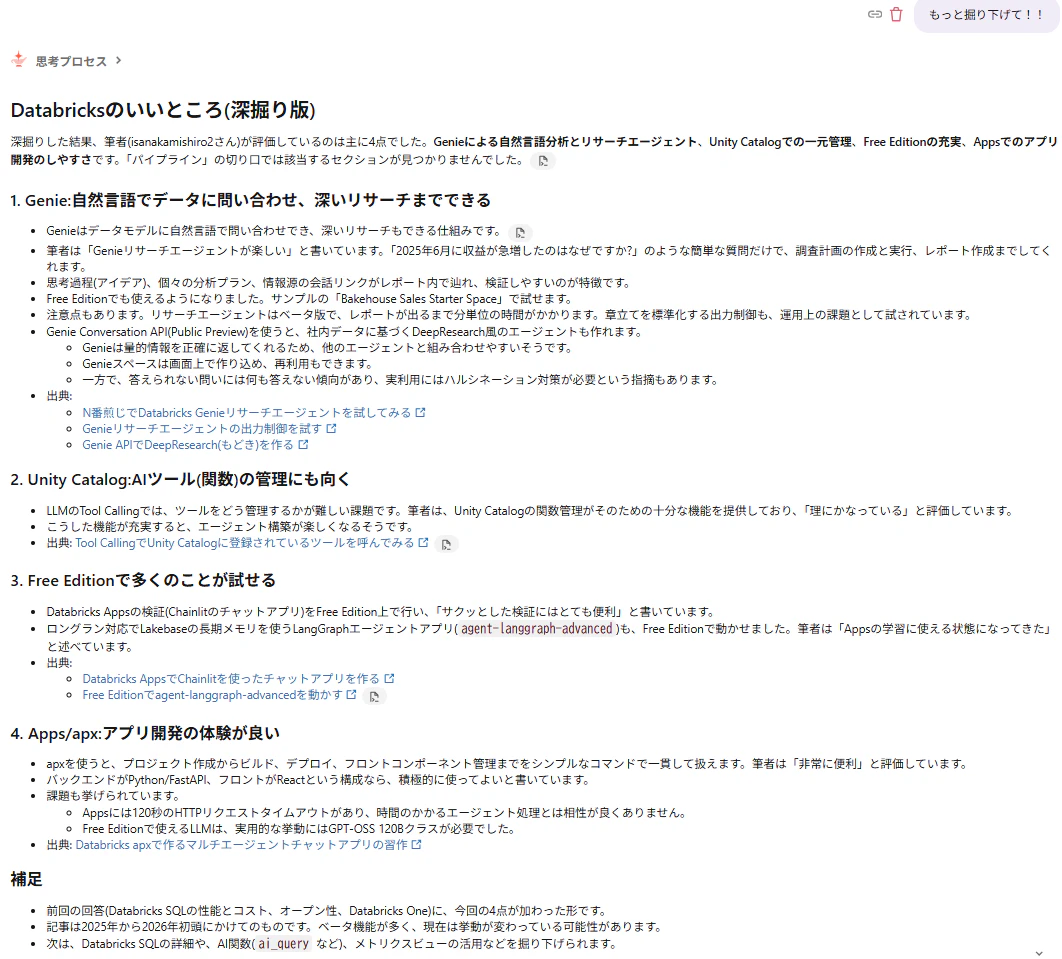
内容的に自分の記事の傾向が出てる気がする結果でした。
まとめ
ai_decideで作ったDecisionRAG(もどき)の検索を、UC関数のまま速くして、Genie Agentから使ってみました。
ai_decideの呼び出し回数削減も高速化に寄与しましたが、それ以外の要素も大きく探索構造設計が重要ですね。
とはいえ、L2を省いた影響や、番号ラベル方式の精度はまだ確認できていません(評価用の質問を作るのが地味に大変)。比較はしてみていて、少し精度感は下がってるとは思います。ちゃんと計測するべきですがそこは次回(?)。
また、今回は大した記事数ではないので今回のやり方で十分だと思いましたが、もっと多くの文書を扱うケースもトライしたいなと思っています。まったく異なる構造設計が必要そう。
その他、Lakehouse//RTがAI Functions対応すればもっと低レイテンシになる気がしているので対応が待ち遠しいです。1~2秒程度のレイテンシになればオンライン用途でも十分な速度になると思うので期待しています。
対応早く!早く!