

この記事は2023年4月11日に執筆されたものです。
こんにちは。Inflabのバックエンド開発者、Haruです。
良いソフトウェア設計、良いコードのためにテストコードを書くべきだという記事は、きっとたくさん目にしてきたと思います。
しかし、テストコードを書く意義に納得できない開発者もいれば、いざテストを書いても効果を実感できないケースもあります。
Inflearnに入る前の私も、そうした開発者の一人でした。
Inflearnに来て印象に残ったことの一つが、テストコードの存在でした。今になって思うのは 「自分はこれまで、テストコードを書くべき理由も、うまく書く方法も知らなかったんだな」 ということです。
本記事では、テストコードをなぜ書くべきなのか、そしてどうすればうまく書けるのかについて、私がアドバイスを受けて学んだ内容をまとめてみようと思います。
なぜテストコードを書くのか?
1つ目:デバッグコストの削減
開発者の総開発時間のうち、純粋に要件に沿った機能開発をしている時間は、全体のどれくらいの割合を占めるだろうか?
この問いに対して、自社サービスの会社でサービスの運用や保守をした経験がある方なら、思ったほど大きな割合を占めていないことをご存じでしょう。
アプリケーションには常に欠陥がつきもので、良いコードと設計を備えていても、欠陥の存在そのものを否定することはできません。
そのため機能のバグは常に発生し、それを解決するために開発者はデバッグをし続けるしかありません。
私も前職では、バグや問題の報告を受けてデバッグし、解決することに多くの時間を費やしていました。
その時間をもう少し細かく分けてみると、問題を解決する時間よりも、問題を見つけるための時間のほうが長かったのです。
どのコードブロックで、どんなケースで問題が発生したのかを把握するのがとても大変だったからです。
 <既存のコードを見ながらデバッグする私の姿>
では、テストコードがある今のプロジェクトではどうでしょうか?
上でも述べたように、堅牢なテストを書いても欠陥を完全になくすことはできません。
しかし、テストコードがあればエラーを減らせるうえ、問題が起きても素早く対処できるようになります。
テストは下の図のように、範囲と比重によって3つ(e2e、integration、unit)に分類され、それぞれに役割があります。
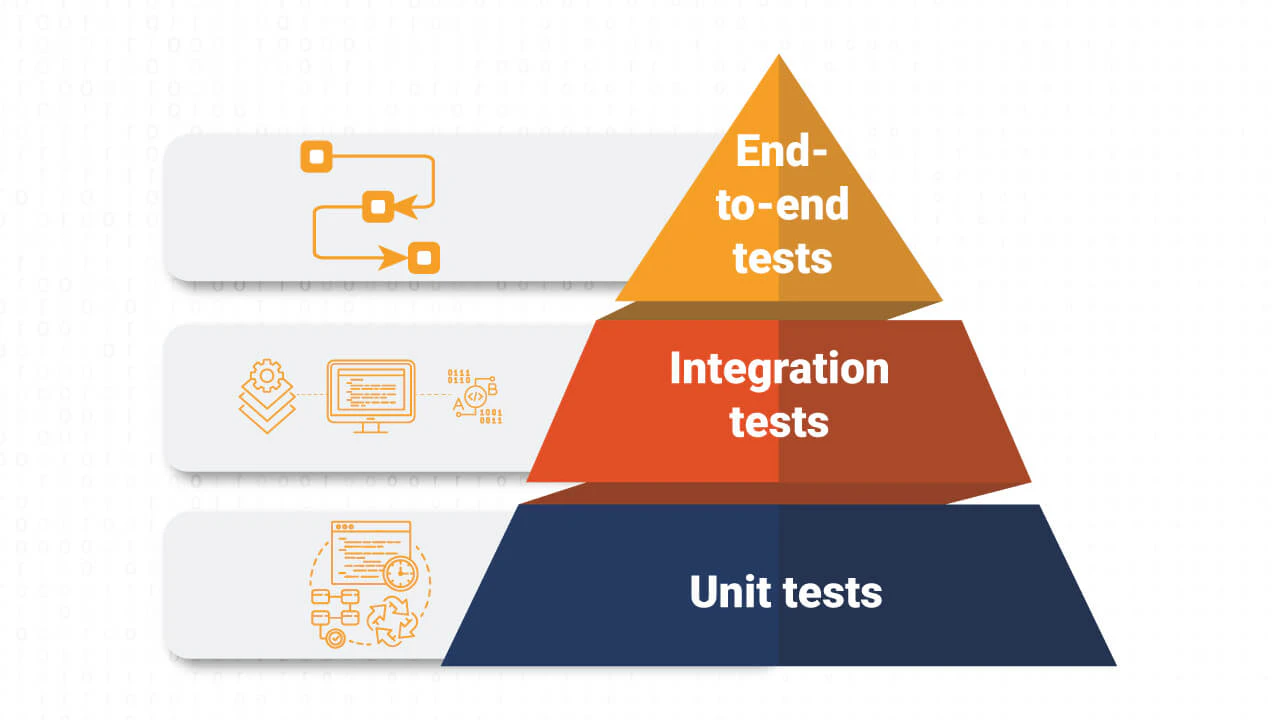
- unitテスト: ドメインモデルとビジネスロジックのテスト、小さな単位のコードやアルゴリズムのテスト
- integrationテスト: コードの主要なフローを統合的にテストし、主要な外部依存(例: データベース)についてテスト
- e2eテスト: エンドユーザーのフローのテストで、外部からのリクエストからレスポンスまで、機能が正しく動作するかどうかのテスト
このように区切ったテスト範囲の境界のおかげで、問題のあるコードの範囲とケースを素早く把握して修正できるようになりました。
テストによって欠陥を最小限に抑えてデバッグにかかる時間を減らすことで、サービス開発者がビジネス開発に集中でき、生産性の向上につながります。
2つ目:コード変更への不安の解消
「バグを直したのに、また別のところで壊れた…」
こんな状況なら、それは回帰バグ(デグレ)です。
回帰バグ
以前は正しく動作していたソフトウェアの機能に問題が生じることを指す。
一般的に、回帰バグはプログラムの変更中に意図せず発生する。
-ウィキペディア
この種のバグには、本当に頻繁に遭遇します。
なぜそうなるのでしょうか?
実は、理由を考えてみれば当然のことだと思います。
アプリケーションの機能は単一の要素(関数、オブジェクト、ドメイン)で成り立っているのではなく、複数の要素が相互に作用し、協力し合うことで作られています。
そのため、ある機能を修正すると、それを構成する要素がほかの機能とも連携しているので、その影響で回帰バグが起きるのです。
では、回帰バグを完全に防ぐことはできるのでしょうか?
上で述べたように、アプリケーションの機能は要素同士の相互作用で作られているため、事実上それは不可能だと思います。
回帰バグは予防するものではなく、管理して対処しなければならないものです。
言い換えれば、回帰テストが必要なのです。
回帰テストは、機能追加やバグ修正によって新たに入り込むエラーがないかを検証します。
テストが数千件あるInflearnのプロジェクトに携わる中で、私が最も実感しているテストのメリットがこれです。
テストコードは、その時点の機能を作るためだけに必要なコードではありません。
その後、
- 要件が変わって既存のコードを修正したり
- より良いコードのためにリファクタリングをしたりと、
サービスを持続的に発展させていくために必要なコードなのです。
3つ目:より良いドキュメント
「うわ…レガシーコード、読みにくすぎる…」
私たちは良いコードを書くために、読みやすく可読性の高いコードを書こうと努力します。
しかし、サービスが複雑になるにつれてコードの量は増え、コードの複雑さも高くなっていきます。
こうした複雑な要件が重なり合った機能は、新しく入社したメンバーがコードを理解するうえで大きな負担になります。
そこで新しいメンバーのために別途ドキュメントを用意しますが、そのドキュメントはすぐに放置されがちです。
これがドキュメント化の最も根深い問題です。
この問題が起きる理由は何でしょうか?
開発者にとって、ドキュメントとコードを同じ保守対象として扱うのが難しいからだと私は考えています。
ドキュメントとコードが別々の場所にあり物理的に離れているために、コードの修正に合わせてドキュメントが更新されないケースが多いからです。
そのため、ソースコード以外の別のドキュメントは管理対象から外れやすく、信頼しにくくなります。
私自身、ドキュメントを書いているうちに、新しく作るよりも既存のドキュメントを保守するほうが面倒だと感じるようになっていました。
しかし、面倒だと思っていたドキュメントの役割を、テストが担えることを知りました。
「ドキュメントにする内容を、自分に最も近いIDE、つまりコードの中に置いてみてはどうだろう?」
次のように、テストを書くときにまず仕様としてコードの実際の振る舞いを記述しておけば、そのコードがどんな役割を持つのかを理解しやすくなります。
既に同じメールアドレスが登録されている場合は、会員登録できません。
ドキュメントとしてのテストは、機能とコードの理解に役立ちます。
4つ目:良いコードはテストしやすい
良いコードは「変更しやすい」と形容されます。
これは結合度が低いコードを意味し、逆に密結合なコードは保守コストが増えるため、低品質なコードに分類されます。
では、密結合なコードはテストしやすいでしょうか?
もちろん、非常に難しいです。
外部の影響を受けたり、内部で依存関係を持っていたりするコードは、変更に柔軟に対応できず、再利用しにくいコードです。
そのため、テストを書きにくいコードが生まれるのです。
かといって、テストしやすいコードがすべて良いコードになるわけではありません。
しかしテストを書くことで、良いコードの指標の一つとして、次のような基準を持てるようになります。
「もし自分が書いたコードがテストしにくいなら、コードの臭い(コードスメル)がある可能性が高い」
5つ目:テストの自動化
「神よ、このプロジェクトをお救いください」
 [waterglasstoon]- 民間信仰
これは開発者あるあるの「お祈りデプロイ」です。自分が書いたコードが本番環境にデプロイされると、不安に駆られて祈り始めてしまいます。
「自分が書いたコードは正常に動くだろうか?」
「自分が書いたコードのせいで、ほかの部分でエラーが起きないだろうか?」
こうしたあれこれの考えが浮かび、開発者の不安はどんどん大きくなっていきます。
しかし自動テストを導入すれば、その時点から、自分たちが書いたテストコードによって、バグがデプロイされるのをCIで防げるようになります。
先ほど述べた変更への耐性や回帰バグを、継続的なコードマージの段階で確認できるため、ソフトウェアの品質も高まります。
つまり、テストコードがあることで、安定したプロジェクト、いや、安心していられる私たちの姿が見えてくるのです。
テストコードをうまく書く方法 with Jest
ここまで、「なぜテストコードを書くのか?」について5つの理由を見てきました。
テストコードを書くべき理由が分かったところで、次はテストコードをどう書くべきかについて見ていきます。
現在Inflearnでは typescript と jest フレームワークでテストコードを書いているため、サンプルコードもその言語とフレームワークを使っています。
1つ目:テストコードはDRYよりもDAMPに書く
開発原則の中でも、DRY(Don't Repeat Yourself)原則はよく耳にしたことがあると思います。
開発者である私たちは重複コードを嫌い、重複コードを見つけるとなんとかしてなくそうとする傾向があります。
ただ、テストコードの場合は、重複を減らす前にまずDAMPに書くことを検討すべきです。
DAMP原則は Descriptive and Meaningful Phrasesの略で、意味があり説明的な表現を使いなさいという原則です。
この原則を理解するために、次のサンプルコードを見てみましょう。
describe('応募者', () => {
  it('応募者を最終合格させる。', () => {
    const name = 'haru';
    const status = JobApplicantStatus.IN_PROGRESS;
    const jobApplicant = JobApplicant.create(name, status);

    jobApplicant.pass();

    expect(jobApplicant.status).toBe(JobApplicantStatus.PASS);
  });

  it('応募書類を不合格にする。', () => {
    const name = 'haru';
    const status = JobApplicantStatus.IN_PROGRESS;
    const jobApplicant = JobApplicant.create(name, status);

    jobApplicant.fail();

    expect(jobApplicant.status).toBe(JobApplicantStatus.FAIL);
  });
});
上のテストコードは、応募者の最終合格と不合格の機能をテストするコードです。
このテストコードを見て、少し違和感を覚えるかもしれません。
なぜなら、2つのテストコードで次の3行が重複しているからです。
  const name = 'haru';
  const status = JobApplicantStatus.IN_PROGRESS;
  const jobApplicant = JobApplicant.create(name, status);
そこで、このコードの重複をなくすために、各テストの実行前に実行される beforeEach(setupメソッド)に次のように書きました。
describe('応募者', () => {
  let jobApplicant: JobApplicant;

  beforeEach(() => {
    const name = 'haru';
    const status = JobApplicantStatus.IN_PROGRESS;
    jobApplicant = JobApplicant.create(name, status);
  });


  it('応募者を最終合格させる。', () => {
    jobApplicant.pass();

    expect(jobApplicant.status).toBe(JobApplicantStatus.PASS);
  });

  it('応募書類を不合格にする。', () => {
    jobApplicant.fail();

    expect(jobApplicant.status).toBe(JobApplicantStatus.FAIL);
  });
});
重複を取り除いたので、うまく書けたテストコードだと思うかもしれません。しかし、「応募書類が不合格の状態のときは保管できる。」という機能が追加された場合、テストコードは次のようになるでしょう。
// ...

it('応募書類が不合格の状態のときは保管できる。', () => {
  jobApplicant.putStorage();

  expect(jobApplicant.isStorage).toBe(true);
});
このテストコードを追加して実行すると、テストは失敗します。
不合格の応募書類を保管するために putStorage メソッドを呼び出したものの、beforeEach メソッドで応募者の状態を不合格(FAIL)ではなく進行中(IN_PROGRESS)に初期化していたからです。
こうなると、失敗の原因を突き止めつつ、テストを再び通すために beforeEach メソッドを確認して修正しなければなりません。
つまり、テストコードを書く人にとっても、テストコードを読み解く人にとっても難しいテストになってしまいました。
その理由は何でしょうか?
それは、テストコードの重複を減らす一方で、テスト間の結合度を高めてしまったからです。
テストのために status をグローバル変数という共有状態にしたことで、テストの修正が難しくなり、テスト同士が影響し合うコードになりました。
また、このテストは以前よりも可読性が下がりました。
テストを追加・修正するたびに必ず beforeEach メソッドを確認しなければならず、個々のテストコードの中を見るだけでは、もはやコード全体を把握できなくなりました。
こうした問題を解決するには、テストコードのリファクタリングは重複を減らす方向ではなく、より説明的で意味のある書き方にする方向で行うべきです。
やみくもにコードの重複を減らすと、かえってテスト間の独立性が下がり、テスト本来の意図がだんだん曖昧になって、正しく把握できなくなってしまうからです。
Better:
- テストの重複を減らすのではなく、より説明的で意味のある書き方にする方向でリファクタリングすべきである。
- テストは互いに独立し、分離されていなければならないため、あるテストの修正がほかのテストに影響しないようにすべきである。
- DAMP原則を守りながら重複を減らす方法としては、テストフィクスチャ関数やクラスなどを使うことができる。
describe('応募者', () => {
  it('応募者を最終合格させる。', () => {
    const jobApplicant = JobApplicantFixture.create(JobApplicantStatus.IN_PROGRESS);

    jobApplicant.pass();

    expect(jobApplicant.status).toBe(JobApplicantStatus.PASS);
  });

  it('応募書類を不合格にする。', () => {
    const jobApplicant = JobApplicantFixture.create(JobApplicantStatus.IN_PROGRESS);

    jobApplicant.fail();

    expect(jobApplicant.status).toBe(JobApplicantStatus.FAIL);
  });

  it('応募書類が不合格の状態のときは保管できる。', () => {
    const jobApplicant = JobApplicantFixture.create(JobApplicantStatus.FAIL);

    jobApplicant.putStorage();

    expect(jobApplicant.isStorage).toBe(true);
  });
});

class JobApplicantFixture {
  static create(status: JobApplicantStatus, name = 'haru') {
    return JobApplicant.create(name, status);
  }
}
2つ目:テストは実装ではなく結果を検証する
テストコードを書くとき、テストを速くするためにモックオブジェクトを使うことがあります。
モックオブジェクトとしてmock、spy、stubなどを使う場合、テスト対象の実装を知らなければテストを書けません。
ところが、これを乱用したり誤って使ったりしてテストを書いてしまうケースがよくあります。
例えば次のように、応募者を合格の状態に変更する前に、応募者が現在不合格やキャンセルの状態でないことを確認する条件があるとしましょう。
export class JobApplicant {
  updatePass() {
    this.validateIsNotCancel();
    this.validateIsNotFail();
    // バリデーション通過後に状態を変更
  }

  validateIsNotFail(): void {
    // 検証
  }

  validateIsNotCancel(): void {
    // 検証
  }
}
上の機能に対応するテストコードを、jest の spyOn メソッドを使って書いてみると次のようになります。
jest.spyOnメソッドは、特定のオブジェクトのメソッドをモックオブジェクトに置き換えることができます。
オブジェクトとそのメソッド名を引数に取り、モックオブジェクトを返します。
it('応募書類を合格にする。', () => {
  const jobApplicant = new JobApplicant();

  jest
    .spyOn(jobApplicant, 'validateIsNotCancel')
    .mockReturnValue(undefined);
  jest
    .spyOn(jobApplicant, 'validateIsNotFail')
    .mockReturnValue(undefined);

  jobApplicant.updatePass();

  expect(jobApplicant.validateIsNotCancel).toBeCalledTimes(1); // 呼び出されたかを検証
  expect(jobApplicant.validateIsNotFail).toBeCalledTimes(1);
  expect(jobApplicant.status).toBe(JobApplicantStatus.PASS);
});
このテストを見て、状態の変更だけでなく validateIsNotCancel と validateIsNotFail メソッドが呼び出されたかどうかも検証しているので、より完璧なテストだと思うかもしれません。
しかし、このテストは壊れやすいテストであり、良いテストではありません。
もし validateIsNotCancel メソッドの名前が変わったり、validateIsNotFail メソッドが削除されたりすると、このテストは壊れてしまいます。
つまり、実装に依存し、テストの目的が実装に向いているテストです。
内部実装や非公開(private)メソッドはいつでも変わりうるため、情報隠蔽によって隠しているものです。それをわざわざ引っ張り出してテストするのは良くありません。
テストコードは、内部実装よりも実行結果に集中するほうが、リファクタリングへの耐性を高められます。
もう一つ、このコードの惜しい点は呼び出されたかどうかの検証です。
  expect(jobApplicant.validateIsNotCancel).toBeCalledTimes(1); // 呼び出されたかを検証
  expect(jobApplicant.validateIsNotFail).toBeCalledTimes(1);
この検証自体は、意味のない検証も同然です。
このテストの目的からすれば、合格状態に変わったことを検証するだけで十分です。
むしろ、このテストが検証したい目的をぼやけさせるだけで、テストコードの理解を妨げます。
モックオブジェクトの乱用や内部実装の検証は、かえってリファクタリングへの耐性を下げ、保守をより難しくします。
「どのように」という内部実装の検証よりも、「何を」という結果の検証に集中してテストコードを書くべきです。
Better:
- テストコードは内部実装ではなく実行結果に集中すべきである。
- 意味のあるテスト、検証をしよう。
it('応募書類を合格にする。', () => {
  const jobApplicant = new JobApplicant();

  jobApplicant.updatePass();

  expect(jobApplicant.status).toBe(JobApplicantStatus.PASS);
});

it.each([
  ['キャンセル', JobApplicantStatus.CANCEL],
  ['不合格', JobApplicantStatus.FAIL],
])(
  '%s状態の応募書類は合格にできません',
  (_, status) => {
    const jobApplicant = new JobApplicant();
    jobApplicant.status = status;

    expect(() => jobApplicant.updatePass()).toThrowError();
  },
);
3つ目:読みやすいテストを書く
テストコードは、メインのプロダクトコードのためのコードだとしても、私たちが責任を持って管理すべき対象です。
テストコードも読みやすくあるべきです。わかりにくいテストコードは、読むのも保守するのも難しくなります。
もし失敗したテストコードが次のようなコードだと仮定してみましょう。
it('投稿のいいね数を更新する。', () => {
  const a = User.create('test', 1);
  const b = User.create('test', 2);
  const c = Post.create('test', a, 3);
  c.updateLikeCount(300);
  expect(c.like).toBe(300);
})
このテストコードを把握するには、上のコードを見ながらかなりの労力を費やさなければならないかもしれません。
それどころか、User.create、Post.create、c.updateLikeCount メソッドの実装まで見なければならないかもしれません。
このように、何を直せばよいのか把握しにくいテストは、うまく書かれたテストではありません。
良いテストコードとは、読む人がそのテストを理解するのに必要なすべての情報を、テストケースの本文に含んでいるテストのことです。
そして同時に、関係のない情報は含めるべきではありません。
また、テストコードの可読性を高める方法の一つは、テストの構造をきちんと整えることです。
テストの構造は、準備・実行・検証の3つのフェーズに分けることができます。
それぞれのフェーズを、AAAパターン(Arrange-Act-Assertのコメントで区切る)やGWTパターン(given-when-thenのコメントで区切る)で分けて書くのがおすすめです。
(もちろん、構造のためのコメントを使わずに、テスト関数内のコードを各フェーズに合わせて区切って書けるのであれば、その方法を使うのがよいでしょう。)
そして、もしテストの中にあまりにも多くのコードがある場合は、その部分をコード再利用の目的でモジュール化(テストファクトリー、ビルダー、ヘルパーメソッド)しておくと読みやすくなります。
Better:
- テストコードもコードなので、読みやすいコードを書こう。
- 何が悪くて失敗したのか、どう直せばよいのかを把握しにくいテストを書かないようにしよう。
- テストの構造を分けるパターンと、テストコードをモジュール化する方法によって、テストコードを読みやすく書こう。
it('投稿のいいね数を更新する。', () => {
  // given
  const givenLikeCount = 3;
  const post = Post.create('title', createUser(), givenLikeCount);

  // when
  const updateLikeCount = 300;
  post.updateLikeCount(updateLikeCount);

  // then
  expect(post.like).toBe(givenLikeCount + updateLikeCount);
})

function createUser(name = 'name', age = 1) {
  return User.create(name, age);
}
4つ目:テストの仕様にビジネス上の振る舞いを込める
最後に、テスト名を書くときにも注意すべき点があります。
テスト名は、パブリックインターフェースと同じように、意図が明確に表れるように書かれるべきです。
テストコードを書く理由の一つとして、「3つ目:より良いドキュメント」についてお話ししました。
良いテストコードは私たちが書いたコードのドキュメントなので、明確な意図が込められた仕様でなければなりません。
ここで言う意図が明確に表れる名前とは、開発者の用語ではなくビジネス上の振る舞いを表し、非開発者でも読めるように書かれた名前のことです。
Bad:
it('管理者を作成した後、管理者情報を確認する。')
Better:
it('管理者情報で会員登録する')
このようにうまく付けられた名前は、次のような効果をもたらします。
- テストコードや実行ログを確認しなくても振る舞いを推測でき、要件を素早く共有できる。
- 影響範囲を素早く把握でき、推測によって素早く復旧できる。
おわりに
テストについての私の考えを長々と書いてしまったので、伝えたかったメッセージがうまく伝わったかどうか分かりません。
テストの重要性は分かっていても、なかなか導入に踏み切れない方もいらっしゃると思います。
また、プロジェクトの性格によっては、テストの導入はROIの面で難しい場合もあると思います。
この記事を通じて、テストコードが「持続可能なサービス、プロジェクト」に欠かせない要素の一つだということを、少しでも知っていただけたら嬉しいです。
最後に、拙い文章を読んでいただき、ありがとうございました。