

ある日、開発者の方から次のようなメッセージが届きました。

調べてみると、Jenkinsのディスクが満杯になってバッチが止まっていました。ビルド履歴の保持設定(logRotator)が抜けていたジョブの履歴が削除されずに溜まり続けていたのが原因です。その間に、キューには実行待ちのバッチが3,000件近く溜まっていました。
溜まっていたビルド履歴を削除してJenkinsを再起動しましたが、キューに残ったバッチをそのまま実行すると、ユーザーへの通知が想定外のタイミングで送られる恐れがありました。結局キューはすべて空にし、バックエンドの開発者の方々に再実行が必要なバッチを選んでもらい、手動で実行しました。
この記事では、こうしたことが繰り返されていたバッチ基盤をJenkinsからTemporalへ移行する中で考えたことをまとめます。
既存のバッチ構成
Jenkinsは、Inflearn、Rallit、社内サービスなどのバッチ基盤として使われてきました。
- サービスごとに開発用と本番用のJenkinsを1台ずつ立てており、12台のEC2でそれぞれのJenkinsが単独で動いていました。
-
220個のジョブが1日に約15,900回実行されていました。各サービスはバッチのコードをDockerイメージとしてビルドし、Groovyで書いたJenkinsジョブがパイプラインの中でそのイメージを
docker runするか、サービスのバッチ用APIをcurlで呼び出していました。
Jenkinsで抱えていた問題

一度止まるとすべてのバッチが止まる
Jenkinsはジョブ定義、ビルド履歴、ログ、バッチのイメージをすべてディスクに保存するため、ディスクが満杯になるとすべてのバッチが止まります。この問題はJenkinsを導入した頃から、ほぼ四半期ごとに起きていました。ビルド履歴の保持数を制限し、ディスクも何度か増やしましたが、原因が毎回少しずつ違うため、根本的に防ぐのは困難でした。
プラグインが原因でJenkinsが止まることもありました。Jenkinsはほとんどの機能をプラグインで追加し、プラグイン同士も互いに依存しています。2024年10月には、Datadogプラグインを新しく入れて再起動したところ、すでに使っていたGitHubプラグインとの依存関係が合わず、Jenkinsがまったく起動しなくなりました。JenkinsとGitHubプラグインをアップグレードして起動し直すまで、そのJenkinsのバッチは一つも実行されず、復旧後は実行されなかったバッチを探して一つずつ再実行する必要がありました。この手の問題は再起動するまで気づきにくく、バージョンもプラグイン構成も少しずつ異なる12台のJenkinsを更新するたびに、同じリスクを抱えることになりました。
失敗しても気づけないバッチ
Jenkinsでは、Slack通知を送る関数を共通のGroovyライブラリ(Jenkins Shared Library)として用意していましたが、いつ通知を送るかはジョブごとにGroovyファイルで直接設定する必要がありました。そのため、どんな状況を失敗とみなして通知するかもジョブによってばらばらでした。あるデータ同期ジョブでは、途中のステップがDBの認証エラーで失敗し続けていたにもかかわらず、最後のステップが成功したためにジョブ全体がSUCCESSとして記録され、通知が一度も届きませんでした。設定ミスではありますが、220個のジョブがそれぞれ通知を設定する構成である以上、こうしたミスはどこかで起き続けます。さらに、Jenkins自体が止まるとジョブは失敗も終了もしないため、通知はまったく送られませんでした。
普段は暇で、集中すると足りないサーバー
バッチは決まった時刻に少しだけ動いて終わるのに、Jenkinsサーバーは24時間起動しておく必要があります。ホストごとの平均CPU使用率は、アカウント関連のバッチが集中する2台を除くと6%にも届きませんでした。一方、バッチが集中する時間帯は同じEC2の上でジョブ同士がリソースを分け合うため、重いジョブがリソースを占有すると他のジョブの実行が後ろにずれることがありました。そのため、ユーザーの少ない深夜にバッチをまとめて実行するのが難しく、複数の時間帯に分けて実行するしかありませんでした。
バッチが集中する時間帯だけサーバーを増やす方法として、JenkinsのEC2 Fleetプラグインも検討しました。このプラグインは、ジョブの実行時に必要な分だけエージェントのインスタンスを起動してくれます。しかし、バッチは途中で中断されてはいけないのでSpotではなくOn-Demandインスタンスを使う必要があり、インスタンスの起動にはたいてい2分ほどかかるため、決まった時刻にすぐ実行すべきバッチには合わないと判断しました。
検討した代替案
これらの問題は以前から認識していましたが、実際に移行するきっかけになったのは、インフラをAWS EKSへ移す作業でした。サービスがEKSへ移るにつれて、EC2コストの中でJenkinsの占める割合が大きくなっていたのです。また開発チームからも、Groovyで書いたジョブは修正しづらいので、バッチをJenkinsのUIではなくサービスのコードベースの中で静的型付け言語で管理したいという声が多く上がっていました。
必要なときだけリソースを使い、バッチをコードで管理できる候補は2つありました。
| Argo Workflows | Temporal | |
|---|---|---|
| 定義方法 | YAML | コード(SDK) |
| 設定の管理 | GitOpsリポジトリ | ワーカーのコード |
| 懸念点 | YAML、GitOpsの習得 | サーバー、ワーカーの運用 |
当初は、CI/CDパイプラインですでに使っていたArgo Workflowsへ移行するつもりでした。しかし、CI/CDパイプラインはDevOpsチームが管理してきたため、開発チームはArgo Workflowsを直接触ったことがなく、YAMLの書き方やGitOpsリポジトリの運用にも新たに慣れる必要がありました。Groovyから抜け出そうとして、また別のDSLを覚えることになるわけです。
そこで、バッチ基盤の構築でよく名前が挙がるTemporalを選びました。
- ワークフローを一般的なプログラミング言語で書けます。開発チームが慣れている言語やツール(型チェック、テスト、コードレビュー)をそのまま活用できます。
- 実行状態と履歴がDBに記録されます。サーバーやワーカーが再起動しても続きから実行でき、蓄積した履歴は分析にも使えます。
- 既存のバッチのイメージをそのまま使えます。
TemporalのWorkflowは実行の順序を書いたコードで、Activityはその中で実際の処理を行う単位です。サーバーはいつ何を実行するかだけを管理し、実際の実行は別のワーカーが担います。TemporalサーバーはEKS上に自前で立て、状態の保存先は既存のAurora PostgreSQLにDBを追加して、別途コストがかからないようにしました。その代わり、サーバーはDevOpsチームが自分たちで運用する必要があり、各チームはワーカーを運用しつつTemporalのルールを守らなければなりません。そこで、繰り返し書くことになるコードは共通ライブラリにまとめ、よく使う構成はサンプルとして用意して、移行しやすくしました。
移行で重視したこと
- 開発チームの作業を最小限に:ジョブの移行はほとんど開発チームが行います。新しく覚えることが多いと移行を終えるのが難しくなるため、できるだけシンプルに構成できるようにします。
- 失敗通知を確実に送る:通知をジョブごとに設定するのではなく、共通ライブラリで確実に送られるようにします。
- 二重実行を防ぐ:ワーカーが落ちて別のワーカーが引き継いでも、バッチが二度実行されないようにします。
- 停止を検知する:「実行中」のまま誰も気づかない状態をなくします。
- 実行を追跡する:1回の実行のログをまとめて見つけられるようにします。
サービスごとのワーカーと共通ライブラリ
開発チームがTemporalを知らなくても済むように、最初はサービスのリポジトリにジョブ定義のYAMLを置くだけで、DevOpsチームが運用する汎用ワーカー1つがそれを読んで実行する方式を試しました。しかし、開発チームはDevOpsチームが決めたYAMLの構造しか使えないため、新しい処理の流れが必要になるたびにスキーマを拡張しなければなりませんでした。結局、また一つDSLを作っているのと同じでした。
そこで、各サービスのリポジトリのbatch/ディレクトリにサービスごとのワーカーを置き、DevOpsチームは共通部品をライブラリとして提供する構成に変えました。ワーカーは、サービスの言語に関係なく開発チームの誰もが扱えるTypeScriptに統一し、ライブラリを1つだけ管理すれば済むようにしました。
Temporal SDKはWorkflow、Activity、Scheduleを作る基本機能しか提供していないため、バッチの実行や失敗通知は各チームが自前で作る必要がありました。そこで、どのサービスでも同じように実装することになるコードはライブラリとして配布し、開発チームが自分で実装しなくても使えるようにしました。
-
defineSchedule:スケジュールをコードで定義し、ワーカーの起動時にサーバーと同期します。 -
runContainer、runHttp:バッチのイメージをKubernetes Jobとして実行するか、サービスのバッチ用APIを呼び出します。 -
alertOnFailure:最終的に失敗したらSlackに通知を送ります。

Jenkinsのジョブに設定していた内容を、defineScheduleの各項目に合わせてコードに移せば完了です。
// schedules.ts
export const schedules = [
  defineSchedule({
    id: 'daily-report',
    description: '毎日03:00 KSTに日次レポートを生成',
    cron: '0 3 * * *',
    timezone: 'Asia/Seoul',
    overlap: 'skip',
    workflow: containerOnly,
    args: [
      {
        command: ['node', 'dist/batch/daily-report.js'],
        slackChannel: '#batch-alert',
        retries: 2,
      },
    ],
  }),
];
スケジュールが実行するcontainerOnlyは、ライブラリがサンプルとして提供しているワークフローです。Jenkinsのdocker runジョブは、ほとんどがこのワークフロー1つで移行できます。
// workflows/container-only.ts
export async function containerOnly(input: ContainerOnlyInput) {
  const { runContainer } = batchActivities({
    startToCloseTimeout: input.timeout ?? '2h',
    retry: { maximumAttempts: (input.retries ?? 0) + 1 },
  });

  // 最終的に失敗したらSlackに1回だけ通知します。
  return alertOnFailure({ slack: input.slackChannel }, () =>
    // ワークフローがキャンセルされたら、起動したJobを削除します。
    withContainerCleanup(async () => runContainer({ command: input.command, env: input.env })),
  );
}
失敗通知を確実に送る
alertOnFailureで囲んだ範囲で最終的に失敗すると、Slackに通知を送ります。通知の送信はバッチの実行とは切り離された別のActivityです。そのため、バッチがすでに失敗で終わったあとにSlackが一時的に応答しなかったり、通知を送っていたワーカーが落ちたりしても、Temporalはバッチを最初から実行し直すのではなく、通知のステップだけを再試行します。Jenkinsではジョブごとに通知を設定する必要がありましたが、今はライブラリが実行と通知をひとまとめにして提供するので、ジョブによって通知が漏れることはありません。
二重実行を防ぐ
ワーカーがKubernetes Jobを作成した直後に問題が起きて正常に動けなくなると、別のワーカーが引き継いだときにJobをもう一度作成し、同じバッチが二度実行される可能性があります。これを防ぐため、Jobの名前を実行ID(TemporalのRun ID)と試行回数から生成するようにしました。前回の試行の名前のJobがまだ実行中か、すでに成功しているかを先に確認し、あればそのJobの監視を引き継ぎ、なければ新しく作成します。また、Kubernetes側の再試行(backoffLimit)は0にして、試行回数はTemporalだけで管理するようにしました。
停止を検知する
Temporalには、長時間動く処理が定期的に生存信号(heartbeat)を送り、その信号が途絶えるとサーバーが失敗として扱う機能があります。ライブラリではすべてのステップにタイムアウトを設定し、コンテナやAPI呼び出しの完了を待つ間はheartbeatを送るようにしました。そのため、ワーカーが止まってもサーバーがそのステップを失敗として扱い、最終的に失敗すれば通知が送られます。
ワーカーがすべて落ちていたり、スケジュールが実行を開始しなかったりした場合は、そもそも失敗する実行がありません。こうした状況は、Temporalが提供するメトリクス(タスクを取りに来るワーカーがいないときに増える値、スケジュール実行の成功回数)にアラートを設定して監視しています。
Temporalサーバーが停止してから再び起動すると、その間に実行されなかった分を後から実行します。Temporalのデフォルトでは1年前の分まで実行してしまうため、溜まったバッチが一度に走らないよう、予定時刻から1時間以内のものだけを後追いで実行するようにしました。
実行を追跡する
Temporal UIでは、どのステップが実行され、どこで失敗したかは確認できますが、Jenkinsのようにバッチが出力したログは表示されません。Inflabではサービスの監視にすでにDatadogを使っていたので、バッチのログもDatadogに送ることにしました。ただ、Datadogが自動で付けるタグだけでは、1回の実行に含まれる複数のステップや再試行のログをまとめられませんでした。そこでライブラリで、JobのPodにはad.datadoghq.com/tagsアノテーションで、ワーカーのログには属性として、同じ実行IDを入れるようにしました。これで、通知やTemporal UIのリンク1つから、その実行のログをまとめて見られるようになりました。
移行の進め方
220個のジョブを一度に移すことはできないため、JenkinsとTemporalを並行運用しながら、サービスごとにジョブ単位で移行を進めています。サービスごとにTemporalのnamespaceを作り、各チームが自分たちのバッチだけをまとめて見られるようにしました。
DevOpsチームはライブラリを作り、サービスごとのワーカーの作り方をまとめたドキュメントと、Jenkinsの概念がTemporalでは何に当たるかをまとめた移行ガイドを開発チームに共有しました。ライブラリのリポジトリには、そのままコピーして使えるサンプルを置いています。さらに、ライブラリの新しいバージョンをリリースすると、それを使っている各リポジトリに更新PRが自動で作られるようにして、移行の途中で直した内容を各チームがすぐに取り込めるようにしました。
切り替えで最も気をつけたのは、同じバッチがJenkinsとTemporalの両方で実行されてしまうことでした。最初は、スケジュールの有効・無効の状態(enabled)もコードで管理するようにしていました。ところが、問題が起きたときはUIからすぐにスケジュールを止められる必要があるのに、ワーカーが再起動してスケジュールを同期すると、止めておいた状態がコードの値に戻ってしまいました。逆にUIで変えた値を優先すると、コードと実際の状態が食い違います。そこで、新しいスケジュールは常に一時停止の状態で登録し、実行するかどうかはTemporal UIでのみ決めるように変えました。
実際の切り替えはジョブごとに決めた担当の開発者が行い、バックエンド開発者の方が1人、ジョブごとの担当者と進捗をシートで管理してくれました。担当者は環境変数、IAM権限、ジョブのパラメーターがJenkinsと同じかを確認したうえで、開発環境から順にJenkinsのジョブを止めてTemporalのスケジュールを有効にしました。切り替え後に失敗通知が来たら、すぐに対応しました。
デプロイ後に問題が起きたときは、Argo CDで前のバージョンに戻せるようにしました。バッチのイメージとワーカーのイメージを同じタグでビルドし、ワーカーの起動時にスケジュールを同期するので、バッチのコード、ワーカー、スケジュールの設定がまとめて前のバージョンに戻ります。
移行の途中で、バッチのコードに問題がないのに失敗扱いになったことがありました。ノードを自動で増減させるKarpenterがノードを減らす際に、実行中のバッチのPodを退避させたのが原因でした。Kubernetes側の再試行を0にしていたので、Podが終了するとその試行は失敗扱いになり、再試行を設定していないジョブはそのまま失敗しました。そこで、ライブラリが作るバッチのPodには、Karpenterに整理されないよう印(karpenter.sh/do-not-disrupt)を付け、失敗通知にはPodが退避させられた理由も載せるようにしました。
Temporalへの移行で変わること
- コスト:JenkinsのEC2をすべて止めれば、Temporalサーバー、ワーカー、バッチ実行用ノードをすべて合わせても、バッチ基盤のコストは半分以下になります。
- バッチの定義:ジョブの追加やスケジュールの変更がコードになり、PRレビューを通るようになります。デプロイすればスケジュールの設定も一緒に反映され、ロールバックすれば一緒に元に戻ります。
-
失敗通知:ライブラリが提供するサンプルのワークフローを使えば、通知を別途設定する必要はありません。ワークフローを自分で作る場合も、
alertOnFailureで囲めば同じ形式の通知が送られます。 - 実行時刻:バッチごとに別のKubernetes Jobとしてリソースが確保されるので、複数のバッチを同じ時間帯にまとめて実行しても、他のジョブの影響で遅れることはありません。ノードが足りなければKarpenterがOn-Demandノードを起動しますが、平均30秒ほどで準備が整います。検討時にインスタンスの起動に2分ほどかかっていたEC2 Fleetプラグインとは違い、この程度の待ち時間は許容できると判断しました。
- ディスク:サーバーのディスクを気にする必要がなくなります。実行履歴はDBに30日間保持され、ログはDatadogにあります。
失敗通知の「ログを見る」を押すとその実行のDatadogのログが、「ワークフローを見る」を押すとTemporal UIの実行履歴が開きます。
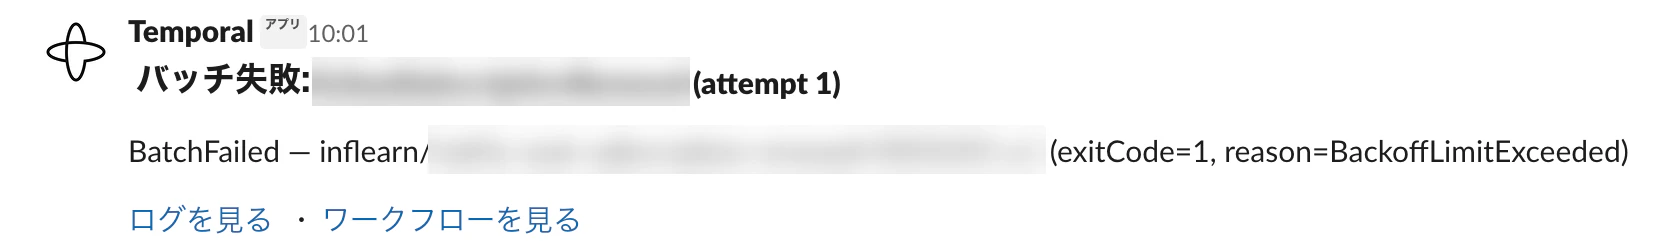
その代わり、構成はJenkinsより複雑になりました。開発チームはTemporalの概念やDatadogでの検索方法を新たに覚える必要があり、この部分は移行ガイドとサンプルで補っているところです。
おわりに
今回の移行で最も長く悩んだのは、Temporalを選ぶことよりも、開発チームが何を気にしなくて済むようにするかを決めることでした。Jenkinsにも共通ライブラリはありましたが、通知はジョブごとに設定する必要があったため、設定が漏れるジョブが出ていました。今回は通知、停止の検知、二重実行の防止、ログの紐付けをバッチ実行の仕組みに最初から組み込み、ジョブを移せばそれらも一緒に付いてくるようにしました。
Jenkinsにはまだ残っているジョブがあります。残りのジョブをすべて移したら、JenkinsのEC2を止める予定です。あわせて、実行履歴をデータ分析用のストレージに移し、誰でもAIツールでバッチの状況を確認できるようにする計画です。また、監視を強化し、ライブラリも改善しながら、バッチがより簡単かつ安定して動くように運用していくつもりです。同じような課題を抱えている方の参考になれば幸いです。
参考資料
※この記事は2026年10月20日に執筆されたものです。