
1. 文章ベクトルでゲーム操作する
AIが自動で弾を避けるというゲーム?を作りました
文章ベクトルのような仕組みで弾避けを学習します。
一般的な強化学習はゲーム専用の状況特化ベクトル、又は画面画像のベクトル化で行うと思うのですが
今回はゲーム特化+文書ベクトル(単語配列)という仕組みで学習しています。
ゲームの盤面状況は次のようなテキスト(単語配列)で表現されます
自機位置5, 200ms経過, 移動完了, 弾_安全_右_中速, 200ms経過, 200ms経過, 弾退出, 200ms経過, 200ms経過, 200ms経過, 無被弾, 自機位置5, 弾_安全_右_中速, 左 ¼, 自機位置4, 200ms経過, 200ms経過, 自機位置3, 移動完了, 200ms経過, 200ms経過, 200ms経過, 200ms経過, 200ms経過, 200ms経過, 無被弾, 自機位置3, 弾_安全_右_中速, 待機 900ms, 200ms経過, 弾退出, 弾なし, 200ms経過, 弾_危険_右_中速, 200ms経過, 200ms経過, 待機完了, 200ms経過, 200ms経過, 弾_危険_右_低速, 弾_危険_正面_低速, 200ms経過, 無被弾, 自機位置3, 弾_危険_右_中速, 弾_危険_正面_低速, 弾_危険_右_低速, 待機 600ms, 弾_危険_正面_中速, 200ms経過, 200ms経過, 200ms経過, 待機完了, 200ms経過, 200ms経過, 200ms経過, 被弾発生, 200ms経過, 200ms経過, 被弾, 自機位置3, 弾_危険_正面_低速, 弾_危険_右_低速, 待機 900ms
AIは現在の盤面状況文章に「右移動」「左移動」「待機」を追加し
各々の推定結果を確認し「無被弾」である選択肢を選ぶという仕組みです。
- デモ:https://ikuo0.github.io/dodge-train/gen1/
- ソース:https://github.com/ikuo0/dodge-train
- Vanilla JavaScriptとWeb Workerで実装し、学習はブラウザ内で行う。
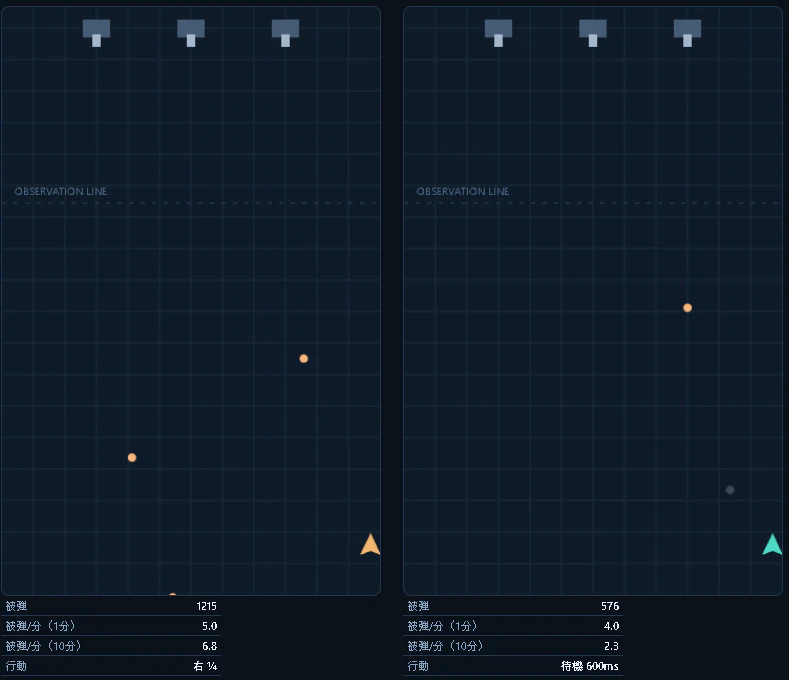
デモンストレーション画面
左の画面はランダムに動き学習データを作成します
バックグラウンドで学習が進みます
右の画面は学習結果を元に行動を決定します
本デモンストレーションは x10 倍速にしてだいたい5,6分放置するとランダムより避けるようになります
2. ゲームを「文章」にする
状況、行動、結果をそれぞれ離散的なトークンに変換し、発生順に並べる。ここでいう文章は自然言語ではなく、ゲーム内イベントを単語に見立てた列であることを明示する。
例:[自機位置, 弾の状況, 右移動, 時間経過, 被弾]
- 弾の危険度・方向・速度、自機位置、行動、被弾などを語彙として扱う。
- 観測やイベントの発生時にトークンを記録し、時間経過もトークンとして加える。
- 行動開始時の履歴を入力、その後の被弾・無被弾を正解とし、結果確定までの情報が入力に混ざらないようにする。
3. 文章の予測結果をゲーム操作に変える
現在の履歴と状況に各行動候補を加え、候補ごとに被弾・無被弾のスコアを比較する。無被弾が予測される候補を優先し、リスクの低い行動を実行する。
例:[履歴, 現在の状況, 左移動] → 被弾・無被弾を予測
- 予測した文章をそのまま操作するのではなく、候補の結果予測を行動選択に使う。
- 左右の経験から結果を学び、右画面の行動選択に反映する。
- 被弾スコアはモデルの比較値であり、安全を保証するものではない。
4. 重み付きONE-HOT総和:順序を圧縮した軽量な文章ベクトル
各トークンのONE-HOTに「現在からの距離に応じた重み」を掛け、要素ごとに足して固定長ベクトルにする。
特徴ベクトル = Σ(ONE-HOT(トークン) × そのトークンの時間距離に応じた重み)
- 直近のトークンほど重く、古いトークンほど軽くすることで、出現の新旧を特徴量に残す。
- 本実装では最大128トークンを41次元に集約し、直近32トークンは線形に減衰、それ以前はさらに指数的に減衰させる。
- 同じ単語の出現回数だけでなく、どの程度最近に現れたかを反映できる。一方、和にするため厳密な並びや単語間の関係は復元できず、異なる履歴が同じ特徴になる場合もある。
- TransformerやRNNに比べて超軽量という特徴はあるが、総和の都合上トークン列が長くなると過去の情報は潰れる、具体的には32トークンくらいが表現の限界
5. 小規模な問題でどこまで学習できたか
10分くらいのトレーニングでランダムな動きと比べて1/3程度の被弾率となっている
学習はできており、想定通り弾を避けている
6 応用範囲
本格的な強化学習に比べて行動が適当すぎる部分があり、精密さよりも人間ぽさの表現に向いているかなと思います
格闘ゲームで100%対空出してくるとか、大攻撃にフレーム単位で反応して差し替えしてくるとか、
そういう不条理なCPUにならず、人間らしいミスやフェイントが効くCPUを作れるのかなと思いました
今度は格ゲーで実験したいですね
以上です