
はじめに
前回の記事では、8バイトブロックに対して呼び出される encrypt 関数を解析しました。
encrypt 関数では、隣の要素の加算、kvar_map による置き換え、4bit rotate、要素のswapといった処理が行われていました。また、再帰呼び出しと例外処理を制御フローとして利用していたため、IDAのデコンパイル結果だけでは処理の流れを把握しにくい構造になっていました。
この記事では、encrypt 関数の後に呼び出される tpyrcne 関数と、ブロックごとの暗号キー更新処理を解析します。
結論から言うと、暗号化処理全体は各8バイトブロックに対して encrypt → tpyrcne → encrypt の順で処理を行い、その後にキー配列を更新する構造になっていました。
最終的には、これまで解析したキー生成・暗号化処理・キー更新処理をもとに、暗号化済みファイルを復号するPythonスクリプトを作成します。
このWriteupの他の記事はこちら↓
- FWE CTF - NativeKotlian Writeup (フロー解析)
- FWE CTF - NativeKotlian Writeup (暗号キー生成関数)
- FWE CTF - NativeKotlian Writeup (暗号化ロジック)
- FWE CTF - NativeKotlian Writeup(暗号化ロジック2・キー更新・復号)
tpyrcne関数
実際に呼び出している箇所を見て、引数が何を受け付けているのかを調べます。
1個目の引数には暗号化データを、2個目の引数には暗号キー生成で生成された、キー配列を与えています。


関数の引数の名前と型を更新しておきます。

関数の処理
この関数は8回のループを行っています。
最初は、それぞれのi番目の要素を取得しています。

その次に、取得したキーの要素を6bit左rotateし、その結果に8を掛けています。
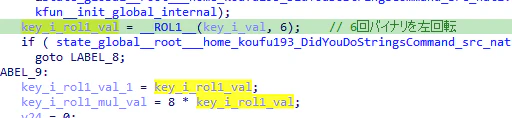
そして、データとキーそれぞれに変換処理を施し、xorしたものを暗号化データのi番目として設定しています。
暗号化データ
- 3回rotate left
- 3倍にする


暗号化キー
- 6回バイナリを左回転
- aと置く

- 左回転したものを8倍
- bと置く

- a - bする

暗号化データの要素として設定

高級言語にする
いつものごとく、疑似Javaにします。
void tpyrcne(UByteArray blob, List<UByte> key) {
  for (int i = 0; i < 8; i++) {
    UByte blobElem = blob[i];
    blobElem = rol(blobElem, 3);
    blobElem = blobElem * 3;

    UByte keyElem = key[i];
    keyElem = rol(keyElem, 6);
    keyElem = (keyElem * 8) - keyElem;

    blob[i] = blobElem ^ keyElem;
  }
}
復号スクリプト作成
keyElemが分かればblobElemを割り出せ、元に戻せそうです。
blobの復号の際に、171 を掛けているのは、8bit空間における 3 の乗法逆元が 171 であるためです。つまり、暗号化時の * 3 を元に戻すために * 171 を行っています。
def rotl8(value: int, shift: int) -> int:
    return ((value << shift) & 0xFF) | (value >> (8 - shift))
...
def tpyrcned(blob: list[int], key: list[int]):
    for i in range(8):
        key_elem = rotl8(key[i], 6)
        key_elem = (key_elem * 7) & 0xFF

        blob[i] = blob[i] ^ key_elem # blobElem
        blob[i] = (blob[i] * 171) & 0xFF
        blob[i] = rotr8(blob[i] , 3)
検証
スクリプトは省略しますが、tpyrcne関数に渡される引数を、実行前と実行後でダンプし、スクリプトが正しく動いているのかを検証します。
tpyrcne実行前
pwndbg> context
...
*RDI  0x7fffffffd8b0 —▸ 0x27e9c3 (kclass:kotlin[ByteArray]+3) ◂— 0
*RSI  0x7ffff6b7e370 —▸ 0x2810a0 (kclass:kotlin.collections[ArrayList]) ◂— 0x2810a0
...
 ► 0x25a440 <kfun:#tpyrcne(kotlin.UByteArray;kotlin.collections.List<kotlin.UByte>){}>       push   rbp
   0x25a441 <kfun:#tpyrcne(kotlin.UByteArray;kotlin.collections.List<kotlin.UByte>){}+1>
...
pwndbg> source list_peek.py
List length: 8
Items address: 0x7fffffffd8c0
Element 0 value: 0xb2
Element 1 value: 0x69
Element 2 value: 0xdc
Element 3 value: 0x39
Element 4 value: 0x2f
Element 5 value: 0xba
Element 6 value: 0x60
Element 7 value: 0x7b
Result: [178, 105, 220, 57, 47, 186, 96, 123]
pwndbg> source collection_peek.py
Items length: 8
0x7ffff6afe1a8
0x7ffff6afe1d8
0x7ffff6afe280
0x7ffff6afe328
0x7ffff6afe358
0x7ffff6afe388
0x7ffff6afe430
0x7ffff6afe4d8
Result: [58, 54, 7, 45, 55, 59, 31, 27]
pwndbg>
実行後
pwndbg> finish
...
 ► 0x25c79e <kfun:#main(kotlin.Array<kotlin.String>){}+8334>    jmp    kfun:#main(kotlin.Array<kotlin.String>){}+7372 <kfun:#main(kotlin.Array<kotlin.String>){}+7372>
    ↓
   0x25c3dc <kfun:#main(kotlin.Array<kotlin.String>){}+7372>    mov    rdi, rbx     RDI => 0x7fffffffd8b0 —▸ 0x27e9c3 (kclass:kotlin[ByteArray]+3) ◂— 0
...
pwndbg> source list_peek.py
List length: 8
Items address: 0x7fffffffd8c0
Element 0 value: 0x5d
Element 1 value: 0x3a
Element 2 value: 0xf5
Element 3 value: 0x56
Element 4 value: 0xf0
Element 5 value: 0xdd
Element 6 value: 0x78
Element 7 value: 0xfb
Result: [93, 58, 245, 86, 240, 221, 120, 251]
pwndbg> source collection_peek.py
Items length: 8
0x7ffff6afe1a8
0x7ffff6afe1d8
0x7ffff6afe280
0x7ffff6afe328
0x7ffff6afe358
0x7ffff6afe388
0x7ffff6afe430
0x7ffff6afe4d8
Result: [58, 54, 7, 45, 55, 59, 31, 27]
pwndbg>
比較
blob = [93, 58, 245, 86, 240, 221, 120, 251]
key = [58, 54, 7, 45, 55, 59, 31, 27]
tpyrcned(blob, key)
print(blob)
うまく動いています。
PS C:\Ctf\FWE-CTF\NativeKotlian> python solver.py
[178, 105, 220, 57, 47, 186, 96, 123]
その後のフロー
一回目のencryptのあとに呼ばれたtpyrcne関数の呼び出し後、再びencryptを呼び出すようになっています。
pwndbg> context
...
 ► 0x25c79e <kfun:#main(kotlin.Array<kotlin.String>){}+8334>    jmp    kfun:#main(kotlin.Array<kotlin.String>){}+7372 <kfun:#main(kotlin.Array<kotlin.String>){}+7372>
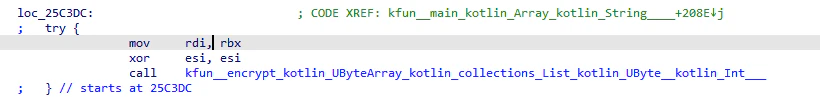
高級言語っぽく表すと、次のような構造になっていると考えられます。
そう考えると、二回目のencryptにも例外ハンドラがあると考えるのが妥当です。
try {
  encrypt(blob, 0);
} catch (Exception ex) {
  tpyrcne(blob, key);
} catch (Throwable ex) {
}
encrypt(blob, 0);
...
二回目のencryptの例外ハンドラを見てみると、一個目の時と違いそうです。
一個目は、
*(_DWORD )((_QWORD *)(*v10 & 0xFFFFFFFFFFFFFFFCLL) + 92LL)は例外タイプ値の取得です。
例外タイプ値と0x18を比較し、例外タイプ値のほうが数値が大きい場合、loc_25C983へ飛んでいます。
でしたが、今回はjbで0x19未満の場合のみジャンプしています。
                                                 ;   catch(...) // owned by 25C3DC
mov     rcx, [rsp+348h+var_348]
mov     rcx, [rcx]
lea     rdx, [rsp+348h+var_340]
mov     [rcx+0D0h], rdx
mov     rdi, rax        ; void *
call    __cxa_begin_catch
mov     rax, [rax+8]
mov     r13, [rax]
mov     qword ptr [rsp+348h+var_320+8], r13
call    __cxa_end_catch
mov     rax, [r13+0]
and     rax, 0FFFFFFFFFFFFFFFCh
mov     rax, [rax]
mov     eax, [rax+5Ch]
add     eax, 0FFFFFF83h
cmp     eax, 19h
jb      loc_25C3E6
jmp     loc_25C9DE
encryptが伝搬してくる例外が同じ型であり、1個目の場合はjaの条件に当てはまらなかったはずです。
なので、こちらは条件を満たすと考えるのが妥当ですが、一応確認しておきます。
確認すると、やはり条件を満たし、ジャンプするようになっています。
► 0x25c731 <kfun:#main(kotlin.Array<kotlin.String>){}+8225> ✔ jb kfun:#main(kotlin.Array<kotlin.String>){}+7382 <kfun:#main(kotlin.Array<kotlin.String>){}+7382>
そうすると、encrypt後のフロー、つまり正規のmainのフローに帰ってきました。

条件に当てはまらない場合、再度ThrowExceptionしています。

これを高級言語化すると、次のような構造になっていると考えられます。
try {
  encrypt(blob, 0);
} catch (Exception ex) {
  tpyrcne(blob, key);
} catch (Throwable ex) {
}
try {
  encrypt(blob, 0);
} catch (Exception) {
}
...
改めてフローチャート
暗号化のフローが、最初の解析とズレていたことがわかったので、改良します。
暗号化キー更新
いよいよ最後の山場です。
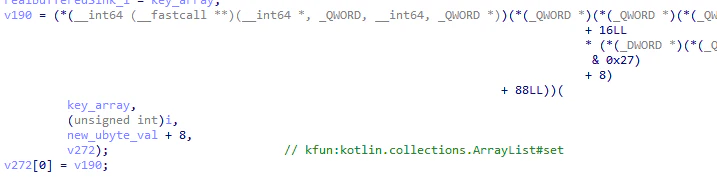
8回ループし、それぞれのi番目の暗号化キーの内容を更新しているようです。
暗号化キーのi番目を取得し、暗号化データのi番目と足しています。

その後、その結果を暗号化キーのi番目として要素を設定しています。
高級言語化する
for (int i = 0; i < 8; i++) {
  key[i] = blob[i] + key[i];
}
そのままPythonで再現します
def update_key(blob: list[int], key: list[int]):
    for i in range(8):
        key[i] = (blob[i] + key[i]) & 0xFF
検証
ループの最初と最後にブレークポイントを置いて、暗号化データとキーを抽出した後、比較します。
実行前
pwndbg> source list_peek.py
List length: 8
Items address: 0x7fffffffd8c0
Element 0 value: 0xfe
Element 1 value: 0x83
Element 2 value: 0xc0
Element 3 value: 0x23
Element 4 value: 0x10
Element 5 value: 0xdd
Element 6 value: 0x5b
Element 7 value: 0x50
Result: [254, 131, 192, 35, 16, 221, 91, 80]
pwndbg> source collection_peek.py
Items length: 8
0x7ffff6afe1a8
0x7ffff6afe250
0x7ffff6afe2f8
0x7ffff6afe328
0x7ffff6afe358
0x7ffff6afe400
0x7ffff6afe4a8
0x7ffff6afe550
Result: [52, 47, 38, 61, 58, 12, 39, 32]
実行後
pwndbg> source collection_peek.py
Items length: 8
0x7ffff6afef70
0x7ffff6afef88
0x7ffff6afefa0
0x7ffff6afefb8
0x7ffff6afefd0
0x7ffff6afefe8
0x7ffff6aff000
0x7ffff6aff018
Result: [50, 178, 230, 96, 74, 233, 130, 112]
比較
blob = [254, 131, 192, 35, 16, 221, 91, 80]
key = [52, 47, 38, 61, 58, 12, 39, 32]
update_key(blob, key)
print(key)
問題なさそうです。
PS C:\Ctf\FWE-CTF\NativeKotlian> python solver.py
[50, 178, 230, 96, 74, 233, 130, 112]
ファイルを復号化する
ついにすべての必要な箇所の解析を終わらせました。
あとはすべてを組み合わせて、今回与えられたファイルを復号化するスクリプトを書きます。
import typing

kvar_map = [101, 163, 69, 35, 181, 201, 0, 113, 5, 150, 157, 141, 24, 217, 89, 6, 7, 111, 112, 124, 31, 109, 57, 133, 10, 204, 79, 238, 175, 19, 206, 47, 149, 90, 184, 215, 140, 96, 227, 36, 186, 230, 123, 228, 85, 44, 132, 11, 13, 58, 118, 60, 192, 14, 246, 244, 99, 179, 25, 41, 240, 84, 212, 129, 190, 236, 155, 80, 194, 49, 66, 116, 8, 139, 18, 62, 207, 151, 37, 243, 131, 185, 87, 130, 70, 28, 224, 162, 43, 223, 211, 226, 251, 254, 92, 56, 239, 137, 81, 177, 55, 233, 134, 208, 107, 158, 189, 205, 166, 95, 46, 174, 102, 106, 171, 74, 64, 218, 225, 219, 142, 98, 12, 76, 91, 145, 172, 248, 193, 94, 237, 221, 97, 231, 191, 199, 119, 195, 45, 234, 146, 161, 214, 159, 135, 105, 147, 115, 198, 72, 82, 42, 187, 86, 222, 21, 170, 178, 138, 104, 164, 180, 176, 252, 30, 67, 125, 4, 156, 241, 83, 59, 196, 154, 121, 3, 165, 65, 203, 182, 122, 75, 128, 114, 200, 39, 117, 34, 27, 232, 103, 148, 40, 202, 229, 255, 17, 110, 54, 108, 15, 250, 73, 23, 100, 126, 183, 38, 153, 26, 169, 197, 71, 1, 61, 51, 63, 33, 152, 143, 68, 88, 2, 160, 52, 9, 167, 253, 93, 213, 29, 235, 127, 173, 209, 247, 144, 50, 120, 78, 210, 22, 48, 249, 168, 77, 220, 20, 216, 16, 32, 188, 136, 245, 242, 53]

def rotr8(value: int, shift: int) -> int:
    return (value >> shift) | ((value << (8 - shift)) & 0xFF)

def rotl8(value: int, shift: int) -> int:
    return ((value << shift) & 0xFF) | (value >> (8 - shift))

def decode_key(key: str) -> list[int]:
    UPPER_CASE_LETTERS = "OIPCYZVTKHDAUBEFRQSMJWNXGL"
    LOWER_CASE_LETTERS = "rwlihcuoebjxsptyfqvgzdnmka"
    NUMBER_LETTERS = "2049531678"
    result = []
    for c in key:
        random = 0
        index = 0
        if c in UPPER_CASE_LETTERS:
            random = 0
            index = UPPER_CASE_LETTERS.index(c)
        elif c in LOWER_CASE_LETTERS:
            random = 1
            index = LOWER_CASE_LETTERS.index(c)
        elif c in NUMBER_LETTERS:
            random = 2
            index = NUMBER_LETTERS.index(c)
        else:
            raise ValueError(f"Invalid character in file name: {c}")

        result.append(random * 26 + index)
    return result

def decrypt(blob: list[int]):
    # inverse catch/finally process
    for i in range(8):
        # 25A3E9
        to_swap = (i * 2) % 8
        index_val = blob[i]
        to_swap_val = blob[to_swap]
        blob[i] = to_swap_val
        blob[to_swap] = index_val
        # 25A380
        blob[i] = rotr8(blob[i], 4)
    # inverse addition and s-box process
    for i in range(7, -1, -1):
        # 25A214
        '''
           int kvarMapIndex = array[index] + index * index;
            array[index] = kvarMap[kvarMapIndex];
        '''
        kvarMapIndex = kvar_map.index(blob[i])
        blob[i] = (kvarMapIndex - i * i) & 0xFF
        # 25A1F2
        '''
        *((_BYTE *)&blob_array->items + (int)index) += *((_BYTE *)&blob_array->items + next_index);// 配列の隣の値を足す
        '''
        a = blob[(i + 1) % 8]
        blob[i] = (blob[i] - a) & 0xFF

def tpyrcned(blob: list[int], key: list[int]):
    for i in range(8):
        key_elem = rotl8(key[i], 6)
        key_elem = (key_elem * 7) & 0xFF

        blob[i] ^= key_elem
        blob[i] = (blob[i] * 171) & 0xFF
        blob[i] = rotr8(blob[i], 3)

def update_key(blob: list[int], key: list[int]):
    for i in range(8):
        key[i] = (blob[i] + key[i]) & 0xFF

file_name = "W3e11yC7.tar.gz.encrypted"
key = decode_key(file_name.split(".")[0])
output = ".".join(file_name.split(".")[:-1])
with open(file=file_name, mode="rb") as reader, open(file=output, mode="wb") as writer:
    while True:
        chunk = reader.read(8)
        if not chunk:
            print("decryption finished")
            break

        if len(chunk) != 8:
            raise ValueError(f"unexpected chunk size: {len(chunk)} bytes")

        blob = list(chunk)
        cipher_blob = blob.copy()

        decrypt(blob)
        tpyrcned(blob, key)
        decrypt(blob)

        writer.write(bytes(blob))

        update_key(cypher_blob, key)
アーカイブの中には、flagともともとのプログラムがあります。
終わりに
ここまでで、ファイル名から初期暗号鍵を復元し、各8バイトブロックに対して encrypt → tpyrcne → encrypt の逆変換を行うことで、暗号化済みファイルを復号できるようになりました。
Kotlin/Nativeでビルドされたバイナリは、Kotlin標準ライブラリやGC、例外処理に由来する処理が多く、デコンパイル結果だけでは読みづらい部分が多くありました。
特に、例外処理が単なる異常系ではなく制御フローの一部として利用されていた点が難しく、静的解析だけでは全体像を把握しにくい問題でした。
AIにも一部相談しましたが、Kotlin/Native由来のデコンパイル結果やランタイム構造については不正確な説明も多く、最終的にはIDAとpwndbgで実際の制御フロー・メモリ・文字列オブジェクトを確認しながら手動で解析しました。
その分、ノイズが非常に多いバイナリの中から、復号に必要な情報だけを切り出す力を鍛えられたと感じています。