
1. 論文概要
| 論文 | 発表年 | 発表先 | 概要 |
|---|---|---|---|
| TTSDS: Text-to-Speech Distribution Score | 2024 | IEEE SLT 2024 | 音声合成品質を、話者特性・プロソディ・明瞭度などの特徴量分布から評価する指標を提案。 |
| TTSDS2: Resources and Benchmark for Evaluating Human-Quality Text to Speech Systems | 2026 | ICLR 2026 | TTSDSを改良し、異なるドメインや言語に対する頑健性を向上。11,000件以上の主観評価データと14言語のベンチマークを公開。 |
- TTSDS2のarXiv初回投稿:2025年6月24日
- TTSDS2論文(arXiv)
- ICLR公式論文ページ
- 実装(GitHub)
- ライセンス:MIT
2. TTSDS2の理論と手法
2.1 評価因子
TTSDS2は、音声の特徴量分布を次の4つの因子から評価する。

| 因子 | 評価内容 |
|---|---|
| GENERIC | 自己教師あり学習モデルの表現による全般的な音声特性 |
| SPEAKER | 話者の声質・話者らしさ |
| PROSODY | ピッチや発話速度などの韻律的特徴 |
| INTELLIGIBILITY | 音声認識モデルの内部表現に基づく明瞭度 |
TTSDSとTTSDS2で使用される特徴量の主な違いを表1に示す。
| 項目 | TTSDS | TTSDS2 |
|---|---|---|
| 一般的な音声特徴(GENERIC) | HuBERT、wav2vec 2.0など | WavLMを追加し、表現を見直す |
| 録音環境(ENVIRONMENT) | ノイズ・歪みを独立評価 | 独立した評価項目を削除 |
| 話者らしさ(SPEAKER) | 話者埋め込み | 基本的に継承 |
| プロソディ(PROSODY) | ピッチ、持続時間など | 発話速度の特徴を改良 |
| 明瞭度(INTELL.) | WER(音声認識誤り率)など | 音声認識モデルの内部表現を利用 |
TTSDS2では、WERベースの特徴量を音声認識モデルの最終層の活性化値に変更し、発話速度の特徴量を改良した。また、GENERICにはWavLMを追加し、多言語評価ではmHuBERT-147やXLSR-53を使用する。
2.2 記号と評価の目的
数式で使用する主な記号を以下に示す。
- $S$:音声信号
- $R$:音声信号から特徴量への変換。変換後の特徴量を $R(S)$ と表す。
- $D^{\mathrm{NOISE}}$:ノイズデータセット
- $\mathcal{D}^{\mathrm{NOISE}}$:一様ノイズ、正規分布ノイズ、すべて1のデータ、すべて0のデータなどを含むノイズデータセットの集合
- $\tilde{P}(R(\tilde{S})\mid\tilde{D})$:音声合成データセットの特徴量の実測分布
- $P(R(S)\mid D)$:実データセットの特徴量の実測分布
TTSDS2では、合成音声の特徴量分布が実音声の特徴量分布にどの程度近いかを定量的に評価する。
その際、合成音声の特徴量分布をノイズ分布とも比較する。ノイズは、ドメイン、話者、その他の交絡因子に依存しない比較対象として使用される。
参考として、1次元のピッチ特徴量の分布例を図に示す。

2.3 Wasserstein距離とスコア
実音声と合成音声の特徴量分布を、2-Wasserstein距離 $W_2$ で比較する。ノイズ分布も比較対象に加え、合成音声がノイズよりも実音声に近いかを評価する。
2.3.1 高次元の場合
分布が多変量ガウス分布で近似できる高次元ベクトルについて、実データセット $D$ と合成データセット $\tilde{D}$ の間の2-Wasserstein距離(Fréchet距離とも呼ばれる)は、次のように定義される。
$$
\begin{aligned}
W_2(D,\tilde{D})^2=||\mu-\tilde{\mu}||_2^2+\operatorname{Tr}\left(
\Sigma+\tilde{\Sigma}-2\left(
\tilde{\Sigma}^{1/2}
\Sigma
\tilde{\Sigma}^{1/2}
\right)^{1/2}
\right)
\end{aligned}
$$
ここで、$\mu$、$\Sigma$ は実音声の特徴量分布の平均ベクトルと共分散行列、$\tilde{\mu}$、$\tilde{\Sigma}$ は合成音声の特徴量分布の平均ベクトルと共分散行列である。
2.3.2 1次元の場合
1次元の場合、2-Wasserstein距離の2乗は、累積分布関数の逆関数 $C^{-1}$ と $\tilde{C}^{-1}$ を用いて、次のように表される(Kolouri et al., 2019)。
$$
W_2(D,\tilde{D})^2=\int_0^1
\left(
C^{-1}(z)-\tilde{C}^{-1}(z)
\right)^2
\ dz
$$
2.3.3 TTSDS2スコアの定義
異なる特徴量や要因にわたる距離を正規化するため、0から100までの範囲のスコアを算出する。
合成音声の特徴量分布 $\tilde{P}$ について、ノイズデータセットの集合 $\mathcal{D}^{\mathrm{NOISE}}$ に含まれる各ノイズデータセットとの $W_2$ 距離を計算し、その最小値を $W_2^{\mathrm{NOISE}}$ と定義する。
なお、合成音声と参照音声の語彙的内容が一致している必要はない。
$$
W_2^{\mathrm{NOISE}}=\min_{D^{\mathrm{NOISE}}\in\mathcal{D}^{\mathrm{NOISE}}}W_2(\tilde{D},D^{\mathrm{NOISE}})
$$
また、合成音声と実音声の特徴量分布との距離を $W_2^{\mathrm{REAL}}$ と表す。
TTSDS2スコアは、次の式で定義される。
$$
S =
100 \times
\frac{
W_2^{\mathrm{NOISE}}
}{
W_2^{\mathrm{REAL}} + W_2^{\mathrm{NOISE}}
}
\tag{1}
$$
- $W_2^{\mathrm{REAL}}$:合成音声と実音声の特徴量分布間の距離
- $W_2^{\mathrm{NOISE}}$:合成音声と複数のノイズ分布との距離の最小値
式(1)のスコアは0から100の値を取り、50より大きい場合に、ノイズよりも実音声との類似性が高いことを示す。
TTSDS2では、各特徴量のスコアを因子ごとに平均し、さらに4因子のスコアを等しい重みで平均して最終スコアを求める。
各因子スコアの算出には5つのWasserstein距離の計算が必要だが、複数の表現を組み合わせることによるアンサンブル効果により、必要なサンプル数は少なく、50~100サンプルで十分とされる。これは、単一の潜在表現を用いた分布スコアとは異なる(Kilgour et al., 2019)。
2.4 特徴量の選定と改良
特徴量の頑健性を検証するため、各グラウンドトゥルースデータセットを2つに分割し、一方の半分を用いて、もう一方の半分に対するTTSDSスコアを算出した。
平均スコアが95未満であった特徴量、またはデータセット間の標準偏差が大きかった特徴量は、すべて除外した。
主な改良点は以下のとおり。
-
INTELLIGIBILITY
- 当初は、単語誤り率(WER)に基づく特徴量を使用していた。
- 予備実験では、WERベースの特徴量を使用すると、さまざまなドメインの実データに対してスコアが低くなることが確認された。
- そこで、代わりに音声認識モデル(ASR)の最終層の活性化値を使用することにした。
-
PROSODY
- 当初は、次の特徴量を使用していた。
- (a) WORLDのピッチコンター(Morise et al., 2016)
- (b) マスク付きプロソディモデルの埋め込み(Minixhofer et al., 2024)
- (c) HuBERT(Hsu et al., 2021)から抽出したトークン長(フレーム単位)
- トークン長の特徴量を使用すると、実際の音声データに対するスコアが低くなることが確認された。
- そこで、発話内の重複を除去したHuBERTトークンの数をフレーム数で割ることで、発話レベルの話速を算出する。
- オリジナルのTTSDSにも含まれている多言語音声認識システム「Allosaurus」(Li et al., 2020)についても、同様の処理を行う。
- 当初は、次の特徴量を使用していた。
-
GENERIC
- 多様性を高めるために、WavLM(Chen et al., 2022)の特徴量を追加した。
- 多言語対応のため、HuBERTをmHuBERT-147(Boito et al., 2024)に、wav2vec 2.0をそのXLSR-53版(Conneau et al., 2021)に変更した。
3. 人間の主観評価との比較
3.1 評価データセット
異なる音声領域に対する汎化性能を検証するため、以下の4種類のデータセットを構築した。
- CLEAN: SNRでフィルタリングした明瞭な読み上げ音声
- NOISY: ノイズを含むLibriVox録音
- WILD: YouTubeから収集した多様な話し方・録音条件の音声
- KIDS: 子どもとバーチャルチューターの会話音声
各データセットから60人の話者を選び、参照音声と合成対象テキストを同じ話者から取得することで、話者の違いによる評価バイアスを抑えた。
3.2 主観評価と比較指標
200人の評価者を募集し、20種類のTTSシステムを対象にMOS、CMOS、SMOSを収集した。
匿名化された11,846件の評価を取得し、ライセンス上の制約を考慮した11,282件を公開している。
比較対象には、話者埋め込みの類似度、MOS予測モデル、信号ベースの指標、分布ベースの指標など、計16種類の客観評価指標を用いた。
3.3 主な結果

- TTSDS2の平均Spearman順位相関係数は0.67で、TTSDSを約10%上回った。
- 比較した16指標のうち、すべての評価条件で人間評価との相関係数0.50超を達成したのはTTSDS2のみだった。
- 話者類似度指標やSQUIM MOSも良好な結果を示したが、ドメインを横断した安定性ではTTSDS2が優れていた。
- KIDSのように学習時に遭遇しにくい音声領域では、各指標の性能が低下する傾向が見られた。
また、因子の重みを学習する方法と等重みの単純平均を比較した結果、未見ドメイン4条件のうち3条件で単純平均が優れた。
この結果は、特定ドメインへの過学習を避けるうえで、等重みの集約が有効であることを示唆する。
4. 多言語ベンチマーク
TTSDS2は14言語のベンチマークを提供し、YouTubeから評価用音声を定期的に収集・構築するパイプラインも公開している。
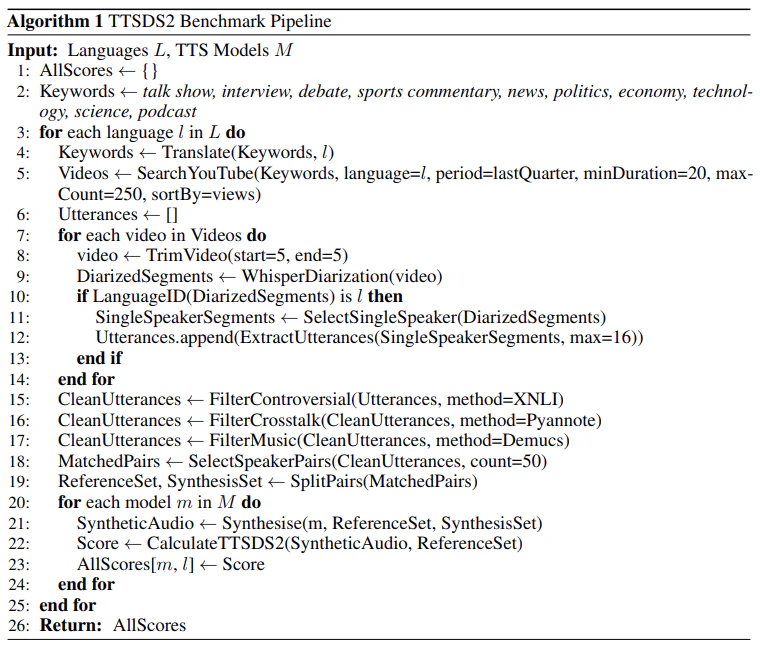
パイプラインは、次の5段階で構成される。
- 収集: 言語別キーワードによるYouTube検索
- 前処理: 音声抽出と話者ダイアライゼーション
- フィルタリング: 言語、不適切な内容、話者の重複、背景音楽などを検査
- 音声合成: 参照音声の話者特性と合成対象テキストを組み合わせて生成
- 評価・公開: TTSDS2で評価し、ベンチマークに結果を反映
また、言語間の類型論的距離とTTSDS2による実音声分布の類似度には負の相関が見られた。
単一言語版では $\rho=-0.39$、多言語版では $\rho=-0.51$ であり、いずれも統計的に有意だった。
5. 制限事項
TTSDS2には、次のような制限がある。
- 複数の特徴量抽出とWasserstein距離の計算が必要で、計算コストが比較的高い。
- 人間評価との相関は強いものの、Spearman順位相関係数は0.8を超えておらず、主観評価を完全に代替することはできない。
- テキストと一致しない音声生成など、TTSDS2だけでは検出できない失敗がある。
- 発話の文脈を十分に考慮できず、30秒を超える長い音声も評価対象に含まれていない。
テキストと音声の不一致を補足するため、ベンチマークではWERが高い発話の数も報告している。
6. まとめ
TTSDS2は、音声品質を単一の特徴量や発話単位の比較だけで評価するのではなく、複数の音声特徴量の分布を実音声およびノイズ分布と比較する評価指標である。
GENERIC、SPEAKER、PROSODY、INTELLIGIBILITYの4因子を等しい重みで集約することで、異なる音声領域や言語に対して比較的安定した性能を示す。
TTSDS2は、主観評価との相関やドメインを横断した頑健性の面で有用だが、テキストとの不一致や発話の文脈など、単独では十分に評価できない要素も残されている。