
近年、大規模なWebサービスやSaaSでは、
- データベースを停止させたくない
- アクセス増加に合わせて水平スケールしたい
- 複数リージョンでサービスを提供したい
- それでもRDBのトランザクションは維持したい
といった要求が増えています。
従来のRDBMSでは、1台のデータベースを中心に構成し、性能が不足したらCPUやメモリを増やす「垂直スケール」が一般的でした。
一方、クラウドネイティブなシステムでは、複数のノードへデータを分散しながらSQLとACIDトランザクションを提供する Distributed SQL(分散SQL) という選択肢があります。
その代表的なデータベースの1つが CockroachDB です。
この記事では、CockroachDBについて、
- CockroachDBとは何か
- 内部でどのようにデータを分散しているのか
- Range / Replica / Raft / Leaseholderとは何か
- 分散トランザクションをどう実現しているのか
- 水平スケールとマルチリージョン
- PostgreSQLとの関係
- どのようなシステムに向いているのか
- Google Spannerとは何が違うのか
を図を使いながら整理します。
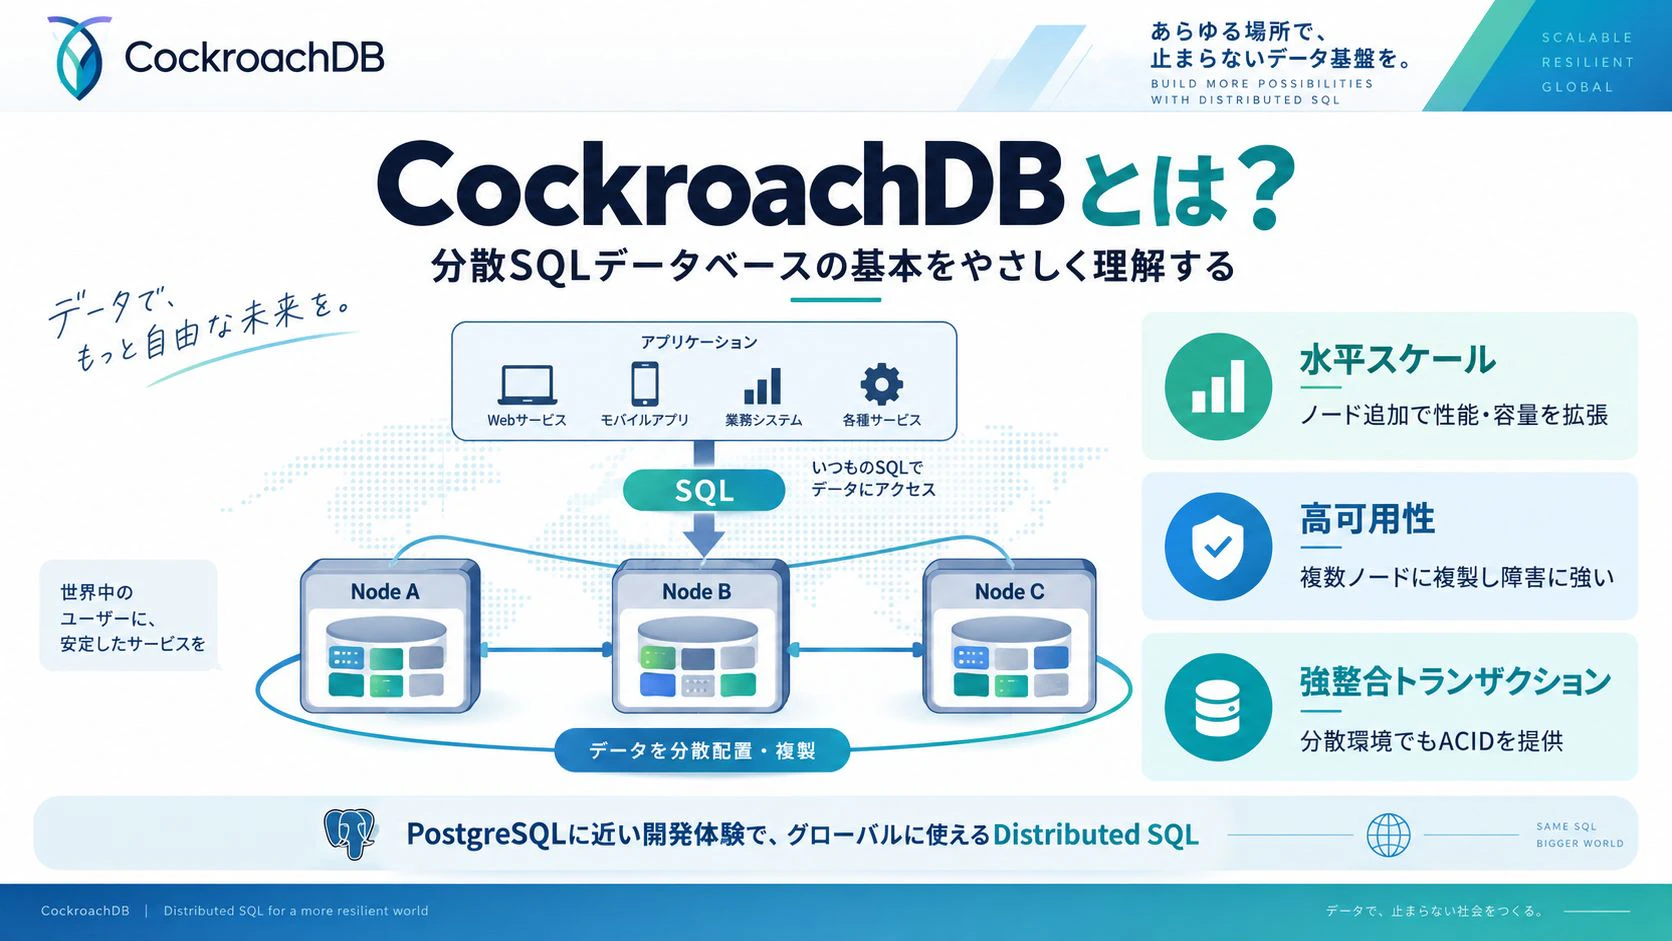
CockroachDBとは
CockroachDBは、複数のサーバーにデータを分散しながら、RDBMSのようにSQLとACIDトランザクションを利用できるDistributed SQL Databaseです。
一言で表現すると、
PostgreSQLに近い開発体験を維持しながら、水平スケール・高可用性・マルチリージョンを実現するための分散SQLデータベース
と考えると分かりやすいです。
一般的なアプリケーションからはSQLでアクセスします。
Application
    |
    | SQL
    v
CockroachDB
しかしCockroachDB内部では、単純に1台のDBサーバーへデータを保存しているわけではありません。
内部ではデータを細かく分割し、複数ノードへ配置・複製しています。
つまり、
Application
    |
    | SQL
    v
+-------------------------+
|      CockroachDB        |
|                         |
| SQL Layer               |
| ----------------------- |
| Distributed KV Layer    |
| ----------------------- |
| Distributed Storage     |
+-------------------------+
   |        |        |
 Node A   Node B   Node C
という構造になっています。
アプリケーション側から見ると普通のSQLデータベースに近い一方、その裏側では分散システムが動いている、というのが重要なポイントです。
CockroachDBの内部構造
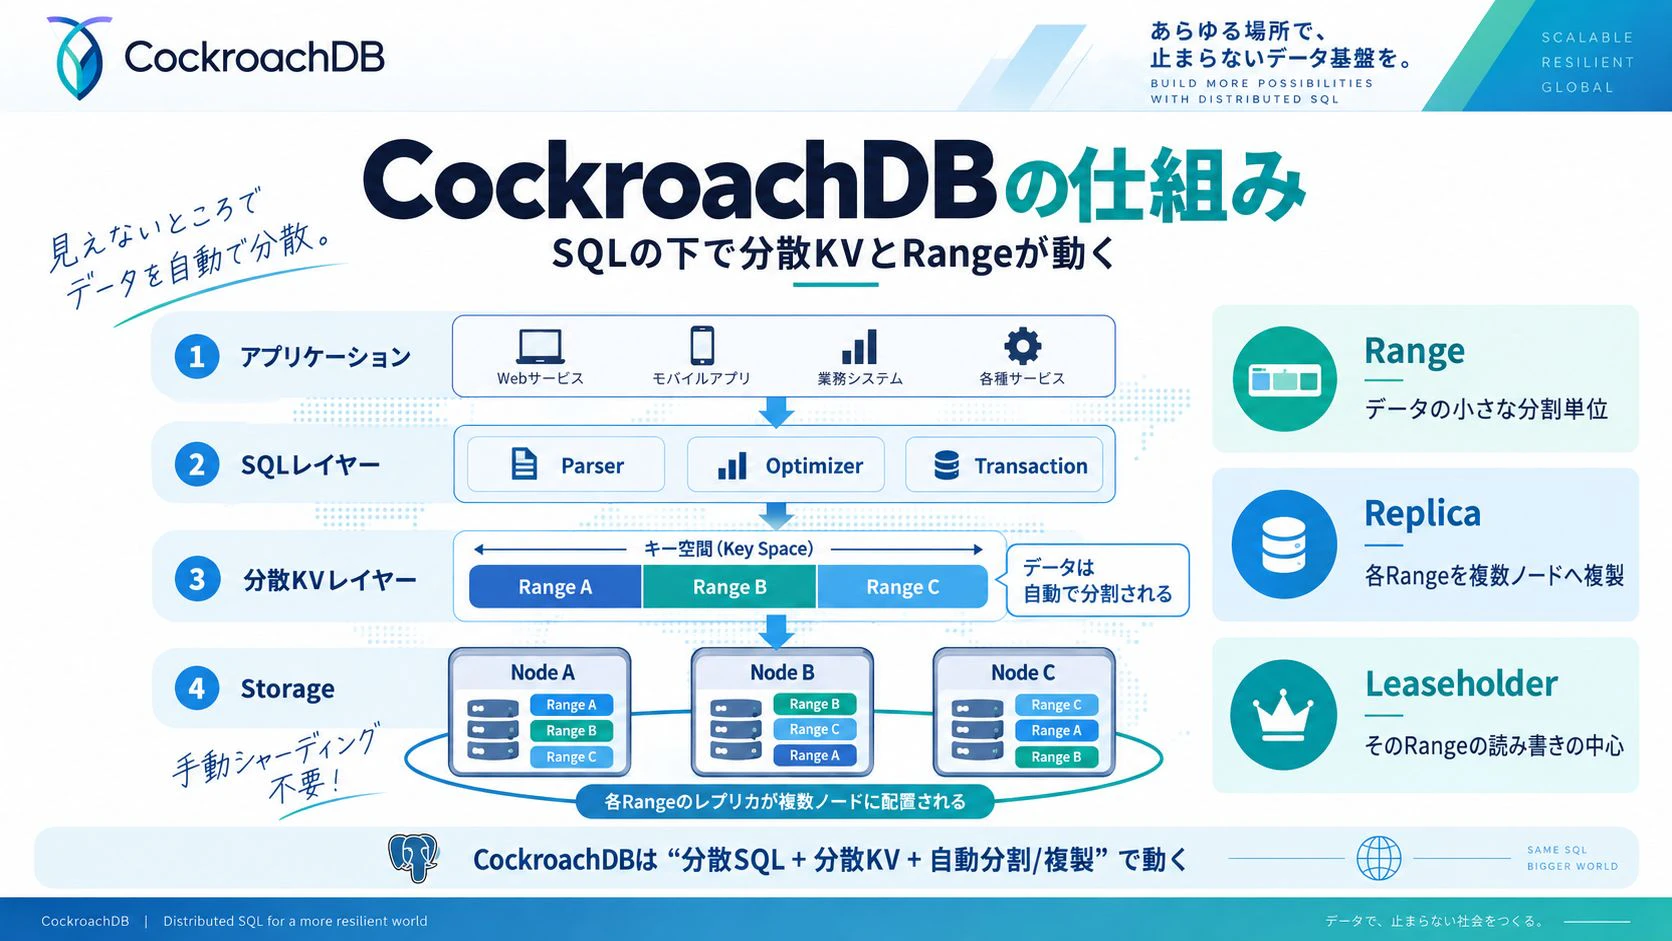
CockroachDBの内部構造を理解するうえで重要なのが、
Range / Replica / Raft / Leaseholder
です。
順番に見ていきます。
SQLの下には分散Key-Value Storeがある
CockroachDBはSQLを受け取ると、内部的にはデータをKey-Value形式として処理します。
概念的には、
SQL Table
   |
   v
Key-Value
   |
   v
Range
   |
   v
Replica
という流れです。
例えば次のようなテーブルがあったとします。
CREATE TABLE users (
    id UUID PRIMARY KEY,
    name STRING NOT NULL
);
アプリケーションからは通常のテーブルとして見えますが、内部ではテーブルやインデックスが順序付きのKey-Value空間へマッピングされます。
その巨大なKey-Value空間を、小さな単位へ分割したものが Range です。
Range
RangeはCockroachDBにおける重要なデータ分割単位です。
イメージとしては、
Key Space

+-------------+-------------+-------------+
|   Range A   |   Range B   |   Range C   |
+-------------+-------------+-------------+
のようになります。
データが増加するとRangeが分割され、クラスタ内のノードへ再配置されます。
そのため、アプリケーション側で、
user_id 1~100000 はDB1
user_id 100001~200000 はDB2
といった手動シャーディングを実装する必要がありません。
CockroachDB自身がデータの分割と配置を管理します。
Replica
Rangeは1か所だけに保存されるわけではありません。
障害に備えて、同じRangeを複数ノードへ Replica として配置します。
例えば、
              Range A

      +------------------+
      | Replica / Node A |
      +------------------+
              |
        +-----+-----+
        |           |
        v           v
+---------------+ +---------------+
| Replica       | | Replica       |
| Node B        | | Node C        |
+---------------+ +---------------+
という構成です。
これによってNode Aが停止した場合でも、Node BやNode Cにデータが残っています。
ただし、単に3コピーを作っているだけではありません。
複数Replica間で「どの値が正しいのか」を合意する必要があります。
そこで利用されるのが Raft Consensus Algorithm です。
Raftによる合意形成
CockroachDBではRangeのReplica群がRaftグループを構成します。
例えば3 Replicaの場合、書き込みを確定するためには基本的に過半数の合意が必要になります。
              Write
                |
                v
          +-----------+
          | Replica A |
          +-----------+
            /       \
           / Raft    \ Raft
          v           v
 +-----------+     +-----------+
 | Replica B |     | Replica C |
 +-----------+     +-----------+

       Majority agreement
              |
              v
            COMMIT
3 Replicaなら、過半数は2です。
この仕組みによって、1台のノードが障害になっても残りのReplicaで処理を継続できます。
Leaseholder
各Rangeには Leaseholder と呼ばれるReplicaがあります。
Leaseholderは、そのRangeに対する最新の読み取りや書き込み処理で中心的な役割を持ちます。
概念的には、
Range A

Node A
  |
  +-- Leaseholder
  |
  +----------+
             |
      +------+------+
      |             |
   Node B        Node C
   Replica       Replica
というイメージです。
重要なのは、すべてのデータに対して1台だけのMasterが存在するわけではないことです。
Range AのLeaseholderはNode A、
Range BのLeaseholderはNode B、
Range CのLeaseholderはNode C、
というように分散できます。
Node A
 └ Range A Leaseholder

Node B
 └ Range B Leaseholder

Node C
 └ Range C Leaseholder
そのため、クラスタ全体で負荷を分散できます。
分散していてもACIDトランザクションが使える
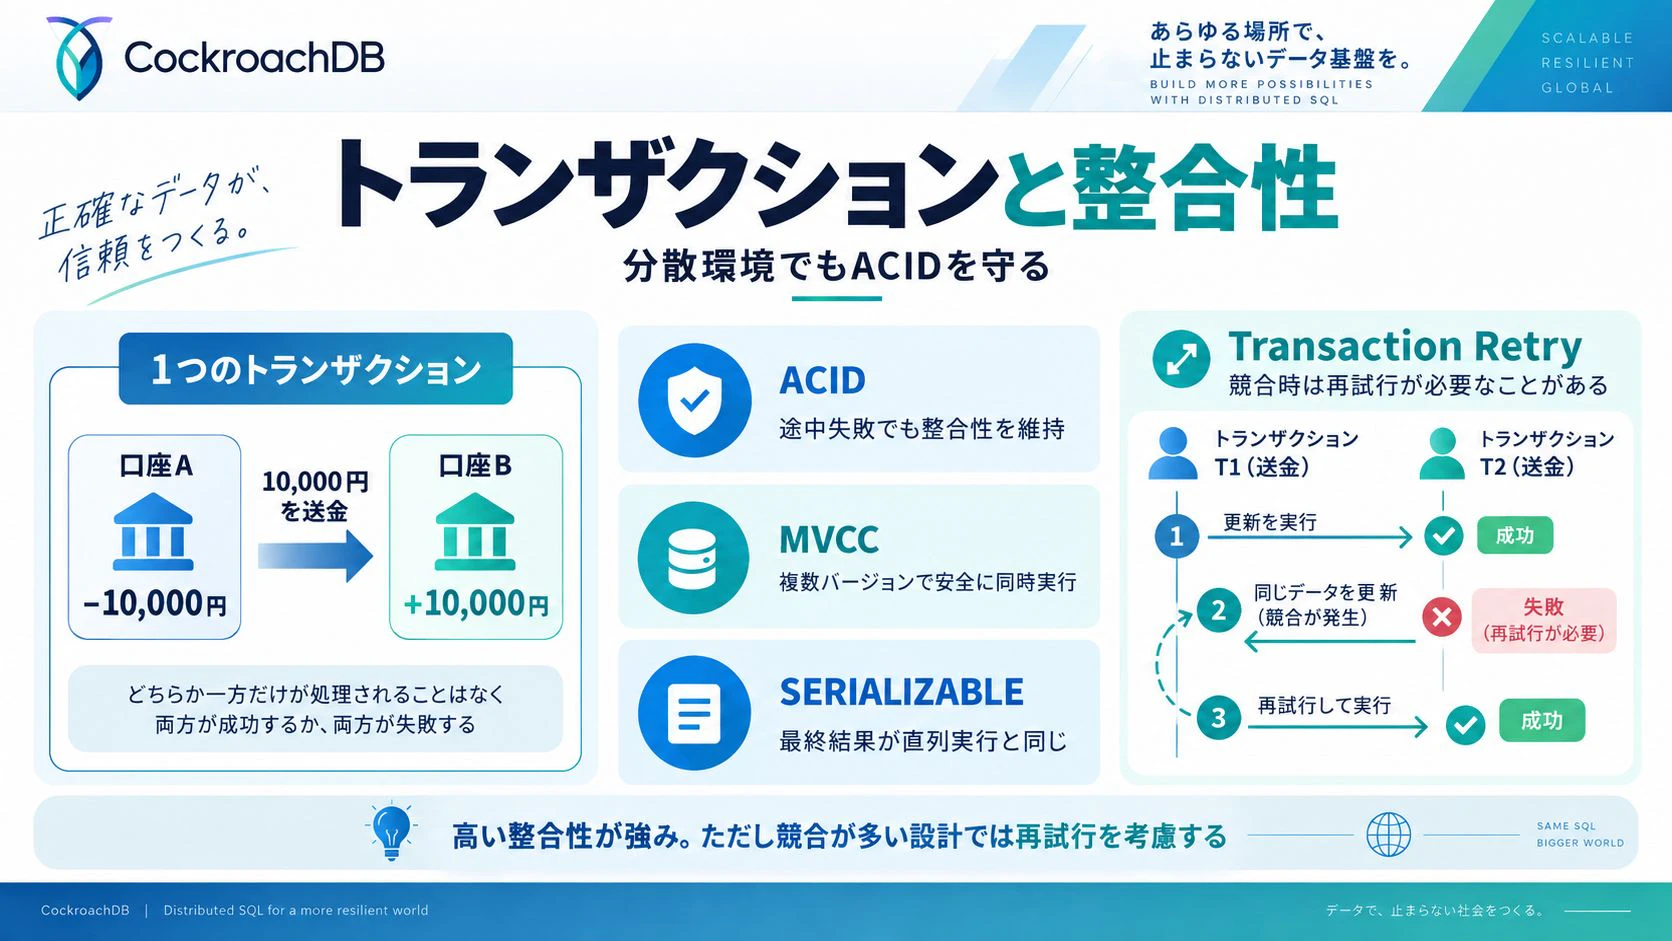
CockroachDBの大きな特徴は、
データが複数サーバーへ分散していても、通常のRDBMSに近いACIDトランザクションを利用できる
ことです。
例えば銀行口座間で1万円を送金するとします。
BEGIN;

UPDATE accounts
SET balance = balance - 10000
WHERE id = 1;

UPDATE accounts
SET balance = balance + 10000
WHERE id = 2;

COMMIT;
口座Aと口座Bが物理的に異なるNodeやRangeへ配置されていたとしても、CockroachDBは1つのトランザクションとして扱います。
つまり、
口座A
-10,000円

        +10,000円

口座B
について、
両方成功
または、
両方失敗
となるように制御します。
「片方だけ更新された」という状態を避けることができます。
MVCC
CockroachDBでは MVCC(Multi-Version Concurrency Control) が使われています。
単純に最新値だけを保存するのではなく、データを複数のバージョンとして管理します。
概念的には、
balance

t1 -> 100,000
t2 -> 90,000
t3 -> 120,000
のような状態です。
これによって、複数のトランザクションが同時に実行されても、それぞれが整合したデータを参照できるようにしています。
デフォルトはSERIALIZABLE
CockroachDBの重要な特徴として、デフォルトのTransaction Isolation Levelが SERIALIZABLE であることが挙げられます。
SERIALIZABLEでは、実際には複数のトランザクションが並列実行されていたとしても、
T1 ------->

     T2 ------->

  T3 ------->
外部から見た最終結果が、
T1
 ↓
T2
 ↓
T3
のような何らかの直列実行と同等になるよう制御されます。
これは、
- 決済
- 注文
- 在庫
- 会員情報
- 金融処理
- Identity
など、データ整合性を重視するシステムでは大きなメリットになります。
Transaction Retry
一方、SERIALIZABLEには注意点があります。
複数のトランザクションが同じデータへ同時にアクセスすると、競合が発生する場合があります。
例えば、
Transaction T1
       |
       +---- UPDATE user A

Transaction T2
       |
       +---- UPDATE user A
のようなケースです。
CockroachDBがそのまま両方を確定するとSERIALIZABLEを維持できない場合、一方のトランザクションを再実行させる必要があります。
CockroachDB自身で自動Retryできるケースもありますが、状況によってはアプリケーション側へRetry Errorが返されます。
そのためCockroachDBを利用するアプリケーションでは、
BEGIN
  |
Transaction
  |
Retry Error?
  |
  +-- Yes --> Retry
  |
  +-- No ---> COMMIT
という設計を意識する必要があります。
PostgreSQLからCockroachDBへ移行するときには、特に確認しておきたいポイントです。
水平スケール
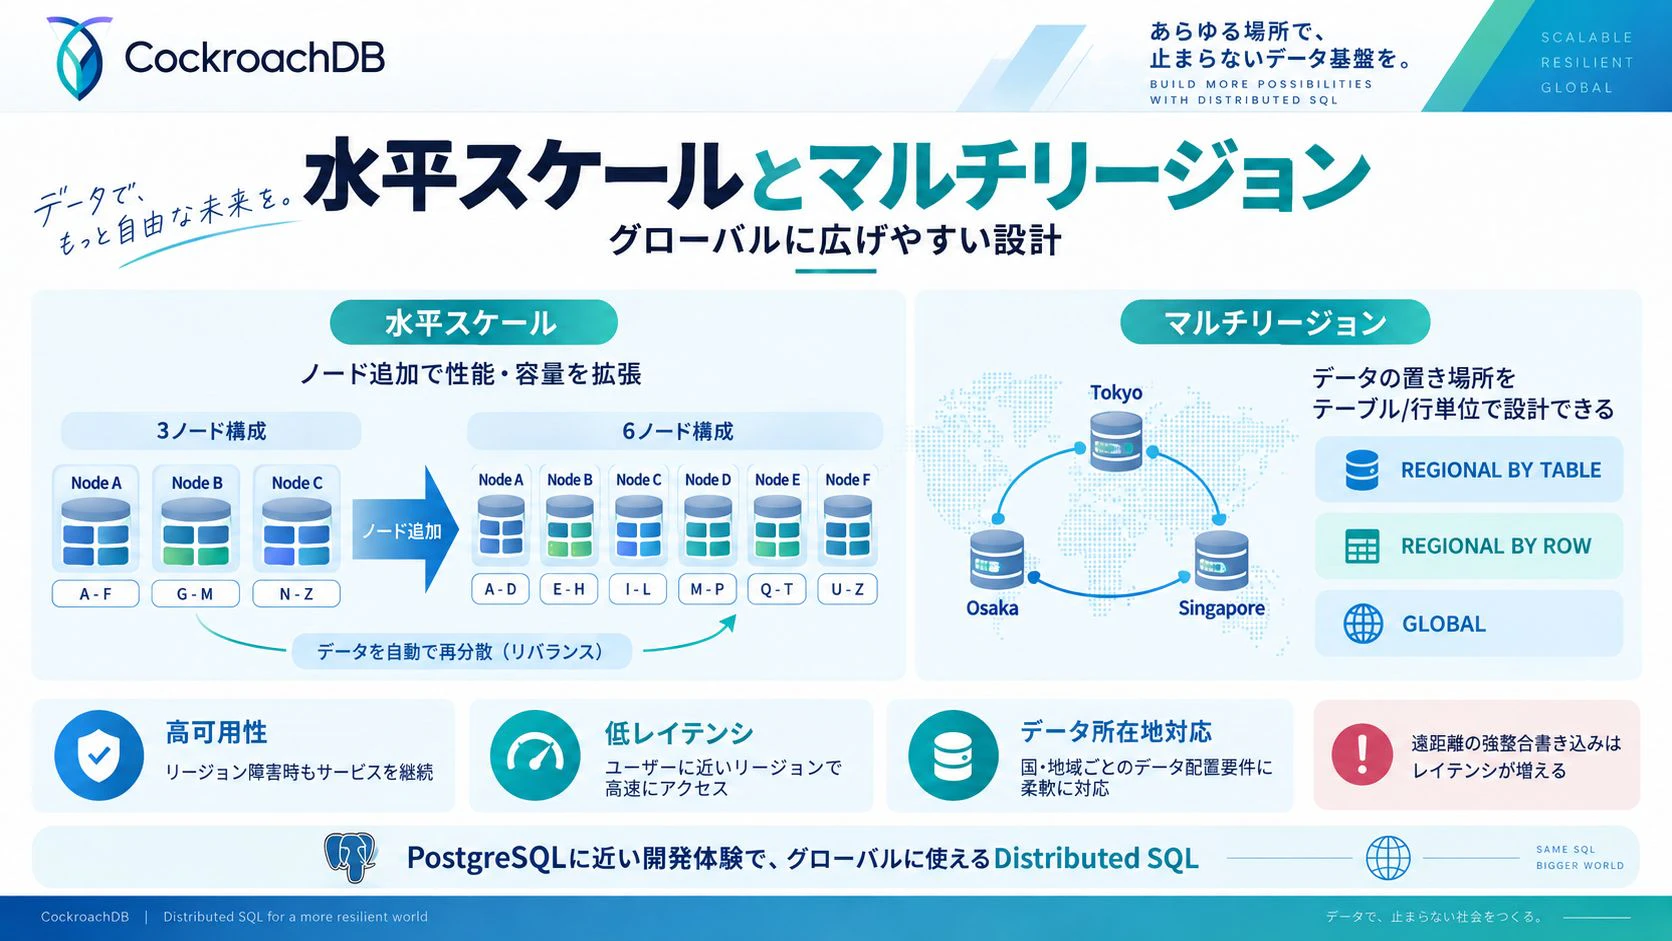
CockroachDBが一般的なRDBMSと大きく異なるポイントの1つが Horizontal Scaling です。
従来型RDBMSの場合、
アクセス増加
    |
    v
CPU不足
    |
    v
より大きなDBサーバーへ変更
という垂直スケールが中心になります。
一方CockroachDBでは、
3 Nodes

Node A
Node B
Node C

   ↓ Node追加

6 Nodes

Node A
Node B
Node C
Node D
Node E
Node F
のようにノードを追加できます。
その後、Rangeがクラスタ内で再配置されます。
Before

Node A : Range A / B / C
Node B : Range D / E / F
Node C : Range G / H / I


After

Node A : Range A
Node B : Range B
Node C : Range C
Node D : Range D
Node E : Range E
Node F : Range F
実際の配置はもっと複雑ですが、考え方としてはこのようになります。
ただし、
Nodeを2倍にすれば、どんな処理でも必ず性能が2倍になる
わけではありません。
特定キーへのアクセスが集中する Hotspot が存在すれば、そのRangeだけに負荷が集中する可能性があります。
Distributed SQLでもデータモデルやPrimary Keyの設計は重要です。
マルチリージョン
CockroachDBは複数リージョンにまたがる構成にも対応しています。
例えば、
Tokyo
  |
  +------ Osaka
  |
  +------ Singapore
といった構成です。
さらにCockroachDBでは、テーブルや行の特性に応じたLocalityを指定できます。
代表的なものとして、
REGIONAL BY TABLE
REGIONAL BY ROW
GLOBAL
があります。
REGIONAL BY TABLE
テーブルを特定リージョン中心で扱う方式です。
Japan Orders
     |
     v
Tokyo
特定地域からの読み書きが中心となるテーブルに向いています。
REGIONAL BY ROW
行単位でホームとなるリージョンを変えられます。
例えば、
User A -> Tokyo
User B -> Tokyo
User C -> Singapore
User D -> Singapore
という配置です。
グローバルSaaSなどで、
日本ユーザーのデータは日本周辺
シンガポールユーザーのデータはシンガポール周辺
といった設計を考えやすくなります。
GLOBAL
複数リージョンから低レイテンシで読み取ることを重視するテーブル向けです。
一方で、遠距離のReplica間で整合性を維持する必要があるため、書き込みではネットワーク距離によるレイテンシを考える必要があります。
分散DBでは、
Consistency
Availability
Latency
Geographic Distance
の関係から完全に自由になるわけではありません。
PostgreSQLとの関係
CockroachDBはPostgreSQLそのものではありませんが、PostgreSQLとの互換性を非常に重視しています。
PostgreSQL Wire Protocolをサポートしているため、多くの場合、
Application
    |
PostgreSQL Driver
    |
    v
CockroachDB
という構成が可能です。
例えば、
Java
 └ PostgreSQL JDBC

Go
 └ pgx

Python
 └ psycopg

Node.js
 └ PostgreSQL compatible driver
といった既存エコシステムを活用できます。
ただし、
CockroachDB = PostgreSQL
ではありません。
CockroachDBは根本的に分散データベースなので、PostgreSQL固有の機能やExtensionなど、一部互換性がないものがあります。
既存PostgreSQLシステムを移行する場合は、
- SQL
- Data Type
- Extension
- ORM
- Transaction
- Sequence
- Lock
- Query Pattern
などの互換性確認が必要です。
CockroachDBが向いているケース
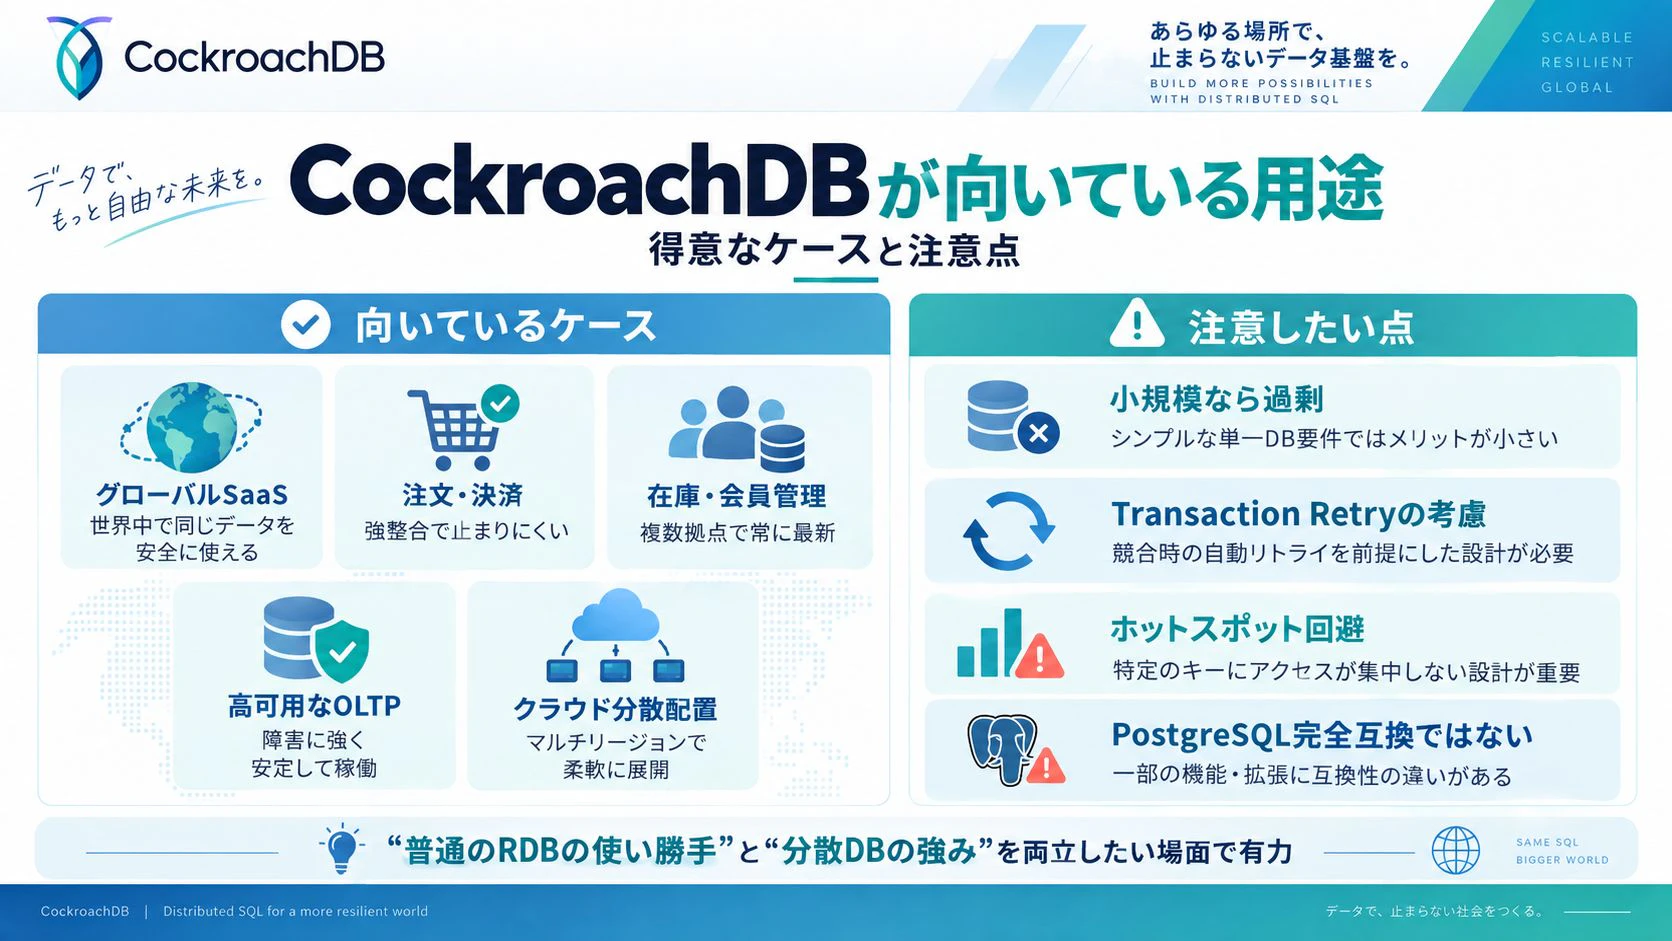
CockroachDBの特徴を考えると、特に向いているのは次のようなシステムです。
グローバルSaaS
複数の国やリージョンから同じサービスを利用するSaaSです。
Japan Users
      \
US Users ---- CockroachDB
      /
EU Users
グローバルに分散しながら、単一の論理データベースとして扱いたいケースと相性があります。
注文・決済
注文と在庫、決済など、複数データを同時に更新する必要があるシステムです。
Distributed SQLでありながらACIDトランザクションを利用できることがメリットになります。
高可用性が重要なOLTP
特定の1台のデータベース障害によってサービス全体を停止させたくないシステムです。
Rangeを複数ノードへ複製することで、ノード障害に強い構成を作れます。
CockroachDBを使うときの注意点
CockroachDBはすべてのシステムでPostgreSQLより優れている、というデータベースではありません。
小規模システムでは過剰になる可能性
例えば、
Single Region
小規模
アクセスも少ない
PostgreSQL 1台で十分
というシステムなら、通常のPostgreSQLやマネージドRDBMSのほうがシンプルです。
Distributed DatabaseにはDistributed Database特有の複雑性があります。
Transaction Retry
SERIALIZABLEで競合が発生した場合、Retryを意識したアプリケーション設計が必要です。
Hotspot
例えば時系列データなどで、
最新データ
最新データ
最新データ
最新データ
     |
     v
Same Range
のようになると、特定Rangeへ負荷が集中する可能性があります。
「分散DBだから何も考えずに無限スケールする」というわけではありません。
PostgreSQL完全互換ではない
PostgreSQL互換性は大きなメリットですが、PostgreSQLそのものではありません。
特に既存システムからの移行では互換性検証が重要です。
Google Spannerとの比較
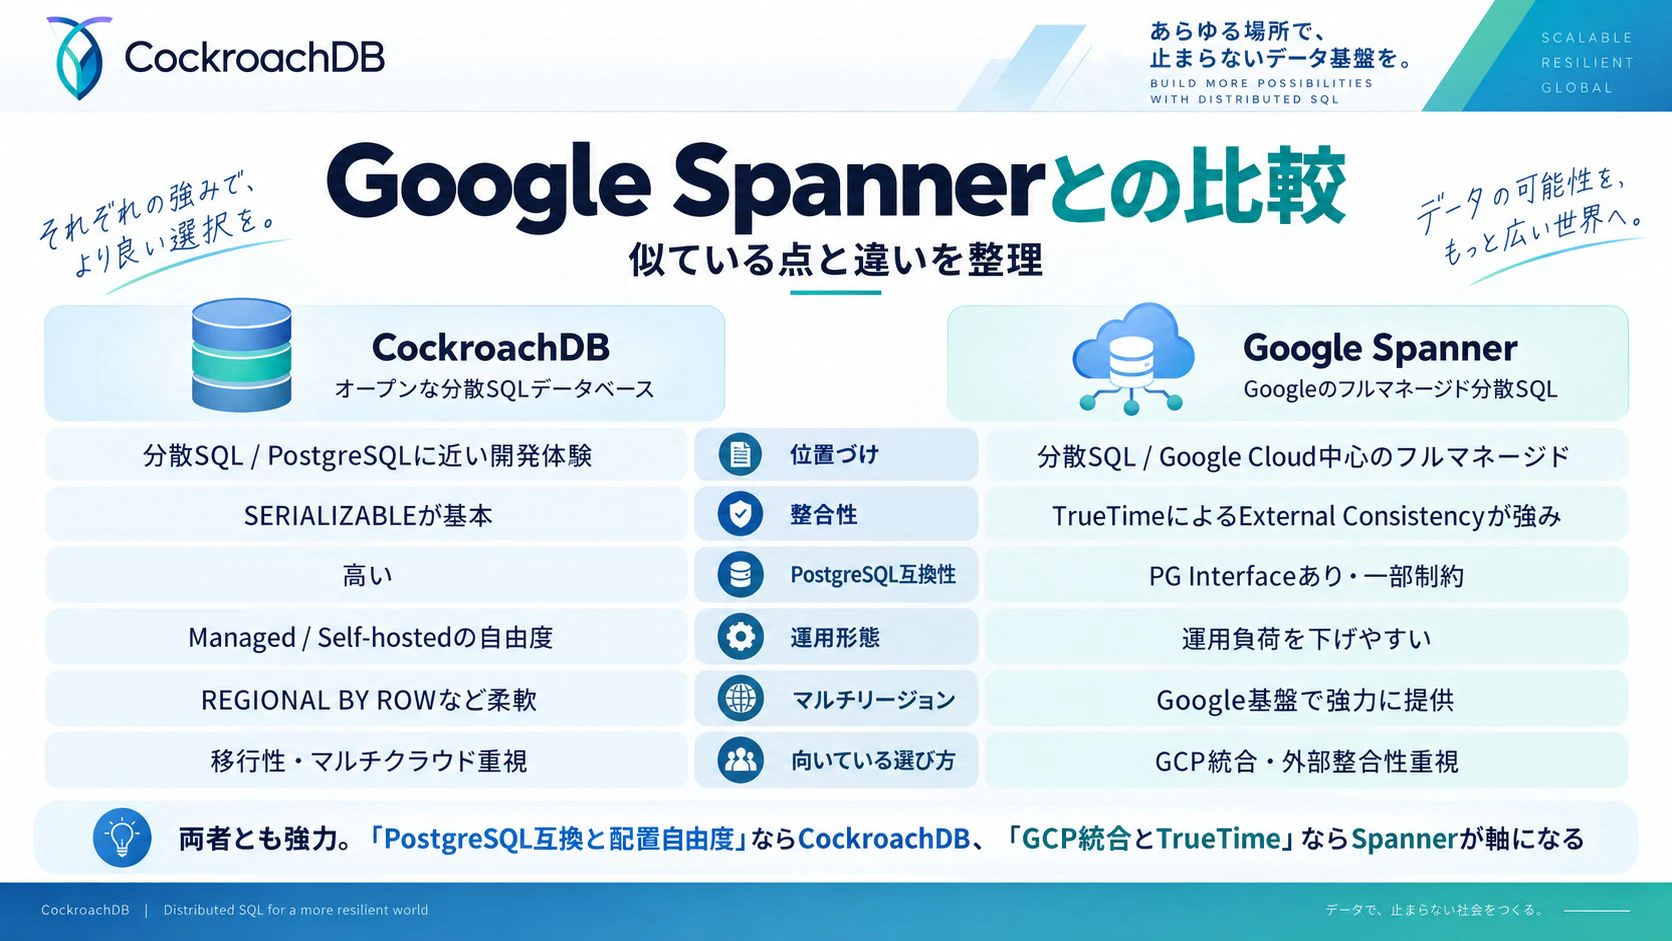
※上記比較図の「オープンな分散SQLデータベース」という表現は、技術的な開放性や配置自由度をイメージした表現です。現在のCockroachDBのライセンス体系は、過去のApache 2.0時代と同一ではないため、「現在も完全なApache 2.0 OSS」という意味ではありません。
CockroachDBを調べると、比較対象としてよく出てくるのが Google Spanner です。
両者は非常によく似た課題を解決しようとしています。
共通する特徴を簡単に整理すると、
| 項目 | CockroachDB | Google Spanner |
|---|---|---|
| 分散SQL | ○ | ○ |
| SQL | ○ | ○ |
| ACID Transaction | ○ | ○ |
| 水平スケール | ○ | ○ |
| Multi-Region | ○ | ○ |
| Strong Consistency | ○ | ○ |
| MVCC | ○ | ○ |
| 自動データ分散 | ○ | ○ |
一方、内部設計や利用体験には重要な違いがあります。
RangeとSplit
CockroachDBではデータを Range に分割します。
CockroachDB

Table
  |
  v
Key-Value
  |
  v
Range
  |
  v
Replica
Spannerにも似た考え方があり、データをキー範囲によって Split に分割します。
Spanner

Table
  |
  v
Key Range
  |
  v
Split
  |
  v
Replica
どちらも、
巨大なデータベースを1台のサーバーに保存するのではなく、小さな単位へ分割して複数サーバーへ配置する
という基本思想は共通しています。
RaftとPaxos
CockroachDBはReplica間のConsensusに Raft を利用します。
CockroachDB
   |
   v
Raft
Spannerでは Paxos系のConsensus が利用されます。
Spanner
   |
   v
Paxos
アルゴリズム自体は異なりますが、
複数Replicaの過半数で合意しながらデータを安全に複製する
という目的は共通しています。
大きな違い1:TrueTime
CockroachDBとSpannerを比較するとき、非常に重要なのが TrueTime です。
SpannerではGoogleインフラが提供する分散ClockであるTrueTimeを利用します。
概念的には、
Google Infrastructure
        |
        v
    TrueTime
        |
        v
     Spanner
        |
        v
Transaction Timestamp
という関係です。
TrueTimeを利用することでSpannerは、SERIALIZABLEなトランザクションに対して External Consistency を提供します。
例えば、
Transaction A
    |
    +---- COMMIT完了

                 Transaction B
                       |
                       +---- START
という順番なら、SpannerはAとBのトランザクション順序にも現実時間上の関係を反映します。
これがSpannerを特徴付ける重要な設計です。
CockroachDBも非常に強い整合性を提供し、デフォルトはSERIALIZABLEですが、SpannerのTrueTimeを利用したExternal Consistencyと内部方式が同一というわけではありません。
大きな違い2:PostgreSQL互換性
CockroachDBはPostgreSQLとの互換性を重要な設計目標にしています。
PostgreSQL Application
        |
        | PostgreSQL Wire Protocol
        v
   CockroachDB
そのため既存のPostgreSQL DriverやORMを利用しやすいのが特徴です。
一方、Spannerにも PostgreSQL Interface があります。
標準的なPostgreSQLクライアントを接続するときには、PGAdapterを利用できます。
Application
    |
PostgreSQL Driver
    |
    v
PGAdapter
    |
    | gRPC
    v
Spanner
つまりSpannerもPostgreSQLに近い開発体験を提供できますが、
CockroachDB
PostgreSQL compatibilityを重要視したDistributed SQL

Spanner
Spannerの基盤上にPostgreSQL Interfaceを提供
という違いがあります。
既存PostgreSQLアプリケーションとの互換性を重視する場合、この差は重要になります。
大きな違い3:配置の自由度
CockroachDBは複数のクラウドやSelf-hostedを含めた配置を選択できます。
イメージとしては、
AWS
 |
 +--- CockroachDB

Google Cloud
 |
 +--- CockroachDB

Azure
 |
 +--- CockroachDB

Self-hosted
 |
 +--- CockroachDB
という考え方ができます。
一方、一般的なGoogle CloudのSpannerは当然ながらGoogle Cloudとの統合が非常に強いサービスです。
Google Cloud
     |
     +-- IAM
     +-- KMS
     +-- BigQuery
     +-- Dataflow
     +-- Monitoring
     |
     +-- Spanner
そのため、
クラウド間のポータビリティを重視するか
それとも、
Google Cloudとの深い統合を重視するか
が選択ポイントになります。
大きな違い4:運用思想
SpannerはGoogle Cloudが提供するフルマネージドサービスです。
ユーザーは、
Infrastructure
Replication
Distributed Database Engine
の詳細な運用をできるだけGoogle側へ任せ、
Schema
Query
Index
Capacity
IAM
Application
へ集中する考え方です。
CockroachDBにもマネージドサービスがありますが、Self-hostedを含め、より幅広い配置方法を選択できます。
つまり、
CockroachDB
    |
    +-- PostgreSQL compatibility
    +-- Deployment flexibility
    +-- Multi-cloud
    +-- Self-hosted option
に対して、
Spanner
    |
    +-- Google Cloud integration
    +-- Fully managed
    +-- TrueTime
    +-- External Consistency
という違いがあります。
CockroachDBとSpannerを整理すると
最後に主要な違いを表にまとめます。
| 観点 | CockroachDB | Google Spanner |
|---|---|---|
| カテゴリ | Distributed SQL | Distributed SQL |
| データ分割 | Range | Split |
| Consensus | Raft | Paxos系 |
| ACID | ○ | ○ |
| MVCC | ○ | ○ |
| 水平スケール | ○ | ○ |
| Multi-Region | ○ | ○ |
| SERIALIZABLE | デフォルト | 対応 |
| External Consistency | Spannerとは方式が異なる | TrueTimeを利用して提供 |
| PostgreSQL互換性 | 高い | PostgreSQL Interface |
| PostgreSQL Wire Protocol | ネイティブに重視 | PGAdapterを利用可能 |
| マルチクラウド | 強い | Google Cloud中心 |
| Self-hosted | 選択可能 | 通常のManaged Spannerではない |
| Google Cloud統合 | 利用可能 | 非常に強い |
| 運用モデル | Managed / Self-hostedなど | Fully Managed中心 |
どちらを選ぶべきか
単純に、
CockroachDB > Spanner
あるいは、
Spanner > CockroachDB
という関係ではありません。
重要なのはシステム要件です。
例えば、
既存PostgreSQL資産
        +
PostgreSQL Driver / ORM
        +
Multi-cloud
        +
配置自由度
を重視するなら、CockroachDBは非常に興味深い選択肢になります。
一方、
Google Cloud中心
        +
運用負荷を減らしたい
        +
TrueTime
        +
External Consistency
        +
GCPサービスとの統合
を重視するなら、Spannerが有力な候補になります。
まとめ
CockroachDBを理解するために最も重要なのは、
「PostgreSQLっぽいSQLデータベース」
として見るだけでなく、
「SQLの下で分散Key-Value StoreとConsensus Algorithmが動いているデータベース」
として理解することだと思います。
CockroachDB内部では、
Application
     |
     v
    SQL
     |
     v
Distributed Transaction
     |
     v
Distributed KV
     |
     v
Range
     |
     v
Replica
     |
     v
Raft
     |
     v
Multiple Nodes
という仕組みが動いています。
この構造によって、
SQL
ACID Transaction
Horizontal Scaling
High Availability
Multi-Region
を同時に実現しようとしています。
特に興味深いのはGoogle Spannerとの比較です。
両者ともDistributed SQLという同じ大きな問題に取り組んでいますが、
CockroachDB
    ↓
PostgreSQL compatibility
Deployment flexibility
Raft
HLC
と、
Google Spanner
    ↓
Google Cloud
Fully Managed
Paxos
TrueTime
External Consistency
という異なるアプローチを採用しています。
分散データベースを学ぶという意味でも、CockroachDBとSpannerを並べて理解すると、
- Consensus
- MVCC
- Distributed Transaction
- Data Partitioning
- Replication
- Clock
- Consistency
- Geo Distribution
といったDistributed Databaseの重要な概念がかなり見えやすくなります。
CockroachDBは単なる「PostgreSQLの代替」というより、
RDBMSの使いやすさをできるだけ保ちながら、分散システムのスケーラビリティと可用性を組み合わせようとしたデータベース
として捉えると理解しやすいと思います。
参考資料
本記事の内容をさらに詳しく確認したい場合は、以下の公式ドキュメントを参照してください。
- CockroachDB Documentation - Architecture Overview
- CockroachDB Documentation - Developer Basics
- CockroachDB Documentation - Transaction Layer
- CockroachDB Documentation - Multi-Region Overview
- CockroachDB Documentation - PostgreSQL Compatibility
- Google Cloud Documentation - Spanner: TrueTime and External Consistency
- Google Cloud Documentation - PostgreSQL Interface
- Google Cloud Documentation - PGAdapter Overview