
Google が 11 月 11 日に、判断専用のモデル Gemini Decision 1 を出しました。文章を生成せず、確率つきの回答だけを返すモデルで、TypeSafe AI の Jev、Liquid AI の d1、OpenAI の Decisions API(GPT-6 Luna)と同じ種類です。本作業の大半を Claude Code で実行・文書化したものです。何を測るかの判断と、結果の読み取りは筆者が行いました。
これまでの記事と同じ 3 つの日本語ベンチマークで、同じ項目を、同じ形の要求で測りました。測定は公開の翌日の 11 月 12 日です。比べる相手は、判断専用の API だけではありません。これまでに同じ条件で測ってきた、普通の LLM(Gemini 3.x と GPT-5.6 の 6 種)、学習させた BERT 系の小型モデル(ModernBERT-Ja)、手元で動かす公開の重み(d1-3B、Jeff など)も並べて、全部で 16 モデルです。
課題によって順位が入れ替わりました。記事のカテゴリ分類(ライブドア)では、判断専用の API の中で最も高く、Gemini の軽量 2 モデルと GPT-5.6 も上回りました。ただ、Gemini の上位 2 モデルと、学習させた BERT には届きません。2 つの文の関係を選ぶ課題(JNLI)では、Jev と d1 に届きませんでした。常識を問う 5 択(JCommonsenseQA)は、LLM も含めてほぼ差がありません。応答時間は、判断専用の API と同じ桁で、LLM より短い結果でした。
Gemini Decision 1 とは
Google のブログ(2026-11-11)に書かれていることを、先にまとめます。
- 新しい API の入口 Gemini Decisions API で使うモデルで、モデル名は gemini-decision-1 です。
- 入力はテキスト、画像、音声、動画、PDF で、上限は 256K トークンです。1 回の要求に最大 1,000 個の質問を付けられます。
- 質問の型は、はい/いいえ(noul)、選択式(choice)、段階評価(score)の 3 つです。選択肢は 2 から 255 個です。
- 回答を文章として生成するのではなく、候補を 1 回の計算で採点します。各回答に、0 から 1 の信頼度が付きます。
- 料金は入力が 100 万トークンあたり 0.10 ドルで、出力は 0 ドルです。応答の速さは、端から端まで 150〜250 ミリ秒と書かれています。
- Google AI Studio で試せます。Google Cloud(Vertex AI を含む可能性があります)への対応は、「近日」とだけ書かれています。
私が確かめた範囲では、11 月 12 日の時点で、Vertex AI の公開モデルの一覧(Google のモデル 34 件)に Gemini Decision 1 は載っていませんでした。
ブログがベンチマークの比較相手に挙げているのは Gemini 3.5 Flash-Lite で、Jev の名前は出てきません。比較の数値も、本文には書かれていません。
測ったもの
| ベンチ | 内容 | 件数 | 偶然の正解率 |
|---|---|---|---|
| JNLI | 2 つの文の関係(含意・矛盾・中立)を選ぶ | 500 | 33% |
| JCommonsenseQA | 常識を問う 5 択 | 500 | 20% |
| ライブドアニュース分類 | 記事のカテゴリを 9 つから選ぶ | 7,367(全件) | 11% |
JNLI と JCommonsenseQA は JGLUE の検証セットから無作為に 500 件ずつ、ライブドアは全件です。これまでの記事と同じ項目を、同じ順で測りました。
Gemini Decision 1 には、判定対象を「項目名: 内容」の形で改行でつないだ文字列にして input に渡し、質問は選択式の 1 問にしました。選択肢には説明文を付けています。JCommonsenseQA は、選択肢の文そのものが選択肢です。1 回の要求に 1 件だけ入れました。無料枠で、JNLI と JCommonsenseQA は並列 1、ライブドアは並列 2 で、要求の間隔を 1.7 秒以上空けて送っています。応答時間は、他のモデルと同じ項目(JNLI の先頭 100 件と、ライブドアからカテゴリごとに 11 件ずつの 99 件)を、同時実行なしで 1 件ずつ送って測りました。
ほかのモデルは、10 月 1 日から 16 日にかけて測った値で、その後のモデルの更新は反映していません。LLM は、思考の設定を切った条件です。
1 件だけ、Google の側で入力が拒否されました。ライブドアの topic-news の記事 1 件で、「禁止された利用の方針に反する語を含む」というエラーで、答えが返りませんでした。この件は不正解に数えています。
結果
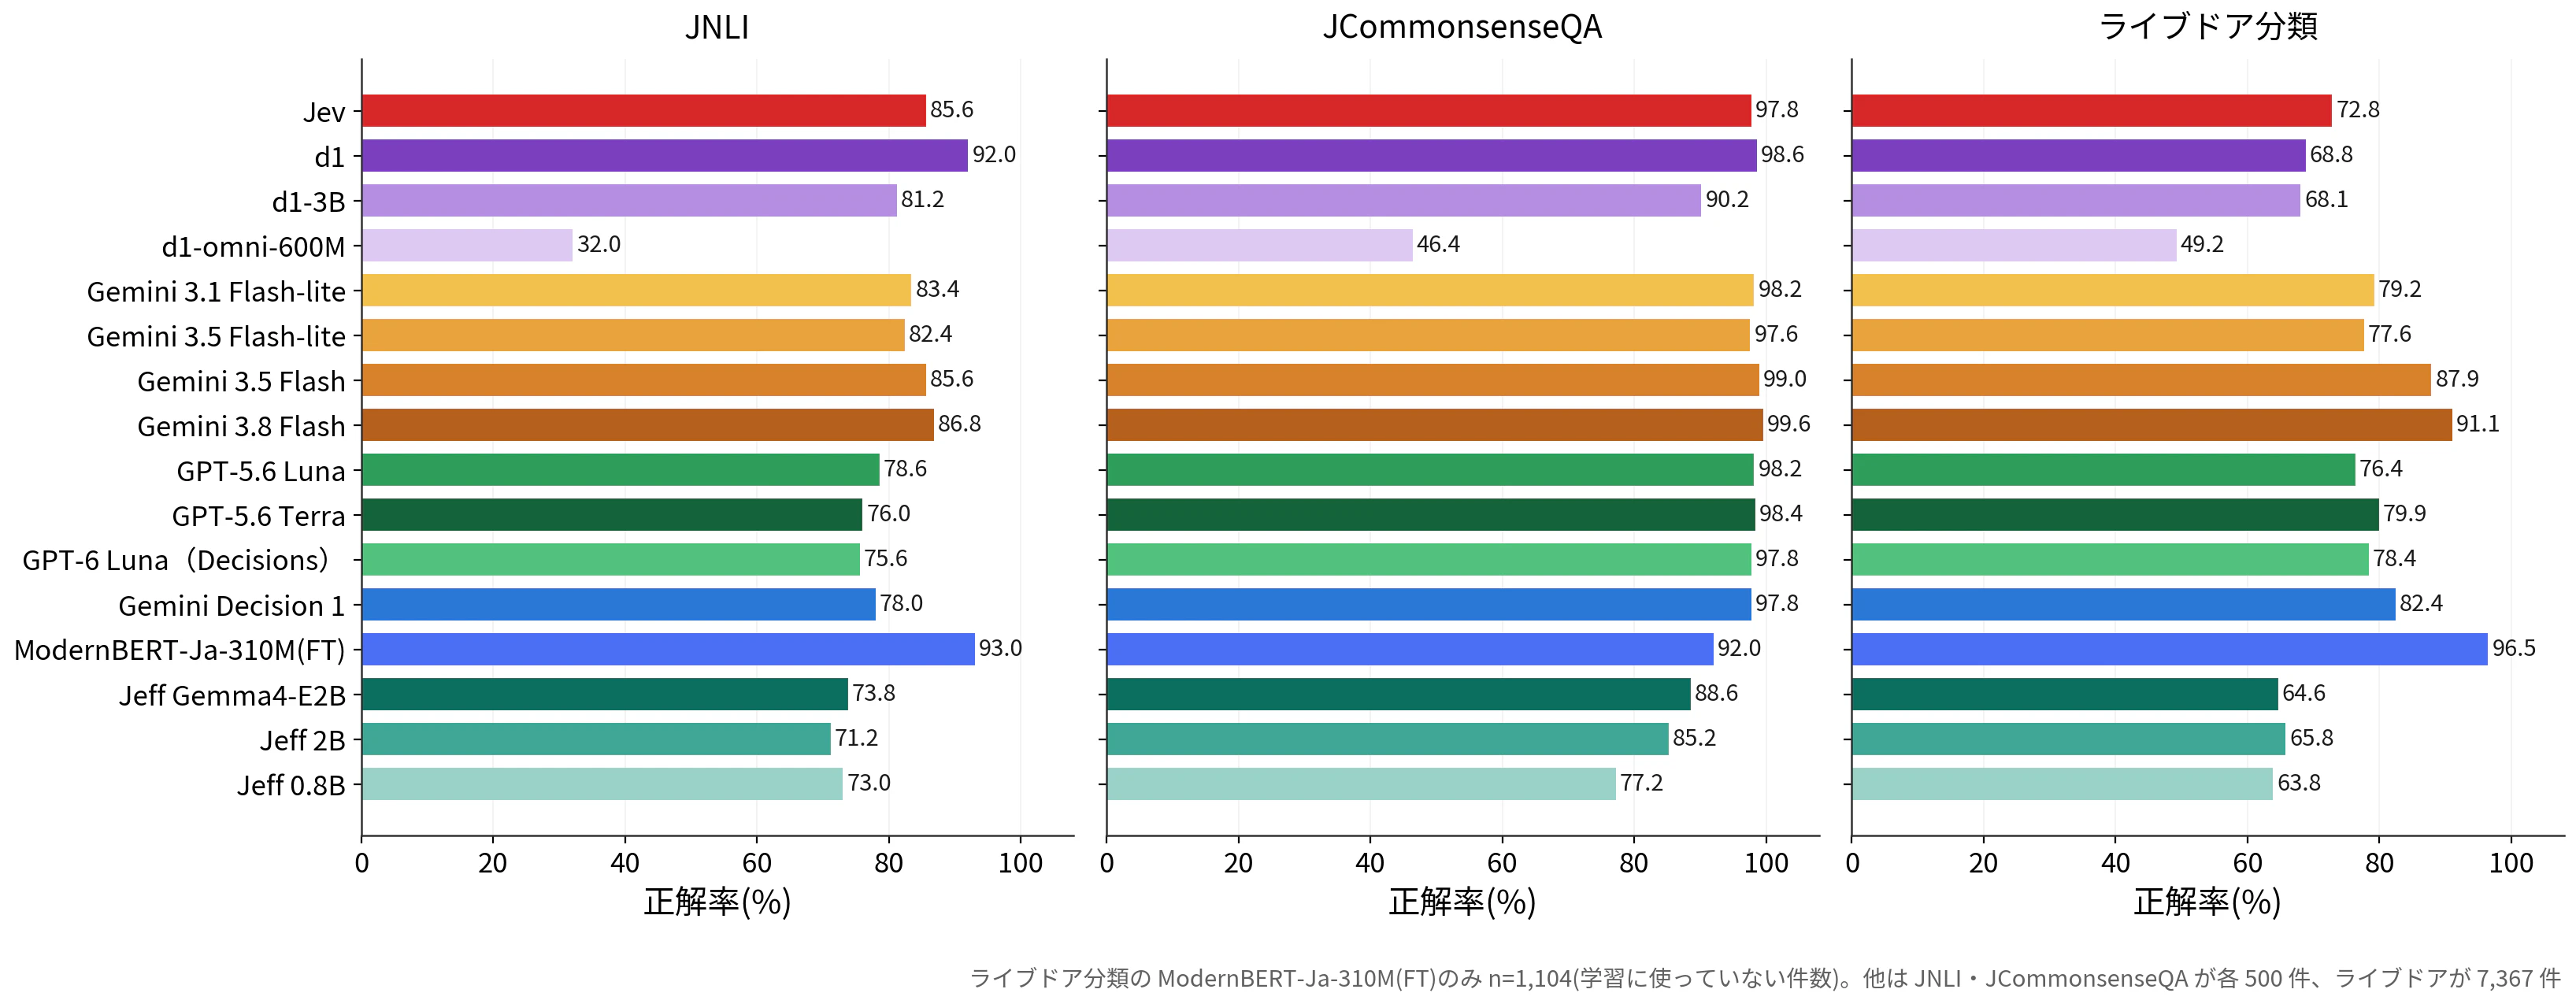
表の数字は、正解率(%)、応答時間の中央値(ミリ秒、JNLI/ライブドア)、1,000 件あたりの費用(ドル、JNLI/ライブドア)です。「—」は、無料枠で価格が未発表のもの(d1)と、手元で動かすもの、課金のないものです。
| モデル | JNLI | JCommonsenseQA | ライブドア | 平均 | 応答時間 | 費用 |
|---|---|---|---|---|---|---|
| 判断専用の API | ||||||
| Gemini Decision 1 | 78.0 | 97.8 | 82.4 | 86.1 | 259/368 | 0.017/0.096 |
| Jev | 85.6 | 97.8 | 72.8 | 85.4 | 200/197 | 0.018/0.075 |
| d1 | 92.0 | 98.6 | 68.8 | 86.5 | 404/398 | — |
| GPT-6 Luna (Decisions) | 75.6 | 97.8 | 78.4 | 83.9 | 220/218 | 0.021/0.120 |
| 汎用の LLM(思考を切った設定) | ||||||
| Gemini 3.8 Flash | 86.8 | 99.6 | 91.1 | 92.5 | 2446/1705 | 0.610/0.789 |
| Gemini 3.5 Flash | 85.6 | 99.0 | 87.9 | 90.8 | 1325/3010 | 0.303/1.560 |
| Gemini 3.1 Flash-lite | 83.4 | 98.2 | 79.2 | 86.9 | 925/1098 | 0.054/0.266 |
| Gemini 3.5 Flash-lite | 82.4 | 97.6 | 77.6 | 85.9 | 818/888 | 0.073/0.328 |
| GPT-5.6 Terra | 76.0 | 98.4 | 79.9 | 84.8 | 1039/996 | 0.469/2.509 |
| GPT-5.6 Luna | 78.6 | 98.2 | 76.4 | 84.4 | 843/869 | 0.047/0.251 |
| 手元で動かすもの、学習させたもの | ||||||
| ModernBERT-Ja-310M(FT) | 93.0 | 92.0 | 96.5 | 93.8 | 0.2/0.7 | — |
| d1-3B | 81.2 | 90.2 | 68.1 | 79.8 | 16/57 | — |
| Jeff Gemma4-E2B | 73.8 | 88.6 | 64.6 | 75.7 | 21/62 | — |
| Jeff 2B | 71.2 | 85.2 | 65.8 | 74.1 | 18/44 | — |
| Jeff 0.8B | 73.0 | 77.2 | 63.8 | 71.3 | 18/27 | — |
| d1-omni-600M | 32.0 | 46.4 | 49.2 | 42.5 | 5/13 | — |
ModernBERT-Ja-310M は、課題ごとに学習データで学習させたモデルで、ライブドアは学習に使っていない 1,104 件で測りました。Gemini 3.8 Flash は、思考の予算を 0 にしても思考が残ります。
Gemini Decision 1 は、3 ベンチの平均が 86.1% で、判断専用の API の中では d1(86.5%)に次ぎ、Jev(85.4%)より高い位置です。普通の LLM と並べると、Gemini の軽量 2 モデル(85.9%、86.9%)と同じ帯で、Gemini 3.5 Flash(90.8%)と 3.8 Flash(92.5%)には届きません。学習させた ModernBERT-Ja-310M(93.8%)が、全体で最も高い結果です。
内訳は課題で分かれます。JNLI の 78.0% は、GPT-5.6 の Luna(78.6%)と Terra(76.0%)と同じ帯で、Gemini の軽量 2 モデル(83.4%、82.4%)より低い値です。JCommonsenseQA は、判断専用の API 4 つが 97.8〜98.6%、LLM が 97.6〜99.6% で、差が小さい課題でした。ライブドアは、82.4% で、GPT-5.6(76.4%、79.9%)と Gemini の軽量 2 モデル(79.2%、77.6%)を上回ります。Gemini 3.5 Flash(87.9%)と 3.8 Flash(91.1%)、ModernBERT(96.5%)には届きません。
同じ項目で、Jev と OpenAI の Decisions API と、対応のある符号検定をしました。Gemini Decision 1 だけが正解した項目と、相手だけが正解した項目の数を比べています。ライブドアは、拒否された 1 件を不正解に数えた 7,367 件です。
| 相手 | JNLI | JCommonsenseQA | ライブドア |
|---|---|---|---|
| Jev | 21 対 59(p=2.5e-05) | 6 対 6(p=1) | 817 対 108(p=2e-135) |
| GPT-6 Luna(Decisions) | 49 対 37(p=0.24) | 5 対 5(p=1) | 437 対 138(p=4e-37) |
数の左が Gemini Decision 1 のみ正解、右が相手のみ正解の項目数です。ライブドアは Gemini Decision 1 が、JNLI は Jev が、どちらも偶然とは考えにくい差で上でした。OpenAI の Decisions API とは、ライブドアだけに有意な差があります。
ライブドアの内訳
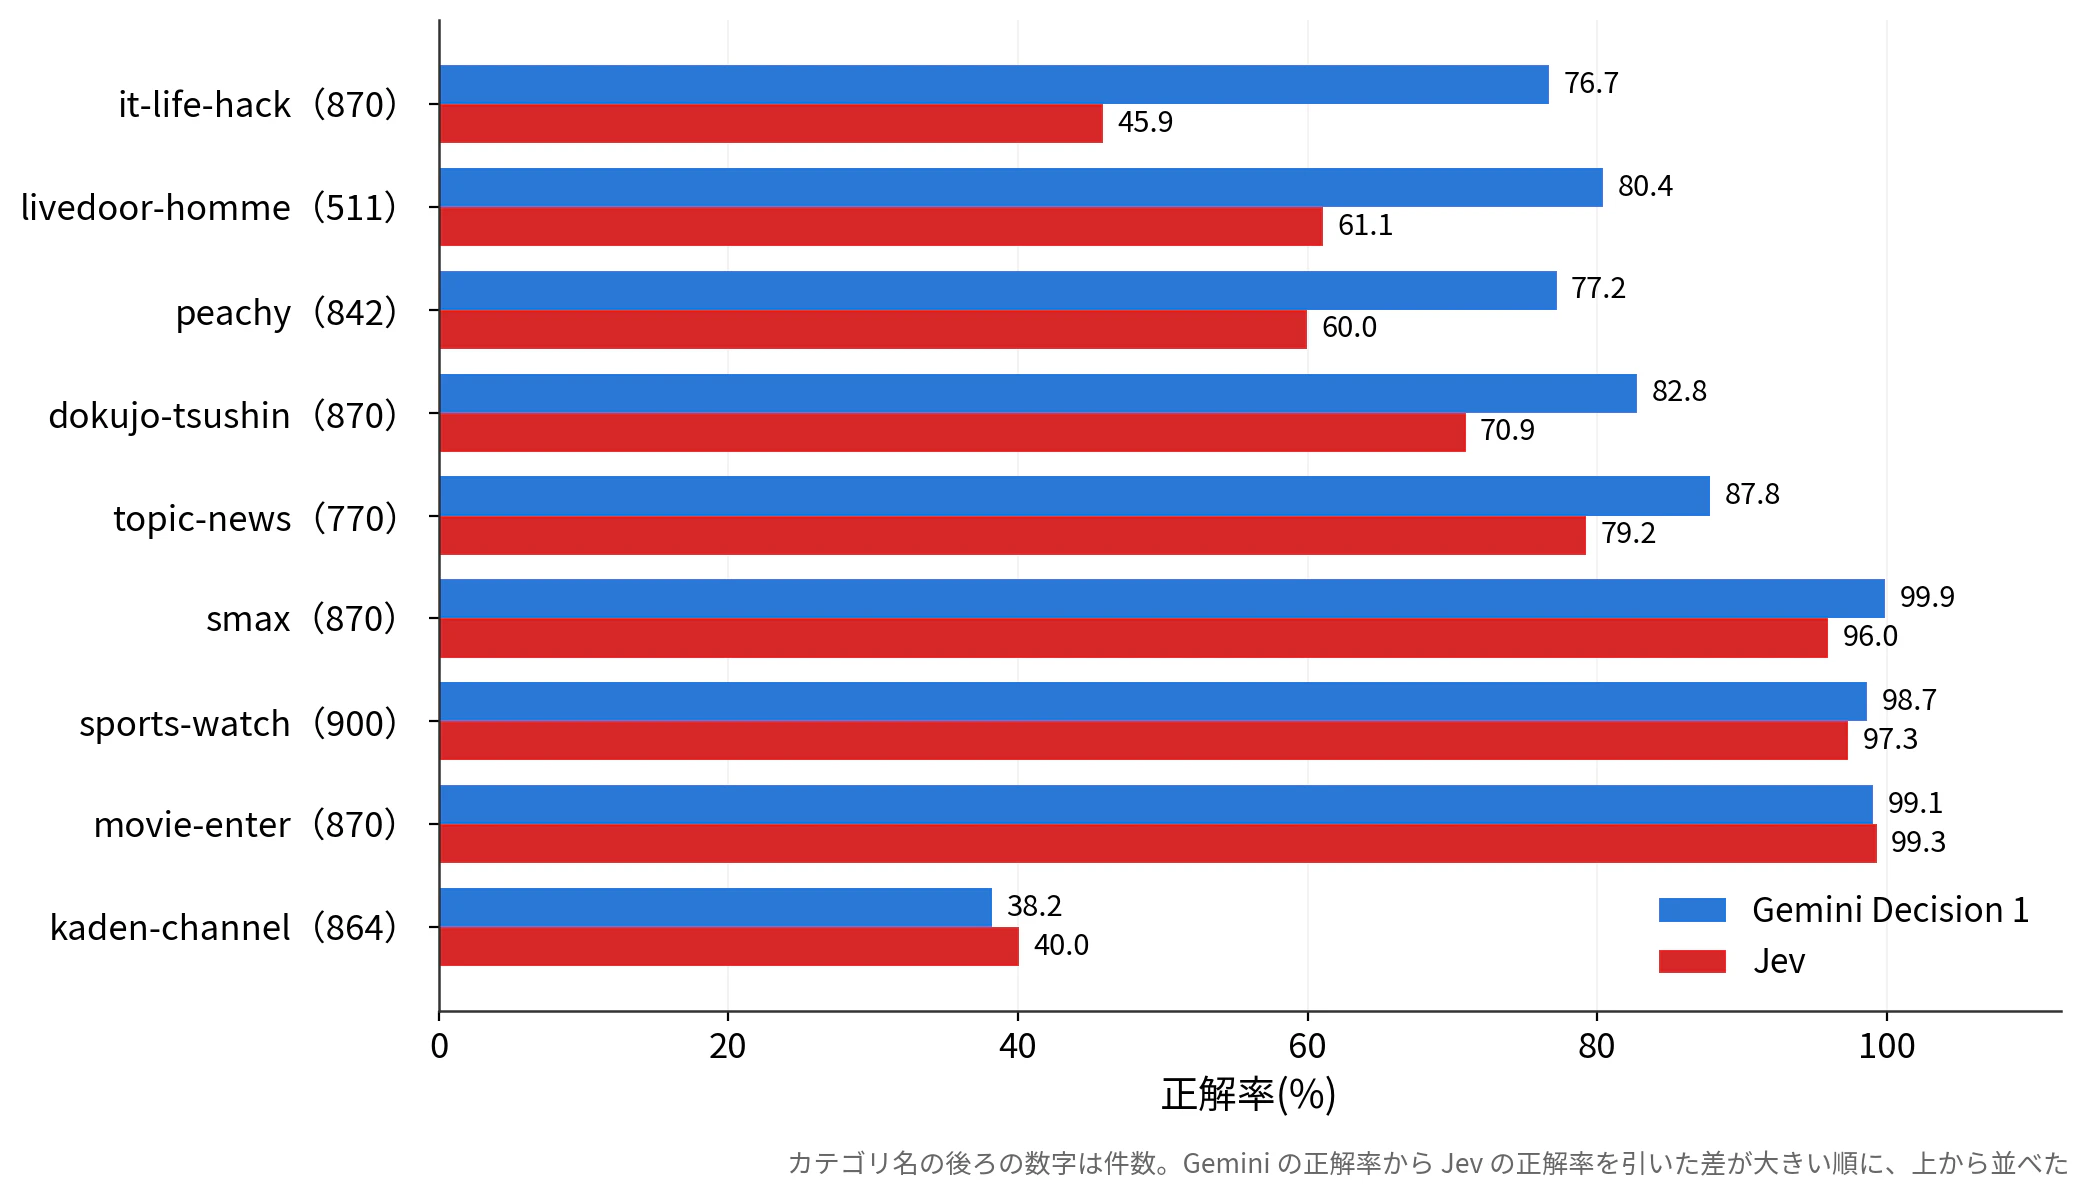
Jev との差の大半は、3 つのカテゴリで生まれています。it-life-hack は Gemini が 76.7%、Jev が 45.9% で、差は約 31 ポイントです。livedoor-homme は約 19 ポイント、peachy は約 17 ポイント、Gemini が上でした。
元から 99% 近い movie-enter、sports-watch、smax は、ほとんど差がありません。kaden-channel は、どちらも 4 割前後でした(Gemini 38.2%、Jev 40.0%)。取り違えの先は、どちらも topic-news が最も多く、Gemini は it-life-hack にも 150 件流れています。
kaden-channel は、記事の内容が it-life-hack や topic-news と重なりやすいカテゴリです。これは私の見立てで、確かめてはいません。カテゴリの境があいまいな課題での差は、判断の精度の差と、そのまま読めない可能性があります。
JNLI の内訳
JNLI での差は、取り違え方に出ています。
- 矛盾を中立と答える誤りが、Gemini は 63 件、Jev は 47 件でした。どちらも最大の誤りです。
- 中立を含意と答える誤りが、Gemini は 30 件、Jev は 7 件でした。これが、Gemini が Jev を下回った主な差です。
速さと費用

応答時間の中央値は、JNLI で 259 ミリ秒、ライブドアで 368 ミリ秒でした(p95 は 530 と 639 ミリ秒)。Jev(200、197 ミリ秒)の 1.3〜1.9 倍、OpenAI の Decisions API(220、218 ミリ秒)の 1.2〜1.7 倍で、0.8〜3.0 秒かかる Gemini と GPT-5.6 の LLM よりは短い値です。Google が書く 150〜250 ミリ秒より長いですが、測定の環境が違うので、直接は比べられません。要求の間隔を空けて送っている点にも注意してください。
3 本の測定で、Gemini Decision 1 に送った入力は合計で 7,201,249 トークンでした。ライブドアが 7,049,187、JNLI が 85,233、JCommonsenseQA が 66,829 です。定価の 100 万トークンあたり 0.10 ドルで計算すると約 0.72 ドルになります。実際は無料枠で測ったので、支払いは 0 円でした。1,000 件あたりでは、JNLI が 0.017 ドル、ライブドアが 0.096 ドルで、Jev(0.018 ドルと 0.075 ドル)と同じ桁です。Gemini 3.5 Flash や GPT-5.6 Terra のような LLM は、1,000 件あたり 0.3〜2.5 ドルかかっています(JNLI とライブドアの範囲)。
ライブドア全件は、要求の間隔を空けたため、約 3 時間半(12,548 秒)かかりました。間隔は、無料枠の 1 分あたりの上限に当たらないよう、保守的に決めたもので、上限の値そのものは確かめていません。
測れていないこと
- 各 1 回の測定で、同じ入力の繰り返しでの揺れは見ていません。
- ほかのモデルとは、測った日が違います。Jev と d1 は 10 月 1 日、OpenAI の Decisions API は 10 月 16 日、Gemini Decision 1 は 11 月 12 日です。その間のモデルの更新は反映していません。
- Google 自身が示したベンチマークは、数値が本文に無く、再現できていません。
- 画像、音声、段階評価、1 回の要求に複数の質問を付けた場合の挙動は測っていません。
- ライブドアのカテゴリの境があいまいなため、分類の正解率は、判断の精度の上限を表しているとは限りません。
参考
- Google のブログ「Gemini Decisions API」(2026-11-11): https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/