
この記事は、Claude Code(Anthropic の AI コーディングツール)と一緒に実験して書きました。生成の実行、測定のスクリプト、比較図の作成は Claude Code が行い、何を測るかの選定と、映像の良し悪しの判定は私が行っています。判定はすべて、私が目で見て決めました。時間は、生成のたびに残した実行記録のファイルから転記した値です。
動画生成をやっている方には、当たり前かもしれません。私も測ってみた、という記録です。
先に結論

- 補助重みなしの 20 ステップが 626.6 秒でした。これに対して、いちばん速かった TaoMate の 3 ステップは 86.4 秒で、7.3 倍です。私の目では、映像も問題ありませんでした。
- カットなしで続きを作る場合(前のクリップの最後の 5 コマを固定)も、831.1 秒が 100.6 秒(8.3 倍)になり、自然に見えました。
- 私の実験環境で既定にしていた補助重み(ckpt850 の 4 ステップ)は、141.5 秒(4.4 倍)と速いものの、この場面では映像がにじんで使えませんでした。
- EasyCache は、補助重みなしの 20 ステップで 1.9 倍になり、構図は変わりませんでした。SageAttention は 2.0 倍ですが、構図や人物が別のものになりました。
試したのは 1 つの場面で、乱数種も 1 つです。倍率は私の環境での値で、他の環境にそのまま当てはまるとは限りません。理由は、後の節に書きました。
用語
| 語 | 意味 |
|---|---|
| MiniMax H3 | 動画と音声を一緒に作る、330 億パラメータのモデル。重みが公開されています |
| ステップ | 映像を少しずつ仕上げていくサンプリングの回数。少ないほど速くなります |
| 補助重み(蒸留 LoRA) | 少ないステップでも映像が崩れないように学習した、追加の重み。LoRA は、本体に重ねて使う小さな追加の重みのことです |
| 乱数種(seed) | 生成に使う乱数の初期値。同じ文面でも、乱数種が違うと別の動画になります |
| EasyCache | 似たステップの出力を再利用して、計算を飛ばす仕組み。ComfyUI の本体に入っています |
| SageAttention | 画面の各部分の関係を計算する部分(attention)を、速くするライブラリ |
| ComfyUI | ノードをつないで生成の手順を組む実行環境。0.33.0 を使いました |
測った環境と場面
- GPU は RTX 4080(16GB)の 1 枚で、ホストメモリは 125GB です。ComfyUI は
--lowvramで動かしました。使い終わった重みを都度メモリへ逃がすので、重みの転送が生成の時間に入ります。 - 重みは、刈り込み(pruned)版の fp8 です。テキストエンコーダは 4 ビットの nvfp4 で、RTX 4080 では模擬実行になります。
- 場面は、アメリカンダイナーでウェイトレスが配膳する、文章だけからの生成です。832×480、192 コマ(8 秒)、乱数種 101、音声なしで揃えました。
- 測定は、1 条件につき 1 回です。同じ条件の繰り返しは測っていないので、測るたびの時間のばらつきは分かりません。
結果
倍率は、補助重みなしの 20 ステップ(626.6 秒)との比です。映像の判定は、私の目視です。
| 条件 | 所要時間 | 倍率 | 私の判定 |
|---|---|---|---|
| 基準(補助重みなし、20 ステップ) | 626.6 秒 | 1.0 | (基準) |
| ckpt850 の 4 ステップ | 141.5 秒 | 4.4 | 完全に NG(にじみ、二重像) |
| ckpt850 の 6 ステップ | 160.4 秒 | 3.9 | NG(ノイズが入る) |
| ckpt850 の 8 ステップ | 196.4 秒 | 3.2 | 悪くない |
| lightx2v の 4 ステップ | 176.6 秒 | 3.5 | 悪くない |
| Turbo v4 の 8 ステップ | 151.8 秒 | 4.1 | OK |
| TaoMate の 3 ステップ | 86.4 秒 | 7.3 | OK |
| FastH3 の 8 ステップ(別の重み) | 221.5 秒 | 2.8 | OK |
| 基準に EasyCache | 336.0 秒 | 1.9 | 問題ない |
| 基準に EasyCache(終了位置 0.95) | 242.2 秒 | 2.6 | OK |
| ckpt850 の 8 ステップに EasyCache | 170.1 秒 | 3.7 | 問題ない |
| lightx2v の 4 ステップに EasyCache | 107.0 秒 | 5.9 | OK |
| 基準に SageAttention | 316.7 秒 | 2.0 | 問題ない |
| ckpt850 の 8 ステップに SageAttention | 140.1 秒 | 4.5 | 問題ない |
| ckpt850 の 8 ステップで、テキストエンコーダを int8 に | 170.7 秒 | 3.7 | OK |
補助重みは、種類ごとに、重みの強さやサンプラーなどの組み合わせが決まっています。それぞれの推奨の設定のまま使ったので、比べているのは、その組み合わせ全体です。
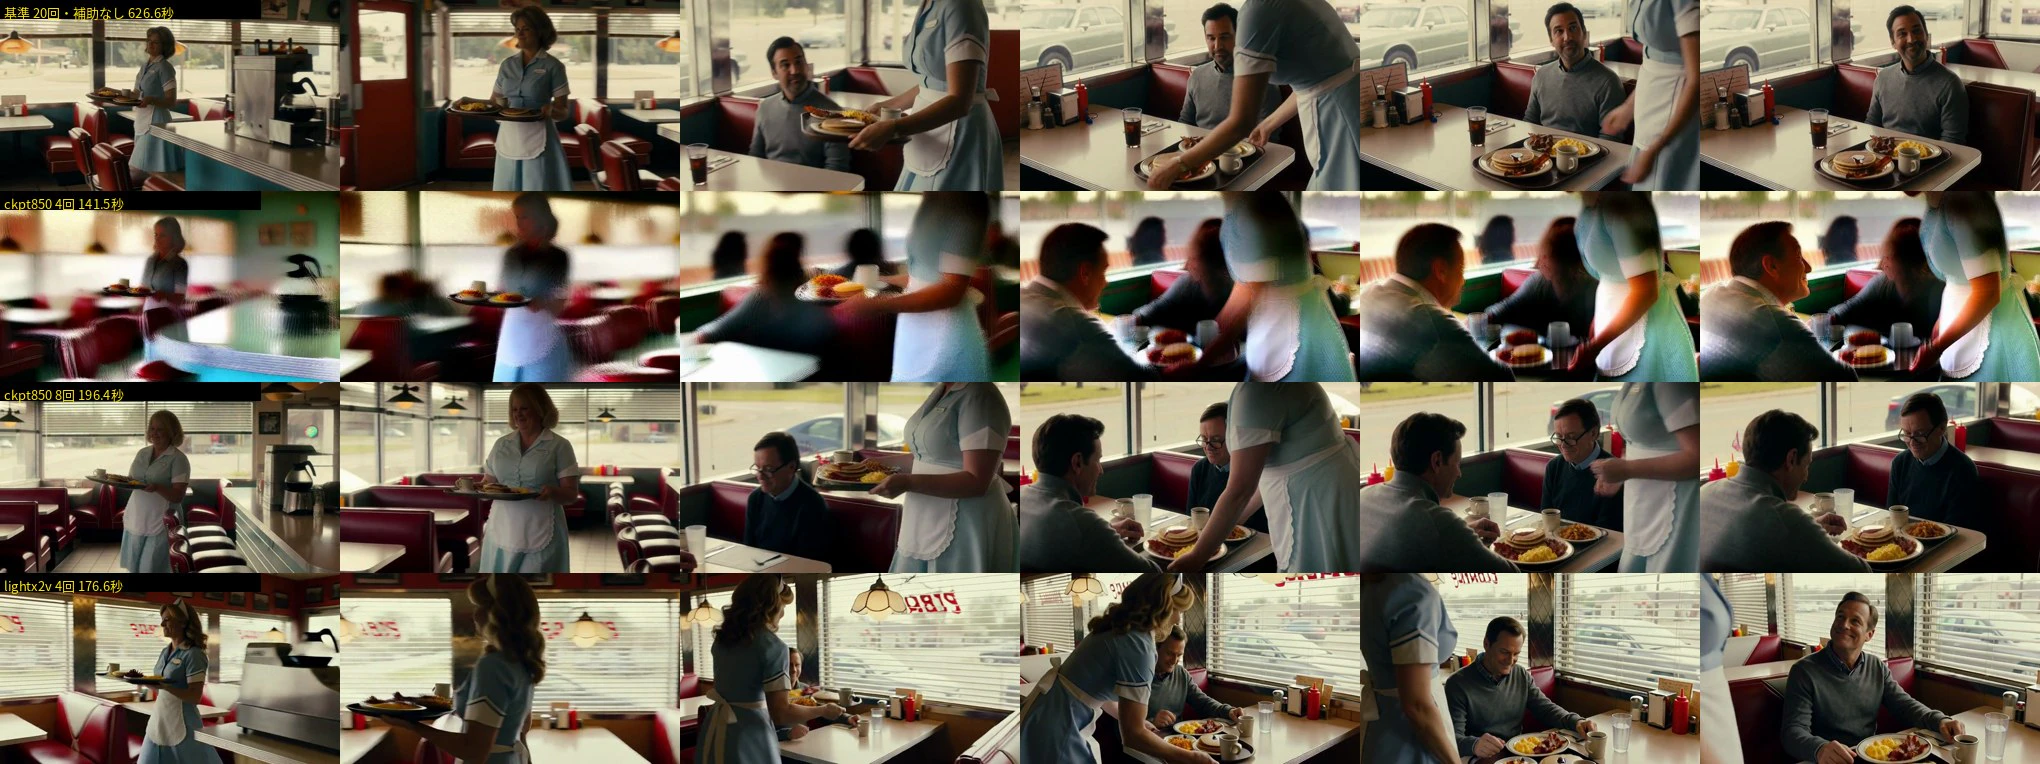
補助重みの結果
ステップ数を減らす補助重みは、いちばん大きく効きました。
TaoMate-H3 は、Alibaba の TaoLive AIGC が公開した 3 ステップ用の LoRA で、ComfyUI 用に変換された版を使いました。強度 1.0、サンプラーは euler、スケジューラは simple で、3 ステップの生成が 86.4 秒でした。
ckpt850 は、larryvrh の Turbo LoRA の系統のものです。配布されているファイルと同じものかは、確認していません。4 ステップではにじみ、6 ステップでもノイズが残りました。8 ステップにして、悪くない映像になりました。
補助重みを替えると、同じ乱数種でも、構図と人物が別のものになりました。速さは比べられますが、映像の良し悪しは、1 本ずつ目で見るしかありません。
私の実験環境で既定にしていた ckpt850 の 4 ステップは、別の条件(544×736、先頭のコマを指定する方式、124 コマ)で測って決めたものでした。今回の 832×480、文章のみ、192 コマという条件では、使えませんでした。
EasyCache — 絵を保ったままの高速化
EasyCache は、似たステップの出力を再利用して、計算を飛ばします。ComfyUI の本体にノード(EasyCache)があります。設定は、再利用のしきい値を 0.2、開始位置を 0.15、終了位置を 0.70 にしました。開始と終了は、全ステップのうち何割目から何割目までを、再利用の対象にするかを表します。

構図、人物、料理の位置は、EasyCache を掛けない版とほぼ同じでした。補助重みを替えたときのように、別のものにはなりません。
補助重みなしの 20 ステップでは 1.9 倍になりました。ただ、ステップが少ないほど飛ばせる回が減るので、8 ステップでは 1.15 倍に下がり、TaoMate の 3 ステップでは 1.00 倍で、速くなりませんでした。
終了位置を 0.95 まで延ばすと、終盤に格子状の模様が出るという報告があります。この場面では、模様は気にならず OK でした(2.6 倍)。
SageAttention — 速さと引き換えに変わる構図と人物
SageAttention は、pip で環境に入れ、ComfyUI を --use-sage-attention で起動し直すと使えます。私の環境にはコンパイラ(nvcc)が無かったので、triton で動く 1.0.6 版を入れました。

補助重みなしの 20 ステップで 2.0 倍、ckpt850 の 8 ステップで 1.4 倍でした。構図や人物は別のものになりましたが、映像の質は、私の目で問題ありませんでした。同じ乱数種で同じ絵を作り直したいときは、この点に注意が要ります。
動かなかったもの
comfy-kitchen の INT8 attention(ComfyUI 本体の ModelAttentionBackend ノード)は、「CUDA driver version is insufficient for CUDA runtime version」というエラーで落ちました。私の環境のドライバは 570 で、CUDA 12.8 までしか対応していません。参考にした記事は RTX 5090 での測定で、新しいドライバの環境を想定しているようでした。
FastH3 の 8 ステップは、配布元の FastVideo が、専用の注意の仕組み(VSA)を前提にしています。ComfyUI にはそれが無いので、配布元と同じ条件では動かせていません。表の FastH3 は、別の重みとして測っただけです。
カットなしの続きでの確認
別の記事に書いた、前のクリップの最後の 5 コマを先頭に固定して続ける方式でも、速い設定が使えるかを測りました。
| 条件 | 所要時間 | 基準(831.1 秒)との比 | 私の判定 |
|---|---|---|---|
| ckpt850 の 8 ステップ | 201.0 秒 | 4.1 | 自然で OK |
| TaoMate の 3 ステップ | 100.6 秒 | 8.3 | 自然で OK |
| lightx2v の 4 ステップに EasyCache | 121.2 秒 | 6.9 | 自然で OK |
前のコマを固定するので、補助重みで構図が変わる心配は、あまりありませんでした。

倍率が大きく出た理由と、他の測定との比較
参考にした記事(松尾公也さん、techno-edge.net、2026 年 9 月 6 日、RTX 5090 での測定。測定の記録は GitHub)では、20 ステップで約 270 秒かかっていた生成が、補助重みと INT8 attention などで 79 秒になっています(約 3.4 倍)。私の環境では、626.6 秒が 86.4 秒になり、倍率は 7.3 倍と大きく出ました。
ただし、解像度、コマ数、場面が違うので、倍率どうしは比べられません。私の環境は、--lowvram で重みを都度転送するため、基準が遅く出ています。ステップを減らすと転送の回数も減るので、倍率が大きくなったと考えています。絶対の時間で見ると、私の 86.4 秒は、記事の 79 秒に近い値です。
限界
- 試したのは、1 つの場面、1 つの乱数種、1 つの解像度です。
- 判定は、私一人の目視です。
- 測定は 1 条件につき 1 回で、繰り返しがありません。時間は、他の利用者もいる共有の機械での値なので、ばらつきが入っている可能性があります。実際、TaoMate の 3 ステップに EasyCache、テキストエンコーダ int8、SageAttention を重ねた 6 本の追加測定では、ほかの条件が 76〜90 秒だったのに、テキストエンコーダ int8 を足した 3 本は、100.8 秒、86.3 秒、130.5 秒とばらつきました。
私が使うことにした設定
速く生成するときは、TaoMate の 3 ステップだけを使うことにしました(強度 1.0、euler、simple)。EasyCache などを重ねても、速さの得は最大で 1.14 倍と小さかったためです。
追記の予定
- 同じ条件の繰り返しを測って、ばらつきを見ます。
- 別の場面と乱数種で確かめます。
参考
- MiniMax H3(MiniMaxAI、Hugging Face): 元のモデルと、配布元のライセンス
- ComfyUI: 実行環境。EasyCache のノードは nodes_easycache.py
- SageAttention と、triton 版の PyPI のページ
- TaoMate-H3(TaoLiveAIGC) と、ComfyUI 用に変換した版(CZMartin22)
- FastH3 8-Step V2(FastVideo) と、FastVideo のリポジトリ
- lightx2v の H3 用 Turbo LoRA、larryvrh の Turbo LoRA
- MiniMax H3 を 4 分 30 秒から 79 秒に縮めた記録(松尾公也さん、techno-edge.net)と、その測定の記録(GitHub)
- 同じ場面で人物を保つ方法は、別の記事にまとめた。