
この記事の調査と下書きは Claude Code(Claude)で行いました。講演の内容を整理したもので、数字や製品名は講演者の発言です。第三者による検証はしていません。名称の表記に確信が持てない箇所は、その旨を書き添えました。
用語
| 語 | この記事での意味 |
|---|---|
| AI Factory | 電力、計算機、ネットワーク、冷却を一体で作り、モデルを動かしてトークンを生産する施設 |
| トークン | 言語モデルが入出力で扱う文字の単位。講演では AI の生産物の単位として使われた |
| ハーネス | エージェントのモデルを包んで動かす部分。作業の段取り、記憶の管理、道具の呼び出しを担う |
| サンドボックス | エージェントを閉じ込める隔離環境。外へ出られる範囲を制限する |
| OpenShell と Sentry | エージェントの権限を外側から制限する NVIDIA の安全の仕組み。OpenShell は通信を方針で制御する隔離環境で、Sentry はそれに任意で加える監視の層(エージェントとは別のハードウェア上で動く) |
| CUDA | NVIDIA の GPU で計算を並列に動かすための、プログラムの仕組み(開発環境) |
| Physical AI | 現実の世界を認識し、推論して動く AI。自動運転やロボットを指す |
講演の位置づけ
NVIDIA の YouTube チャンネルで 2026-10-21 に公開された、GTC Berlin 2026 の基調講演です。講演者は CEO のジェンスン・ファンです。欧州との 33 年の関わりと、過去 1 年の欧州への投資(約 100 億ドル、提携 12,000 件以上)を述べたあと、AI Factory、エージェントの基盤、Physical AI、個人用のコンピューターの順に説明しました。新しい GPU の発表や、Vera Rubin より先の世代のロードマップへの言及はありませんでした。製品の発表を期待していた筆者には、この点が少し残念でした。
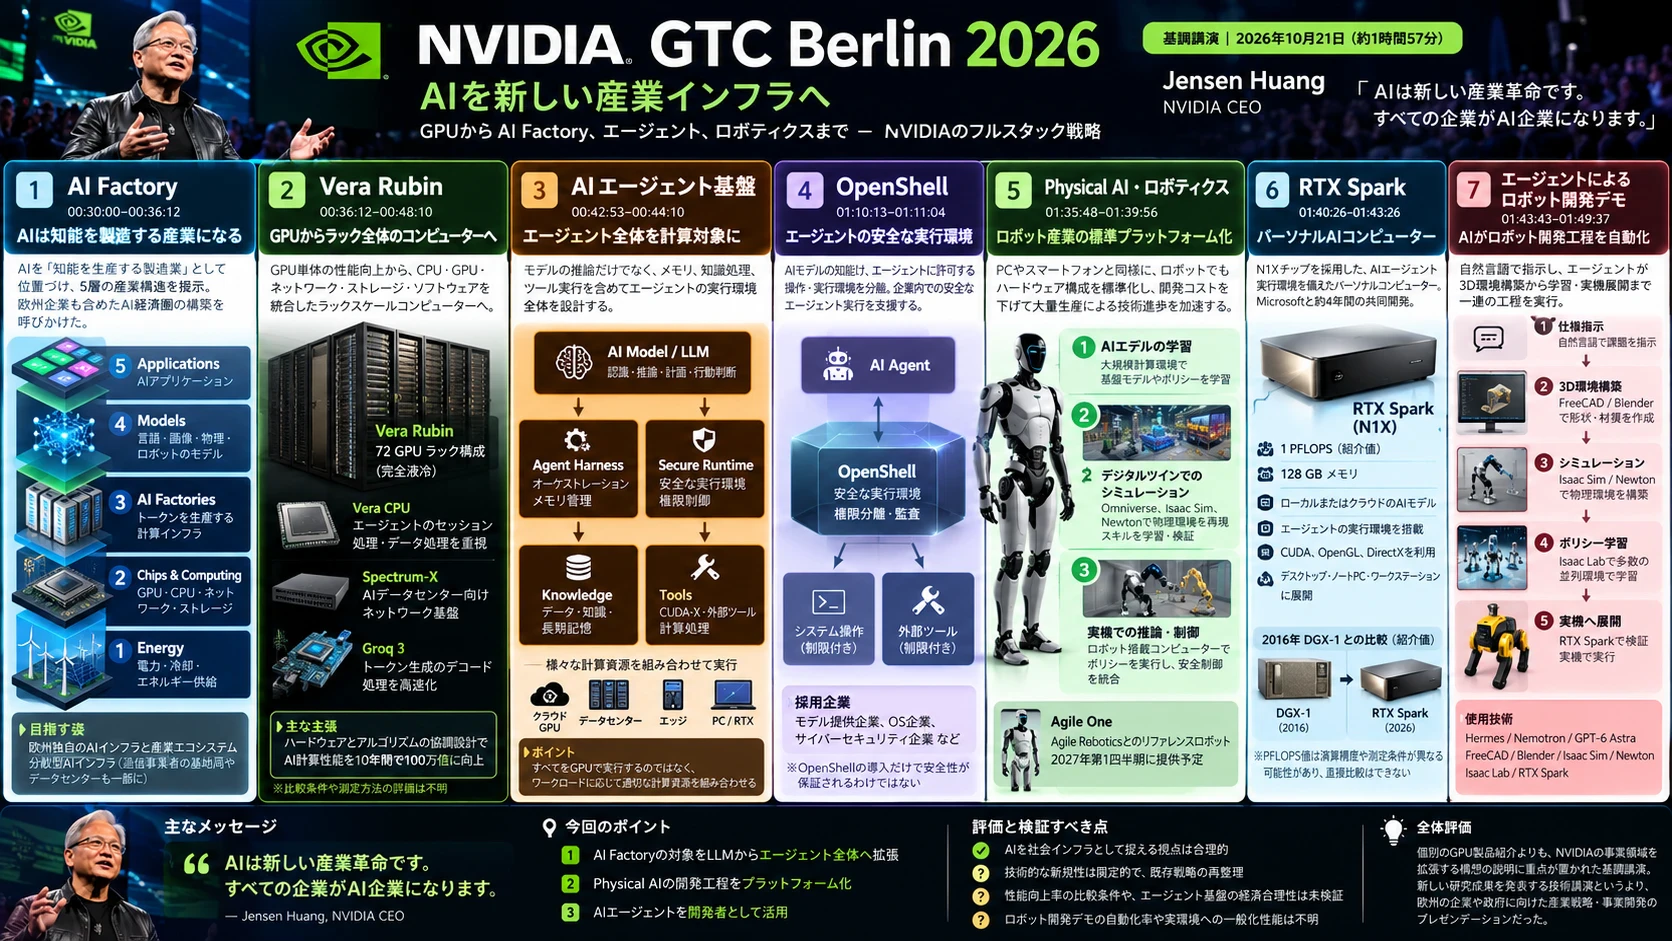
上の図は、別の AI(GPT)が同じ講演から作った概観図です。DSX POD、Sentry、Hyperion の 4 ブランド、Anthropic との提携は含まれていないので、以下で補います。図中の製品名や数字には、誤りが残る可能性があります(「GPT-6 Astra」など)。
講演の中で「今日発表する」と述べた新しい内容は、DSX POD、Hyperion への 4 ブランドの追加、Anthropic との提携の 3 つです。残りは、量産中の Vera Rubin など、既に発表済みの製品と構想の説明でした。
AI Factory
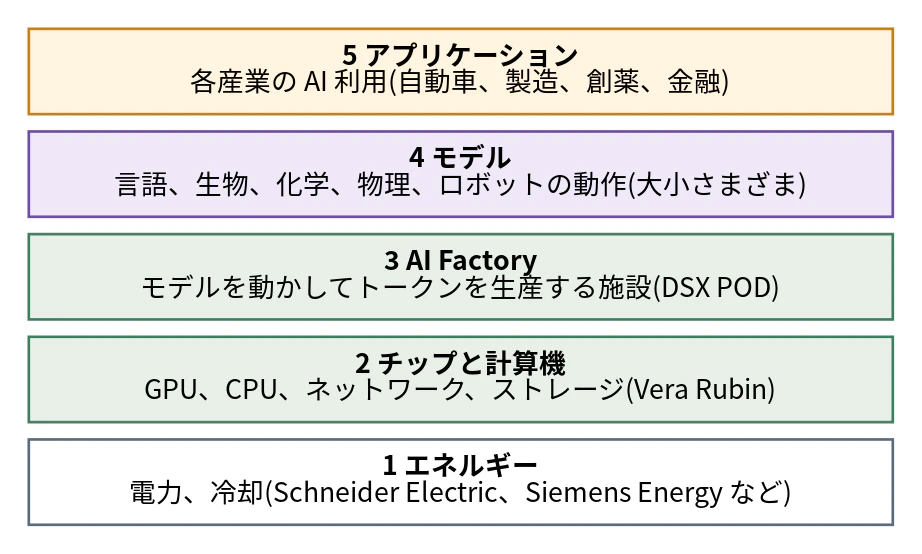
ジェンスン・ファンは AI を「ソフトウェアであると同時に製造業」と位置づけ、次の 5 層で整理しました。欧州の企業が AI を使うだけでなく、作る側にも回るべきだ、という主張です。
土台の計算機として、量産中の Vera Rubin を紹介しました。Grace Blackwell は配線が多く、液冷も 80% で、1 ノードの組立に 2 時間かかりました。Vera Rubin はケーブルがなく完全な液冷で、5 分未満で組み立てられると述べました。実演では、計算機のトレイをラックから引き抜いて見せています。短くなった理由を、構造のどの変更によるのかまでは、講演は説明していません。ただ、実演を見ると、ケーブルをなくし、トレイ単位で取り付けと取り外しができるブロック(カートリッジ)式の構造に改めたことが、組立の短縮の背景にあるのは明らかです。この説明は講演者が明言したものではなく、実演から読み取れる構造です。72 個の GPU を NVLink でつなぎ、1 つの大きな GPU として使います。Blackwell は Hopper の約 30 倍(LLM の処理)、Rubin はそのさらに約 30 倍と述べ、10 年で AI の性能が 100 万倍になったとも主張しました。100 万倍の基準(演算精度、モデル、測定の対象)は示されていません。
今回新しく発表された DSX POD は、納入から稼働までの期間を縮める製品です。従来は、機器を搬入してから、現地で組み立て、配線し、試験していたので、稼働までに数か月かかっていました。DSX POD は、ブロック工法のように、Vera Rubin の液冷ラック 7 台を配線と試験まで工場で作り込み、コンテナで届けます。現地の作業は電源と冷却の接続だけになり、そのぶん稼働までが短くなる、という説明です。1 ギガワットの設備は約 500 億ドルで、稼働が数か月遅れると 10 億ドル単位の売上が失われる、というのが工場で作り込む理由でした。
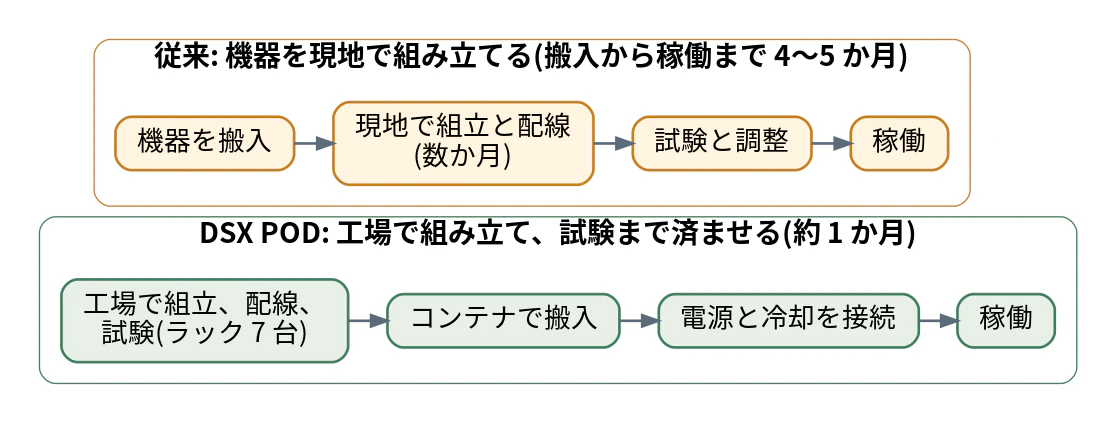
動画のナレーションは「現地の設置が数か月から数日になる」と述べていて、ジェンスン・ファンの「4〜5 か月が約 1 か月」とは測る範囲が違います。そのほか、電力を負荷に合わせて配分する制御で、同じ出力で電力を約 30% 減らせるとも主張しました。
エージェントの基盤
講演はエージェントを、モデル、ハーネス、サンドボックス、知識、道具の 5 つに分けました。エージェントはトークンを大量に使うので GPU の需要が増えた、というのが講演の主張です。
安全のための OpenShell(Apache 2.0 で公開)は、エージェントに「お願いする」のではなく、外側から制限を強制します。外への通信はすべて、サンドボックスの外の監督役を通り、方針に合わないものは拒否されます。鍵は監督役が持つので、侵されたエージェントは鍵を漏らせません。追加の Sentry は、別のハードウェア(BlueField-4)の上で通信を監視し、異常を見つけるとミリ秒で接続を切ります。
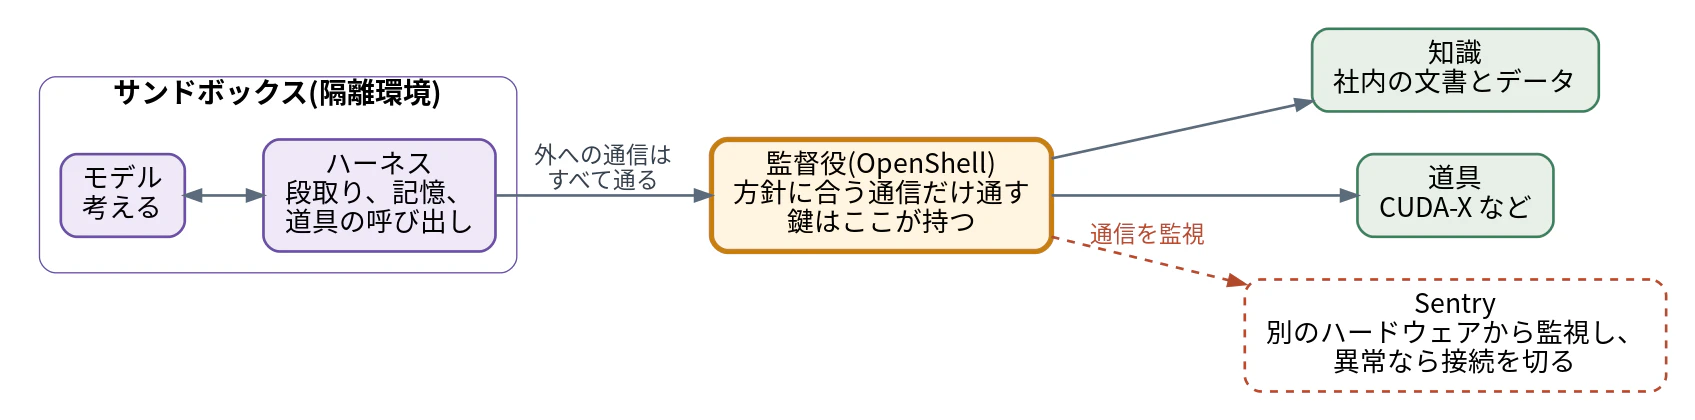
この Sentry は、Meta の Muse の安全設計に出てくる Sentinel(外への通信と外部サービスの操作を、許可するかどうか決める見張り番)に近い考え方です。どちらも、エージェント本体とは別の場所に、権限を決める仕組みを置きます(Meta の技術ブログ)。Muse の安全設計は、別の記事(X の投稿 198 件と技術ブログで見る、Meta の AI エージェント Muse の向き不向きと安全設計)にまとめています。
モデルについては、閉じたものと公開のものの併用を勧めました。NVIDIA の公開モデル Nemotron を自社のデータで追加学習すれば、最先端の水準にできる、という主張です。知識は文書の読み取りと検索の部品で、道具は 350 以上の CUDA-X のライブラリで与えます。実演として、Lila Sciences の創薬、Siemens の工場、Dassault Systèmes の設計が示されました。ジェンスン・ファンは、AI で道具のソフトウェアが不要になるのではなく、道具を作る会社がエージェントを作る会社になる、と述べました。Anthropic との提携は、OpenShell 上で動くエージェントについてです。
Physical AI
作るには 3 つの段階が要り、段階ごとに専用の計算機を使う、というのが講演の説明です。

自動運転では、カメラ 14 台、レーダー 9 基、ライダー 3 基と 2 つの GPU を標準の構成(Hyperion)にし、各社のロボタクシーが同じ構成を使えば、配車サービスから見て、1 つの大きな仮想のフリート(運行する車両の集まり)として扱える、という主張です。今回、フォルクスワーゲンのバン、ジャガー・ランドローバー(JLR)、ボルボ、メルセデス・ベンツの次世代車が対応に加わりました。人型ロボットでは、構成を標準にしないと技術が進む循環が起きないと述べ、参照ロボット Agile One を来年の第 1 四半期に出すと発表しました。通信では、基地局の無線信号の処理を NVIDIA の GPU(CUDA で動くプログラム)で行う方式を挙げ、先週、T-Mobile の回線で Nokia の機器とともに、初の商用通話を行ったと述べました。通話そのものは従来と同じで、その上に AI を重ねていく、という筋立てです。この通話は講演者の発言で、独立した報道は確認できていません。報道では、同じ構成の商用の試験が 2026 年内、商用の提供が 2027 年とされています。
個人用のコンピューターと実演
RTX Spark は、PC を、ユーザーの代わりに動くエージェントの実行環境にする製品です。N1X というチップを載せ、性能は 1 ペタフロップス、メモリは 128 ギガバイトと述べました(演算精度の条件は示されていません)。実演では、エージェントが小型ロボット Microduck の 3D 環境の作成、シミュレーション、クラウドでの並列学習、実機への展開までを進めました。人の介入の回数や失敗率は示されていません。
主張と検証の観点
講演者は NVIDIA の CEO で、製品の採用と投資を促す立場にあります。
| 主張 | 検証に必要なこと |
|---|---|
| 10 年で AI 性能が 100 万倍、Rubin は Blackwell の約 30 倍 | 演算精度、モデル、遅延、ワットあたりかなどの比較の条件 |
| DSX POD で稼働までが 4〜5 か月から約 1 か月 | 測る範囲と、実際の納入の実績 |
| OpenShell と Sentry で、許可以上の権限をエージェントが得ない | 方針の書き方の難しさと誤検知。公開されているので第三者が検証できる |
| ロボットの構成の標準化で進みが速くなる | 標準の機体で未知の環境にどこまで適応できるか |
| エージェントがロボット開発の工程を進められる | 人の介入の回数、失敗率、別の課題での再現 |
「Groq 3」(トークン生成の後半を担う加速器)、「GPT-6 Astra」(実演のモデル名)、追加学習の例の社名は、講演での発音から書いた表記のままで、正式な名称を確認していません。
出典
- NVIDIA GTC Berlin 2026 Keynote With CEO Jensen Huang(NVIDIA の YouTube チャンネル、2026-10-21 公開、https://www.youtube.com/watch?v=PvFjbPYEOZI)