
はじめに
データサイエンスの知識はゼロの状態から学習を始めました。
「とにかく手を動かしてみたい」と思い、ChatGPTに助けてもらいながら、Kaggleで公開されている Netflix作品データ を分析してみた記録です。
これは技術解説記事というよりも、「データサイエンティストの第一歩を踏み出した初心者の体験記」です。
つまずきの連続
最初はデータをpandasで読み込むところから。
import pandas as pd
df = pd.read_csv("netflix_titles.csv")
df.head()
ここまでは動きましたが、すぐに壁にぶつかりました。
country 列に欠損が多い
date_added が文字列で扱いづらい
「欠損?日付型?なんだそれ…」状態でした。
そこでChatGPTに「どうすれば分析できる形になるの?」と相談しました。
教えてもらった方法はこうです👇
df['country'].fillna('unknown', inplace=True)
df['date_added'] = pd.to_datetime(df['date_added'], errors='coerce')
df['year_added'] = df['date_added'].dt.year
→ 初めて「データを加工して“使える形にする”」という感覚を理解できました。
可視化で見えてきたこと
ChatGPTに「次は何をすればいい?」と聞いたら、「グラフにしてみよう」と提案されました。
年ごとの作品数
df['year_added'].value_counts().sort_index().plot(kind='bar')
📊 結果 → 2015年以降に作品が急増。「ストリーミング時代の勢い」を感じました。
国別作品数トップ10
df['country'].value_counts().head(10).plot(kind='bar')
📊 結果 → アメリカが圧倒的ですが、インドやイギリスも多いのが意外でした。
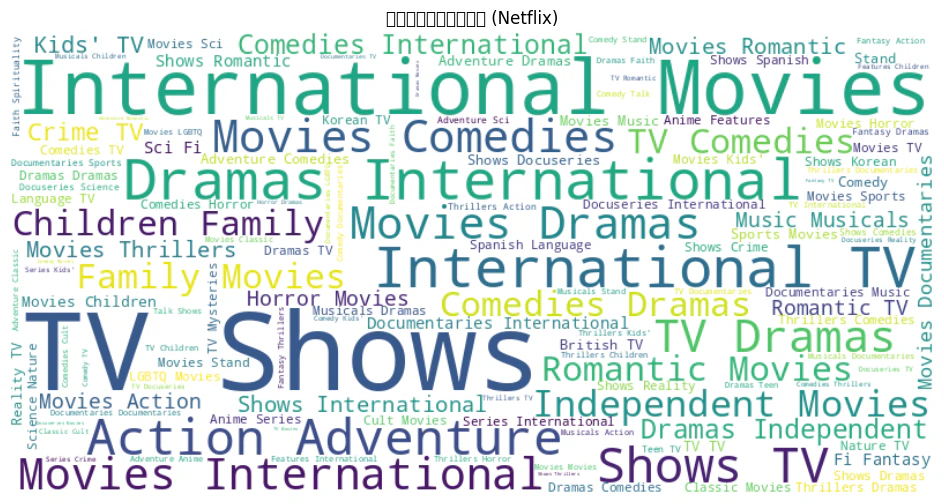
ジャンル別の傾向
ジャンルを集計してWordCloudにすると「ドラマ」「コメディ」が強い。
コードの意味はまだ完全に理解できていませんが、**「グラフが現実を映し出す瞬間」**はとても面白かったです。
感じたこと・疑問
正直、ChatGPTを使えば初心者でも形のある分析はできます。
実際、僕も「コードを完全に理解していなくても“それっぽい結果”は出せてしまう」ことを体感しました。
ここでふと疑問が湧きました。
「それならデータサイエンティストはいらないのでは?」
でも考えてみると、本当に大事なのは
データから課題を見つける力
ビジネスに結びつけて価値を出す力
仮説を立て、検証を繰り返す力
これらは単純にコードを動かすだけでは身につきません。
だからこそ、データサイエンティストは重宝されるのだと気づきました。
次の一歩へ
今回のNetflix分析は、**「誰でもできる第一歩」**だったと思います。
でも、これだけではまだ「分析をした気分」になっただけ。
本当の個性が出るのは、未来を予測するアプローチに挑戦するとき。
次はKaggleの House Prices(住宅価格予測) にチャレンジし、「予測の世界」に足を踏み入れたいと思います。
まとめ
ChatGPTの助けを借りて、データ分析の第一歩を踏み出した
欠損処理や可視化を通じて「データを扱う実感」を得られた
「データサイエンティストの価値は、コードではなく活用力にある」と感じた
次は予測課題に挑戦し、実践力を伸ばしていきたい
📂 全コードはこちら 👉 GitHubリポジトリ