
はじめに
AIモデルって一口に言っても「色々なアルゴリズムやモデルの名前が出てきて、全体像が掴めない…」って思うこと多々ありますよね。
この記事では、私自身の学習の整理も兼ねて、初学者の方に向けて「AIモデルの種類」をできるだけシンプルに、まとめてみました。(この記事はメモ程度としてあとで再投稿予定)
1. AI・機械学習・ディープラーニングの違い
モデルの種類に入る前に、よく混同されがちな3つの言葉の関係性を整理します。
これらは「包含関係」になっています。
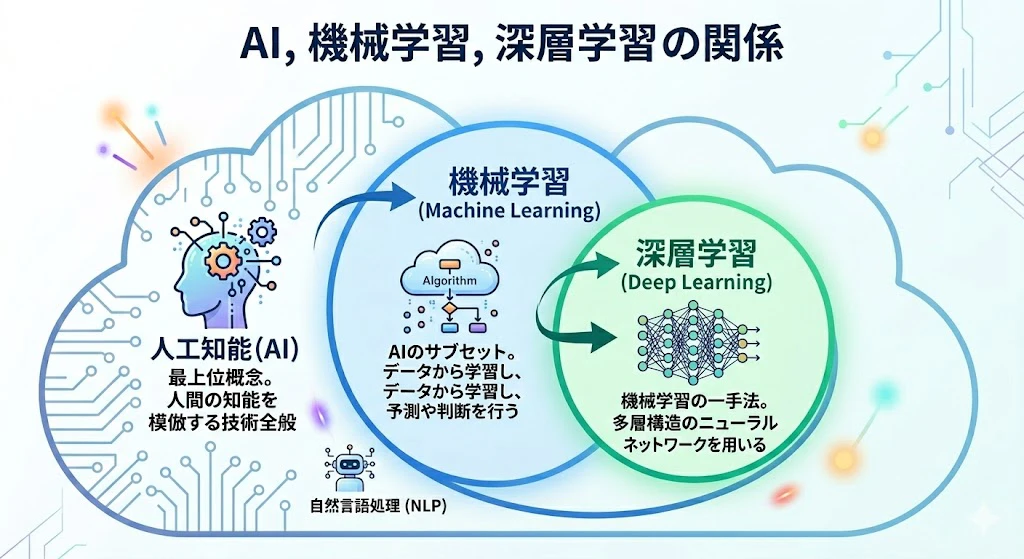
- AI(人工知能): 人間の知的な振る舞いをコンピュータで再現する技術の総称(一番広い概念)。
- 機械学習(Machine Learning): AIの一分野。データからパターンやルールをコンピュータ自身に自動で学習させる手法。
- ディープラーニング(深層学習): 機械学習の一分野。人間の脳神経回路を模した「ニューラルネットワーク」を多層にして、より複雑なデータを学習する手法。
とまあこんな感じの理解で十分だと思います。
ここからは、実務やコンペで主役となる「機械学習」と「ディープラーニング」のモデルについて解説します。
2. モデルの学習手法による分類
まずは、モデルがデータからどのように法則を学ぶのか、3つの大きなアプローチに分けられます。
① 教師あり学習(Supervised Learning)
「問題」と「正解(ラベル)」のセットを読み込ませて学習させる手法です。
実務やコンペティションで最もよく使われます。
- 回帰(Regression): 連続する数値を予測します。
具体例: 過去の気象データや血統データから、明日の気温やレースの走破タイムを予測。 - 分類(Classification): データがどのカテゴリ(クラス)に属するかを予測します。
具体例: 画像に写っているのが「犬」か「猫」か、あるいは対象が「勝つ」か「負ける」かを分類。
② 教師なし学習(Unsupervised Learning)
正解ラベルのないデータを読み込ませ、データ自身の構造や特徴、グループを見つけ出す手法です。
-
クラスタリング: 似た特徴を持つデータを自動でグループ分けします。
具体例: 顧客の購買データから、似た傾向を持つ顧客層(セグメント)を抽出する。 -
次元削減: データの重要な情報を保ったまま、情報量(次元)を圧縮して可視化や計算を楽にします。
具体例:3Dの地球儀を2Dの世界地図にする。「世界地図」は、究極の次元削減。。
③ 強化学習(Reinforcement Learning)
AI(エージェント)が環境の中で試行錯誤し、最も報酬(スコア)が多くもらえる最適な行動を自ら学習していく手法です。
具体例: チェスや将棋などのゲームAI、ロボットの自動歩行制御など。
3. 代表的なアルゴリズムの種類
次に、扱うデータ(表形式、画像、テキストなど)に合わせて選ぶべき、代表的なアルゴリズムやアーキテクチャを紹介します。
伝統的な機械学習モデル(表形式データに強い)
データベースに保存されているような、Excelのような表形式の構造化データ(テーブルデータ)の予測において、現在でも非常に強力です。
- 線形回帰 / ロジスティック回帰: 最も基礎的。結果に対する各データの影響度(解釈性)がわかりやすい。
- 決定木(Decision Tree): 「Yes/No」の条件分岐のツリーを作って予測する直感的なモデル。
- アンサンブル学習: 複数のモデル(主に決定木)を組み合わせて高い精度を出す手法。
Random Forest(ランダムフォレスト) や、LightGBM、XGBoost といった勾配ブースティング系のモデルは、Kaggleなどのデータ分析コンペや、テーブルデータを使った実務の予測タスクで「とりあえずこれから試す」と言われるほど定番です。
ディープラーニングモデル(非構造化データに強い)
画像、音声、自然言語など、人間には直感的にわかってもコンピュータには扱いづらい非構造化データに圧倒的な強みを発揮します。
- CNN(畳み込みニューラルネットワーク): 主に画像の認識や生成で活躍。画像の中から輪郭や特徴を抽出するのが得意です。
- RNN / LSTM(再帰型ニューラルネットワーク): 過去の情報を記憶しながら処理を行うため、音声やテキストなどの時系列データ(順番に意味があるデータ)を扱うのに適しています。
- Transformer(トランスフォーマー): 現在の生成AIブームのコアとなっている技術。文章の文脈を深く理解でき、ChatGPTなどの大規模言語モデル(LLM)の基盤です。Difyのような生成AI開発プラットフォームの裏側でも、このアーキテクチャから生まれたモデルたちが動いているようです。
まとめ
AIモデルには様々な種類がありますが、初学者のうちは以下の2ステップで考えるのがおすすめです。
1.どんなデータを使って、何をしたいのか(回帰?分類?クラスタリング?)を決める。
2.データの種類(表形式か、画像か、テキストか)に合わせて、定番のアルゴリズム(LightGBMやCNNなど)を選択する。
まずはLightGBMのような扱いやすいモデルを使って、身近なデータで予測モデルを作ってみると、理解が深まりそうですね!