

【AZ-305】合格への道(DAY3) — バックアップとサイトリカバリ
Microsoft Learn を教材にした AZ-305(Designing Microsoft Azure Infrastructure Solutions)の研修を4日間受講しています。
講師の解説のうち「Learn の本文だけでは拾えない判断基準」を中心に、受講メモとして整理しました。
前提知識として、AZ-104合格後です。
⚠️ 本記事は受講メモをベースにした個人の整理です。正確な仕様は必ず公式ドキュメントをご確認ください。
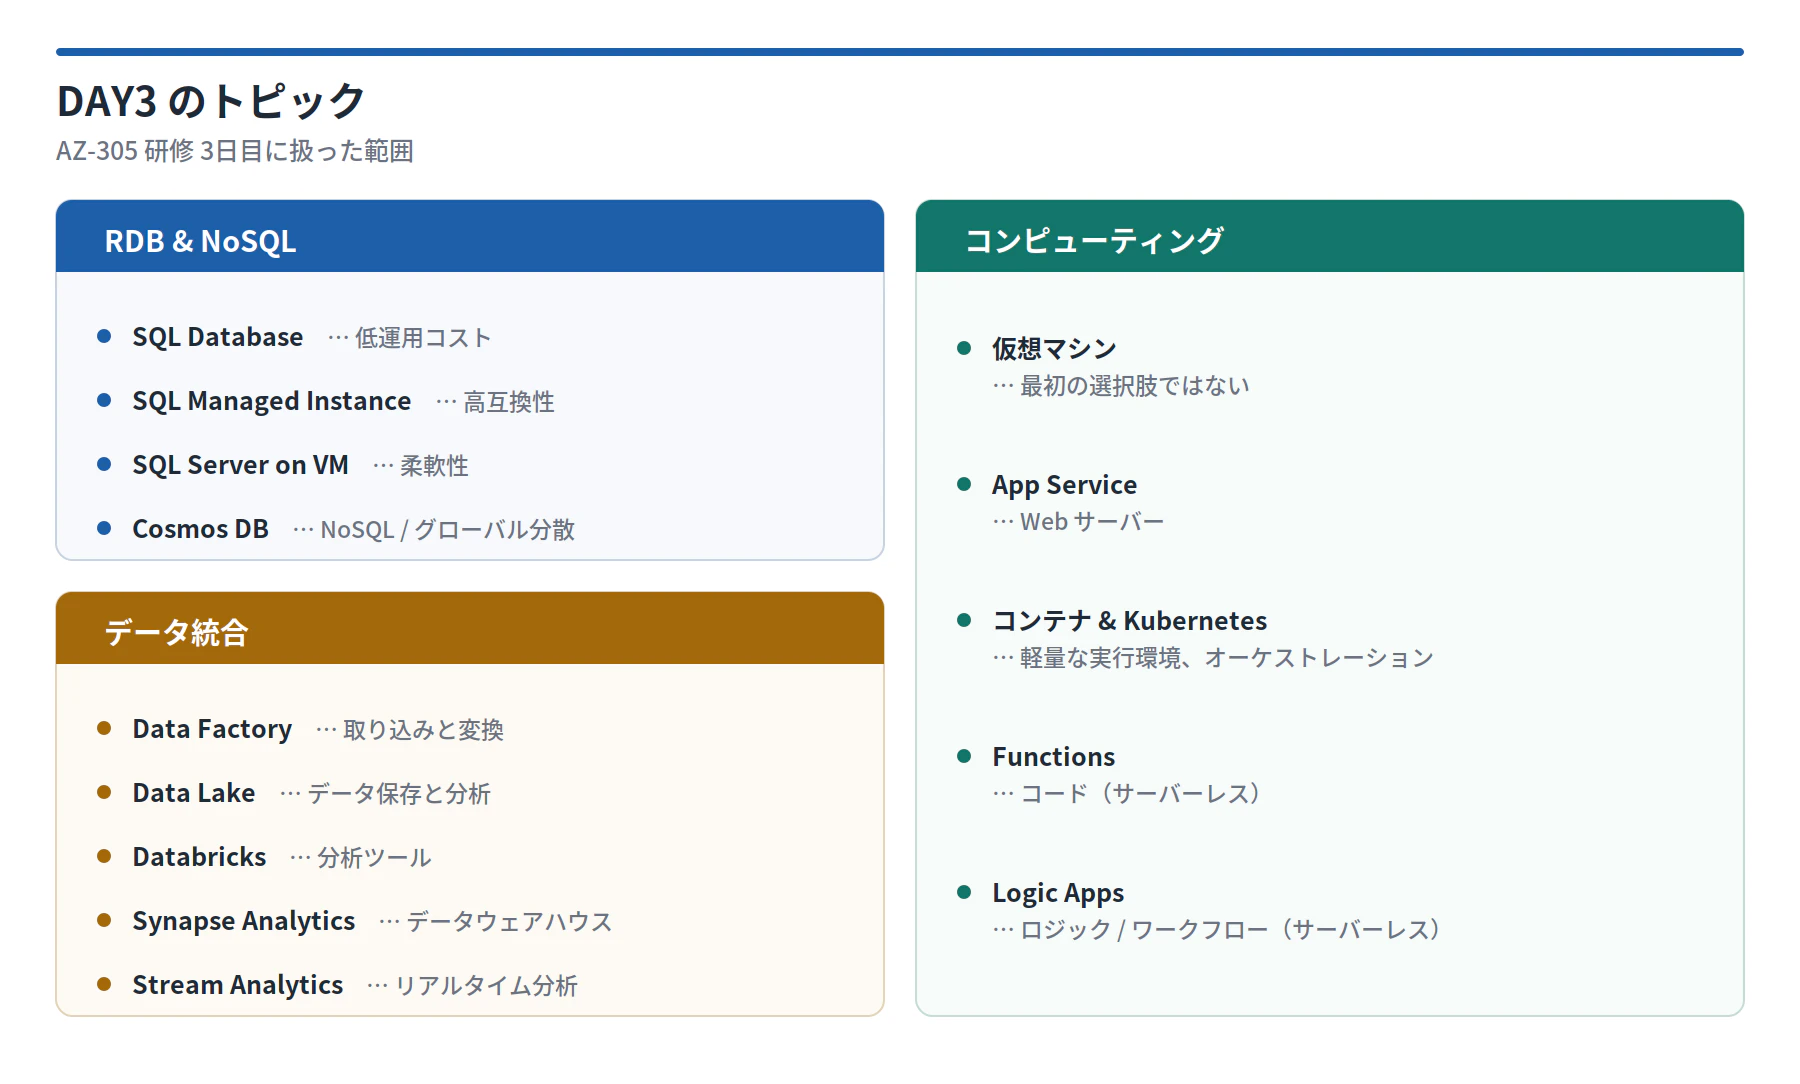
研修全体の構成
| 内容 | |
|---|---|
| DAY1 | ID・ガバナンス |
| DAY2 | ストレージアカウント、データベース |
| DAY3 | バックアップとサイトリカバリ |
| DAY4 | インフラストラクチャ ソリューション設計 |
1. ストレージ ソリューションの設計
1-1. アクセス層の自動最適化
利用頻度に応じて自動的にストレージ層を変更してくれる仕組みがあります。
AWS でいう S3 Intelligent-Tiering に相当するものだと理解すると早いです。
- ライフサイクル管理は Premium では利用不可
- Web App は Azure Files に マウント可能(ストレージアカウントを指定する)
参考: BLOB データのアクセス層の自動最適化 - Microsoft Learn
1-2. Azure File Sync でオンプレのファイルサーバをクラウドへ
構成の流れは以下の通りです。
- オンプレミスにファイルサーバを立てる
- そこに File Sync エージェント をインストールする
- クラウド側に Storage Sync Service を設定し、共有フォルダ(Azure Files)を作成する
- オンプレの File Sync からクラウドの共有フォルダへデータを格納する(自動レプリケーション)
ポイントは以下です。
- HTTPS でアクセス可能なため、SMB を直接利用する必要がない
- App Service からマウント可能
- 「オンプレ → Azure → オンプレ」という経路で、Azure を介したオンプレファイルサーバ同士のレプリケーションが可能
- クラウド側でバックアップも取れるため、オンプレ側のバックアップが不要になる
講師曰く、Microsoft の方針として「オンプレミスのサーバを無くしていこう」という方向で全体が動いている、とのこと。
企業内で作成した独自の Web アプリケーションについても、既存アプリは捨てて SharePoint に移行するなど、クラウドベースの別アプリケーションに乗り換えるという選択肢が提示されます。
1-3. ストレージアカウントのアクセス制御
大きく分けて、ネットワーク側の制限と ID 側の制御があります。
ネットワーク制限
- パブリックエンドポイントの IP 制限
- サービスエンドポイントの VNet 制限
- プライベートエンドポイント
アクセス制御の方式
| 方式 | 内容 |
|---|---|
| 匿名読み取り許可 | Blob の機能。BLOB 匿名アクセスを「許可」にする必要あり。認証なしでアクセス可 |
| 匿名制限付きアクセス(SAS) | 共有アクセス署名。アクセスレベルは Blob 専用の匿名読み取りアクセス |
| Entra ID 認証 + RBAC | 推奨される方式 |
1-4. SAS(共有アクセス署名)の生成
- 署名キーを利用して生成する
- 生成物は Blob SAS トークン と Blob SAS URL
- URL を改ざんするとハッシュ値が合わずエラーになる(ここが SAS の肝)
アクセスポリシー
- 「アクセスできる日程」を作るイメージ
- Blob オブジェクトに対してアクセスポリシーを設定することが可能
- シグネチャの中にポリシー名が含まれるため、改ざんするとハッシュ計算でエラーになる
2. リレーショナルデータ用のデータストレージ ソリューション
2-1. 3つの選択肢とネットワーク構成
SQL Server on VM(IaaS)
- 仮想マシン
- VNet の中にサブネットがあり、その中に VM がある
SQL Managed Instance(PaaS)
- VNet 統合
- 構成に時間がかかる
- 互換性が高い
- VNet の中に専用サブネットがあり、そこに SQL インスタンスがある(構成の見た目は SQL Server on VM に近い)
Azure SQL Database(PaaS)
- 独立サービス
- 手軽
- 互換性に制限あり
- VNet 外の Azure リソース上に SQL Database が存在する。VNet 上にプライベートエンドポイントを作ればアクセス可能


2-2. データベースのスケーラビリティ
Azure SQL Database は、まず Database サーバを作成し、その上に Database を作成するという構成です。
SQL は無条件のパブリックアクセスはありません。
Elastic Pool(エラスティックプール)
複数のデータベースで CPU・メモリ・ストレージなどのリソースをまとめて共有できる仕組みです。
- 1つのデータベースサーバに単純に複数データベースを置くのは得策ではない
- 複数データベースを扱うなら Pool を使う方が良い
- 中規模以下の負荷であれば、サーバをシェアするという考え方
サーバレスの設定も選択できます。
価格モデル
| モデル | 特徴 |
|---|---|
| DTU | パフォーマンスを指定(CPU・メモリなどは自動的に決まる) |
| 仮想コア(vCore) | コストパフォーマンスが一番良い。負荷が高いケース向け |
| サーバレス | 負荷が低い / 負荷が分散しているケース向け |
2-3. データベースの可用性(サービスレベル)
かつては「可用性の指標」「応答時間・パフォーマンス」で語られていた区分です。
General Purpose
- コストと汎用性のバランス重視、SSD
- レプリカ DB 側はコールドスタンバイ(昔は遅かったが、最近は速い)
- リモート SSD のため Business Critical には劣る
Business Critical(Premium)
- 高可用性・低遅延・高速復旧重視
- フルローカル SSD のため速い
- レプリカ DB 側はホットスタンバイ

Hyperscale
- 大きなデータベースを対象とする
- 価格が高い / 容量が大きい / バックアップ・復元が速い
★ Business Critical と Hyperscale の選択基準は「容量」で決めること。

2-4. リージョン間のフェールオーバーと負荷分散
- 別リージョンに対してフェールオーバーしたい場合は、Traffic Manager が制御する
- ロードバランサー(L4 / ネットワーク層)でデータベースの負荷分散もできるが、読み取りのみ。書き込みはできない
- SQL Server で読み書きを同時には行えない
2-5. 選択基準まとめ(試験で問われやすい形)
| 要件 | 選ぶもの |
|---|---|
| データベースが 16TB を超える | Hyperscale |
| オンプレミスからのデータベース移行 | SQL Managed Instance |
| 最小コストで既知のデータベースを動かす | Azure SQL Database、Elastic Pool |
| リージョン間でレプリケートする | 自動フェールオーバーグループ |
| 複数のデータベースをまとめる | Elastic Pool |
| パフォーマンス、読み取りレプリカが欲しい | Business Critical |
| 障害対策(可用性グループ) | Always On |
| コストパフォーマンス重視 | 仮想コアベース(第1優先)、次に DTU |
3. 保存データ・移動中のデータ・使用中のデータのセキュリティ設計
3-1. ネットワークセキュリティ
- 仮想ネットワーク
- ファイアウォール
3-2. ID とアクセス
Azure SQL データベースに対する認証の考え方です。
SQL Server の場合
- master データベース(SQL Server 自身)への登録が login
- Database(複数作成可能)側が User
- AD DS のユーザと SQL のユーザを連携し、Windows ログインアカウントで SQL に対して認証する
クラウドの場合
- Entra ID を利用する
- Entra ID アカウントと SQL アカウントをマッピングできる(マッピングを作る必要あり)
- Entra ID にマッピングしない SQL ユーザも作成可能(master データベースに新規登録される)
- 管理者は「追加」ではなく「差し替え」。もし追加したい場合は master データベースを直接操作する必要がある
ユーザ名とパスワードだけでは今のご時世よろしくない、という前提の話でした。

3-3. 3つのサービスの機能比較
| サービス | 特徴的な機能 |
|---|---|
| Azure SQL Database | 自動バックアップ、アクティブ geo レプリケーション |
| Azure SQL Managed Instance | データベース間クエリ、リンクサーバ、CLR(Common Language Runtime/DB 内で任意のプログラムを実行したいとき)、ネイティブ VNet サポート、自動バックアップ。作成に5〜6時間かかることも |
| SQL Server on VM | OS レベルのアクセスが必要、古いバージョンのサポート、Reporting Services、Integration Services(Data Factory と統合)、Analysis Services |
3-4. データ保護
VM のエフェメラルディスク以外は、ディスクは原則暗号化されます。
TDE(Transparent Data Encryption / 透過的データ暗号化)
- Microsoft 管理の暗号化キー
- Key Vault(カスタマーマネージドキー)
Always Encrypted
- オンにするとメモリ上に展開されるときも暗号化されている
- メモリ上の復号はアプリケーションが行うため、アプリが Key Vault のデータを読む必要がある
- ネットワークを流れるとき、データベース上、すべて暗号化される
- 暗号化は列単位
- 暗号化の種類:決定論的 / ランダム化
★ データベース内のデータ自体を暗号化するのは Always Encrypted のみ。
処理中(使用中)のデータを守るのも Always Encrypted。
動的データマスク(DDM)
- 特定の列に対してマスクをかける
- データ自体をマスクするのではなく、クエリ結果がマスクされる
- クレジットカード番号の下4桁だけ見せる、といった用途
- データベース管理側で対応する必要がある

3-5. 演習で出てきた観点
地理的に遠隔地から利用し、アイテム数が多いと遅くなる — というケーススタディです。データ量に左右される問題に対して、以下のような打ち手が挙がりました。
- Cosmos DB を入れる手もあるが、アプリケーション改修が必要
- Azure Cache for Redis などのデータベースキャッシュを設ける
- RDB の見直しは効果あり(インデックスを使って検索を高速化する見直し)
- 透過的暗号化
- プライベートエンドポイントは、Web サーバと Azure SQL をセットで考える
- Azure ハイブリッド特典の利用(可能な場合)
- Azure Defender for SQL → ワークロード保護(SQL 脆弱性評価などが利用できる)
4. Azure Cosmos DB
ChatGPT や Entra ID の裏側で Cosmos DB が使われている、という話から入りました。
Entra ID は世界中どこでも使えますが、それは世界各地にレプリカを持っており、それを Cosmos DB が支えているからです。
4-1. 特徴
- 世界各地にレプリケーションし、クライアントから一番近いところが応答する
- 整合性レベルを選択できる
4-2. 複数の API セット
| API | 用途 |
|---|---|
| Azure Cosmos DB for NoSQL | 半構造化データの管理(もともと DocumentDB として作られた経緯) |
| Azure Cosmos DB for MongoDB | MongoDB と互換 |
| Azure Cosmos DB for Table | ストレージアカウントの Table 相当 |
| Azure Cosmos DB for Apache Gremlin | リレーションを表すグラフ DB。人・商品・組織・SNS のつながりなど、関係性が重要なデータ |
| Azure Cosmos DB for Apache Cassandra | キーバリューストア |
| Azure Cosmos DB for PostgreSQL | リレーショナルだが Cosmos に入っている例外扱い |
基本は NoSQL(AWS でいう DynamoDB)で、Document(JSON など)/Key-Value/グラフ DB を扱うもの、という整理です。
4-3. 整合性レベル
| レベル | 内容 |
|---|---|
| 強固(Strong) | すべてのレプリカが同期して読み込みができる |
| 有界整合性制約(Bounded Staleness) | 他のレプリカは遅れてもよいという考え方 |
| セッション(Session) | セッションによりレプリカは遅れてもよいという考え方 |
| 一貫性のあるプレフィックス(Consistent Prefix) | 順序としての一貫性はあるが、時間的な遅れは分からない |
| 最終的(Eventual) | 順序と時間の保証なし。複数リージョンで同時書き込みができ、レプリケーションの中で自動的に決まる。世界的な SNS やネットワークゲームなどで使われる |

5. データ統合ソリューションの設計
全体の流れは以下のイメージです。
Data Factory ─→ Data Lake ─→ Databricks
             └─────────────→ Synapse Analytics
やることは「データ移動を調整する」と「大規模なデータを変換する」の2つ。
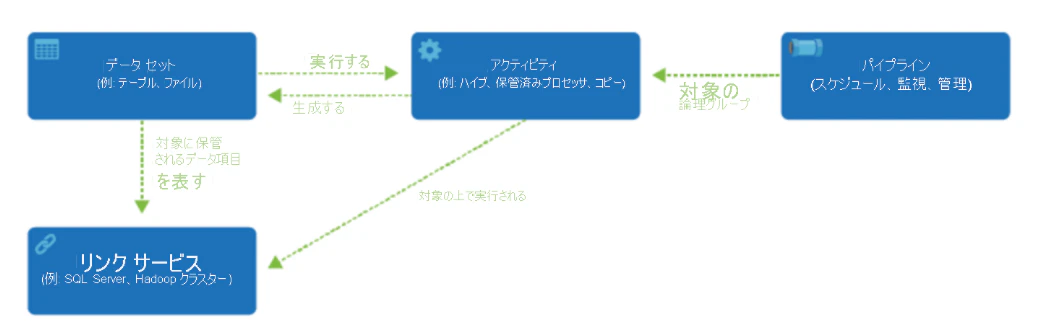
5-1. Azure Data Factory
★ 覚えておきたい:統合ランタイム(IR)の3種類
- Azure: Azure 上で処理
- セルフホステッド: 利用者が用意したサーバ上で処理
- Azure-SSIS: SQL Server Integration Services
5-2. Azure Data Lake
Hadoop(Google が開発した MapReduce の系譜)の考え方がベースです。
大きなデータを検索するとき、1つのファイルだと時間がかかるため、複数のファイルに分割します。ファイルとサーバを一体にし、分割することで同時に処理できるので速くなります。分割したものを分析して結果をまとめる、という流れです。
データをコピーするのではなく、Map(HDFS: Hadoop Distributed File System)で処理します。
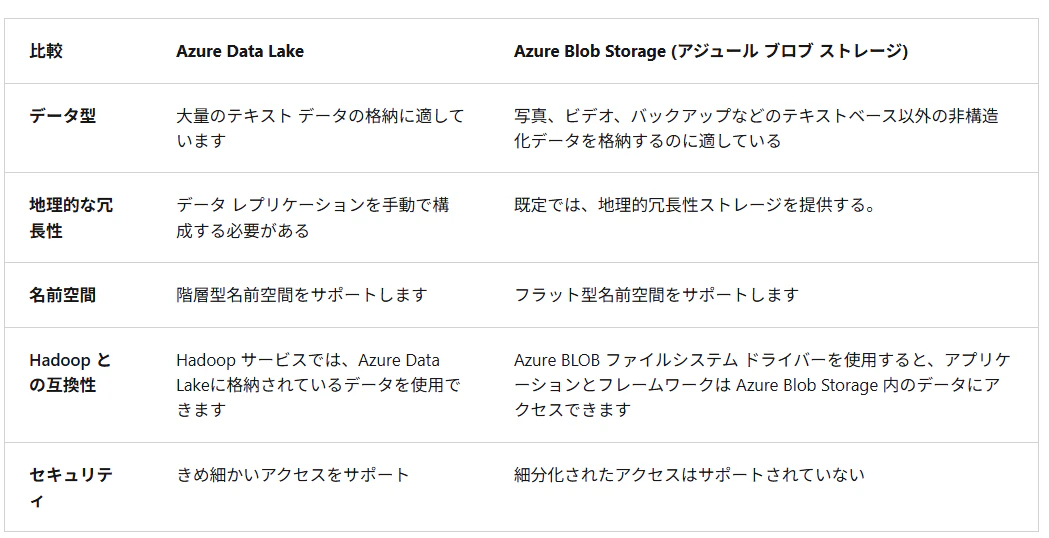
- 出来上がったものはほぼ Blob
- Data Lake はテキストファイルに適している
5-3. Azure Databricks
分析を行うオープンソースベースのサービス。
- コントロールプレーン:無料
- コンピュートプレーン
5-4. Azure Synapse Analytics
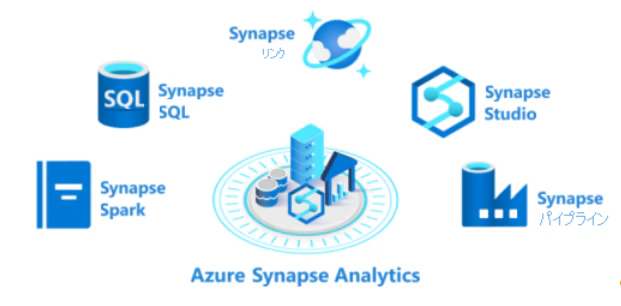
Microsoft の分析サービス。SQL と Apache Spark が使えます。
| 主目的 | データ変換機能 | |
|---|---|---|
| Data Factory | データ取り込み | あり |
| Synapse Analytics | 分析 | あり |
使い分けの目安:
- Databricks: Linux ベースの環境であれば利用
- Synapse Analytics: Microsoft の環境であれば利用
5-5. 関連サービス
- Microsoft Fabric: Synapse Analytics、Data Factory、Power BI をまとめたサービス
- Azure Stream Analytics: リアルタイム分析。IoT などのデータ分析に使う
ホット / ウォーム / コールドの整理(データ処理の観点)
| 区分 | 内容 |
|---|---|
| ウォーム | 一般的なデータ(データ作成直後) |
| コールド | データがほとんど変化しない |
| ホット | 1秒間に何千・何万のデータ処理 → Stream Analytics |
6. AZ-305: インフラストラクチャ ソリューションの設計
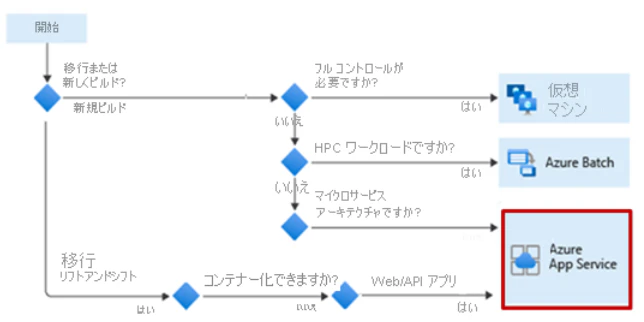
6-1. Azure コンピューティング サービスを選択する
まず前提として、仮想マシンはクラウド最適化ではないという立ち位置。
- 可用性を高めたい・オートスケールさせたい場合は Kubernetes 一択
- Azure Container Instances(ACI)にはその機能がない。単独でコンテナが動くだけ
- ロードバランサーなどが必要なら ACI では自前で対応することになる。その点 AKS はオーケストレーション機能を持つ
コンテナ関連の理解
- Container Instances: Docker
- Kubernetes: コアの部分は Docker
ローカルで Docker コマンドを使って構築したコンテナは、Azure 上では ACI でも AKS でも動かせる。AKS は Docker コンテナを束ねる管理機能(オーケストレーション機能)である — この理解で正しい、との確認が取れました。
その他のポイント
- ★ App Service に対して、コードではなくコンテナを指定することができる
ただし本来の目的は Web サーバとして使うこと。マイクロサービス的な使い方は本来想定していない - ★ Container Apps 環境(Kubernetes の中間的サービス)
- Azure Functions + Logic Apps も選択肢に入る
★ ここをおさえておきたい

参考: Choose a compute service - Microsoft Learn
6-2. Azure Virtual Machines ソリューション
Azure ホットパッチというオプションを選んでおくと、再起動なしで Windows Update が可能になります。
仮想マシンファミリの決定
| ファミリ | 用途 |
|---|---|
| D シリーズ | 汎用 |
| F シリーズ | コンピューティング最適化 |
| E シリーズ | メモリ最適化 |
| L シリーズ | ストレージ最適化 |
| N シリーズ | GPU |
| H シリーズ | ハイパフォーマンスコンピューティング |
仮想マシンスケールセット(VMSS)
- 負荷に応じて台数の増減が可能
- ただしロードバランサーが必要
6-3. Azure Batch ソリューション

6-4. Azure App Service ソリューション
- 仮想マシンに相当する App Service プランを決定する
- 本番とプレビュー環境を分けることができる
- Entra ID の認証も容易に組み込める
6-5. Azure Container Instances ソリューション
- テストと開発で使用されることが多い
- マイクロサービス用に設計されていない

6-6. Azure Kubernetes Service ソリューション
用語の対応は以下の通り。
- ノード = VM
- ポッド = コンテナ
スケールの考え方:
- 役割が違うのであればポッドを増やす
- ポッドが追加できなければノードを増やす
- ノード追加には時間がかかる(1〜2分)。そのつなぎとして ACI(Container Instances)を起動する


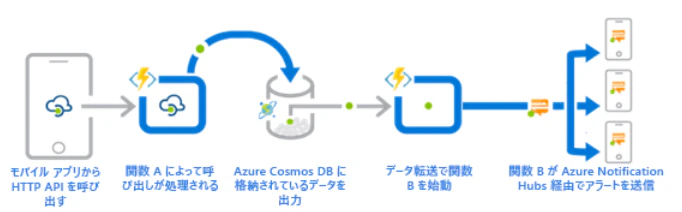
6-7. Azure Functions ソリューション
AWS でいう Lambda。
- コードの再利用
- マイクロサービスに最適化されている
- Durable Functions: 長時間かかる処理や複数ステップの処理を、状態を保持しながら実行できる仕組み
- 関数アプリ作成時にプランを複数選択可能
- 既存の言語を利用(Python など)

6-8. Azure Logic Apps ソリューション
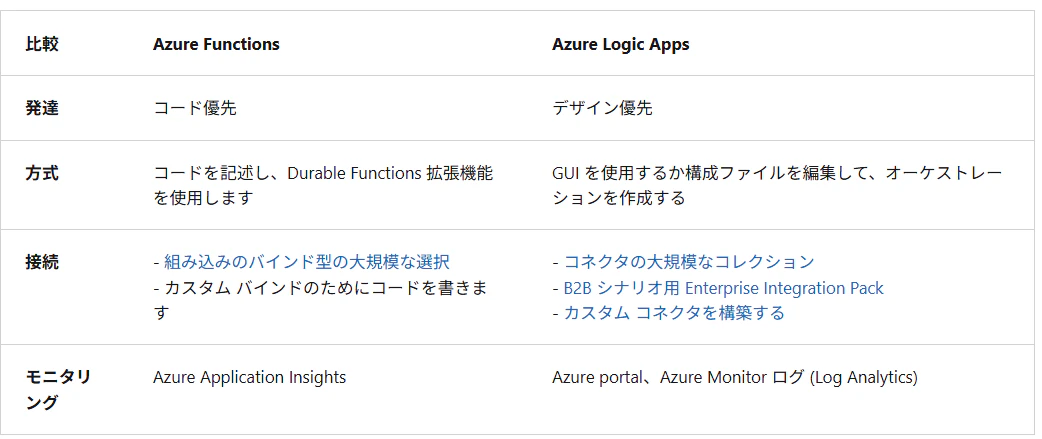
Azure Functions とは作り方が違います(AWS でいう Step Functions)。
- ワークフローで作るイメージ
- ロジック アプリ デザイナーがあり、GUI ベースでワークフローを作成できる
- ロジック アプリ コードビューもあり、コードベース(JSON 形式)で見ることも可能
- 特に Office 製品との接続がやりやすい


7. 試験対策メモ
講師から挙がった、出題傾向に関するコメントです。
- 試験対策的に VM を選ばせる傾向が高い
- Functions と Logic Apps の比較は出題頻度が高い
- コンテナ関連もぼちぼち出る
あわせて、本文中で「★」を付けた以下は自分用の重点ポイントです。
- Business Critical と Hyperscale の選択基準は「容量」
- データベース内のデータ自体の暗号化は Always Encrypted のみ
- Data Factory の統合ランタイム3種類(Azure / セルフホステッド / Azure-SSIS)
- App Service にはコードではなくコンテナも指定できる
おわりに
AZ-104 では「サービスの使い方」が中心でしたが、AZ-305 は明確に「どれを選ぶか、なぜそれを選ぶか」を問われる内容になっています。
特にリレーショナルデータベースの3択(VM / Managed Instance / SQL Database)とコンピューティングの選定は、要件から逆引きできる状態にしておく必要があると感じました。
最終日も、整理でき次第まとめていきます。