
対策を進めたあとに、また通知が来た
以前、3ノードで動かしている分散DBの応答遅延をNew Relicで調べました(前回の記事)。外から測った応答時間と、DB内部の指標を同じ時間帯に並べたことで、それまで気づけていなかった点が見えてきた、という内容です。
前回の調査後、rack2のDBプロセスに--cpuset 1を設定し、実行先をCPU0からCPU1へ変更しました。ただし、この変更による改善効果は再計測で確認できていません。そんな中、2026年11月2日の20時過ぎに、読み取りタイムアウトの通知がまた届きました。今回の問いは、前回と同じ原因が再発したのか、似た症状に別の待ちが混ざっているのか、の2つです。
先に書いておくと、根本原因は特定できていません。前回と同じ原因かどうかも確認できていません。この記事は、再発した1回の読み取りに絞って、アプリに残った記録とNew Relicのメトリクスをどこまで突き合わせられたかを整理したものです。原因の確定には届きませんでしたが、同じ時間帯・同じ対象で見比べたことで、候補の整理と、次に必要な観測の定義まではできました。
進め方は、New Relicの画面で自分がNRQLを実行し、返ってきたJSONや画面をChatGPTに貼って、クエリの組み立てや数値の読み方を相談する形です。ChatGPTの説明には訂正が必要な箇所がいくつかあり、それも後半で書きます。時刻はすべて日本時間(JST)です。
1回の読み取りに残っていた記録
対象は、ARMのrack1、AMDのrack2、rack3の3ノードです(レプリカ数3、整合性レベルはQUORUM)。Botにはタイムアウト時に診断ログを書き出す仕組みがあり、今回の1件には、設定を読むSELECTについて次の記録が残っていました。
| 記録 | 値 |
|---|---|
| 同時実行枠の待機 | 0.022 ms |
| ドライバの送信API呼び出し | 0.401 ms |
| 500ms警告タイマーの遅れ | 0.489 ms |
| ドライバのcallback待ち | 1499.918 ms |
| 代替DBへ切り替えたあとの読み取り | 1337.748 ms |
| 読み取り全体 | 2838.883 ms |
| 試行先のコーディネータ | rack3 |
これらは同じ要求を別の区間で測った値で、重なりがあるので足し算はできません。
流れとしては、20:07:58.119に500msの警告が出て、期限の1,500msに達した時点(診断ログの時刻は20:07:59.119)でもドライバのcallbackは返っておらず、Botは代替DBからの読み取りに切り替えて成功しました。通知の画面には「20:08」と表示されますが、これは分単位の表示です。読み取りの開始は、警告の時刻から逆算するとおよそ20:07:57.6頃と見ています。

図1 通知に残った読み取り時間。callbackが未到達だった区間には、ドライバ内部・通信・サーバー側の待ちが含まれます。切り替え後の時間にも、DB実行以外の待ちが入り得ます。
送信APIの呼び出しは0.401msで戻っていて、時間の大半はそのあとのcallback待ちに使われています。ただ、呼び出しが戻ったことと、要求がサーバーに届いたことは別の話なので、この1.5秒がドライバ内部なのか、ネットワークなのか、サーバー側なのかは、この記録から決められません。500ms警告のタイマーは0.489msしか遅れていなかったため、少なくともその付近ではBotのイベントループが回っていたと考えられますが、あくまで500ms付近の観測で、1.5秒の全期間の状態は別の記録で確かめる必要があります。
試行先としてrack3が記録されている点は、読み方を慎重に考えました。rack3がコーディネータとして選ばれたことは分かっても、QUORUMでは複数のレプリカの応答が必要なので、実際にどのノードの応答を待っていたのかは、今回の記録に含まれていません。そこでrack3を原因と決めずに、3ノードを同じ条件で見比べることにしました。
最初にそろえたのは、時刻と対象
比較に入る前に、検索の範囲と対象の識別でつまずきました。
1つ目は検索範囲です。最初のクエリには20:00〜20:15の15分を指定したつもりでしたが、返ってきた結果のmetadata(beginTime / endTime)を確認すると、実際の検索範囲は20:07:58〜20:08:58の1分間でした。画面側の時間範囲の指定がクエリ文のSINCE/UNTILと併存していて、返ってきたのは画面側に近い1分だったようです。確認できたのは返却されたmetadataの値までで、画面側の設定が優先されたという点は推測です。その後は19:55〜20:20の25分間をクエリに明記して取得し直し、metadataで範囲を確かめてから比較に使いました。

図2 クエリに書いた時間と、実際の検索範囲。比較にはmetadataの範囲を使いました。
この1分間の結果に対して、ChatGPTからは「15分間で6件しか返っていないので、収集が足りないのではないか」という趣旨の説明がありました。実際は1分間の結果で、count(*)が何を数えるかもメトリクスの型によって変わります。New Relicの変更告知によると、Metricに対するcount(*)の解釈は2025年6月以降、メトリクス型が持つcountフィールドに合わせたものになり、データポイントの報告数を知りたい場合はdatapointCount()を使うとされています(What's new)。この収集不足の説明は撤回しました。
2つ目は対象の識別です。最初はhostnameでFACETしたところ結果が空になり、「ノードを識別する属性が無い」という説明になりかけました。keyset()で属性を確認し直すと、host.hostnameとscrapedTargetNameの2つがあり、属性名の選び間違いでした。
さらにhost.hostnameで分けてみると、3つの対象すべてが同じ値で、それは3ノード分のメトリクスを集めている収集元のホストでした。ノードごとの比較にはscrapedTargetNameを使います。収集元が1つであることは監視構成についての事実で、今回の遅延と結びつける材料は得られていません。
rack2で目立った値を並べる
New Relicに入っているDB内部の指標のうち、最初に目に入ったのはrack2のstall関連の値でした。stallは、一般にはDBの処理ループが一定時間止まったことを数える系統の指標と理解していますが、今回の実行バージョンでの定義と単位は確認できていません。
25分間(19:55〜20:20)のreactor_stalls_sumの返却値を合計すると、rack1が28、rack2が136、rack3が16でした。これはNRQLが返した値の合計で、回数を表すのか時間を表すのかは未確認です。1分ごとの値では、障害を含む20:07台がrack1=2、rack2=6、rack3=1で、rack2の最大は障害より後の20:09台の16でした。
同じ指標のヒストグラムを、障害を含む3分間(20:07〜20:10)で見ると、最大の有限バケットまでの累積値は、rack1=3、rack2=33、rack3=1でした。

図3 stallヒストグラムの有限範囲内に記録された件数(20:07〜20:10)。+Infバケットと独立した_countを取得できていないため、全件数の確定値としては扱っていません。
もうひとつ、CPUの割り当てが影響している可能性を考えて、reactor_cpu_steal_time_msも見ました。これはDB側が自分で推定している値で、OSやハイパーバイザーが報告するsteal率とは別の指標です。ソースコード上の説明でも、すべてのスケジューリング待ちを拾えるものとは位置づけられていません。25分間のレートに1分(60秒)を掛けて足し上げた算術値は、rack1=21ms、rack2=266ms、rack3=0msで、rack2が最大でした。ただし、障害を含む20:07台の1分は、rack1=0.2833 ms/s、rack2=0、rack3=0で、rack2の山は19:57台や20:05台など、別の時間に出ています。

図4 Reactor CPU stealのレート(全shard集計、ms/s)。各点は1分バケットの開始時刻で、障害を含むのは20:07の点です。ユーザー空間の推定値であり、OSのsteal率とは別の指標です。
やり取りの途中では、rack2を再発原因の最有力候補として扱う説明もありました。時刻を並べ直すと、rack2のstall関連の値は25分を通して高めに推移している一方で、今回の1.5秒の時刻に重なる増加は確認できませんでした。しかも今回の試行先として記録されたのはrack3で、rack3のstall記録は3ノードの中で最小です。rack2の値は気になる点として残しつつ、今回の要求と結ぶ材料は、現時点では持っていません。なお、3ノードのshard数は診断時点で4/1/2と異なっており、全shard合計の値を単純に並べる比較には注意が必要です。
rack3の読み取りヒストグラムを見る
次に、試行先として記録されていたrack3の読み取りレイテンシのヒストグラムを、3ノードで並べました。Prometheus形式のヒストグラムは累積バケットなので、全バケットを足すと重複して数えてしまいます。隣り合うバケットの差を取って区間ごとの件数にし、件数が入っている区間のうち最も大きい側を比べたものが図5です(Prometheusのヒストグラムの説明を参照しました)。

図5 読み取りヒストグラムで最も大きかった非空区間(20:07〜20:10)。横軸はleの原値で、単位は未確認です。
rack3の最上位の区間は(32768, 40960]で、1件が入っていました。rack1は(20480, 24576]、rack2は(2048, 2560]です。この3分間では、3ノードの中でrack3の裾が最も長く見えます。rack3の有限範囲内の1,615件の内訳は、le≦640が1,599件、(20480, 24576]が15件、(32768, 40960]が1件でした。
ただし、このleの単位はまだ確認できていません。仮にマイクロ秒だとすると、最上位の区間は約33〜41ミリ秒で、今回の約1.5秒には届きません。その場合、この3分間のヒストグラムには1秒を超える読み取りが載っていないことになります。サーバー側で完了を記録する前に、クライアントが期限を迎えた要求がヒストグラムに入るのかどうかも確認できていないので、この分布と今回の1件との対応は付けられていません。なお、有限範囲の外側の観測は、今回取得したデータに含まれていません。
CQLエラーと要求数を照合する
アプリ側で期限切れになった要求が、サーバー側のエラーとして残っていないかを見るために、CQLエラーのカウンターも確認しました。25分間、3ノードとも全バケットで増分は0でした。
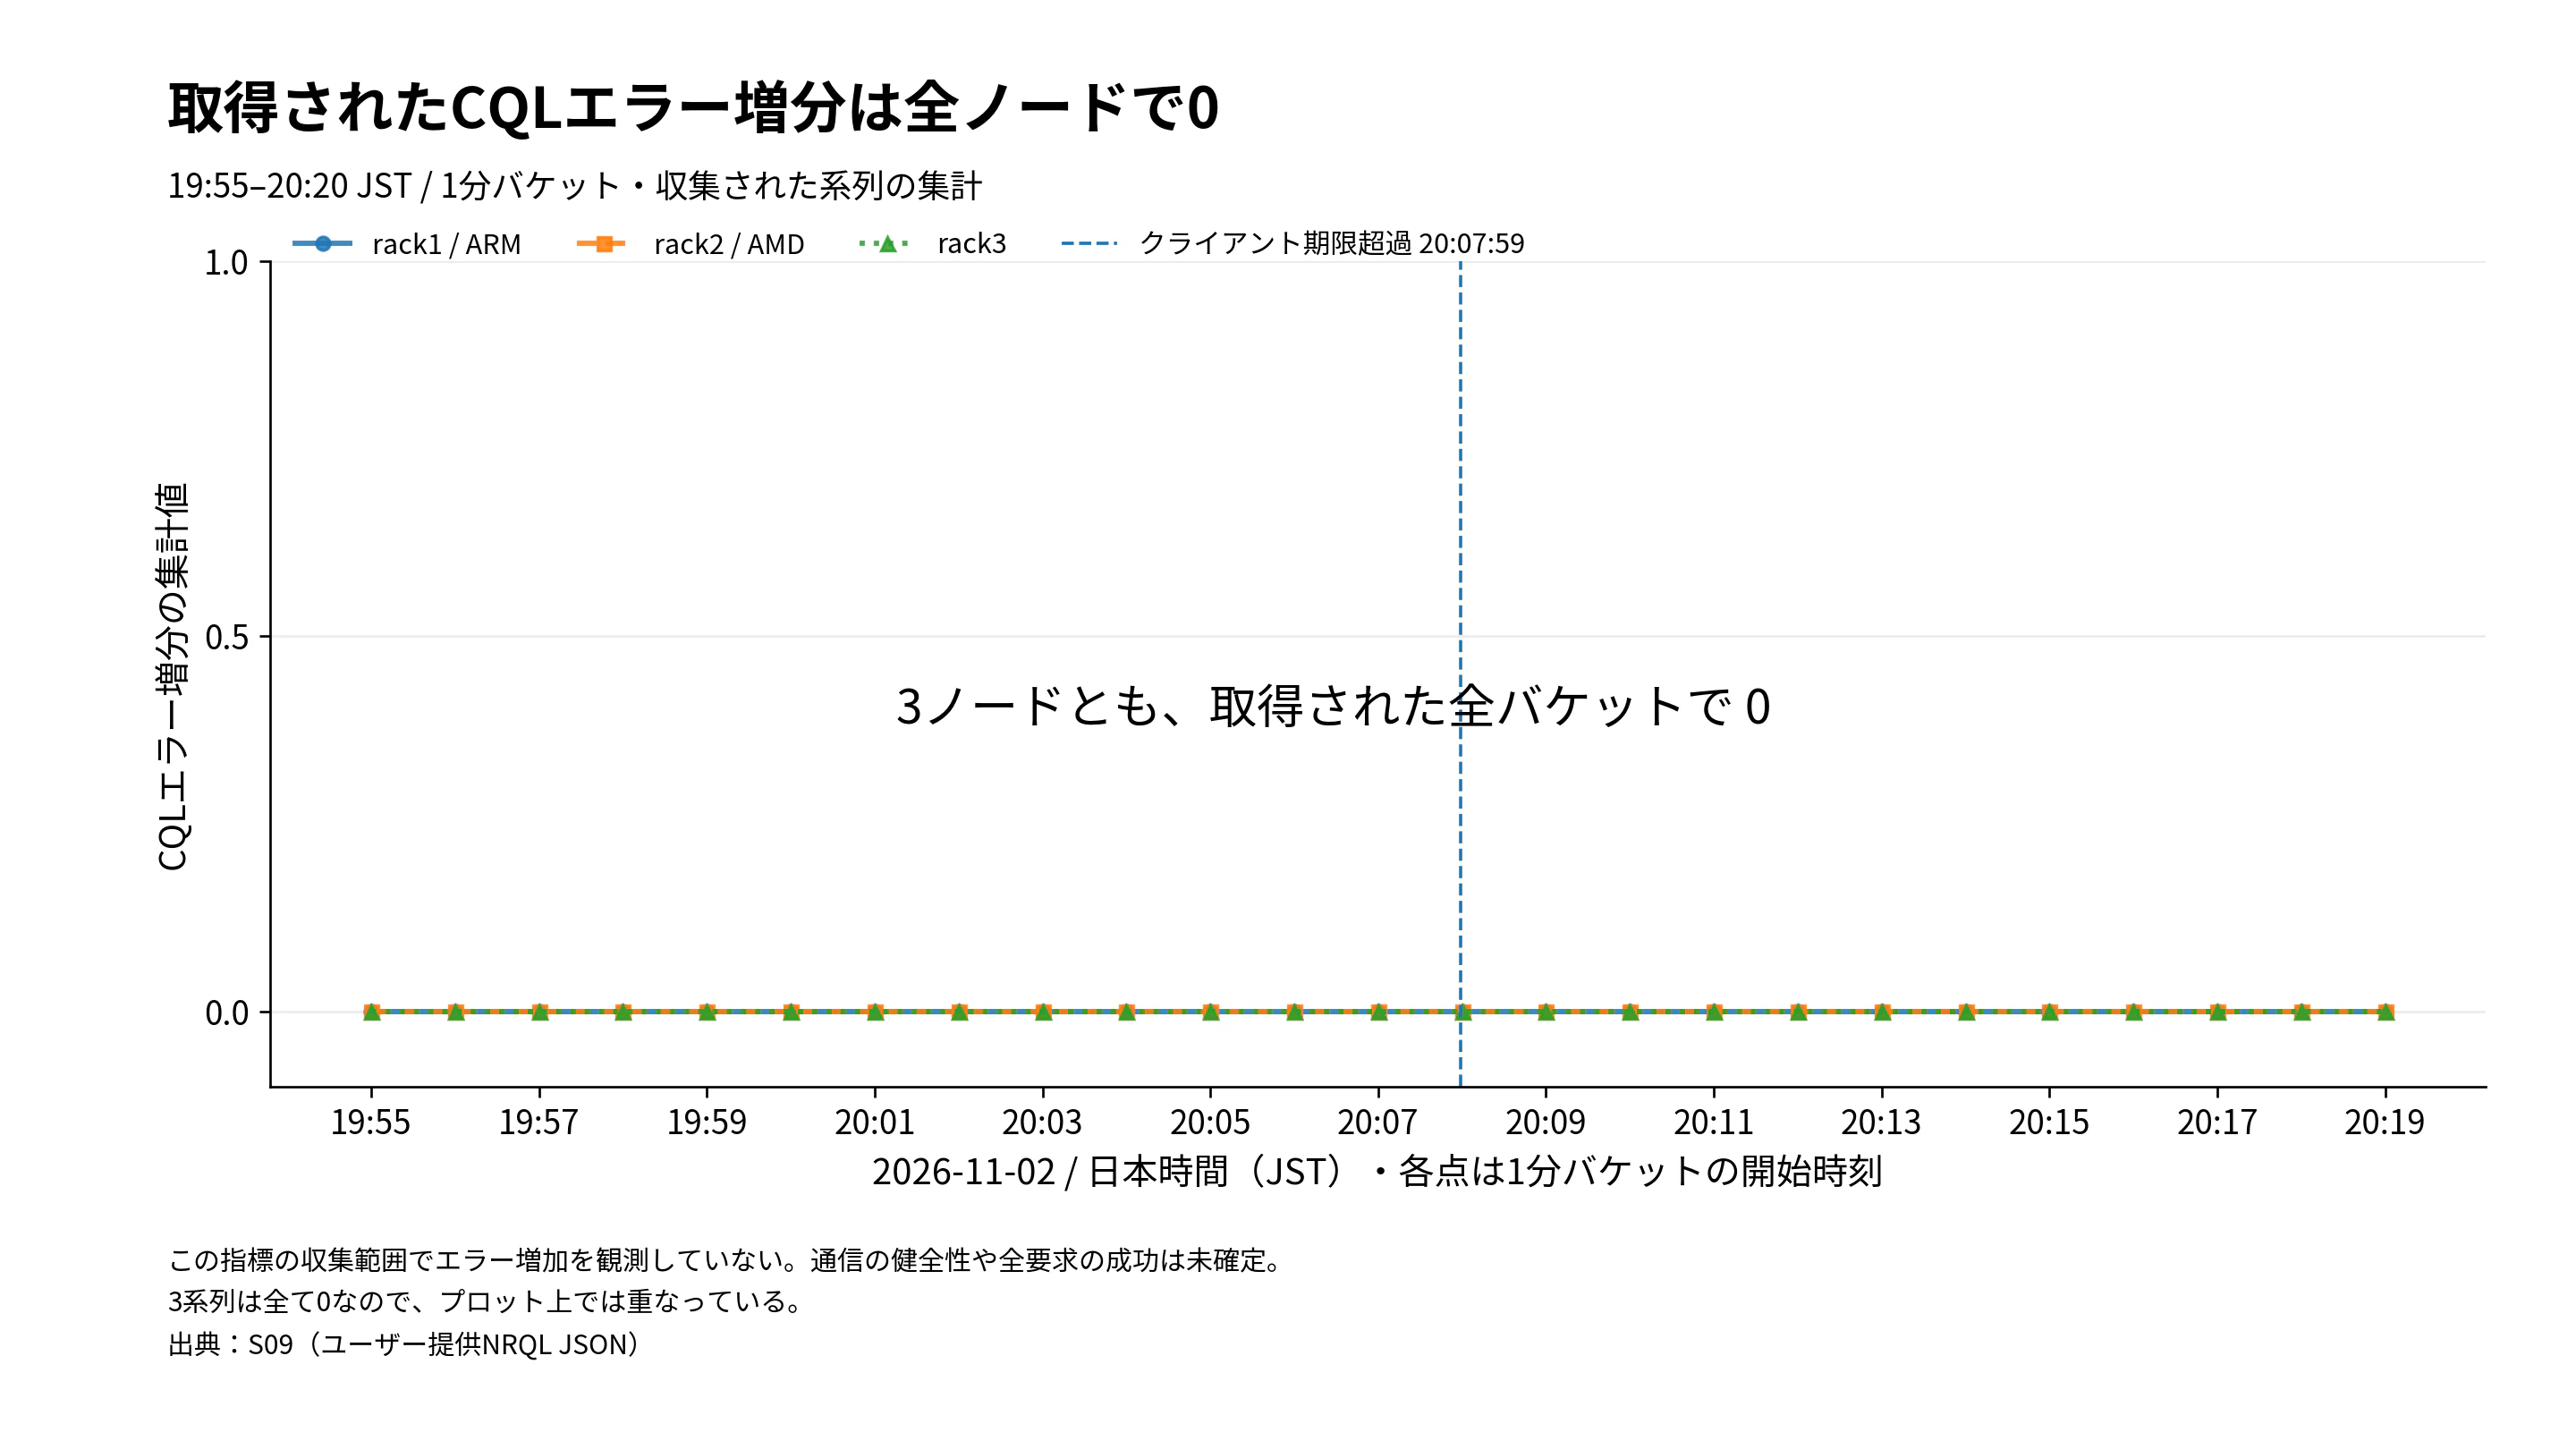
図6 取得されたCQLエラー増分(19:55〜20:20)。3系列とも全て0なので、プロット上では重なっています。
言える範囲は、取得できたエラーカウンターに増加が記録されていない、というところまでです。サーバーに届く前に滞留した要求や、送信後にクライアントが先に期限を迎えた要求がこのカウンターに載るのかどうかは、別の観測で確かめる必要があります。
続いて、同じ時間帯にサーバーが要求を受け続けていたかどうかを、CQL要求数の1分値で見ました(20:05〜20:12の7分間)。
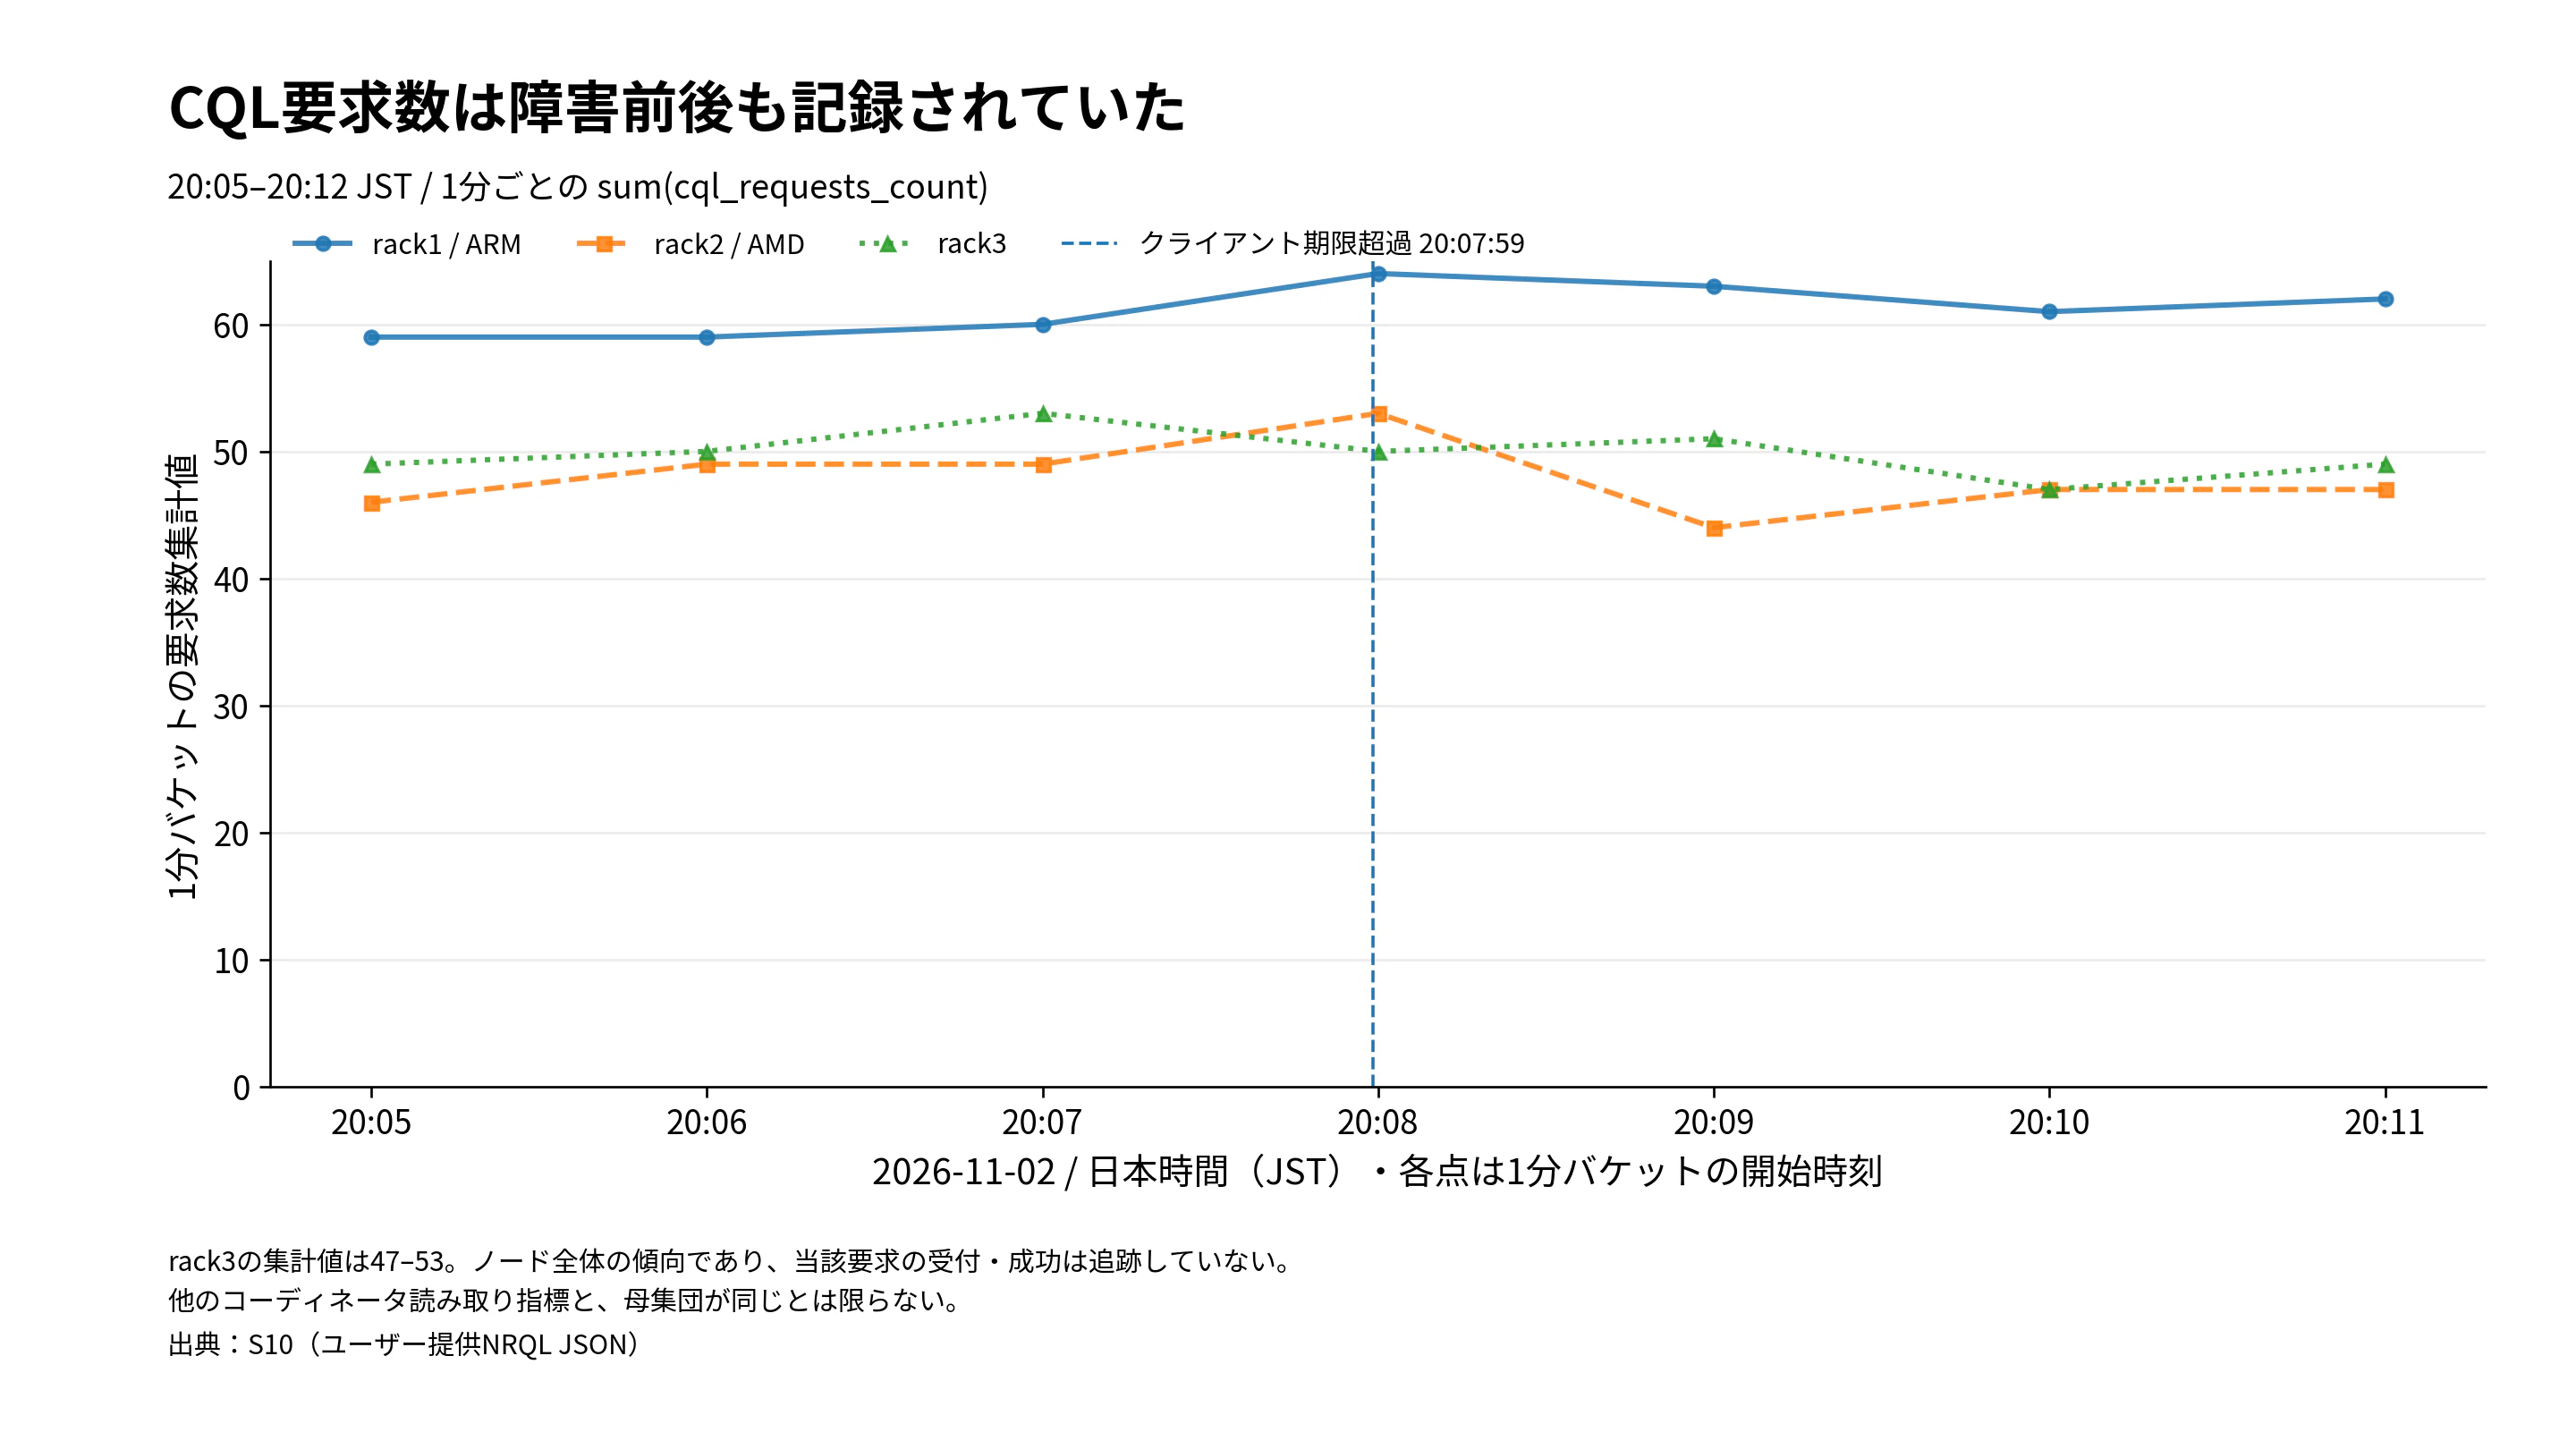
図7 CQL要求数の1分値(20:05〜20:12)。ノード全体の傾向を示す値で、今回の要求が受け付けられたかどうかは追跡していません。
1分あたりの要求数は、rack1が59〜64、rack2が44〜53、rack3が47〜53で、障害を含む20:07台も途切れずに記録されていました。ただし、今回の1件がこの数に含まれているかどうかは追跡できていません。
ここまでの到達点
観測できたこと
- 同じ読み取りで、ドライバの送信API呼び出しは0.401msで戻り、callback待ちは1499.918msで期限に達し、代替DBへの切り替えが成功しました(アプリの記録)。
- 3ノードのメトリクスは
scrapedTargetNameで分けて、同じ時間・同じ対象で比べられました。 - rack2のstall関連の値は、25分間を通して他の2ノードより高めでした。単位は未確認です。
- 障害を含む1分間のReactor CPU stealの記録で、rack2は突出していませんでした。
- 読み取りヒストグラムの裾は、20:07〜20:10の3分間ではrack3が最も長く見えました(
leの原値)。 - CQLエラーの増分は3ノードとも0で、CQL要求数は障害前後も記録されていました。
残る問い
- 約1.5秒の待ちは、どの段階で発生したのか。ドライバ内部、Botのイベントループ、ネットワーク、サーバー内部、レプリカ待ちは、いずれも仮説の段階です。
- rack2の高めの値は、今回の要求と関係があるのか。
-
leや_sumの単位と意味はどうなっているのか。+Infと_countはどう扱われているのか。 - 同じ3分間で、読み取りヒストグラムの有限範囲内の件数(1,566〜1,615)は、CQL要求数の合計(146〜187)のおよそ8〜11倍でした。母集団が異なる可能性がありますが、理由は確認できていません。
- 前回と同じ原因なのか。
次回の最小限の計測
次の1件が遅れたときに、アプリ・ドライバ・通信・サーバーのどこまで要求が進んだかを、同じIDで追えるようにするための案です。まだ実施していません。
- アプリの入口にcorrelation IDと開始時刻(monotonic)を入れ、ドライバ受付・callback・代替DBへの切り替えのログを同じIDでつなぐ。
- callbackの到着時刻を、期限後に届いた場合も含めて記録する。状態を壊さない設計にする。
- callbackからイベントループへの配送待ちと、切り替え後の区間(接続の取得・実行・デコード)を分けて計測する。
- 同じ時刻のBotとDBの間の接続状態・再送・経路変化を残す。
- サーバー側は、対象を安全に絞ったトレースで、受付と完了を同じ要求に対応付ける。
- DBとexporterのバージョン、対象メトリクスのHELP/TYPE、ヒストグラムの+Inf・
_countの扱いを、一度だけ確認して保存する。
仮説ごとに、どの観測が判断材料になるかも整理しました。
| 仮説 | 強める観測 |
|---|---|
| サーバー内部が遅い | 同じ要求の受付から完了までが長い |
| 応答経路が遅い | サーバーの完了からクライアントの受信までが長い |
| ドライバ側が詰まる | 受信済みなのにcallbackが遅い |
| Botのイベントループが詰まる | callback到着後の配送待ちが長い |
| 代替DB側にも待ちがある | 接続取得・実行・配送のどこかに偏りがある |
SQL全文や認証情報は収集せず、サンプリング率と保持期間を決め、診断処理が本処理の待ちを増やさないようにする方針です。
おわりに
New Relicにデータが残っていたおかげで、障害が起きたあとでも同じ時間帯を何度も見直せました。今回の価値は、取得済みのメトリクスを同じ時間・同じ対象にそろえて比べられたことにあったと思っています。ノードごとの値、障害を含む1分、25分の推移を並べて見たことで、rack2が気になるという最初の印象を、時刻を重ねて確かめ直すことができました。
一方で、時刻・対象・集計の意味を確かめる作業が、調査の大きな部分を占めました。ChatGPTにはクエリの作成や数値の整理で助けてもらいましたが、属性・集計関数・凡例の解釈では訂正が必要でした。主なものは次のとおりです。
- CPUグラフのスクリーンショットで凡例を取り違えた読み取りがあり、数値の根拠から外しました。
- 属性名の選び間違いが、「識別属性が無い」という説明になりかけました。
- 返却件数の6から、収集が足りないと推定する説明がありました。
- 有限バケットまでの累積値を、全stall数のように説明する場面がありました。
往復も長くなりました。途中で時間の負担が気になり、追加のクエリを重ねるのを止めて、ここまでの到達点を整理することにしました。その結果、原因は未確定のままですが、次に何を観測すればよいかは書き出せたと考えています。
根本原因の確定は引き続き課題です。次に同じことが起きたときに、1件の要求を最後まで追えるよう計測を足し、効果を確かめられた段階で、改めて記録したいと思います。
付録 再利用できる確認手順
今回の調査で確認が必要だった点を、手順としてまとめます。メトリクス名は一般化しています。
-
検索範囲:返却JSONの
metadata.beginTime/endTimeで、実際に検索された範囲を確認する。画面側の時間指定とクエリ中のSINCE/UNTILが併存していないかも見る。 -
属性:
keyset()で、使える属性名を先に確認する。 -
収集元と対象:
host.hostnameのようなホスト名属性が、収集元を指していないかを確認する。ノードの比較には、対象を表す属性(今回はscrapedTargetName)を使う。 -
件数の意味:
count(*)の返却値は、メトリクス型によって意味が変わる。報告されたデータポイント数はdatapointCount()で確認する。 -
ヒストグラム:
leは文字列で返るので、数値に直して並べる。累積なので、区間ごとの件数は隣り合う値の差を取る。+Infと_countが取れているかを先に確認し、取れていなければ「最大の有限バケットまでの値」と呼ぶ。 -
latest():複数の系列をまとめたlatest()は、合計を保証しない。今回、接続数のlatest()はrack1=9、rack2=9、rack3=0と返りましたが、同じ時間帯にrack3のCQL要求数が記録されていたので、ノードの総接続数としては読んでいません(NRQLの関数の説明を参照しました)。 -
_sum:名前に_sumが付いていても、時間や回数と決めつけず、単位と集計仕様を確認する。 - 時刻:UTCとJSTを混ぜない。1分バケットの点は開始時刻で、20:09の点は20:09:00〜20:10:00の集計を表す。
bucketPercentile()はnullを返したため、有限バケットを直接比較する方針に切り替えました。原因は検証していませんが、バケット属性がleであることと、公式のドキュメントでhistogram.bucket.leが説明されていることの形式差が、説明の候補になります(Prometheus指標の参照)。
今回使った形を一般化したNRQLの例です。
-- 属性の確認
FROM Metric SELECT keyset()
WHERE metricName = '<bucketメトリクス名>'
SINCE '2026-11-02 11:07:00+00:00' UNTIL '2026-11-02 11:10:00+00:00'

-- 収集元と対象の確認(返却値は型により意味が変わる)
FROM Metric SELECT count(*)
WHERE metricName = '<メトリクス名>'
FACET host.hostname, scrapedTargetName
SINCE '2026-11-02 11:00:00+00:00' UNTIL '2026-11-02 11:15:00+00:00' LIMIT MAX

-- ヒストグラムをノード別・le別に取得(取得後に数値順へ並べて差分化)
FROM Metric SELECT sum(<bucketメトリクス名>)
WHERE metricName = '<bucketメトリクス名>'
FACET scrapedTargetName, le
SINCE '2026-11-02 11:07:00+00:00' UNTIL '2026-11-02 11:10:00+00:00' LIMIT MAX

-- カウンターのレート(1分バケット)
FROM Metric SELECT rate(sum(<counterメトリクス名>), 1 second)
WHERE metricName = '<counterメトリクス名>'
FACET scrapedTargetName TIMESERIES 1 minute
SINCE '2026-11-02 10:55:00+00:00' UNTIL '2026-11-02 11:20:00+00:00'