

「応答が遅いのは、あのノードのせいだろう」
そう考えながら、私は何週間もScyllaDBを調べていました。
ノード別に速度を測り、CQL tracingを確認し、Botにはタイムアウトの場所や処理時間の内訳を記録するログまで追加しました。それでも、遅くなった場所は分かっても、なぜ遅くなるのかを説明できませんでした。
私は高校生で、個人開発のDiscord Bot「Disnana」を運用しています。専任のインフラ担当はいません。分からないことを調べながら、原因を推測しては検証する毎日でした。
転機になったのは、10月30日に導入したNew Relicと、調査を一緒に進めたChatGPTです。最初はNew Relicの画面を私が操作してAIに数値を伝え、後にはNew Relicの公式MCPを使った自作のChatGPT連携ツールから直接調べるようになりました。
11月5日には、CPU stealが最大76.16%になり、ScyllaDBのノード間RPCタイムアウトも増えた時間帯を確認しています。
この記事で伝えたいのは「AIが障害原因を一発で当てた」という話ではありません。約1か月半の試行錯誤を、観測値と自分の思い込みの両方から見直した記録です。原因の有力な手がかりは得られましたが、ハイパーバイザー側の根本原因と個々のBotエラーとの因果関係はまだ確定していません。
この記事で持ち帰れるもの:クライアント側の詳細ログでも見えない範囲、New Relic導入前後の調査の違い、CPU stealの調べ方、AIの回答を検証する方法、障害時にサービスを維持するための次の一手。
1. 9月18日から11月5日まで、何をしていたのか
ScyllaDBの導入を相談し始めたのは2026年9月18日。11月5日まで約48日、ほぼ1か月半です。48日間ずっと障害が起きていたわけではなく、導入・構築・性能調査・再発への対応を続けた期間です。
| 時期 | やったこと・起きたこと | そのときの判断や課題 |
|---|---|---|
| 9/18 | 高速性と耐障害性を求め、3ノードのScyllaDB構成を検討 | 「複数ノードなら安心」という期待から開始 |
| 9/25 | セットアップ、1GBメモリーノードの起動・クラスタ参加を調整 | shardあたりのメモリー不足、ネットワークの問題に直面 |
| 9/26 | コーディネータ別の書き込み遅延を調査 | 遅いノード・通信経路・性能を疑う |
| 10/23 | 読み取りが1.5秒の期限を超え、PostgreSQLへの切り替えに成功 | 障害時の逃げ道はあったが、原因は未特定 |
| 10/24 | 3ノードのCQL読み取りp95を比較 | 外から遅く見えるrack3を強く疑った |
| 10/30 | New Relicを導入、ChatGPTと約30分集中調査 | 内部で気になるノードがrack2に変わった |
| 10/30〜31 | Botの詳細ログやイベントループ停止を調査 | DB待ちに加えてBot側の停止も見えてきた |
| 11/2 | Reactor stall、CQLエラー、読み取り関連指標を照合 | 同じ時刻・同じ対象で比較する重要性を実感 |
| 11/4 | New Relic × ChatGPTの自作連携から直接調査 | 1.1秒の読み取り遅延周辺でCPU steal最大72.20%を観測 |
| 11/5 | 午前と午後の再発を比較 | CPU steal最大76.16%、RPCタイムアウトの集中を確認 |
| 現在 | PostgreSQLとの継続同期と、弱いノードの移行を計画 | 改善後の効果測定はこれから |
9月26日に取得したコーディネータ別の書き込みp95も、あるノードが約78.08ms、別のノードは約0.91ms、さらに別のノードは約0.131msと大きく異なっていました。ただし、これはコーディネータから見た書き込み時間であり、遅い値を返したホスト自身が原因とは限りません。当時から「遅く見える場所」と「原因の場所」を分ける必要があったのだと思います。
「1か月半でようやく分かった」と言うより、1か月半で集まったバラバラの材料が、ようやく比較できるようになった、という感覚に近いです。
2. New Relicを入れる前から、ログはかなり増やしていた
遅延が起きるたびに、Bot側では少しずつ計測項目を増やしていました。
10月30日9:36(JST)のある設定読み取りでは、次のように記録できていました。内部IDと接続先は省略しています。
| Botが記録した区間 | 所要時間 |
|---|---|
| 読み取り全体 | 748.36ms |
| 同時処理枠の待機 | 0.018ms |
| 読み取り開始→client | 0.140ms |
| driver送信呼び出し | 0.393ms |
| driver callback待ち | 742.128ms |
| callback→event loop | 0.130ms |
| 設定のデコード・検証 | 5.465ms |
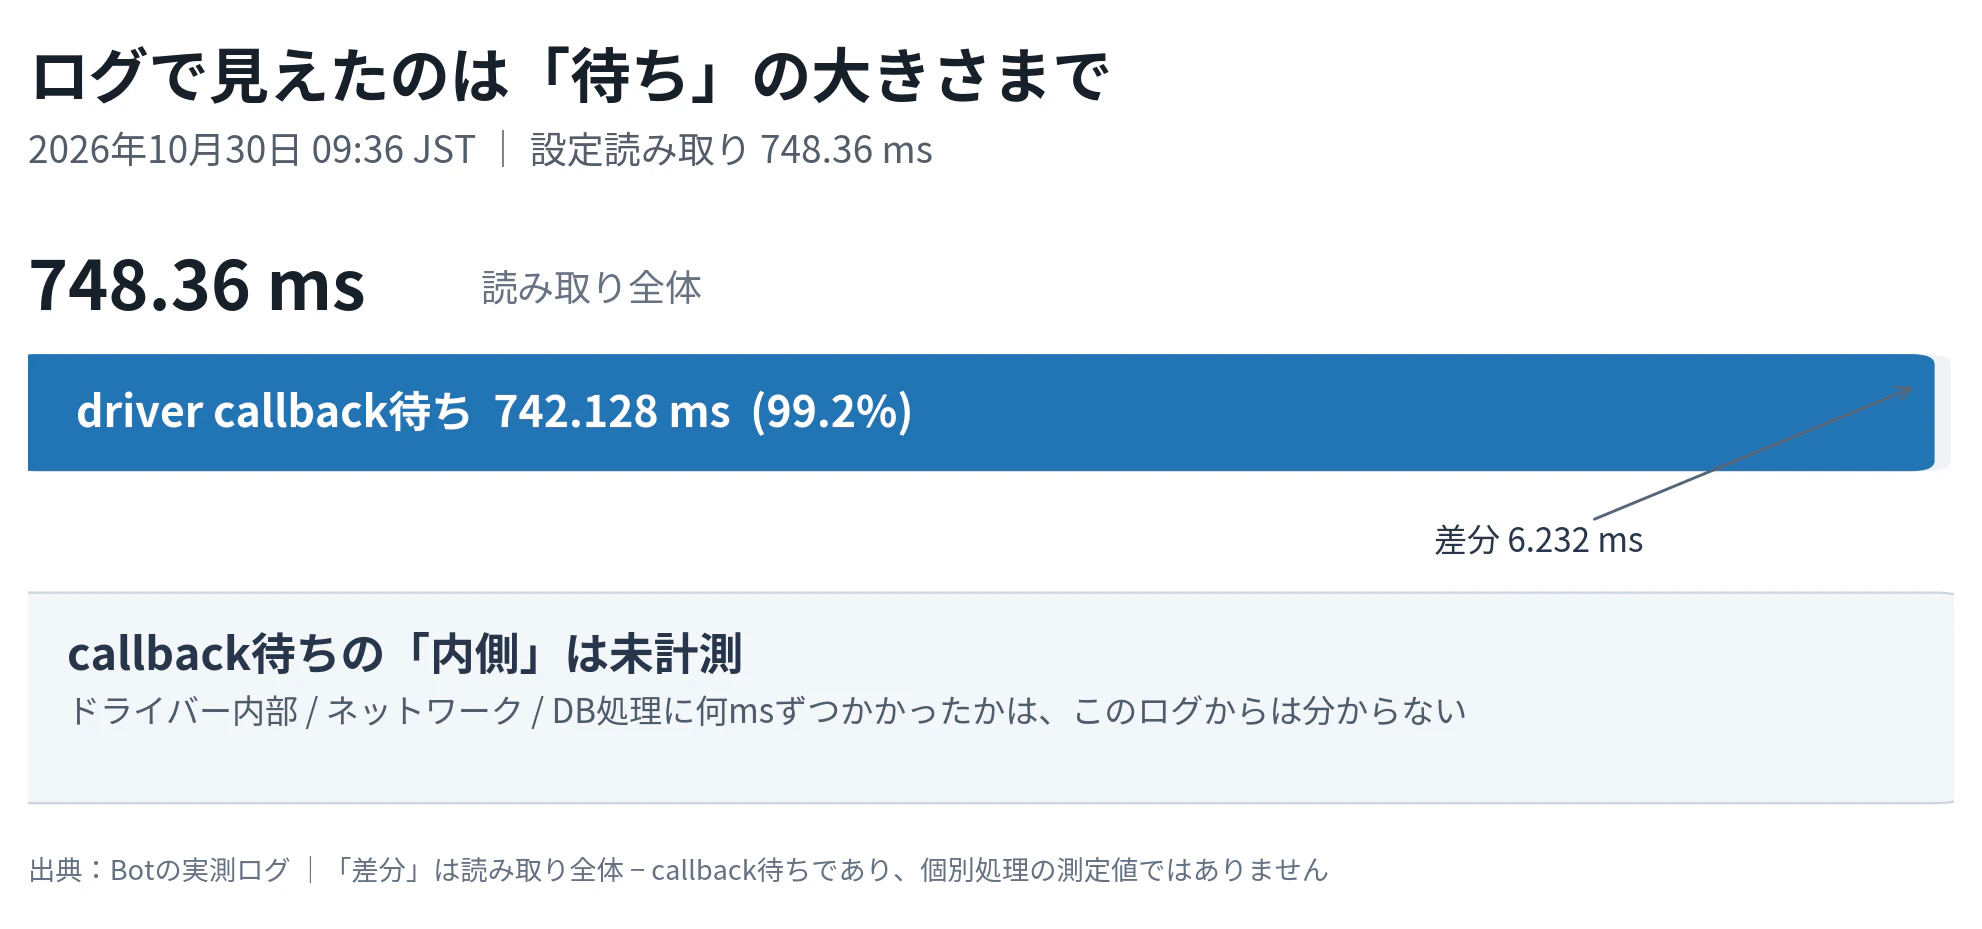
図1:10月30日のBotログから作成。748.36msのうち742.128msがdriver callback待ちで、その内部の待機先は特定できていません。
通知にはhybrid.warn_slow_read、waiting_for_driver_callback、呼び出し経路、警告閾値500ms、切り替え期限1,500msまで残していました。ここまで分かれば、あとは原因を見つけるだけだと思っていました。
ところが、callbackを742ms待ったことと、DBサーバーが742ms処理したことは同じではありません。その間にはドライバー内部、ネットワーク、コーディネータ、レプリカなどが挟まっています。Botのログだけでは、その内訳を測れていませんでした。
さらに10月31日2:39頃には、別の切り分けが必要な事象も起きました。
- Botのイベントループが3.501秒停止
- DBドライバーのcallback待ちが約1.5秒
- callbackからevent loopへの受け渡しに約2.57秒
- PostgreSQLへのフォールバックは成功したものの、処理全体では約5.08秒
イベントループ監視では、同期的なファイルログ出力に関係するスタックが繰り返し観測されました。これも原因確定ではありませんが、「DBが遅い」だけでは済まない証拠です。
計測した場所は増えた。でも計測していない場所は、相変わらず見えない。
今なら当たり前に聞こえますが、当時の自分には大きな盲点でした。
3. 自分が疑っていたことと、実際に分かっていたこと
ここは格好をつけずに書きます。私は原因を調べているつもりで、一度納得した説明を前提に次の調査をしてしまうことがありました。
| 当時の思い込み・偏り | そう考えた理由 | 本来確認すべきだったこと |
|---|---|---|
| 一番遅いノードが悪い | ノード別p95でrack3が目立った | 接続経路、関与したレプリカ、内部の待ちを分ける |
| OSのCPU使用率が低いなら余裕がある | ホスト全体の平均値を見ていた | shard、CPU affinity、CPU steal、実際の割り当て |
| callback待ちが長いからScyllaDBが遅い | Botの内訳ではcallback待ちが大半 | ドライバー・通信・DB内部・イベントループを分離する |
| ログを増やせば原因を掴める | 通知と測定項目が増えていた | どの層の情報が欠けているかを設計する |
| 前に考えた原因を優先してしまう | それまでの調査に時間を費やしていた | 反対の証拠、別ノード、正常期間も見る |
これらは、当時の全判断を一字一句再現したものではなく、残っているログと調査過程を読み返した今の反省です。
実際、10月24日の外形CQL計測では次の結果でした。
| 接続先 | ONE p95 | QUORUM p95 |
|---|---|---|
| rack1 | 約9.3ms | 約11.4ms |
| rack2 | 約10.1ms | 約11.8ms |
| rack3 | 約25.6ms | 約48.9ms |

図2:10月24日の外形読み取り計測。接続先別p95で、同日のNew Relic計測ではありません。
ここからrack3を疑うのは自然だと思います。ただしQUORUMには複数レプリカやネットワークも関係します。「接続先が遅い」と「そのノードが原因」は違います。
4. 10月30日、New Relicを初めて使って驚いたこと
そこで導入したのがNew Relicです。
- Infrastructure AgentでOS・VM側のCPU、I/O、メモリーを収集
- PrometheusメトリクスでScyllaDB内部のReactorなどを収集
- OS・ScyllaDBのログも、発生時刻を起点に照合
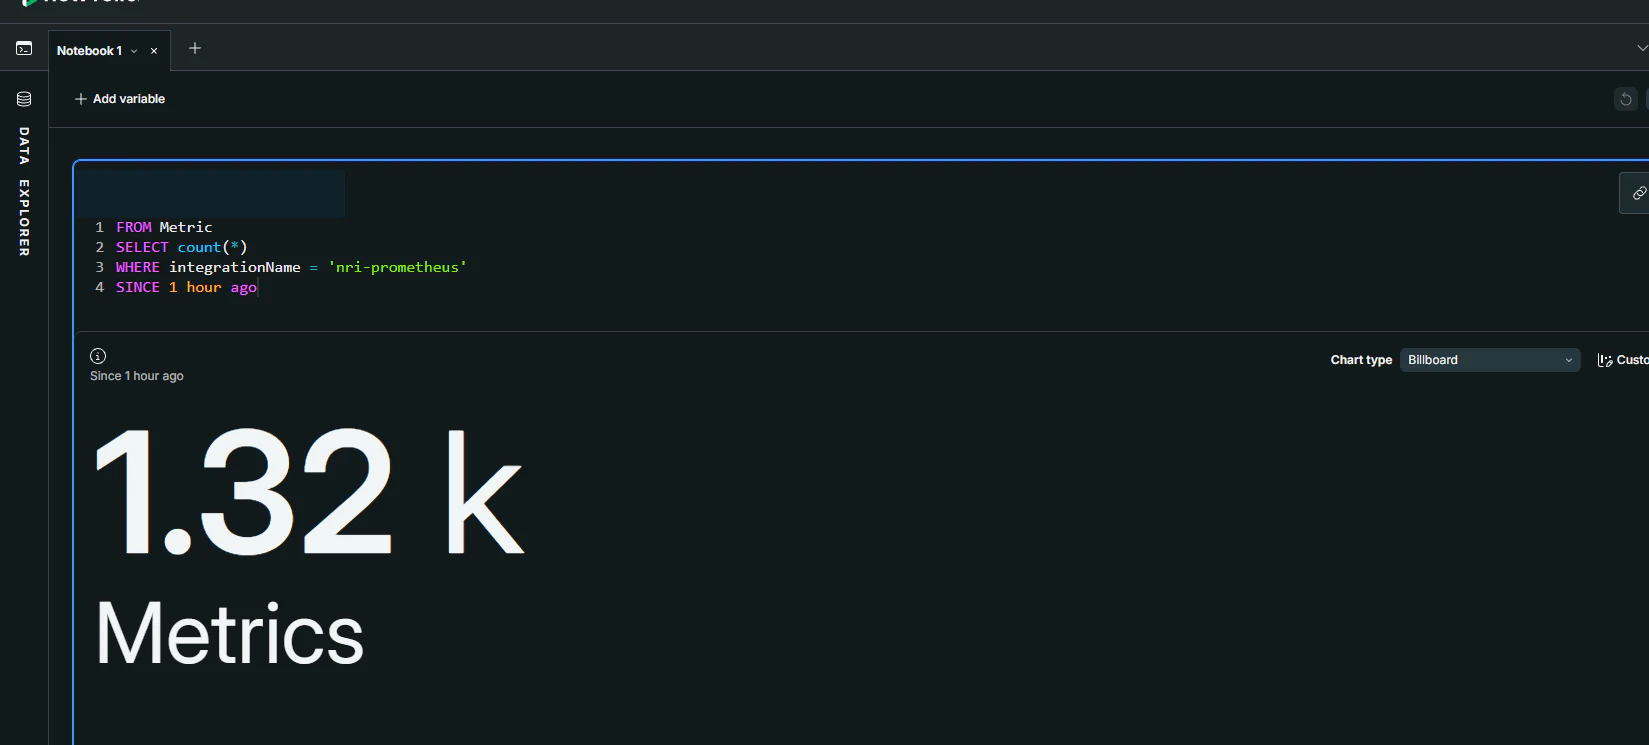
図3:10月30日に使用したNew Relicの画面例。Prometheusメトリクスの取り込み確認であり、rack2のCPU分析結果ではありません。
もちろん導入するだけで原因が出るわけではありません。最初は画面に指標がたくさんあって、どこを見るか分からず、NRQLの書き方もほぼ知りませんでした。
そこでChatGPTに日本語で相談し、教わったNRQLを自分でNew Relicの画面に入力して結果を見比べました。これが10月30日の「約30分」の調査です。この時点でAIがNew Relicを直接操作していたわけではありません。
驚いたのは、rack3とは別のrack2の内部状態でした。OS全体のCPU使用率は平均約9.7%だった一方、ScyllaDBは--smp 1で動作し、CPU affinityも1 CPUだけ。Linuxからは2 CPU見えていました。
「ホスト全体のCPUには余裕がある」ことは、「ScyllaDBの実行環境に余裕がある」ことを意味しません。
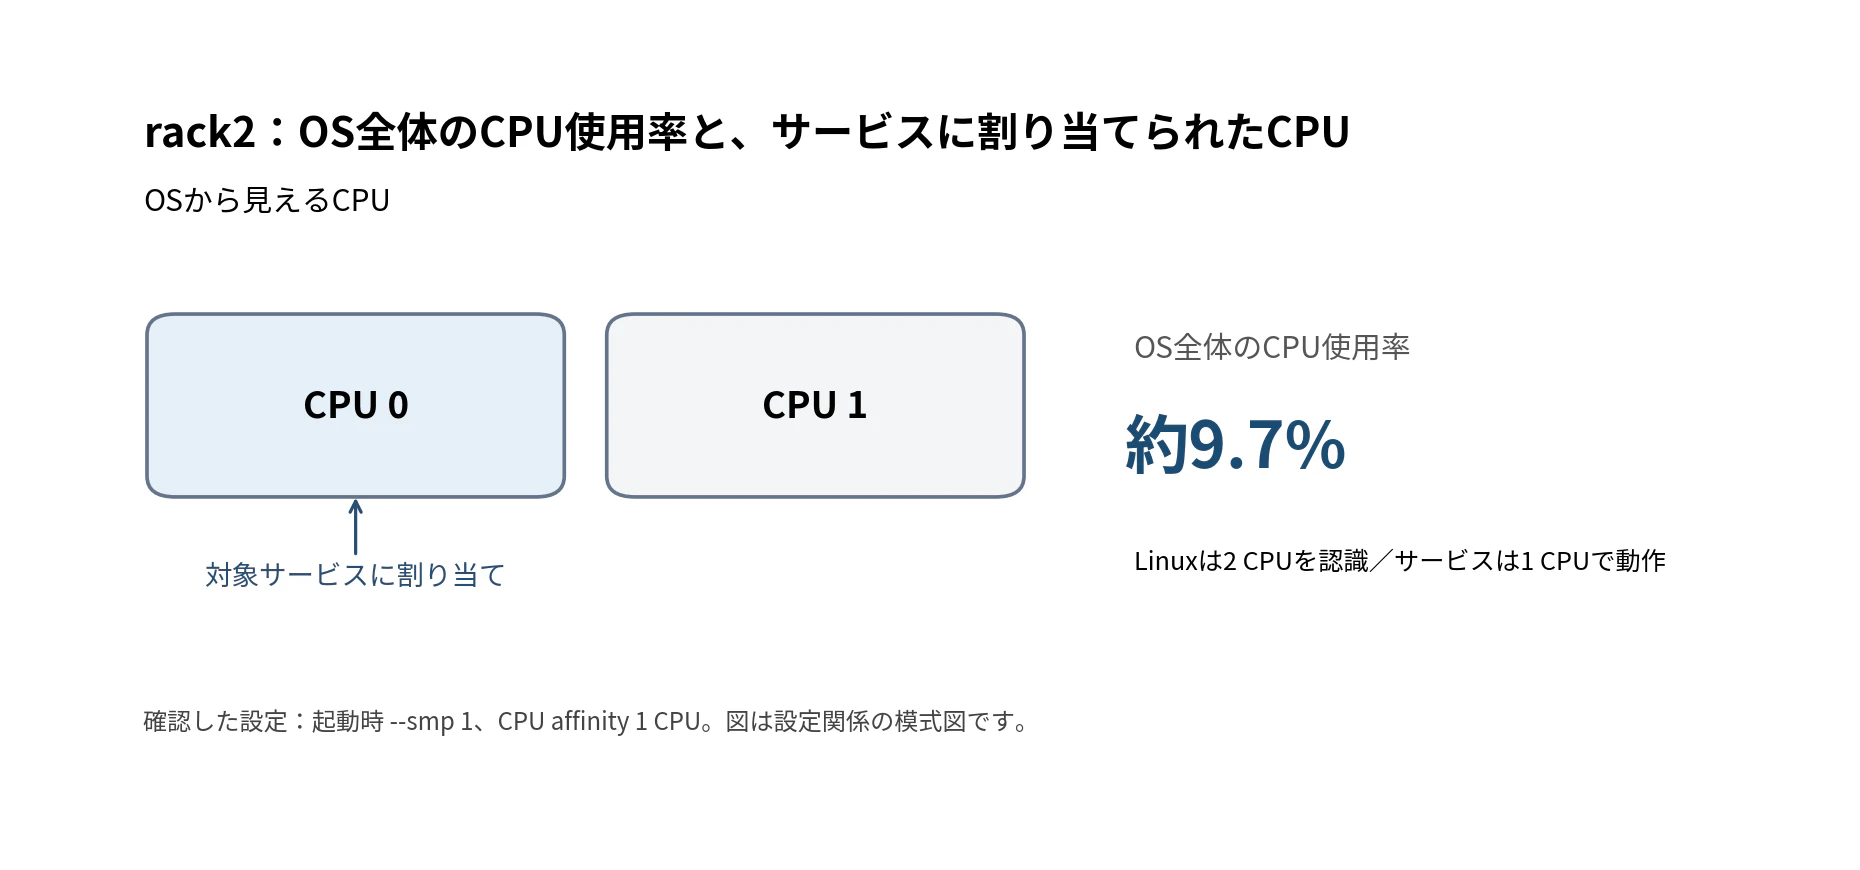
図4:10月30日に確認したrack2の設定をもとにした模式図。Linuxからは2 CPUが見えていても、ScyllaDBは1 CPUで動作していました。
約30分で根本原因を解決したわけではありませんが、数週間持ち続けた調査の前提を見直す手がかりが得られました。
なお、rack3の外形p95とrack2の内部メトリクスは別日時の計測です。同時刻の因果関係を示すものではありません。この切り分けは既存記事にも詳しくまとめています。
5. 11月の再発を、今度は同じ時刻で追ってみる
10月30日に手がかりを得ても、遅延は再発しました。
11月4日23:20:31には、設定のSELECTが1,094.104msかかり、そのうち1,092.285msがdriver callback待ちでした。この時刻をNew Relicで追うと、AMDホストでCPU steal最大72.20%、同じ時間帯のCPU iowaitやディスクI/O指標の上昇を確認。アプリ通知から約32秒後には、ScyllaDBのfailure detectorがRPCタイムアウトを記録していました。
そして翌11月5日。午前と午後に似た現象が起きたため、同じ指標を並べて比較しました。
| 実際に取得した指標 | 11/5 11:57頃 | 11/5 15:31頃 |
|---|---|---|
| AMDホストのCPU steal最大 | 63.88% | 76.16% |
| CPU stealの最大1分平均 | 39.71% | 55.07% |
direct_failure_detectorのRPC timeoutログ |
23件 | 60件 |
| Reactor stall関連指標 | 増加 | 継続的に大きく増加 |
RPCタイムアウトの件数は午前が11:57台の集中発生、午後が15:20〜15:42の検索範囲で確認した値です。集計時間幅が異なるため、件数の大小だけで障害規模を比較することはできません。
午後は15:26〜15:34の各1分間で、CPU steal平均が約49〜55%になっていました。同じ時間帯、比較対象のほかの2ホストのCPU stealは平均約0.2%でした。

図5:New Relic SystemSample の2026年11月5日15:20〜15:41 JSTの実測。1分単位の平均と最大を表示しており、最大76.16%を確認できます。
15:31「だけ」が悪いのではなく、その前後に数分間続く資源待ちとノード間通信異常が見えてきたわけです。
ただし、表のRPC timeout件数はログの検出件数で、失敗したユーザー操作の数ではありません。ReactorのSummary形式メトリクスも、そのNRQL返却値をそのままstall回数とみなすことは避けました。
問題のノードは、どんなインスタンスだったのか
New RelicのSystemSampleを調べると、CPU stealが目立ったホストはOracle CloudのVM.Standard.E2.1.Microでした。メモリーは約1GBで、Oracle公式の説明ではCPUの基準割り当ては1/8 OCPUです。
比較対象にはArmのA1.Flexもありましたが、これは「AMDだから遅い、Armなら速い」という比較ではありません。そもそもインスタンスに割り当てられたリソースが違います。
CPU steal、I/O wait、Reactor関連指標、RPCタイムアウトが時間的に重なったことから、仮想CPUの実行機会を十分に得られない状態がDBの処理や通信に影響した可能性を優先して調べたいと考えています。
一方で、仮想化ホスト側の状態は確認できていません。Bot側の個々のエラーと各RPCタイムアウトの対応も取れていません。原因の有力な手がかりは見つかったが、根本原因を断定できる段階ではない、というのが現在の結論です。
6. ChatGPTからNew Relicを直接調べられるようにした
10月30日は私がNew Relicの画面を操作し、見えた数値をChatGPTに伝えていました。便利な反面、AIが「次はこの指標を見て」と提案するたびに、私が画面へ戻って結果をコピーする必要がありました。
そこで11月4日頃、New Relicの公式MCP Serverを利用する、自分専用のNew Relic × ChatGPT(非公式)を整備しました。
ChatGPT
  └─ 自作New Relic × ChatGPT Plugin
       └─ 所有者限定のChatGPT Site / MCP
            └─ New Relic公式MCP
                 ├─ Metric・NRQL
                 ├─ Log
                 └─ アラート等の参照
今度は「11月5日の15:31頃に異常があった。CPU stealとScyllaDBの通信ログを比較して」と伝えると、ChatGPTが読み取り専用のNRQLを実行し、追加の指標も調べられるようになりました。
この構成で私が便利だと感じたのは、過去の時刻を指定するだけで、必要なログとメトリクスを会話の中で掘り下げられることです。調査に戻るたびに監視画面とAIの間で情報を転記する作業が減りました。
New Relicが担当するのは観測データを集め、検索できる状態にすること。ChatGPTは問いとクエリを組み立て、仮説を比較すること。そして最終的に意味を判断するのは自分です。
これを自分以外の人も試せるよう、ソースを公開しています。
自作PluginはNew Relic・OpenAIの公式Pluginではありません。各利用者が所有者限定の環境を作る想定で、第三者環境の初回セットアップや全端末での動作には未検証の部分があります。今回New RelicのAutopilotを使ったわけでもありません。
7. 読者が自分の環境で試すなら:再発を追ったNRQL
実際に11月5日の再発を調べた際のクエリを、公開用に整理したものです。環境にSystemSampleとScyllaDBのログが取り込まれていることが前提です。時刻はJST(UTC+09:00)を明示しています。
① まずCPU stealとI/O waitを時刻別・ホスト別に見る
SELECT average(cpuStealPercent), max(cpuStealPercent),
       average(cpuIOWaitPercent)
FROM SystemSample
FACET hostname
SINCE '2026-11-05 15:20:00+09:00'
UNTIL '2026-11-05 15:42:00+09:00'
TIMESERIES 1 minute
② DBのRPCタイムアウトが増えた時刻を確認する
SELECT count(*)
FROM Log
WHERE message LIKE '%direct_failure_detector%'
SINCE '2026-11-05 15:20:00+09:00'
UNTIL '2026-11-05 15:42:00+09:00'
TIMESERIES 1 minute
③ メトリクス名と属性を先に確認してから、ノード比較へ進む
SELECT keyset()
FROM Metric
WHERE metricName LIKE 'scylla_%'
SINCE '2026-11-05 15:20:00+09:00'
UNTIL '2026-11-05 15:42:00+09:00'
この確認は地味ですが大事です。今回のScyllaDBメトリクスでは、host.hostnameがScyllaDB自身ではなく収集元ホストを表すことがありました。そのままノード比較に使うと、3ノード分を一つにまとめてしまいます。収集ターゲットを示すscrapedTargetNameなど、実際に返ってきた属性を確かめてから比較しました。
また、scylla_reactor_utilizationに1を超える値が返るケースや、scylla_reactor_stalls_sumがSummary形式であることも確認しています。見た目の数値を勝手にCPU使用率やstall回数に置き換えないようにしています。
この手順を自分の環境で使うときは、検索期間の前後、データ欠損、同一時刻の正常区間も確認してください。New RelicのNRQL公式リファレンスも役立ちます。
AIに渡しているのは「答えを出せ」ではなく「反証も探して」
例えば、次のような形で相談すると、思い込みを見直しやすくなりました。
○月○日○時頃に読み取り遅延が発生しました。
New RelicにあるOS・DB・通信ログを同じ時間帯で比較してください。
正常期間と別ノードも確認し、最初の仮説に反する証拠も探してください。
各結論に、実際のNRQL・対象期間・メトリクス名を付けて、
「観測事実」「有力な仮説」「未確認」を分けて報告してください。
※これは読者向けに整理した例文で、過去に送信した一字一句そのままのプロンプトではありません。
8. New Relicを使って、何が一番変わったか
宣伝文句のように聞こえるかもしれませんが、使い始めて一番ありがたかったのは必要なデータが同じ場所にあることでした。
| 導入前 | 導入後 |
|---|---|
| アプリの通知から、待った区間を推測 | 通知時刻を起点にOS・DB・ログを横断照会 |
| ノードごとのコマンド結果やログを個別に確認 | メトリクスを同じ期間で並べて比較 |
| OS平均CPUだけで考えがちだった | CPU steal、I/O、shardの状態も確認 |
| ChatGPTに数値を手で伝えていた | 後に公式MCP経由で読み取り専用NRQLを直接照会 |
| 次に疑う場所が曖昧 | 検証したい仮説と必要な指標が具体化 |
もう一つ驚いたのが無料プランです。New Relic公式によると、月100GBのデータ取り込み、フルプラットフォームユーザー1名、無制限のBasicユーザーなどが用意され、クレジットカードなしで始められます。今回、個人で3ノードを調べるうえで、この無料枠が大きな助けになりました。利用条件と取り込み量は公式料金ページを確認してください。
高校生だからという理由で運用の問題が簡単になるわけではありません。それでも、初めてNew Relicを触った自分が、実際の障害についてここまで調べられました。学生だけでなく、個人開発や少人数でサービスを運営する人にも、一度試してみてほしいです。私自身、卒業してからも使い続けたいと思っています。
もちろん「1か月半の調査が30分で終わった」わけではありませんし、同条件で工数削減率を計測したものでもありません。約30分で調査の向きが変わり、MCP連携で情報の受け渡しが減った、というのが実際の成果です。
9. 見つけた手がかりを、止まりにくい設計へつなげる
調査が進んでも、Botが止まってよいわけではありません。今は「どうして遅いか」の調査と並行して、「遅くてもサービスを続ける」設計を優先しています。
PostgreSQLへの読み取りフォールバック自体は既にあります。 10月23日には、ScyllaDBが期限を超えた後、PostgreSQLからの読み取りに成功していました。
今後必要なのは、より安全な非常時動作です。
- ScyllaDBの読み取りに、サービス全体の応答目標から決めた期限を設ける
- 一定期間の失敗時は一時的にScyllaDBへの問い合わせを抑える
- PostgreSQLへ新しいデータを継続的に反映し、切り替え時の鮮度を確保する
- 更新ID・バージョンなどを使い、重複書き込みや古いデータでの上書きを防ぐ
- 復旧後に差分を検査し、安全に整合性を取る
特に認証・権限・課金のような情報では、古い値を返すリスクを別に考える必要があります。書き込みのタイムアウトは「失敗した」とは限らないため、再試行の冪等性も必要です。
合わせて、極端なCPU stealを観測したAMD Microノードの移行も検討しています。候補はVPSやRaspberry Pi+SSDなど。ただし移行しただけで改善したとは書けません。同じ指標で移行前後のCPU steal、p95・p99、RPCエラー、フォールバック発生回数を比較するのが次の仕事です。
ここから先は実装と効果測定が未完了の計画です。進捗が出たら、別の記事で数字とともに報告したいと思います。
10. 未来の自分のための、障害調査チェックリスト
- 発生時刻・利用者影響・対象操作を記録したか
- 正常な時間帯と異常な時間帯を同じ条件で比較したか
- クライアントの「待ち」とDB内部の処理時間を混同していないか
- OS CPU平均だけでなく、CPU steal・I/O wait・割り当てCPUを見たか
- 収集元ホストと監視対象ノード、単位と集計関数を確認したか
- 最初の仮説と反対の証拠も探したか
- 観測事実・仮説・未確認を分けたか
- 切り替えや修正後の効果を同じ指標で測る予定があるか
チェックリストを残すのは、同じ失敗を繰り返さないためです。
おわりに
最初は、高速で壊れにくいデータベースを作るつもりでした。気づけば、起動設定、ネットワーク、タイムアウト、イベントループ、CPUの割り当てまで調べていました。
私は「遅い」という結果を見て、原因もそこにあると思い込んでいた部分があります。ログを増やす努力は無駄ではありませんでしたが、観測していない層を想像で埋めてしまっていたのだと思います。
New RelicがOS・DB・ログをつなげてくれたことで、初めて見えるようになったものがありました。ChatGPTは、知らなかった指標や別の仮説を考えるきっかけをくれました。そしてAIが間違えることもあるからこそ、実測と照合する姿勢が必要でした。
1か月半かけて学んだのは、最初から正しい原因を知ることではなく、自分の考えを観測した事実で修正していくことでした。
次の目標は、この知見を使ってBotを安定稼働させることです。
参考資料
- New Relic公式サイト・無料プラン
- New Relic公式Ground Truth(MCP)
- NRQL公式リファレンス
- Oracle Cloud Always Freeリソース
- 自作 New Relic × ChatGPT OSS
この記事の観測値は、当時のBot通知・New Relicの取得結果と公開済みの調査記録に基づいています。内部IP、識別子、機密情報は省略しています。New RelicとChatGPTの連携ツールは非公式の個人開発OSSです。