

【PR】本記事はBright Dataの依頼により執筆しています。
検証の設計・測定・結果の解釈は筆者が行っており、Bright Dataに有利でない結果もそのまま掲載しています。
責任ある利用について
本記事の検証対象は、筆者が運営する公開ブログと、スクレイピング学習用に公開されているテストサイト(ScrapingCourse)です。ログイン、非公開データへのアクセス、サイト全体のクロールは行っていません。
Bright Dataは、公開Webデータを対象とする方針と許容利用ポリシーを公開しています。これは、個々の取得行為の適法性を保証するものではありません。対象サイトの利用規約・robots.txtを確認し、著作権・個人情報保護・不正アクセスに関する法令などを守る責任は利用者自身にあります。本記事は、規約や法令に反する取得を推奨するものではなく、法的助言でもありません。
Pythonでスクレイピングを書くなら、まず requests + BeautifulSoupを使い、JavaScriptの実行が必要ならPlaywrightを使うのが一般的な選択です。小規模な取得であれば、requests + BeautifulSoup、またはPlaywrightで必要なデータを取得できる場合があります。
サイト側でCloudflareなどのアンチボット対策が実際に動き始めた場合に、プロキシやブラウザ実行、ブロック対応、リトライといった取得経路の維持と、抽出器の実行をBright Dataのクラウドへ任せる価値がどこにあるのかを、requests、Playwright、Bright Dataで比較しました。Bright Dataからは、取得を任せるWeb Unlockerと、取得から抽出までを任せるScraper Studioの2製品を使っています。
▶ Bright Data Scraper StudioでCloudflare保護ページの取得を試す(専用リンク・カード登録不要)
本測定は、チャレンジが発生しない公開ブログの40試行と、チャレンジが返る学習用テストページの30試行、合計70試行です。Collectorの準備やWeb Unlockerの補助診断は、合計70試行に含めていません。
この検証の結論は何か?
今回の公開ブログ2ページではrequestsが最も速く、保護付きテストページ2URLでは、requestsとPlaywrightがそれぞれ0/10、Scraper Studioが7/10で目的の本文に到達しました。
- Cloudflare配下のブログ(チャレンジなし)では、4方式すべてが10/10で成功し、requestsの時間中央値が0.500秒で最短でした。
- 保護付きテストページ2URLでは、requestsとローカルPlaywrightが0/10、Scraper Studioが7/10でした。
- Scraper Studioは一発では完成せず、Collector生成の失敗、Self-Healing、タイムアウト、抽出不備を経験しました。
Scraper Studioの価値は、取得・抽出・実行基盤をクラウドへ移し、requestsとローカルPlaywrightが到達できなかったテストページでも取得を試せる点にあります。速度は、チャレンジが発生しない公開ブログ2ページでrequestsが最短でした。検証日は2026年10月24日(JST)です。
どの4方式を比較したのか?
requests、ローカルPlaywright、Bright Data Web Unlocker、Bright Data Scraper Studioの4方式を用意し、実験1では4方式すべてを測定しました。実験2の本測定はWeb Unlockerを除く3方式で行い、Web Unlockerは補助診断のみ実施しました。
| 方式 | 内容 |
|---|---|
| requests |
requests + BeautifulSoup |
| Playwright | ローカルChromium(stealthパッチなし、ヘッドレス) |
| Web Unlocker | Bright Data Web Unlocker + 自前抽出(実験1で本測定) |
| Scraper Studio | 自然言語からCollectorを生成し、クラウド側で取得・抽出 |
Web Unlockerは、対象ページの取得時に必要なプロキシのローテーションやブロック解除、リトライをBright Data側へ任せるAPIです。本検証では、Web Unlockerから返った内容の抽出は自前で行いました(公式ドキュメント)。
Scraper Studioは、AIによる抽出器(Collector)の生成、クラウドでの取得・抽出、構造化データの出力までを扱うノーコード/ローコードの統合環境です。公式製品ページでは、プロキシ、ブラウザ実行、アンブロッキング、JSレンダリング、リトライを含む実行基盤をScraper Studio側で扱い、生成後のコードはIDEから調整できると案内されています。
役割の違いをまとめると、Web Unlockerは「ページの取得」を任せるAPIです。本検証では、HTMLの解析とデータ抽出を自前のコードで行いました。Scraper Studioは「取得から抽出・構造化までの実行」を任せるサービスで、取得項目の定義(Collectorへの指示)と結果の検査を利用者が担当します。本記事では、Web Unlocker+自前抽出の構成とScraper Studioの構成を、目的のデータを得るまでの一連の処理として比較します。
Scraper StudioにはCode WorkerとBrowser Workerという使い分けがありますが、本検証ではworker種別を独立した条件として比較していません。内部のsolver、接続元IP、内部リトライも外部から観測できないため、本記事では推測しません。
「成功」はどう定義したのか?
HTTP 200やCLI終了コード0だけでは成功とせず、期待するタイトル・本文・ページ固有の内容が取得できた場合だけを成功としました。
- HTTP 200だけでは成功にしない
- Scraper Studio CLIの終了コード0だけでも成功にしない
- 期待するタイトル・本文・ページ固有の内容が取得できていること
-
Just a moment...などのチャレンジ画面は失敗扱い - 取得結果のスキーマと対象URLも検査する
以下は判定の流れを示すclassify関数の簡略例です。関数末尾の challenge という単語の有無では、ページ固有の到達を確認できません。また、classify関数だけでは本記事の成功率を再計算できません。 実運用の成功判定には、対象URLごとに期待する到達文などを検査する処理を用意してください。
def classify(data, url, status=None):
    if not isinstance(data, dict):
        return False, "schema_mismatch"

    title = data.get("title")
    if isinstance(title, str) and any(
        x in title.lower()
        for x in ("just a moment", "attention required")
    ):
        return False, "challenge_content"

    if not all(isinstance(data.get(k), str)
               for k in ("page_url", "title", "body_text")):
        return False, "schema_mismatch"

    if data["page_url"].rstrip("/") != url.rstrip("/"):
        return False, "wrong_page"

    if status is not None and not 200 <= status < 300:
        return False, "http_error"

    # テストページ固有の成功内容まで確認する
    if "challenge" not in data["body_text"].lower():
        return False, "expected_content_missing"

    return True, "expected_content"
取得内容の検査が必要なのは、検証中に、CLIは正常終了したのに中身はチャレンジ画面だったケースが出たためです。
測定上の前提は何か?
- 対象は公開ページのみ
- ログインや非公開データへのアクセスは行わない
- テスト用サイトではサイト全体をクロールせず、指定したページだけを低頻度で取得
- 利用者側の操作として、手動CAPTCHA、既存Cookieの持ち込み、stealthパッチは使わない(Bright Data側の内部処理は観測していない)
- 本測定中にCollectorを修復・変更しない
実験1:Cloudflare配下で、チャレンジが発生しないブログではどの方式が速いのか?
Cloudflare配下でもチャレンジが発生しないブログでは、4方式すべてが10/10で成功し、requestsの時間中央値0.500秒が最短でした。
対象は、筆者が運営する blog.disnana.com のトップページと公開記事1ページです。4方式 × 2URL × 5回で、合計40試行を行いました。
レスポンスヘッダーには server: cloudflare と cf-ray があり、Cloudflare経由で配信されていることは確認できました。requestsでもPlaywrightでも、チャレンジは一度も観測されませんでした。
| 方式 | 内容検査での成功 | 全10試行の時間中央値 |
|---|---|---|
| requests + BeautifulSoup | 10/10 | 0.500秒 |
| ローカルPlaywright | 10/10 | 3.153秒 |
| Bright Data Web Unlocker | 10/10 | 5.378秒 |
| Bright Data Scraper Studio(修復後) | 10/10 | 5.652秒 |
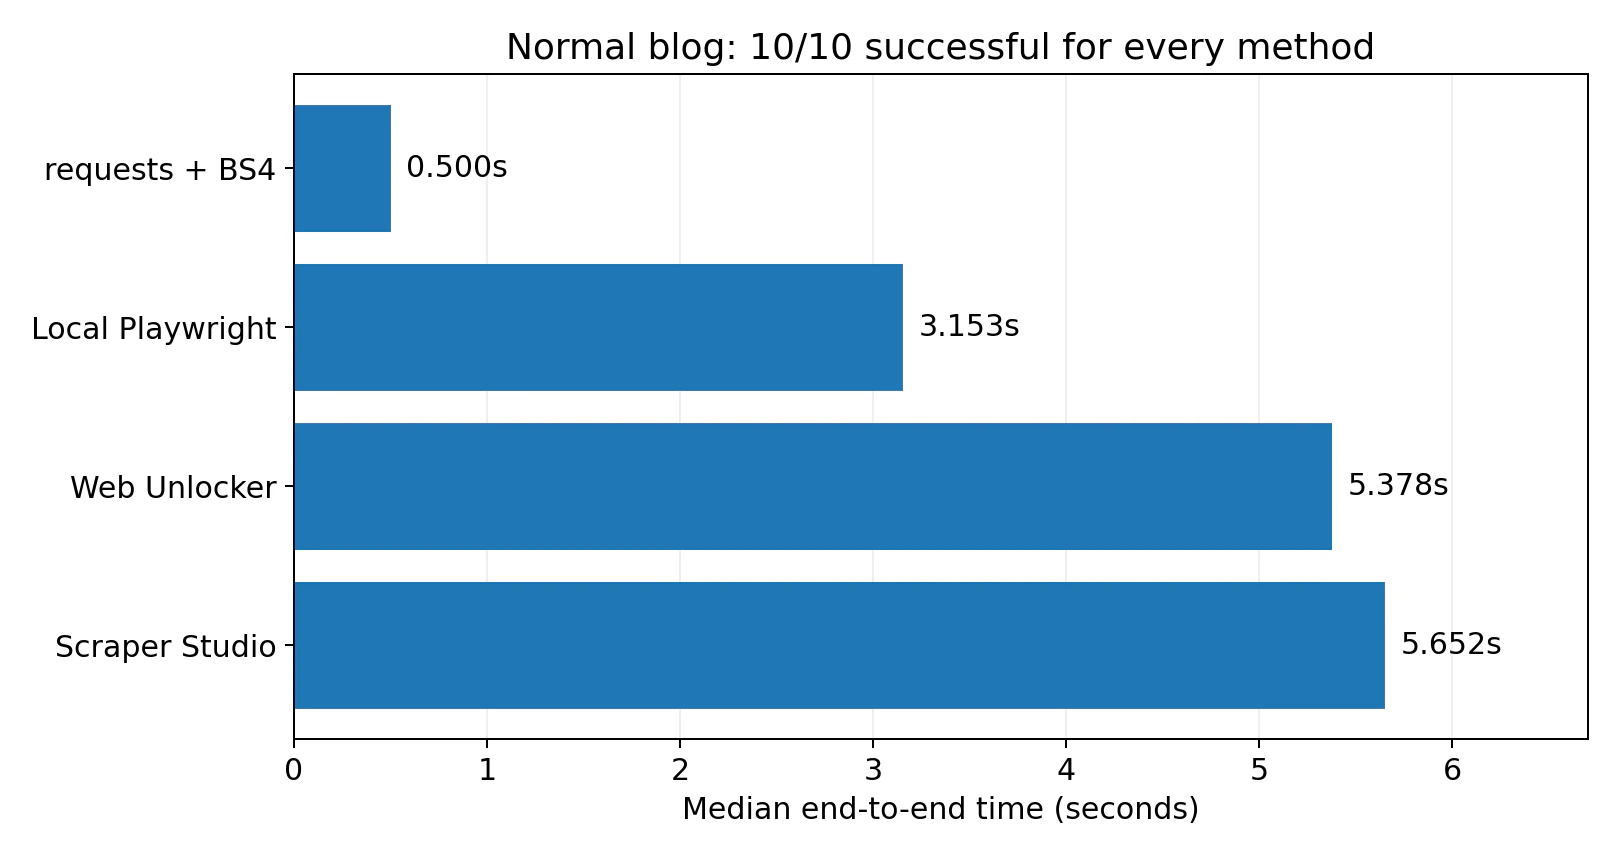
Cloudflare経由のサイトでも、今回の公開ブログ2ページは、requestsでHTMLを取得しBeautifulSoupで抽出する構成で、10試行すべてに成功しました。ブラウザの起動や外部の取得APIを使わず、全10試行の所要時間中央値は0.500秒でした。
実験1の表に示した所要時間は、対象ページとの通信だけでなく、各方式でデータを利用できる状態にするまでの処理を含みます。
- requests:取得 + 抽出 + 検査 + 保存
- Playwright:Chromiumの起動・終了と待機を含む
- Bright Data:CLIのNode起動、API呼び出し、ポーリング、結果ダウンロードを含む
Scraper Studioのコレクターは一発で期待通りに動いたのか?
Scraper Studioのコレクターは、初回生成では title と content_text が欠け、2回の修復を経て、自前抽出と本文・リンク集合が一致しました。
-
初回生成:URLと記事リンクは返るが、
titleとcontent_textが欠けていた - 修復1回目:必須フィールドは返るようになったが、本文範囲が広すぎた
-
修復2回目:
main内で除外する要素とリンク範囲を明示し、本測定では自前抽出と本文・リンク集合が一致した
自前実装にもバグがありました。最初は header を削除してから見出しを取得していたため、main 内の header にある h1 まで消していました。AI生成でも手書きでも、受け入れ条件を決めて実データを検査する工程は必要でした。
実験2:Cloudflareのチャレンジが実際に返るページでは何を検証したのか?
チャレンジが発生しないブログではアンチボット対策の比較にならないため、実際にチャレンジが返る学習用テストサイトScrapingCourseの2ページを追加で検証しました。
候補にしていたFingerprintの公式デモは、ベンチマーク利用の扱いを明確に判断できなかったため、使用を見送りました。採用したScrapingCourseは、スクレイピング学習用テストサイトとして公開されています。対象は次の2ページです。
https://www.scrapingcourse.com/antibot-challengehttps://www.scrapingcourse.com/cloudflare-challenge
通常のrequestsで事前確認すると、2ページとも HTTP 403、server: cloudflare、cf-mitigated: challenge が返りました。

ローカルPlaywrightでも、20秒待機したあとチャレンジ画面のままでした。Playwrightでは、チャレンジをクリックしたり解こうとしたりせず、ページ遷移後に固定時間待って本文を観測しています。
page.goto(
    url,
    wait_until="domcontentloaded",
    timeout=timeout * 1000,
)

page.wait_for_timeout(wait_seconds * 1000)

data = {
    "page_url": page.url,
    "title": page.title(),
    "body_text": page.locator("body").inner_text(timeout=5000),
}
保護付きページでは、requests・Playwright・Scraper Studioのどれが本文に到達したのか?
保護付きテストページ2URLの30試行では、requestsとPlaywrightが0/10、Scraper Studioが7/10で目的の本文に到達しました。
3方式 × 2ページ × 5回で、合計30試行です。成功条件は、レスポンスが返ることではなく、各テストページ固有の到達内容が本文に含まれていることです。
| 方式 | 目的データへの到達 | 全試行の時間中央値 | 成功試行のみの中央値 |
|---|---|---|---|
| requests | 0/10 | 0.561秒 | 未到達 |
| Playwright | 0/10 | 21.216秒 | 未到達 |
| Scraper Studio | 7/10 | 66.918秒 | 63.894秒 |

Scraper Studioのページ別の結果は次のとおりです。
-
cloudflare-challenge:5/5 -
antibot-challenge:2/5
requestsの時間中央値0.561秒は、チャレンジ画面を受け取るまでの時間で、目的データには到達していません。保護ページの表では、時間を目的データへの到達の有無とセットで読む必要があります。
Scraper Studioの7/10という成功数は、ScrapingCourseのcloudflare-challengeとantibot-challengeを、それぞれ5回取得した本測定の観測値です。Scraper StudioのCloudflare全般での成功率や、Playwright一般の能力を示す数字ではありません。
▶ Scraper Studioの無料枠で、自分の対象ページの取得結果を検査する(専用リンク)
無料枠はScraper Studio、Web Unlocker、SERP APIなどの対象製品で共用します。適用条件と消費単位は、記事後半の「無料枠・料金・認証」の表で説明します。
Scraper Studioの所要時間66.9秒には何が含まれるのか?
失敗を含む全10試行の所要時間中央値は66.918秒、本文に到達した7試行のみでは63.894秒でした。内部処理の時間内訳は計測していません。
本検証で測ったのは、CLIの起動、API呼び出し、ポーリング、結果のダウンロードを含む所要時間です。Bright Dataはプロキシやブラウザ実行、リトライなどを基盤側で扱うと説明していますが、各試行でどの内部処理が実行され、何秒かかったかは観測していません。したがって、66.918秒という値だけから遅延の原因は特定できません。
Scraper Studioが失敗した3件の内訳は何か?
Scraper Studioの失敗3件は、CLIタイムアウト2件(いずれもantibot-challenge)と必須データ不足1件でした。
タイムアウトした2件は、保存された応答IDから後で既存ジョブの結果だけを確認しました。返ったのは page_url と input 程度で、目的データの取得にはなっていませんでした。
Scraper Studioは10試行中8件でCLI終了コード0でしたが、目的データへ到達したのは7件でした。CLIの成功と、取得結果の成功は、別の状態です。
Scraper Studioの準備段階ではどのような手戻りがあったのか?
保護付きページの本測定までに、Collector生成の失敗、未完成Collectorの403、CLI終了コード0のチャレンジ画面に対応しました。 準備から本測定までの経緯は、次のとおりです。
- 保護ページを直接seedにしたCollector生成が失敗
- 未完成Collectorを実行すると、Bright Data APIから
403/Collector does not have a template - 保護ページと同じドメイン(www.scrapingcourse.com)の公開トップをseedに、別Collectorを作成
- 保護ページへ適用した予備試行で、CLI終了コード0なのに、タイトルが
Just a moment...、本文も欠落 - 失敗時の本文も取得できるように、Self-Healingを1回実施
- 修復後の保存版を固定し、30試行の本測定を実施
403は2種類あり、混同していません。対象サイトが返すHTTP 403と、未完成Collectorに対してBright Data APIが返す403は、原因が違うため、別々に扱いました。
Collectorの作成と修復は、CLIから実行しました。
# Collector作成(公開トップをseedに)
bdata scraper create https://www.scrapingcourse.com/ "<指示文>" \
  --name course-benchmark --timeout 600 --no-retry --json

# Self-Healing(本測定前に1回だけ)
bdata scraper heal <collector_id> "<修復指示>" \
  --auto-approve --auto-save --no-retry --json -o heal.json
本測定では、保存済みCollectorを固定し、各URLに対して実行しただけです。
bdata scraper run <collector_id> <url> \
  --timeout 90 --json -o result.json
使用したSelf-Healingの指示文は次のとおりです。
Protected-page runs return title Just a moment... but OMIT body_text. Fix extraction
 to always populate body_text from the actual body text even for challenge/error pages,
 not only normal main content. Keep output schema page_url,title,body_text. Use the
 platform supported Browser worker navigation and wait up to 20 seconds for the page to
 settle before extraction. Keep the supplied protected URL and actual final URL; never
 switch to the homepage or alternate unprotected paths. If still blocked, return actual
 title and body text. Do not invent a bypass message or hardcode success, do not crawl links.
Self-Healingでは、失敗時にも実際に返ったタイトルと本文を欠落させずに記録することを重視しました。本文がなければ、外部から、保護による拒否、worker側のエラー、生成コードの抽出失敗を区別できません。失敗をすべてCloudflareのせいにはしていません。
Web Unlockerは保護付きページで目的の本文に到達したのか?
Web Unlockerの補助診断(各ページ1回)では、cloudflare-challengeで目的データに到達し、antibot-challengeで captcha or protection page found により失敗しました。
実験2では、Web Unlockerを本測定の3方式に含めず、補助診断として各ページ1回だけ確認しました。2回の診断は傾向を語れるデータ量ではありませんが、同じサービスでも対象ページによって結果が分かれることは確認できました。
Bright DataはWeb Unlocker APIについて、1回のAPI呼び出しでプロキシのローテーション、ブラウザフィンガープリント、CAPTCHA解決、リトライを処理すると説明しています(公式ドキュメント)。
状況別に、どの取得方式を選ぶべきか?
本検証の範囲では、静的ページにはrequests、ブラウザ操作が必要ならPlaywright、取得経路を外部に任せたいならWeb Unlockerなど、取得・抽出・実行基盤までまとめて任せたいならScraper Studioが候補になります。
| 状況 | まず検討する方式 |
|---|---|
| 普通の静的ページ | requests + BeautifulSoup。今回のブログ2ページでは10/10成功、所要時間中央値0.500秒 |
| JSレンダリングやブラウザ操作が必要 | Playwright |
| 取得経路そのものを外部に任せたい | Web Unlocker APIなどを検討 |
| 取得・抽出・構造化・実行基盤までまとめてクラウドへ寄せたい | Scraper Studioを候補に |
今回の公開ブログ2ページでは、Bright Dataを使う必要性はほぼありませんでした。requestsだけで必要なデータを取得できました。チャレンジが発生するテストページでは、requests・Playwrightが0/10だった条件で、Scraper Studioは7/10でした。一方で、Collectorの生成・修復・実行結果の検査という別の作業が発生しました。
Scraper Studioでは、プロキシやブラウザの実行基盤をBright Data側が提供し、利用者が取得項目の定義と結果の検査を担当します。本検証でも、ブログ用Collectorは本測定前に2回修復し、保護ページ用Collectorでは本測定前にSelf-Healingを1回実施しました。導入後も、抽出器の調整と取得内容の確認は必要でした。人間の開発工数を何時間・何%削減できたかは、測定していないため、数値で主張しません。
この検証にはどのような限界があるのか?
本記事の結果は、2サイト・各2ページ・少ない試行回数に限られ、70試行を合算した成功率や速度倍率は算出していません。
- 対象は2サイト、各2ページのみ
- 試行回数は少ない
- 実験1と実験2は、サイト・待機条件・Collectorが異なる
- Scraper Studioの7/10は、この2ページ・この条件での観測値で、Cloudflare全般の成功率ではない
- Playwrightの0/10は、Playwright一般の能力を示すものではない
- Scraper Studio内部のsolver、接続元IP・地域、内部リトライ、実際のworker種別は観測していない
- Code WorkerとBrowser Workerを独立条件として比較していない
- CLIのタイムアウトは、クラウド側ジョブのキャンセルを意味しない可能性がある
- 実験単体の確定請求額を分離できなかったため、1成功あたりの費用は算出していない
検証環境は、Python 3.11.9 / Windows 10、requests 2.34.2、beautifulsoup4 4.15.0、Playwright 1.64.1、Bright Data CLI 0.3.4です。検証コードの作成・測定・結果整理には、Codex(GPT-6.1 Sol / Middle Thinking)を使用しました。AIは検証作業の補助で、記事内の成功条件と結果は、保存した実測データに基づいています。
まとめ
今回の公開ブログ2ページはrequestsで取得できました。一方、チャレンジが返るテストページでは、速度より先に「目的データへ到達できるか」が問題になり、Scraper Studioは10試行中7件で到達しました。
- 今回の公開ブログ2ページでは、requests + BeautifulSoupが10/10成功し、所要時間中央値は4方式中最短の0.500秒だった
- 実際にチャレンジが発生する条件では、目的データへの到達可否が先に問題になった
- Scraper Studioは、Collector生成の失敗、Self-Healing、タイムアウト、抽出不備も経験しており、100%成功ではない
今回の結果が示す範囲は、ScrapingCourseの保護付き2ページで、Scraper Studioが10試行中7件で目的データに到達したことです。自前方式で取得経路の維持が難しくなった場合は、プロキシ・ブラウザ実行・リトライを含む実行基盤と抽出器の実行をクラウド側で扱うScraper Studioのようなサービスを、選択肢に入れられます。導入後も、成功条件を先に決めて、返ってきたデータを検査します。
Bright Data Scraper Studioの無料枠・料金・認証はどうなっているのか?
対象となる新規アカウントには、対象製品で共用する月5,000クレジットの無料枠があります。Scraper Studioだけに使う場合は、最大5,000 page loads相当です。
以下は2026年10月30日に確認した公式情報です。プランや適用条件は変わることがあるため、利用前に各リンク先で再確認してください。
| 項目 | 確認した内容 | 出典 |
|---|---|---|
| 無料枠 | 対象の新規アカウントに月5,000クレジット。Studio、Web Unlocker、SERP APIなどの対象製品で共用し、製品ごとに別枠ではない | 無料枠の公式説明 |
| Studioの消費単位 | 1 page loadにつき1クレジット。レコード数ではなく、読み込むページ数に応じて消費 | 無料枠の公式説明 |
| 適用条件 | カード登録不要。カスタムPAYG料金・pre-commitプランは無料枠の対象外。プロキシ製品も月次無料枠の対象外 | 無料枠の公式説明 |
| 無料枠を使い切った後 | 入金済み残高があればPAYG料金で継続。残高がなければリクエストはエラーとなり、継続には入金が必要 | 無料枠の公式説明 |
| StudioのPAYG料金 | 1,000 page loadsあたり1.5米ドル | 公式料金ページ |
| セキュリティ関連の認証・報告書 | ISO/IEC 27001:2022、27017:2015、27018:2019。SOC 3報告書は公開、SOC 2 Type II報告書はNDAのもとで提供 | 公式セキュリティ情報 |
認証・監査報告書は情報セキュリティ等の管理に関するもので、個々のスクレイピング行為の適法性や取得成功を保証するものではありません。
本記事の検証で実際にかかった費用は、分離して集計できていないため、記載していません。
▶ Bright Dataの無料枠で保護ページの取得を試す(専用リンク)
関連する公式ページ
- Scraper Studioの製品仕様(公式)
- Scraper Studioの料金(公式)
- Web Unlocker API(公式ドキュメント):1回のAPI呼び出しで、プロキシのローテーション、CAPTCHA解決、リトライを処理するAPI
- 公式MCP Server(公式ドキュメント):AIエージェントがWeb検索やスクレイピングを呼び出すためのサーバー。Web Unlocker APIを基盤とし、無料枠は上記のアカウント共通枠から消費します。本記事では公式MCPを測定していません。
- Datasets(データセットマーケットプレイス)
- Proxy Networks(プロキシネットワーク)
- セキュリティ・認証情報(公式ドキュメント)
責任ある利用について(再掲)
本記事の検証は、筆者の公開ブログと学習用テストサイトに限定しています。Bright Dataの公開Webデータに関する方針は、個々の利用の適法性を保証するものではありません。取得対象の利用条件と関連法令を確認し、守る責任は利用者自身にあります。
よくある質問(FAQ)
Scraper StudioはCloudflareのチャレンジ画面を突破できますか?
本検証では、ScrapingCourseの保護付きテストページ2URL・各5回の計10試行のうち、7試行で目的の本文に到達しました。cloudflare-challengeが5/5、antibot-challengeが2/5です。同じ対象URLの本測定では、requestsとPlaywrightはそれぞれ0/10でした。一般のサイトでの成功率は測定していません。
Cloudflare配下のサイトは、requestsでは取得できませんか?
取得できる場合があります。本検証のCloudflare配下のブログ(blog.disnana.com)では、チャレンジが一度も発生せず、requestsが10/10で成功しました。時間の中央値は0.500秒でした。
HTTP 200が返れば、取得に成功したと判断してよいですか?
判断できません。本検証では、HTTP 200だけでは成功とせず、期待するタイトル・本文・ページ固有の内容まで検査しました。Scraper Studioでは、CLI終了コード0なのに、タイトルが Just a moment... で本文が欠落した例がありました。
Scraper Studioの無料枠はいくらですか?
対象製品で共用する月5,000クレジットです。Studioだけに使う場合は最大5,000 page loads相当で、カード登録なしで始められます。対象アカウントや残高による継続条件は、「無料枠・料金・認証」の表と公式の無料枠説明を確認してください(2026年10月30日確認)。
Scraper Studioの取得時間はなぜ長いのですか?
保護ページでは、失敗を含む全10試行の中央値が66.918秒、成功7試行のみでは63.894秒でした。CLIの起動から結果取得までを測っていますが、内部処理の時間内訳は観測していないため、遅延の原因は特定できません。
用語集
-
Cloudflareチャレンジ:Cloudflareが、アクセス元を確認するために返す画面。タイトルが
Just a moment...になる例があります。 -
cf-mitigated:Cloudflareのチャレンジ画面の応答に付くHTTPヘッダー。値は
challengeです(Cloudflare公式資料)。 - Scraper Studio:対象URLと欲しい項目を自然言語で指定し、AIが生成した抽出器(Collector)をクラウド上で実行して構造化データを返す、Bright Dataのサービス。
- Collector:Scraper Studioで生成される抽出器。
- Self-Healing:Scraper Studioで、抽出器の問題を指示文に基づいて修復する機能。保護ページの実験では、本測定の前に1回実施しました。
- Web Unlocker:1回のAPI呼び出しで、プロキシのローテーションやCAPTCHA解決などを処理して、対象ページの内容を返すBright DataのAPI。
- page load:Scraper Studioの利用量・課金の単位。無料枠では1 page loadにつき1クレジットを消費します。Collectorの1回の実行や出力1レコードと同義ではありません(公式説明)。
本記事はBright Dataの依頼により執筆したPR記事です。