
はじめに
こんにちは。大学4年生の @haru452 です。
以前、ベトナムでインターンシップに参加し、そこで Stitch や AI を活用したアプリ開発を学びました。このインターンシップがきっかけで、アプリ開発にすっかりはまり、今回は自分のためのアプリを一から作ってみました。
毎日英語の勉強をしているのですが、スピーキングの練習では「早めにアドバイスやフィードバックをもらえたほうが、スキルが早く伸びる」という話を聞き、話した英語にすぐアドバイスがもらえるアプリを作りたいと思いました。
そこで、スマホに向かって英語で話すと、AI が自然な英語に直してくれるアプリを Unity で作りました。
話した内容はそのまま英語日記として残り、毎日続けると連続記録(ストリーク)が伸びていきます。書き忘れた日には Discord にリマインドが届きます。
この記事では、アプリに実装した機能と、それぞれをどう実装したかを紹介します。
(まだ改良中なので、これから機能を増やしていく予定です)
- アプリ本体(Unity):https://github.com/haru452/Learningapp
- リマインダー(Cloudflare Workers):https://github.com/haru452/my-project-connected-to-discord
- データベース・Web 版(Supabase):https://github.com/haru452/database_learnApp
開発の進め方
ベトナムのインターンシップで学んだ「AI と一緒に開発する」やり方を、そのまま自分のアプリでも試しました。
卒論と並行して作ったので、コードを書く部分は AI(Claude)に手伝ってもらい、「何を作るか」「どう作るか」の設計、Unity での画面の組み立て、実機でのテストと改善は自分で担当しました
| 自分でやったこと | AI に手伝ってもらったこと |
|---|---|
| 作りたい機能と、全体の構成を決める | C# のコードを書く |
| Unity で画面・ボタン・シーンを組み立てる | エラーの原因の候補を出す |
| Android の実機で試して、問題を見つける | 直し方の案を出す |
| 直し方を選んで、もう一度試す |
(ちなみに、口下手なので、この記事も Claude に手伝ってもらいながら書いています)
できること
| 機能 | 内容 |
|---|---|
| 🎤 英語の添削 | 英語を話すと、文字起こしして、文法を直した文と解説を表示 |
| 🔀 添削エンジンの切り替え | Gemini(添削 + 解説)と DeepL Write(自然な言い換え)を選べる |
| 📔 英語日記モード | 長めの日記を話し続けて、最後にまとめて添削 |
| 🔥 連続記録 | 日記を書いた日数を記録し、「N Days Streak」と今週の達成状況を表示 |
| ☁️ ログイン・クラウド保存 | Supabase でログインすると、記録と日記をクラウドに保存(Web 版と共通) |
| 💬 Discord 連携 | 添削した日記を Discord に送信。直した単語には下線を付ける |
| ⏰ リマインダー | 夜までに日記を書いていないと、Discord に通知が届く |
| 🧸 3D キャラと会話(実験中) | VRM キャラクターと、端末内の LLM で英語の音声会話 |
実際に使っている様子です。「Start Recording」を押して話し、もう一度押すと添削されます。
「I eat apple yesterday」と話すと、「I ate an apple yesterday.」に直してくれます。

全体の構成
| 項目 | 使ったもの |
|---|---|
| アプリ | Unity 2022.3 / C#(Android。iOS は未検証) |
| 音声認識 | Android の SpeechRecognizer、iOS の SFSpeechRecognizer
|
| 添削 | Gemini API、DeepL Write API |
| ログイン・データベース | Supabase(Auth + PostgreSQL の関数) |
| リマインダー | Cloudflare Workers(KV)、cron-job.org |
| 3D キャラ | UniVRM、LLMUnity |
| UI デザイン | Stitch(案出し)、uGUI + TextMesh Pro |
1. 音声認識:端末内蔵の機能を使い、ダメなら Gemini に任せる
最初は「録音した音声を Gemini に送って文字起こしする」作りでしたが、実際に使ってみると送信と待ち時間が長かったので、実機では端末内蔵の音声認識を使うように変えました。話している途中の文字がリアルタイムで出るので、使い心地もよくなりました。
Unity の Editor など、内蔵の音声認識が使えない環境では、録音した WAV を Gemini に送るフォールバックにしています。
| 環境 | 文字起こしの方法 |
|---|---|
| Android |
android.speech.SpeechRecognizer を AndroidJavaObject で直接呼ぶ |
| iOS | Objective-C++ のブリッジ(.mm)から SFSpeechRecognizer を呼ぶ |
| Editor など |
Microphone で録音 → WAV に変換 → Gemini で文字起こし |
Android:ネイティブのコールバックを Unity のメインスレッドに戻す
SpeechRecognizer は Android の UI スレッドで操作する必要があり、結果のコールバックも UI スレッドから届きます。Unity の API はメインスレッドからしか触れないので、キューに積んで、Update でメインスレッド側から取り出すようにしました。
iOS:UnitySendMessage で C# に結果を返す
iOS は .mm ファイルで SFSpeechRecognizer を使い、結果を UnitySendMessage で C# に送っています。
GameObject の名前を指定して呼ぶ仕組みなので、受け取る GameObject の名前は変えないことがポイントです。
また、iOS は Info.plist にマイクと音声認識の利用目的を書かないとクラッシュするので、ビルド後に自動で追加する Editor スクリプトを用意しました。(自分は Android ユーザーなので、iOS では試せていません)
2. Gemini で「決まった形の JSON」を返してもらう
添削結果は「直した文」と「解説」に分けて画面に出したいので、Gemini の responseSchema(構造化出力) を使い、決まった形の JSON で返してもらっています。
private const string CorrectionSchema =
    "{\"type\":\"OBJECT\",\"properties\":{" +
    "\"transcript\":{\"type\":\"STRING\"}," +
    "\"corrected\":{\"type\":\"STRING\"}," +
    "\"explanation\":{\"type\":\"STRING\"}}," +
    "\"required\":[\"transcript\",\"corrected\",\"explanation\"]}";
リクエストの JSON は、文字列で組み立てています。JsonUtility を使うと、空のフィールドまで出力されてしまうためです。
string body =
    "{\"contents\":[{\"parts\":[" +
        "{\"text\":\"" + HttpUtil.JsonEscape(prompt) + "\"}" +
        audioPart +   // 音声を送るときだけ inline_data を足す
    "]}]," +
    "\"generationConfig\":{" +
        "\"responseMimeType\":\"application/json\"," +
        "\"responseSchema\":" + schemaJson +
    "}}";
プロンプトの工夫
- 文字起こしでは、文法の誤りを直さずにそのまま書かせる:先に直されてしまうと、どこを間違えたかがわからなくなるためです。
- 意味を変えない、新しい情報を足さない:AI がそれっぽい内容を付け足してしまうのを防ぎます。
-
日記の解説は、主な修正を最大5つ、
I has -> I had (past tense of 'have')の形で:短く読みやすくするためです。
"explanation": list the most important corrections (at most 5) in simple English,
each as a short line like: "I has -> I had (past tense of 'have')".
混雑したときのリトライと予備モデル
使っていると、Gemini が混雑して 503 や 429 を返し、添削に失敗することがありました。そこで、同じモデルで 1 秒 → 2 秒と待ってリトライし、それでもダメなら予備のモデルに切り替えるようにしました。
foreach (string model in models)            // メインモデル → 予備モデル
{
    string url = $"{EndpointBase}{model}:generateContent";
    for (int attempt = 0; attempt < MaxAttemptsPerModel; attempt++)
    {
        try
        {
            return await HttpUtil.PostJsonAsync(
                url, body, new[] { ("x-goog-api-key", _apiKey) }, timeoutSeconds: 90);
        }
        catch (HttpException e) when (IsRetryable(e))   // 429 / 500 / 503 のときだけ
        {
            lastError = e;
            if (attempt < MaxAttemptsPerModel - 1)
                await Task.Delay(1000 * (1 << attempt));
        }
    }
}
throw lastError;
UnityWebRequest を async/await で使う
Unity 2022.3 では UnityWebRequest を直接 await できないので、Task.Yield() で完了を待つ小さなヘルパーを作り、すべての通信で使い回しています。
var op = req.SendWebRequest();
while (!op.isDone)
    await Task.Yield();

if (req.result != UnityWebRequest.Result.Success)
    throw new HttpException(req.responseCode, $"HTTP {req.responseCode} : {req.error}");
ステータスコード付きの例外にしておくと、「リトライしてよいエラーか」を判断しやすくなります。
3. 英語日記モード:途切れる音声認識をつなぎ続ける
日記は数分話すこともありますが、実機で試してみると、端末内蔵の音声認識は、少し黙ったり一定時間たったりすると自動で終わってしまうことがわかりました。
そこで、認識が終わるたびに確定した文章を保存し、ユーザーが停止ボタンを押すまで自動で再開するようにしました。
private async void OnNativeSessionEnded(string text, string error)
{
    if (!string.IsNullOrWhiteSpace(text))
    {
        _segments.Add(text.Trim());         // 確定した文章をためていく
        _consecutiveErrors = 0;
    }
    else if (!string.IsNullOrEmpty(error))
    {
        _consecutiveErrors++;               // 無音は失敗に数えない
    }

    if (!_active)                           // ユーザーが停止した → 添削へ
    {
        await FinalizeAsync();
        return;
    }

    if (_consecutiveErrors >= MaxConsecutiveErrors)
    {
        await AbortAsync("Speech recognition keeps failing.");
        return;
    }

    await RestartAsync(_sessionId);         // まだ話している → 聞き取りを再開
}
ほかにも、次の点を工夫しました。
- Android では無音で終了するまでの時間を 2.5 秒に延ばし、考えながら話しても途切れにくくする。
- 話している間は
Screen.sleepTimeout = SleepTimeout.NeverSleepで画面が消えないようにする。
4. Discord に送るとき、直した単語に下線を付ける
添削した日記を Discord に送るとき、元の文から変わった単語だけに下線(Discord の __単語__ 記法)を付けています。どこを直されたかが一目でわかります。
差分は、単語単位の LCS(最長共通部分列)で計算しています。語順が変わっても正しく比べられます。
// 後ろから LCS の長さを埋める
for (int i = n - 1; i >= 0; i--)
    for (int j = m - 1; j >= 0; j--)
        dp[i, j] = a[i] == b[j]
            ? dp[i + 1, j + 1] + 1
            : Math.Max(dp[i + 1, j], dp[i, j + 1]);

// 前からたどり、原文に対応する単語がないものを「変更あり」にする
int x = 0, y = 0;
while (x < n && y < m)
{
    if (a[x] == b[y]) { x++; y++; }
    else if (dp[x + 1, y] >= dp[x, y + 1]) { x++; }   // 原文だけにある単語(削除)
    else { changed[y] = true; y++; }                  // 添削文だけにある単語(追加・変更)
}
音声認識の結果には大文字や句読点がほとんど付かないので、大文字・小文字と前後の記号の違いは「変更」とみなさないようにしています。
これをしないと、i → I や文末の . まで全部下線になってしまいます。
Discord は 1 メッセージ 2000 文字までなので、長い日記は改行や空白の位置で分割して送っています。
5. 連続記録(ストリーク)とログイン
なぜ連続記録を付けたのか
自分はすごく飽き性なのですが、なぜか連続記録が表示される Quizlet だけは、1年以上続いています。
なので、このアプリにも連続記録を表示するようにしました。さらに、記録を Web 上にも保存して、たとえスマホが壊れても記録が途切れないようにしています。
端末だけでも動き、ログインするとクラウドと同期する
ストリークは、まず端末内(PlayerPrefs)に記録します。ログインしていなくても使えるようにするためです。
Supabase にログインしている場合はクラウドにも保存し、Web 版と同じ記録を表示します。
- 今日まだ書いていなくても、昨日まで続いていれば連続は途切れていない扱いにする。
- 「1日の区切り」を何時にするか設定できる(夜中に書いても前の日として数えられる)。
- ログイン後に1回だけ、端末の記録をクラウドに引き継ぐ。
不正に記録を伸ばせないよう、「今日」はサーバーで決める
クライアントから「連続日数 = 100」のように直接書き換えられると、記録をごまかせてしまいます。
そこで、テーブルへの書き込みは RLS で禁止し、PostgreSQL の関数(RPC)経由でしか記録できないようにしました。「今日」の日付もサーバーの時刻で決めるので、端末の時計をいじっても変えられません。
-- 本人の行だけ読める。書き込みは complete_study() 経由のみ
alter table public.streaks enable row level security;

create policy "streaks_select_own"
  on public.streaks for select
  to authenticated
  using ((select auth.uid()) = user_id);

revoke all on public.streaks from anon, authenticated;
grant select on public.streaks to authenticated;
-- 「今日」は、サーバーの時刻を p_timezone で換算して決める
create or replace function public.complete_study(p_timezone text default 'Asia/Tokyo')
returns table (streak integer, last_date date, already_done boolean)
language plpgsql
security definer
...
Unity からは、Supabase の REST API(/rest/v1/rpc/関数名)を UnityWebRequest で直接呼んでいます。
ログイン状態の復元で気をつけたこと
ログイン状態は、リフレッシュトークンを保存して次回起動時に復元します。
ただし、リフレッシュトークンは1回しか使えないので、起動時に複数の画面から同時に「復元」を呼ぶと、2回目が失敗してログアウトされてしまいました。
最初の呼び出しの Task を使い回し、実際の通信は1回だけになるようにして解決しました。
6. リマインダー:Cloudflare Workers で毎晩チェック
日記を書き忘れないように、夜 20 時までに書いていなければ Discord に通知が届くようにしました。
- アプリは日記の添削に成功したら、Worker に「今日書いた」と連絡するだけです(結果は待たない)。
- Worker は、KV に保存した日付を見て、今日書いていなければ Discord Webhook で通知します。
- 最初は Cloudflare の Cron Trigger だけで毎日動かそうとしましたが、うまく動かないことがありました。そこで、外部サービスの cron-job.org から毎日決まった時刻に Worker の
/checkを呼ぶようにしました。 -
/checkは合言葉(APP_SECRET)がないと動かないので、他の人が勝手に呼んでも通知は送られません。 - Webhook の URL や合言葉は、コードに書かず、Cloudflare のシークレットに保存しています。
7. (実験中)VRM キャラクターと英語で会話する
英会話の相手として、VRM の 3D キャラクターと音声で会話する機能も試作しています。LLM は LLMUnity を使ってスマホの中で動かしているので、外部 API は使いません。
返事を待たずに、できた文から読み上げる
スマホの LLM は生成に時間がかかるので、返事が全部できるのを待たず、1文できるたびに読み上げています。
// LLM から「ここまでの返事全体」が届くたびに呼ばれる
void OnReplyPartial(int id, string soFar)
{
    while (SentenceSplitter.TryTake(soFar, consumed, out string sentence, out int end))
    {
        consumed = end;
        sentenceQueue.Enqueue(sentence);   // 読み上げ側のループが順番に読む
    }
}
文の区切りは、英語の . ! ? の次の文字が空白のときだけ確定させています。こうすると「3.5」や「Mr. Smith」の途中で区切られません。
返事に [happy] のような感情タグを入れてもらい、それを読み取ってキャラクターの表情を変える、ということもしています。
アニメーションファイルなしで体を動かす
キャラクターの動きは、アニメーションファイルを使わずコードで作っています。
- 起動時に、各ボーンの「元の回転(T ポーズ)」を覚えておく。
- 毎フレーム、元の回転に「呼吸」「うなずき」などの差分を足して姿勢を作る(前のフレームに足していかないので、誤差がたまらない)。
- 聞いているときは首をかしげ、ユーザーが話している間は相づちでうなずく。
キャラクターをタッチすると反応する機能もあります。VRM にはコライダーがないので、起動時に頭・体・腕・手のボーンへ見えない球の当たり判定を自動で付けています。(実際はタッチ機能は少し邪魔になることがあったのでつけてないです。ただコードだけ残していてつけれるようにはしてます。)
実際に会話している様子です。
8. UI デザイン:迷ったら Stitch で案を出してもらう
機能は作れても、画面のデザインを考えるのには結構迷いました。ボタンをどこに置くか、色をどうするか、Unity の上で何度も動かしては悩みました。これまで自分が作ったアプリは機能重視で、使いやすさを何も考えていなかったので、いつも「使いにくいなー」と感じていました。
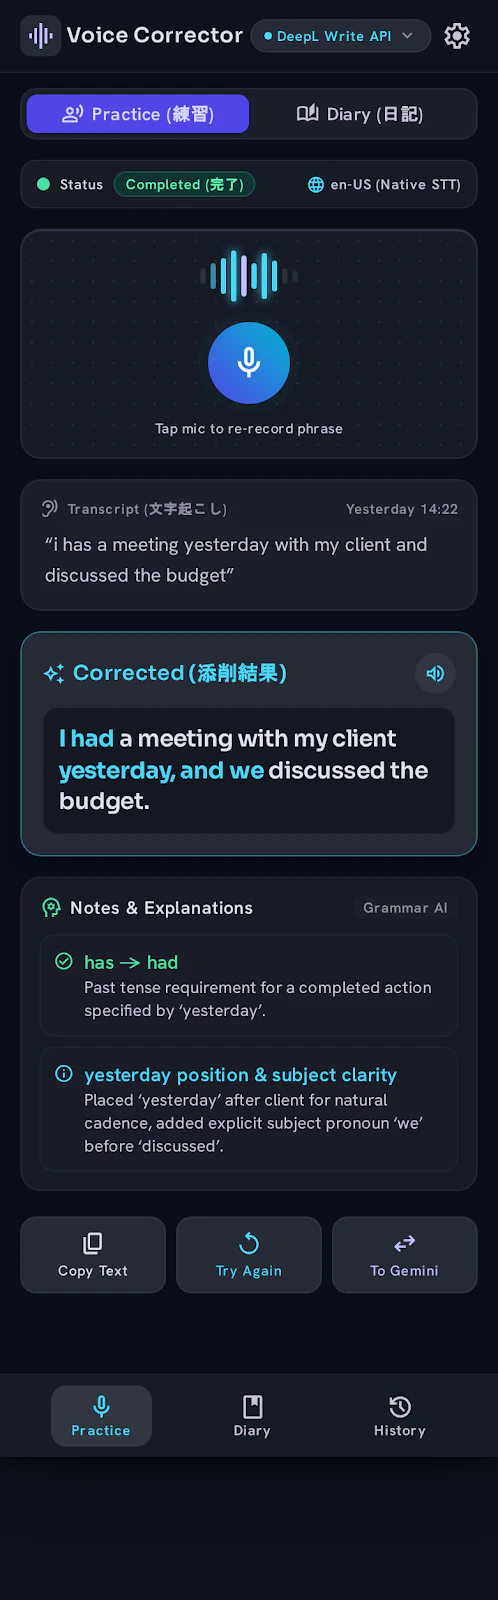
そこで、ベトナムのインターンシップで使い方を教わった Google の Stitch を使いました。Stitch は、作りたい画面を文章で伝えると、AI が UI デザインの案を出してくれるツールです。
使い方の流れ
- Stitch に作りたい画面を文章で伝える
- 出てきた案を見て、自分のイメージと違うところを文章で伝えて直してもらう
- 色・配置・文字の大きさを参考にしながら、Unity の uGUI(Canvas・TextMesh Pro)で自分で組み立てる
Stitch のデザインは、そのまま Unity に取り込めるわけではない(たぶん)ので、「どんな画面にするか」を決めるための下書きとして使いました。
使ってよかったこと
- 頭の中にイメージがなくても、まず案が出てくるので、考え始めやすい
- 違うところを伝えるだけで直してくれるので、自分の好みを形にしやすい
Stitch の案と、実際に作った画面
Stitch が作った UI です。
自分が Unity で作った画面です。
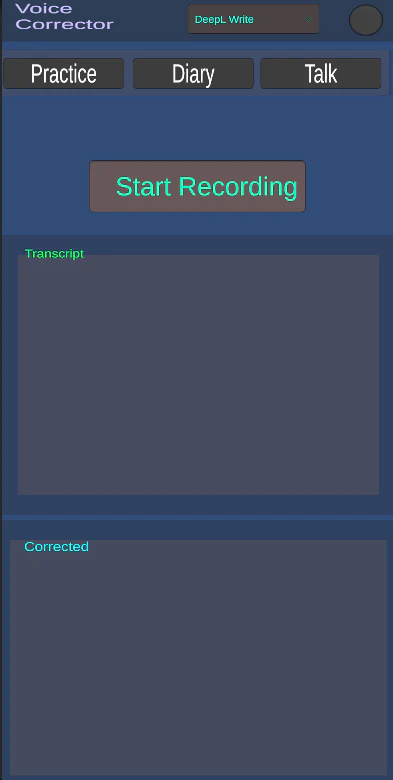
見てわかる通り、Stitch の案のほうがかっこいいのですが、自分の Unity の技術では再現しきれませんでした。ここはこれからの課題です。
苦労したところ・学んだこと
- 外部の API は失敗する前提で作る:Gemini の混雑で添削に失敗することがあり、リトライと予備モデル、「添削だけやり直す」ボタンを用意しました。
-
AI の出力は形を決める:
responseSchemaで JSON の形を決めると、パースで失敗しなくなりました。 - UI は思った通りに作れない:Stitch で理想のデザインは作れても、Unity で再現するのは難しかったです。
まとめ
Unity で、話した英語を AI が添削してくれる英語日記アプリを作りました。
端末の音声認識、Gemini / DeepL、Supabase、Cloudflare Workers、Discord を組み合わせることで、「話す → 直してもらう → 記録が続く → 忘れたら通知が来る」という流れを、毎日続けやすい形にできました。
3D キャラクターとの会話はまだ実験中なので、これから英会話の練習相手として使えるようにしていきたいと思っています。
(さすがに卒論がやばいし、自分の作りたいものがほとんどできたので、しばらくは卒論中心になりますが、また更新する予定です)
ソースコードは GitHub で公開しています。