
はじめに ― Strataによる環境変化
ローカルAIが普及しVRAM容量が正義となった昨今、NVIDIA系GPUを安価に入手するのは困難を極める。NVIDIA系GPUの主な利点はCUDAエコシステムが利用できることにあるが、ここ最近「Strata」(ストラータ)という新しいLLM用ランタイムがNiko Veit氏(X)によって公開されて以降、8~16GBの低容量VRAMのGPUと32~64GB中程度のRAMの組み合わせで「Qwen3.8-Flash-Next」というMoEモデルを高速に動作可能な環境が急速に整ってきている。
この「Strata」はQwen3.8-Flash-Nextのアーキテクチャに特化したランタイムである(現在はその他のMoEモデルにも対応しつつある)。最初のバージョンがリリースされてから2週間しか経過していないが、既にスターが二万件以上、forkが二千件に達する勢いで普及・拡張されており、その利用拡大と機能拡張が急速に進んでいる。本家Strataの更新速度は尋常ではなく、ユーザーからは比較的低スペックな環境でも最先端MoEモデルを(IQ3_XXS版などの量子化版とはいえ)利用できることに歓喜する声と、相次ぐ更新にキャッチアップするための時間が全く不足していて睡眠時間を求める悲鳴が同時に上がっている。
既に世界中でStrataの派生版が様々に開発されており、NVIDIA系GPUだけでなく、AMD系やIntel系のGPUに対応したバージョンも続々と公開されている。今回利用するのはその派生版の一つで、MistVVK氏(X)によるIntel系GPU向けの派生版Strata「XeStrata」(エックスイーストラータ)である。これはIntel系GPU向けにCUDAをSYCLで書き直した上で最適化したもので、B70+64GB RAMで報告されている実測値は約80 tok/sとかなりの速度が出ている。
Qwen3.8-Flash-Nextは、次世代のQwen4系で採用されるアーキテクチャを先行公開した実験的モデルとして位置付けられている。アリババ社の開発チームは、同モデルで導入した新技術を基盤としてQwen4系の開発を進める方針を明らかにしている。Qwen4の最終的なモデル構成については未公表の部分もあるが、Qwen3.8-Flash-Nextで採用された主要な設計思想が引き継がれる見込みである。
既にQiitaではStrataに関連する記事が20件ほど投稿されている。最近は本家Strataの更新内容が落ち着きつつある(?)ので、動作検証には良い頃合いに思われる。
先週、Intel系GPUの最新モデル(とはいえ発売日は半年前)であるArc Pro B70を約24万円で購入する機会があった。発売時の希望小売価格からは1.5倍ほど高額ではあるものの、同じ32GBのVRAMを有するRTX 5090が100万円以上に値上がりしていることなどを踏まえると、昨今のVRAM単価を考えればお買い得だったと言える。
とはいえRTX 5090のVRAM帯域はB70の約3倍であり、スペックとしてはRTX 5090が大きく勝る。また、GPU増設に伴い電源を玄人志向のATX対応1000W電源ユニット「KRPW-GS1000W/90+」に交換したため、+約1万円の出費が生じている。
依然としてCUDAは便利で優れた実行環境を提供するものの、上述のStrata派生版のような非NVIDIA系GPU対応のランタイムの開発・チューニングが盛り上がりつつある今日では、新規に調達するGPUとしてNVIDIA系ではなくAMD系やIntel系も有力な選択肢となる。
そこで本稿では、近々リリースされるQwen4系への備えも兼ねて、Intel系GPU(Intel Arc Pro B70)× XeStrataによってQwen3.8-Flash-Nextを動作させてみる。
使用するのはISTA-DASLabが公開する Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS である。モデル本体は2分割GGUFで、合計約75.8GB(70.6GiB)。
XeStrataの対応OS
公式READMEによれば、XeStrataはLinuxとWindowsを正式な動作対象としている。WSL2については「動作する可能性はある」という位置付けであり、正式な動作確認対象には含まれていない。
WSL2ではWindows上の仮想環境でLinuxを動かすため、RAMの一部をWindows側で使用するほか、GPUへのアクセスにもWindowsのドライバや仮想化層が関与する。必ずしもハードウェアの性能を十分に発揮できないわけではないものの、ネイティブLinux環境とは異なる制約や性能差が生じる可能性がある。
WSL2に割り当てるRAMの上限(デフォルトは物理RAMの半分)は変更可能であるが、すべてのメモリを割り当てられるわけではない。
XeStrataを正式な動作対象環境で利用し、OSやドライバに起因する制約をできるだけ避けたい場合は、Linuxを直接インストールする方法が考えられる。Windows環境も維持したいのであればデュアルブート構成にするのが方策の一つである。既存のSSDをパーティションで分割する方法のほか、別のSSDにLinuxをインストールしてWindows側の環境と分離する方法もある。
また、内蔵ストレージを増設したくない場合は、USB接続の外付けSSDなどにLinuxをインストールする方法もある。ただし、UEFIから外付けドライブを起動できることが前提となり、接続方式によっては内蔵NVMe SSDよりも読み書き速度が低下する可能性がある。特に、モデルがストレージ側にも乗る場合は推論速度への影響が大きいと思われる。
【参考記事】
実行環境・比較対象
実行環境は次の通り。Intel Arc Pro B70 32GBとRTX 3060 Ti 8GBのデュアルGPU構成だが、画面出力には後者のみを使用している。RAMに関しては、WSLへの割り当て上限を52GBとしている(デフォルト設定では32GB)。
| 項目 | 実行環境 |
|---|---|
| CPU | Intel Core i7-14700KF |
| RAM | DDR5-5600 64GB/WSLへの割り当て上限52GB |
| 推論用GPU | Intel Arc Pro B70 32GB(PCIe 5.0 x16スロット) |
| 画面出力用GPU | NVIDIA RTX 3060 Ti 8GB(PCIe 4.0 x4スロット) |
| OS | Windows 11+WSL2/Ubuntu 24.04 |
| ビルド環境 | Intel oneAPI 2026.1.1 |
| 対象モデル | Qwen3.8-Flash-Next/IQ3_XXS |
今回、以下のランタイムを比較する。いずれも WSL2 向けの独自の修正を加えたビルドを利用する。
| 比較対象 | 基準バージョン | 比較上の位置付け |
|---|---|---|
| 本家Strata SYCL版 | v0.1.43 | 最新版はv0.1.44だが重大な差異は無い。 |
| XeStrata | xe0.1.43.1 | Intel GPU向け別ランタイムとの比較。組み込みのoneAPI環境でソースビルドする。 |
Arc Pro B70の導入
グラフィックボードの換装~ドライバのインストールはNVIDIA製品とほとんど同じ手順で実施できる。筆者の環境ではASRockマザーボード(ASRock Z790 Steel Legend WiFi)のBIOSが古く、B70がうまく認識されなかったためBIOSの更新も行った(BIOSを9.03から22.02に更新)。BIOS更新の際は、USBフラッシュメモリや外付けSSDなどが必要。
ドライバはIntel® Arc™ Pro B70 Graphicsをインストールする(Proのラベルが付いている方)。インストーラの起動後、以下の項目のみチェックを入れてインストールを実行すればよい。
- Intel Graphics Driver
- Intel Graphics Software
- oneAPI Level Zero SDK
Windowsに複数ユーザーがいる場合は管理者権限のあるユーザーで作業を実施すること。一度インストールできれば他のユーザーの環境にも反映される。
インストールの過程で何度か再起動が行われるので気長に待つ。
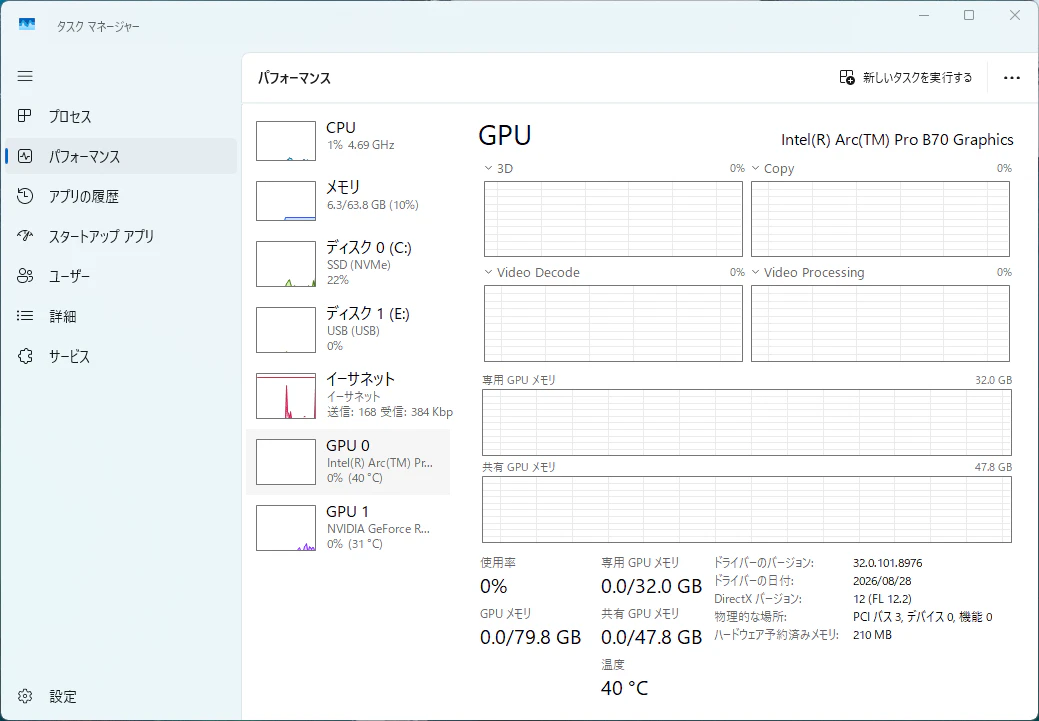
...というわけでGPUを2枚搭載した環境を構築した。Intel Arc Pro B70(32GB)とGeForce RTX 3060 Ti(8GB)のデュアルGPU構成で、すべてのモニターをRTX 3060 Ti側に接続している。そのため、B70をディスプレイ描画に使用せず、搭載する32GBの専用VRAMのほぼ全容量をLLMの推論処理に利用できる構成となっている。Windowsのタスクマネージャーでも32GBの専用VRAMが正常に認識されていることを確認した(下図)。システムメモリは64GBで、DDR5のデュアルチャンネル構成としている。
マザーボードのGPUスロットの端子の規格について
今回用いたPCのマザーボード(Z790 Steel Legend WiFi)には3つのPCIeスロットがあり、現在以下の構成となっている。
| スロット | 接続先 | スロットの接続仕様 | 今回の搭載GPU |
|---|---|---|---|
| PCIE1(最上段) | CPU | PCIe 5.0 x16 | Intel Arc Pro B70 |
| PCIE2 | チップセット | PCIe 4.0 x4 | GeForce RTX 3060 Ti |
| PCIE3 | チップセット | PCIe 3.0 x2 | なし |
PCIeの帯域が狭ければGPU間の転送は遅くなるが、それだけでLLMの推論に不向きとは限らない。重要なのは推論中に何をどの程度転送するかである。
例えば、モデルの層を複数のGPUに分け、各GPUが担当する重みをVRAMに常駐させる方式では、毎tokenの生成時にモデル全体の重みを送り直すわけではない。GPU間を移動するのは主に、分割した層の境界を通る中間結果(activation)である。したがって、PCIe 3.0 x2のスロットでも、追加したGPUのVRAMを利用してモデルを収め、CPUやストレージへのオフロードを減らせるなら、性能面で有利になる可能性がある。
この考え方はPipeline Parallelismにも当てはまる。PyTorchの解説では、段階間でactivationを送受信する方式として説明されている。vLLMの解説でも、NVLinkがない環境では通信負担を抑える選択肢としてPipeline Parallelismを挙げている。
一方、層内の計算を分割して頻繁に通信するTensor Parallelismや、実行中に重みをRAMからGPUへ転送する方式では、PCIe帯域の影響が大きくなり得る。層単位の分割でも、入力長、バッチサイズ、GPU間の転送経路、各GPUの処理速度によっては転送や待ち合わせが律速となる。
そのため、「PCIE3には推論用GPUを増設しない方がよい」や「M2_2を使うと必ず大きく遅くなる」などとは一律には判断できない。VRAMに重みを常駐させることで得られる利点と、通信帯域が減る不利を、実際に使うモデルとランタイムで比較する必要がある。
複数GPU構成の一番のネックは推論速度がどうこうというよりも、電力供給かもしれない。それなりの容量の電源を使わなければ動作不良の元となり、最悪の場合はパーツの破損に繋がる恐れがある。各パーツのTDPの合計から電源の容量を計算しておき、マシン構成に合った電源を用意するべきである。
測定方法と結果
比較条件
比較には、
- Strata v0.1.44.1
- XeStrata xe0.1.43.1
を使用した。冒頭に述べた通り、更新が非常に速いプロジェクトなので、ここでは測定に使用したバージョンを明記しておく。なお、いずれも WSL2 向けの独自の修正を加えたビルドを用いているため、配布状態のバイナリをそのまま比較した結果ではないことに注意。
GPU 計算は B70 に限定し、RTX 3060 Ti は画面出力のみに使用した。モデルと tokenizer を共通にし、同じ入力トークン列を渡した。5 配置 × 2 入力 × 5 回の計 50 件で比較した。
| 項目 | 測定条件 |
|---|---|
| モデル | Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS |
| 設定上の最大 context/KV キャッシュ | 32,768 トークン/FP16 |
| 評価入力 | 約 1K 入力(1,017 トークン)、短い日本語入力(38 トークン) |
| 生成設定 | 温度 0、thinking 無効、生成上限 256 トークン |
| MTP | 有効、window = 4 |
| 集計 | 実行順を入れ替えて各条件 5 回測定した中央値 |
以下では、GPU 上の expert キャッシュ容量を変えた比較と、XeStrata の公式キャリブレーションによる設定調整を分けて示す。
生成速度
5回試行した際の生成速度の中央値を表に示す。この生成速度は実際に出力されたトークン数を decode 時間で割った値である。採用されなかった先読みトークンは含めていない。
| ランタイム | expert キャッシュ容量 | 約 1K 入力(tok/s) | 日本語入力(tok/s) |
|---|---|---|---|
| Strata | 20.5 GiB | 33.89 | 27.51 |
| Strata | 21.5 GiB | 35.69 | 29.23 |
| XeStrata | 20.5 GiB | 64.30 | 59.96 |
| XeStrata | 21.5 GiB | 68.36 | 59.74 |
| XeStrata | 22.5 GiB | 66.67 | 62.91 |
同じExpertキャッシュ容量で比較すると、XeStrataの生成速度はStrataの約1.9~2.0倍となった。一方、最初のトークンが返るまでの時間(TTFT)は、21.5 GiB・約 1K 入力で本家 Strata が 2.78 秒、XeStrata が 3.48 秒であり、本家の方が短かった。
XeStrata のキャッシュヒット率は次の通りである。
| expert キャッシュ容量 | 約 1K 入力 | 日本語入力 |
|---|---|---|
| 20.5 GiB | 75.9% | 63.0% |
| 21.5 GiB | 80.1% | 66.2% |
| 22.5 GiB | 80.3% | 68.8% |
容量を増やすとヒット率は上がったが、約 1K 入力では 21.5 GiB から 22.5 GiB への増加分は小さかった。この変化分は生成速度の変動に概ね対応している。
推論時のメモリは限界まで埋まっている。(PowerSehllとWSL以外は起動していない)

MTPの有効化
今回、MTP(Multi-Token Prediction)の効果はエキスパートの配置を調整する前に実施した別系列の40件の測定で比較した(expertキャッシュは20.5 GiB、KVキャッシュはFP16)。各入力・各設定を5回ずつ測定している。表の数値はいずれも中央値である。
| ランタイム | 入力 | MTP無効 | MTP有効 | 有効化による速度変化 |
|---|---|---|---|---|
| Strata | 約1K | 24.54 tok/s | 31.59 tok/s | 約28.7%向上 |
| Strata | 日本語 | 19.35 tok/s | 26.02 tok/s | 約34.5%向上 |
| XeStrata | 約1K | 44.41 tok/s | 64.63 tok/s | 約45.5%向上 |
| XeStrata | 日本語 | 41.20 tok/s | 60.41 tok/s | 約46.6%向上 |
この試験では、両ランタイムともMTPの有効化によって生成速度が上がり、XeStrataでは約46%の向上となった。MTPにはトークンの先読みと検証のコストを要するため常に高速化できるとは限らないが、今回採用した版・設定・入力では非常に有効であった。
StrataではMTP有効化後も生成トークン列が一致したが、XeStrataでは約1K入力の74番目、日本語入力の123番目から出力が分岐していた。
一般に、MTPを利用した投機的デコーディングでは、予測したトークンをメインモデルで検証するため、原理的には通常のデコーディングと同等の出力品質を維持する。ただし、実装上の数値誤差(CPU/GPUでの丸め方の違い、モデルの層の置き方、など)やサンプリング処理の違いによって、生成される文章が変化する場合がある。
MTP有効時は両者ともwindowを4としたが、継続閾値はStrataが0.8、XeStrataが0.5であり、ランタイム間で全設定が同一というわけではない。
公式キャリブレーションによる調整
続いて XeStrata の公式キャリブレーションを実施した。公式の tools/calibrate.py は変更せずに使用した。expert キャッシュを 21.5 GiB に固定する条件と、容量を自動決定する条件の 2 通りを調べた。ここでいう容量の自動決定は、prefill の実行方式を選ぶ auto とは別の設定である。
公式キャリブレーションでは必要な処理を実行するため生成上限 512 トークンを許可した(前節の通常比較の生成上限は 256 トークン)。キャリブレーションには英語入力を用い、今回の集計では計 372 回の生成を行った。容量自動決定時の expert キャッシュは約 22.37~22.38 GiB、補完 RAM キャッシュは約 17.59~17.60 GiB となった。21.5 GiB 固定時の補完 RAM キャッシュは 18.47 GiB である。
容量自動決定時は、GPU に常駐しない expert の処理配分を指定する pcie-frac が 0.00 の条件で有利だった。これはモデル全体の GPU 配置率がゼロという意味ではない。頻繁に使う expert は GPU、残りは主に RAM 上の重みを使って CPU で処理する分担が、この環境では有力だった。
推測デコードの閾値 spec-min-p の探索では、0.5 より 0.7 の方が速かった。
| expert キャッシュ | spec-min-p = 0.5 | spec-min-p = 0.7 | 同条件内の速度変化 |
|---|---|---|---|
| 21.5 GiB 固定 | 67.80 tok/s | 72.66 tok/s | 約 7.2% 向上 |
| 容量自動決定 | 69.51 tok/s | 74.01 tok/s | 約 6.5% 向上 |
容量自動決定・pcie-frac = 0.00・spec-min-p = 0.7 の場合は、中央値 74.16 tok/s が得られた。この結果から、今回の英語入力では、expert の配置容量を調整するだけでなく、推測デコードの設定を合わせて調整することも有効だったといえる。
CPU worker 数は探索した候補中では 6 が最速だったが、13 との差は約 1% にとどまり、従来の 8 は探索されていない。また、毎回 80 個・160 個の expert を入れ替える設定も、今回の入力では有利にならなかった。容量自動設定も連続的な最適容量探索ではないため、公式キャリブレーションで得られた約 22.4 GiB が厳密な最適値というわけではない。
pcie-frac とは?
--pcie-frac は、VRAMに存在しないExpertの計算を、CPUとGPUにどのような割合で分担させるかを指定するパラメータである。Strata/XeStrataでは、頻繁に使用するExpertの重みをVRAMにキャッシュし、キャッシュに存在しないExpert(システムRAM側に保持されている)についてはCPUで計算するか、PCIe経由でGPUに重みを転送して計算する。
| 設定値 | VRAMにないExpertの処理 |
|---|---|
| 0.0 | CPUで100%計算 |
| 0.2 | GPUへ20%、CPUで80% |
| 0.5 | GPUへ50%、CPUで50% |
| 0.8 | GPUへ80%、CPUで20% |
| 1.0 | GPUへ100% |
例えば --pcie-frac 0.35 なら、VRAMキャッシュにないExpertの約35%をGPU側で計算するよう指定される。
この割合はGPUのVRAM使用率ではない。また、実際の振り分けはExpert数の整数単位で行われるため、常に設定値と完全一致するわけではない。最適値はPCIe帯域、CPU性能、RAM帯域、GPU性能などに依存しするため、GPUへの転送を増やせば必ず高速になるわけではない。
なお、XeStrataは起動時にCPUとGPUそれぞれのExpert計算時間を測定し、自動的に処理を分担する機能を備えている。pcie-fracを固定すると、この自動調整を上書きできる。
spec-min-p とは?
--spec-min-p は、MTPが予測したトークンの確信度に関する閾値である。具体的には、MTPのドラフトモデルが予測したトークンについて、その予測確率が閾値以上であれば、後続のトークンもまとめて予測・検証する候補に加える。
| 設定値 | 動作の傾向 |
|---|---|
0.0 |
確信度による候補延長の制限なし |
0.3 |
低確信度の予測も候補に加えやすい |
0.5 |
中程度の閾値 |
0.7 |
確信度の高い予測を優先 |
0.9 |
非常に高い確信度を要求 |
例えば、MTPが次のような確率でトークンを予測した場合を考えてみる。
| 予測位置 | MTPの予測確率 | 閾値0.5 | 閾値0.7 |
|---|---|---|---|
| 1 | 0.92 | 通過 | 通過 |
| 2 | 0.78 | 通過 | 通過 |
| 3 | 0.62 | 通過 | 停止 |
| 4 | 0.43 | 停止 | 停止 |
ここでの「通過」はメインモデルによる検証対象に加えられることを意味する。
閾値を下げれば多くのトークンを一度に検証できる可能性があるが、誤った予測が増えれば検証コストが無駄になる。逆に閾値を上げすぎると、MTPによる高速化の効果が減少する。
なお、
spec-min-pは通常のサンプリングに使用するmin_pとは異なるパラメータである。
出力の再現性とメモリ使用上の注意
同じ設定で5回測定したところ、生成されたトークン列はすべて一致した。ただし、配置条件を変えると、数値や出力に違いが出た。今回の検証は動作と速度の確認が目的で、設定間で出力品質が同じかどうかは確かめていない。推測デコードの設定変更も、速度が上がっただけでは品質への影響がないとは言えない。
XeStrataの通常性能比較30件では、expertの読み出しによるfile readは0件だった。ただし、推論全体でSSDへのアクセスがなかったわけではない。PLEの読み出し、モデルの読み込み、OSのページング/スワップは別に確認する必要がある。
参考情報として、初期設定の状態ではデコード速度が40 tok/s程度に留まっており、PLEがメモリ側に乗り切っていなかった可能性はある。
また、WSL2内に空きメモリがあるように見えても、Windows側の物理メモリやコミット容量が足りないことがある。キャッシュ容量を増やすときは、WSL2側とWindows側の両方のメモリ状況を確認する。
WSLに割り当てるメモリの量を変更するには以下のようにする。
①
C:\Users\<ユーザー名>\.wslconfigを作成する。
② 次の内容を書いて保存する。(メモリの容量は任意)[wsl2] memory=52GB swap=8GB③ PowerShellで
wsl --shutdownを実行し、WSLを再起動する。
まとめ
今回の環境では、XeStrata は本家 Strata より優れたデコード速度を示し、公式キャリブレーションによる設定調整後は英語入力で約 74 tok/s 前後に達した。最適な配置はキャッシュ容量だけで決まるわけではなく、入力と推測デコードの設定、Windows/WSL2 双方のメモリ余裕にも左右されることが確かめられた。
今回の検証はあくまで動作テストであり、速度を追求する場合はWSLではなくpureなLinux OSを利用すべきである。
結論として、CUDA環境でなくとも(それなりのRAM容量があれば)実用レベルの速度で125BのMoEモデルを動かせることが確認できた。実用的なLLMランタイムが登場してきたことで、Intel系GPUもAMD系GPUも今後さらなる値上がりの波に晒されそうである。
...というわけで、32GB級の非NVIDIA系GPUが20万円台で入手できる時期もそろそろ終わりそうな予感がする。
次回はRAMとVRAMを倍増した構成で今回同様のテストを実施してみたい。
おまけ
XeStrataのGUI・画像の読み取り
setup.sh を実行すればモデルが起動できる(Pythonの実行環境が必要)。Windowsのブラウザで http://127.0.0.1:8095 を開けばチャット用GUIを起動できる(ただしメモリに余裕はないのでChromeの利用はおすすめできない)。

モデル側は、以下のコマンドで画像の読み取りが可能になる。
./setup.sh --setup --vision gpu
今回は残念ながらブラウザの不具合(?)のため、筆者の環境では画像の読み取りテストは実施していない。