
全件Trueを返す検出子を書いてしまった──有無判定に通す2方向テストを実装してみた
はじめに
ある記事チェックツールに「この記事に目次が付いているか」を判定する関数を追加した。
18本の記事に対して実行したところ、全件 True(目次あり)を返した(2026年10月実測)。
最初は「全部の記事に目次が付いているのか、なるほど」と思った。
だが、目次が付いていないとわかっている記事が1本あった。それも True を返していた。
問題はデータではなく、コード(測定器)にあった。
この記事では、2026年10月に実際に踏んだこの失敗を通じて、「有無を判定するコード(検出子)」に必ず通すべき検証パターンを整理する。小規模なスクリプトやツールを自作する場面では、このような見落としが起きやすい。テスト環境が整っていない状況でも、最低限の2ステップで壊れた検出子を発見できることを示す。
背景:記事品質チェックツールを自作している
ブログ記事のSEOや品質を自動で確認するスクリプトをPythonで書いている。
各記事のHTMLやAPIレスポンスを取得し、見出し構造・リンク切れ・字数・画像枚数などをチェックして一覧で出力するツールだ。
そこに「目次(ToC: Table of Contents)の有無を見る」項目を追加することにした。
目次があると読者が記事の全体像を把握しやすくなり、離脱を減らす効果が期待できるからだ。
ツール自体は過去の記事でも何度か取り上げてきた:
今回もその延長として、「ある/ない」を判定する関数の設計について掘り下げる。記事チェック・リンク検査・設定確認など、自動化ツールには「有無を判定する関数」が多く出てくる。このパターンは単純に見えるが、壊れやすいという特性がある。
何が起きたか
構成:記事品質チェックツールへの追加
チェック対象はnote記事の品質検査ツール。記事の本文JSON・公開HTMLを取得して、見出し不足・リンク切れ・タグなどを一括で判定するスクリプトだ。
そこに「目次(TOC)の有無を見る」項目を追加しようとした。
コードはこうなった。
def has_toc(raw_json: str) -> bool:
    """記事に目次があるか判定する"""
    return bool(re.search(r'"index"\s*:\s*true|toc', raw_json, re.I))
note の記事APIレスポンスに "index" というキーが見えていた。
"index": true か、あるいは toc という文字列があれば目次ありと判定する──そういう意図だった。
実行してみると、18本全件が True を返した(2026年10月実測)。
記事1: True
記事2: True
記事3: True
...
記事18: True
「全件目次あり」は明らかにおかしかった。目次のない記事が確実に存在する。
原因を調べた
APIのJSONレスポンスを直接確認する
note の記事APIレスポンスを実際に見てみた。
import json, urllib.request

url = "https://note.com/api/v3/notes/<note_id>"
with urllib.request.urlopen(url) as r:
    data = json.loads(r.read())

# "index" キーを探す
body = data.get("data", {})
for key, val in body.items():
    if "index" in key.lower():
        print(f"{key}: {type(val).__name__} = {repr(val)[:80]}")
出力はこうなった。
index: list = [{'id': 1, 'title': 'はじめに', 'level': 2}, ...]
"index" は「目次を表示するかどうかのフラグ」ではなかった。
見出しの一覧(リスト) だった。
note のAPIでは、すべての記事にこのキーが必ず存在する。見出しが0本の記事でも "index": [] というかたちで空リストが入っている。
つまり、作った検出子は「目次の有無を判定するコード」ではなく、「APIレスポンスの中に "index" という文字列があるか」を見るコードだった。全件Trueを返すのは当然だった。
# ❌ 常にTrueを返す("index"キーは全記事に存在するため)
def has_toc(raw_json: str) -> bool:
    return bool(re.search(r'"index"\s*:\s*true|toc', raw_json, re.I))

# ✅ 実際のHTML構造を見る
def has_toc(html: str) -> bool:
    # noteは <nav aria-label="目次"> でToCを描画する
    return bool(re.search(r'<nav[^>]*aria-label=["\']目次["\']', html))
<nav aria-label="目次"> は、実際に目次UIが描画されているときだけ存在する。公開後のHTMLを確認すると、18本のうち目次ありは7本、目次なしは11本と正しく分かれた(2026年10月実測)。
なぜこの間違いが起きたか

正例だけで試すと壊れた検出子が区別できない
検出子を作るとき、「それが存在するサンプル」だけで試していた。
- 目次がある記事でコードを試す → True が返る → 「動いた」
ここで終わりにした。
「目次がない記事でFalseを返すか」は1回も確かめていなかった。
目次ありサンプルだけで試すと、「目次があるときにTrueを返す検出子」と「常にTrueを返す壊れた検出子」は同じ結果を出す。区別できない。
この見落としが起きやすい理由は、「動いている」の意味が曖昧になりやすいからだ。正例でTrueが返ると、コードが意図通りに動いているように見える。だが、それは「目次ありのときにTrueを返した」という事実にすぎず、「目次なしのときにFalseを返す」という性質は一切確認していない。
人間の判断でも同じことが起きる。「うまくいった例」ばかりを集めて検証すると、失敗する条件に気づけない。コードの場合は、意識しなければ自然と正例に偏る──「動作確認」として手元にある記事で試すと、それが正例ばかりになる傾向があるからだ。
2方向テストは、この構造的な見落としを防ぐための手順だ。「Trueが返るかどうか」だけでなく、「Falseが返るべきときにFalseが返るか」を同時に確認することで、壊れた検出子を早期に見つけられる。
2方向テストとは
定義:2つの方向から検出子をテストする
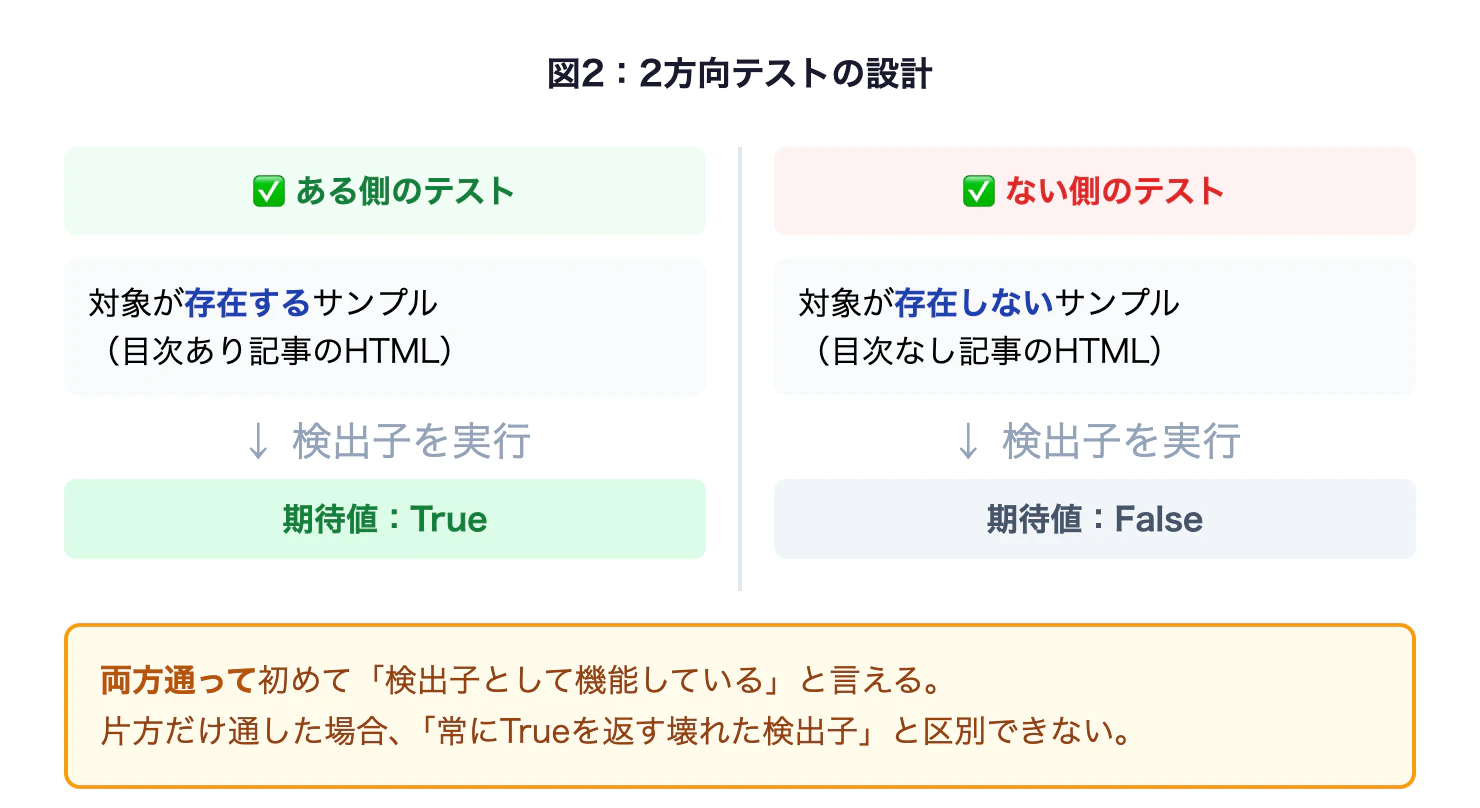
有無を判定するコードを書いたとき、必ず2つのテストを通す。
-
ある側のテスト:対象が存在するサンプルで試す → 期待値は
True -
無い側のテスト:対象が存在しないサンプルで試す → 期待値は
False
この2方向テストの考え方は、テスト設計でいう「境界値テスト」や「等価分割法」に近い。有無の境界(あるときとないとき)の両側を必ずカバーするという発想だ。
「ある側」だけをテストするのは、コインを1面しか確認しないのと同じだ。表が出ることを確かめたとしても、裏が出るかどうかは別の問題だ。有無判定では、「ある」のテストと「ない」のテストはセットで意味を持つ。
なぜ片方だけでは不十分なのか
両方通って初めて「検出子として機能している」と言える。
片方だけ通しても、意味のある保証は得られない。2つの命題は独立しているからだ。「目次があるときにTrueを返す」という事実は、「目次がないときにFalseを返す」という事実を何も保証しない。片方が成り立ってもう一方が成り立たない場合はいくらでもある。今回の壊れた検出子がその典型例だ。
def validate_detector(
    detect_fn,
    positive_examples: list,   # 対象が存在するサンプル群
    negative_examples: list,   # 対象が存在しないサンプル群
) -> dict:
    """検出子の精度を2方向で測る"""
    tp = sum(1 for x in positive_examples if detect_fn(x))
    tn = sum(1 for x in negative_examples if not detect_fn(x))
    fp = len(positive_examples) - tp
    fn = len(negative_examples) - tn

    return {
        "tp": tp,          # 真陽性:あるものをTrueと判定
        "tn": tn,          # 真陰性:ないものをFalseと判定
        "fp": fp,          # 偽陽性:ないのにTrueと判定(今回の問題)
        "fn": fn,          # 偽陰性:あるのにFalseと判定
        "precision": tp / (tp + fp) if (tp + fp) > 0 else 0,
        "recall":    tp / (tp + fn) if (tp + fn) > 0 else 0,
    }
実際に適用してみた

修正前:全件Trueを確認する
修正前の検出子(re.search(r'"index"...', raw_json))に2方向テストを当ててみる。
# テストサンプルを用意する
positive_examples = [article_json for article in articles_with_toc]
negative_examples = [article_json for article in articles_without_toc]

result = validate_detector(broken_detector, positive_examples, negative_examples)
print(result)
# → {"tp": 7, "tn": 0, "fp": 11, "fn": 0, "precision": 0.389, "recall": 1.0}
出力の "fp": 11 を見れば、11件の「目次なし記事」が誤ってTrueと判定されていることがわかる(2026年10月実測)。
修正後:2方向テストが通ることを確認する
修正後の検出子(re.search(r'<nav...aria-label="目次"', html))を同じテストに通すと:
result = validate_detector(fixed_detector, positive_examples, negative_examples)
print(result)
# → {"tp": 7, "tn": 11, "fp": 0, "fn": 0, "precision": 1.0, "recall": 1.0}
"fp": 0 と "fn": 0。18件すべてで正しく判定できている(2026年10月実測)。
全件TrueとFalseに気づく方法
今回は「目次がないとわかっている記事も True を返した」という事実があったので気づけた。
何も知らない状態では、全件Trueを見ても「全部合格」と読んでしまうかもしれない。

疑うべき結果のパターン
全件が同じ値を返したら、まず測定器を疑う。
これが今回最大の教訓だった。
次のいずれかに当てはまるなら、検出子が壊れている可能性が高い:
- ✅ 全件が
True(常にTrueを返す) - ✅ 全件が
False(常にFalseを返す) - ✅ 全件が同じ数値(常に同じ定数を返す)
- ✅ 件数が多いほど陽性率が一定(サンプルサイズに比例している)
実例として、今回の "index" の他にも同様のパターンを踏んだことがある。どれも「正例では動いている」ように見えたが、負例で確認した瞬間に問題が発覚した。
# ❌ Pythonのdictに特定のキーがあるかで判定(キーは常に存在する)
def has_setting(config: dict) -> bool:
    return "enabled" in config  # 常にTrueを返す可能性

# ❌ ファイルサイズで中身の有無を判定
def has_content(filepath: str) -> bool:
    return os.path.getsize(filepath) > 0  # 空でないだけでは「意味のある内容がある」とは言えない

# ❌ HTTPステータスで「ページが生きているか」を判定
def is_alive(url: str) -> bool:
    return requests.head(url).status_code == 200  # 200でも期待するコンテンツがない場合がある
検出子が壊れやすいパターン

以下は「常にTrueを返す」検出子になりやすいパターンだ。これらのパターンに共通するのは、「検索対象が存在するかどうかに関係なく、常に何かにマッチするパターンを書いてしまっている」という点だ。
コードを書いたときにこのパターンに気づくのは難しい。なぜなら、正例で試すと「Trueが返る」という期待通りの動作をするからだ。壊れている部分は「負例でもTrueを返す」という事実で、それは正例だけのテストでは見えない。
1. 名前が似ているが意味が違うキーを読む
今回がこのケース。"index" という名前から「目次のフラグ」を期待したが、実体は「見出しのリスト」だった。
APIのJSONキーは意図した意味を持たないことがある。名前だけで判断せず、実際の値を確認する。特にAPIのレスポンスは設計者の命名規則に依存するため、同じ名前でも意味が異なることがある。実際の値の型(bool/list/string)と、その値が持つ意味(フラグ/リスト/テキスト)を両方確かめることが重要だ。
2. 親要素の存在だけを見て、その内容を見ない
# ❌ <ul>が存在するかだけを見る(ul は他の用途でも使われる)
def has_nav_list(html: str) -> bool:
    return bool(re.search(r'<ul', html))

# ✅ aria-label で目的を絞る
def has_toc(html: str) -> bool:
    return bool(re.search(r'<nav[^>]*aria-label=["\']目次["\']', html))
3. ページに必ず存在するパターンにマッチさせる
# ❌ "content" という単語はほぼ全ページに存在する
def has_main_content(html: str) -> bool:
    return "content" in html.lower()
4. 除外条件が広すぎて全件がスコープ外になる
# ❌ 短い記事を除外していたら、実際はほとんどの記事が短い
def long_articles(articles):
    return [a for a in articles if a["chars"] > 10000]
    # → 該当0件 → 全件が「短い記事」として除外される
この4パターンのうち、「除外条件が広すぎる」パターンは全件Falseになるため、一見別の問題に見える。しかし根本的な構造は同じだ。「測定対象が存在するかどうかに関係なく、常に同じ結果を返している」という意味では、全件True・全件False・偏った結果のいずれも同じカテゴリの問題だ。2方向テストはこれらをまとめて検出できる。
正しいサンプルの選び方

負例を意図的に集める
2方向テストを有効にするには、「負例(対象が存在しないサンプル)」を意図的に集める必要がある。
正例(ある側)は自然に集まりやすい。目次のある記事を探すのは簡単だ。
問題は負例(ない側)の扱いだ。つい正例だけで検証して終わりにしてしまう。
# 負例を確保するための実践的なアプローチ
def get_test_samples():
    """
    正例と負例を意図的に集める
    """
    # 正例:確実に目次を持つ記事(編集画面で目次をONにしたもの)
    positive = fetch_articles_with_known_toc()

    # 負例:確実に目次を持たない記事(目次機能を使ったことがない記事)
    negative = fetch_articles_with_known_no_toc()

    # 最低限のバランス:両側に最低1件ずつ
    assert len(positive) >= 1, "正例が1件もない"
    assert len(negative) >= 1, "負例が1件もない"

    return positive, negative
負例が用意できない場合のチェック方法:
- 単体で試す:検出子を単独で実行し、「True/Falseが混在しているか」を確認する。全件が同じなら疑う
- 人工的な負例を作る:「確実に目次がないこと」がわかる空のHTMLで試す
- 境界値を確認する:検出対象が1つ/0つのサンプルで両方試す
負例が用意できないときの対処
「負例が手元にない」という状況はよく起きる。目次の有無を判定する場合なら、「確実に目次がない記事」が手元になければ、人工的に作るしかない。
どうしても負例を集められない場合は、人工的に作るのが現実的だ。
# 人工的な負例の例
empty_html = "<article><p>テスト本文</p></article>"
empty_json = '{"id": "test", "index": [], "content": "test"}'

# 空のHTMLで試して、Falseが返るか確認する
assert not has_toc(empty_html), "空のHTMLでFalseが返るべき"
assert not has_toc_broken(empty_json), "(壊れた検出子)空のJSONでもFalseが返るべき"
# → 後者は AssertionError になる → 壊れているとわかる
実装の最終形
ここまでの内容をまとめた実装を示す。壊れた検出子と正しい検出子の両方を残しつつ、validate_detector で2方向テストをかけ、audit_all_detectors で一括監査する構成だ。
コードを単体でテストするのではなく、「正例群と負例群を渡して精度を測る」関数を用意しておくことで、新しい検出子を追加するたびに機械的にチェックできる。テストを書く手間も減る。
この構造は、目次の有無を判定する場合に限らず、「記事にアフィリエイトリンクが含まれるか」「meta descriptionが設定されているか」「h1が1つだけか」といった、ほかの有無判定にも同様に適用できる。
import re
import json
import urllib.request
from typing import Callable


def has_toc_broken(raw_json: str) -> bool:
    """❌ 壊れた検出子:常にTrueを返す"""
    return bool(re.search(r'"index"\s*:\s*true|toc', raw_json, re.I))


def has_toc(html: str) -> bool:
    """✅ 正しい検出子:公開HTMLのDOM構造を見る"""
    return bool(re.search(r'<nav[^>]*aria-label=["\']目次["\']', html))


def validate_detector(
    detect_fn: Callable,
    positive_examples: list,
    negative_examples: list,
    label: str = ""
) -> dict:
    """
    検出子の精度を2方向で測る。

    Returns:
        tp: 真陽性(あるものをTrueと判定)
        tn: 真陰性(ないものをFalseと判定)
        fp: 偽陽性(ないのにTrueと判定)← 今回の問題
        fn: 偽陰性(あるのにFalseと判定)
    """
    tp = sum(1 for x in positive_examples if detect_fn(x))
    tn = sum(1 for x in negative_examples if not detect_fn(x))
    fp = len(positive_examples) - tp
    fn = len(negative_examples) - tn

    result = {
        "label":     label,
        "tp":        tp,
        "tn":        tn,
        "fp":        fp,
        "fn":        fn,
        "precision": tp / (tp + fp) if (tp + fp) > 0 else 0,
        "recall":    tp / (tp + fn) if (tp + fn) > 0 else 0,
    }

    # ⚠️ 全件が同じ値なら警告を出す
    total = len(positive_examples) + len(negative_examples)
    all_true  = tp + fp == total
    all_false = tn + fn == total
    if all_true:
        print(f"  ⚠ [{label}] 全件True:検出子が壊れている可能性があります")
    if all_false:
        print(f"  ⚠ [{label}] 全件False:検出子が壊れている可能性があります")

    return result


def run_validation():
    """検出子の検証を実行する"""
    # ここでは模擬サンプルを使う
    # 実際には公開記事のHTMLを取得する

    html_with_toc = '<nav aria-label="目次"><ul><li>セクション1</li></ul></nav>'
    html_without_toc = '<article><h2>セクション1</h2><p>本文</p></article>'

    # 疑似JSONレスポンス
    json_with_toc    = '{"index": [{"title": "h1"}], "content": "..."}'
    json_without_toc = '{"index": [], "content": "..."}'

    print("=== 壊れた検出子(JSONキーを読む)===")
    result = validate_detector(
        has_toc_broken,
        [json_with_toc],
        [json_without_toc],
        label="has_toc_broken"
    )
    print(f"  tp={result['tp']}, tn={result['tn']}, fp={result['fp']}, fn={result['fn']}")

    print("\n=== 正しい検出子(HTMLのDOMを読む)===")
    result = validate_detector(
        has_toc,
        [html_with_toc],
        [html_without_toc],
        label="has_toc"
    )
    print(f"  tp={result['tp']}, tn={result['tn']}, fp={result['fp']}, fn={result['fn']}")


if __name__ == "__main__":
    run_validation()
実行すると次のように出力される。
=== 壊れた検出子(JSONキーを読む)===
  ⚠ [has_toc_broken] 全件True:検出子が壊れている可能性があります
  tp=1, tn=0, fp=1, fn=0

=== 正しい検出子(HTMLのDOMを読む)===
  tp=1, tn=1, fp=0, fn=0
なぜAPIのJSONではなくHTMLを使うのか

APIのJSONは「データ」を返し、公開HTMLは「描画結果」を返す。
今回の目次判定では:
| 判定ソース | 内容 | 問題 |
|---|---|---|
APIの "index" キー |
見出しのリスト(常に存在) | 目次表示の有無と無関係 |
APIの "toc" キーを探す |
存在しない(noteAPIにはない) | 常にFalseになる |
公開HTMLの <nav aria-label="目次">
|
ユーザーに実際に見える構造 | 正確 |
「ページに何が表示されているか」を判定したいなら、公開HTMLを使う。APIは便利だが、描画結果とは限らない。
この原則はnoteに限らない。
- Webページの要素の有無を判定するなら、レンダリング後のDOMを見る
- 設定フラグの効果を判定するなら、その設定が適用された結果を見る
- ファイルの内容を判定するなら、実際にファイルを開いて読む
「設定している側」ではなく「効いている側」を見ることで、意図と実装のずれを検出できる。
この判断基準は、テストコードにも当てはまる。「設定フラグがTrueになっているか」ではなく、「その設定がユーザーに見える動作として反映されているか」を確認する。APIのJSONは中間データであり、最終的な出力ではない。最終出力(公開HTML・レンダリング結果・実際のUI)を見ることで、実装の意図と動作のずれを見つけられる。
記事チェックツールを書くなら、「記事の設定」ではなく「読者に届いている情報」を測る。それがツールの目的と一致している。APIを便利に使いながら、「これは描画結果か設定値か」を意識しておくことで、今回のような見落としを防げる。
「全件Trueが出たら疑う」を自動化する
def audit_all_detectors(detectors: dict, positive: list, negative: list):
    """
    複数の検出子を2方向で一括検査する。
    全件True/Falseの検出子を報告する。
    """
    suspicious = []

    for name, fn in detectors.items():
        result = validate_detector(fn, positive, negative, label=name)
        total = len(positive) + len(negative)

        if result["fp"] + result["tp"] == total:  # 全件True
            suspicious.append((name, "全件True(常にTrueを返す疑い)"))
        elif result["fn"] + result["tn"] == total:  # 全件False
            suspicious.append((name, "全件False(常にFalseを返す疑い)"))
        elif result["precision"] < 0.5:
            suspicious.append((name, f"precision={result['precision']:.2f}(偽陽性が多い)"))
        elif result["recall"] < 0.5:
            suspicious.append((name, f"recall={result['recall']:.2f}(偽陰性が多い)"))

    return suspicious
このような監査関数を用意しておくと、検出子を追加するたびに自動で2方向テストを通せる。
audit_all_detectors に複数の検出子をまとめて渡すと、全件True・全件False・精度低下のいずれかに該当するものが一覧で出てくる。ツールのメンテナンス中に新しい検出子を追加したとき、この関数を一度回しておくだけで「壊れたまま本番に出た」を防げる。
実際に使ってみると、予想外の検出子が引っかかることがある。「動いていると思っていたが全件Falseだった」というケースも多い。全件Trueと対称的で、こちらは「何も検出できていない」という壊れ方だ。どちらも2方向テストでしか見つけられない。
検出子の信頼性は、積み上げてきた正例・負例の品質に依存する。サンプルを増やすほど、見つけられる不具合が増える。まず両側を最小限揃えることから始めて、徐々に増やしていくのが現実的だ。完璧なサンプルセットを最初から用意しようとすると、テスト自体が後回しになる。小さく始めて、問題が見つかるたびにサンプルを追加していくやり方の方が実用的だ。
まとめ
有無を判定するコードには、必ず2方向テストを通す。
- ある側のテスト:対象が存在するサンプルでTrueが返るか
- 無い側のテスト:対象が存在しないサンプルでFalseが返るか
全件が同じ値を返したら、データではなく測定器を疑う。
今回の失敗の構造はシンプルだ。
「目次あり記事でTrueが返った」
  ↓ これだけで「動いた」と判断した
「目次なし記事でもTrueが返っていた」
  ↓ 全件Trueに気づいて発覚
「"index"キーは全記事に存在する」
  ↓ 根本原因はAPIキーの取り違え
「公開HTMLのDOMを直接見るべきだった」
有無を判定するコードは書くのが簡単で、壊れているときも動いているように見える。
その特性を知った上で、2方向テストを習慣にする。
「データが少ない段階で正例と負例をそれぞれ揃える」だけで、この種のバグの大半は防げる。完璧なテストスイートを最初から用意する必要はない。まず両方向に最低限試す──この1ステップが最も大きな効果を持つ。
記事チェックツールのような自作ツールは、エラーが出なければ「動いている」に見える。だが、静かに間違い続けているコードも同じ見た目をしている。定期的に「全件同じ値を返していないか」を確認する習慣を持つだけで、早期発見につながる。
次の1アクション
次の1アクションとして、手元に有無を判定する関数が1つでもあれば、今すぐ2方向テストを通してみる。既存のコードに追加するなら、validate_detector(fn, positive_examples, negative_examples) を1回呼ぶだけでいい。新しく書くなら、最初の行に「正例1件でTrueになるか」「負例1件でFalseになるか」の確認を入れる。
記事品質チェックや自動化ツールの設計・実装について相談したい場合は、mainichi-lab.com/contact からこちらから連絡できる。