
ブラウザー操作のログに CLICK とだけ残っていても、どの画面を見て、どの候補から選んだのかは分かりません。AI の判断をレビューするには、返答と、その返答に渡した入力を一緒に確認する必要があります。
Jevfast.com の「What Jev decides」は、ソースコードを確認したプロジェクトについて、Jev に渡す指示と状態、返答を並べたチャートです。この記事では Jev Ultrafast と fx を使い、返答が実際の操作に変わる箇所を読みます。最後に、ブラウザー操作のレビュー用に小さな検査例を示します。
Jev は TypeSafe AI の判断用モデルです。ここで扱う Choice は、アプリが渡した候補から答えを選ぶ形式です。候補を作る処理と、その答えを実行する処理は、各プロジェクトのコードにあります。
Jev Ultrafast は操作と対象を別々に選ぶ
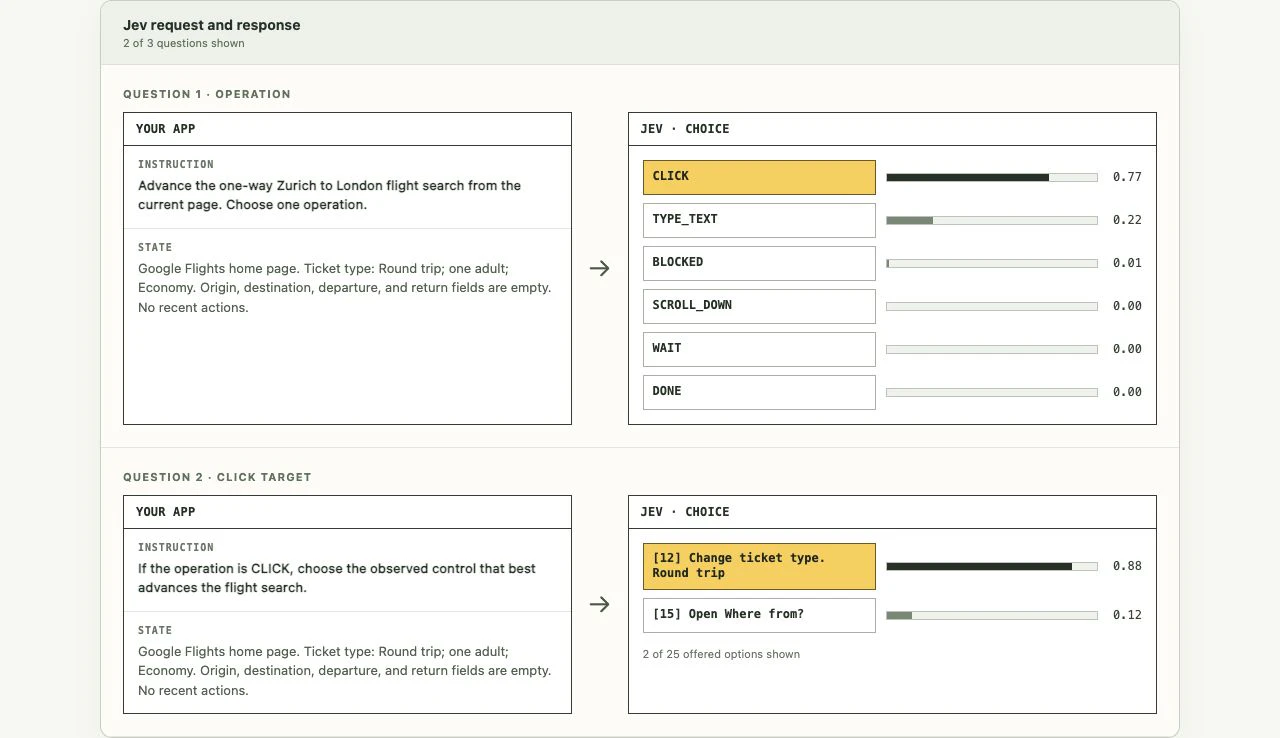
図は記録された返答の例で、3 問中 2 問を表示しています。
この場面の目標は、チューリッヒからロンドンへの片道便を探すことです。画面は往復の設定で、出発地と目的地はまだ空欄です。
- 操作の質問では
CLICKが 0.77。 - クリック対象の質問では
[12] Change ticket type: Round tripが 0.88。
この二つの値は、異なる質問の候補に付いた確率です。予約成功率として読んだり、掛け算してタスク全体の成功率にしたりはできません。
固定コミットの model.py を読むと、画面から観測した要素を操作別の候補にまとめています。操作が決まると、その操作に対応する対象の返答を検証し、候補にひも付いたアクション ID を取り出します。使わない操作の対象の返答が、そのまま別の操作を起こす構造にはなっていません。
また、validate_choice は候補 ID、確率の範囲と合計、選択された候補と最大確率の整合性などを検査します。返答が JSON として読めることに加え、アプリが用意した候補と整合しているかも確認できます。
チャートの左側にある画面の状態と、右側で選ばれた対象を見比べると、この対応をコードから探しやすくなります。Jevfast の Ultrafast ページにはチャートとソースへのリンクがあります。
fx は実行待ちのツール呼び出しを質問に含める
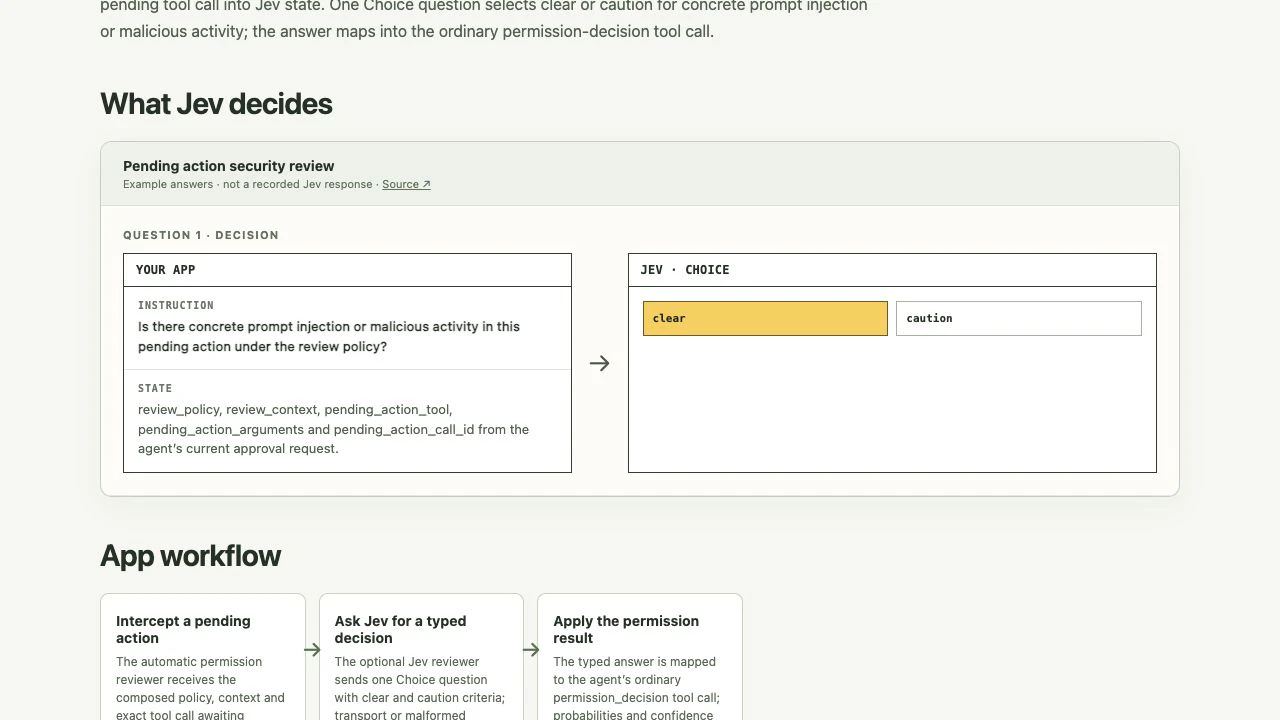
図の回答は説明用です。実際の Jev 返答を記録したものではありません。
fx は Zig 製のコーディングエージェントで、任意の設定として Jev を使う自動権限レビュアーがあります。この経路では、具体的なプロンプトインジェクションや悪意のある動作があるかを clear / caution で判定します。
固定コミットのリクエスト組み立て処理には、次の入力があります。
| 入力 | レビュー時に確認すること |
|---|---|
review_policy |
何を許可・拒否する基準なのか |
review_context |
判定に必要な周辺情報があるか |
pending_action_tool |
対象のツール名が合っているか |
pending_action_arguments |
実際に実行する引数と一致するか |
pending_action_call_id |
どの呼び出しに対する返答か追えるか |
チャートからは、権限の質問にも対象の操作を入力していることが読み取れます。例えば、ツール名だけ同じでも、書き込むパスや送信先が違えば、レビュー対象も変わります。
このレビュアーの clear は、そのポリシーで具体的な悪意を検出しなかったという分類です。削除や送信を含む操作全般の安全性を保証する値としては扱えません。fx は返答を既存の permission_decision インターフェースへ渡し、確率や confidence を追跡用に記録します。それらを追加の判定しきい値にはしていません。
fx の Jevfast ページで質問の範囲を確認してからコードを読むと、どこまでをモデルに判断させているかを追えます。
操作対象の対応だけを小さくテストする
Ultrafast の例を参考にすると、最初に切り出せる検査は「選んだ操作に、その対象が含まれるか」です。
以下はこの記事用の Python の最小例です。元プロジェクトの実装や Jev API クライアントではありません。確率の検証、画面の再取得、権限の確認は含めず、操作と対象の対応だけを検査します。コードはブラウザーを操作しません。
def resolve_target(operation, target, candidates):
    allowed = candidates.get(operation)
    if allowed is None or target not in allowed:
        raise ValueError("operation/target mismatch")
    return allowed[target]


candidates = {
    "CLICK": {"12": "ticket-type-button"},
    "TYPE_TEXT": {"13": "origin-input"},
}

assert resolve_target("CLICK", "12", candidates) == "ticket-type-button"

for operation, target in [
    ("CLICK", "13"),        # 別の操作の対象
    ("CLICK", "99"),        # 候補にない対象
    ("UNKNOWN", "12"),      # 候補にない操作
]:
    try:
        resolve_target(operation, target, candidates)
    except ValueError:
        pass
    else:
        raise AssertionError((operation, target))
このテストが通っても、ボタンが目的に合っているかは別に確認します。画面が更新されていれば、保存した番号が同じ要素を指すとも限りません。実際に組み込むときは、観測した画面と候補一覧を一緒に保存し、実行直前の対象との対応も確認する設計が必要です。
レビューで残す記録
二つの例では、判断に使う入力と、返答を渡す先が異なります。操作を追加するときは、次の項目を一つの判断単位で追えるようにすると、失敗した箇所を調べやすくなります。
| 記録 | 確認したい問題 |
|---|---|
| 指示と状態 | モデルに必要な情報を渡したか |
| 候補一覧と返答 | 想定外の値を受け取っていないか |
| 対象の ID と引数 | 判定した操作と実行した操作が同じか |
| 検証結果と実行結果 | 返答の不正、対象の不一致、実行エラーを区別できるか |
これらの記録に秘密情報や個人情報が含まれる場合は、保存する項目とアクセス権を絞ります。公開記事の図にも、実際の返答か、説明用の回答かを添えておくと、読み手が結果を評価できます。
Jevfast.com の判断チャートは、このレビューを始めるための見取り図として使えます。使いたいパターンを見つけたら、リンク先の固定コミットで、返答の検証と実行処理まで確認してください。
参照
執筆者は Jevfast.com の運営者です。Jevfast は TypeSafe AI とは独立したサイトです。本文は AI の支援で作成・推敲し、記載したソースコードとチャートを確認しています。