

前回、「Haskell の Int は『空間』でもある — プログラミング言語のデータ型が持つもうひとつの顔」という記事を公開しました。
序:この記事は何を目指すか
前回の記事では、Haskell の Int や [Char] が「点と道の集まり」としての空間になっている、という話をしました。
あの記事の最後で、円周 $S^1$ を Cubical Agda のデータ型として書くところまで見ました。
お読み頂いた皆様の中には、こう思われた方もおられるかもしれません。
『ちょっと待ってほしい。Haskell と Cubical Agda は、どちらもデータ型を書ける言語だが、Cubical Agda は円周をコンストラクタで定義できて、Haskell はできない。
この違いはどこから来ているのか?』
と。
この問いに対する筆者からの返答は、両者(Haskell と Cubical Agda)の背後にある 型理論が違うから 、というものです。
型理論 とは、おおまかに言えば、 「どんなデータ型を、どう作っていいか」を決めるルールブック です。
Haskell の背後にも 型理論 があり、Rocq や Agda の背後にも 型理論 があり、Cubical Agda の背後には さらに新しい型理論 があります。
この記事では、その 型理論の家系図 を、単純なものから順に たどります。
最終的に ホモトピー型理論(HoTT) にたどり着きます。
Haskell の日常から出発して、大きな迂回はせず、まっすぐ登ります。
1. 型理論とは、そもそも何か
「型理論」 と聞くと、大学の情報科学の講義で扱う専門分野に思えるかもしれません。
しかし、皆様はすでに日々、型理論をお使いになられているのではないでしょうか。
例えば、Haskell で Int -> Int と書くとき、皆様は型理論の記法でコードタイピングしているのです。
型理論 とは、次の 3 つを決めるルールブック です。
-
型を作るルール —
Intや[Char]やInt -> Intのような型を、どう組み立てていいか - 値を作るルール — 各々の型について、どんな値が住んでいるか
- 値を組み合わせるルール — 値をどう関数に渡し、どう結果を取り出すか
Haskell が採用している型理論と、Rocq や Agda が採用している型理論では、この 3 つのルールの中身が違います。
だから、書けるプログラム、書けるデータ型が違ってきます 。
この記事では、単純なルールブックから始めて、少しずつルールを追加 していきます。
ルールが増えるたびに、書けるものが増え、そして書けるものの意味も変わります 。
2. 出発点 — 単純型付きラムダ計算(1940年)
型理論の最も単純な形は、単純型付きラムダ計算 (simply typed lambda calculus)です。Alonzo Church が 1940 年に定式化しました。
これは、Haskell の ほんの一部分だけを取り出した、ミニ Haskell だと思ってください。次の 2 つのルールだけ があります。
- 型は、基本型(例:
Bool)と、関数型(例:Bool -> Bool)だけ - 値は、変数、関数の適用、ラムダ抽象(無名関数)だけ
Haskell 風に書くとこうです。
not :: Bool -> Bool
not x = if x then False else True

andB :: Bool -> Bool -> Bool
andB x y = if x then y else False
ここまでで表現できるのは、これだけです。
再帰も、リストも、整数もありません。
単純型付きラムダ計算 に整数はビルトインされていないのです。
整数を扱いたければ、Bool の組み合わせで頑張るか、あるいは自然数を「Church エンコーディング」という技巧で表現します。
「たったこれだけで何ができるの?」 と思われるかもしれません。
実際、それが単純型付きラムダ計算のポイントで、 とてもシンプル、だから性質を数学的に調べやすい のです。
この単純さの上に、あとから機能を積み上げていくのが型理論の歴史 です。
この段階の意味論
単純型付きラムダ計算では、型は「集合」だと思って読めます。
Bool は 2 元集合、
Bool -> Bool は 2 元集合から 2 元集合への関数全体の集合、と読めます。
まだ「空間」の話は出てきません。
(補足説明)
「意味論」という言葉を初めて見る方のために、短く補足します。
意味論(semantics)とは、プログラムや型といった記号列が、数学的に何を意味するのか ── どのような計算を行い、どのような結果をもたらすのか ── を厳密に定義するための枠組みです。
意味の与え方にはいくつかの流儀があり、この記事で「この段階の意味論」として確認していくのは、そのうち「型を、集合や空間といった数学の対象として解釈すると、何と読めるか」という流儀です。以降の節でも、各段階の終わりにこの解釈を確認していきます。
3. 一段登る — 多相型(1972年)
次の階段は、多相型 (polymorphism)の導入です。
Jean-Yves Girard が 1972 年に発表した System F と呼ばれる 型理論 が、その代表です。
多相型 とは、Haskell の次のような型のことです。
id :: forall a. a -> a
id x = x

length :: forall a. [a] -> Int
forall a. の部分に注目してください。ここは「どんな型 a についても」と読みます。
id は「どんな型 a を持ってきても、a の値を受け取って a の値を返す関数」です。
Haskell をすでにお使いになられている方々は、多相型を意識せずに、Haskell のコードを書かれているのではないでしょうか。
map、filter、foldr、これらはすべて多相型です。
多相型がなければ、Int 用の map と String 用の map を別々に書かなければなりません。

この段階の意味論
多相型 は、「型そのものを引数に取れる関数」を許します。
この一歩が、実は大きな飛躍です。
型についても抽象化し、使う型を指定して関数を使える、という発想が入ってきます。
この発想が、後で「型と値の区別を無くす」という次のステップにつながります。
📌 中上級者向け補足:厳密性を担保した説明をすると ── 「型そのものを引数に取る」の厳密な意味
本文では「型そのものを引数に取れる関数」と説明しました。より厳密には、System F の多相性では、型について抽象化した項を作り、型を指定してその項を型適用することができます。
ここでいう「型を引数に取る」は、型がプログラム実行時の値になる、という意味ではありません。型抽象・型適用という仕組みによって、同じ項を複数の型に対して使えるようにする、という意味です。
したがって、本文の説明は直感を優先した言い方であり、実際の System F では型と通常の実行時の値は区別されています。
この段階でも意味論はまだ集合
多相型を集合として解釈するのは技巧が必要ですが(Reynolds 1984 の困難など、細かい話は省きます)、大枠では「型 = 集合」の見方で通用します。
4. 依存型 — Martin-Löf 型理論(1972年〜)
ここが、Haskell との別れ道です。
依存型 (dependent types)を導入する型理論に進みます。
スウェーデンの論理学者 Per Martin-Löf が 1972 年以降に発表した一連の型理論が、この道の源流です。
依存型 とは、「値によって型が決まる」型 のことです。
例えば、「要素数を指定した List 型」を書くことができます。
Haskell では叶いませんが、Agda や Idris 2 では次のように記述することができます。
Vec : Type → Nat → Type
これは、「型 $A$ と自然数 $n$ を受け取って、型を返す」関数です。
Vec Int 3 は、「長さ 3 の Int のリスト」という型になります。
Vec Int 4 はまた別の型です。
リストの長さという「値」が、型を決めている のです。

これができると何が嬉しいかというと、たとえば、次のように記述することができるのです。
head : {A : Type} → {n : Nat} → Vec A (n + 1) → A
「 長さが少なくとも 1 以上の Vec からしか、head を呼べない」ということが、型の段階で保証されます 。
Haskell で空リストに head を呼ぶと実行時エラーになる、あの問題が、依存型ではコンパイル時に防ぐことができる のです。
Martin-Löf 型理論の特徴的な型
Martin-Löf 型理論には、単純型付きラムダ計算にはなかった、いくつかの重要な型 が組み込まれています。
-
Σ 型(シグマ型、依存対) — 「まず値 a : A を作り、それに依存する型 B(a) の値を作る」ペア型です。Haskell のタプル
(A, B)の一般化です。
-
Π 型(パイ型、依存関数型) — 「引数 a : A を受け取り、a に依存する型 B(a) の値を返す」関数型です。Haskell の
A -> Bの一般化です。上のheadの型がまさにこれです。
-
恒等型(identity type) — これが最も重要です。任意の型 A と、その 2 つの値 x, y : A に対して、 「x と y が等しい」ということ自体を新しい型として自動的に生成する型 です。Agda では、
x ≡ yと書きます。
Σ 型のユースケース を2例、見ていただきます。
【Σ型の利用事例 1】 — 長さが実行時にしか決まらないデータを、長さの保証つきのまま返す(Idris 2)
長さつきリスト Vect n a をフィルタすると、何個の要素が残るかは、コンパイル時には分かりません。実行してみないと決まらないからです。「長さは分からない。でも、長さの保証は捨てたくない」── この板挟みを、Σ 型が解決します。Idris 2 では Σ 型(依存対)を (m ** ...) と書きます。
filterVect : (a -> Bool) -> Vect n a -> (m ** Vect m a)
filterVect p [] = (0 ** [])
filterVect p (x :: xs) =
  case filterVect p xs of
    (m ** ys) => if p x then (S m ** x :: ys)
                        else (m ** ys)
読み方を解説します。
- 1 行目の第 1 引数
(a -> Bool)は、各要素を「残すか、捨てるか」判定する条件関数 です。要素を 1 つ受け取り、残すならTrue、捨てるならFalseを返します。つまり、ここでも要素ごとのチェックは行われています。ただし後述のユースケース 2 と違い、返るのはBoolの判定結果だけで、「チェックに通った」という証明は値に残りません。この違いは後でもう一度触れます。
- 1 行目の返り値の型
(m ** Vect m a)が Σ 型です。「ある自然数 m と、長さ m のベクトルの組」と読みます。長さ m は呼び出し側が指定するのではなく、関数が結果のベクトルと一緒に差し出す のです。
- 2 行目、入力が空なら「長さ 0 と、空ベクトルの組」
(0 ** [])を返します。
- 4〜6 行目、まず残り
xsをフィルタした結果を(m ** ys)として受け取ります。先頭xが条件pを満たすなら、ysにxを積んで(S m ** x :: ys)(長さ m + 1 と、そのベクトルの組)を返します。満たさないなら、受け取った組をそのまま返します。
- ポイントは、「長さが分からない」ことを「長さを忘れる」ことなく表現できている 点です。受け取った側は組から m を取り出し、以後も「長さ m のベクトル」として型の保証つきで使い続けられます。Idris 2 の標準ライブラリの
filterも、実際にこの型をしています。
具体的な設例で、実装コードを見てみます。センサーから 6 回分の測定値を受け取ったが、欠測は -1 で記録されている、という場面です。有効な測定値だけを取り出します。
readings : Vect 6 Int
readings = [23, -1, 25, 24, -1, 26]

valid : (m ** Vect m Int)
valid = filterVect (\x => x >= 0) readings
-- 評価すると (4 ** [23, 25, 24, 26]) になります
読み方を解説します。
- 1〜2 行目、測定値のベクトルです。この時点では長さ 6 だと型
Vect 6 Intに明記されています。
- 5 行目、条件関数として無名関数
\x => x >= 0(「x は 0 以上か」)を渡しています。これが先ほどの(a -> Bool)の実物です。欠測の -1 はここでFalseと判定され、捨てられます。
- コメント行のとおり、結果は
(4 ** [23, 25, 24, 26])です。「有効な測定値は 4 個で、その 4 個はこれです」という、個数と中身の組 が返っています。この後の処理(平均を取る、グラフに描くなど)は、Vect 4 Intという長さの保証つきの型で安全に書き続けられます。
【Σ型の利用事例 2】 — 「検証済みの値」を、検証の証明ごと持ち運ぶ(Agda)
Web サービスの年齢確認を考えます。未検証の入力値と、検証済みの年齢を、型のレベルで区別したい場面です。
open import Data.Nat using (ℕ; _≤_)
open import Data.Product using (Σ; _,_)

Adult : Set
Adult = Σ ℕ (λ age → 18 ≤ age)
読み方を解説します。
- 最終行が本体です。
Adultという型を、「ある自然数 age と、『18 ≤ age』の証明の組」として定義しています。第 1 成分は年齢の値、第 2 成分はその年齢が 18 以上であることの証明です。
- 第 2 成分の型
(λ age → 18 ≤ age)が、第 1 成分の値 age に依存している ことに注目してください。これが「依存」対と呼ばれる理由です。Haskell のタプル(A, B)では B が A の値を参照できないのに対し、Σ 型では参照できます。
- 実務での使い方はこうです。入力の境界に検証関数(ℕ を受け取り、検証に成功したら
Adultを返す関数)を 1 つ置きます。以後、酒類の販売処理のような関数は、引数の型をAdultと宣言するだけで、検証済みの値しか受け取れなくなります。検証したという事実そのものが、証明として値に同梱されて運ばれるからです。
- Haskell でも newtype と検証関数で「作れる場所」を制限する手法(smart constructor)はありますが、検証の中身までは型に現れません。Σ 型はこの手法の強化版で、「何を検証したのか」まで型が語ります。
具体的な設例で、判定するコードを動かしてみます。境界に置く検証関数 checkAdult を実装し、年齢 20 と年齢 15 を実際に判定させます。
open import Data.Nat.Properties using (_≤?_)
open import Data.Maybe using (Maybe; just; nothing)
open import Relation.Nullary using (yes; no)

checkAdult : ℕ → Maybe Adult
checkAdult age with 18 ≤? age
... | yes proof = just (age , proof)
... | no  _     = nothing
読み方を解説します。
- 5 行目、
checkAdultの型は「自然数を受け取り、検証に成功すればAdultを、失敗すれば何も返さない」です。Maybeは Haskell のMaybeと同じものです。
- 6 行目の
18 ≤? ageが判定の本体です。_≤?_は「18 ≤ age が成り立つかどうか」を実際に計算する判定関数ですが、ここがユースケース 1 の(a -> Bool)との違いの回収地点 です。Boolを返すのではなく、成り立つなら 証明を添えてyes proof、成り立たないなら反証を添えてno ...を返します。判定した瞬間に、判定の根拠が手に入るのです。
- 7 行目、判定に成功した枝です。手に入った証明
proofを、そのまま Σ 型の第 2 成分に詰めてjust (age , proof)を返します。「値と、その値についての証明の組」がここで組み立てられます。
- 8 行目、失敗した枝は
nothingを返すだけです。証明が作れなかったのだから、Adultは作れません。
実際に評価すると、次のようになります。
checkAdult 20
-- 評価結果は just (20 , s≤s (s≤s (… z≤n)))
--(第 2 成分は「18 ≤ 20」の証明の項で、s≤s が 18 回入れ子になった形で表示されます)

checkAdult 15
-- 評価結果は nothing
年齢 20 に対しては、値 20 と「18 ≤ 20」の証明の組が just に包まれて返り、年齢 15 に対しては nothing が返ります。
ここで、評価結果の表示について、「s≤s が 18 回も入れ子になった項は、読みづらくないか。素直に 18 ≤ 20 と書いてほしい」とお思いになられる方もおられるかもしれません。
もっともな感覚ですが、実はここに、この節の恒等型の話とも通じる大事な区別が隠れています。
18 ≤ 20 という表記は 命題(型) の側のものです。
他方で、返り値の第 2 成分に入っているのは、その命題の 証明(値) です。
証明そのものがひとつの値である以上、値としての具体的な形を持ちます。
z≤n は「0 はどんな数以下でもある」、s≤s は「m ≤ n ならば m + 1 ≤ n + 1」という 推論の 1 歩に対応する部品 で、18 回の入れ子は「0 ≤ 2 から出発して、両辺に 1 を 18 回ずつ足す」という 証明の道筋そのもの なのです。
なお、実務上は、この項を人間が読む必要はほとんどありません。
型検査器 が「この値は確かに 18 ≤ 20 という型の住人か」を機械的に検査してくれることが本体で、人間は型(命題)の側だけを読めば足ります。
証明の項は、人間が読むためのものではなく、機械に検査されるためのもの です。
なお、この 「命題 = 型、証明 = 値」という対応 は、第 6 節で Curry-Howard 対応 として正面から扱います。
今回示したユースケースでは、酒類の販売処理を serve : Adult → … と型宣言しておけば、checkAdult の just の中身を受け取る経路でしか呼べない処理ロジックを組むことができます。
検証をすり抜けた値が、販売処理に届いてしまう懸念は、型検査の段階で摘むことが可能になる のです。
以上が Σ型の解説 でした。
次に、恒等型 の解説に移ります。
前回の記事で 「等しさの根拠を数える」という話 をしましたが、あの 「等しさの根拠を集めた空間」の正体が、この恒等型 です。
Martin-Löf 型理論 に 恒等型が組み込まれていること が、 「型を空間として見る」道を開きました 。
前回の記事の内容は、実はこの恒等型の話をしていた のです。
この段階の意味論
型を集合として読むこともできますが、 恒等型があるおかげで、型を ∞-亜群(点と道の集まり)として読むこともできる ようになります。
ここで初めて、「型 = 空間」の解釈が可能に なります。
(関連記事)
📌 中上級者向け補足:リンク先の記事で何が分かるか ── ∞-亜群という言葉の先
本文でさらっと「∞-亜群(点と道の集まり)」と書きましたが、この言葉の背後には、それだけで一本の記事に値する話が広がっています。リンク先の記事は、まさにこの ∞-亜群を主題のひとつに据えたものです。
第 1 に、Hofmann-Streicher の亜群モデル(1990 年代)を扱っています。もともとの動機は「恒等型の証明はすべて同一とみなしてよいか(UIP)」という型理論の内部的な問いで、UIP が Martin-Löf 型理論から導けないことを示すために、型を亜群(対象と可逆な射からなる構造)として解釈するモデルが構成されました。
その副産物として、恒等型そのものが亜群の構造を持つ という決定的な事実が判明します。
本文で「恒等型があるおかげで ∞-亜群として読める」と述べたことの、歴史上の出発点がここにあります。
第 2 に、∞-亜群と ∞-圏の区別を扱っています。HoTT の恒等型が与える経路は、等しさの対称性ゆえに すべて可逆 です。
したがって HoTT の型が成すのは、射がすべて可逆な ∞-圏、すなわち ∞-亜群にとどまります。
一方、現代数学で使われる一般の ∞-圏は可逆でない射を本質的に含みます。
この差が、HoTT という言語の適用範囲を定める深い制約になっている
── リンク先では、そこまで踏み込んで解説しています。
「∞-亜群って何だろう。もっと知りたい」と思われた方の受け皿として、この位置に置いておきます。
5. ここまでの整理 — Haskell はどこにいるのか
いったん立ち止まって、Haskell がこの家系図のどこにいるかを確認します。
Haskell の型システムは、単純型付きラムダ計算に多相型を加え、さらに GADTs や型クラスなどの拡張を積んだ形です。 依存型は基本的にサポートしていません (DataKinds や TypeFamilies を駆使すれば真似事はできますが、Agda や Idris 2 のような本格的な依存型ではありません)。
Haskell の型システムは、 単純型付きラムダ計算 + 多相型 + α の位置にいます。
Martin-Löf 型理論の手前で止まっている、と言えます。
だから Haskell では Vec A n のようなデータ型は素直には書けませんし、恒等型を直接扱う機能もありません。なお、GHC には依存型に近づく拡張の研究・提案が続いていますが、Agda 水準の依存型は現在も標準機能ではありません(詳しくは下のコラムをご参照ください)。
📌 中上級者向け補足:厳密性を担保した説明をすると ── Haskell と依存型の距離
「Haskell は依存型を基本的にサポートしていません」という本文の記述には、少し補足が要ります。
GHC には、依存型の方向へ近づくための拡張が数多くあります。
GADTs、DataKinds、TypeFamilies、そして singletons ライブラリを組み合わせると、型レベルで自然数を扱い、長さつきリストに相当するものを構築することもできます。
さらに、Haskell に本格的な依存型を導入する「Dependent Haskell」という構想があり、Richard Eisenberg の学位論文(2016 年)を出発点として、GHC への提案・実装作業が現在も続いています。
ただし、これらはいずれも「値の世界と型の世界を、変換装置(シングルトン型など)を介して橋渡しする」作りであり、Agda や Idris 2 のように値と型が最初から同じ世界に住んでいる設計とは異なります。
恒等型に相当するもの(:~: など)はあっても、それを「空間の道」として扱う理論的な裏づけ(Martin-Löf 型理論の恒等型の消去規則)を備えているわけではありません。
したがって、「真似事はできるが、本格的な依存型は現在も標準機能ではない」というのが、2026 年時点での正確な距離感です。
一方、 Agda や Idris 2 や Rocq は Martin-Löf 型理論の系譜にいます。
だから 依存型が書けて、恒等型を扱えて、その恒等型を「空間の中の道」として解釈できる のです。
6. 分岐点 — CoC と CIC(1986年、1988年)
Martin-Löf 型理論の系譜から、少し脇道に分岐します。
フランスの Thierry Coquand と Gérard Huet が 1986 年に発表した Calculus of Constructions(CoC、構成計算) です。
CoC の特徴を一言で言うと、 「型と値の区別を突き詰めて、型そのものも値として扱う」 型理論です。
前節で述べた多相型は「型を引数に取れる関数」を許しました。
CoC は、それをさらに徹底 します。
具体的には、CoC には次のような階層があります。
-
値 の世界(
3,"abc",factorialなど) -
型 の世界(
Int,String,Int -> Intなど) - 命題 の世界(「1 + 1 = 2」のような論理式)
CoC では、 この 3 つを統一的に扱えます 。
型も値のように扱え、命題も型のように扱えます。
ここで、次の対応が働きます。
命題 = 型、証明 = その型の値
この対応を Curry-Howard 対応 (カリー・ハワード対応)と呼びます。
1934 年に Haskell Curry が、1969 年に William Howard が独立に指摘したものです。
CoC は、この対応を型理論の設計思想の中心に据えました 。
具体的には、こう考えます。
- 「1 + 1 = 2」という命題を、
1 + 1 = 2という 型 として書く
- この命題の証明を、その型に住む 値 として書く
- 値を作れれば 証明が完成し、値を作れなければ 命題は証明できていない

この発想により、プログラミングと数学の証明が、同じ言語で書けるようになります。
関数を書くことと、定理を証明することが、同じ営みになる 。
これが CoC が目指したもの です。
CIC — 帰納型を加える(1988年)
CoC には最初、 帰納型 (inductive type)が 組み込まれていませんでした 。
帰納型とは、Haskell の data 宣言に相当 するもので、Nat、List、二分木など を定義する仕組み です。
data Nat = Zero | Succ Nat

data List a = Nil | Cons a (List a)
CoC には当初これがなかったので、自然数もリストも「Church エンコーディング」という技巧で表現していました。しかしそれでは実用に耐えません。
そこで 1988 年、Thierry Coquand と Christine Paulin が Calculus of Inductive Constructions(CIC、帰納的構成計算) を発表します。
これは、CoC に帰納型を組み込んだもの です。
Rocq(旧 Coq)は、この CIC を実装した処理系 です。
Rocq でデータ型を Inductive で定義できるのは、CIC が背後にあるから です。
この段階の意味論
CIC まで来ると、次のことができます。
- 依存型(
Vec A nなど) - 命題を型として書き、証明を値として書く
- 帰納型を自由に定義
Rocq を使って、四色定理や Feit-Thompson の定理などの大きな数学的定理が形式証明されています。
ただし、CIC には制限があります 。
CIC における 恒等型 は、Martin-Löf 型理論のそれよりも 狭い扱い をします。
具体的には、CIC は UIP(Uniqueness of Identity Proofs、恒等証明の一意性)に近い性質を持ちがちで、 「等しさの根拠は本質的に 1 本」という前提が強く働きます 。
これは、前回の記事の言葉で言えば、 「Rocq の中では、すべての型が退屈な空間(h-set)に見えてしまいがち」ということ です。
円周 $S^1$ のような 「等しさの根拠が複数ある」型を素直に扱うのは難しくなります 。
📌 中上級者向け補足:厳密性を担保した説明をすると ── CIC と UIP・h-set の関係
本文では、CIC は UIP に近い性質を持ち、「すべての型が h-set に見えてしまいがち」と説明しました。これは初心者向けの直感としては有用ですが、厳密には「CIC だから恒等型が必ず UIP を満たす」という単純な言い方ではありません。
重要なのは、CIC の Prop における証明の無関係扱いなどが、HoTT のように恒等証明そのものを豊かな構造として扱う世界とは異なる、という点です。
したがって、ここでは「CIC の標準的な構成では、HoTT のように非自明な高次の恒等構造を直接扱うことができない」という程度に理解しておくとよいでしょう。
Lean はこの分岐のどこにいるか?(2013年〜)
近年、LLM に数学定理の検証用コードを生成させるプロジェクトで名前を目にする Lean も、実はこの CoC・CIC から伸びる枝の先 に位置付けられる言語(処理系)です。
Leanは、Lean ~ Lean 4まで、複数のバージョンがあります。
そこで、バージョンごとに整理します。
-
Lean(初代、2013年〜) — Microsoft Research の Leonardo de Moura が開発を始めた証明支援系です。CIC 系の型理論を土台として出発しました。
-
Lean 2(2015年) — 家系図の観点で、特異な時期です。標準モード(証明を区別しない Prop を持つ CIC 系)に加えて、HoTT モード を備えており、恒等型を空間として扱うHoTT のライブラリ が Lean 2 の上で開発されていました。つまり Lean 2 は、CIC の枝と HoTT の枝の両方に、同時に足を掛けていた のです。
-
Lean 3(2017年) — HoTT モードを廃止 し、証明の無関係扱い(proof irrelevance)を核とする CIC 変種に一本化しました。UIP が成り立つ側、前回の記事の言葉で言えば「すべての型が h-set に見える」側です。
- Lean 4(2021年〜) — Lean 3 の路線を継承しつつ、言語と処理系を全面的に作り直したものです。数学ライブラリ mathlib が移植され、現在の LLM による定理証明検証プロジェクトの多くが採用しているのは、この Lean 4 です。家系図の中の位置は Lean 3 と同じで、Rocq と同じ CIC の枝の、UIP が成り立つ側 です。
📌 中上級者向け補足:厳密性を担保した説明をすると ── Lean 4 は「CIC そのもの」ではない
Lean 4 は、Rocq と同じく CoC/CIC の系譜に属する依存型理論ですが、CIC をそのまま実装したものではありません。Prop、proof irrelevance、商型などを含む独自の設計を持っています。
したがって、本文の家系図では「CIC の枝」として同じ場所にまとめていますが、「Lean 4 = CIC」と同一視するのではなく、「CIC 系の型理論を基礎にした別の体系」と捉えるのが正確です。
考察 — なぜ Lean は HoTT の足場を外したのか
Lean 2 から Lean 3 への移行で位置付けが変わった理由について、公表されている技術的事実と、そこからの筆者の考察を分けて書きます。
技術的事実として、Lean 3 以降の核である「証明の無関係扱い」は、等しさの証明を 1 本 1 本区別する HoTT と正面から両立しません。どちらかを選ぶ必要があります。また、性質の異なる 2 つのモードを併走させることは、処理系の保守負担を倍にします。
以下は、筆者による考察です。
Lean の主目標が「古典数学の大規模形式化と、強力な自動化」に定まったことが、決定的だったと考えられます。
証明の無関係扱いと商型は、古典数学の形式化を軽く、速くします。
古典数学の大規模形式化を目的に掲げる以上、「等しさの階層」というHoTTの豊かさを扱う能力を追求することは、費用に見合う便益になりづらくなったのです。
mathlib の巨大な成功と、AI プロジェクトでの採用の広がりは、この設計選択がもたらした結果と読めます。
等しさの豊かさを取るか、古典数学の運用効率を取るか
── Lean は後者を選び、前者の道は Cubical Agda が引き受けた、と整理することができるのではないでしょうか。
(考察は以上です)
型理論の家系図の道筋 ── 単純型付きラムダ計算から Martin-Löf 型理論を経て、HoTT へ登っていく流れ ── の話に戻ります。
本稿で CIC の難点として取り上げた 「等しさの根拠が複数ある型を素直に扱えない」点 を受けて、恒等型を空間の道として真剣に扱う型理論 を求める動きが形になっていきます。
源流は 1990 年代、Hofmann と Streicher が 「恒等型の証明はすべて同一とみなしてよいか」という問い に向き合うなかで、型を亜群として解釈するモデル によって 「証明は複数ありうる」ことを示した 仕事にあります。
この仕事が、2006 年前後から本格的な流れとなります。
次節で、その2つの流れについて見ていきます。
7. HoTT の到着 — 恒等型を空間として真剣に扱う(2006年〜)
Martin-Löf 型理論には恒等型が組み込まれていました。
しかし、その恒等型を 本格的に「空間の中の道」として解釈するという発想 は、しばらくの間、はっきりとは持ち込まれていませんでした。
2006 年前後、次の 2 つの流れが独立に、この視座に到達します。
- Steve Awodey と Michael Warren が、Martin-Löf 型理論の恒等型を、Quillen モデル圏という抽象的な数学的構造で解釈できることを示す(arXiv:0709.0248, 2007 年)
- Vladimir Voevodsky(1966–2017、2002 年にフィールズ賞受賞)が、独立に単体的集合を使ったモデルを構成し、 恒等型を「空間内の経路」として扱う道筋を確立 する(2009 年頃)
両者の合流点として、ホモトピー型理論(Homotopy Type Theory、 HoTT ) が形成されました。
2012–2013 年、米国プリンストンの高等研究所で Univalent Foundations Program が組織され、体系書 HoTT Book が 2013 年に刊行されました。
HoTT は、Martin-Löf 型理論に次の 2 つの視座と原理を追加したもの です。
視座 — 「型 = 空間、恒等型 = 経路空間」
Martin-Löf 型理論の 恒等型 x ≡ y を、 「x から y への道の集まり」 として 真剣に読みます。
恒等型の恒等型 p ≡ q を、 「経路 p と経路 q の間の変形」 として 読みます。
これを 無限に繰り返し て、型 を ∞-亜群 (無限に続く点・道・変形・変形の変形・…の階層)として 扱います。
前回の記事で「Haskell の型を点と道の集まりとして見る」と言ったあの話は、HoTT の視座を Haskell に持ち込んでいたのです。
(関連記事)
原理 — Univalence Axiom(一価性公理)
Voevodsky が 2010 年頃に提唱した公理です。ざっくり言うと、以下のようになります。
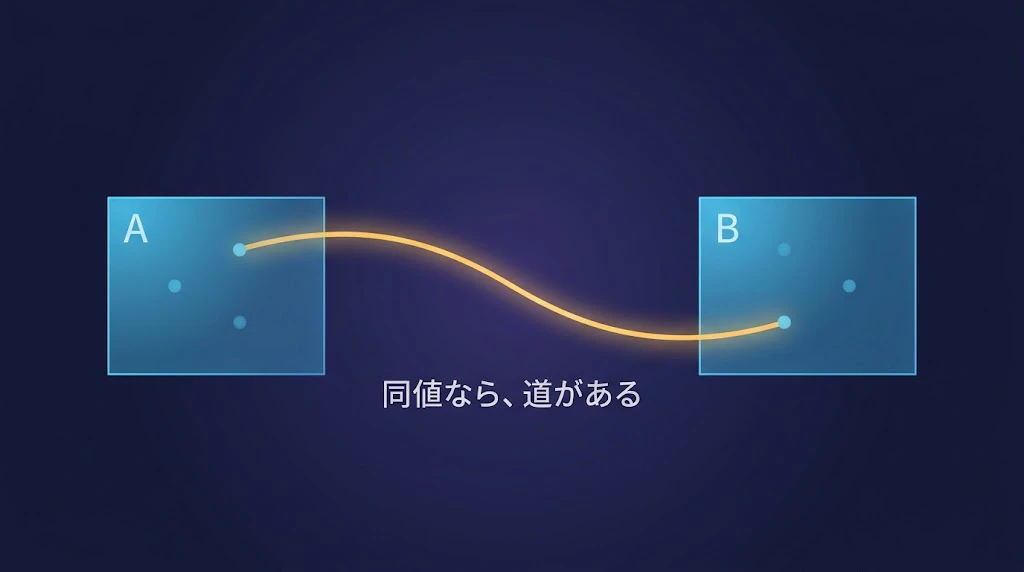
型 A と型 B の間に、値をやりとりして戻せる対応(同値)があるなら、A と B は等しい
数学者は昔から 「同型な構造は同じもの」と暗黙に扱ってきました が、集合論の上ではこれは技術的には成り立ちません 。
Univalence Axiom は、この暗黙の慣習を、型理論の公理として明文化 しました。
この段階で追加される「型を作るルール」
HoTT では、Martin-Löf 型理論の型に加えて、 高次帰納型(HIT) を許します。
前回の記事で見た円周 $S^1$ の定義を思い出して下さい。
data S¹ : Type where
  base : S¹
  loop : base ≡ base
これは HIT の例 です。
値だけでなく、"値と値の間の道" もコンストラクタで導入できる、というルール が HoTT で追加されました。
📌 中上級者向け補足:厳密性を担保した説明をすると ── HIT は HoTT だけの発明ではない
本文では HIT を HoTT で追加された仕組みとして紹介しました。入門上はこの整理で十分ですが、厳密には HIT は「HoTT だけに固有の発明」というより、依存型理論において点だけでなく恒等性に関する構造も指定して型を生成するための拡張です。
HoTT では、HIT が恒等型を空間として読む視座と非常によく結びつくため、重要な構成要素として扱われています。
Cubical Agda — HoTT を実際に走らせる(2019年)
HoTT には長らく実装上の課題がありました。
Univalence Axiom は 「公理」として置くだけでは、プログラムとして実行できませんでした。
この課題を解決したのが、2019 年頃に登場した Cubical Agda です。
Cubical Agda は、Univalence Axiom を計算できる形で実装した Agda の拡張 です。
関数外延性も、HIT の消去規則も、実際にプログラムとして走ります 。
前回の記事の第 6 節で $S^1$ のコードを Cubical Agda のものとして示したのは、この理由からです。
7.5 立方体型理論 — HoTT を「実際に走らせる」ための橋(2017年)
前節の最後で、Cubical Agda が「Univalence Axiom を計算できる形で実装した Agda の拡張」だと述べました。
ここで自然に湧く疑問があります。
Univalence Axiom を「計算できる形で実装した」とは、どういう意味か?
公理として置くのと、実装するのとは、何が違うのか?
この疑問に答えるのが、 立方体型理論(Cubical Type Theory、以下 CuTT) です。
Cubical Agda の 「Cubical」の部分 は、この 立方体型理論 から来ています。
2017 年頃、Cyril Cohen、Thierry Coquand、Simon Huber、Anders Mörtberg らが発表しました(Cohen-Coquand-Huber-Mörtberg 2018)。
そもそも「公理として置く」と何が困るのか
Univalence Axiom を 「公理として置く」 というのは、証明支援系に 次のような一文を書き加えることに相当 します。
仮定する : 型 A と型 B の間に同値があるなら、A ≡ B である
これで数学の証明は書けます。
実際、HoTT Book の中の多くの定理は、Univalence を公理として仮定した上で証明されています。
しかし、プログラムとして走らせようとすると、問題が起きます 。
Haskell で 1 + 1 と書けば結果が 2 に「計算され」ます 。
関数を書けば、引数を渡して評価すれば具体的な値が返る。これはあまりに当たり前です。
証明支援系でも同じことが 起きるべき です。
ある型の値を作る証明を書いたら、 その値が具体的に何なのか、実際に計算できるべき です。
ところが、Univalence を 公理として置いた場合 、公理を使って作られた値は 「計算が詰まって進まない」 のです。
具体的にはこうです。
前回の記事の第 6 節で見た円周 $S^1$ の話を思い出してください。
base ≡ base の中には、動かない道、loop、loop・loop、loop⁻¹、… という、整数の本数だけの道がありました。
ここで「loop・loop を 実際に構成してみよ 」と言われたら、Univalence を 公理として置いた HoTT では、 途中で計算が詰まって具体的な結果が出ないことがある のです。
これは、数学の証明を書くだけなら問題になりません が、 「証明がそのままプログラムになる」という Curry-Howard 対応の魅力を、Univalence の周辺だけ失ってしまうこと を意味します。
Voevodsky 自身、この問題を認識しており、生涯を通じて「Univalence を 計算できる形に する」ことを目標のひとつとしていました。
「立方体」というアイデア
この問題を解決したのが、立方体型理論 です。
名前の由来から説明します。
前回の記事で「型は点と道と、道の間の変形と、変形の間の変形と、…の階層を持つ」と述べました。
この階層を、幾何学的な立方体で表現しようというのが立方体型理論のアイデア です。
具体的にはこうです。
- 0 次元の立方体 = 点。値そのもの。
- 1 次元の立方体 = 線分(辺)。両端が 2 つの点で、それを結ぶ道。これが 1 段目の道に対応。
- 2 次元の立方体 = 正方形。4 つの辺と 4 つの頂点を持つ。2本の道の間の変形に対応。
- 3 次元の立方体 = 通常の立方体。8 つの頂点、12 の辺、6 つの面を持つ。変形の間の変形に対応。
- 以下、n 次元立方体、と 無限に続く。

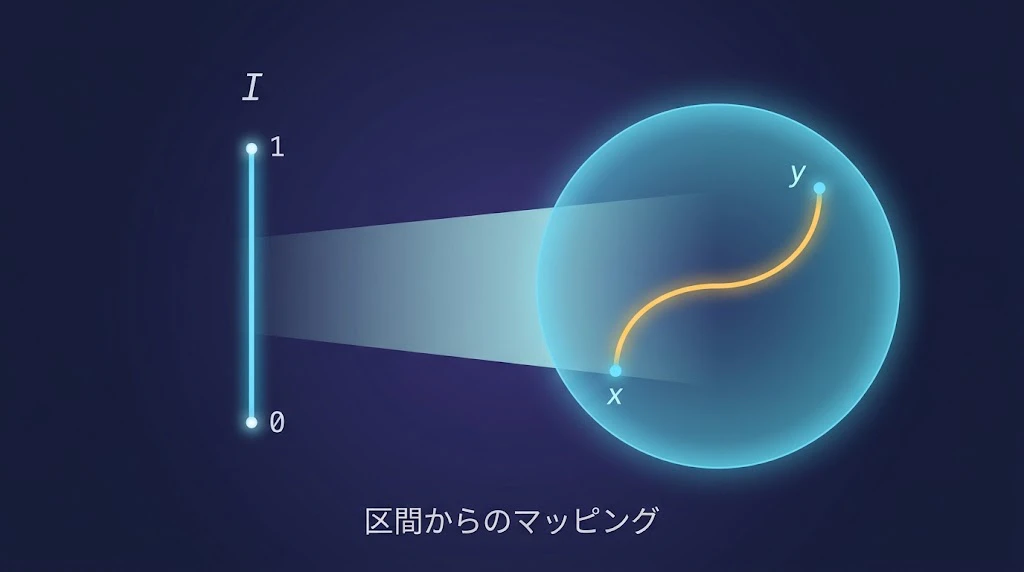
ここで大事なのは、 「道」を「区間 [0,1] からのマッピング」として考える見方 です。
数学の 位相幾何 では、点 $a$ から点 $b$ への道を、区間 [0,1] から空間への連続写像 $γ: [0,1] → X$ で $γ(0) = a$ , $γ(1) = b$ を満たすもの、として定義します。
立方体型理論 は、この「区間 [0,1]」を型理論の中に 形式的な記号として 持ち込み ます。
$I$ という記号を用意し、0 と 1 を端点として持つ形式的な区間として扱います。
📌 中上級者向け補足:厳密性を担保した説明をすると ── 立方体型理論の $I$ は、位相幾何の [0,1] そのものではない
本文では、位相幾何の区間 [0,1] との対応を直感として紹介しています。
しかし、立方体型理論の $I$ は、実数の集合としての [0,1] そのものではありません。
$I$ は、型理論の中で形式的に導入された「区間」であり、0 と 1 を端点として持ち、立方体を構成するための追加の構造を備えて います。
したがって、位相幾何の連続写像をそのまま型理論に持ち込んでいる、と考えるより、「区間という幾何学的直感を、型理論の計算可能な構造として再構成している」と理解するのが適切 です。
本記事末尾近くの「補足:本文で省略した点」で、この $I$ が備える 操作(min、max、否定) にも触れています。
そして、 「型 $A$ における $x$ から $y$ への道」を、「 $I$ から $A$ への関数で、0 を $x$ に、$1$ を $y$ に送るもの」として定義 します。
Cubical Agda の記法で書くとこうです。
p : x ≡ y   -- 従来の恒等型の書き方
p : PathP (λ i → A) x y   -- 立方体型理論の書き方
2 行目の $λ i → A$ は、$I$ の要素 $i$ を受け取って型 $A$ を返す関数です(この記法ではただの定数関数ですが、より複雑な場合には $A$ が $i$ に依存できます)。
全体として、「 $i$ が $0$ のとき $x$ 、 $1$ のとき $y$ になるような、道 $p$ 」を表しています。
つまり、 恒等型を「区間からのマッピング」として直接、実体を持ったオブジェクトに書き直した のが 立方体型理論 です。
何が嬉しいか
この書き換えにより、次のことが可能になります。
関数外延性が定理として証明できる
前回の記事の第 5 節で「関数外延性は、通常の Agda では 公理 、Cubical Agda では 定理 」と述べました。この理由がここにあります。
立方体型理論 では、「各入力について道がある」という前提から、$I → (A → B)$ の関数を構成することで、 関数どうしの道を実際に組み立てて見せることができる のです。公理として仮定しなくても、道を具体的に作ることができる 。
Univalence が計算できる
型 $A$ と型 $B$ の間に同値があるとき、立方体型理論 には Glue 型 という仕掛け があります。
ざっくり言うと、 $A$ と $B$ を 辺で貼り合わせた 新しい立方体を 構成する仕掛け です。
この仕掛けを使うと、$A$ から $B$ への道を具体的に作る(構成する)ことができて、しかも 計算が詰まらずに進み ます。
Univalence が 「公理」ではなく「実際に計算できる操作」になる わけです。
📌 中上級者向け補足:厳密性を担保した説明をすると ── 「Univalence が計算できる」の厳密な意味
「Univalence が計算できる」というのは、単に Univalence を使った式が通常のプログラムのように評価できる、という意味だけではありません。
立方体型理論では、Univalence に対応する構成に計算規則が与えられており、項の還元が進むことで、計算可能性や canonicity(正準性)につながります。特に、閉じた項が適切な標準形へ還元されるという性質が重要です。
本文の「計算が詰まらずに進む」という説明は、この性質を初心者向けに直感化したものです。
高次帰納型(HIT)が自然に定義できる
前回の記事の円周 $S^1$ の定義を再掲します。
data S¹ : Type where
  base : S¹
  loop : base ≡ base
この loop : base ≡ base は、立方体型理論の言葉 で言えば、「 $I$ から $S^1$ への関数で、両端を base に送るもの」です。
立方体型理論では、これがそのまま型のコンストラクタとして許される のです。
従来の型理論では扱いにくかった HIT が、立方体型理論の土台の上では自然に住みます。
立方体型理論と HoTT の関係
ここで整理しておくと、立方体型理論と HoTT の関係 は次のようになります。
- HoTT は、「型を空間として見る」視座と、Univalence Axiom などの原理を含む、理論的な枠組み
- 立方体型理論 は、HoTT の考え方を計算的に実現することを目指して設計された、具体的な型理論
たとえるならば、HoTT が「型を空間として見る」という理論的な考え方をまとめたものだとすると、立方体型理論 は、その考え方を 計算できる型理論として具体化したもの、と考えると分かりやすいでしょう。
両者は競合するものではなく、立方体型理論は HoTT の原理を計算的に実現する代表的なアプローチの一つ です。
📌 中上級者向け補足:厳密性を担保した説明をすると ── HoTT と立方体型理論は、単純な「理論と実装」の上下関係ではない
HoTT と立方体型理論の関係は、「HoTT という理論を立方体型理論が実装した」という一方向の上下関係だけで表すことはできません。
立方体型理論は、Path や Glue などを基本的な構成要素として持ち、Univalence を計算規則と結びつけることを目指して設計された、独立した型理論です。そのモデルや解釈を通じて、HoTT の原理を実現できます。
したがって本文では、「HoTT の原理を計算的に実現する代表的な型理論の一つ」と理解するのが適切です。
Cubical Agda との関係
Cubical Agda は、立方体型理論を実装した Agda の拡張 です。
Agda の 型システム に、 I、PathP、Glue などの立方体型理論の仕掛け を 組み込み ました。
その結果、Cubical Agda で書いたプログラムは、以下を実現できます。
- 恒等型を、区間からのマッピングとして直接扱える
- 関数外延性が定理として使える
- Univalence が計算できる形で入っている
- HIT が自然に定義できて、その上での計算も詰まらずに進む
前回の記事の第 6 節で $S^1$ を Cubical Agda で書いたとき、これらの仕掛けを暗黙に使っていた のです。
立方体型理論の兄弟たち
立方体型理論 には、実は 複数の派生形 があります。
- BCH cubical(Bezem-Coquand-Huber, 2014)
- CCHM cubical(Cohen-Coquand-Huber-Mörtberg, 2017、これが Cubical Agda の土台)
- ABCFHL cubical(Angiuli-Brunerie-Coquand-Favonia-Harper-Licata)
- cartesian cubical(Angiuli-Favonia-Harper)
などがあります。
それぞれ、区間の扱い方や、貼り合わせの仕組みが微妙に違います 。
CCHM 版は 代表的な立方体型理論の一つ で、Cubical Agda と、実験的な独立実装の cubicaltt が この系統 にあります。
家系図に立方体型理論を書き加える
前節の家系図に、立方体型理論 を書き加えると次のようになります。
2013年  HoTT Book 刊行、HoTT が正式に成立
        │
        │  (Univalence を計算できる形にする問題)
        │
2014年  Bezem-Coquand-Huber: BCH cubical
        │
2017年  Cohen-Coquand-Huber-Mörtberg: CCHM cubical(Cubical Type Theory の代表)
        │
2019年  Cubical Agda: CCHM を Agda に実装
つまり、HoTT から Cubical Agda に至るまでの間に、立方体型理論という理論的な中継地点があった ということです。
HoTT が 「型を空間として見る」というビジョンを提示 し、
立方体型理論 が そのビジョンを 「計算できる型理論」として具体化 し、
Cubical Agda がそれを プログラミング処理系として実装 した。
3 段構え でここまで来ています。
補足:本文で省略した点
立方体型理論の$I$は、位相幾何の区間 [0,1] そのものではなく、その形式的な模倣 です。
$I$ は自由に 和集合や交わりを取れる操作(min, max, 否定) を持ち、これによって $n$ 次元立方体を組み立てられるように設計 されています。
詳しくは Cohen-Coquand-Huber-Mörtberg 2018 の第 2 節をご参照ください。
「Univalence が計算できる」の厳密な意味は、canonicity(正準性)という性質に 関わります。
閉じた項が具体的な標準形に還元されることが保証される、という意味 です。
立方体型理論がこの canonicity を満たすことは、Huber らによって証明されています。
立方体型理論と HoTT の関係は、実は今も研究が進行中 です。
「立方体型理論のモデルは HoTT のモデルになるが、その逆が完全に成り立つかは自明でない」といった技術的な論点があり、この方向の研究は続いています。

8. 家系図を1枚にまとめてみる
ここまでの話を、時系列と系譜で整理します。
1934年  Curry: Curry-Howard対応の萌芽

1940年  Church: 単純型付きラムダ計算
        │
1969年  Howard: Curry-Howard対応の確立
        │
1972年  Girard: System F(多相型)  ─────  Haskell の型システムの土台
        │
1972年  Martin-Löf 型理論 開始
        │  (依存型・恒等型・Σ型・Π型)
        ├──────────────┐
        │              │
1986年  │              Coquand-Huet: CoC(構成計算)
        │              │
1988年  │              Coquand-Paulin: CIC(帰納型を追加)
        │              │
        │              └── Rocq (旧Coq) の理論的土台
        │
2006年  Awodey-Warren, Voevodsky: 恒等型の空間論的解釈
        │
2010年  Voevodsky: Univalence Axiom
        │
2013年  HoTT Book 刊行、HoTT が正式に成立
        │
2019年  Cubical Agda: Univalence を計算できる形で実装
そして、皆様が日常でお使いのツールと、それぞれの言語がどの型理論を実装しているかを対応させると、以下の表になります。
| 言語・処理系 | 背後にある型理論 | 家系図の中の位置 |
|---|---|---|
| Haskell | 単純型付きラムダ計算 + System F(多相型)+ 独自拡張 | Martin-Löf 型理論の手前 |
| Agda、Idris 2 | Martin-Löf 型理論の系譜(依存型・恒等型) | 依存型の本流 |
| Rocq(旧 Coq) | CIC(帰納的構成計算) | CoC からの分岐の先 |
| Lean 4 | CIC の変種(証明の無関係扱い・商型などの独自拡張) | Rocq と同じ CIC の枝(UIP が成り立つ側) |
| Cubical Agda | 立方体型理論(CCHM)= HoTT の実装方式 | 家系図の現在の先端のひとつ |
9. まとめ — なぜこの家系図を知る必要があるのか
長い散歩でしたが、ここでもう一度、最初の疑問に戻ります。
Haskell と Cubical Agda は、どちらもデータ型を書ける言語だが、Cubical Agda は円周をコンストラクタで定義できて、Haskell はできない。この違いはどこから来ているのか?
冒頭に掲げたこの問いに対する答えは、両言語が実装している型理論が、家系図の別の場所にいるからです。
Haskell は単純型付きラムダ計算に多相型を足したあたりに留まり、恒等型も依存型も持たない。
Cubical Agda は HoTT を実装し、恒等型を空間の道として扱い、HIT で経路をコンストラクタとして定義できる。
そして、前回の記事で見た 「Haskell の型が空間である」という視座 は、実は HoTT の視座を Haskell に投げ返したもの でした。
Haskell 自身の型システムには恒等型はありませんが、 値の等しさを空間の中の道と見る発想 は、Martin-Löf 型理論以降の型理論を経由して初めて明確になったもの です。
ここまで来ると、 「プログラミング言語のデータ型は、HoTT における型に該当するもの」 という言い方が、ようやく本当の意味を持ちます。
- Haskell の
Intは、HoTT で言えば h-level 2 の型(h-set)です。 - Haskell の
Int -> Intは、HoTT で言えば h-set から h-set への関数型で、これも h-set です。 - Haskell の
[a]は、HoTT で言えば a の h-level を引き継ぐ帰納型です。 - Cubical Agda の $S^1$ は、HoTT で言えば h-level 3 の HIT です(前回の記事で見たとおり、球面 $S^2$ のように、有限の h-level を持たない HIT も定義できます)。
Haskell の data Foo = Bar | Baz というコードは、家系図をずっと登った先の HoTT から見ると、 「退屈な空間を、コンストラクタで定義している」こと になります。
退屈と言っても、それは HoTT の視座から見ての話で、日常のプログラミングには十分な豊かさです。
その退屈さの外に出たいと思ったとき、Cubical Agda の HIT が待っています。
家系図を貫いてきた「動機」
最後に、この散歩で通り過ぎた各段階を、「なぜルールを足したのか」という動機だけで並べ直します。型理論の進化は、思いつきの連続ではなく、そのつど困りごとに応答してきた歴史 だということが見えてきます。
ただし、この家系図は「全体地図」ではない
なお、ここで注意いただきたい点があります。
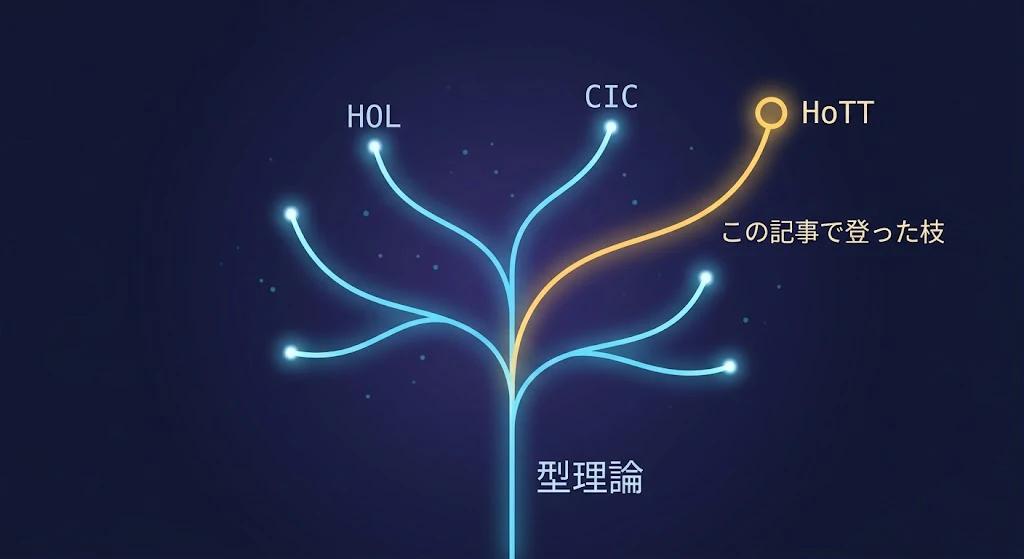
本稿でお示しした家系図は、HoTT に至る道を選んで描いた 1 枚であって、型理論の全系譜ではありません。**
Isabelle/HOL のように、単純型理論の系譜 で大きな成功を収めている体系もあれば、
Rocq や Lean のように、 CIC の枝 で栄え続けている体系もあります。
HoTT は「型理論の頂点・最終形」ではなく、「等しさ」を主役に据えた、有力な一系統です。
別の枝も、いまも現役で繁栄を謳歌しています 。
📌 中上級者向け補足:この家系図は、型理論の「全体地図」ではない
本文の家系図は、「Haskell の日常から出発して HoTT にたどり着く」という、この記事の目的のために選ばれた一本道です。
読み方によっては「HoTT が型理論の到達点・最終形」と受け取られかねないので、ここで視野を広げておきます。
まず、単純型理論の系譜は、HoTT とは別方向で大成功しています。
sabelle/HOL は、単純型理論(高階論理)に多相型を加えた体系の上に築かれた証明支援系で、巨大な証明ライブラリ(Archive of Formal Proofs)を擁し、OS カーネル seL4 の検証など、産業的にも重要な成果を挙げています。
依存型も HoTT も使わずに 、です。
次に、CIC の枝は、現在の形式数学の主流です。
Rocq による四色定理・Feit-Thompson の定理の形式証明、Lean 4 と mathlib による現代数学の大規模形式化、そして AI による定理証明プロジェクトでの採用と、この枝の隆盛は本文で見たとおりです。
さらに、この家系図に描かれていない枝 もあります。
- 線形型(資源の使用回数を型で管理する系譜。Rust の所有権システムにも影響)
- 部分構造型理論
- 効果システム
など、型理論は、多方向に伸びる樹 です。
つまり、型理論 という樹には 太い枝が複数あり、それぞれが異なる問いに応えて栄えています。
HoTT はそのうちの、「等しさとは何か」という問いに最も深く応えた枝 です。
本文の家系図は、その枝への登り方を描いた 1 枚の地図 、とご理解ください。
📌 補足コラム:手続き型言語や論理プログラミング言語には、全く別の型理論があるのか
「この記事の家系図は関数型・定理証明系の話だったが、C や Java や Python、あるいは Prolog のような別の流儀の言語には、全く異なる型理論があるのだろうか」── そう思われた方のための補足です。
この問いに対するありうる回答は、「全く異なる理論がある」というより、同じ道具立てが別の使われ方をしている、この記事の一本道に現れなかった別の軸がある、というものです。
まず、手続き型・オブジェクト指向言語 についてです。
意外に思われるかもしれませんが、Java や C# のジェネリクス(List<T> のような型引数)は、本文第3節で見た System F の多相型の直系の子孫 にあたります。
実際、Java にジェネリクスを導入した設計(GJ)には、関数型言語の理論家たちが関わっています 。
また、C のような言語の型システムも、理論的に分析するときは、この記事で見た ラムダ計算系の型理論 に、可変な状態(参照) や 部分型付け(サブタイピング) といった 拡張 を加えた枠組みで記述するのが標準です。
この分野の定番教科書(Pierce の Types and Programming Languages)は、まさにその流儀で手続き型やオブジェクト指向の型システムを扱っています。
つまり、家系図の低層部(単純型付きラムダ計算〜System F)は、関数型専用の理論ではなく、主流の静的型付き言語すべてを記述する共通の土台 なのです。
ただし、この記事の一本道に現れなかった 別の軸 もあります。
部分型付け 、オブジェクトの理論 、可変状態の扱い 、そして Rust の所有権システムに影響を与えた 線形型・アフィン型 などです。
これらは 「依存型の方向に登る」のとは別の方向に伸びた型理論の枝 です。
次に、論理プログラミング言語(Prolog など)についてです。
古典的な Prolog は型を持ちませんが、型付きの子孫(Mercury など)が存在します。
さらに面白いのは、本文第6節の Curry-Howard 対応に、論理プログラミング版の読み替えがある ことです。
関数型 が、「証明 = プログラム、証明の正規化 = 計算」 と読むのに対して、
論理プログラミング は、「証明の探索 = 計算」と読みます。
同じ対応の、別の切り口です。
実際、依存型理論の親戚である LF(論理フレームワーク) の上に築かれた Twelf のように、論理プログラミングの様式と依存型が合流した処理系 もあります。
制約プログラミング のように、型がそもそも設計の主役ではない流儀や、Python のような 動的型付けの伝統(型検査を実行時に回す、という別の選択) もあります。
まとめると、型理論 という樹の枝は、この記事で登った 「等しさの階層」の方向 だけでなく、「状態と資源」「部分型」「証明の探索」といった複数の方向 に伸びており、手続き型言語 も論理プログラミング言語 も、それぞれの枝の上に立って います。
全く別の理論の国があるのではなく、同じ樹の、別の枝の眺め なのです。
補足:本文で省略した用語と、次に読むもの
- Curry-Howard 対応 の詳しい入門は、Wadler の "Propositions as Types"(2015 年) が定番です
- Martin-Löf 型理論 の原論文は Per Martin-Löf 自身の一連の講義録ですが、入門としては nLab の Martin-Löf dependent type theory が読みやすいです
- CoC/CIC については Coquand-Huet の原論文 と、Rocq の公式ドキュメント が一次資料です
- HoTT の体系書は HoTT Book(2013) が定番で、PDF が無料で公開されています
- Cubical Agda については Agda 公式ドキュメント と、実装の解説論文 Vezzosi-Mörtberg-Abel 2019 があります
これで、前回の記事で「Haskell の型は空間である」と述べたことの背景が、型理論の家系図の側から見えたと思います。
Haskell の Int や [Char] は、HoTT の型に相当します。
ただし、家系図をずっと登った先から見ての、退屈な形の型に、です。
退屈でも、そこから始まって、円周も球面も、そしてその先の代数トポロジーの定理も、同じ型理論の言葉で書ける — というのが、この家系図がたどり着いた場所なのです。
📌 補足コラム:この記事で意図的に省いた論点
この記事は「散歩」を掲げているため、次の論点は意図的に本文から省きました。深掘りしたい方への道しるべとして、名前と省いた理由だけ記しておきます。
- System F の非可述性と、その集合論的解釈の困難 — 本文第 3 節で「Reynolds 1984 の困難」とだけ触れた話です。多相型を素朴な集合で解釈しようとすると矛盾が生じる、という型理論の意味論の古典的な難所ですが、家系図の本筋には影響しないため省きました。
- Girard のパラドックス — 「Type : Type」を素朴に許すと矛盾が導ける、という結果です。型の宇宙に階層が必要な理由の核心ですが、本文ではリンクの紹介にとどめました。
- Lean と HoTT の相性の詳細 — Lean の証明の無関係扱いと UIP が、HoTT とどう衝突するのかという技術的な詳細です。本文第 6 節の Lean の考察で輪郭だけ述べました。筆者が別の記事群で扱った主題と重なるため、ここでは深入りしていません。
- 立方体型理論のモデル理論への深入り — 立方体集合によるモデルの構成や、HoTT のモデルとの対応関係の細部です。第 7.5 節の補足に記した範囲で十分と判断しました。
いずれも、この散歩を登山に変えてしまう重さの話題です。家系図の幹を掴んだ後で訪ねると、風景がよく見えると思います。
今後のロードマップ
数珠つなぎの単独記事の全体像は、次のとおりです。