
記事の要約
AIが作った「データの地図(潜在空間)」をそのまま信じていませんか?
本記事では、潜在空間に潜む「歪み」を数学的に正し、現実のデータ変化に即した真の最短ルートを算出する 「リーマン計量」 の実装を解説します。
「地図上の直線が実は遠回り」というユークリッドの罠 を突破し、データから真の戦略地形を導き出す ための第一歩を踏み出しましょう。
本稿の位置づけ:戦略地図から幾何学的な分析へ
本稿は、連載「ジオメトリック・インテリジェンス」に関連する技術解説記事です。
連載初回では、VAEを使って高次元のビジネスデータを低次元の「戦略地図(潜在空間)」として捉える考え方を紹介しました。
本稿では、その地図を数学的に分析するための基礎を解説します。
VAEのデコーダが潜在空間の座標をどのようにデータへ変換するのかを調べ、ヤコビアンからリーマン計量(Pullback Metric)を構成します。
これにより、潜在空間の場所によって異なる距離の尺度を定量化します。
そして連載第2回では、曲率マップを使って戦略地形の特徴を可視化し、ブルーオーシャンの発見につながる分析を目指します。
連載全体における本稿の位置づけ
本稿のポイントは、潜在空間を単なる座標の集まりとして扱うのではなく、場所によって距離の尺度が変化する幾何学的な空間として分析することです。
それでは、まず高次元のデータがどのように2次元の戦略地図へ変換されるのかを見ていきましょう。
関連記事
-
Geometric Data Science × VAE で社会データから立体戦略地形図を作る(Python環境想定)
Geometric Data ScienceとVAEを組み合わせ、社会・経済データから戦略地形図を構築する考え方を紹介します。
本記事で解説した潜在空間の幾何学的な分析が、戦略地形図の構築という全体像の中でどのような役割を果たすのかを理解できます。
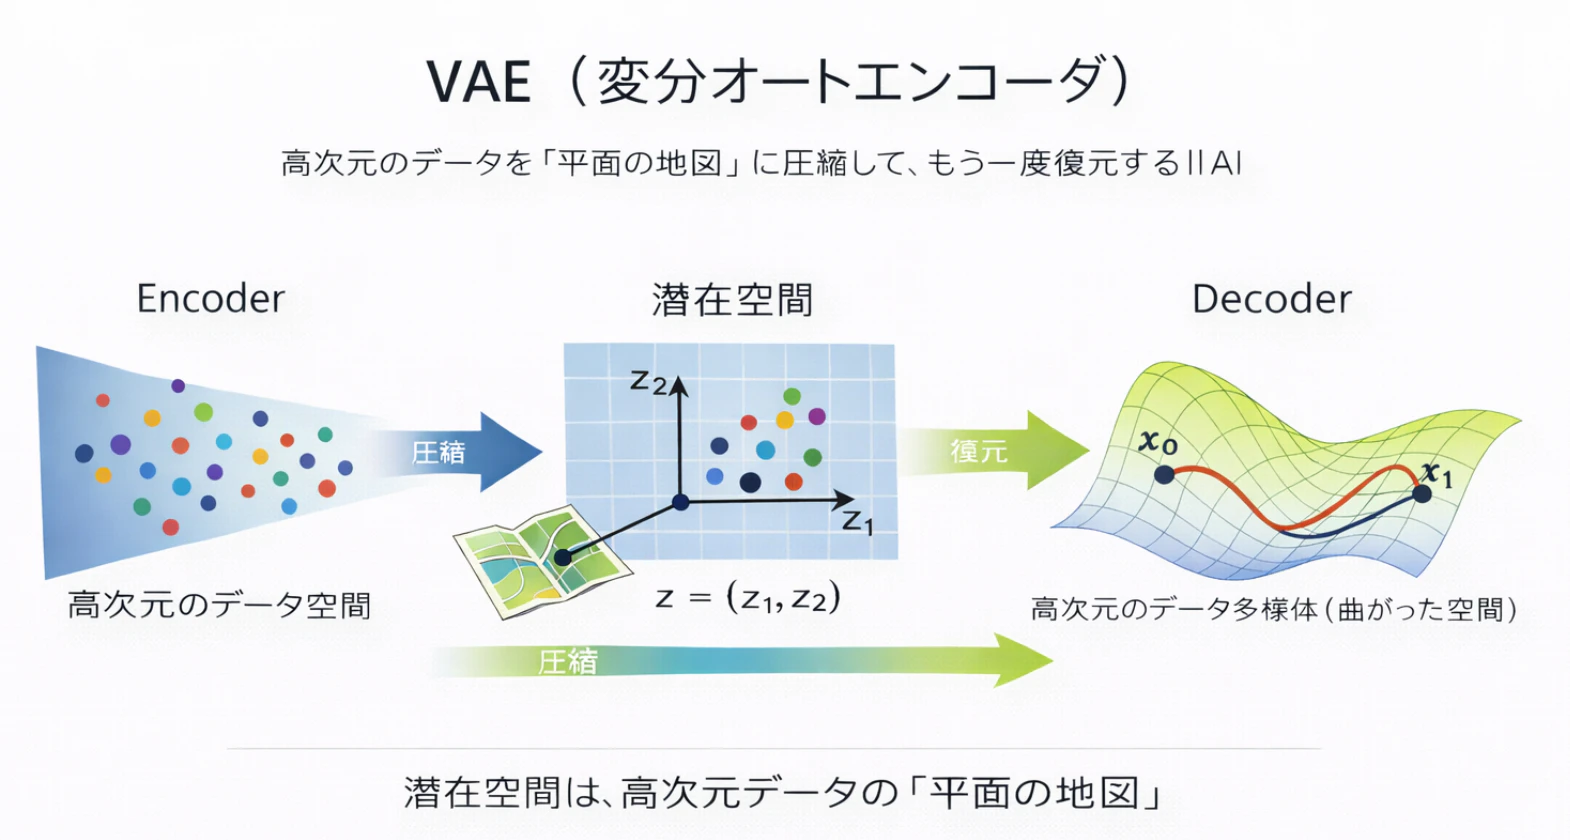
1. データの旅:100次元のカオスから2次元の「戦略地図」へ
プログラマにとって 「潜在空間」 や 「次元」 は抽象的で分かりにくいものです。
まずは、データがモデルの中でどう変化するのかをビジュアルで整理しましょう。
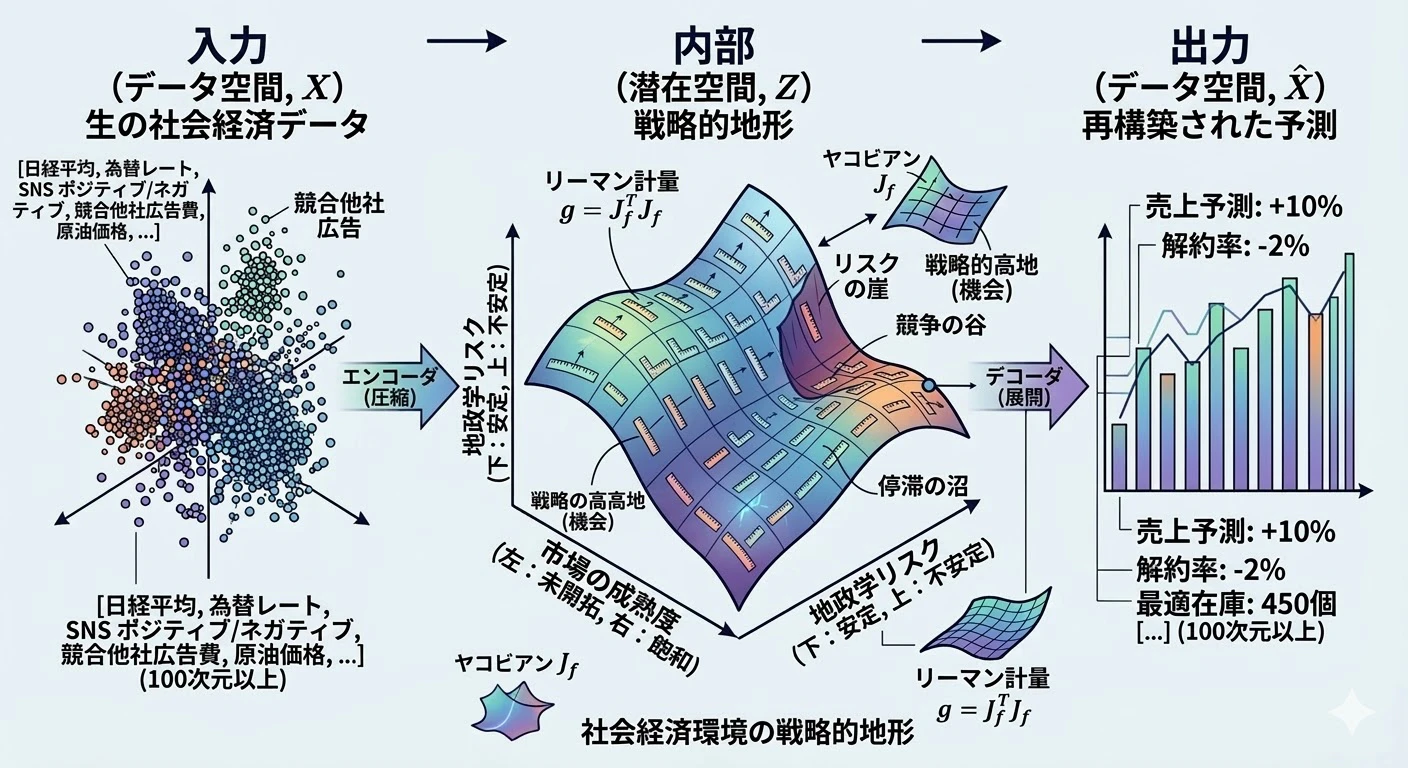
(上図:VAEによる戦略的地形の生成プロセス)
① 入力:100次元の「現実データ」
VAEに入力されるのは、人間には理解不可能なほど複雑な100次元のデータベクトルです。
(例)
[日経平均, 為替, SNSのポジティブ度, 競合の広告費, 原油価格, ...]
➡ これらはノイズだらけで、そのままでは「次に何をすべきか」は見えません。
② モデル内:2次元の「戦略地図(潜在空間)」
VAEのエンコーダは、この100次元のカオスを2次元の座標軸に凝縮します。この軸には、AIが学習した「データの背後にある本質的な意味」が割り当てられます。
- 横軸(Dim 1): 市場の成熟度(左に行くほど未開拓、右に行くほど飽和)
- 縦軸(Dim 2): 地政学リスク(下に行くほど安定、上に行くほど不安定)
ここが重要!: この地図は平坦なチェス盤ではなく、場所によってゴムのように伸び縮みする 「曲がった空間(多様体)」 になっています。
③ 出力:100次元の「予測・復元」
デコーダは、地図上の特定の座標を指差したとき、それを再び100次元の具体的な数値に翻訳して戻してくれます。
(例)
[(予測売上: +10%), (離脱率: -2%), ...]
2. 潜在空間の「距離」をそのまま使ってはいけない理由
「ユークリッドの罠」:地図上の直線は、現実の最短ではない
地図上でA地点からB地点へ 直線(ユークリッド距離) で進もうとすると、現実の世界では、不自然にデータが急変する崖を通ったり、逆に全く変化しない場所を延々と歩かされたりすることがあります。
これは、AIが作った地図の場所によって 「定規のメモリ」がバラバラ だからです。この歪みを無視して戦略を立てることは、等高線を無視して登山計画を立てるのと同じくらい危険です。
(上の状況を図に示したイメージ)
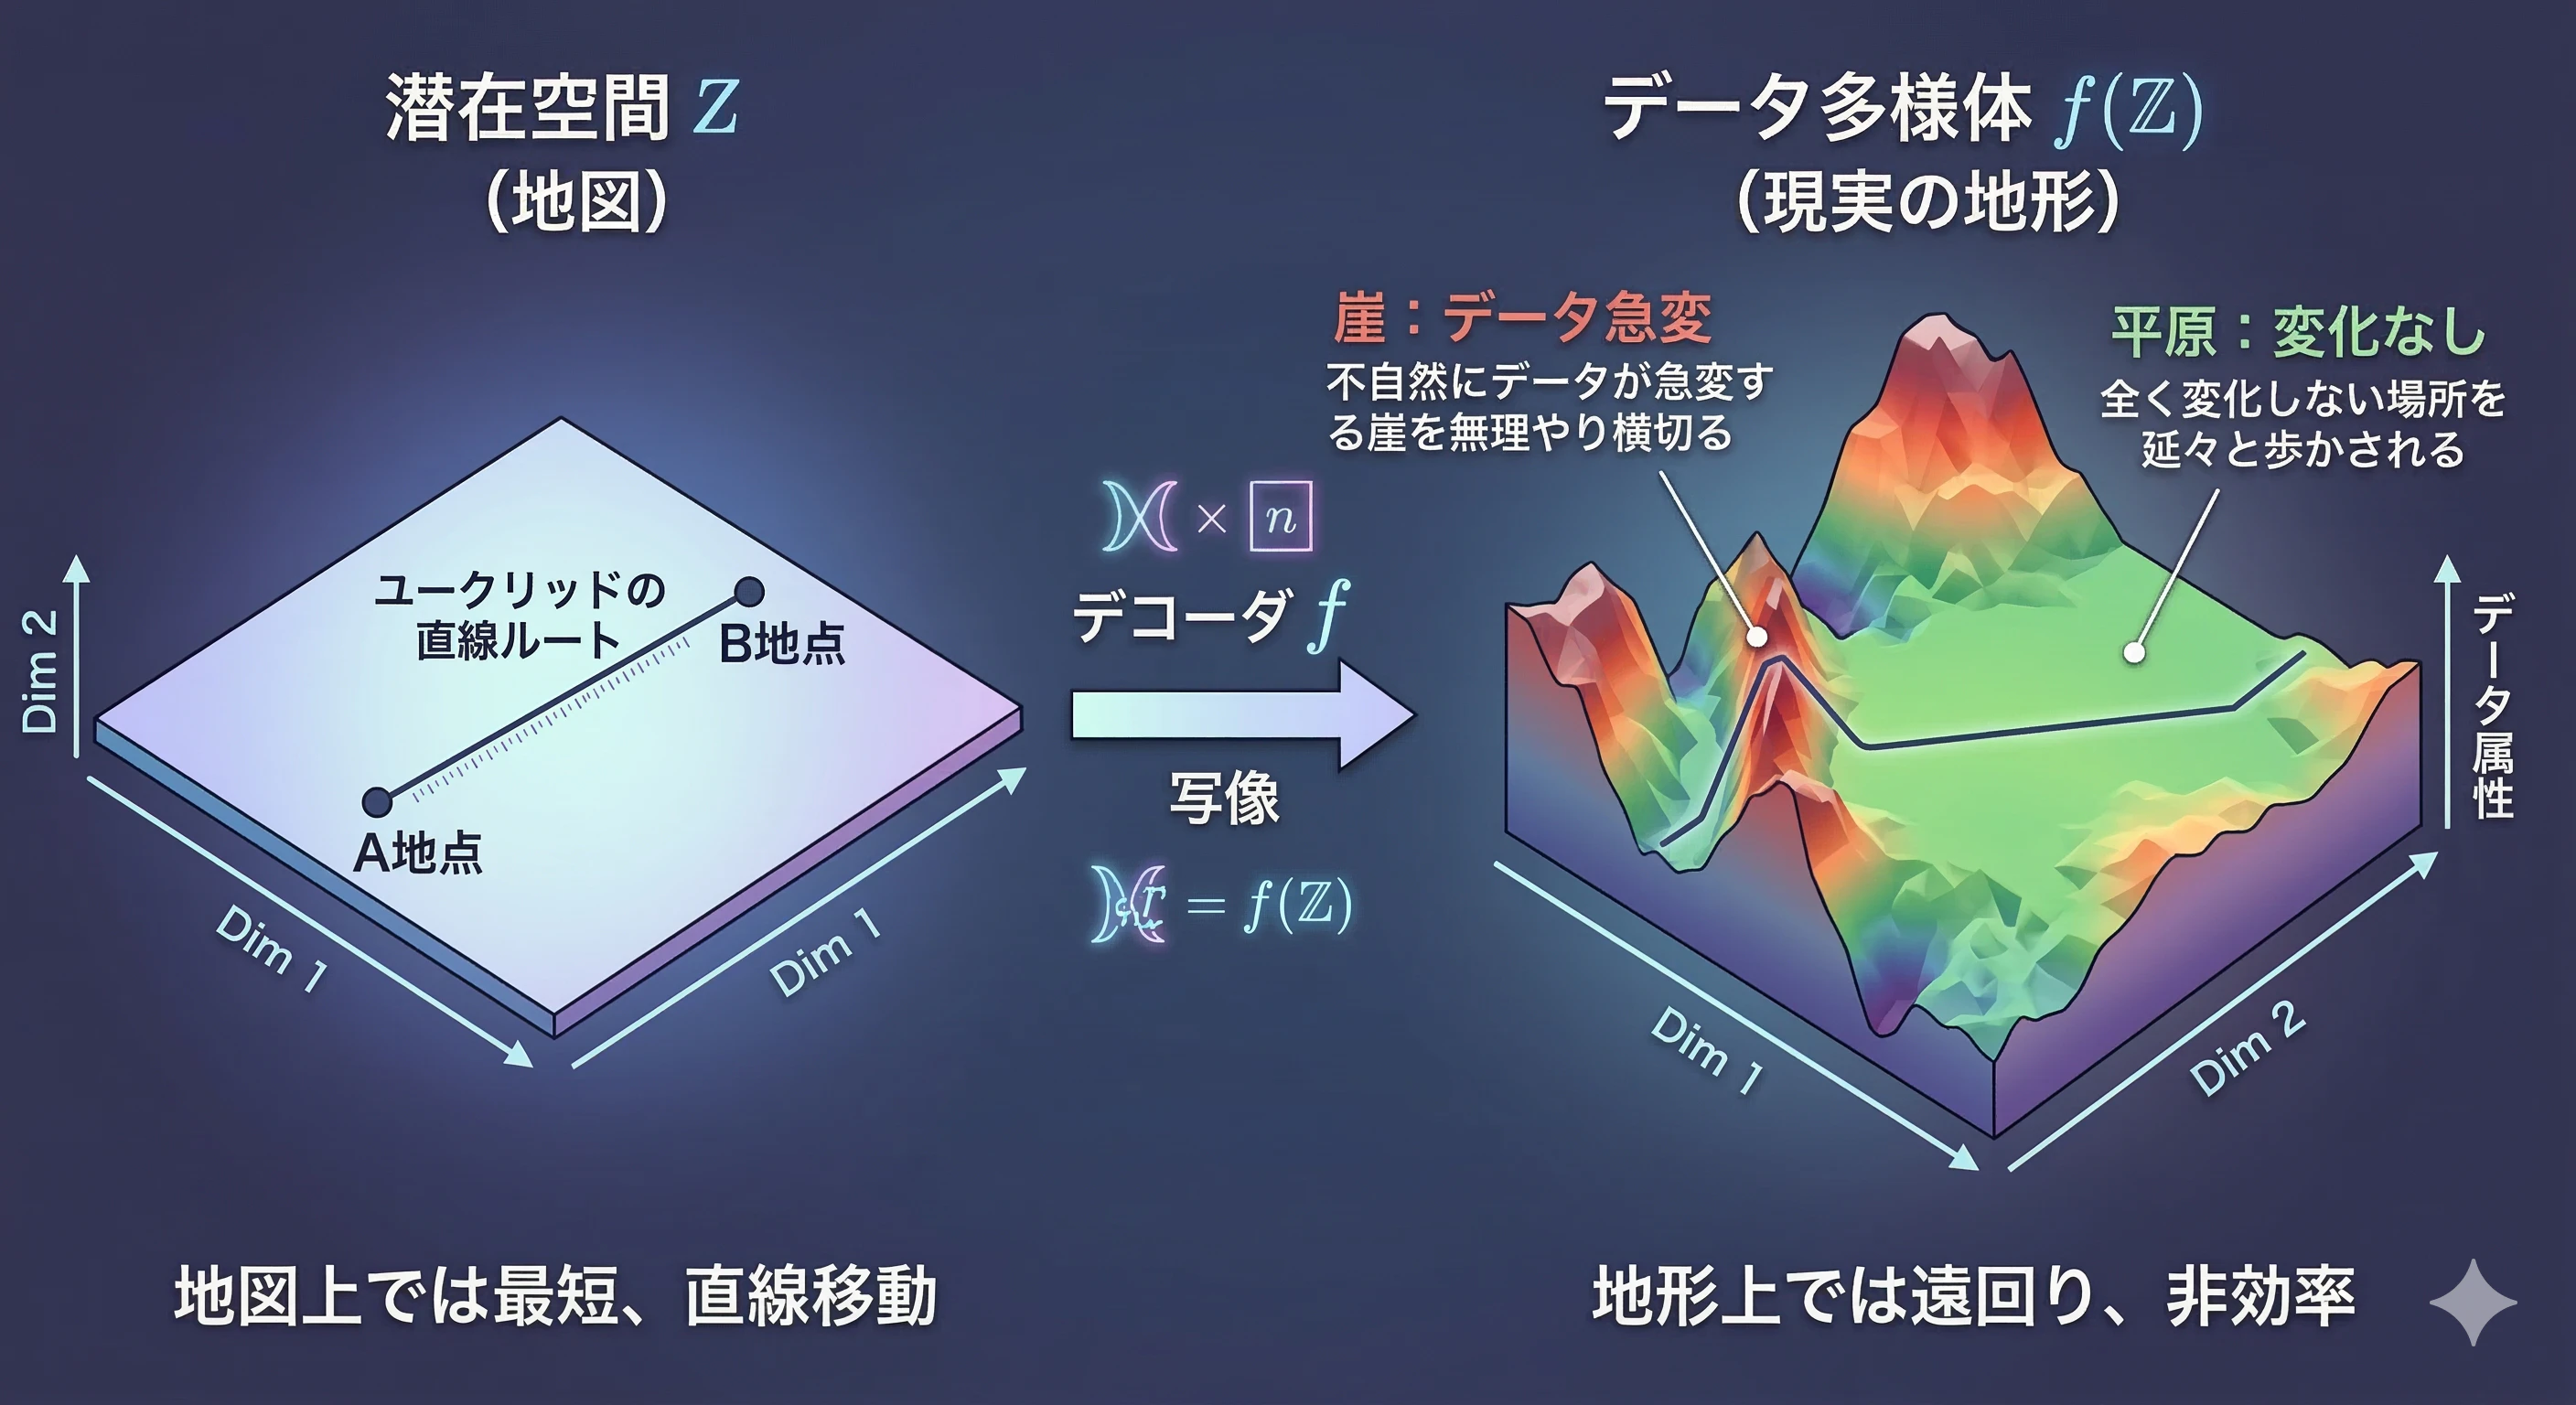
(上図の説明)
-
「崖: データ急変」:
地形が垂直に近くなっている部分。潜在空間の直線を投影すると、この「崖」を無理やり横切ることになり、不自然にデータが急変する様子を可視化しました。 -
「平原: 変化なし」:
地形が非常に平坦になっている部分。潜在空間の直線を投影すると、ここでは長い距離を移動しても「高さ(データ属性)」がほとんど変わらない様子を表現しました。
(説明おわり)
3. ヤコビアンと計量テンソル:歪みを測る数学の目
ヤコビアン(Jacobian):空間の伸び縮みを記録するカタログ
デコーダ関数を $f: \mathbb{R}^d \to \mathbb{R}^D$ としたとき、地図上のわずかな移動が現実をどう変えるかを表す「変化のカタログ」がヤコビアン $J_f$ です。
$$J_f = \frac{\partial f}{\partial z}$$
計量テンソル(Metric Tensor):正しい定規
ヤコビアンを使って、地図上の移動距離を「現実の移動距離」に変換する新しい定規をリーマン計量 $g$ と呼びます。
$$g(z) = J_f(z)^T J_f(z)$$この $g$ を使うことで、地図上の移動を「現実の距離」に変換するための補正係数になります。数学的にはこれを 「プルバック計量」 と呼びます。
(「計量テンソル」(地図の「正しい」定規)で測った「正しい距離」のイメージ)
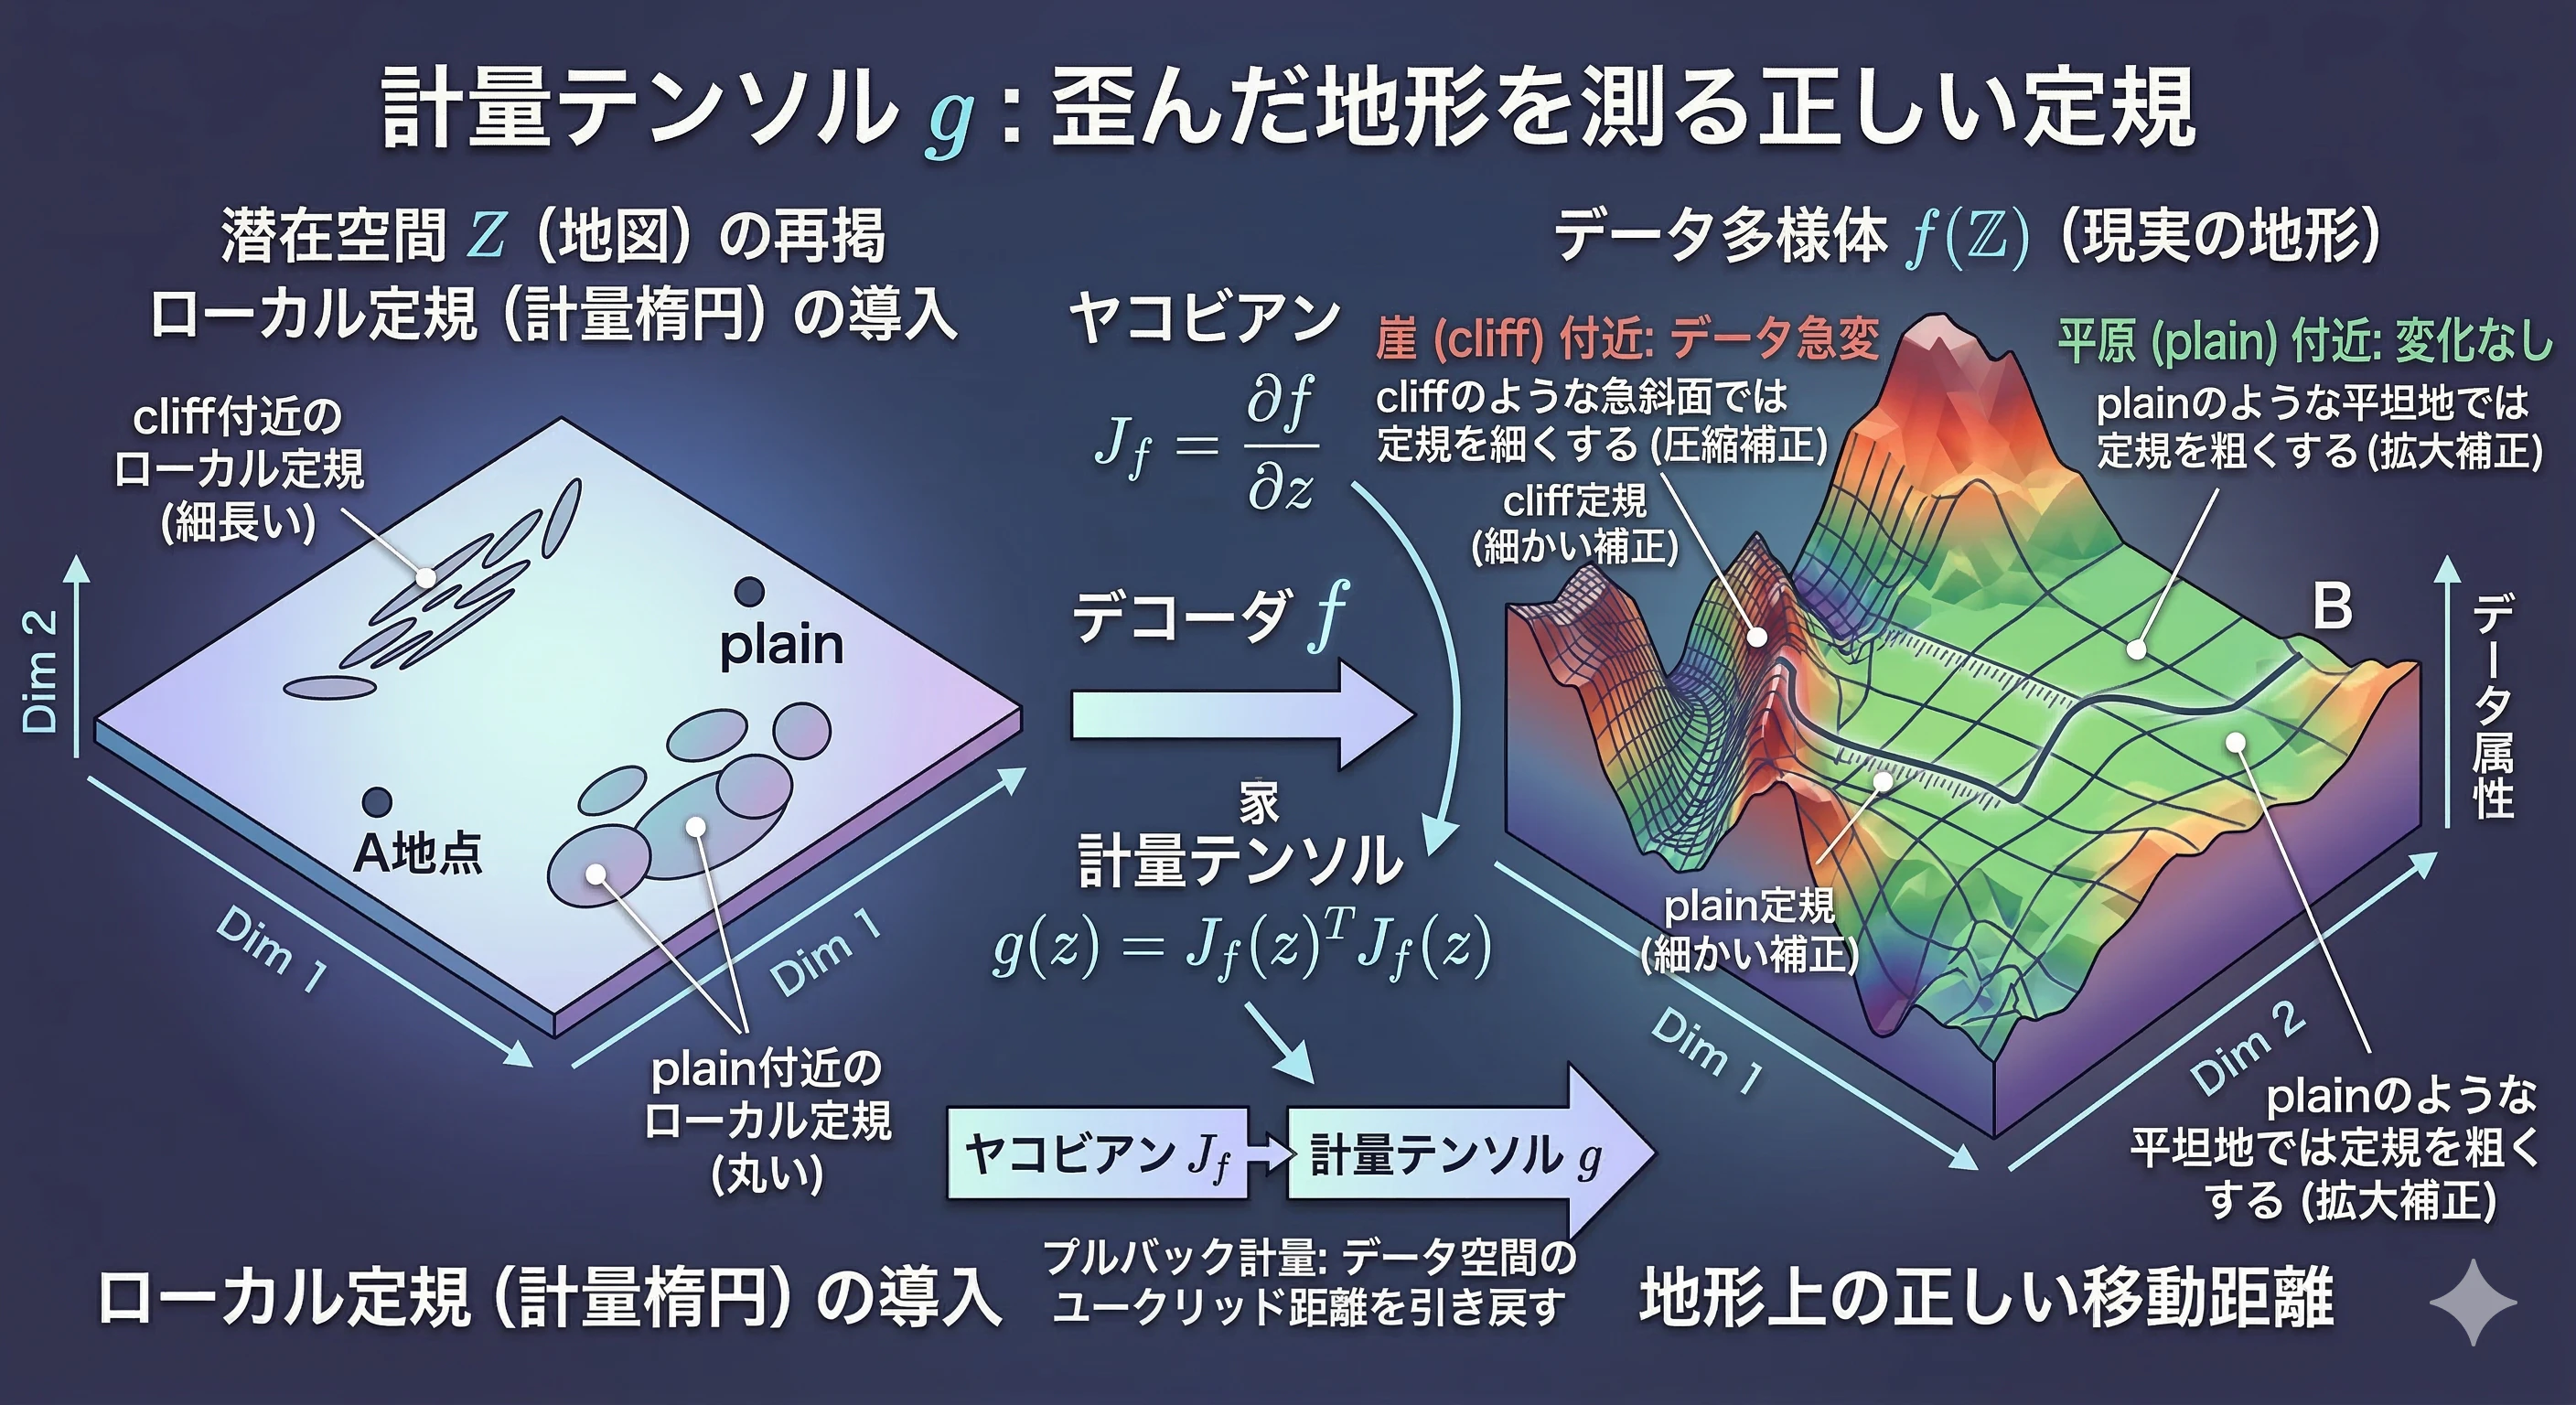
(上図の解説)
-
(左側):
潜在空間 Z (地図)前回の2D地図を再掲しました。
今回は、あらたに 「ローカル定規(計量楕円)」を書き込みました。
cliff(崖) 付近、plain(平坦地) 付近などに、地形の歪みに合わせた異なる楕円形の「定規」が配置されています。 -
(中央):
計量変換プロセスデコーダ $f$ の矢印を中央に配置しました。
ヤコビアン $J_f$ からリーマン計量 $g$ への変換を示すフローを配置しました。
(数式)「$J_f = \frac{\partial f}{\partial z}$」「$g(z) = J_f(z)^T J_f(z)$」を書き込んでいます。 -
(右側):
データ多様体 $f(Z)$ (現実の地形) として、前回と同じ3D地形を再掲しています。
cliff(崖)付近、plain(平坦地)付近などに、地形に合わせて歪んだ「正しい定規」を描画しました。 ➡ cliff(崖)のような急斜面では非常に細かくなり、plain(平坦地)のような平坦地では粗くなる状況を読み取ってください。
(解説おわり)
📌 補足コラム①: ヤコビアンを「世界一わかりやすく」説明してみる
数学の教科書では難しく書かれがちな ヤコビアン(ヤコビ行列) ですが、
データサイエンスの実務では「場所によって変わる、変換効率のカタログ」
と考えると一気に理解が深まります。
1. 「普通の微分」から「ヤコビアン」へ
高校数学で習う微分
$$
f'(x)
$$は、
「$x$ を1動かしたとき、$y$ がどれくらい変わるか」
つまり 坂道の傾き を表します。
しかし今回のVAEモデルのように
- 2つの入力(地図の座標)
- 100個の出力(現実のデータ)
がある場合、傾きが1つでは足りません。
例えば次のような疑問が生まれます。
- 横($z_1$)に動いたとき、100個のデータはどう変わる?
- 縦($z_2$)に動いたとき、100個のデータはどう変わる?
この 合計200個の「変化の割合」 をすべて記録した
巨大な変化カタログ(行列) が ヤコビアン です。
2. 数学的な正体:偏微分の行列
デコーダ関数 $f$ が
- 地図の座標
$z = (z_1, z_2)$を
- 100次元データ
$x = (x_1, x_2, \dots, x_{100})$に変換するとします。
このときヤコビアン $J_f$ は
偏微分の行列として書かれます。$$
J_f =
\frac{\partial f}{\partial z}
=
\begin{pmatrix}
\frac{\partial x_1}{\partial z_1} & \frac{\partial x_1}{\partial z_2} \\
\frac{\partial x_2}{\partial z_1} & \frac{\partial x_2}{\partial z_2} \\
\vdots & \vdots \\
\frac{\partial x_{100}}{\partial z_1} & \frac{\partial x_{100}}{\partial z_2}
\end{pmatrix}
$$つまり
- 行 → 出力変数
- 列 → 入力変数
を表しています。
💡 豆知識:$\partial$(ラウンド・ディー)の読み方
これは
「$x_1$ を $z_1$ で偏微分する」
という意味です。
要するに
- $z_1$ だけ動かす
- $z_2$ は固定
して変化率を見る、ということです。
普通の微分と同じ感覚でOKです。
3. 直感イメージ:伸び縮みする「魔法の布」
ヤコビアンは
AIが作った地図が「場所によってどれくらい伸び縮みしているか」
を記録しています。
値が大きい場所
- 布が 引き伸ばされている エリア
- 地図上で 1cm 動くだけで
現実データが ドカン! と激変値が小さい場所
- 布が ギュッと縮んでいる エリア
- 地図上を 1m 歩いても
現実は ほとんど変わらない
4. なぜこれが「戦略」に必要なのか?
ヤコビアンを計算すると
AIが作った地図の 「感度」 がわかります。例えば
「このエリアはヤコビアンが巨大だ。
ちょっとした判断ミスで結果が崖っぷちまで転げ落ちる
ハイリスク地帯だ」逆に
「ここは数値が安定している。
戦略を少し変えても結果がブレない
守りの固いエリアだ」ただの 数字の羅列だったデータ に
「手触り感のある地形」 を与えてくれる。それがデータサイエンティストにとっての
ヤコビアンの正体です。
🎓 Summary for High Schoolers
ヤコビアンとは
「入力のわずかな動きを、多次元の出力の変化へ翻訳する変換表(カタログ)」
のことです。
📌 補足コラム②: 【深掘り】技術的サプリメント:実装と数学の裏側
ここからは、Pythonの実装コードを交えながら、数学的な背景をさらに詳しく解説します。
先ほどの 「補足コラム①」 で解説した 「ヤコビアン = 多変数関数の微分」 が、もっとも重要な部品(概念) になります。
1変数関数 $y = f(x)$ の微分は $\frac{dy}{dx}$ でしたが、機械学習では入力ベクトル $z$ から出力ベクトル $x$ への関数 $f: \mathbb{R}^d \to \mathbb{R}^D$ を扱います。その微分がヤコビアン行列です。$$J_f = \begin{pmatrix} \frac{\partial f_1}{\partial z_1} & \dots & \frac{\partial f_1}{\partial z_d} \ \vdots & \ddots & \vdots \ \frac{\partial f_D}{\partial z_1} & \dots & \frac{\partial f_D}{\partial z_d} \end{pmatrix}$$
自動微分とVAEのデコーダVAEでは、デコーダ $x = f(z)$ がニューラルネットワークになっています。
この複雑な微細な変化を計算するために、PyTorchなどのライブラリは、自動微分(Automatic Differentiation) を利用します。
(Pythonでの実装例)
実際に $f: \mathbb{R}^2 \to \mathbb{R}^2$ の関数を定義し、ヤコビアンと計量を計算してみましょう。
import torch
import torch.nn as nn

# 1. デコーダネットワークの定義
class Decoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(2, 16),
            nn.ReLU(),
            nn.Linear(16, 2)
        )
    def forward(self, z):
        return self.net(z)

decoder = Decoder()
z = torch.tensor([0.2, 0.4], requires_grad=True)

# 2. ヤコビアンを自動微分で計算
J = torch.autograd.functional.jacobian(decoder, z)
print("Jacobian Matrix:\n", J)

# 3. ヤコビアンから計量(Metric)を作る
# 数学的には「pullback metric(引き戻し計量)」と呼ばれます
g = J.T @ J
print("Metric Tensor g:\n", g)
(実行結果)
 tensor([[ 0.0042,  0.2517],
        [ 0.0730, -0.0475]])
Metric Tensor g:
 tensor([[ 0.0053, -0.0024],
        [-0.0024,  0.0656]])
(補足説明)
このコードは実行するたびに結果の数値が変わります。
その理由は、ニューラルネットワーク(Decoder クラス)の重みの初期化にあります。
PyTorchの nn.Linear などの層は、インスタンス化されるたびに内部の重み(Weights)とバイアス(Bias)をランダムな値で初期化します。
ヤコビアン行列 $J$ や計量テンソル $g$ は、これらの重みを使って計算されるため、実行するたびに(=新しいモデルが作られるたびに)結果が変わるのです。
なぜ変わるのか?
-
ランダム初期化:
decoder = Decoder() と書くたびに、PyTorchは「今回はこの数値でいこう」とサイコロを振って重みを決めます。 -
計算の連鎖:
ヤコビアン $J$ は**デコーダ関数の「傾き」**です。
関数の形(重み)が変われば、当然その地点 $z$ での傾きも変わります。 -
計量への波及:
$g = J^T J$ なので、$J$ が変われば $g$ も変わります。
結果を固定する方法(再現性の確保)
もし、デバッグや学習のために毎回同じ結果を出したい場合は、コードの冒頭で 乱数シード(Seed)を固定します。
import torch

# 乱数のシードを固定する(これで毎回同じ重みが生成される)
torch.manual_seed(42)

# 以下、モデルの定義と計算...
decoder = Decoder()
# ...
こうすることで、サイコロの出目が常に同じになり、ヤコビアンや計量テンソルの値も固定されます。
import torch

class Decoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(2, 16),
            nn.ReLU(),
            nn.Linear(16, 2)
        )
    def forward(self, z):
        return self.net(z)

# 乱数のシードを固定する(これで毎回同じ重みが生成される)
torch.manual_seed(42)

decoder = Decoder()
z = torch.tensor([0.2, 0.4], requires_grad=True)

# 2. ヤコビアンを自動微分で計算
J = torch.autograd.functional.jacobian(decoder, z)
print("Jacobian Matrix:\n", J)

# 3. ヤコビアンから計量(Metric)を作る
# 数学的には「pullback metric(引き戻し計量)」と呼ばれます
g = J.T @ J
print("Metric Tensor g:\n", g)
今度は、結果はつねに次の数値になりました。
Jacobian Matrix:
 tensor([[ 0.1430, -0.0296],
        [ 0.5345, -0.1498]])
Metric Tensor g:
 tensor([[ 0.3062, -0.0843],
        [-0.0843,  0.0233]])
数学的な視点
デコーダ $f(z)$ の出力を $x = W z + b$ (単純な線形層の場合)とすると、ヤコビアン $J$ は単に重み行列 $W$ そのものになります。$$J = \frac{\partial (Wz + b)}{\partial z} = W$$つまり、ヤコビアンの中身はモデルの重みそのもの(あるいは重みの関数) であるため、重みが変わればヤコビアンも変わる、というわけです。
📌 補足コラム②: 計量とは何か?(なぜヤコビアンから作れる?)
計量とは何か?
次に 計量(metric) です。
計量とは、簡単に言うと
距離を測るルール
です。
普通の距離
$$
d(x,y) = (x-y)^2
$$
これは
ユークリッド距離
です。
しかし 曲がった空間 では事情が変わります。
そこで登場するのが
リーマン計量(Riemannian metric)
です。
ヤコビアンから計量を作る
VAEモデルのデコーダ
$$
f:\mathbb{R}^d \rightarrow \mathbb{R}^D
$$
があるとき、
計量は
$$
g = J_f^{\top} J_f
$$
になります。
成分表示
$g_{ij}=
\sum_{k=1}^{D}
\frac{\partial f_k}{\partial z_i}
\frac{\partial f_k}{\partial z_j}$
これは
データ空間の距離を潜在空間へ引き戻したもの
です。
数学では
Pullback Metric(引き戻し計量)
と呼ばれます。
▶ 深掘り解説:「引き戻し」($pullback$)とは?
ヤコビアンを使って、地図上の移動距離を「現実の移動距離」に変換する新しい定規をリーマン計量 $g$ と呼びます。計量テンソル(Metric Tensor)は、歪んだ世界を測る「正しい定規」です。
$$g(z) = J_f(z)^T J_f(z)$$
上の数式こそが、数学で、「引き戻し(Pullback)」 と呼ばれる魔法の操作です。
なぜこれが数学的に正しいのか
この理論は
微分幾何学(Differential Geometry)
の基本定理です。
データ空間のユークリッド計量を、
デコーダ写像 $f_\theta(z)$ によって潜在空間へ引き戻すと
$$
g(z) = J_f(z)^{\top} J_f(z)
$$
という リーマン計量 が得られます。
になります。
このアイデアは次の研究でも使われています。
- (論文)Diederik P Kingma & Max Welling (2013), Auto-Encoding Variational Bayes, Arxiv
- (論文)Arvanitidis, G., et al. (2018). Latent Space Oddity: on the Curvature of Deep Generative Models.
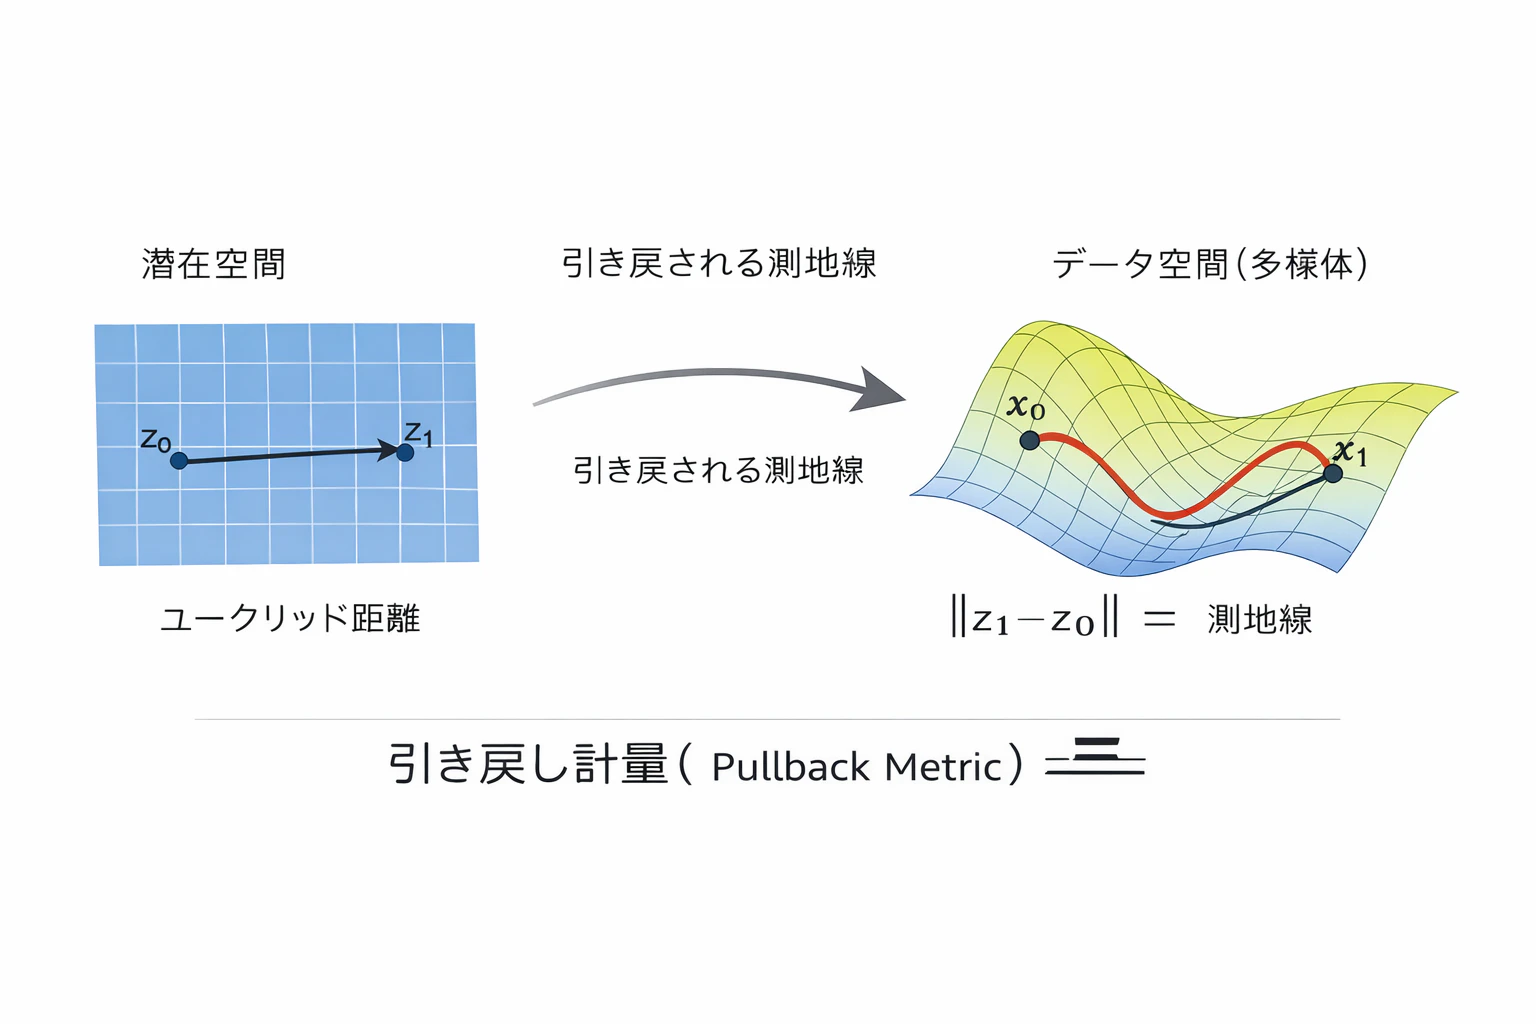
【図解】「引き戻し」ってなに?
想像してみてください。あなたは「エベレストの地図」を持っています。
- 現実世界(データ空間) には、1メートルを正しく測れる「普通の定規」があります。
- しかし、地図(潜在空間) の上では、場所によって「1cm」が表す実際の険しさがバラバラです。
- そこで、デコーダ という道を通って、現実世界の「正しい定規」を地図の上に 「引き戻して」、地図専用のメモリを書き込みます。
これが 「引き戻し」 です。
数式で $J^T$ と $J$ を挟むように掛けているのは、「地図上の動きを一度現実世界に変換し($J$)、そこで距離を測り、また地図上のルールとして確定させる($J^T$)」 という往復作業をしているからなのです。
引き戻しのイメージをした図で示したものが、下の絵になります。
Pythonで計量を計算
import torch

g = J.T @ J

print(g)

# 4. Python実装:計量を算出し、距離の歪みを暴く

それでは、*PyTorch* を使って、**地点 $z$ における「正しい定規 $g$」** を計算してみましょう。

```Python
import torch
import torch.nn as nn

# 1. デコーダの定義 (Softplusを使い微分可能にする)
class StrategyDecoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(2, 64),
            nn.Softplus(), # ReLUではなく滑らかなSoftplusを使用
            nn.Linear(64, 100) # 100次元のデータ空間へ復元
        )
    def forward(self, z):
        return self.net(z)

decoder = StrategyDecoder()

# 2. 特定の地点 z におけるヤコビアンを計算
def get_jacobian(z):
    # torch.autograd.functional.jacobian で変化のカタログを取得
    return torch.autograd.functional.jacobian(decoder.forward, z)

# 3. ヤコビアンからリーマン計量 g を算出
def get_metric(z):
    J = get_jacobian(z)       # (100, 2) の行列
    g = torch.matmul(J.T, J)  # J^T * J を計算して (2, 2) の計量を作る
    return g

# 地図上の「成熟度=1.0, リスク=0.5」の地点での計量を確認
z_sample = torch.tensor([1.0, 0.5])
g = get_metric(z_sample)

print(f"地点 {z_sample.tolist()} におけるリーマン計量 g:\n{g}")
(実行結果)※ Google Colab環境で実行しました。
tensor([[1.6760, 0.0919],
        [0.0919, 1.5408]])
これで
潜在空間の計量テンソル
が得られました。
【比較】ユークリッド距離 vs リーマン距離
ユークリッド距離
$$
|z_1 - z_2|
$$
意味
潜在空間の直線距離
リーマン距離
$$
L =
\int
\sqrt{\dot{z}^{\top} g(z) \dot{z}}
, dt
$$
意味
VAEデコーダを通した本当の距離
違い
| 距離 | 意味 |
|---|---|
| ユークリッド距離 | 潜在空間の直線距離 |
| リーマン距離 | VAEデコーダを通した「本当の距離」 |
つまり、
| 距離 | 意味 |
|---|---|
| ユークリッド距離 | 潜在空間の直線距離 |
| リーマン距離 | データ空間(多様体)での実際の距離 |
です。
例えば
地図では近い
でも山を越える必要がある
とすると
実際の移動距離は長くなります。
これが リーマン距離です。
リスクとの関係
リスクとの関係は モデル次第です。
2つ例を示してみましょう。
(ケース1)
データが
- 市場状況
- サプライチェーン
- 為替
などであれば、
- 距離 = 状況の違い
になります。
このとき
リーマン距離は
現実世界でどれくらい状況が変わるか
を表します。
(ケース2)
潜在空間の変化が
- 利益
- 破綻確率
- ボラティリティ
に影響するなら
- 距離 = リスク地形の移動距離
として解釈できます。
潜在空間 → 多様体 → 測地線
VAEでは、潜在空間の点はデコーダを通して
高次元のデータ多様体へ写されます。
このとき潜在空間の直線は
データ空間では 曲がった経路(測地線) になります。
つまり
- 潜在空間:平面の地図
- データ空間:曲がった地形
- 測地線:その地形での最短経路
という関係が成り立ちます。
データは点の集まりではない。
曲がった空間の幾何学である。
Geometry of Data
VAEが教えてくれる重要な視点があります。
それは
データとは 単なるベクトルではない
ということです。
データは
多様体(Manifold)
の上に存在します。
データは点の集まりではない。
曲がった空間の幾何学である。
Pythonで距離比較
import torch

z1 = torch.tensor([0.1,0.2])
z2 = torch.tensor([0.8,0.7])

euclid = torch.norm(z1 - z2)

print("Euclidean distance:", euclid)
リーマン距離は 数値積分 で近似できます。
steps = 100
length = 0

for t in torch.linspace(0,1,steps):

    z = z1*(1-t) + z2*t

    J = torch.autograd.functional.jacobian(decoder, z)

    g = J.T @ J

    dz = (z2 - z1)/steps

    length += torch.sqrt(dz @ g @ dz)

print("Riemannian distance:", length)
(まとめ)
- ヤコビアン = 多変数関数の微分
- VAEデコーダは、関数 $f(z)$
- ヤコビアンから計量を作ることができる
- 計量を使うと本当の距離が測れる
つまり
潜在空間は、曲がった空間(多様体)
です。
次のステップ
ここまで理解すると
次のテーマが見えてきます。
- 潜在空間の 曲率
- 測地線最適化
- Riemannian VAE
- Geometric Deep Learning
これは
Geometric Data Science
の世界です。
▶ 発展知識
ここまでの議論の延長線上の景色として、
- 地形
- 戦略
- 感度
を踏まえると、本当は もう一段深い概念があります。
それは、
- 情報幾何の距離
です。
例:
- Fisher Information Metric
- KL距離
これは、
統計モデルのリスクや不確実性そのものの距離
になります。
つまり
ユークリッド距離
↓
リーマン距離
↓
情報幾何距離
という 3段階の深さがあります。
Pythonで距離比較
import torch

z1 = torch.tensor([0.1,0.2])
z2 = torch.tensor([0.8,0.7])

euclid = torch.norm(z1 - z2)

print("Euclidean distance:", euclid)
登場した数学定理と論文
| 分類 | 名称 / タイトル | 概要 |
|---|---|---|
| 数学定理 | プルバック計量 (Pullback Metric) | データ空間のユークリッド計量を、滑らかな写像(デコーダ)を通じて潜在空間へ引き戻す幾何学の基本。 |
| 数学概念 | ヤコビアン (Jacobian Matrix) | 多変数関数の微分。各成分における「変化のカタログ」を表す行列。自動微分の核となる概念。 |
| 論文 | Latent Space Oddity: on the Curvature of Deep Generative Models | VAEの潜在空間を「平坦」とみなすことの危険性を指摘し、幾何学的解析を導入した重要論文 (Arvanitidis et al., 2018)。 |
| 論文 | The Riemannian Geometry of Deep Generative Models | 生成モデルをリーマン多様体として扱い、測地線を計算する枠組みを提示 (Shao et al., 2018)。 |
次回の予告: 「戦略の地形」を可視化する
【連載:ジオメトリック・インテリジェンス 第2回】「戦略の地形」を可視化する:曲率マップとブルーオーシャンの発見
内容紹介:
- 本記事で手に入れた 「定規(計量 $g$)」 を使って、次はいよいよ 地図の凸凹を浮き彫りに します。
- 空間の「曲がり具合(曲率)」を計算することで、どこが激戦区で、どこが穴場なのか?
- 等高線とカラーマップを駆使して、意思決定を支える「戦略地形図」をPythonで描画します。
本記事とのつながり:
第1回(本記事)で「場所によって定規が違うこと」をコードで証明しました。
第2回では、その定規の変化率から「曲率」を特定し、視覚的なインテリジェンスへと昇華させます。