

Executive Summary
暗号は長らく「通信を盗聴から守る」技術として理解されてきました。
しかし、AIの普及によって、データを「計算している最中」にも守る必要が生まれています。
データは、守ろうとすると使えず、使おうとすると守れない。
この ジレンマ に対し、現代の 「高機能暗号」 は、
- 暗号化したまま計算する
- 秘密を明かさずに正しさを証明する
- 一か所に集めずに分散して計算する
という3つの新しい答えを用意しています。
本記事は、暗号を「守る・計算する・証明する・分散する」の4つの機能で整理 し、楕円曲線暗号、準同型暗号、ゼロ知識証明、秘密分散・秘密計算(MPC)のしくみを、高校数学だけを前提に解説 します。
準同型暗号 は指数法則から群・環の準同型へ、
格子暗号 は誤差を混ぜた連立一次方程式(LWE)へ、
ゼロ知識証明 は Schnorr プロトコルへ、
秘密分散 は「何点で曲線が決まるか」へと、
それぞれの数学の核心まで踏み込み、Python の実装コードで動作を確かめます。
あわせて、実務の現在地 も示します。
準同型暗号 は、いまも平文に比べて数百万倍以上の計算時間がかかる一方、この十数年で処理の最大の壁(ブートストラップ)が百万倍以上高速になり、Apple や Microsoft の製品では、検索・照合のような限られた用途ですでに使われています。
また、準同型暗号と同じ 格子の数学 は、量子コンピュータ時代に備えた耐量子計算機暗号の標準(ML-KEM)の土台にもなっています。
結論として、暗号はもはやセキュリティ専門家だけのものではなく、個人情報や機密データを扱うすべてのエンジニアにとって、「守りながら活かす」ための思考の道具になりつつあります。
ただし 万能ではなく、TEE や差分プライバシーなど暗号以外の手法と、「誰から・何を守るのか」に応じて組み合わせることが、実務での手法選びの基本 です。
本記事の論旨展開
0. 本記事の方針についての注意書き
本記事は、専門書を開く前段階で全体像を直感的につかむことを目的としています。
そのため、数学的な厳密性よりも、イメージのつかみやすさを優先しています。
本文中の表現や説明には、厳密な定義・命題の前提条件・適用範囲を意図的に省略・簡略化している箇所があります。
正確な定義は各分野の標準的な教科書・論文に譲り、本記事では「何のための道具か」という骨格の理解を優先しました。専門家の方で、より正確な言い回しの提案があれば、ぜひコメントでご指摘いただけますと幸いです。
※ 本記事は、厳密な代数学や格子理論の知識を前提にしません。準同型暗号・楕円曲線・格子といった用語そのものは登場しますが、それぞれを「どんな問題を解く道具なのか」という直感のレベルで説明します。
なお、量子暗号(量子鍵配送など、量子力学を直接使う暗号)は、本記事では軽く位置づけに触れるだけにとどめ、稿を改めて別の記事で扱います。本記事が扱うのは、従来のコンピュータ上で動く「数学に基づく暗号」です(耐量子計算機暗号 = PQC はこちらに含みます)。
※ 本記事に登場するコードは、仕組みを手を動かして理解するための学習用です。
特に第6章・第7章のコードは、原理が見えるように最小限の形で書いたもので、実務で求められる安全対策(サイドチャネル攻撃への対策や、パラメータの適切な選び方など)は施していません。
暗号は「動く」ことと「安全である」ことの間に大きな隔たりがある分野です。実務では暗号を自作せず、専門家による監査を経た実績あるライブラリを使ってください。
1. はじめに ― 本記事の想定読者と読むメリット
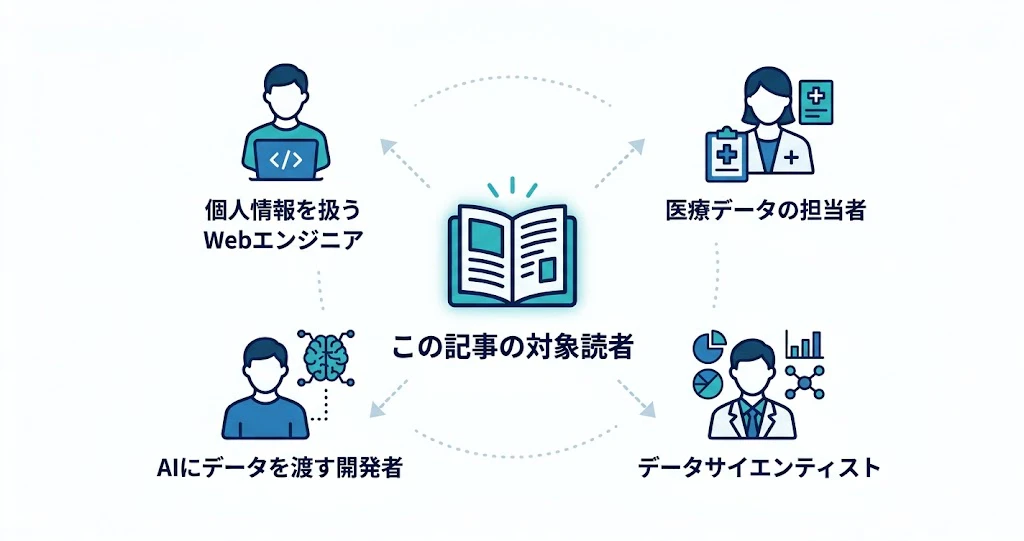
想定読者
- 暗号といえば「通信を盗聴から守るもの(HTTPSなど)」というイメージで止まっており、それ以外に何ができるのか全体像が見えない方
- Webサービス・医療・金融・製造などで、個人情報や機密データを扱う業務に携わっており、「データを守りながら活用する」ことに関心がある方
- データサイエンス・機械学習・バックエンド開発の現場にいて、「準同型暗号」「ゼロ知識証明」「楕円曲線」といった単語を見かけて戸惑ったことがある方
- LLM・AIエージェントにデータを渡すとき、「この情報、本当に渡して大丈夫か?」と一度でも不安に思ったことがある方
前提知識は 高校数学だけで十分 です。
専門用語や数式は、初出のたびにやさしく解説します。
この記事を読むメリット
本記事は定義の羅列をしません。
高機能暗号を以下の観点から整理・俯瞰し、全体の見取り図をお届けします。
- 暗号を「通信を守る」だけでなく「データを暗号化したまま計算・活用する」道具として捉え直す視点
- 計算できる暗号(準同型暗号)・楕円曲線暗号・ゼロ知識証明・秘密分散など、主要な高機能暗号の名前と用途の地図
- 各暗号が、Webビジネス・医療カルテ・個人情報を扱う業務で、どんな場面で使えるのかの具体的な利用シーン
- 各暗号の数学的な仕組みを、想定読者が理解できるレベルまで噛み砕いた解説(準同型暗号の群論・環論、格子暗号のLWE、ゼロ知識証明のSchnorrプロトコル、秘密分散の多項式まで、高校数学だけを前提に、しくみの核心まで逃げずに踏み込みます)
- 各手法を試すための実装コード例(Python中心)
- LLM・AIエージェント時代に、これらの暗号ニーズが現在どうなっていて、将来どこへ向かうのかの展望(すでに実用化されている事例や、TEE・差分プライバシーなど暗号以外の手法との使い分けを含む)
『読む前』と『読んだ後』で、読者の皆様はどう変わるか
| 読む前 | 読んだ後 | |
|---|---|---|
| 暗号のイメージ | 通信を盗聴から守る技術 | データを守りながら暗号化したまま活用する技術群 |
| 準同型暗号 | 名前も知らない/何ができるか不明 | 暗号文のまま計算できる暗号とその利用シーンがわかる |
| 楕円曲線暗号 | HTTPSやビットコインで使われる何か | なぜRSAより短い鍵で強いのか直感がわかる |
| ゼロ知識証明 | 難しそうで敬遠していた | 秘密を明かさず正しさだけ示す発想と用途がわかる |
| 自分の業務との接続 | 暗号は専門家のもの、自分に無関係 | 個人情報・医療・AI活用の課題に暗号が有効だと気づくことができる |
| AI時代のデータ保護 | 通信を暗号化すればよい | 計算中・学習中のデータも守るという発想を持てる |
TL;DR(一言要約)

暗号は「通信を守る」だけの道具ではありません。
現代の 高機能暗号 は、データを暗号化したまま、計算・検索・統計処理・機械学習を行うことを可能にしつつ あります。
その本質は「秘密を守ること」と「データを活用すること」という、相反しがちな2つを数学で両立させる点 にあります。
本記事は、
(1) 暗号を 「守る/計算する/証明する/分散する」の4機能 で整理し、
(2) 準同型暗号・楕円曲線・ゼロ知識証明の仕組み を初心者向けに概説し、
(3) Webビジネス・医療・個人情報業務 での利用シーンと実装コードを示し、
(4) LLM・AIエージェント時代のニーズと展望 までを見渡す地図です。
なお、量子暗号は軽く触れるにとどめ、別稿に譲ります。
本記事の読み方
- まず全体像だけつかみたい方 → 第2章・第3章
- 計算できる暗号(準同型暗号)を知りたい方 → 第5章(本記事の中心テーマ)
- 楕円曲線暗号の仕組みを知りたい方 → 第4章
- ゼロ知識証明・秘密分散を知りたい方 → 第6章・第7章
- 実装コードを見たい方 → 第4章・第5章・第6章・第7章
- AI時代の展望や、TEE・差分プライバシーなど暗号以外の手法との使い分けを知りたい方 → 第9章
2. そもそも暗号は何をしているのか ── 4つの機能
「暗号」と言われると、多くの人は「通信を盗聴から守るもの」を思い浮かべます。
HTTPSの鍵マーク、メッセージアプリのエンドツーエンド暗号化などです。
これは暗号の最も古典的で重要な機能ですが、現代の暗号が担う役割は、それよりはるかに広がっています。

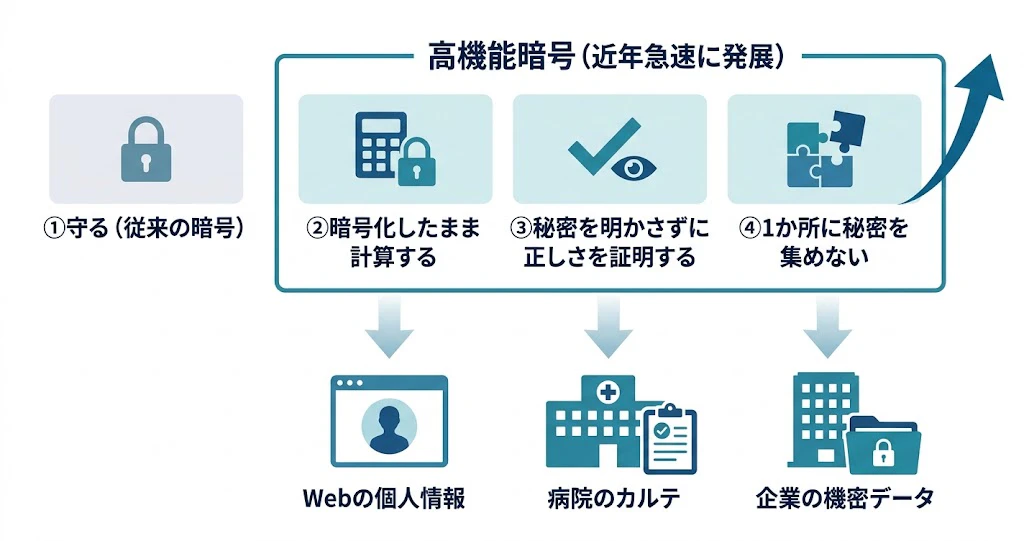
本記事では、暗号の役割を次の4つの機能に整理 します。
これが 本稿の構造 です。
| 機能 | ひとことで言うと | 代表的な手法 |
|---|---|---|
| ① 守る(秘匿) | 第三者に中身を読ませない | 共通鍵暗号(AES)、公開鍵暗号(RSA・楕円曲線) |
| ② 計算する(準同型) | 暗号化したまま計算する | 準同型暗号(BFV・CKKS・TFHE) |
| ③ 証明する(証明) | 秘密を明かさず正しさだけ示す | ゼロ知識証明(ZKP) |
| ④ 分散する(分散) | 1か所に秘密を集めない | 秘密分散、秘密計算(MPC) |

この4つは、理解しやすさを優先して、主な役割ごとに整理した見取り図です。
実際のシステムでは、複数の手法を組み合わせて使うことも あります(第8章・第9章で触れます)。
ポイントは、①(守る)以外の②(暗号化したまま計算する)・③(秘密を明かさずに正しさを証明する)・④(1か所に秘密を集めない)こそが、近年「高機能暗号」と呼ばれて急速に発展している領域 だということです。
これらが力を発揮する領域は、金融や軍事だけではありません。
Webサービスの個人情報、病院のカルテ、企業の機密データ
── 「守りたいが、活用もしたい」というジレンマを抱えるあらゆる業務で、武器になりえます。
3. なぜ「暗号の数学」が、非暗号の業務で武器になるのか
理由は、現代のビジネスが抱える、ある根本的なジレンマ にあります。
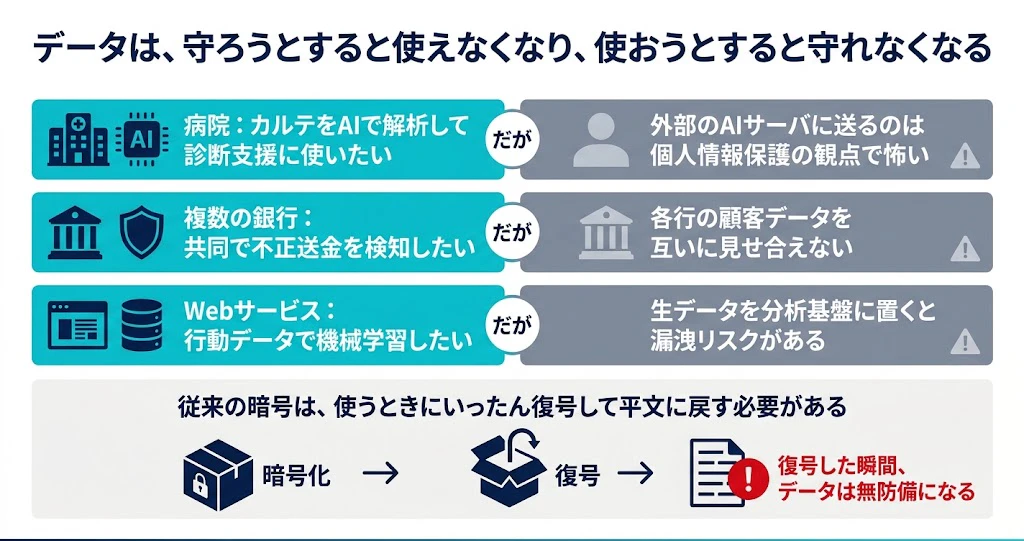
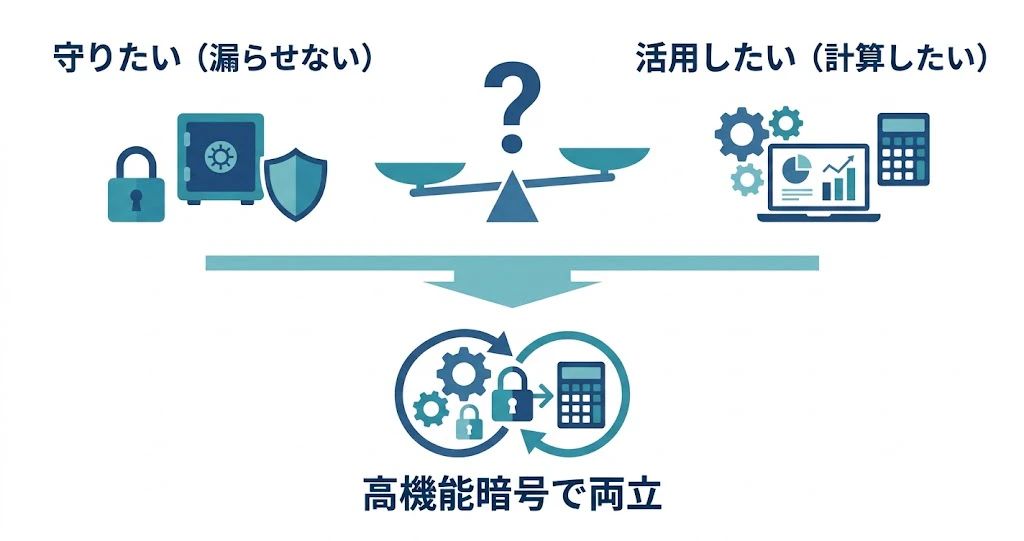
データは、守ろうとすると使えなくなり、使おうとすると守れなくなる。
たとえば、こういう場面 です。
- 病院が、患者のカルテをAIで解析して診断支援に使いたい。
でも、カルテを外部のAIサーバに送るのは、個人情報保護の観点で怖い。
- 複数の銀行が、共同で不正送金を検知したい。
でも、各行の顧客データを互いに見せ合うことはできない。
- Webサービスが、ユーザーの行動データで機械学習したい。
でも、生データを分析基盤に置くと漏洩リスクがある。
従来の暗号(①守る)だけでは、このジレンマは解けません。
なぜなら、従来の暗号は「使うとき(計算するとき)には、いったん復号して平文に戻す」必要があるからです。復号した瞬間、データは無防備になります。
ここで力を発揮するのが、②暗号化したまま計算する・③秘密を明かさずに正しさを証明する・④1か所に秘密を集めない、という高機能暗号 です。
これらは、「暗号化したまま使う」「秘密を明かさず確かめる」「一か所に集めない」という、まったく新しい発想 でこのジレンマを数学的に解こうとします。

重要なのは、この発想が暗号の専門家でなくても自分の業務に応用しうるという点です。
ここで言う「応用」とは、暗号そのものを自分で設計したり実装したりすることではありません。
暗号の設計は専門家の仕事であり、実務では、専門家による監査を経たライブラリやクラウドサービスを使います。
非暗号エンジニアに求められるのは、自分の業務の中にある「守りたいが、活用もしたい」という場面に気づき、「このデータは、平文に戻さなくても計算できるのではないか」「この確認は、中身を見せなくても済むのではないか」「このデータは、1か所に集めなくても分析できるのではないか」と問いを立てることです。
この問いを立てられるかどうかで、設計の選択肢が大きく変わります。
たとえば、「顧客データを外部に渡せないから、この分析はあきらめる」という結論が、「暗号化したまま計算できる道具を使えば、渡さずに分析できるかもしれない」という検討に変わります。
どの道具を選び、どこまでを暗号で守るのかは、第9章で見るように、「誰から、何を守りたいのか」を整理すれば判断できます。
本記事が第4章以降で各暗号の数学に踏み込むのも、こうした問いを自分で立てられるようになるためです。
しくみの核心を一度理解しておけば、「何ができて、何ができないのか」を自分の言葉で説明でき、専門家やベンダーとも具体的に相談できるようになります。
4. 楕円曲線暗号 ── 「短い鍵で強い」公開鍵暗号の主役
高機能暗号 の話に入る前に、現代の暗号の土台になっている 楕円曲線暗号(ECC) を押さえます。
HTTPS、ビットコイン、マイナンバーカード、メッセージアプリの鍵交換
── 現代のあらゆる場所で使われています。
4-1. まず「公開鍵暗号」とは
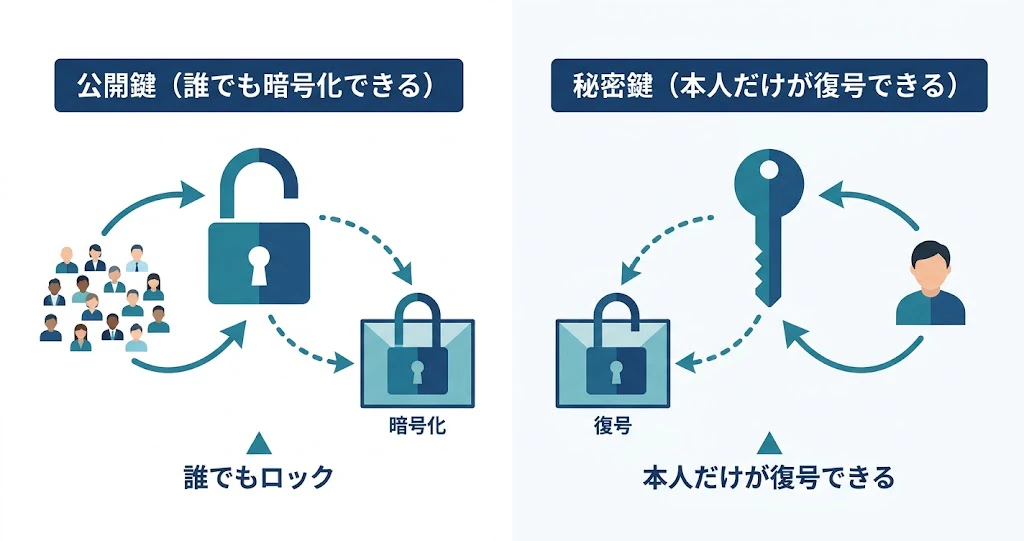
公開鍵暗号 は、鍵を2つに分けるという発明です。
公開鍵 は誰に見られてもよい鍵で、これで暗号化(または署名の検証)をします。
秘密鍵 は本人だけが持つ鍵で、これで復号(または署名)をします。
南京錠にたとえると分かりやすいです。
公開鍵は「開いた南京錠」で、誰でも手に入れてカチャッと閉じられる(暗号化できる)。
でも、いったん閉じた錠を開ける鍵(秘密鍵)は、本人しか持っていない。
だから、公開鍵をいくらばらまいても安全 なのです。
4-2. なぜ「楕円曲線」が出てくるのか
公開鍵暗号 が成り立つには、「片方向は簡単だが、逆は極端に難しい」という数学的な仕掛けが必要 です。
古くからある RSA暗号 は、「大きな2つの素数を掛けるのは簡単だが、その積を素因数分解するのは難しい」という性質 を使います。
楕円曲線暗号 は、素因数分解とは別の「難しさ」を使います。
それは、楕円曲線上の「点の足し算」を何回も繰り返すという操作 です。
楕円曲線 とは、大まかに言えば $y^2 = x^3 + ax + b$ という形の、なめらかな曲線です。
この曲線上の2点には、独特のルールで「足し算」が定義できます。
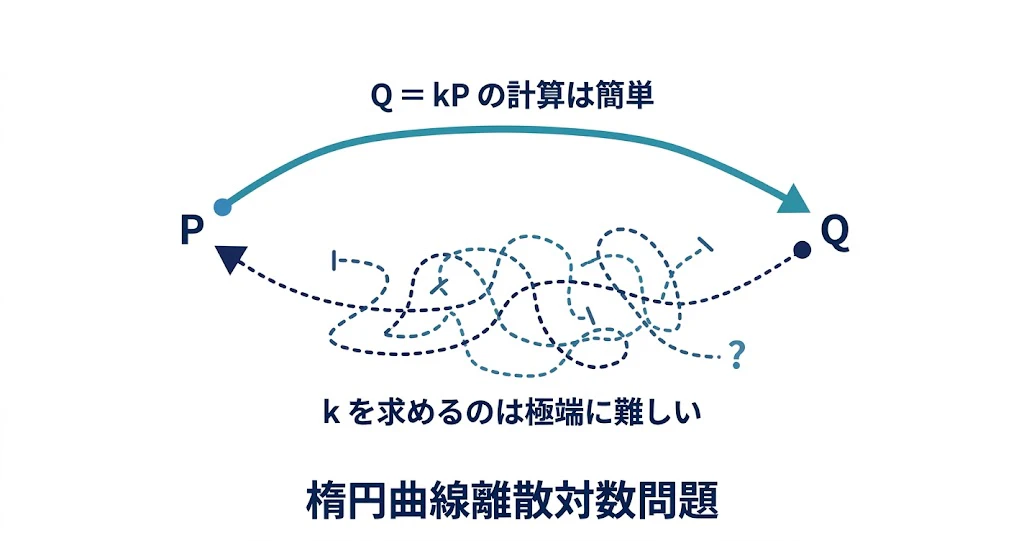
ポイントになるのは、次の非対称性 です。
ある点 $P$ を $k$ 回足し合わせて $Q = kP$ を計算するのは簡単。
逆に、$P$ と $Q$ だけを見て「何回足したか( $k$ )」を求めるのは極端に難しい(楕円曲線離散対数問題)。
この非対称性が、楕円曲線暗号の安全性の源 です。
ただし、ここでの「なめらかな曲線」は、あくまで直感をつかむための絵です。
実際の暗号では、$x$ や $y$ を実数ではなく「ある大きな素数 $p$ で割った余り」($0$ から $p-1$ までの整数)に限った、有限体の上の楕円曲線を使います。
$y^2 \equiv x^3 + ax + b \pmod{p}$ を満たす整数の点 $(x, y)$ だけを集めると、なめらかな曲線ではなく、平面上にバラバラに散らばった点の集まりになります。
それでも、実数の曲線で決めた「点の足し算」のルールは、余りの世界に翻訳してそのまま使えます。
点 $P$ を何回か足していくと、$Q = kP$ は散らばった点の間を予測のつかない順番で飛び回るように見えます。
これが、「何回足したか($k$)」を逆算しにくいことの直感的なイメージです。

4-3. なぜ「短い鍵で強い」のか
楕円曲線暗号 の最大の魅力は、RSAよりはるかに短い鍵で、同等の安全性を達成できること です。
大まかな目安として、RSAで3072ビットの鍵が必要な安全性が、楕円曲線では256ビットで足ります。
なぜこれほど差がつくのでしょうか。
RSAが頼る素因数分解には、総当たりよりはるかに速い攻撃法(数体ふるい法など)が知られています。
そのため、安全性を保つには鍵を大きく伸ばす必要があります。
一方、楕円曲線の離散対数問題には、いまのところそうした近道が見つかっていません(特殊な弱い曲線を除く)。
知られている最良の攻撃でも、鍵の長さのおよそ半分のビット数に相当する手間がかかります。256ビットの鍵なら、約 $2^{128}$ 回の計算です。
攻撃の近道がない分、短い鍵でも同じ安全性を保てる のです。
鍵も署名も小さくなるため、スマホ・ICカード・IoT機器のような計算資源の限られた環境で特に有効 です。
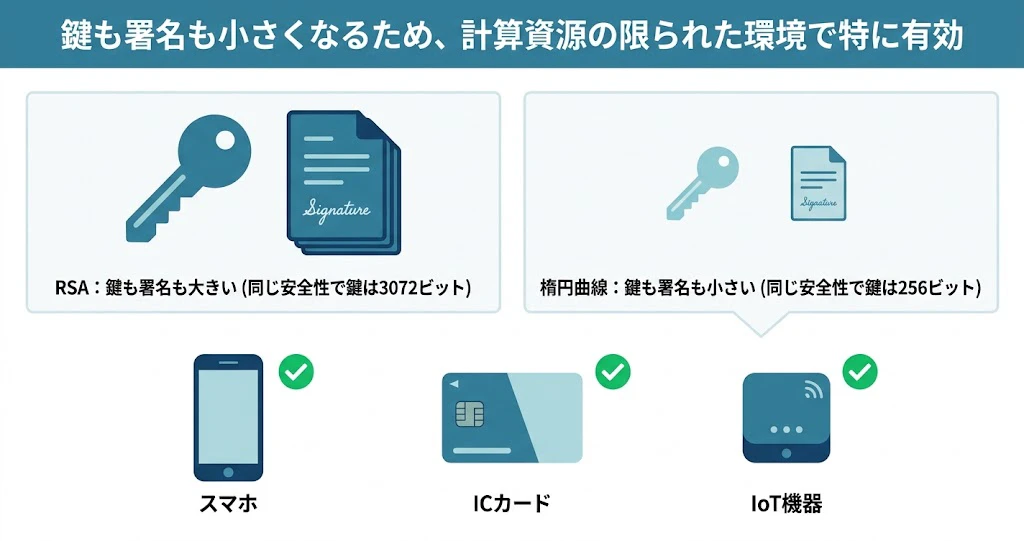

※ 図の数値は NIST SP 800-57 Part 1 Rev. 5(2020年)の Table 2 にもとづきます。楕円曲線の「鍵長」として示しているのは、正確には曲線の基点の位数のビット長(表の f)です。
秘密鍵の長さはこれにほぼ一致しますが、公開鍵は曲線上の点の座標なので、圧縮しない形式ではおよそ2倍(P-256 で約512ビット)になります。
また、「同じ安全性」は、現在知られている最良の攻撃法(従来型コンピュータによるもの)にもとづく推定値です。
将来の攻撃法の改良によって評価が変わる可能性があり、後述の5-5で見るとおり、量子コンピュータに対しては RSA・楕円曲線のどちらも安全ではありません。
4-4. 実装イメージ
楕円曲線による鍵ペアの生成と署名を、Pythonの cryptography ライブラリで 書くと、次のようになります。
仕組みは難しくても、Pythonの実装コードはわずか数行 です。
実行条件:Python 3、
pip install cryptography用途:ライブラリの使い方の例(実務では鍵の保管・管理も別途必要)
# pip install cryptography
from cryptography.hazmat.primitives.asymmetric import ec
from cryptography.hazmat.primitives import hashes

private_key = ec.generate_private_key(ec.SECP256R1())
public_key = private_key.public_key()

message = b"diagnosis: type-2 diabetes"
signature = private_key.sign(message, ec.ECDSA(hashes.SHA256()))
public_key.verify(signature, message, ec.ECDSA(hashes.SHA256()))
print("署名は正当です")
5. 計算できる暗号(準同型暗号) ── 本記事の中心テーマ
ここからが、本記事で最も伝えたい一節 です。
暗号化したまま計算する という、一見すると魔法のような技術の話です。
5-1. 準同型暗号とは何か
通常の暗号では、データを使うときにいったん復号します。
「暗号化 →(復号して)計算 →(再び)暗号化」という流れで、計算の瞬間だけ平文がむき出しに なります。
準同型暗号(Homomorphic Encryption, HE) は、この常識を覆します。
暗号文のまま足し算や掛け算ができ、その結果を復号すると、平文で計算したのと同じ答えになるのです。
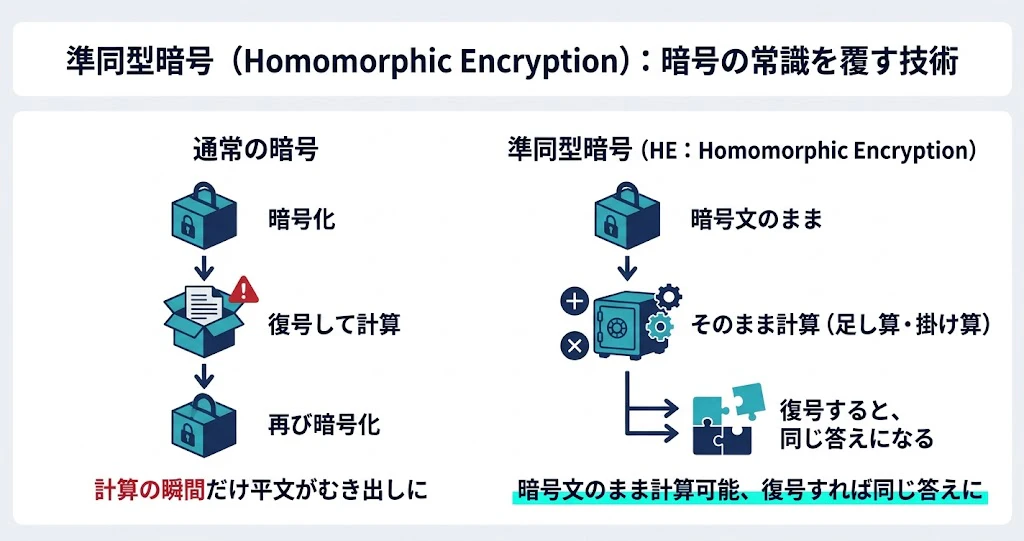
暗号化を E(・)、復号を D(・) と書くと、D(E(a) ◇ E(b)) = a + b のように、暗号文どうしを演算 ◇ してから復号すると、平文を足した答え a+b が出てきます(◇ は暗号文の世界での演算で、方式によって足し算だったり掛け算だったりします)。
計算する側は a も b も中身を一切知らないまま、結果だけを暗号文として得られます。
ここで一つ注意点があります。
「E(a) ◇ E(b) が、E(a + b) とまったく同じ暗号文になる」とは限りません。
現代の暗号は、同じ平文を暗号化しても毎回ランダムに違う暗号文になる(確率的暗号)ように作られています。
そうでないと、「同じ暗号文なら同じ中身」と見破られてしまうからです。
ですから正確には、E(a) ◇ E(b) は、「a+b を暗号化した暗号文の“一つ”(復号すれば a+b になるもの)」になる、という意味です。
本記事で E(a) ◇ E(b) = E(a + b) のように書くときも、この意味で読んでください。
たとえるなら、中身の見えない金庫の中で、品物を組み合わせる作業です。
作業する人は金庫の中身を見られないのに、組み立て作業だけは正しくでき、依頼主が鍵を開けると完成品が入っている、というイメージです。
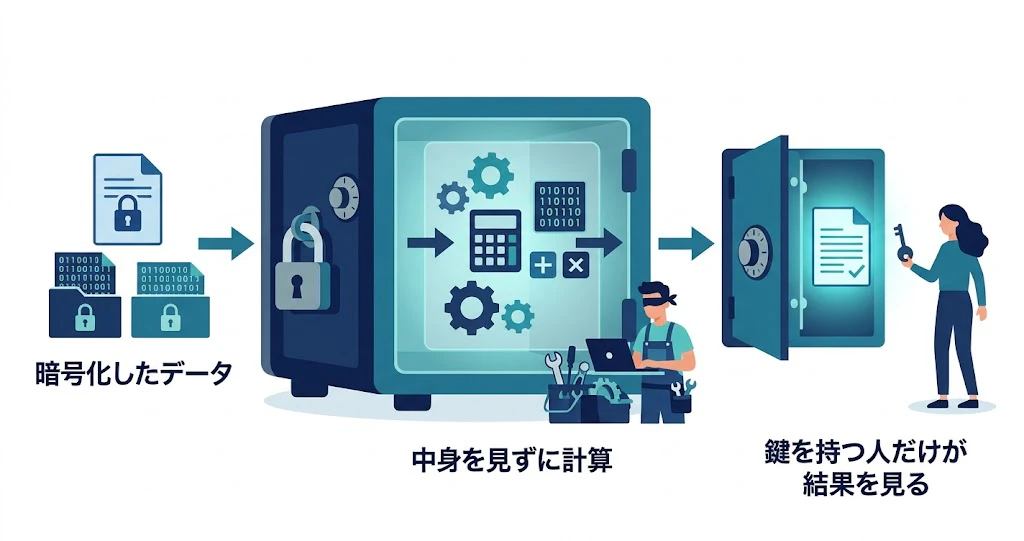
ただし、どんな計算でも自由にできるわけではありません。実行できる演算の種類や回数、計算の精度には方式ごとの制約があり、計算にかかる時間も平文よりはるかに大きくなります。代表的な制約は、5-3〜5-5で順に見ていきます。
5-2. 数学的な設計図(その1)── 「準同型」とは何か、なぜ群論が出てくるのか
ここから、準同型暗号の数学的なしくみに踏み込んでみましょう。
準同型暗号には、大学で学ぶ 群論(とその発展である環論)という数学 が使われます。
しかし本稿では、高校数学だけを前提知識として、まず 「準同型」のイメージ を解説します。
そのうえで、大学数学の準同型の概念が準同型暗号にどう組み込まれているのか を分かりやすく解説します。
出発点は、高校で習う「関数(写像)」です。
関数とは、ある世界の要素を、別の世界の要素に対応させる規則のことでした。
たとえば $f(x) = 2x$ は、1 を 2 に、3 を 6 に対応させる規則です。
準同型の話は、この「対応させる規則」から始まります。
【ステップ1:群とは「集合 + 演算」のこと】
大学数学の「群(ぐん、group)」は、難しそうな名前ですが、中身は高校で慣れ親しんだものです。
群とは、簡略化して言うと、「ある集合と、その上の1つの演算」がセットになったもので、いくつかの素直な条件(演算で閉じている、結合法則が成り立つ、単位元がある、逆元がある)を満たすものです。
身近な例を挙げます。
整数全体の集合と「足し算」をセットにする と、これは 群 になります。
- 整数を足せば整数になり(閉じている)
- (a+b)+c = a+(b+c) が成り立ち(結合法則)
- 0 を足しても変わらず(単位元は 0)
- a に対して -a を足せば 0 に戻せる(逆元は -a)
高校で当たり前に使っていたこの構造が、実は 「群」と呼ばれるものの正体 です。

もう1つ。
正の実数全体の集合と「掛け算」をセット にしても 群 になります。
- 掛ければ正の実数になり
- 結合法則が成り立ち
- 1 を掛けても変わらず(単位元は 1)
- a に対して 1/a を掛ければ 1 に戻せる(逆元は 1/a)

つまり 「足し算の世界」と「掛け算の世界」は、それぞれ別の群だ、というわけ です。

【ステップ2:準同型写像とは「構造を保つ対応」】
ここからが大事なところです。
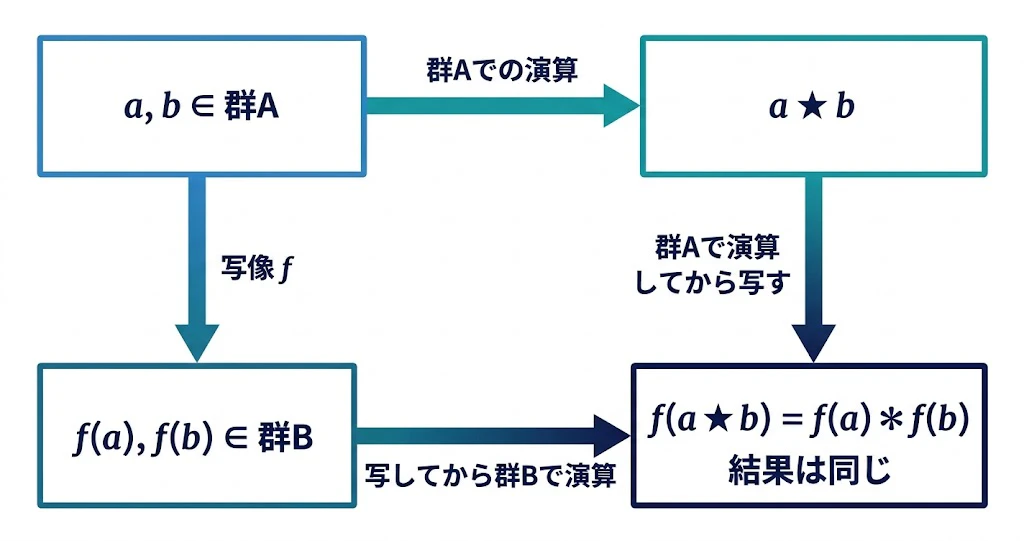
2つの群の間の対応 $f$ が「準同型写像(homomorphism)」である とは、次の式が成り立つことを言います。
f(a ★ b) = f(a) ◇ f(b)

★ … 出発する世界(群A)での演算
◇ … 行き先の世界(群B)での演算
言葉にすると、「先に群Aで演算してから $f$ で送っても、先に $f$ で送ってから群Bで演算しても、同じ結果になる」ということです。
$f$ が、演算という構造を壊さずに、そっくり運んでくれる。
これが「構造を保つ対応=準同型」の意味 です。
【ステップ3:実は高校で準同型を使っていた ── 指数法則】
驚かれるかもしれませんが、皆様は高校で準同型写像をすでに使っています。
それが 指数法則 です。
2^(a + b) = 2^a × 2^b
この式を、ステップ2の準同型の式 と見比べてください。
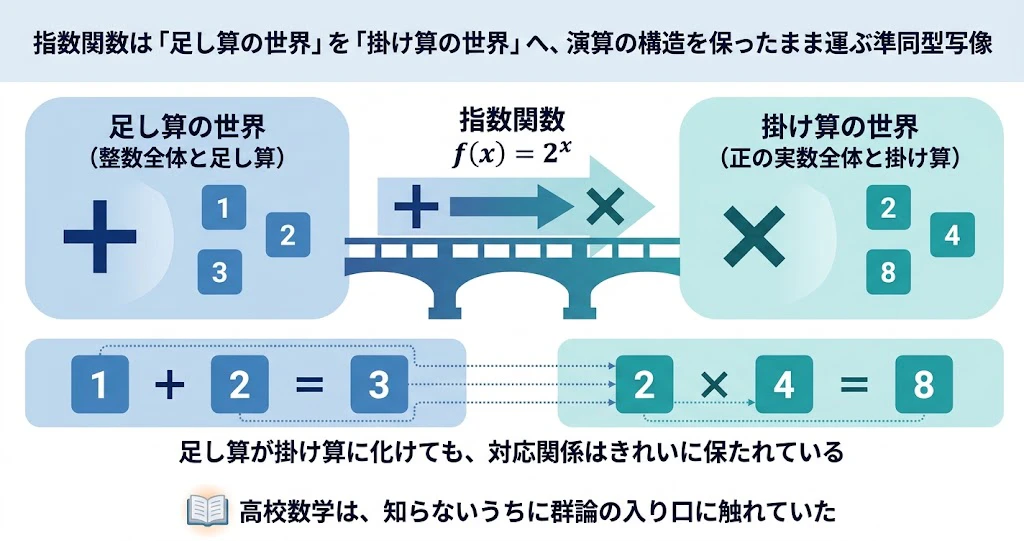
$f(x) = 2^x$ という対応を考えると、左辺は $f(a + b)$ 、右辺は $f(a) × f(b)$ です。
つまり、
f(a + b) = f(a) × f(b)

出発の世界(群A)… 整数と「足し算」
行き先の世界(群B)… 正の実数と「掛け算」
指数関数 $f(x) = 2^x$ は、「足し算の世界」を「掛け算の世界」へ、演算の構造を保ったまま運ぶ準同型写像だった のです。
足し算が掛け算に化けても、対応関係はきれいに保たれている。
高校数学は、知らないうちに群論の入り口に触れていた、というわけです。

※ 図の曲線は、$x$ を実数全体に広げて描いています。
本文では出発の世界を「整数と足し算」としましたが、実数と足し算の世界から正の実数と掛け算の世界への対応としても、$f(x) = 2^x$ は演算の構造を保つ準同型写像になっています(しかも、異なる $x$ には異なる値が対応する一対一の対応です)。
整数に限っても、同じ関係 $2^{a+b} = 2^a \times 2^b$ がそのまま成り立ちます。
【ステップ4:これが準同型暗号にどう組み込まれているか】
ようやく本題です。
準同型暗号の「暗号化」$E$ を、1つの 準同型写像だ と考えてみてください。
すると、第5章の冒頭で見た式は、こう読み解けます。
E(a + b) = E(a) ◇ E(b)

左辺 … 平文の世界で a と b を足してから暗号化
右辺 … a と b を別々に暗号化してから、暗号文の世界で演算 ◇
これはまさに、ステップ2の準同型の式そのもの です。
(5-1で触れたとおり、暗号文は毎回ランダムに変わるので、厳密には「右辺を復号すると a+b になる」という意味です)
暗号化 $E$ が準同型写像であれば、「平文の世界での足し算」が「暗号文の世界での演算」に対応する。
だからこそ、暗号文のまま計算できる のです。
準同型暗号の「準同型」という名前は、まさにこの群の準同型写像から来ています。

具体例 で見ます。
ステップ3の指数法則 $2^{a+b} = 2^a \times 2^b$ を、そのまま暗号にした のが、Paillier(パイエ)暗号 や 「指数型ElGamal暗号」 と呼ばれる方式です。
大まかに言えば、平文 $m$ を「$g$ の $m$ 乗」という形で、暗号文の“肩の上”に埋め込みます
(実際には、毎回変わる乱数のマスクを掛けて隠し、ある大きな数で割った余りの世界で計算します)。
すると、2つの暗号文を掛け合わせると、指数法則によって、肩の上の平文どうしが足し算されます。
暗号文の中身(イメージ):E(a) = g^a × (乱数のマスク)

E(a) × E(b) = g^a × g^b × (マスク)
            = g^(a + b) × (マスク)   ← ステップ3の指数法則
            → 復号すると a + b
暗号文の世界の「掛け算」が、平文の世界の「足し算」に対応する。
これは、ステップ3で見た「足し算の世界 → 掛け算の世界」の準同型写像そのもの です。
Paillier暗号 は、この性質を使って「暗号化したまま合計や平均を計算する」用途で、実際に使われています。
一方、古典的な RSA暗号 (教科書どおりの素のRSA)は、平文 $m$ を「$m$ の $e$ 乗」という形で暗号化します。
こちらは、同じ指数法則でも $(a × b)^e = a^e × b^e$ という別の形(底どうしの掛け算が、べき乗しても保たれる法則)によって、$E(a) × E(b) = E(a × b)$ が成り立ちます。
これは「掛け算の世界 → 掛け算の世界」の準同型で、RSAが部分的な準同型性(掛け算だけができる)を持つことの正体 です。
同じ「指数法則」でも、Paillierは「肩の上の足し算」を、RSAは「底の掛け算」を運んでいる、という違い があります。

※ 図の左右を数式で書くと、次のようになります(いずれも実際には、ある大きな数で割った余りの世界で計算します)。
Paillier暗号(左)では、平文が $g$ の肩に乗っているため、暗号文どうしの掛け算が肩の上の足し算になります。
$$E(a) \times E(b) = g^a \times g^b \times (\text{乱数のマスク}) = g^{a+b} \times (\text{乱数のマスク}) \quad\longrightarrow\quad \text{復号すると } a+b$$
RSA暗号(右)では、平文が底に置かれているため、暗号文どうしの掛け算が底の掛け算になります。
$$E(a) \times E(b) = a^e \times b^e = (a \times b)^e = E(a \times b)$$
足し算も掛け算も両方できる完全準同型暗号(FHE)では、話が一段階レベルアップ します。
群は「1つの演算」を持つ構造 でしたが、
足し算と掛け算の「2つの演算」を同時に持ち、両者が分配法則 $a×(b+c) = a×b + a×c$ で結びついている構造 を、大学数学では 環(かん、ring) と呼びます。
整数全体(足し算も掛け算もできる)が、環の代表例です。
FHEは、後述する格子という舞台の上で、平文の足し算と掛け算の両方を、暗号文の演算へと対応させます。
群の準同型を2つの演算に広げた「環の準同型」 を、暗号化そのものに仕込んでいる
── これがFHEの数学的なしくみの骨格です。

【発展コラム】ここで登場する「格子」は格子暗号の名前の由来か?
結論から言うと、Yesです。
ここで登場する「格子」こそが、「格子暗号」という名前の由来です。
そして、現在実用されている完全準同型暗号(FHE)は、ほぼすべてが格子暗号に分類されます。
「格子」とは何か
ここでいう格子とは、いくつかの基本ベクトルを整数倍して足し合わせた点を、すべて集めたものです。
2次元なら方眼紙の交点のような点の並びで、これを数百〜数千次元に一般化したものを考えます(詳しくは5-5で解説します)。
格子暗号が「格子」の名を冠しているのは、安全性の根拠を、この格子の上の難しい問題に置いているからです。
代表的なものに、与えられた点に最も近い格子点を探す最近ベクトル問題(CVP)や、原点以外で最も短い格子点を探す最短ベクトル問題(SVP)があります。
高次元では、これらをコンピュータで現実的な時間内に解く方法が知られていません。
5-5で紹介するLWE問題は、一見すると「誤差を混ぜた連立一次方程式」の話で、格子とは無関係に見えます。
しかし2005年にRegevが、LWEを解くことは格子の難しい問題を解くのと同じくらい難しい、という関係を証明しました。このつながりがあるため、LWEに基づく暗号も格子暗号に分類されます。
なお、数学には「lattice」と呼ばれる別の概念(順序の構造)もありますが、日本語ではそちらを「束(そく)」と訳し分けます。格子暗号の「格子」は、あくまで点の並びとしての格子です。
FHEは格子暗号なのか
本記事で紹介するBFV・BGV・CKKS・TFHEは、いずれもLWEやその環版(Ring-LWE)に安全性の根拠を置いており、格子暗号です。
現在実用されているFHEの主流は、格子暗号だと言ってよいでしょう。
ただし、「FHEであること」と「格子暗号であること」は、定義のうえでは別の性質です。
2009年にGentryが示した最初のFHEは格子に基づく方式でしたが、その翌年には、格子ではなく整数の問題(近似GCD問題)に基づくFHE(DGHV方式)も提案されています。
逆に、格子暗号であってもFHEではないものは数多くあります。たとえば第8章で触れる耐量子計算機暗号の標準 ML-KEM は格子暗号ですが、暗号文のまま計算する機能は持っていません。
また、本章で見たPaillier暗号や教科書どおりのRSA暗号のように、足し算または掛け算の一方だけができる部分準同型暗号は、格子ではなく整数の問題に安全性の根拠を置いています。5-5の冒頭で「準同型暗号の多くは」格子に基づくと書いているのは、こうした例外があるためです。
ただし、正直に言うと、格子に基づくFHEの準同型は「完璧な準同型」ではありません。
5-4・5-5で見るように、暗号文にはわざと誤差(ノイズ)が混ぜられており、演算のたびにその誤差が育っていきます。
正確には「ノイズが許容範囲に収まっている限りにおいて成り立つ準同型」であり、だからこそノイズの管理がFHEの設計の中心課題 になります。

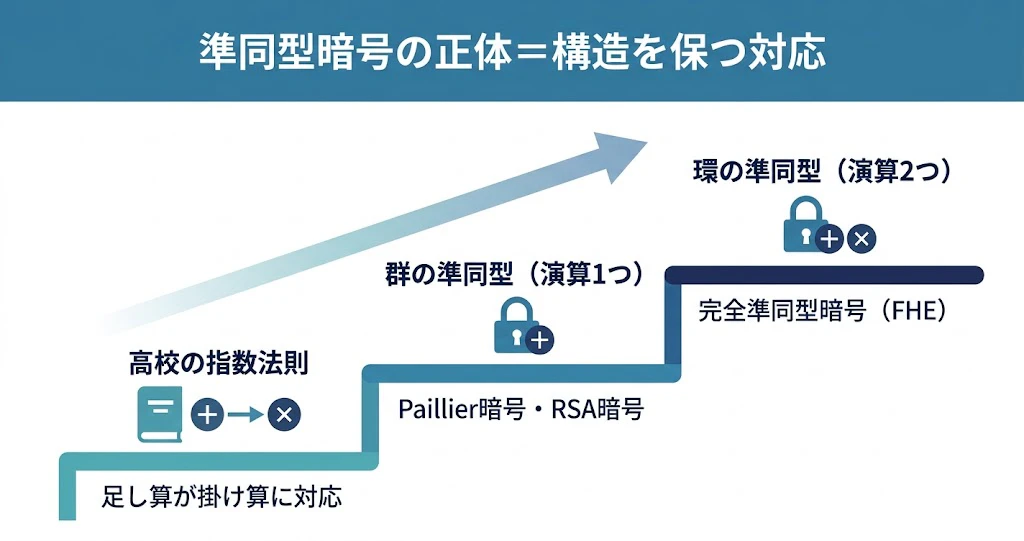
まとめると、準同型暗号 とは、群論・環論でいう「演算の構造を保つ対応(準同型写像)」を、暗号化という対応そのものに仕込んだ暗号だ と言えます。
- 加法だけ・乗法だけなら 群の準同型
- 両方なら 環の準同型
高校の指数法則で見た「足し算が掛け算に対応する」という現象の、はるかに精巧な版が、暗号の中で動いているのです。
5-3. 3つの世代と方式
準同型暗号にはいくつかの方式があり、用途によって使い分けます。
代表的な3つの方式を、概要に絞って紹介します。
| 方式 | 得意なこと | 主な用途のイメージ |
|---|---|---|
| BFV / BGV | 整数の加算・乗算 | 暗号化したままの集計・カウント |
| CKKS | 小数(実数・複素数)の近似計算 | 暗号化したままの機械学習・統計 |
| TFHE | 論理演算と高速なブートストラップ | 暗号化したままの比較・分岐・任意の関数 |
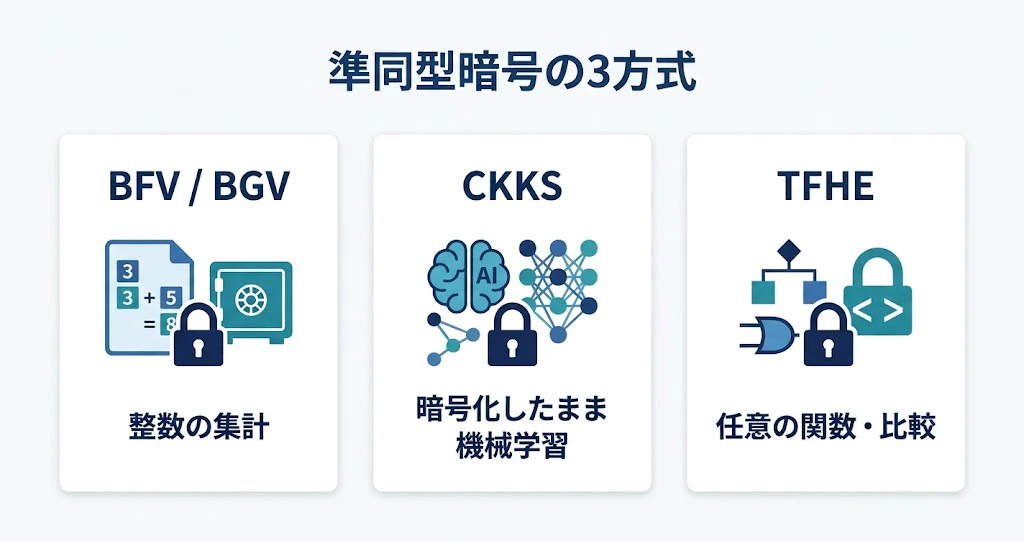
特に、CKKSは小数を近似的に扱えるため、機械学習で必要になる実数の計算と相性がよく、準同型暗号の上で深層学習を行いやすいことから、機械学習の用途で注目されています。
TFHEは、トーラス(円周のように、端まで進むと反対側の端に戻ってくる数の世界)という数学的構造を利用した方式で、ブートストラップを高速に行えることで、実用的な性能を達成 しました。
ブートストラップ とは、暗号文に溜まった誤差(ノイズ)を、暗号化したまま取り除いてリセットする処理のこと です。
準同型暗号では、安全性のために暗号文にわざと小さな誤差を混ぜており、計算を重ねるたびにその誤差が大きくなって、いずれは正しく復号できなくなります。
そこで、途中でブートストラップを挟んで誤差を小さく戻せば、計算を何度でも続けられるようになります。
ただし、この処理は従来きわめて重く、準同型暗号の実用化を阻む最大の壁でした(ノイズとブートストラップについては、5-4で詳しく見ます)。

TFHEの活用例には、暗号化された画像の分類や、医療データの秘匿分析 があります。
5-4. なぜ難しいのか ── 「ノイズ」という宿敵
準同型暗号は魔法のようですが、大きな技術的課題があります。
5-3でも少し触れた、ノイズ です。
多くの準同型暗号は、安全性を確保するために、暗号文にわざと小さなノイズ(誤差)を混ぜています。
このノイズは暗号文に対して計算が行われるたびに増加し、特に乗算で顕著に増えます。ノイズが大きくなりすぎると、平文を正しく復号できなくなってしまいます。
つまり、こういうことです。
暗号文のまま計算を重ねるほどノイズが溜まり、いつか限界を超えて答えが壊れます。
この問題を解決するのが、溜まったノイズをリセットするブートストラップという処理です。
ただしこの処理は計算コストが非常に高く、準同型暗号を実用化する上で最大のボトルネックでした。
近年、TFHEなどでこのブートストラップが高速化され、ようやく実用が見えてきた、というのが現在地です。

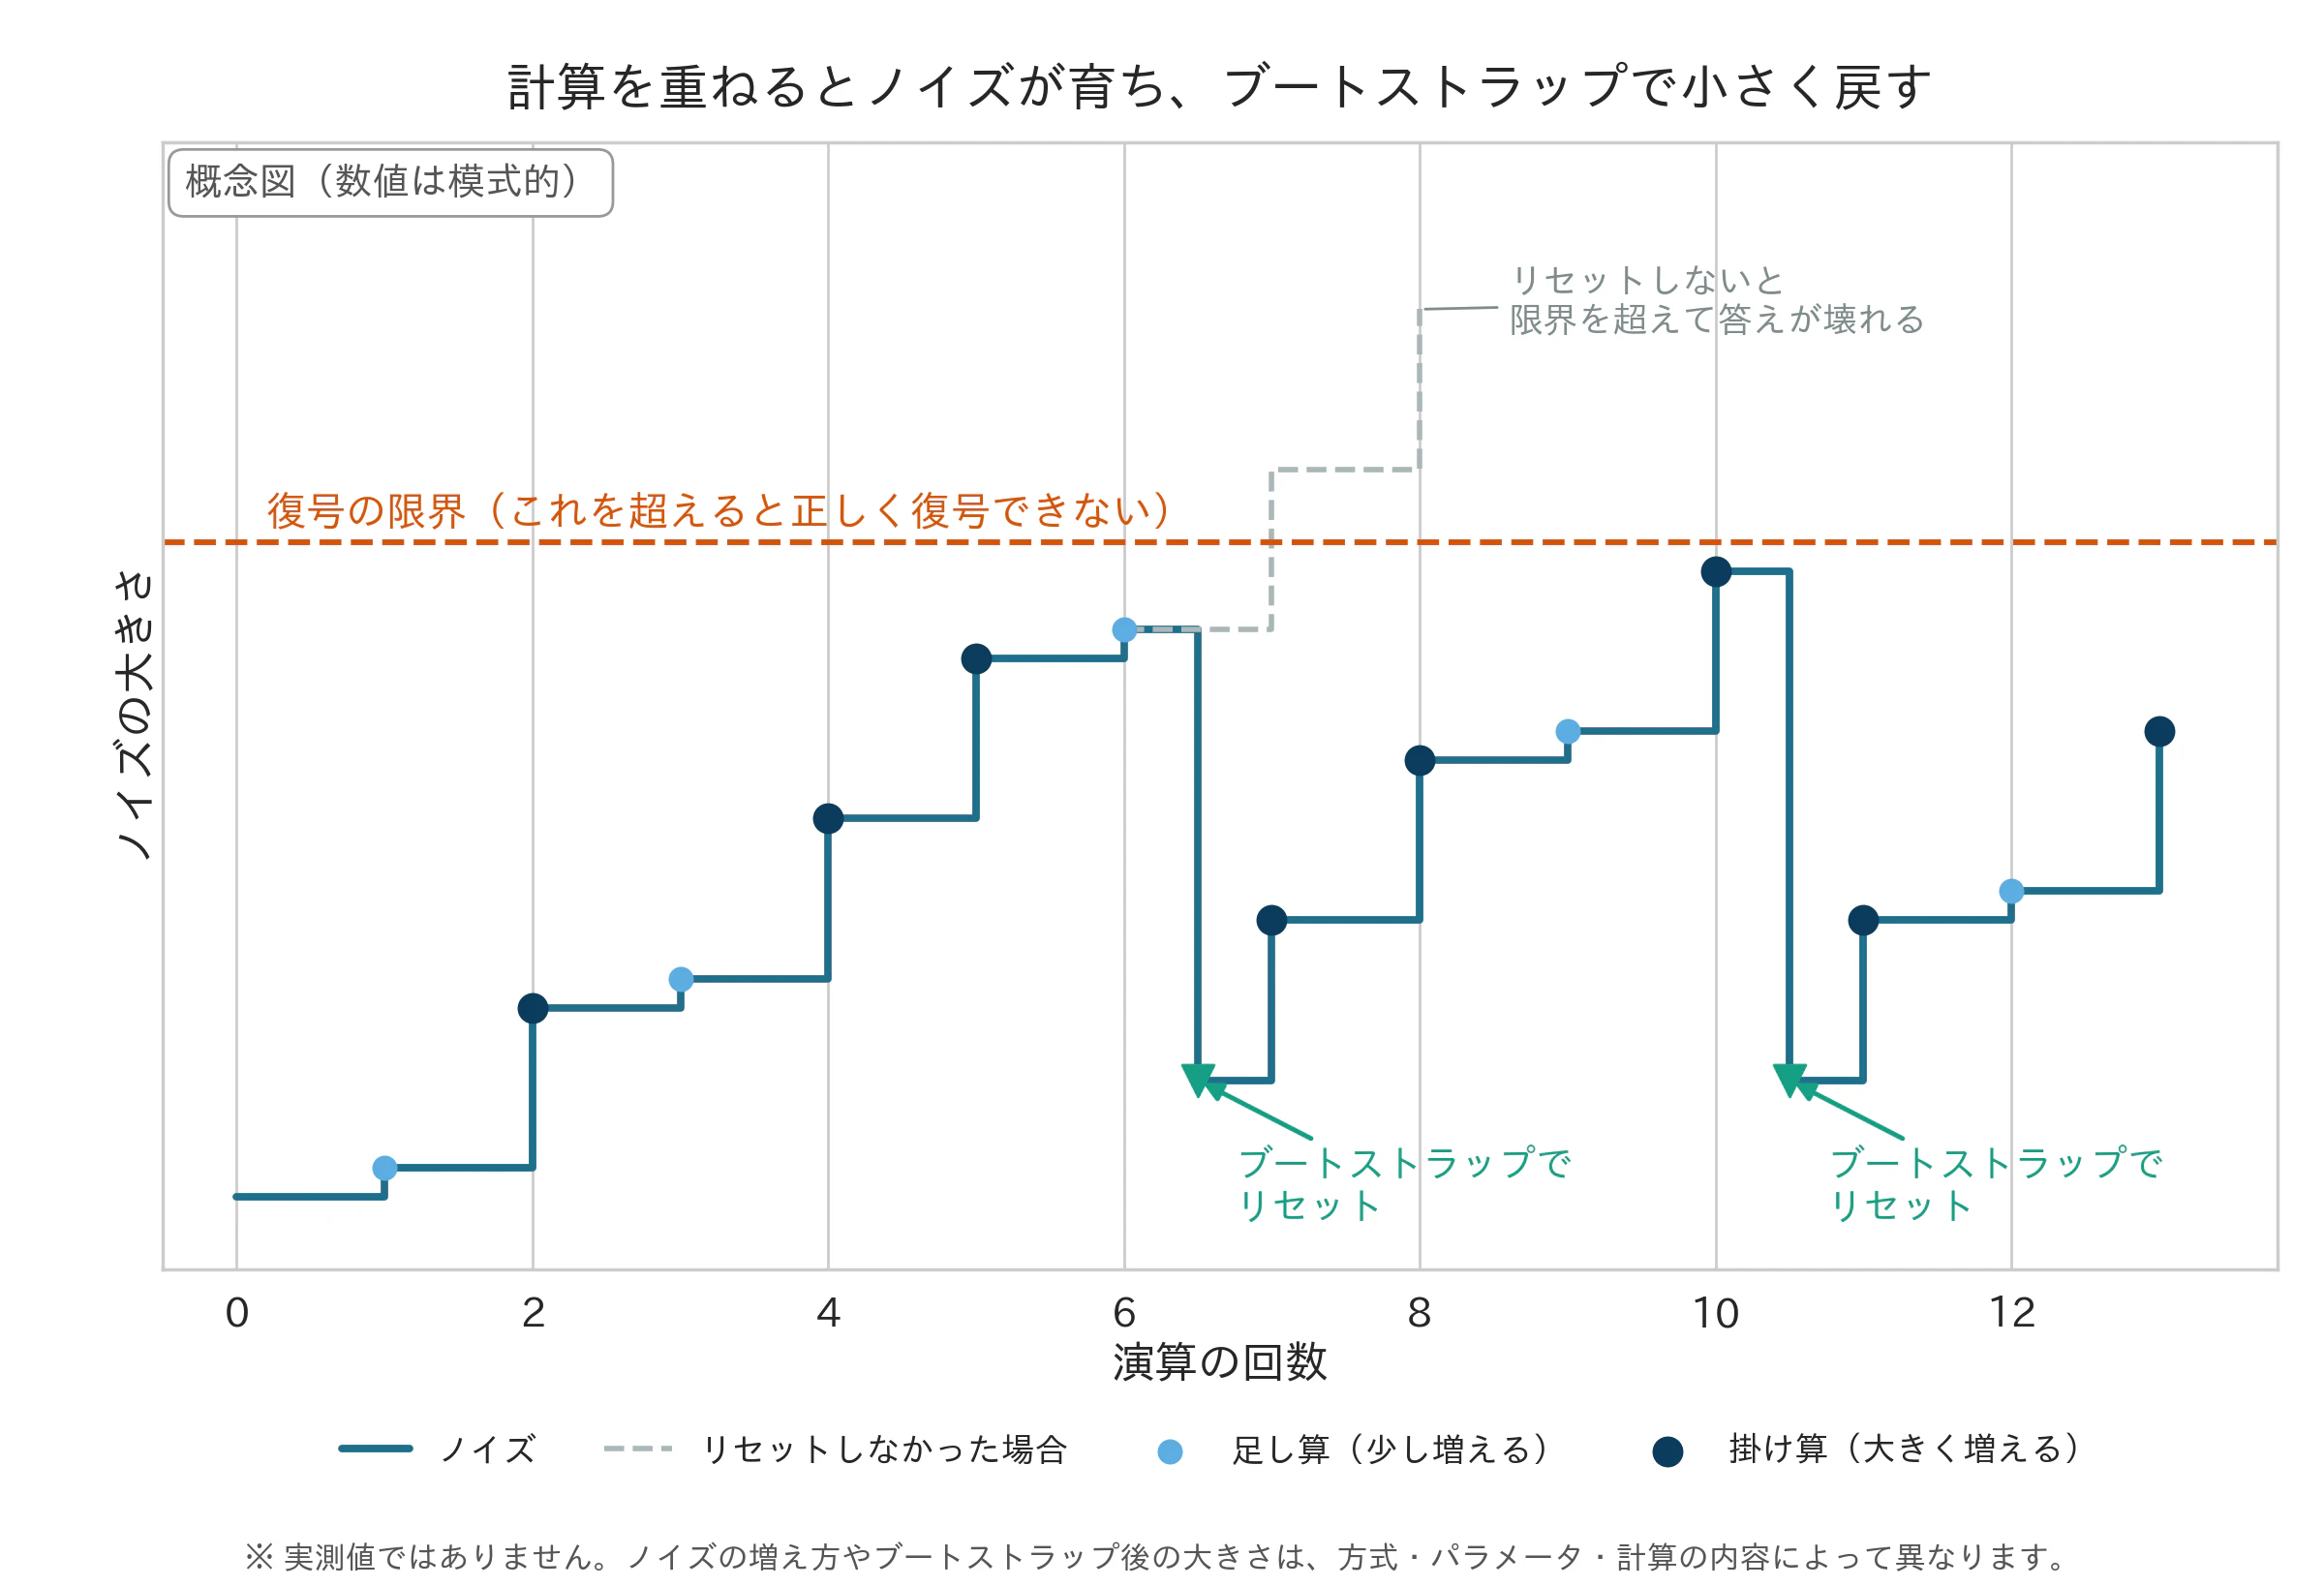
※ この図は、ノイズの増え方としくみを示すための模式図で、特定の方式の実測値ではありません。実際のノイズの増え方は、方式やパラメータ、計算の内容によって異なります。
平文で計算する場合と比べて、どれくらい遅いのか
具体的な計算で比べてみます。
なお、以下の数値は、異なる研究・実装で報告された代表例です。
計算の内容も、使った計算機も、測った年もそれぞれ違うため、数値どうしを横並びのベンチマークとして比べるものではありません。
「平文と比べて、どのくらいの桁で遅いのか」をつかむための目安として読んでください。
1つ目は、いちばん単純な64ビット整数の足し算です。
平文なら、CPUの1命令で1ナノ秒にも満たない時間で終わります。
これを暗号文のまま行うと、2025年に発表された実装でも、高性能GPU(H100)を8枚積んだ計算機で、64ビットの暗号文どうしの足し算に8.7ミリ秒、掛け算に32ミリ秒かかります[15]。
足し算で比べると、平文のおよそ数百万倍以上の時間です。
2つ目は、共通鍵暗号AESで1ブロック(128ビット)を暗号化する計算です。
平文なら最近のCPUで約20ナノ秒ですが、2012年に初めて準同型暗号で計算した研究では約48時間かかり、並列化しても1ブロックあたり約40分でした。これは平文の約1.2×10¹¹倍(約1200億倍)遅い計算にあたります[12][18]。
3つ目は、機械学習の推論です。
画像認識の小型モデルであるResNet-20で、CIFAR-10という小さな画像を1枚分類する計算は、平文ならミリ秒単位で終わります。
これを暗号化したまま行う研究では、2023年の時点でGPUを使って1.4秒まで短縮されましたが、これは先行研究の1,622倍の高速化を経た数字です[16]。
逆算すると、その先行研究(2022年、CPU1スレッド)では1枚あたり約2,300秒(約38分)かかっていたことになります。
こうした計算の内側で何度も繰り返されるのがブートストラップです。
準同型暗号の計算時間の大半は、このノイズのリセットに費やされます。
ResNet-20の推論でも、推論時間の大部分はブートストラップに使われています[16]。
この十数年で、どれくらい速くなったのか
「暗号化したまま計算する」という構想そのものは1978年にまでさかのぼりますが、足し算と掛け算の両方を何度でも行える完全準同型暗号(FHE)が初めて構成されたのは、2009年のGentryの研究です。
当初の方式では、基本的なビット演算1回に約30分かかると報告されており、実用には遠く及びませんでした。
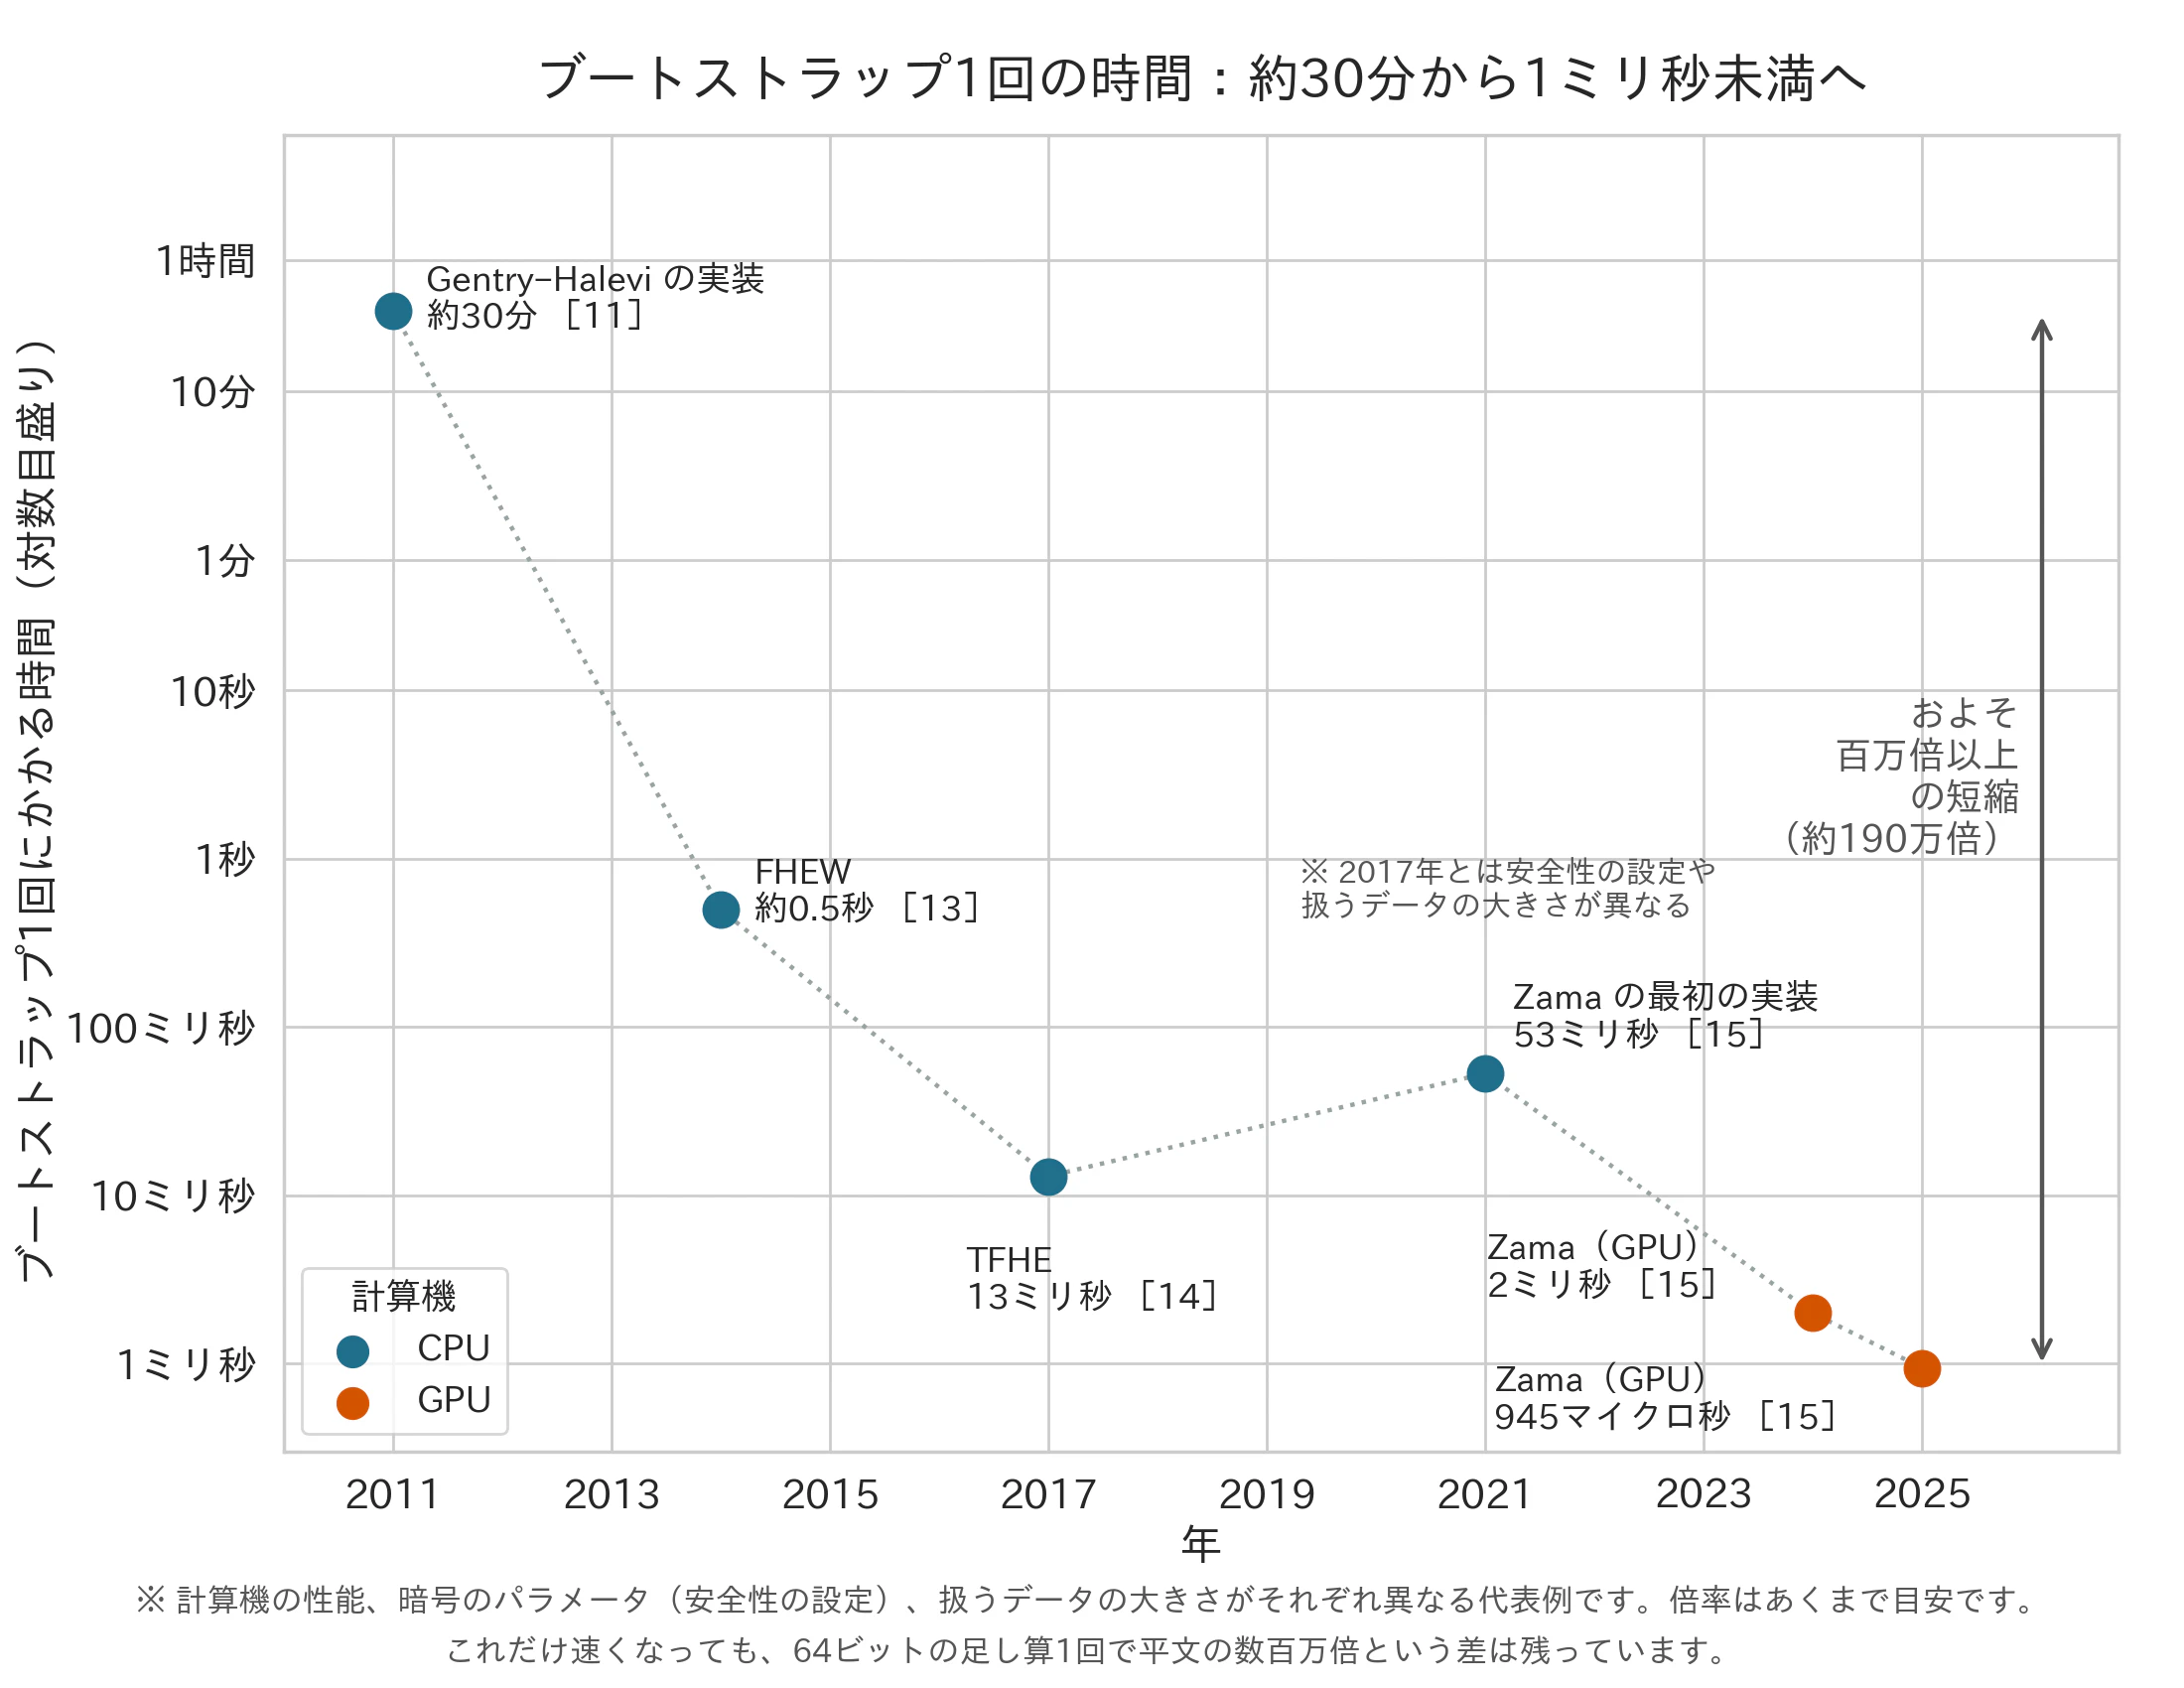
2011年に発表された最初の本格的な実装でも、ブートストラップ1回に、小さい設定で30秒、大きい設定で30分かかりました[11]。
ここから現在までの短縮は、主に次の4つのブレークスルーによるもの です。
1つ目は、ノイズ管理の工夫と並列化(2011〜2012年)です。
BGV方式などで導入された「モジュラス切り替え」という技法により、ブートストラップを挟む回数そのものを減らせるようになりました。
さらに、1つの暗号文の中に多数の値を詰め込み、一度に計算するSIMD(バッチ処理)の工夫が加わりました。
前述のAESの計算は、この並列化により、1回の評価で54ブロックを同時に処理し、1ブロックあたり40分弱になったものです。
その後の改良で、2015年には小型のノートPCでAES1回の評価が約4分、ブートストラップを含む設定でも180ブロックを約18分、1ブロックあたり約6秒にまで短縮されています[12]。
2つ目は、ブートストラップそのものの設計の刷新(2014〜2017年)です。
当時の代表的な実装(HElib)でブートストラップに約6分かかっていたのに対し、2014年に発表されたFHEWは、ビット演算とブートストラップを合わせて、一般的なPCで約0.5秒で実行しました[13]。
これを発展させたのがTFHEで、ブートストラップの時間を690ミリ秒から13ミリ秒(CPU1コア)へ短縮し、必要な鍵のサイズも1GBから16MBへと小さくしました[14]。
この節の冒頭で「TFHEなどでブートストラップが高速化され」と述べたのは、この流れのことです。
その延長線上で、2023年にはTFHEを使い、AESの評価を一般的なノートPCで30秒未満で行えることも示されています[17]。
また同じ時期の2016〜2017年には、小数を近似的に扱えるCKKS方式が登場し、機械学習への応用が現実的になりました。
3つ目は、GPUによる高速化(2020年代)です。
Zama社の最初の実装(2021年、CPU)ではブートストラップ1回に53ミリ秒かかっていましたが、2025年にはGPUで945マイクロ秒と、1ミリ秒を切りました。
同じ期間に、64ビット暗号文の足し算は2秒から8.7ミリ秒へ(230倍)、掛け算は13秒から32ミリ秒へ(406倍)と短縮されています[15]。
CKKS方式でも、前述のResNet-20の推論が、GPUライブラリによってCPU(64スレッド)実装の21倍高速化されました[16]。
4つ目は、準同型暗号専用のハードウェアです。
まだ研究段階ですが、専用ハードウェアの設計案でシミュレーションすると、ResNet-20の推論は30ミリ秒まで縮まり、当初のCPU1スレッドの実装より75,700倍高速になると見積もられています[16]。
ブートストラップ1回の時間だけで比べると、2011年の約30分から2025年の1ミリ秒未満まで、およそ百万倍以上の短縮です。
ただし、計算機の性能や暗号のパラメータ、扱うデータの大きさがそれぞれ異なるため、この倍率はあくまで目安です。
また、これだけ速くなっても、64ビットの足し算1回で平文の数百万倍という差は残っています。
第9章で見るように、実用化されている事例が「検索・照合のような、限られた種類の計算」に絞られているのは、このため です。
5-5. 数学的な設計図(その2)── 格子暗号とLWE、なぜ「誤差」が暗号になるのか
準同型暗号の多くは、格子(lattice)と呼ばれる数学的構造に安全性の根拠を置いています。
ここも、高校数学だけを前提に、格子暗号のしくみの核心まで踏み込みます。
鍵になるのは、高校で習う「ベクトル」と「連立一次方程式」です。
【ステップ1:格子とは「格子点」のこと】
格子とは、高校で見た「方眼紙の交点(格子点)」を一般化したものです。
平面上で、2つの基本ベクトルを整数倍して足し合わせてできる点を、すべて集めたものを格子と呼びます。
たとえば基本ベクトル (1,0) と (0,1) なら、格子点は (3,2) や (-1,5) のような、座標がすべて整数の点の集まりになります。これは方眼紙の交点そのものです。
基本ベクトルを (2,1) と (1,3) のように斜めにとると、格子点は斜めの網目状に並びます。
重要なのは、同じ格子(同じ網目)でも、それを生成する基本ベクトルの選び方は何通りもある、という点です。
「きれいで短い基本ベクトルの組」もあれば、「ゆがんで長い基本ベクトルの組」もあり、どちらも同じ網目を張ることができます。
この自由度が、後で重要な意味を持ちます。

※ 上の図の基本ベクトルは $\vec{b}_1 = (2, 1)$、$\vec{b}_2 = (-1, 2)$ で、2本は互いに直交しています。
下の図の基本ベクトルは、これを整数倍して足し合わせた $\vec{c}_1 = 2\vec{b}_1 + \vec{b}_2 = (3, 4)$、$\vec{c}_2 = 3\vec{b}_1 + 2\vec{b}_2 = (4, 7)$ です。この組み替えの係数は、$\vec{c}_1$ の式から $2$ と $1$、$\vec{c}_2$ の式から $3$ と $2$ の4つです。これを2行2列に並べた表(行列)を考えると、その「行列式」が重要な役割を果たします。2行2列の行列で、1行目が $a,\ b$、2行目が $c,\ d$ のとき、行列式は次の1つの数です。
$$ad - bc$$
行列式は、図形的には「2本のベクトルが作る平行四辺形の面積が、組み替えによって何倍になるか」を表します。
今回の係数では、行列式は $2 \times 2 - 1 \times 3 = 1$ です。係数がすべて整数で、行列式が $1$(または $-1$)のとき、逆向きの組み替えも整数の係数で書けます。実際、$\vec{b}_1 = 2\vec{c}_1 - \vec{c}_2$、$\vec{b}_2 = -3\vec{c}_1 + 2\vec{c}_2$ と書けるので、2組の基本ベクトルはまったく同じ格子点の集まりを張ります。これが「2つの基底が同じ格子を張る」ための条件です。
薄く塗った平行四辺形は、2本の基本ベクトルが作る「基本領域」です。
その面積も、2本のベクトルの成分を並べた行列式で計算でき、上の図では $2 \times 2 - 1 \times (-1) = 5$、下の図では $3 \times 7 - 4 \times 4 = 5$ と、どちらも同じ値になります。組み替えの行列式が $1$ なので、面積は $1$ 倍、つまり変わらないというわけです。
なお、本文で斜めの基底の例として挙げた $(2, 1)$ と $(1, 3)$ も、$(1, 3) = (2, 1) + (-1, 2)$ なので、この図と同じ格子を張っています。
【ステップ2:格子の難しい問題 ── 最近ベクトル問題】
格子には、コンピュータでも解くのが極端に難しい問題があります。
代表的な問題が「最近ベクトル問題(CVP)」です。
これは、空間のどこかにポツンと置かれた1つの点に対して、格子点(網目の交点)のうち最も近いものを見つけよ、という問題です。
2次元の方眼紙でなら、目で見て一瞬で分かります。
しかし、これが数百〜数千次元になると、事情が一変します。
高次元では、網目が想像を絶するほど複雑に入り組み、「最も近い格子点」を、現実的な時間で見つける方法が知られていないほど難しくなります。
しかも、手元にある基本ベクトルが「ゆがんで長い組」だと、なおさら絶望的になります。
逆に「短くてきれいな組(=秘密鍵)」を知っていれば解ける ── この非対称性が、格子暗号の安全性の源です。

※ 格子は、前の図と同じ格子を使っています。
2次元では、目標点の周りにある候補の格子点は数個しかないので、すべての距離を比べればすぐに答えが出ます。ところが次元が上がると、調べなければならない候補の数が次元とともに爆発的に増えていきます。
数百〜数千次元では、すべてを調べ尽くすことも、うまく絞り込むことも、現実的な時間で行う方法は知られていません。
基本ベクトルの「きれいさ」が解きやすさを左右することも、この図で確かめられます。
目標点 $(3.6, 3.3)$ を、基本ベクトルの組み合わせ「$x$ 倍と $y$ 倍の和」として表し、$x$ と $y$ をそれぞれ最も近い整数に丸めて格子点を求める、という素朴な方法を試してみます。
前の図の「きれいな基底」$\vec{b}_1 = (2, 1)$、$\vec{b}_2 = (-1, 2)$ で表すと、目標点は $2.1\vec{b}_1 + 0.6\vec{b}_2$ です。丸めると $2\vec{b}_1 + 1\vec{b}_2 = (3, 4)$ となり、正しく最も近い格子点にたどり着きます。
一方、「ゆがんだ基底」$\vec{c}_1 = (3, 4)$、$\vec{c}_2 = (4, 7)$ で表すと、目標点は $2.4\vec{c}_1 - 0.9\vec{c}_2$ です。丸めると $2\vec{c}_1 - 1\vec{c}_2 = (2, 1)$ となり、目標点から約 $2.8$ も離れた、まったく別の格子点に着いてしまいます。
同じ格子、同じ方法でも、手元の基本ベクトルがきれいなら正解に、ゆがんでいれば見当違いの点に着く。この差が、格子暗号の「秘密鍵(きれいな基底)を知っている人だけが解ける」という非対称性の正体です。
【ステップ3:LWE ── 「わざと誤差を混ぜた連立一次方程式」】
格子に基づく暗号で、いま最も広く安全性の土台として使われているのが「LWE問題(Learning With Errors、誤差付き学習)」 です。
暗号の安全性は、「解くのが極端に難しい問題」の上に成り立っています。
格子暗号の多くは、このLWE問題の難しさを、その拠りどころにしています。
LWE問題は、高校で習う連立一次方程式を土台にした、驚くほど素直なアイデアでできています。
高校で、こういう連立一次方程式を解いたはずです。
3x + 1y = 14
1x + 2y = 13

→ きれいに解けて x=3, y=5
式が変数の数だけ揃っていれば(式どうしが独立していれば)、連立一次方程式は必ず解けます。
これは高校数学の基本です。
ところが、LWEはここに一工夫を加えます。
各式の右辺に、わざと小さなランダムな誤差を足すのです。
3x + 1y = 14 + (誤差+1) = 15
1x + 2y = 13 + (誤差−1) = 12
  …これを何百本も、誤差をバラバラに混ぜて並べる
秘密の答え(x, y, …)は決まっているのに、各式に小さなノイズが乗っているため、ふつうに連立方程式を解こうとすると、誤差に振り回されて正しい答えにたどり着けません。
式を何百本・何千本と集めても、「どの式にどれだけ誤差が乗っているか」が分からないため、秘密の答えを復元するのが、コンピュータでも極端に難しくなります。
もう一つ大事なのは、実際のLWEでは、計算をすべて「ある数 $q$ で割った余りの世界」で行うことです。
ふつうの数の世界なら、誤差入りの式をたくさん集めて平均をとるような方法(最小二乗法など)で、誤差の影響を薄めて答えに近づけてしまえます。
ところが余りの世界では、数が $q$ で一周して元に戻るため、こうした「大きい・小さい」を手がかりにする方法が使えません。誤差と余りの世界がそろって、初めて解読が困難になるのです。
これが LWE問題 です。

ポイントは、誤差を混ぜるだけで、素直な連立一次方程式が、解読困難な暗号の土台に化けるということ です。
では、この難しさをどうやって暗号に使うのでしょうか。
登場人物は、メッセージを受け取る人と、送る人の2人です。
まず、受け取る人が鍵を作ります。
受け取る人は、最初に答え(上の例なら $x = 3,\ y = 5$)を自分で決めてしまいます。
これが 秘密鍵 で、誰にも渡さず、手元に置いておきます。
次に、適当な係数を選んで左辺を作り($3x + 1y$、$1x + 2y$ など)、自分の決めた答えで右辺を計算してから、小さな誤差を足します($14 + 1 = 15$、$13 - 1 = 12$)。
こうしてできた誤差入りの式の集まり($3x + 1y = 15$、$1x + 2y = 12$)が 公開鍵 で、これを誰にでも配ります。
つまり秘密鍵は、方程式を解いて得るものでも、誰かから送られてくるものでもありません。
受け取る人が最初に決めた答えそのものであり、 式のほうがその答えから作られている のです。
式は公開されていても、誤差のせいで、そこから答え(秘密鍵)を割り出すことはできません。
次に、送る人がメッセージを暗号化します。
送る人は、公開された式をいくつか選んで足し合わせ、その右辺にメッセージを埋め込みます。
ここでは「0か1か」の1ビットを送るとして、1を送るときは右辺に大きな数(たとえば $50$)を足し、0を送るときは何も足さないことにします。
たとえば1つ目の式を選んで1を送るなら、暗号文は「$3x + 1y = 65$」($15 + 50$)です。送る人が使うのは公開鍵だけで、秘密鍵は一切知りません。
最後に、受け取る人が暗号文を復号します。
秘密鍵 $x = 3,\ y = 5$ を持っている受け取る人は、左辺を実際に計算できます。
$3 \times 3 + 1 \times 5 = 14$ です。
右辺の $65$ からこれを引くと $51$ が残ります。
この残りは「メッセージの分($50$)+小さな誤差($1$)」なので、$0$ より $50$ のほうにずっと近いと分かり、送られたのは1だと読み取れます。
0が送られていれば、残りは誤差の $1$ だけで、$0$ に近くなります。
誤差は小さく作ってあるので、「$0$ に近いか、$50$ に近いか」で丸めれば、誤差を消してメッセージだけを正しく取り出せるのです。
秘密鍵を持たない人(途中で暗号文を盗み見た人など)には、左辺の値($14$)が分かりません。
そのため、右辺の $65$ のうち、どこまでが式本来の値で、どこからがメッセージや誤差なのかを切り分けられません。
秘密鍵を知っている人だけが「式本来の値」を正確に引き算でき、残った「メッセージ+小さな誤差」から誤差を丸めて取り除ける。
ここでも「知っていれば簡単、知らなければ絶望的」という非対称性がはたらいています。
(上の例は、しくみを見せるために極端に小さくしたものです。実際の暗号の規模については、次の発展コラムで補足します。)
【発展コラム】この暗号のしくみはどこから来たのか、そして2つの「秘密鍵」の関係
この方式の出自
本文で紹介した「受け取る人が答えを決め、誤差入りの式を公開鍵として配る」暗号は、2005年にRegevが提案したLWE問題に基づく公開鍵暗号のしくみを高校数学の範囲に縮めたものです。
Regevは同じ論文で、LWE問題を解くことは格子の難しい問題を解くのと同じくらい難しい、ということも示しました。
この方式は、その後の格子暗号の出発点となり、2024年に標準化された耐量子計算機暗号 ML-KEM(第8章)も、この流れを汲んでいます。
本文の例は、なぜ「小さすぎる」のか
本文の例は、式が2本、答えが $x = 3,\ y = 5$ の2つだけです。
これほど小さければ、秘密鍵を知らなくても、$x$ と $y$ に小さな整数を順に当てはめて試すだけで、答えはすぐに見つかってしまいます。
実際の暗号では、答え(秘密鍵)は数百個の数の組で、式も数百本以上使います。
さらに、本文で触れたとおり、計算はすべて「ある数で割った余りの世界」で行うため、「大きい・小さい」を手がかりに答えを絞り込むこともできません。
こうした条件がそろって初めて、誤差の入った式から答えを割り出すことが、現実的な時間では不可能になります。本文の例は、あくまでしくみを見せるための模型だと考えてください。
2つの「秘密鍵」の関係
5-5のステップ2では、格子の話として「短くてきれいな基本ベクトルの組(=秘密鍵)」を知っていれば、最も近い格子点を探す問題が解ける、と述べました。
一方、本文のLWE暗号では、「方程式の答え」が秘密鍵でした。
秘密鍵が2種類出てきたように見えますが、これは格子暗号の中に、秘密鍵の持ち方が異なる流儀が複数あるためです。
前者は「きれいな基底」を秘密鍵にする流儀、後者は「方程式の答え」を秘密鍵にする流儀です。
それでも、両者は同じ一つの問題でつながっています。
LWEの公開鍵の右辺(誤差を足した値)は、格子の目で見ると、「格子点から少しだけずれた点」になっています。
誤差を足す前の値が格子点で、誤差の分だけそこからずれている、というわけです。ですから、公開鍵から答えを割り出すことは、「そのずれた点に最も近い格子点を探す」こと、つまりステップ2で見た最近ベクトル問題の仲間を解くことにあたります。
まとめると、「きれいな基底」も「方程式の答え」も、最も近い格子点を探す問題を、その持ち主にとってだけ簡単にする情報だという点で共通しています。
本文では、読者が混乱しないよう、LWEの文脈では「方程式の答え=秘密鍵」に絞って説明しました。
【発展コラム】グレブナー基底を使えば、LWEの連立方程式は解けるのか?
「グレブナー基底という数学の道具を使うと、連立方程式を計算機で高速に解ける」という話を耳にしたことがある方もいるかもしれません。
では、この道具で、連立一次方程式に誤差を混ぜたLWEの暗号を解読できるのでしょうか。
結論から言うと、「LWEを連立一次方程式として解く」用途には使えません。
しかし、「誤差を含んだ一次方程式を、誤差が入らない代わりに2乗や3乗の項を含む方程式(非線形の方程式)に作り変えてから解く」という別の形で、グレブナー基底を使う攻撃は実際に研究されています。
ただし、実用の暗号のパラメータに対しては、現実的な脅威にはなっていません。順に見ていきましょう。
グレブナー基底は、そもそも何のための道具か
グレブナー基底は、連立「一次」方程式ではなく、$x^2$ や $xy$ のような2次以上の項を含む連立「多項式」方程式を、計算機で扱うための道具です。
連立一次方程式に対してグレブナー基底を計算すると、その手順は、高校や大学1年で習う掃き出し法(ガウスの消去法)とまったく同じものになります。
つまり、一次方程式に限れば、グレブナー基底は掃き出し法以上の力を持ちません。
なぜ、掃き出し法ではLWEが解けないのか
LWEを掃き出し法で解こうとすると失敗します。
掃き出し法では、式どうしを何倍かして足し引きすることで、変数を1つずつ消していきます。
ところがLWEでは、式を何倍かして足し引きするたびに、各式に乗っていた誤差も一緒に何倍かされ、足し引きされて大きくなっていきます。最後には、膨れ上がった誤差が答えを覆い隠してしまうのです。
LWEの難しさは「方程式が一次かどうか」ではなく「誤差がある」ことにあります。ですから、一次方程式を速く解く道具をそのまま当てても、歯が立ちません。
それでも、グレブナー基底を使う攻撃は存在する
そこで発想を変えて、「誤差を消すかわりに、方程式を非線形にする」という攻撃があります。2011年にAroraとGeが提案した方法です。
たとえば、誤差が $-1,\ 0,\ +1$ のどれかだと分かっているとします。
本文の例の1本目の式 $3x + 1y = 15$ なら、$3x + y - 15$ の値は誤差そのものなので、$-1,\ 0,\ +1$ のどれかです。すると、次の式が誤差なしで、ぴったり成り立ちます。
$$(3x + y - 15 + 1)(3x + y - 15)(3x + y - 15 - 1) = 0$$
3つの因数のどれか1つが必ず $0$ になるので、掛け合わせた全体も $0$ になる、というわけです。こうして誤差は消えましたが、そのかわり方程式は3次になりました。
このような「誤差のない多項式方程式」をたくさん集めれば、問題は連立多項式方程式を解くことに置き換わります。
ここで、グレブナー基底の出番になります。
実際、2014年頃にAlbrechtらが、この攻撃にグレブナー基底の計算を組み合わせて改良する研究を発表しています。
なぜ、実用の暗号は破られないのか
この攻撃が成功するには、2つの条件がそろう必要があります。
1つ目は、誤差が取りうる値の範囲がごく狭いことです。
上の例では誤差が3通りだったので3つの因数を掛けましたが、誤差の範囲が広がるほど掛け合わせる因数が増え、方程式の次数が上がります。次数が上がると、グレブナー基底の計算量は急激に増えていきます。
2つ目は、式(公開鍵や暗号文から得られるサンプル)が非常にたくさん手に入ることです。次数の高い多項式方程式を解くには、それに見合う膨大な本数の式が必要になります。
実用の格子暗号は、この2つの条件が同時に満たされないように、パラメータを選んでいます。
たとえば、第8章で触れる ML-KEM では、誤差の範囲は狭めに設定されていますが、攻撃者が手にできる式の本数が限られています。
そのため、この代数的な攻撃の計算量は、格子の問題を直接解く既知の攻撃よりも、はるかに大きくなります。
現在、格子暗号の安全性を見積もるときの主役は、グレブナー基底ではありません。
「格子基底簡約」と呼ばれる、ゆがんだ基本ベクトルを少しずつ短くきれいな組に近づけていく攻撃です。
5-5で見た「きれいな基底を知っていれば、最も近い格子点が見つけやすい」という性質を、攻撃者の側から利用しようとする方法だと言えます。
理論的には使えるのか
理論的には「使える」と言えます。
誤差の範囲がとても狭く、式が十分にたくさん手に入るような、わざと弱く設計したLWEに対しては、この代数的な攻撃が有効にはたらくことが分かっています。
逆に言えば、暗号の設計者は、こうした代数的な攻撃も想定に入れたうえで、誤差の大きさや、攻撃者に渡るサンプル数の上限を決めているわけです。
暗号の安全性は、「知られているあらゆる攻撃法の、どれに対しても十分な計算量を要求する」ようにパラメータを選ぶことで保たれています。
グレブナー基底が主役になる暗号もある
最後に、グレブナー基底が暗号解読で主役になる分野も紹介しておきます。
連立多項式方程式を解くことの難しさに安全性を置く「多変数多項式暗号」です。
この分野では、グレブナー基底の計算こそが最大の攻撃手段になります。
2003年には、FaugèreとJouxがグレブナー基底の高速な計算法を使って、HFEという多変数多項式暗号の挑戦問題を解いたことがよく知られています。
同じ「連立方程式」を土台にしていても、格子暗号は「一次方程式+誤差」、多変数多項式暗号は「誤差のない多項式方程式」と、難しさの源が違います。
その違いが、効果のある攻撃手段の違いになって表れているのです。
【ステップ4:これが準同型暗号とどうつながるか ── 5-4のノイズの正体】
ここで、5-4で見た「ノイズ」の話と一本につながります。
ステップ3で見たように、LWEの暗号文は「秘密鍵で計算できる式本来の値+メッセージ+小さな誤差」という形をしています。
準同型暗号では、この暗号文どうしを足したり掛けたりすると、メッセージ(平文)が足し算・掛け算されると同時に、混ざっていた誤差も一緒に足し合わさって育っていく のです。
だからこそ、計算を重ねるほど誤差(ノイズ)が増え、ある限界を超えると、もはや正しい答えと誤差を区別できなくなって復号に失敗する。
5-4で「乗算でノイズが特に増える」と述べたのは、掛け算では誤差どうしも掛け合わさって、より急速に育つからです。
そして、溜まった誤差をリセットするブートストラップが必要になる
── 5-4の現象は、すべてこのLWEのしくみから自然に出てくる帰結だったのです。
【ステップ5:なぜ量子コンピュータにも強いのか】
第4章の 楕円曲線やRSAは、「素因数分解」や「離散対数」という特定の計算の難しさに頼っていました。
実は、これらは量子コンピュータのショアのアルゴリズムで効率的に解けてしまうことが知られています。
だから量子時代には危ういのです。
一方、格子の最近ベクトル問題やLWEは、いまのところ量子コンピュータでも効率的に解く方法が見つかっていません。
だから、格子に基づく暗号は耐量子計算機暗号(PQC)の有力候補であり、同時に準同型暗号の土台でもある。
「計算できる暗号」と「量子に強い暗号」が、格子という同じ土台の上で同居しているのは、こうした理由から です。

5-6. 実装イメージ ── 暗号文のまま平均を計算する
Microsoft SEALのPythonラッパーである TenSEAL を使うと、CKKS方式 で「暗号化したまま計算する」体験ができます。
下の例は、依頼主(病院)が数値を暗号化してサーバに渡し、サーバが秘密鍵を持たないまま暗号文のまま平均を計算し、依頼主が最後に復号して初めて結果を見る、という流れです。
実行条件:Python 3、
pip install tenseal用途:準同型暗号の体験用(パラメータは学習用の設定)
# pip install tenseal
import tenseal as ts

# ===== 依頼主(病院)側:鍵を作り、データを暗号化する =====
context = ts.context(ts.SCHEME_TYPE.CKKS, poly_modulus_degree=8192,
                     coeff_mod_bit_sizes=[60, 40, 40, 60])
context.global_scale = 2**40
context.generate_galois_keys()           # 暗号文のまま合計(sum)するのに必要な鍵

plain = [120.0, 135.0, 128.0]            # 例:3人の検査値
enc = ts.ckks_vector(context, plain)     # 暗号化(中身は読めない)

# サーバに送るのは「秘密鍵を抜いた公開用コンテキスト」と「暗号文」だけ
public_ctx_bytes = context.serialize(save_secret_key=False)
enc_bytes = enc.serialize()

# ===== サーバ(クラウド)側:秘密鍵を持たないまま計算する =====
def server_compute_mean(public_ctx_bytes, enc_bytes, n):
    server_ctx = ts.context_from(public_ctx_bytes)
    assert not server_ctx.has_secret_key()   # サーバは秘密鍵を持っていない
    enc_vec = ts.ckks_vector_from(server_ctx, enc_bytes)
    enc_mean = enc_vec.sum() * (1.0 / n)     # ★暗号文のまま合計→平均★
    return enc_mean.serialize()              # 結果も暗号文のまま返す

result_bytes = server_compute_mean(public_ctx_bytes, enc_bytes, len(plain))

# ===== 依頼主側:秘密鍵で結果だけを復号する =====
enc_result = ts.ckks_vector_from(context, result_bytes)
print("平均(復号後):", enc_result.decrypt()[0])  # ≒ 127.67(CKKSは近似計算なので微小な誤差が出る)
このコードのポイントは、サーバ側の関数 server_compute_mean に渡しているのが、秘密鍵を抜いた公開用コンテキスト(save_secret_key=False でシリアライズしたもの)と暗号文だけだという点です。
サーバは合計と平均を計算できますが、120 も 135 も一度も見ていませんし、自分が計算した結果すら読めません。
鍵を持つ依頼主だけが、最後に復号して答えを受け取ります。
ここでは分かりやすさのために1つのファイルにまとめていますが、実際のシステムでは、serialize() したバイト列をネットワーク越しにサーバへ送ることになります。
5-7. 利用シーン
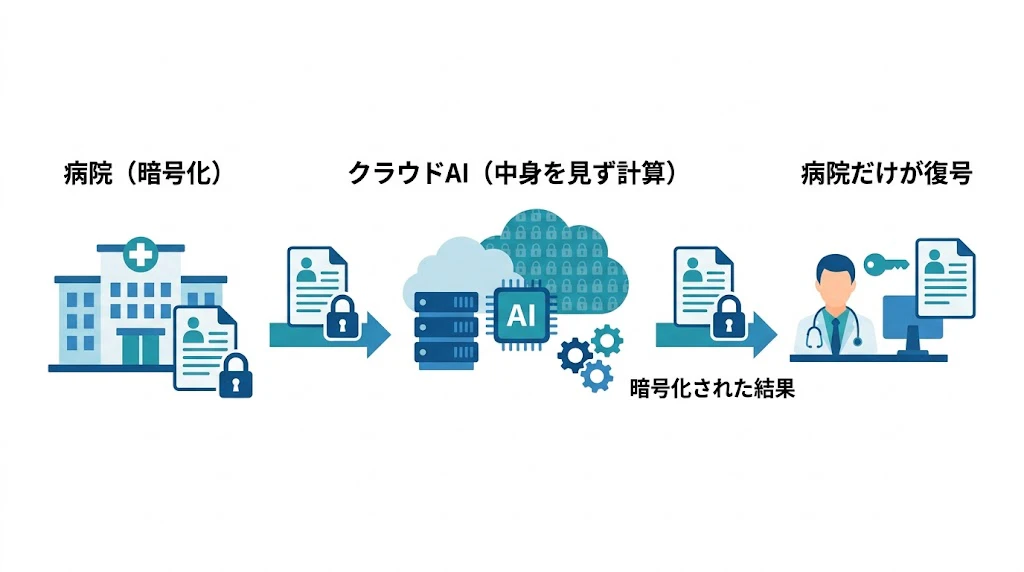
- 医療 ── 病院が患者データを暗号化したままクラウドのAIに送り、暗号化されたまま診断スコアを計算してもらう。クラウド側はカルテの中身を一切見ない。
- 金融 ── 複数の金融機関が、顧客情報を互いに見せずに、暗号化したまま共同で不正検知の計算を行う。
- Webサービス ── ユーザーの行動データを暗号化したまま集計・分析し、分析担当者すら生データに触れない設計にする。
- クラウド計算 ── 機密データの処理をクラウドに外注したいが、クラウド事業者にも中身を見せたくない場面全般。
ただし注意も必要です。
完全準同型暗号は、いまのところ一般向けの技術とは言えず、通常の暗号に比べてデータサイズが何倍も大きくなり、大きなオーバーヘッドを伴います。
「平文なら一瞬の計算が、暗号文だと桁違いに重い」のが現実です。
本当に秘匿が必要な計算に絞って使う、という設計判断 が求められます。

6. ゼロ知識証明(ZKP) ── 「秘密を明かさず、正しさだけ示す」
6-1. ゼロ知識証明とは
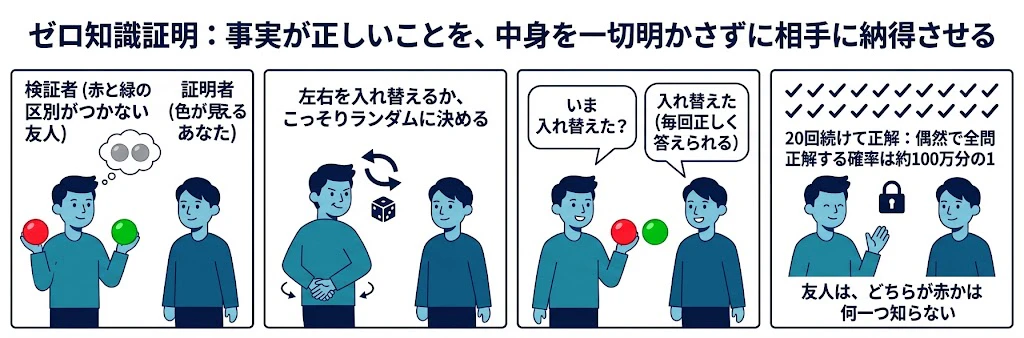
ゼロ知識証明(Zero-Knowledge Proof, ZKP) とは、「ある事実が正しいことを、その事実の中身を一切明かさずに、相手に納得させる」技術 です。
有名なたとえ話があります。
赤と緑の区別がつかない友人に、2つのボールが「違う色である」ことを、どちらが何色かは一切言わずに納得させる、という話です。
友人は2つのボールを両手に1つずつ持ち、あなたに見えないよう背中に回して、左右を入れ替えるか・入れ替えないかを、こっそりランダムに決めます。
そしてボールを再び見せ、あなたに「いま入れ替えた?」と尋ねます。
色が見えるあなたは、赤と緑の位置が変わったかどうかで、毎回正しく答えられます。もし2つが本当は同じ色なら、あなたにも区別がつかないので、当てずっぽうで答えるしかなく、正解率は半分です。
これを20回繰り返して毎回正解すれば、偶然で全問正解する確率は (1/2)^20、つまり約100万分の1しかありません。
友人は「2つは本当に違う色だ」と納得します。
それでいて友人は、どちらが赤でどちらが緑かという中身については、何一つ知ることはありません。
このとき、ランダムな問題を出して確かめる側(友人)を検証者、秘密の知識を持って答える側(あなた)を証明者と呼びます。
「検証者がランダムな問題を出し、本当に知っている証明者だけが毎回正しく答えられる。でも答えから秘密そのものは漏れない」── これが、ゼロ知識証明に共通する骨格です。
6-2. 何が嬉しいのか
ゼロ知識証明が解くのは、「証明したいが、証明のために秘密を渡したくない」というジレンマ です。
- 「私は18歳以上です」を、生年月日を明かさずに証明する。
- 「私はこの口座に十分な残高があります」を、残高そのものを明かさずに証明する。
- 「このパスワードを知っています」を、パスワードを送信せずに証明する。
6-3. 数学的な設計図(その3)── Schnorrプロトコル、指数法則だけでできた証明
ゼロ知識証明にも、高校数学だけで追える具体的な手順があります。
ここでは、最も基本的なゼロ知識証明の一つである Schnorr(シュノア)識別プロトコルを紹介します。
使う道具は、第4章で登場した「離散対数の難しさ」と、5-2のステップ3で見た「指数法則」の2つだけです。
【ステップ1:秘密と公開情報】
あなた(証明者)は秘密の数 $x$(パスワードのようなもの)を持っています。
そして、$y = g^x$ を計算して公開しておきます(実際には、ある大きな素数 $p$ で割った余りの世界で計算します)。
$x$ から $y$ を計算するのは簡単ですが、$y$ から $x$ を逆算するのは極端に難しい(離散対数問題)。
第4章で見た「片方向は簡単、逆は難しい」の仕掛けです。
目標は、$x$ そのものを見せずに、「私は $y = g^x$ となる $x$ を知っています」と検証者に納得させることです。
【ステップ2:3つのメッセージのやり取り】
① 証明者:使い捨ての乱数 r を選び、t = g^r を送る   … コミットメント
② 検証者:ランダムな数 c を選んで送る               … チャレンジ
③ 証明者:s = r + c·x を計算して返す                … レスポンス
④ 検証者:g^s = t × y^c が成り立つかを確かめる
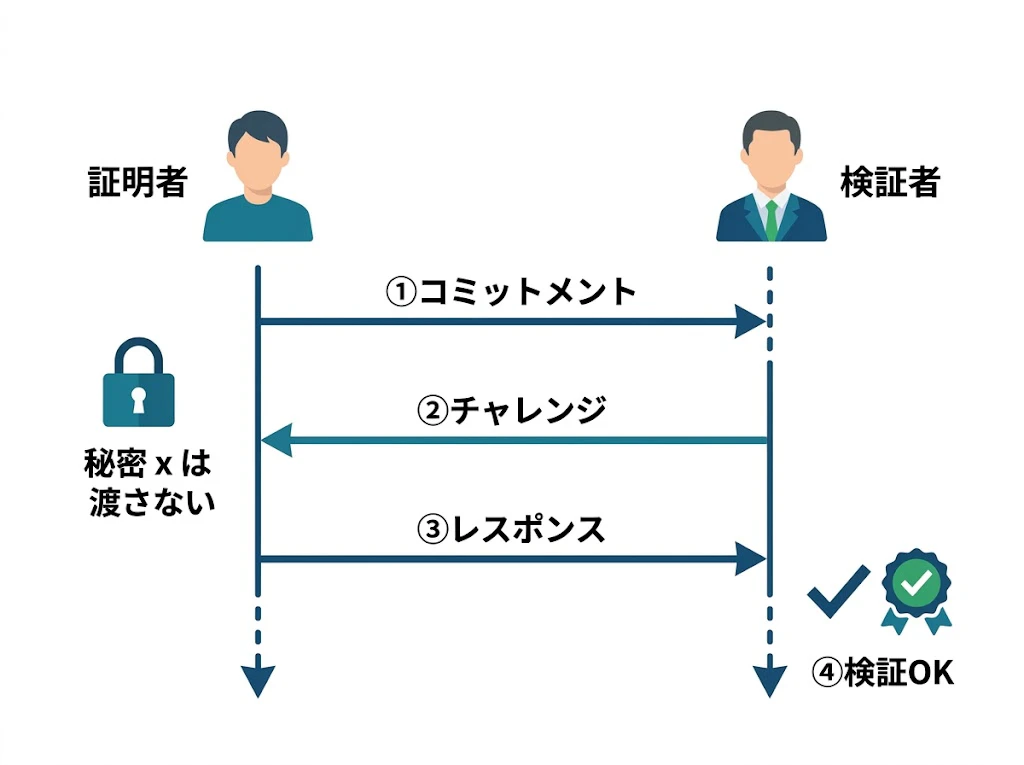
6-1のたとえ話と見比べてください。
②で検証者がランダムな問題を出し、③で証明者が答える、という構造がそっくりです。
【ステップ3:なぜ答え合わせができるのか ── ここでも指数法則】
検証者は $x$ を知りません。
それでも④の確認ができるのは、指数法則のおかげです。
g^s = g^(r + c·x)
    = g^r × (g^x)^c      ← 指数法則
    = t × y^c
5-2で見た「肩の上の足し算が、掛け算に化ける」性質が、ここでも主役です。
正しい $x$ を知っている証明者なら、どんな $c$ が来ても、必ずこの等式を満たす $s$ を作れます。
【ステップ4:なぜ x が漏れないのか、なぜごまかせないのか】
$x$ が漏れない理由は、証明者が返す $s = r + c \cdot x$ に、毎回使い捨ての乱数 $r$ が足し込まれているからです。
$r$ は検証者には分からないので、$s$ はただのランダムな数にしか見えず、$x$ の情報は乱数の中に覆い隠されています。乱数を足して文字を隠すワンタイムパッドと同じ発想です。
逆に、$x$ を知らない人がこのやり取りを突破できるのは、①で $t$ を送る時点で、②でどんな $c$ が来るかを運よく予想できたときだけです。
なぜなら、もし同じ $t$ に対して2種類の $c$($c_1$ と $c_2$)の両方に正しく答えられるなら、その2つの答え $s_1,\ s_2$ から $s_1 - s_2 = (c_1 - c_2) \cdot x$ という関係が成り立ち、$x = (s_1 - s_2) \div (c_1 - c_2)$ として $x$ そのものを計算できてしまうからです(割り算は余りの世界での割り算です)。
つまり、「どんな問題にも答えられる」ことは「$x$ を知っている」ことと同じなのです。
$c$ の候補は膨大にあるので、当てずっぽうで突破できる確率は無視できるほど小さくなります。
【ステップ5:コードで確かめる】
小さな数で、1回分のやり取りを実際に計算してみます。
実行条件:Python 3(標準ライブラリのみ) / 用途:学習用(数が小さく安全ではないため、実務では使用不可)
# 学習用のおもちゃ実装です(数が小さすぎて安全ではありません。実務では使わないこと)
import secrets

p, q, g = 2039, 1019, 4   # p = 2q + 1(どちらも素数)。g は「位数 q」の元

# ----- 準備:証明者(あなた)の秘密と公開情報 -----
x = 777                    # 秘密(パスワードに相当)。誰にも見せない
y = pow(g, x, p)           # 公開情報 y = g^x mod p(第4章の「離散対数」の難しさで守られる)

# ----- 1回のやり取り -----
r = secrets.randbelow(q)   # ① 証明者:使い捨ての乱数 r を選び、
t = pow(g, r, p)           #    t = g^r を送る(コミットメント)
c = secrets.randbelow(q)   # ② 検証者:ランダムな問題 c を出す(チャレンジ)
s = (r + c * x) % q        # ③ 証明者:s = r + c·x を返す(レスポンス)

# ④ 検証者:x を知らないまま、指数法則で答え合わせをする
#    g^s = g^(r + c·x) = g^r × (g^x)^c = t × y^c
print("検証結果:", pow(g, s, p) == (t * pow(y, c, p)) % p)   # True
実際のシステムでは、ハッシュ関数を使ってチャレンジ $c$ を作ることで、やり取りを1回のメッセージにまとめる工夫(Fiat–Shamir変換)を施します。
これが Schnorr 署名の土台になっています。
さらに「任意の計算が正しく行われたこと」まで証明できるように大きく一般化したのが、ブロックチェーンなどで使われる zk-SNARK や zk-STARK です。
中身ははるかに複雑ですが、「乱数で隠しつつ、ランダムな問題に答えさせて確かめる」という骨格は共通しています。
6-4. 利用シーン
- 本人確認・KYC ── 年齢や国籍などの属性を、個人情報の中身を渡さずに証明する。
- ブロックチェーン ── 取引の正当性を、取引の中身を秘匿したまま検証する(zk-Rollupなど)。
- 認証 ── パスワードや生体情報そのものをサーバに送らずに、本人であることを示す。
7. 秘密分散・秘密計算(MPC) ── 「一か所に秘密を集めない」
7-1. 秘密分散とは ── そして、その数学的な設計図
秘密分散(Secret Sharing)は、1つの秘密を複数の断片に分割し、「一定数以上の断片が集まらないと元に戻せない」ようにする技術です。
たとえば、秘密を5つの断片に分け、「うち3つ揃えば復元できるが、2つ以下では何も分からない」ように設計できます(しきい値法)。
断片を別々の場所に保管すれば、1か所が漏洩しても秘密は守られます。
ここも高校数学だけを前提に、しくみの核心まで踏み込みます。
鍵になるのは、高校で習う「多項式とグラフ」、特に「何点で曲線が決まるか」という素朴な事実です。
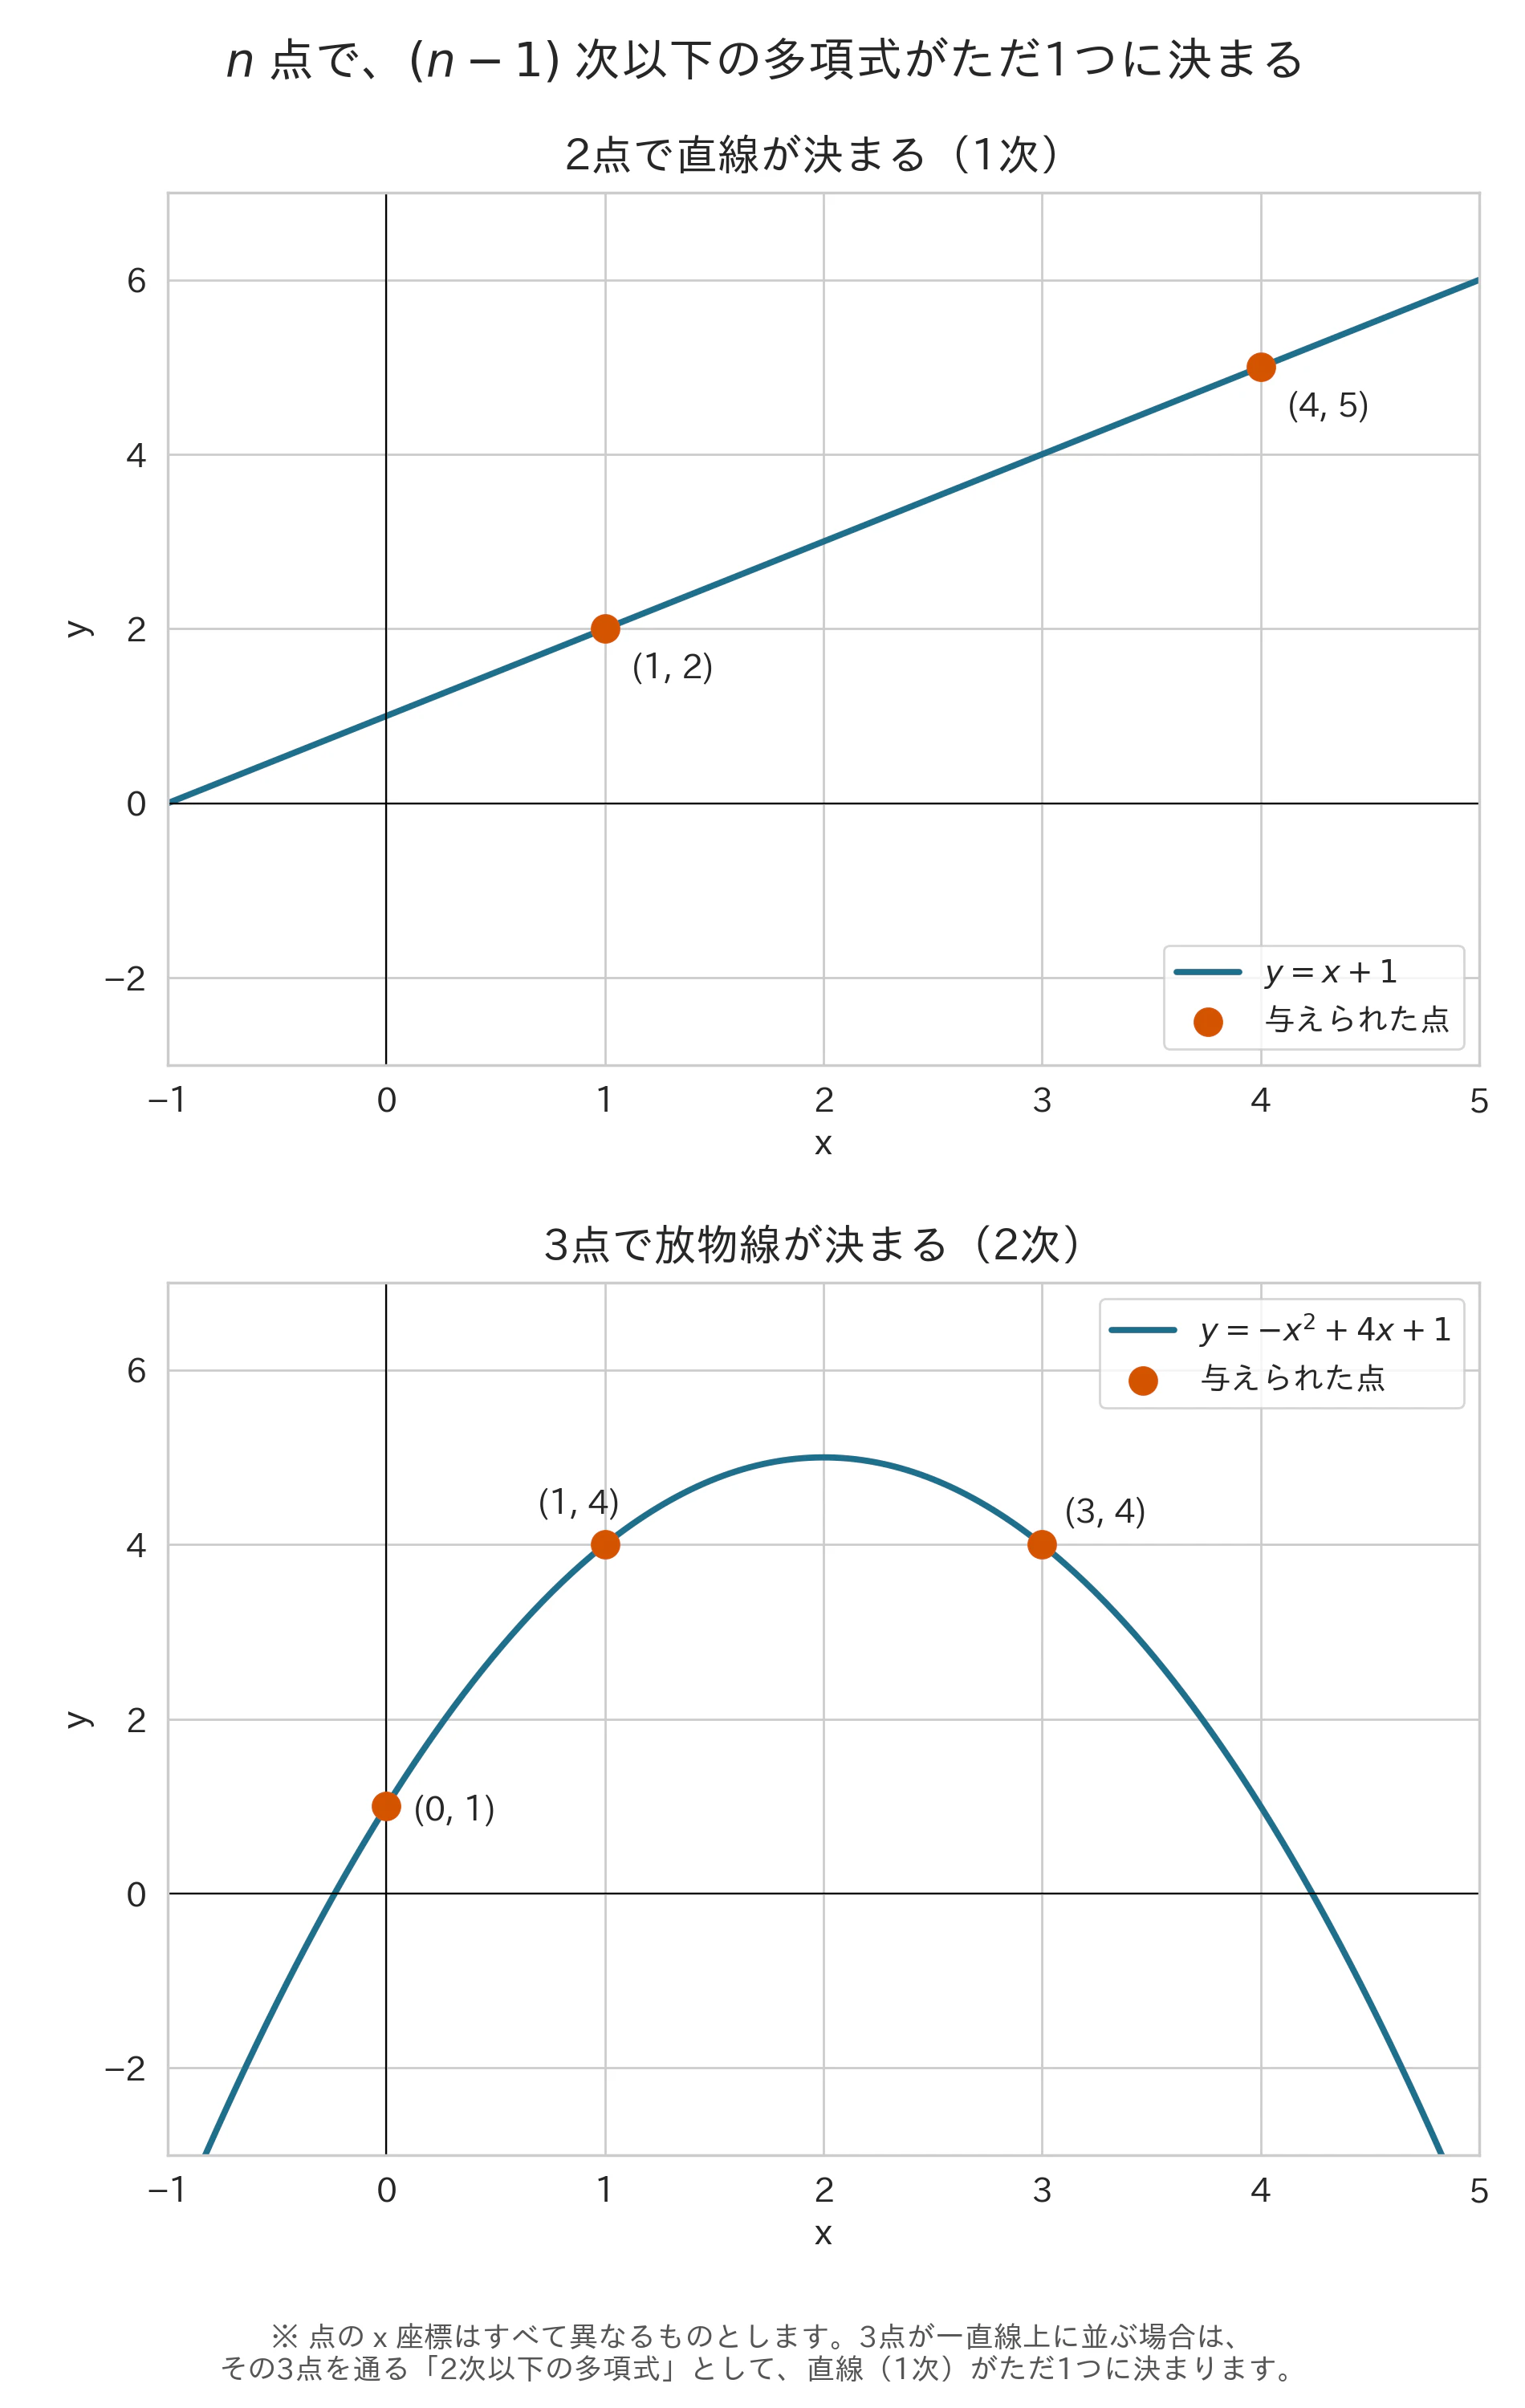
【ステップ1:高校で習った「何点で決まるか」】
高校で、次の事実を学んだはずです。
- 2点を通る直線は、ただ1本に決まる。
- 3点を通る放物線(2次関数)は、ただ1つに決まる。
一般化すると、相異なる $n$ 個の点を通る $(n-1)$ 次以下の多項式は、ただ1つに決まります。
逆に言えば、点が足りないと、曲線は1つに決まりません。
たとえば2次関数(3点で決まる)は、2点しか与えられないと、その2点を通る放物線が無数に引けてしまいます。
【ステップ2:シャミアの秘密分散のしくみ】
1979年にシャミアが考案した秘密分散は、このステップ1の事実を、そっくりそのまま暗号のしくみに使います。
「3つ集めれば復元、2つ以下では不明」を作りたいとします。
手順はこうです。
まず、隠したい秘密の数値 $S$ を用意します。
次に、y切片(x=0 のときの値)が $S$ になるような、2次関数を1つ、ランダムに作ります。
f(x) = S + a·x + b·x²   (a, b はランダムに選んだ係数)

→ f(0) = S      ← y切片が、隠したい秘密そのもの
そして、この曲線の上の点を、配る人数分だけ計算して配ります。
たとえば f(1), f(2), f(3), f(4), f(5) という5つの点を、5人に1つずつ配る。
この配られた1点ずつが「シェア(断片)」です。
秘密 $S$ 自体(y切片)は誰にも渡しません。
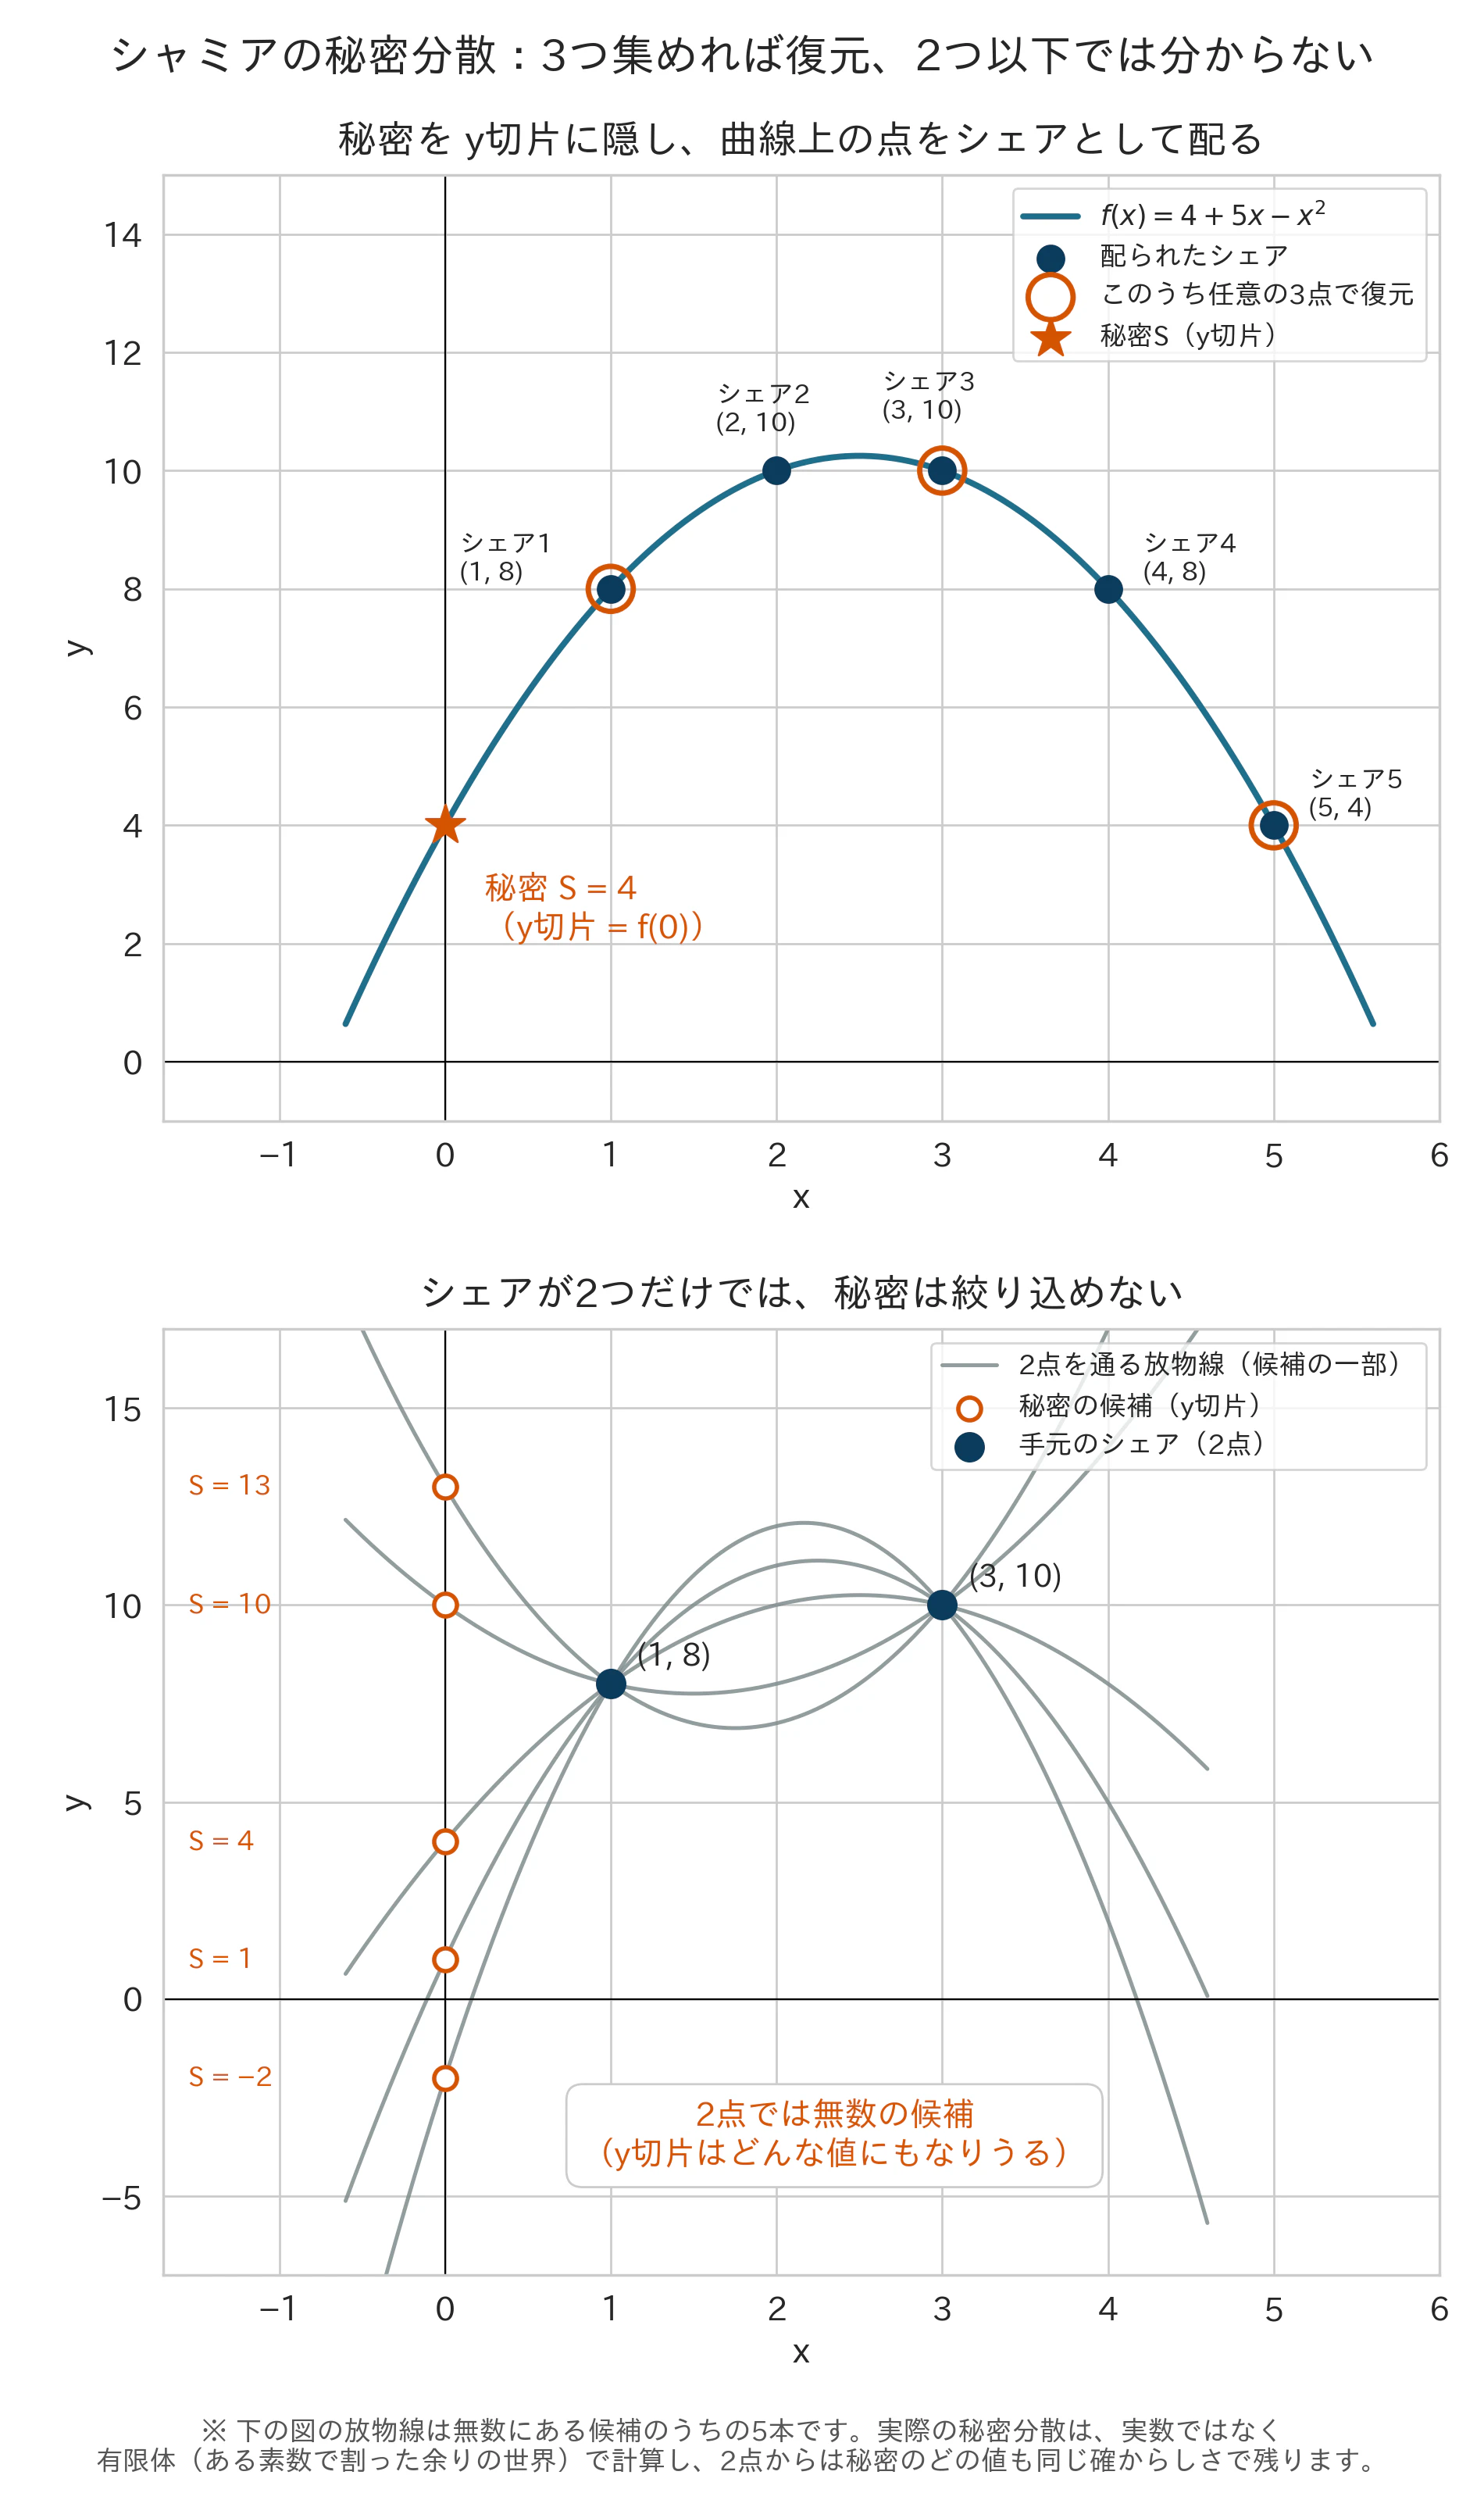
※ 上の図では、秘密 $S = 4$ を y切片に隠した2次関数 $f(x) = 4 + 5x - x^2$ の上の5点を、シェアとして5人に配っています。たとえば $f(1) = 4 + 5 - 1 = 8$ なので、1人目のシェアは $(1, 8)$ です。5つのシェアのうち、どの3つを選んでも、その3点を通る2次以下の多項式はただ1つに決まり、y切片として元の秘密 $S = 4$ が復元されます。
下の図は、シェアを2つ($(1, 8)$ と $(3, 10)$)しか持たない人の立場です。秘密の候補 $S'$ をどんな値に決めても、3点 $(0, S')$、$(1, 8)$、$(3, 10)$ を通る2次以下の多項式がちょうど1つ見つかります。つまり、2つのシェアと矛盾しない秘密の候補は、どの値にも存在するのです。描いた5本の中には本物の秘密($S' = 4$)を通る放物線も含まれていますが、2つのシェアしか持たない人には、それがどれかを見分ける手がかりがありません。
なお、$S' = 7$ のときだけは、3点が一直線上に並ぶため、通る多項式は放物線ではなく直線(1次)になります。「2次以下の多項式」と書いているのは、このような場合も含めるためです。
【ステップ3:なぜ「3つで復元、2つで不明」になるのか】
ここで、ステップ1の事実が生きてきます。
2次関数は3点で1つに決まるので、5人のうち誰でも3人が集まってシェア(3点)を持ち寄れば、元の2次関数 f(x) がただ1つに復元できます。
あとは x=0 を代入すれば、秘密 $S = f(0)$ が分かります。
では2人だけが集まったら?
手元には2点しかありません。2点を通る2次関数は無数にあります。
つまり、y切片(秘密 $S$)として、ありとあらゆる値があり得てしまい、まったく絞り込めない。2人がどれだけ知恵を絞っても、秘密について何の情報も得られないのです。
これが「2つ以下では何も分からない」の数学的な正体です。
一般に、「$k$ 個集めれば復元、$k-1$ 個以下では不明」を作りたければ、y切片を秘密にした $(k-1)$ 次の多項式を使えばよい、ということになります。
配る人数 $n$ は曲線上の点を増やすだけなので自由に決められます。
これが、シャミアの秘密分散のしくみの全体です。
【ステップ4:復元の道具 ── ラグランジュ補間】
「集まった点から元の多項式を復元する」具体的な計算には、ラグランジュ補間と呼ばれる方法を使います。
名前は難しいですが、やっていることは「与えられた点をすべて通る多項式を、機械的に組み立てる」だけで、高校数学の延長で理解できます。
実務では、この計算を有限体(ある素数で割った余りの世界)の上で行い、誤差なくぴったり復元できるように設計します。
【ステップ5:コードで確かめる】
「5人に配って、3人で復元」を、実際に計算してみます。
実行条件:Python 3.8 以上(標準ライブラリのみ。
pow(x, -1, P)に 3.8 以上が必要) / 用途:学習用(実務では監査済みのライブラリを使用)
# 学習用の実装です。実務では監査済みのライブラリを使ってください
import secrets

P = 2**127 - 1   # 大きな素数。計算はすべて「P で割った余りの世界(有限体)」で行う

def split(secret, n, k):
    """秘密を n 個のシェアに分け、k 個集まれば復元できるようにする"""
    # y切片が秘密になる (k-1) 次の多項式 f(x) = secret + a1·x + a2·x² + …
    coeffs = [secret] + [secrets.randbelow(P) for _ in range(k - 1)]
    f = lambda x: sum(c * pow(x, i, P) for i, c in enumerate(coeffs)) % P
    return [(x, f(x)) for x in range(1, n + 1)]   # 曲線上の点 (1, f(1)), …, (n, f(n))

def recover(shares):
    """ラグランジュ補間で f(0)(=y切片=秘密)を求める"""
    secret = 0
    for j, (xj, yj) in enumerate(shares):
        num, den = 1, 1
        for m, (xm, _) in enumerate(shares):
            if m != j:
                num = num * (0 - xm) % P
                den = den * (xj - xm) % P
        secret = (secret + yj * num * pow(den, -1, P)) % P
    return secret

shares = split(secret=20240613, n=5, k=3)   # 5人に配り、3人で復元できる設定
print(recover(shares[:3]))                  # 1,2,3番目の3人 → 20240613
print(recover([shares[0], shares[2], shares[4]]))  # 別の3人でも → 20240613
print(recover(shares[:2]))                  # 2人だけ → でたらめな値(秘密は分からない)
3人分のシェアからは、どの組み合わせでも同じ秘密が復元され、2人分のシェアからは、でたらめな値しか出てこないことが確かめられます。
2人分の結果がでたらめなのは偶然ではなく、ステップ3で見たとおり、2点では2次関数が決まらず、y切片としてあらゆる値がありえるからです。
まとめると、秘密分散とは、「$n$ 点で $(n-1)$ 次以下の多項式がただ1つに決まる」という高校数学の事実を、そのまま安全性の根拠にした暗号です。
秘密を曲線のy切片に隠し、曲線上の点をばらまく ── 一度このしくみが腑に落ちると、非常に美しい仕組みだと感じられるはずです。
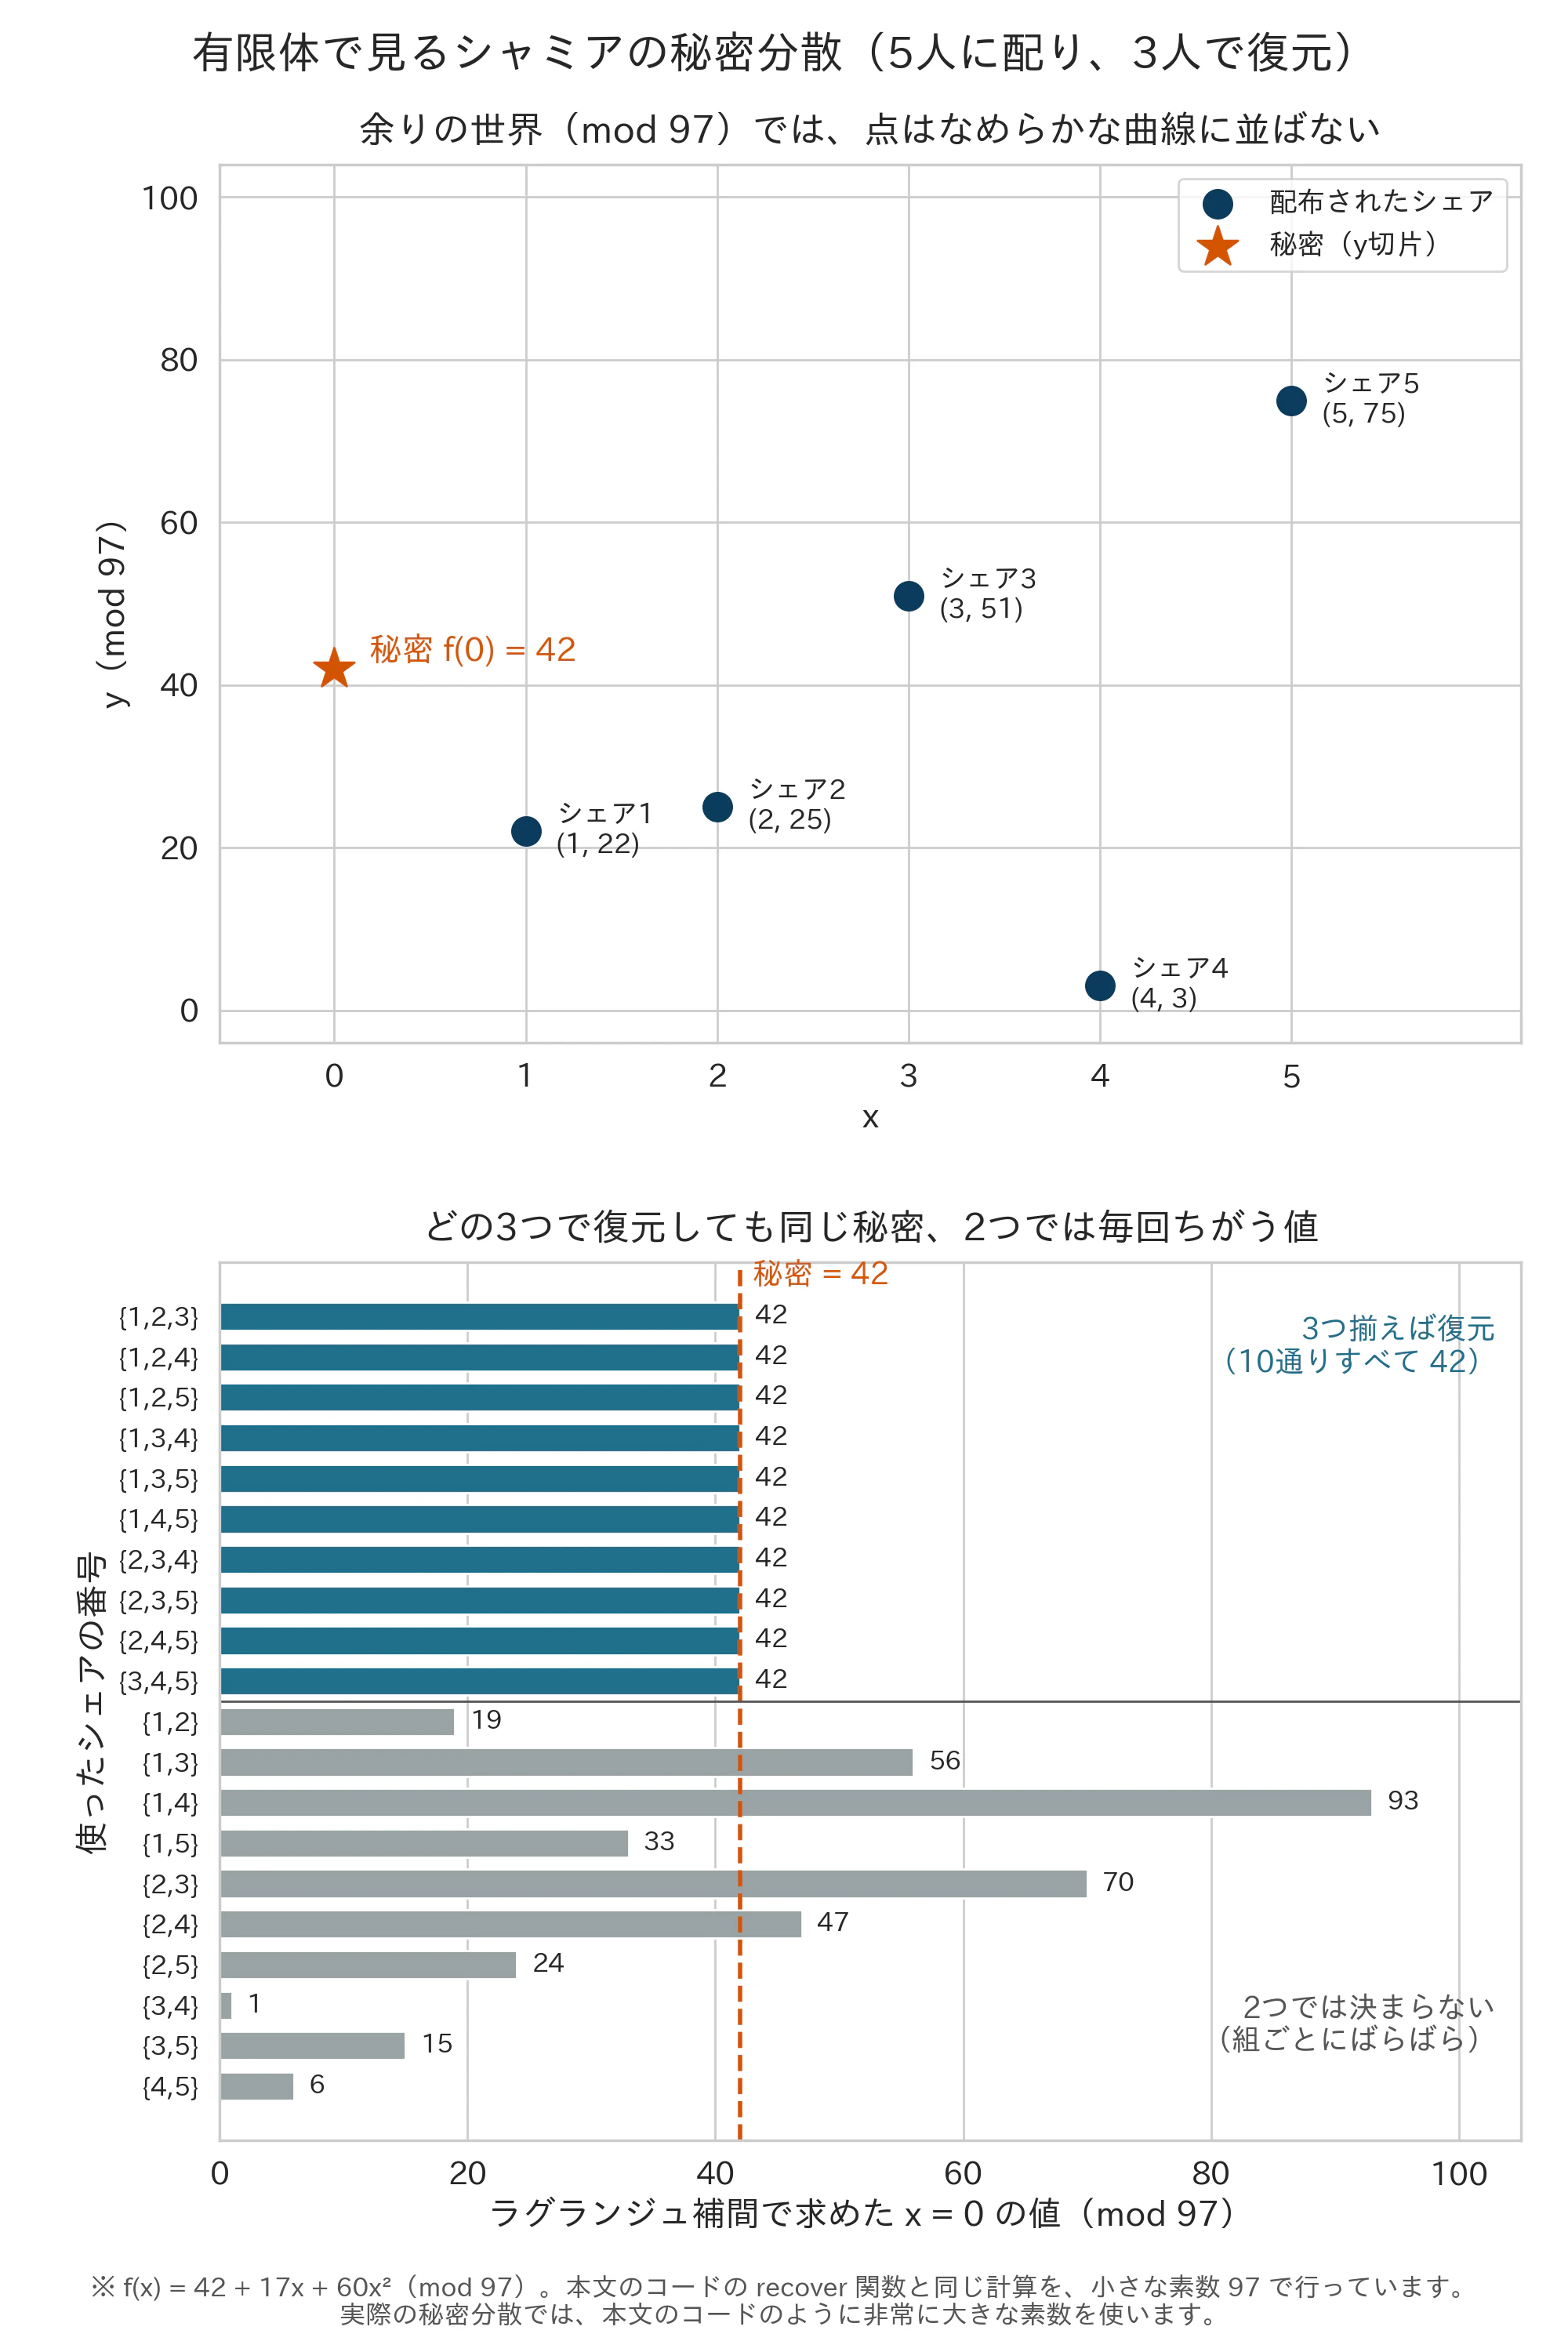
※ 上の図は、前の図と同じしくみを、実際の秘密分散と同じ「余りの世界」で計算したものです。
ここでは秘密を $42$ とし、$f(x) = 42 + 17x + 60x^2$ を $97$ で割った余りでシェアを作っています。
たとえば $f(1) = 42 + 17 + 60 = 119$ で、$119$ を $97$ で割った余りは $22$ なので、1人目のシェアは $(1, 22)$ です。
実数で描いた前の図とは違い、点はなめらかな曲線には並ばず、ばらばらに散らばって見えます。
それでも、「3点で2次以下の多項式がただ1つに決まる」という性質は、余りの世界でもそのまま成り立ちます。
下の図は、本文のコードの
recover関数と同じ計算を、シェアの組み合わせごとに行った結果です。5つのシェアから3つを選ぶ組み合わせは10通りあり、そのすべてで秘密の $42$ が復元されています。
一方、2つを選ぶ10通りで同じ計算をすると、組み合わせごとにばらばらの値になります。
2つのシェアから計算した値が、たまたま秘密と一致することもありえます(この例なら $97$ 回に1回程度)。
しかし、2つのシェアしか持たない人には、その値が本物かどうかを確かめる方法がありません。
前の図で見たのと同じ理屈で、2つのシェアと矛盾しない秘密の候補は、$0$ から $96$ までのどの値にもちょうど1つずつ存在するからです。
2つ以下のシェアからは秘密について何の手がかりも得られない、というのはこの意味です。
7-2. 秘密計算(MPC)とは
これを計算に応用したのが、秘密計算(Secure Multi-Party Computation, MPC)です。
複数の参加者が、それぞれの手元のデータを互いに見せ合うことなく、全員のデータを使った計算結果だけを得る、という技術です。
古典的な例が「百万長者問題」です。
2人の金持ちが、どちらが裕福かを、互いの正確な資産額を明かさずに判定する、という問題です。
MPCを使えば、各自の資産額は秘密のまま、「どちらが多いか」という結論だけを得られます。
MPCにも、高校数学で追える具体的な手順があります。
いちばん単純な「合計を秘密のまま求める」場合を見てみましょう。
道具は、7-1と同じ「秘密を断片に分ける」発想ですが、ここではさらに単純な加法的秘密分散を使います。
【ステップ1:足すと元に戻る断片に分ける】
A病院の患者数が 1200 人だとします。
A病院は、この 1200 を、足し合わせるとちょうど 1200 になる3つのランダムな数に分けます。たとえば 1200 = 5821 + (−3104) + (−1517) のように分けます(実際には、ある素数で割った余りの世界で計算するので、負の数は出てきません)。
断片を1つだけ見ても、ただの乱数にしか見えず、1200 という値は分かりません。
【ステップ2:断片を別々のサーバに配り、各サーバは足すだけ】
A病院・B病院・C病院が、それぞれ自分の値を3つの断片に分け、3台の計算サーバに1つずつ配ります。
各サーバは、届いた3つの断片(各病院から1つずつ)を足し合わせて小計を作ります。
どのサーバも、乱数にしか見えない断片を足しているだけなので、どの病院の値も分かりません。
【ステップ3:小計を足すと、合計「だけ」が分かる】
最後に3台のサーバの小計を足し合わせると、足し算の順番を入れ替えても答えは変わらない(交換法則・結合法則)ので、結果は「3病院の値の合計」に一致します。
個々の値は誰にも見えないまま、合計だけが明らかになるのです。

3病院の合計を、実際に計算してみます。
実行条件:Python 3(標準ライブラリのみ)
用途:学習用(実務では監査済みのライブラリを使用)
# 学習用の実装です(加法的秘密分散で「合計」だけを秘密計算する)
import secrets

P = 2**61 - 1   # 大きな素数。計算は P で割った余りの世界で行う

def share(value, n):
    """value を、足すと value に戻る n 個のランダムな断片に分ける"""
    parts = [secrets.randbelow(P) for _ in range(n - 1)]
    parts.append((value - sum(parts)) % P)
    return parts

patients = {"A病院": 1200, "B病院": 850, "C病院": 430}   # 各病院の患者数(互いに秘密)
n = len(patients)

# 各病院が自分の値を3つの断片に分け、3つの計算サーバに1つずつ配る
all_shares = [share(v, n) for v in patients.values()]

# 各計算サーバは、届いた断片を足すだけ(1つ1つはただの乱数にしか見えない)
server_sums = [sum(s[i] for s in all_shares) % P for i in range(n)]

# 最後にサーバの小計を足し合わせると、合計「だけ」が分かる
print("3病院の合計:", sum(server_sums) % P)   # 2480
足し算はこのように簡単にできますが、掛け算や「どちらが大きいか」の比較のような計算には、サーバどうしの追加のやり取りなど、もう一工夫が必要になります。
それでも、「断片に分け、断片のまま計算し、最後に結果だけを組み立てる」という骨格は同じ です。
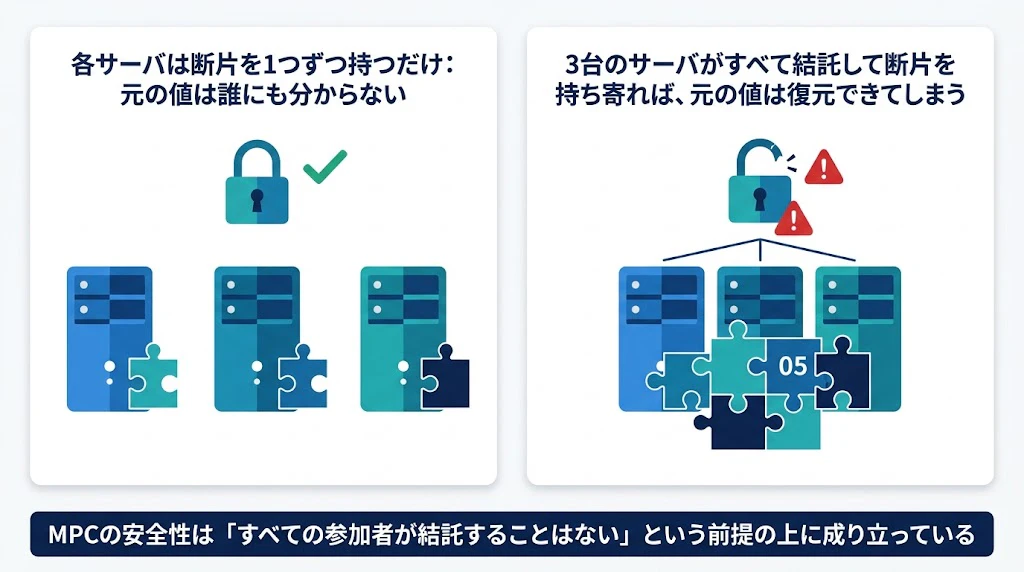
なお、3台のサーバがすべて結託して断片を持ち寄れば、元の値は復元できてしまいます。
MPCの安全性は「すべての参加者が結託することはない」という前提の上に成り立っている点 も、押さえておきましょう。
7-3. 利用シーン
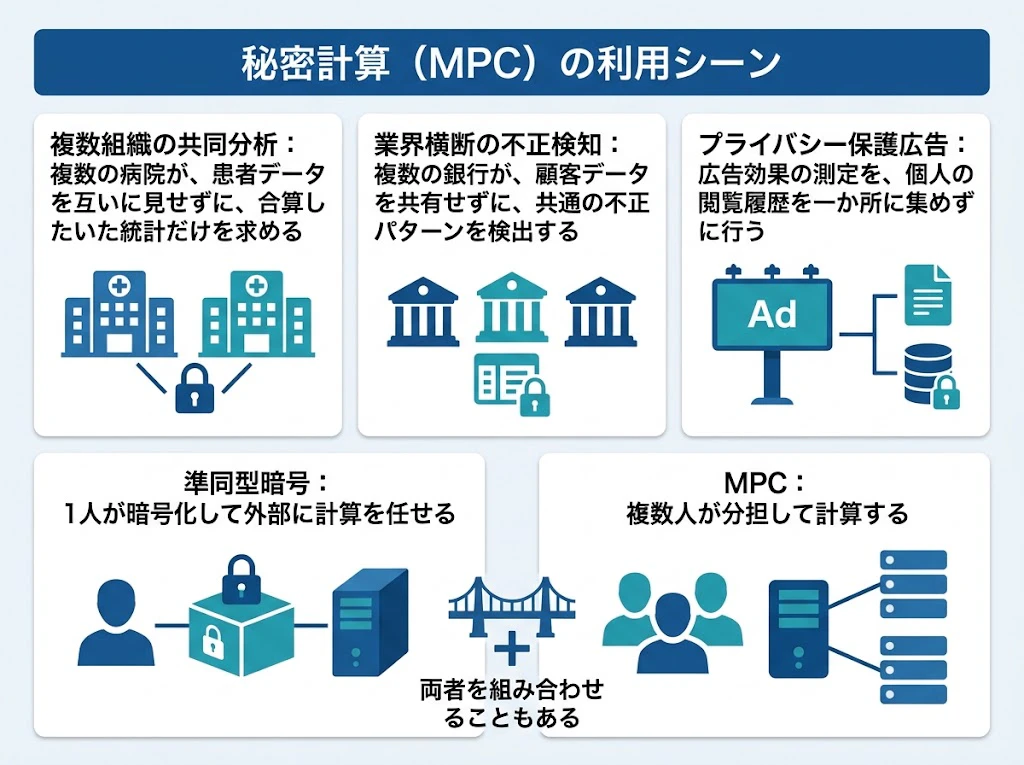
- 複数組織の共同分析 ── 複数の病院が、患者データを互いに見せずに、合算した統計だけを求める。
- 業界横断の不正検知 ── 複数の銀行が、顧客データを共有せずに、共通の不正パターンを検出する。
- プライバシー保護広告 ── 広告効果の測定を、個人の閲覧履歴を一か所に集めずに行う。
準同型暗号が「1人が暗号化して外部に計算を任せる」のに対し、MPCは「複数人が分担して計算する」点が対照的です。両者を組み合わせることもあります。
8. ここまでの整理 ── 4機能と手法の地図
ここで一度、全体を俯瞰しておきましょう。
第2章で示した4機能に、各手法を対応させると、次のようになります。
| 機能 | 手法 | 解くジレンマ | 主な数学 |
|---|---|---|---|
| ① 守る | 楕円曲線・RSA・AES | 中身を読ませたくない | 楕円曲線・整数論 |
| ② 計算する | 準同型暗号 | 渡さずに計算したい | 格子・LWE |
| ③ 証明する | ゼロ知識証明 | 明かさずに証明したい | 離散対数・楕円曲線・多項式 |
| ④ 分散する | 秘密分散・MPC | 一か所に集めたくない | 多項式・ラグランジュ補間・加法的分散 |
これらを支える数学の土台を一望すると、楕円曲線(守る・証明する) と 格子(計算する・耐量子) という 2つの大きな柱 が見えてきます。
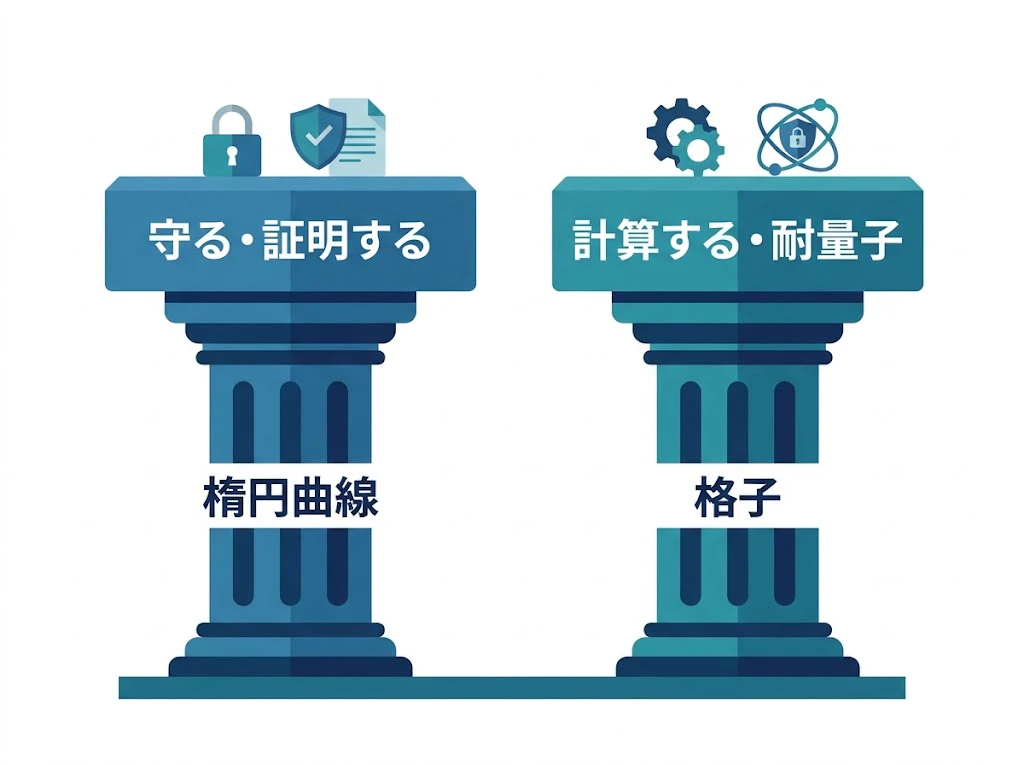
ここで、耐量子の話 に軽く触れます。
現在広く使われている 楕円曲線暗号やRSAは、大規模な量子コンピュータが実現すると破られる恐れがあります(ショアのアルゴリズム) 。
そこで、量子コンピュータでも破れないと期待される耐量子計算機暗号(PQC)への移行 が、世界的に進んでいます。
その主役が、まさに準同型暗号と同じ格子に基づく暗号 です。
米国のNISTは2024年8月13日、格子に基づく鍵共有方式 ML-KEM(FIPS 203)と署名方式 ML-DSA(FIPS 204)、ハッシュ関数に基づく署名方式 SLH-DSA(FIPS 205)を、PQCの標準として正式に公開しました[5][6][7][8]。
ML-KEM の安全性の土台は、5-5で見たLWEの仲間(Module-LWE) です[6]。
高校の連立一次方程式に誤差を混ぜるというアイデアが、そのまま世界標準の暗号の土台になっているのです。
※ ここで言うPQCは「量子計算機でも破れない、従来型コンピュータ上で動く暗号」です。
光子などの量子力学を直接使う「量子暗号(量子鍵配送)」とは別物で、後者は本記事では扱わず、別稿に譲ります。
9. LLM・AIエージェント時代の暗号ニーズ ── 現在と展望
9-1. なぜ、いま暗号ニーズが高まっているのか
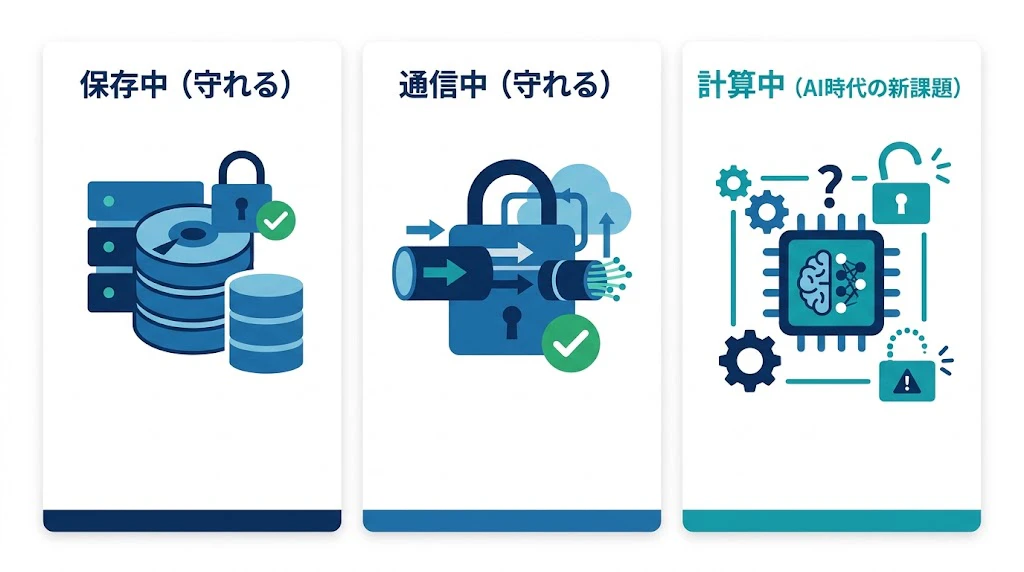
LLMやAIエージェントの普及は、データ保護に新しい難問を突きつけています。
従来、データ保護は主に「保存中(暗号化したディスク)」と「通信中(HTTPS)」の2場面でした。
ところが AI活用では、第3の場面、「計算中・推論中」のデータ保護が問題になります。
なぜなら、AIにデータを処理させるには、これまでは平文をAIサーバに渡すしかなかったからです。
プロンプトに含めた機密情報、アップロードしたカルテや契約書 ── それらは処理の瞬間、AI事業者から見える状態になります。
「生成AIは便利だが、企業で使うと情報漏洩が心配だ。もしAIサーバのデータ処理に準同型暗号を使えれば」という発想は、まさにここから生まれています。
9-2. 各暗号が、AI時代に力を発揮する場面
- ② 計算する(準同型暗号)── 暗号化したままLLMに推論させる、暗号化したまま機械学習する。
プロンプトやデータを平文で渡さずにAIを使う、という未来の中核技術。
- ③ 証明する(ゼロ知識証明)── 「このAIの出力は、確かにこのモデルが正しく生成した」ことを、モデルの中身を明かさずに証明する。AIの出力の真正性・来歴の証明に役立つ。
- ④ 分散する(MPC)── 複数組織がデータを持ち寄ってAIを学習させたいが、生データは共有できない、という場面。
なお、よく一緒に語られる連合学習(フェデレーテッドラーニング)は、データを各組織の手元に置いたまま学習し、モデルの更新値だけを集める「学習の方式」であり、それ自体は暗号技術ではありません。
更新値からも元データがある程度推測されうるため、その集約を秘密のまま行う「セキュアアグリゲーション」の部分で、MPCや秘密分散が使われます。
9-3. 現在地 ── 期待と現実
ただし、過度な期待は禁物です。
現状を正直に言えば、「暗号化したままLLMを丸ごと動かす」のは、まだ計算コストの面で非現実的です。
準同型暗号のオーバーヘッドは依然として大きく、巨大なニューラルネットワーク全体を暗号文のまま動かすのは、現在の技術では重すぎます。
いま現実的なのは、部分的な適用です。
推論の一部の機密性が高い箇所だけを準同型暗号で処理する、軽量なモデルや特定の統計処理に限って暗号化したまま計算する、といった使い方です。
研究の最前線では、GPUを用いた準同型暗号演算の高速化や、複数人で運用するマルチキー方式の拡張など、実用化に向けた改良が活発に進んでいます。
一方で、「狭い用途」では、準同型暗号はすでに大規模な本番サービスで動いています。
Appleは2024年7月、iOS 18の着信者情報の照会機能(Live Caller ID Lookup)で準同型暗号を使い、問い合わせ先のサーバに電話番号を知られずに照会する仕組みを導入したと発表し、その実装である BFV 方式のライブラリを swift-homomorphic-encryption としてオープンソース化しました[1][2]。
同年10月には、写真アプリのランドマーク検索(Enhanced Visual Search)の仕組みも公開しています。
写真から計算したベクトルを準同型暗号で暗号化したままサーバ側のデータベースと照合し、さらに「データベースのどの区画を問い合わせたか」という手がかりを、偽の問い合わせを混ぜる差分プライバシーと、送信元IPアドレスを隠す中継ネットワークで守るという構成です[3]。
Microsoft Edgeのパスワード漏洩チェック(Password Monitor)も、2021年から、Microsoft SEALを土台にした準同型暗号のプロトコルで、パスワードそのものをMicrosoftに知られずに漏洩データベースと照合しています[4]。
これらに共通するのは、「巨大な計算を丸ごと暗号化する」のではなく、「検索・照合のような、限られた種類の計算だけを暗号化したまま行う」という使い方だという点です。
準同型暗号を自分の業務に取り入れるときも、まずはこの「狭く・確実に」から考えるのが現実的です(各社の採用状況は変化が速いため、最新の情報は末尾の参考文献に挙げた各社の公式発表で確認してください)。
9-4. 暗号だけが答えではない ── TEE・差分プライバシー・連合学習との使い分け
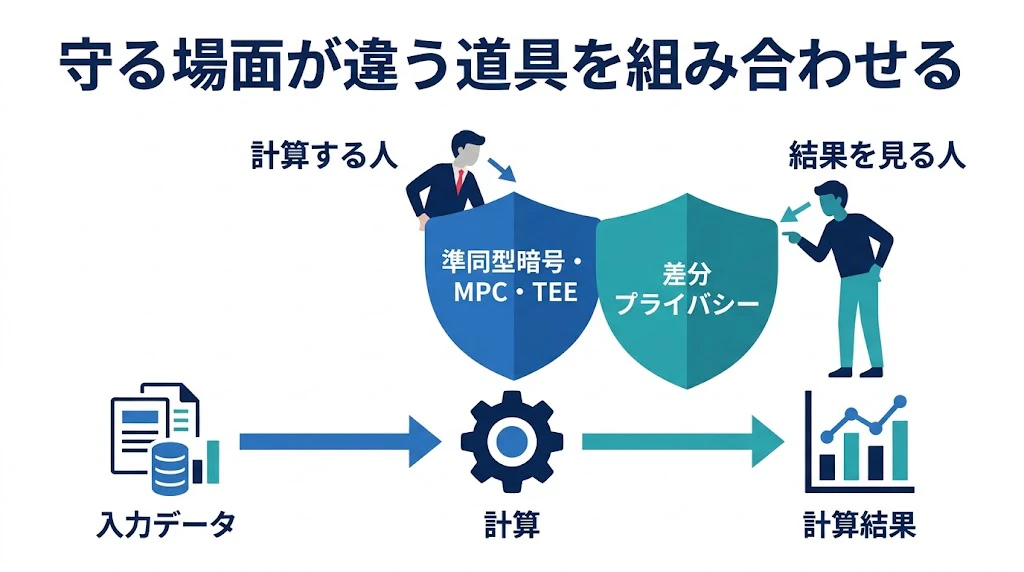
「計算中のデータを守る」という課題には、暗号以外のアプローチも あります。
実務で手法を選ぶときには、これらとの違いを押さえておくことが欠かせません。
| 手法 | 何に頼って守るか | 守れるもの | 弱点・注意点 |
|---|---|---|---|
| 準同型暗号(HE) | 数学(暗号) | 計算する相手から、計算中のデータを隠す | 計算コストが非常に大きい |
| 秘密計算(MPC) | 数学(暗号)+分散 | 複数組織が、互いのデータを見ずに共同計算する | 参加者間の通信が多い。全員が結託すると破れる |
| TEE(Confidential Computing) | ハードウェアの隔離領域 | クラウド事業者やOS管理者からも、計算中のデータを隠す | ハードウェアの製造元を信頼する必要がある。サイドチャネル攻撃の報告もある |
| 差分プライバシー | 統計的なノイズ | 集計結果や学習済みモデルから、個人が逆算されるのを防ぐ | 精度とプライバシーのトレードオフがある。計算中のデータは守らない |
| 連合学習 | データを動かさない設計 | 生データを1か所に集めない | 更新値から推測されうるので、MPCや差分プライバシーとの併用が前提 |
TEE(Trusted Execution Environment) は、CPUやGPUの中に、OSやクラウドの管理者からも中を覗けない隔離された領域を作り、その中で計算する技術 です。
数学ではなくハードウェアに頼る方式ですが、通常の計算とほぼ同じ速度で動くため、LLMの推論のような重い計算を秘匿したい場面では、現時点では準同型暗号よりはるかに実用的 です。
GPU向けの機密計算モードなど、AI推論を隔離環境で行う仕組みが、大手クラウド各社から提供されています。

差分プライバシーは、守る対象がまったく違う点に注意が必要です。
準同型暗号やMPCは「計算する人」からデータを隠しますが、「計算結果」そのものからの漏洩は防げません。
たとえば、暗号化したまま「ある条件に当てはまる患者の平均年齢」を計算しても、条件に当てはまるのが1人だけなら、その平均はその人の年齢そのものです。
差分プライバシーは、出力に計算されたノイズを加えることで、こうした「結果からの逆算」を防ぎます。
Appleの写真検索でも、準同型暗号だけでは隠しきれない手がかり(どの区画を問い合わせたか)を、差分プライバシーで補っています[3]。
このように、暗号と差分プライバシーは、互いの守備範囲の穴を埋め合う関係 にあります。
つまり、これらは競合するというより、守る場面が違う道具 です。
「誰から(計算する人から? 結果を見る人から?)」「何を(入力? 出力?)」守りたいのかを先に決め、それに合った道具を組み合わせる
── これが、実務での手法選びの基本 になります。

9-5. 将来展望
向こう数年〜十年の方向性 として、次のような流れが見込まれます。
ひとつは、PQCへの移行 です。
量子コンピュータの進展に備え、楕円曲線・RSAから格子ベースの暗号への置き換え が、OSやブラウザ、通信プロトコルのレベル で進んでいきます。
実際、主要ブラウザでは、従来の楕円曲線(X25519)と格子暗号を組み合わせた「ハイブリッド鍵交換」が、すでに標準で使われています。
Chromeは2024年4月のバージョン124で、標準化前の格子暗号Kyberを使ったハイブリッド鍵交換をデスクトップ版で標準で有効にし、バージョン131(2024年11月)で、標準化されたML-KEMを使う方式(X25519MLKEM768)へ切り替えました[9]。
Firefoxもバージョン132(2024年10月29日)で、ML-KEMを使うハイブリッド鍵交換に対応しています[10]。万一どちらか一方が破られても、もう一方が守る、という二重構えです。
まだ実用的な量子コンピュータが存在しないのに、なぜ今から急ぐのか。
それは、「今のうちに暗号化された通信を盗んで保存しておき、将来量子コンピュータができてから解読する(Harvest Now, Decrypt Later)」という攻撃が考えられるからです。
医療記録や個人の遺伝情報のように、何十年も秘密にしておくべきデータほど、この脅威は現実的です。これはAIに限らず、すべてのデジタルインフラに関わる地殻変動です。
もうひとつは、「計算するプライバシー」の主流化です。
準同型暗号・MPC・ゼロ知識証明を組み合わせ、「データを集めず、見せず、それでも価値を引き出す」というアーキテクチャが、特に医療・金融・行政など、機密性の高い分野から実用に入っていくと考えられます。

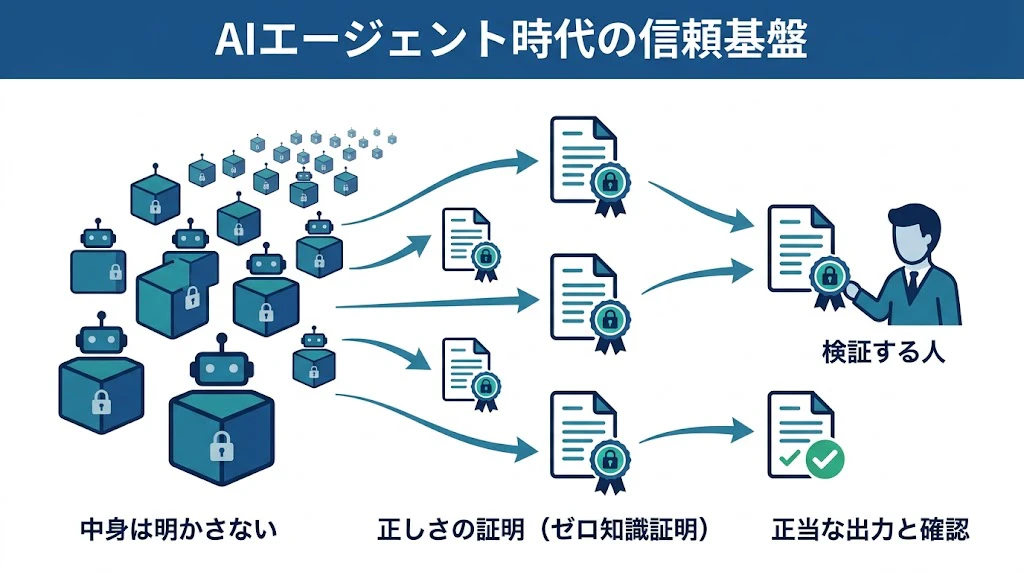
そして、AIエージェント時代の信頼基盤として、ゼロ知識証明が「このエージェントの行動・出力は正当か」を検証する役割を担う可能性があります。
自律的に動くエージェントが増えるほど、「中身を明かさずに正しさを保証する」技術の価値は高まります。
10. 結び ── 暗号は「守る」から「活かす」へ
振り返れば、暗号は長らく「通信を盗聴から守る」ための技術でした。
しかし現代の高機能暗号は、その役割を大きく広げています。
暗号化したまま計算し、秘密を明かさず証明し、一か所に集めずに分散する
── これらはすべて、「守ること」と「活用すること」という、相反しがちな2つを数学で両立させる試み です。
そしてこのニーズは、AI時代にいよいよ切実になっています。
データを使えば使うほど、それを守る難しさが増す。
その矛盾を解く鍵が、本記事で見てきた暗号の数学です。
暗号は、もはやセキュリティ専門家だけのものではありません。
個人情報を扱い、データを活かそうとする、あらゆるエンジニア・データサイエンティストのための、汎用的な思考の道具になりつつあります。
もしあなたが、これらの発想を一つでも携えれば、「データを守るか、活かすか」という二者択一から、「守りながら活かす」という第三の道へ、一段進めるはずです。
本記事が、その道具箱を開ける一枚の地図になれば幸いです。最後までお読みいただき、ありがとうございました。
※ 本記事では、量子力学を直接用いる「量子暗号(量子鍵配送など)」には立ち入りませんでした。
これは稿を改めて、別の記事で扱う予定です。
参考文献
本文中の[1]〜[18]は、以下の文献に対応しています。URLの最終閲覧日はいずれも2026年10月24日です。
- Fabian Boemer, Karl Tarbe, Rehan Rishi. "Announcing Swift Homomorphic Encryption." Swift.org Blog, Apple Inc., 2024年7月30日. https://www.swift.org/blog/announcing-swift-homomorphic-encryption/
- Apple Inc. swift-homomorphic-encryption(GitHubリポジトリ). https://github.com/apple/swift-homomorphic-encryption
- Apple Machine Learning Research. "Combining Machine Learning and Homomorphic Encryption in the Apple Ecosystem." Apple Inc., 2024年10月24日. https://machinelearning.apple.com/research/homomorphic-encryption
- Kristin Lauter, Sreekanth Kannepalli, Kim Laine, Radames Cruz Moreno. "Password Monitor: Safeguarding passwords in Microsoft Edge." Microsoft Research Blog, Microsoft, 2021年1月21日. https://www.microsoft.com/en-us/research/blog/password-monitor-safeguarding-passwords-in-microsoft-edge/
- National Institute of Standards and Technology (NIST). "NIST Releases First 3 Finalized Post-Quantum Encryption Standards." NIST News, 2024年8月13日. https://www.nist.gov/news-events/news/2024/08/nist-releases-first-3-finalized-post-quantum-encryption-standards
- National Institute of Standards and Technology (NIST). Module-Lattice-Based Key-Encapsulation Mechanism Standard. Federal Information Processing Standards Publication (FIPS) 203, 2024年8月13日. https://doi.org/10.6028/NIST.FIPS.203
- National Institute of Standards and Technology (NIST). Module-Lattice-Based Digital Signature Standard. Federal Information Processing Standards Publication (FIPS) 204, 2024年8月13日. https://doi.org/10.6028/NIST.FIPS.204
- National Institute of Standards and Technology (NIST). Stateless Hash-Based Digital Signature Standard. Federal Information Processing Standards Publication (FIPS) 205, 2024年8月13日. https://doi.org/10.6028/NIST.FIPS.205
- David Adrian, David Benjamin, Bob Beck, Devon O'Brien. "A new path for Kyber on the web." Google Online Security Blog, Google, 2024年9月13日. https://security.googleblog.com/2024/09/a-new-path-for-kyber-on-web.html
- Mozilla. "Firefox 132.0 Release Notes." Mozilla Foundation, 2024年10月29日. https://www.mozilla.org/en-US/firefox/132.0/releasenotes/
- Craig Gentry, Shai Halevi. "Implementing Gentry's Fully-Homomorphic Encryption Scheme." EUROCRYPT 2011(Cryptology ePrint Archive, Paper 2010/520). https://eprint.iacr.org/2010/520
- Craig Gentry, Shai Halevi, Nigel P. Smart. "Homomorphic Evaluation of the AES Circuit." CRYPTO 2012(Cryptology ePrint Archive, Paper 2012/099). https://eprint.iacr.org/2012/099
- Léo Ducas, Daniele Micciancio. "FHEW: Bootstrapping Homomorphic Encryption in less than a second." EUROCRYPT 2015(Cryptology ePrint Archive, Paper 2014/816). https://eprint.iacr.org/2014/816
- Ilaria Chillotti, Nicolas Gama, Mariya Georgieva, Malika Izabachène. "TFHE: Fast Fully Homomorphic Encryption over the Torus." Journal of Cryptology, 2020(Cryptology ePrint Archive, Paper 2018/421). https://eprint.iacr.org/2018/421
- Zama. "Bootstrapping TFHE ciphertexts in less than one millisecond." Zama Blog, 2025. https://www.zama.ai/post/bootstrapping-tfhe-ciphertexts-in-less-than-one-millisecond
- Jaiyoung Park, Donghwan Kim, Jongmin Kim, Sangpyo Kim, Wonkyung Jung, Jung Hee Cheon, Jung Ho Ahn. "Toward Practical Privacy-Preserving Convolutional Neural Networks Exploiting Fully Homomorphic Encryption." arXiv:2310.16530, 2023. https://arxiv.org/abs/2310.16530
- Daphné Trama, Pierre-Emmanuel Clet, Aymen Boudguiga, Renaud Sirdey. "At Last! A Homomorphic AES Evaluation in Less than 30 Seconds by Means of TFHE." Cryptology ePrint Archive, Paper 2023/1020. https://eprint.iacr.org/2023/1020
- Rashmi Agrawal, Lake Bu, Alan Ehret, Michel A. Kinsy. "Fast Arithmetic Hardware Library For RLWE-Based Homomorphic Encryption." arXiv:2007.01648, 2020. https://arxiv.org/abs/2007.01648