
はじめに
AI とのロールプレイ、楽しいんですが、長く遊んでいると必ずこの 2 つにぶつかりませんか。
- 記憶がふわっと消える。 20 ターン前に拾った鍵、名前を付けた相棒、NPC と交わした約束。会話が長くなるにつれて、いつの間にかなかったことになっている。
- 設定が崩れる。 「第一次世界大戦から分岐したパラレルワールドのロボット戦記」のように細かい設定で始めても、気づくとスマートフォンや現代の軍制がしれっと混ざってくる。
原因は単純で、LLM にとっての「記憶」がコンテキストウィンドウしかないからです。ウィンドウから押し出されたものは消えるし、世界観のテキストも薄まって、モデルの事前知識(=現代の常識)が勝ってしまう。
この問題を「プロンプトを頑張る」ではなくアーキテクチャで解くことを目標に、個人開発で AI ゲームマスター(GM)のハーネスを作りました。名前は Aisling です。もうひとつのこだわりとして、ただのチャット画面ではなく、画像生成を活用したノベルゲーム(ADV)風の画面で遊べるようにしています。
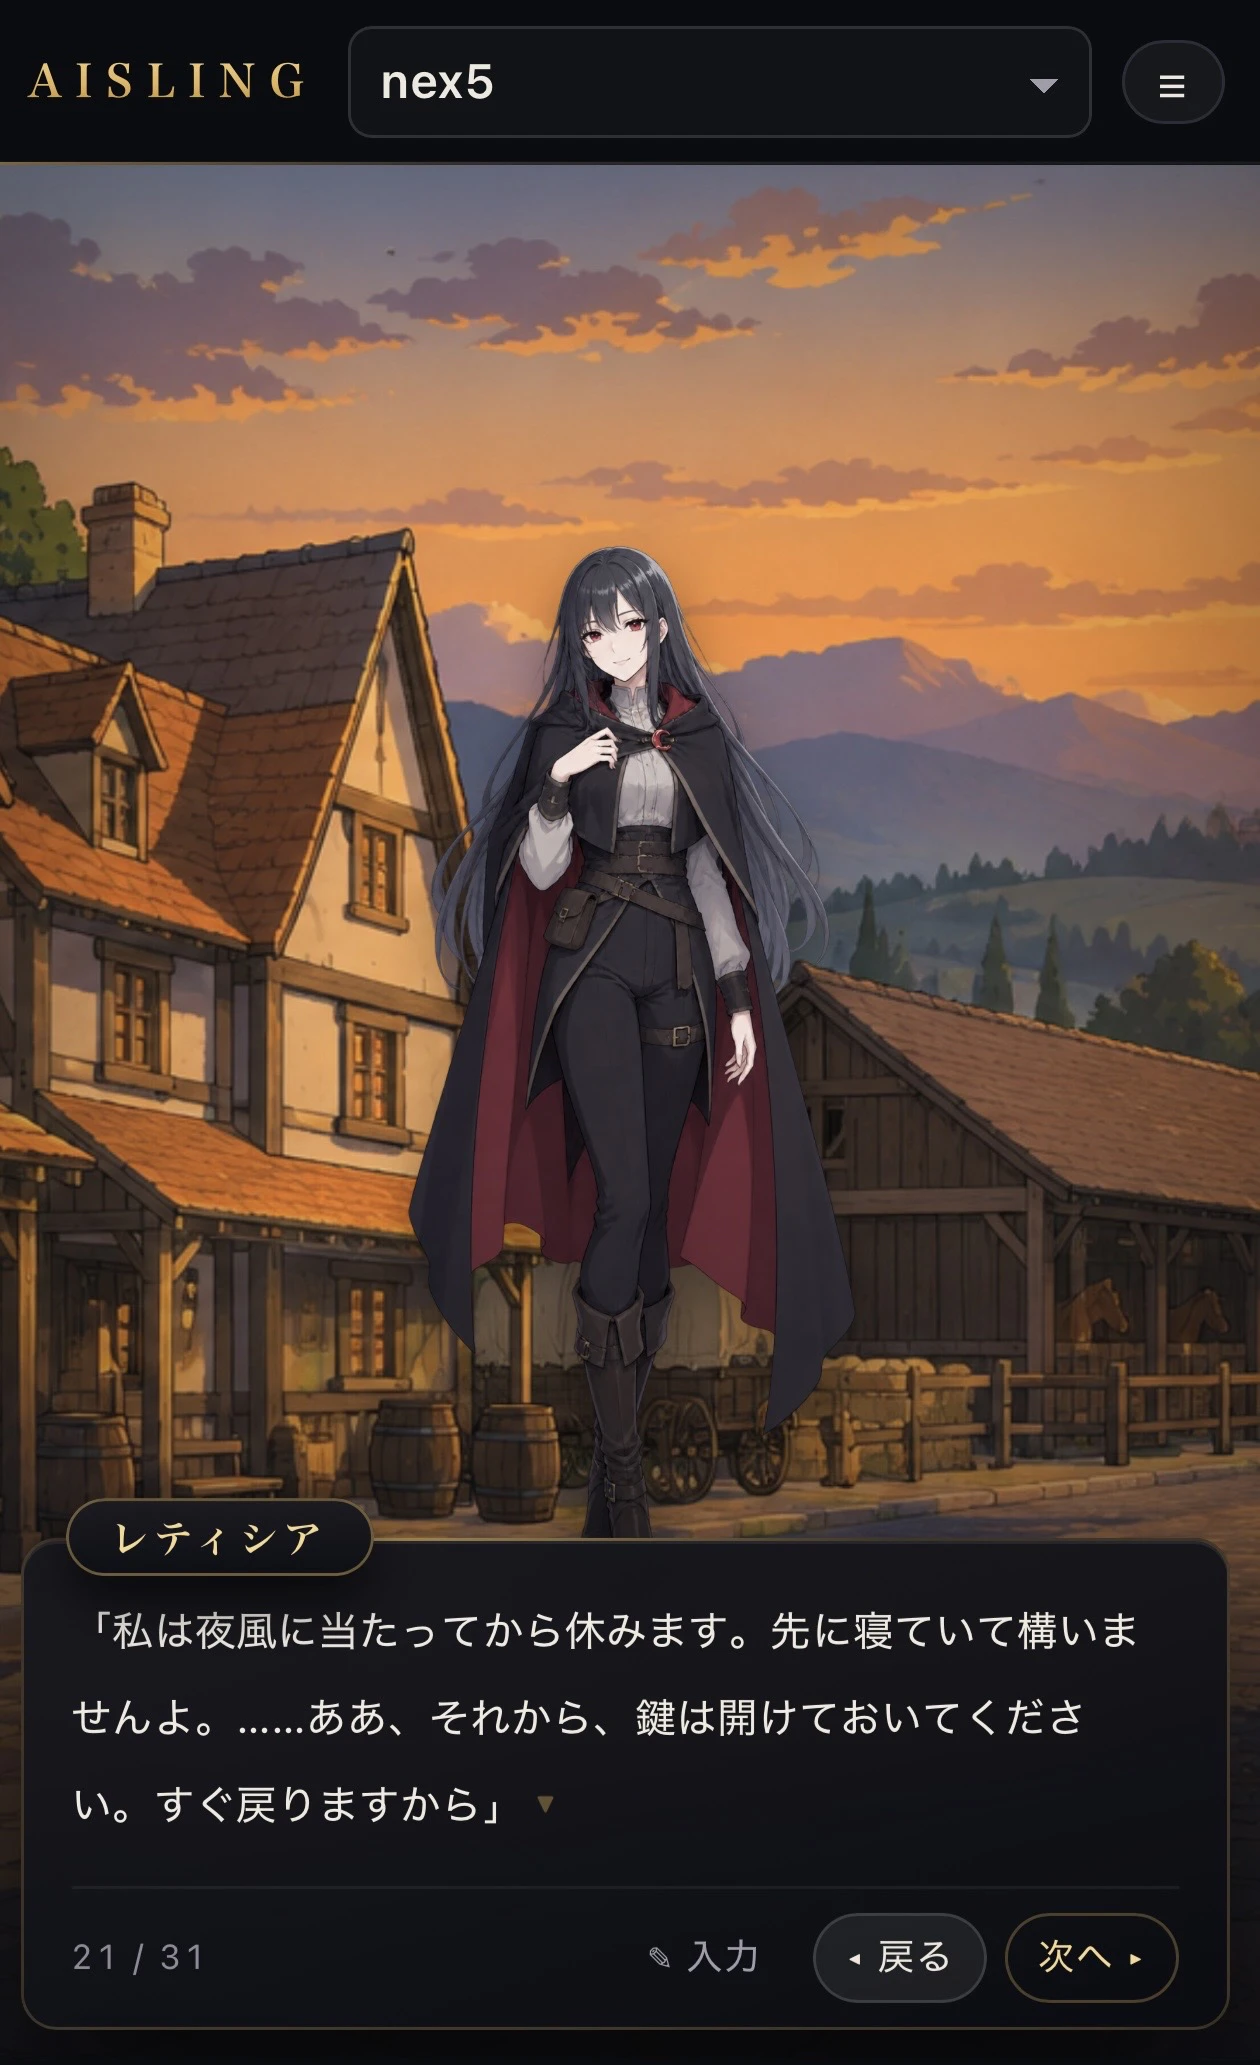
1日あたり50ターンまで無料で遊べます。
(モデル固定、手動での画像生成なし。ADVの生成は通常通り行います)
この記事では、インフラを Cloudflare に統一した構成と、「長期記憶」「設定の一貫性」をどう実現したかの仕組みを、概念図と処理の流れを中心に紹介します。ソースコードそのものよりも、考え方の解説がメインです。
設計の出発点: 「記録していないことは起きなかったことになる」
最初に決めた原則がこれです。
会話履歴はキャッシュにすぎない。正はディスク(永続化された記録)にある。
GM 役の LLM には「大事なことはすべてツールで記録しなさい。記録していないことは、次のターンには起きなかったことになる」というルールで動いてもらいます。人間の TRPG のゲームマスターがキャンペーンノートを取るのと同じで、覚えておく責任を LLM の頭の中からファイルに移すわけです。
記録の種類は役割ごとに分けています。
| 記録 | 中身 | 性質 |
|---|---|---|
| state | 現在地、ゲーム内時刻、HP、所持品、フラグ | 構造化データ(JSON マージパッチで更新) |
| journal | 時系列の出来事 | 追記のみ |
| memory | GM が自由に書くノート(NPC、伏線、プレイヤーの好み…) | ファイル群 |
| documents | 世界設定、前提、PC シート | プレイヤーと GM が共有する資料 |
| summaries | チェックポイントの引き継ぎ要約 | 追記のみ |
| 物語 DB | メインの骨組み、確定した真相、クエスト、手がかり | GM だけが読める非公開記録 |
| プレイログ | 過去の会話 | 追記のみ |
ポイントは、これらすべてが検索対象になること。GM は「あれ、北門の衛兵なんて名前だっけ」と思ったら、推測で埋めるのではなく検索して読みに行きます(後述)。

全体構成: Cloudflare に全部寄せる
言語は TypeScript、インフラは Cloudflare で統一しました。
それぞれの役割は次のとおりです。
- Workers(入口): サインイン(Google ログイン)、画面の配信、API のルーティング。セッションの一覧や世界観プリセットの共有など「セッションをまたぐデータ」は D1 に置きます。
- Durable Objects(DO): 1 セッション = 1 オブジェクト。そのセッションの記録はすべて DO 内蔵の SQLite に入ります。
- Workers AI + Vectorize: 記録の埋め込みと意味検索。
- AI Gateway: LLM 呼び出しを一元化して、プロバイダごとの使用量をまとめて見られるようにします。リクエスト本文はログに残さず、どのセッションの呼び出しかだけをメタデータで付けています。
- Workflows + R2: 画像生成を非同期ジョブとして回し、結果を R2 に置きます。
- Cron: 毎晩、遊ばれたセッションの中身をまるごとバックアップ用バケットへ書き出します。
なぜ Durable Objects なのか
AI ロールプレイのセッションは、「1 つの部屋に 1 人(または少人数)が入って、順番にターンを進める」という、とても ステートフルで直列的 な性質を持っています。これは DO のモデルと相性が抜群でした。
- 部屋ごとに状態が独立している。 他のセッションの記録が混ざる余地がなく、セッションを削除すればそのオブジェクトの中身を丸ごと消せます。
- 直列化がタダで手に入る。 同じ部屋へのリクエストは 1 つのオブジェクトが順に処理するので、「ターンの途中にもう 1 回送信された」をアプリ側で頑張らなくていい。
- SQLite が同期 API で使える。 全文検索(FTS5)の索引も、会話履歴も、同じデータベースに置けます。
もうひとつ大きかったのが アラーム です。LLM の 1 ターンはツール呼び出しを何往復もするので、数分かかることがあります。HTTP リクエストの中でそれを待つのではなく、
- リクエストは「ターンを受け付けた」ことを SQLite に書いて、すぐアラームを鳴らし、202 を返す
- ターン本体はアラームの中で動かす(接続と無関係に動ける)
- 画面は SSE で進捗を受け取る
という形にしました。途中でデプロイが走って DO が再起動しても、「開始済み」のマークが残っているので次に開いたときに「中断」として扱えますし、再実行されたアラームが同じターンをもう一度 LLM に送ることもありません(同じターンを二重に処理しない)。
本題: 長期記憶と一貫性をどう保つか
ここからがメインパートです。仕組みは 3 本柱です。
- ツール呼び出し(エージェント的ループ)で記録を読み書きする
- ハイブリッド検索(FTS5 + Vectorize)で必要な記憶だけを引っ張る
- チェックポイントで会話履歴を「要約 + 記録」に置き換える
1. 1 ターンはツールのループ
GM には、記録を扱うためのツール一式を渡しています。
| ツール | 役割 |
|---|---|
| recall | 全記録の横断検索(キーワード + 意味) |
| read_document | 資料 1 本をまるごと読む |
| get_state / update_state | 構造化された状態の読み書き |
| journal_append / journal_read | 出来事の追記と直近の読み出し |
| memory | 自由形式ノートの作成・編集 |
| story_read / story_begin / story_revise / story_advance | 物語の計画と真相の管理(GM 専用) |
| roll_dice | 本物の乱数 |
| register_npc / set_scene | 人物と場面の登録(画像生成のトリガー) |
| adv_stage | ADV 画面の演出(入退場・立ち位置・背景) |
1 ターンの流れはこうです。
大事なのは、LLM が「自分で検索クエリを書いて」記録を引く ところです。プロンプトに世界設定を全部流し込むのではなく、資料は目次だけを常時渡し、必要な節だけを読みに行かせる二層構成にしています。設定が何万字あってもコンテキストは膨らみませんし、「設定の薄まり」も起きにくくなります。
もう 1 つ、ターン中の書き込みはすべてステージングされます。state、journal、memory、物語 DB、画像の発注、ADV の演出。これらは、そのターンの会話履歴を保存するときに 1 つのトランザクションで一緒に確定 します。API エラーなどでターンが失敗したら全部ロールバックされるので、送り直しても二重に記録されません。画像の生成も、ターンが確定してから始めます(失敗したターンのぶんは生成されない)。
2. ハイブリッド検索: FTS5 + Vectorize + RRF
recall の中身は、2 種類の検索の合成です。
- キーワード側: DO の SQLite に FTS5 の trigram 索引を持っています。trigram なので日本語も形態素解析なしで部分一致できます。固有名詞(「ブラム」「北門」)に強い。
-
意味側: Workers AI の
bge-m3(1024 次元)で埋め込み、Vectorize に入れます。索引は 1 つで、名前空間をセッションごとに分けています。「あのとき衛兵が言ってた噂」のような言い回しの違いに強い。 - 統合: Reciprocal Rank Fusion(RRF)で 2 つのランキングを混ぜます。意味検索側は類似度のしきい値と「トップとの差」で足切りして、無関係な問いに適当なヒットが返るのを防いでいます。
- 返すのは節: ファイル全体ではなく、見出し単位のチャンクを返します。資料側は見出しで分割して索引しているので、「地理 › 北部 › 北門」のような経路ごと返せます。
Vectorize を使って一番ハマったのが 書き込みの反映が非同期で、数分遅れることがある 点でした。「前のターンで書いた記録を、次のターンで意味検索しても出てこない」のは致命的です。そこで、埋め込んだばかりのベクトルは DO の SQLite にも控えておき、索引が追いつくまでは検索時に DO の中で直接コサイン類似度を取るようにしました。索引側の処理済み時刻を見て、追いついたぶんから控えを消していきます。これで「直前に起きたこと」も意味で引けます。
埋め込みのタイミングも工夫していて、ターンのアラームの中だけで行います。ターンの前に「前ターン以降にプレイヤーが編集した資料」を埋め込んでからターンを始め(そのターンが新しい設定を意味で見つけられる)、ターンの後に「そのターンが書いた記録」を埋め込みます。1 回に処理するバッチ数には上限を設け、残りは次のターンに回すことで、アラームのサブリクエスト枠をターン本体に残しています。
3. チェックポイント: 履歴を「要約 + 記録」に置き換える
会話履歴が一定サイズを超えたら、ハーネスが GM に チェックポイント を要求します。これはプレイヤーの発言ではなく運営メッセージで、GM は物語を進めずに次を順番に行います。
- まだ記録していない事実をツールで保存する(現在地、時刻、状態の変化、登場した NPC、伏線、プレイヤーとの約束など)
- リセット後の自分に向けた引き継ぎ要約を書く
要約には固定の見出し(現在のシーン、PC と同行者、進行中のクエストと伏線、主要 NPC、プレイヤーの好み、など)を使わせ、「確認済みの出来事・噂・推測・未実行の予定を区別する」「矛盾はそのまま書き、つじつまを合わせる情報を作らない」といった規約を置いています。
そして会話履歴を空にし、次の発言の先頭に 要約 + 資料の目次 + state + 直近の journal を添えます。つまり LLM から見ると、
「要約を読む → 足りない詳細は recall / read_document で記録から引く → 続きを語る」
という形で再開できる。コンテキストの長さを気にせず、何十セッションでも同じキャンペーンを続けられる構造です。
「設定崩壊」への対策
記憶喪失は上の 3 本柱でかなり抑えられましたが、「現代の要素が混ざる」タイプの崩壊には、追加で 2 つの仕掛けを入れています。
- 物語 DB(GM 専用の非公開記録): メインストーリーの骨組み、確定した真相(追記のみ、上書き不可)、クエスト、手がかりを、専用ツールで保存させます。クエストの決着ごとに「結果と次の計画」を同じトランザクションで保存するので、「あの伏線なんだったっけ」が GM 側で起きません。真相やネタバレは要約にも画像プロンプトにも転記しない規約です。
-
世界観プリセット: 前提・世界設定・PC・NPC(外見つき)・GM のふるまい・GM だけが知る秘密、を 1 セットにしたものです。これが資料として索引されるので、GM は語る前に
recallで「この世界に電話はあるのか」を確かめられます。
正直に言うと、LLM 自体が真相を知って語る以上、漏えいを機械的に 100% 防げるわけではありません。ただ「推測で埋める」のではなく「記録を読みに行く」経路を必ず用意し、記録を正とすることで、崩れ方がかなり穏やかになりました。
ADV 風の画面と画像生成
せっかく記憶が保てるようになったので、見た目にもこだわりました。
-
背景と立ち絵: GM が
set_sceneで場面を登録すると背景が、register_npcで人物を登録すると全身の透過立ち絵が、それぞれ非同期で生成されます。生成は Workflows のジョブ(1 ジョブ 1 インスタンス)で、ターンが確定してから起動し、結果は R2 に置かれます。DO が休止・再起動しても、ジョブは止まりません。 -
演出: GM は
adv_stageで「この段落の前に A が左に入場」「この台詞で B を退場」といったキューを指定します。演出は返信の完了後に再生され、失敗したターンの演出は反映されません。 - 話者タグ: 本文の台詞には話者タグが付くので、画面側は立ち絵を最大 3 人(左・中央・右)並べて、話者だけを明るく、ほかはグレーで表示できます。
- バックログ: 「履歴」から過去の会話を遡れて、そのときの背景と立ち絵も一緒に再現します。

画像が間に合わない間はグリッドの仮想空間やシルエットを出し、できたら自動で差し替わります。
実際に動いている世界観と機能
現在、公式の世界観として 2 つを用意しています。
- 剣と魔法のファンタジー
- 第一次世界大戦から分岐したパラレルワールドのロボット戦記
後者が、まさに冒頭で挙げた「設定が崩れやすい」題材です。時代考証と架空の技術が混ざる世界で、どこまで一貫性を保てるかの実験場でもあります。
加えて、自分のオリジナル世界観を作って共有する機能があります。前提・世界設定・PC・NPC・GM のふるまい・GM だけの秘密を書いてプリセットにし、非公開 / 限定公開(リンクを知っている人だけ)/ 公開のいずれかで置けます。他の人の世界観で遊ぶとき、その人が書いた資料の本文は GM だけが読めて、プレイヤーには名前しか見えません(ネタバレ防止)。公開されたものは新着・人気・お気に入りの棚に並びます。
日本語と英語の両方に対応していて、1 つのセッションの中で複数の LLM プロバイダ(Anthropic / OpenAI / Google)のモデルを切り替えることもできます。別社のモデルへ移るときは、今のモデルが一度要約を書いてから引き継ぐので、ここでもチェックポイントの仕組みが効いています。

おわりに
会員登録なし(Google ログインのみ)で毎日 50 ターン遊べるようにしています。(モデル固定、手動の画像生成は使えません)
「本当に設定や記憶が飛ばないのか?」は、作っている自分が一番知りたいところです。
- 30 ターン前に拾った小物の名前を、急に聞いてみる
- ロボット戦記の世界で、わざと現代のものを持ち出してみる
- 自分だけの、やたら細かい設定の世界を作って遊んでみる
ぜひ無茶振りして、壊しにきてください。壊れたら教えてもらえると、次の改善につながります(。•ᴗ•。)