
はじめに
LLM に毎回同じ長いシステム指示や参考資料を渡すと、「この部分はさっきも送ったのに、毎回同じ費用がかかるのかな?」と気になります。
そこで今回は、OCI Enterprise AI の Responses API に実際にリクエストを送り、Prompt Caching が使われたことを API の応答で確認してみました。速度だけで判断せず、キャッシュされた入力 token 数を読み取ります。
結論から言うと、今回の環境では xai.grok-4.3 と openai.gpt-oss-120b の両方でキャッシュ命中を観測しました。ただし、命中と料金の割引は分けて確認する必要がありました。
この記事では、次の内容を紹介します。
- Prompt Caching の仕組みと、回答そのもののキャッシュとの違い
-
.envとmodel-settings.jsonを使う Python の検証コード - 2モデル・24リクエストの実行結果と、成功しなかったパラメーター
- OCI の普通入力/キャッシュ入力の価格差と、実測値に基づく試算
検証日は 2026年11月5日です。以下の表は実測値であり、モデル全体の性能保証ではありません。
1. Prompt Caching とは?
長い資料を読む作業を考えると分かりやすいです。1回目に資料を読み、2回目に同じ資料で別の質問をするとき、資料の読み直しに相当する計算の一部を再利用できる仕組みが Prompt Caching です。技術的には、共通する入力の先頭部分を処理した中間状態を再利用します。
前の回答をそのまま返す「回答キャッシュ」とは異なり、回答の生成は毎回行います。 そのため、入力の一部がキャッシュされても、出力 token の費用がなくなるわけではありません。
静的な指示や資料を先頭へ、変化する質問を後ろへ置くと、共通部分を保ちやすくなります。一方、キャッシュの保持やルーティングによって、同じ入力でも命中が保証されるとは限りません。これは一般的な仕組みの説明です。xAI 直接 API の推奨ヘッダーや保持条件が、そのまま OCI にも適用されるとは扱いません。xAI の Prompt Caching 解説
OCI の Grok 4.3 の公式説明にも cached input token の対応が記載されています。今回は、その記載に加えて、OCI の Responses API から実際の使用量を取得して確認しました。Oracle: xAI Grok 4.3
2. 今回の検証条件
| 項目 | 設定 |
|---|---|
| Python | 3.12 |
| 呼び出し | OCI 公式の推論エンドポイントの POST /openai/v1/responses
|
| 認証 |
.env の接続別 API key と JSON の Project OCID |
| モデル |
xai.grok-4.3 / openai.gpt-oss-120b
|
| 入力 | 公開可能な合成データ170行。実測 3,488 / 3,539 tokens |
| 出力上限 | リクエストには max_output_tokens=128 を指定 |
| 推論設定 | 両モデルとも reasoning.effort=low
|
| 保存 |
store=false、過去の response ID は不使用 |
| 繰り返し | 各モデル12回。自動リトライなし、リクエスト間に約1秒待機 |
| 計時 | HTTP 応答全体の所要時間。TTFT は未計測 |
設定ファイルには別サービスの互換エンドポイントを使う3モデルもありましたが、OCI の検証対象から除外し、呼び出していません。また、初回にも少量の cached token があったため、「完全なコールド状態を作った」とは言えません。
store=false は応答保存の設定です。今回、それを指定していてもキャッシュ token を観測できました。保存された会話の再利用と Prompt Caching は分けて考えます。
3. .env とモデル JSON を準備する
プロジェクトでは、秘密情報を .env、モデル名や接続先などを model-settings.json に分けています。検証コードは既存ファイルを読み取るだけで、設定を書き換えません。
PLATFORM_MODEL_SETTINGS_FILE=model-settings.json
PLATFORM_OCI_ENTERPRISE_AI_API_KEY=<primary-api-key>
PLATFORM_OCI_ENTERPRISE_AI_SECONDARY_API_KEY=<secondary-api-key>
JSON の最小構成は次のとおりです。<region> と Project OCID は自分の値に置き換えてください。サンプルには実際の接続先や秘密情報を入れていません。
{
  "version": 6,
  "enterprise_ai": {
    "api_path": "/responses",
    "connections": [
      {
        "connection_id": "primary",
        "endpoint": "https://inference.generativeai.<region>.oci.oraclecloud.com/openai/v1",
        "project_ocid": "<your-project-ocid>"
      }
    ],
    "models": [
      {
        "model_id": "xai.grok-4.3",
        "connection_id": "primary",
        "reasoning_effort": "low"
      }
    ]
  }
}
もう一方のモデルも測る場合は、同梱の model-settings.example.json を使います。JSON の接続設定を使い、API key だけを接続 ID に対応する環境変数から取得します。プロセスの環境変数は .env より優先します。PLATFORM_MODEL_SETTINGS_FILE の相対パスは .env のディレクトリから解決します。
OCI の公式資料では、互換 API の base URL、API key、Project OCID を指定して Responses API を呼び出す構成が説明されています。Oracle: OCI Responses API
4. Python で実際に呼び出す
全ソースは ZIP 内の probe.py にあります。重要な部分は、同じリクエストを送って、返された usage をそのまま保存するところです。
import httpx

with httpx.Client(timeout=180, follow_redirects=False) as client:
    response = client.post(
        endpoint.rstrip("/") + "/responses",
        headers={
            "Authorization": f"Bearer {api_key}",
            "OpenAI-Project": project_ocid,
            "Content-Type": "application/json",
        },
        json={
            "model": model_id,
            "input": [
                {"role": "system", "content": fixed_prefix},
                {"role": "user", "content": question},
            ],
            "reasoning": {"effort": "low"},
            "max_output_tokens": 128,
            "store": False,
        },
    )
    response.raise_for_status()
    usage = response.json().get("usage", {})
    details = usage.get("input_tokens_details", {})
    cached_tokens = details.get("cached_tokens")
    print({"usage": usage, "cached_tokens": cached_tokens})
上は要点の抜粋です。完全版では認証情報をログに出さず、HTTP 400 の本文も脱敏して保存します。キャッシュ項目がない場合を 0 に置き換えず、「情報不足」と判定するようにしました。
実行手順は次のとおりです。--output は既存の記録を上書きしないよう、新しいディレクトリを指定します。
uv venv --python 3.12
uv pip install --python .venv/bin/python -r requirements.txt
cp .env.example .env
cp model-settings.example.json model-settings.json
# .env と model-settings.json に自分の設定を入れる
.venv/bin/python -m unittest -v test_probe.py
.venv/bin/python probe.py --env-file .env --output results-new
.venv/bin/python make_report.py --results results --output report.html
既存プロジェクトの設定を使う場合は、次のように指定できます。
.venv/bin/python probe.py --env-file /path/to/project/platform/.env --output results-new
実測では、既存の Python 環境を利用して次のコマンドを実行しました。
rag/backend/.venv/bin/python tmp/oci-prompt-cache/probe.py --env-file platform/.env --output tmp/oci-prompt-cache/live-results
5. 実行結果:両モデルで命中を確認
ケースは以下の順に実行しました。
- A の初回入力と、同一入力の繰り返し2回
- 固定資料を保ち、末尾の質問だけ変更2回
- 資料先頭付近の識別子を B に変更し、同じ B を再送
- A に戻す
- 同じ
prompt_cache_keyを付けて2回 -
prompt_cache_retention="in-memory"を加えて2回
同一入力の繰り返しで返された usage の実例です。
{
  "model": "xai.grok-4.3",
  "case": "A_repeat_1",
  "usage": {
    "input_tokens": 3488,
    "output_tokens": 151,
    "total_tokens": 3639,
    "input_tokens_details": {"cached_tokens": 3456},
    "output_tokens_details": {"reasoning_tokens": 149}
  }
}
ここでの model と case は、応答の usage に検証用のラベルを付けたものです。元の応答全体は ZIP の results/model-01/02-A_repeat_1.response.json に保存しています。
input_tokens=3488 のうち 3456 がキャッシュ由来なので、この要求の入力 token の約99.08%でキャッシュが観測されています。
以下は全24回の結果です。秒数は小数第3位まで記録しました。
| モデル | ケース | HTTP | 入力 | cached | 出力 | 全体秒数 |
|---|---|---|---|---|---|---|
| xai.grok-4.3 | A_initial | 200 | 3488 | 128 | 131 | 2.071 |
| xai.grok-4.3 | A_repeat_1 | 200 | 3488 | 3456 | 151 | 1.897 |
| xai.grok-4.3 | A_repeat_2 | 200 | 3488 | 3456 | 156 | 1.868 |
| xai.grok-4.3 | A_suffix_1 | 200 | 3488 | 128 | 125 | 1.812 |
| xai.grok-4.3 | A_suffix_2 | 200 | 3488 | 128 | 205 | 2.062 |
| xai.grok-4.3 | B_prefix_change | 200 | 3488 | 128 | 137 | 1.674 |
| xai.grok-4.3 | B_repeat | 200 | 3488 | 3456 | 137 | 1.495 |
| xai.grok-4.3 | A_return | 200 | 3488 | 3456 | 150 | 1.941 |
| xai.grok-4.3 | cache_key_1 | 200 | 3488 | 3456 | 159 | 1.853 |
| xai.grok-4.3 | cache_key_2 | 200 | 3488 | 3456 | 198 | 2.180 |
| xai.grok-4.3 | retention_1 | 400 | — | — | — | 0.185 |
| xai.grok-4.3 | retention_2 | 400 | — | — | — | 0.164 |
| openai.gpt-oss-120b | A_initial | 200 | 3539 | 64 | 18 | 0.178 |
| openai.gpt-oss-120b | A_repeat_1 | 200 | 3539 | 3536 | 20 | 0.114 |
| openai.gpt-oss-120b | A_repeat_2 | 200 | 3539 | 3536 | 18 | 0.112 |
| openai.gpt-oss-120b | A_suffix_1 | 200 | 3539 | 3520 | 18 | 0.110 |
| openai.gpt-oss-120b | A_suffix_2 | 200 | 3539 | 3520 | 18 | 0.110 |
| openai.gpt-oss-120b | B_prefix_change | 200 | 3539 | 96 | 18 | 0.165 |
| openai.gpt-oss-120b | B_repeat | 200 | 3539 | 3536 | 18 | 0.109 |
| openai.gpt-oss-120b | A_return | 200 | 3539 | 3536 | 18 | 0.108 |
| openai.gpt-oss-120b | cache_key_1 | 200 | 3539 | 3536 | 18 | 0.106 |
| openai.gpt-oss-120b | cache_key_2 | 200 | 3539 | 3536 | 18 | 0.106 |
| openai.gpt-oss-120b | retention_1 | 400 | — | — | — | 0.015 |
| openai.gpt-oss-120b | retention_2 | 400 | — | — | — | 0.010 |
同じ質問をそのまま再送したケースでは、両モデルとも大きなキャッシュ命中を観測しました。
一方、末尾の質問だけ変更したケースでは差がありました。gpt-oss-120b は3,520 tokensがキャッシュ由来でしたが、Grok 4.3 は128 tokensでした。今回の結果から、Grok 4.3 で長い資料の前方一致が必ず再利用されるとは言えません。ルーティングや内部の処理が原因かどうかも、この応答だけでは特定できません。
速度は補助情報です。たとえば Grok 4.3 は初回2.071秒、同一入力の再送1.897秒でしたが、出力 token 数も変わっています。少数試行であり、統計的な高速化率や TTFT の改善は主張しません。
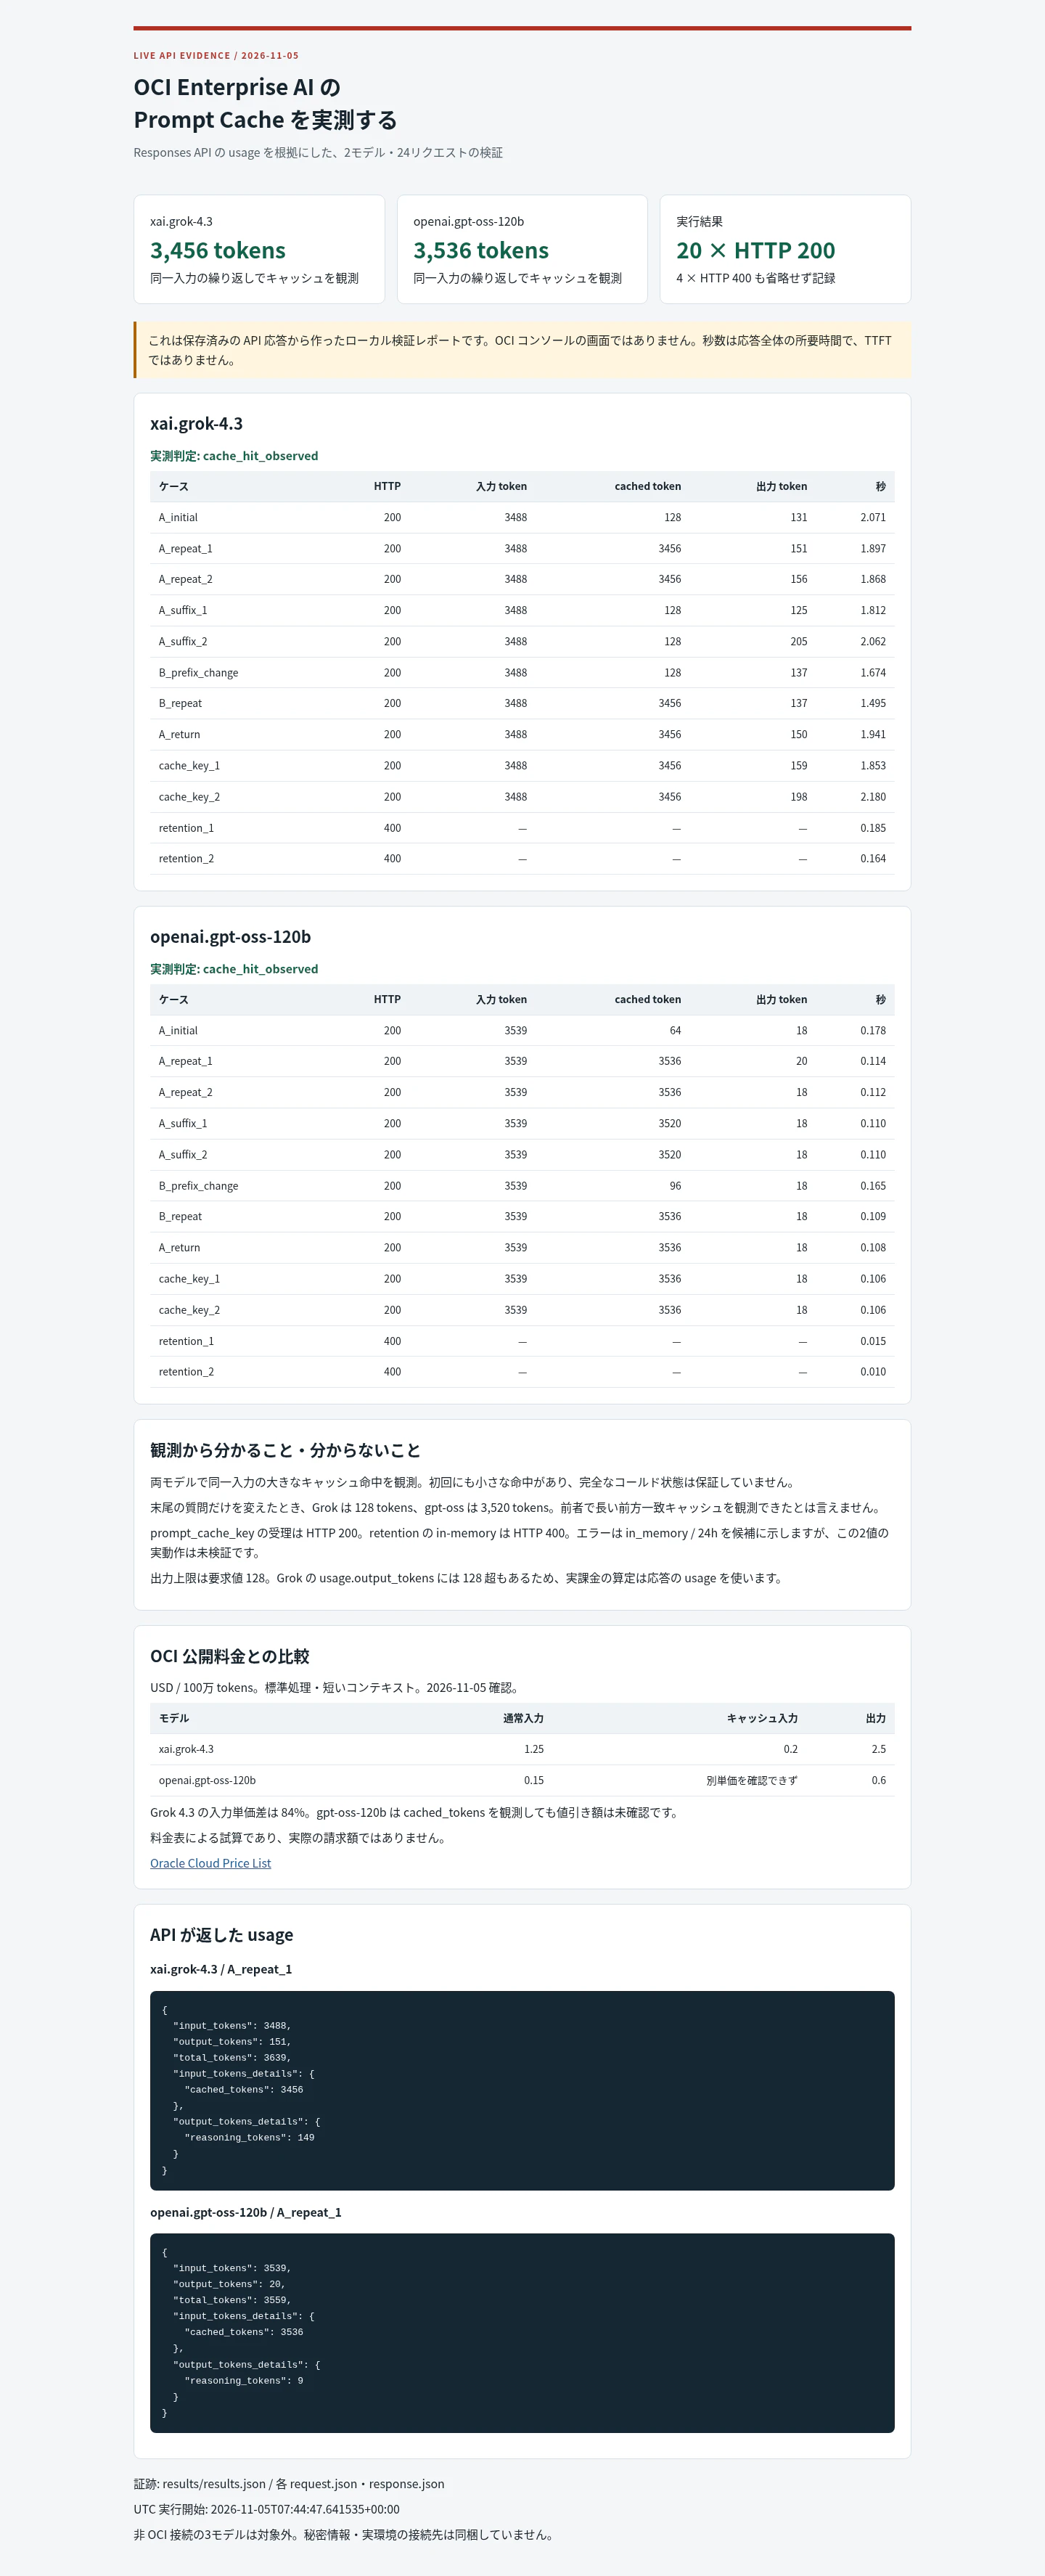
上の画像は、保存済み API 応答から作った HTML を実際にブラウザで開いて撮影したものです。OCI コンソールの画面ではありません。
6. キャッシュ用パラメーターの落とし穴
prompt_cache_key を付けた要求は、両モデルで HTTP 200 になりました。ただし、キーなしでも既に命中しているため、この結果だけでキーのルーティング効果や必須性を証明したとは扱いません。
prompt_cache_retention="in-memory" は、両モデルとも HTTP 400 でした。返されたエラーは次のとおりです。
unknown variant `in-memory`, expected `in_memory` or `24h`
このエラーは「キャッシュ非対応」を意味しません。指定値のハイフンとアンダースコアの違いが問題でした。 今回の呼び出し上限に達したため、in_memory と 24h の受理・保持時間・課金は追加実測していません。
同梱コードの既定値は実測の再現用として in-memory を保っています。後続検証では --retention-value in_memory または --retention-value 24h を指定できますが、その結果は本記事の実測表には含めません。
なお、max_output_tokens=128 を要求しましたが、Grok の usage.output_tokens には128超の応答もありました。指定値が実際の使用量を必ず128以下に抑えた、とは言えません。料金計算は応答の実測 usage を使います。
7. OCI の料金:キャッシュなしとありで何が変わる?
2026年11月5日に Oracle Cloud Price List と Oracle の公開価格 JSON を確認しました。以下は USD、Pay As You Go、100万 tokens あたりの公開価格です。Grok は今回の約3,500入力 tokensに対応する標準・短いコンテキストの価格を使います。Priority の単価ではありません。
| モデル | 普通入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| Grok 4.3 | US$1.25 | US$0.20 | US$2.50 |
| gpt-oss-120b | US$0.15 | 独立した単価を確認できず | US$0.60 |
確認した SKU は Grok が B112080 / B112081 / B112082、gpt-oss が B112004 / B112005 です。抽出した公式データは pricing-source.json、計算用の値は pricing.json に残しています。
Grok 4.3 のキャッシュ部分の入力単価は、普通入力に対して 84%低い計算です。
1 - 0.20 / 1.25 = 0.84
これは「リクエスト全体の費用が84%安くなる」という意味ではありません。キャッシュされない入力と出力はそれぞれの単価で計算します。
N = 入力 token 数(キャッシュ分を含む)
C = cached token 数
O = 出力 token 数

キャッシュなしの仮定:
  N × 普通入力単価 / 1,000,000 + O × 出力単価 / 1,000,000

実測のキャッシュ量を適用:
  (N-C) × 普通入力単価 / 1,000,000
  + C × キャッシュ入力単価 / 1,000,000
  + O × 出力単価 / 1,000,000
実測の A_repeat_1 を例にすると、Grok 4.3 は N=3488、C=3456、O=151 でした。
| 計算対象 | キャッシュなしの仮定 | 実測キャッシュ量を適用 |
|---|---|---|
| 入力費用 | US$0.0043600 | US$0.0007312 |
| 出力費用 | US$0.0003775 | US$0.0003775 |
| 合計 | US$0.0047375 | US$0.0011087 |
この1回では、合計の試算差は約76.60%です。出力の reasoning token は API の output_tokens に含まれるので、再度足して二重計上しません。キャッシュなし側は同じ入出力 token 数を通常単価で計算した反実仮想であり、キャッシュを強制無効化して実測した請求ではありません。
成功した Grok の10回分を合算すると、入力34,880、キャッシュ21,248、出力1,549 tokensでした。公開単価での合計は、キャッシュなしの仮定で US$0.0474725、実測キャッシュ量を適用すると US$0.0251621 です。計算は cost_example.py で再現できます。
gpt-oss-120b は、キャッシュ命中を観測しましたが、確認した公式一覧に独立したキャッシュ入力単価がありません。したがって、キャッシュ分を無料や割引とは仮定しません。入力の全量を普通入力単価で計算する参考額は出せますが、キャッシュによる料金差は未確認です。
これらは公開単価による試算で、請求書との照合結果ではありません。税・契約割引・通貨換算・追加のサービス料金は含めず、HTTP 400 の課金の有無も確認していません。価格表にはコンテキスト境界の表記差もあるため、本記事では十分小さい入力のケースに限定しています。利用前には最新の料金表と契約条件を確認してください。
8. 分かったこと
今回、OCI の Responses API 経由で、Grok 4.3 と gpt-oss-120b の両方に cached_tokens > 0 があることを実測できました。キャッシュ対応の確認には、体感速度より usage の記録が役立ちます。
実装では固定部分を安定させ、質問を後ろに置き、毎回 input_tokens・cached_tokens・output_tokens を記録する構成にすると、効果を後から確認できます。