
初めに
RAGの検索には、意味で探すベクトル検索と、語で探す全文検索があります。この2つを組み合わせるのが混合検索です。
自作のProduction Ready Suiteでは、次の2方式を選べます。
- OracleのHybrid Vector Indexを利用する
oracle_hybrid_index - ベクトル検索と全文検索を個別に実行する
oracle_separate_sql
名前だけを見ると、「Oracleに全部任せる方式」と「Sudachiだけで検索する方式」に見えるかもしれません。実装を読むと、それだけでは説明できませんでした。
そこで、40件の合成記録と24問を固定し、同じembeddingを使って検索結果を比べました。 本稿では、現在の実装、比較条件、実際に返った順位を紹介します。
確認日は2026年11月12日です。資料・質問・識別子はすべて合成データです。掲載画像は今回新しく撮影したデスクトップ画面で、アカウントや内部ID、接続先の情報はマスクしています。
先に整理:「DBを使わない方式」ではない
どちらもOracle AI Databaseを使います。 Sudachiは検索結果を保存するDBでも、ベクトル検索エンジンでもありません。日本語を分割・正規化する形態素解析器です。SudachiPyの公式資料でも、分割モードと正規化形を確認できます。
現在の実装の違いは、主に次です。
| 比較するもの | Oracleネイティブ方式 | Sudachi+個別SQL方式 |
|---|---|---|
| 設定値 | oracle_hybrid_index |
oracle_separate_sql |
| 全文検索の索引 | Hybrid Vector Indexのテキスト側 | 通常のOracle Text索引 |
| ベクトル検索 | ネイティブ索引、または小範囲の厳密検索 | Oracle AI Vector SearchのSQL |
| 検索の入口 |
DBMS_HYBRID_VECTOR.SEARCHなど |
VECTOR_DISTANCEとCONTAINSを個別に実行 |
| 順位の扱い | DBの経路順位を受け取り、閾値や重みに沿って寄与を計算 | 取得した2経路の順位をアプリ側で融合 |
| 日本語の検索式 | 現在はSudachiの共通処理を再利用 | 同じ共通処理を使用 |
| データの保存先 | Oracle AI Database | Oracle AI Database |
今回比較する製品実装では、Oracleネイティブ方式にもSudachiが使われます。 「Sudachiの有無」だけを比較する試験ではありません。
1. まず共通部分を見る
混合検索の前に、文書を解析してchunkへ分け、embeddingを作ります。本製品はOCI Generative AIで作ったembeddingを保存し、検索時にも同じモデルで質問のembeddingを作ります。
ネイティブ方式だから、DBの中で毎回embeddingを生成するわけではありません。
なお、ネイティブ索引が未準備ならエラーとして扱い、個別SQL方式へ自動で切り替えません。後述する小範囲の厳密検索は、準備不足を隠すための切替ではありません。
保存したchunkには、本文に加えて、文書、解析版、元要素、位置などの情報があります。検索結果から原文へ戻るための情報は、検索方式を変えても必要です。
2. Oracleネイティブ方式の実装
OracleのHybrid Vector Indexは、全文検索とベクトル検索を組み合わせる索引です。検索にはJSON形式の要求を受け取るDBMS_HYBRID_VECTOR.SEARCHを使えます。Oracleの公式ガイド
保存済みの本文とvectorを索引へ渡す
本製品のrag_chunksには、検索用の本文とembeddingがあります。同期トリガーが、次の構造のhybrid_payloadへまとめます。
# 保存する構造の概念例。vectorは既に作ったものを渡す。
payload = {
    "text": search_text,
    "embedding": embedding,
}
このJSON列にHybrid Vector Indexを作ります。実装で使うDDLの要点です。
CREATE HYBRID VECTOR INDEX RAG_CHUNKS_HYBRID_IDX
    ON rag_chunks (hybrid_payload)
    PARAMETERS ('VECTORIZER RAG_CHUNKS_HYBRID_PREF
        LEXER RAG_TEXT_WORLD_LEXER STOPLIST RAG_TEXT_STOPLIST
        SEARCH_ON TEXT MAINTENANCE MANUAL SYNC (ON COMMIT)');
これは説明のための抜粋です。既存環境へ手動で作り直すコマンドではありません。実際の管理処理は、既存の列・preference・同期トリガー・索引を合わせて扱います。
JSON要求で検索し、経路の順位を取り出す
検索要求では、検索範囲、vector、全文式、取得件数などを指定します。混合検索ではUNIONとWRRFを使います。
SEARCHの仕様には、融合方式、text.contains、search_vector、順位、検索範囲のパラメーターが定義されています。
SELECT n.vector_rank, n.text_rank, n.vector_score, n.text_score
FROM JSON_TABLE(
    DBMS_HYBRID_VECTOR.SEARCH(JSON(:native_spec)),
    '$[*]' COLUMNS (
        vector_rank NUMBER PATH '$.vector_rank',
        text_rank NUMBER PATH '$.text_rank',
        vector_score NUMBER PATH '$.vector_score',
        text_score NUMBER PATH '$.text_score'
    )
) n;
製品ではさらに、返されたrowidを元のchunkへ結び付けます。権限・対象KB・文書の版などの条件も維持します。
小さな検索範囲では、別の分岐がある
ここが、今回の実装を調べて分かった重要な点です。
RAG_NATIVE_VECTOR_EXACT_MAX_CHUNKSの範囲内では、ベクトル側を対象行の厳密な距離順で読みます。全文側にはネイティブAPIを使い、得られた順位を合わせます。
今回の実環境の設定値は50,000件で、比較対象は40件です。そのため、既定のネイティブ方式はこの小範囲の厳密検索経路を使いました。
「ネイティブ方式を選んだので、必ず1回のHybrid Search APIだけで全処理が終わる」とは限りません。本稿では、この既定経路を主比較とし、設定を検証プロセス内だけで0にしたネイティブ索引経路も、代表3問で追加確認します。
3. Sudachi+個別SQL方式の実装
質問を、そのまま全文検索へ渡さない
日本語の質問から、SudachiのCモードとAモード、正規化形・表層形などを使って検索語を作ります。さらに、型番や文字種の境界、送り仮名の違いなどを補います。
たとえば、今回の実行環境では次の質問から、次の語が得られました。
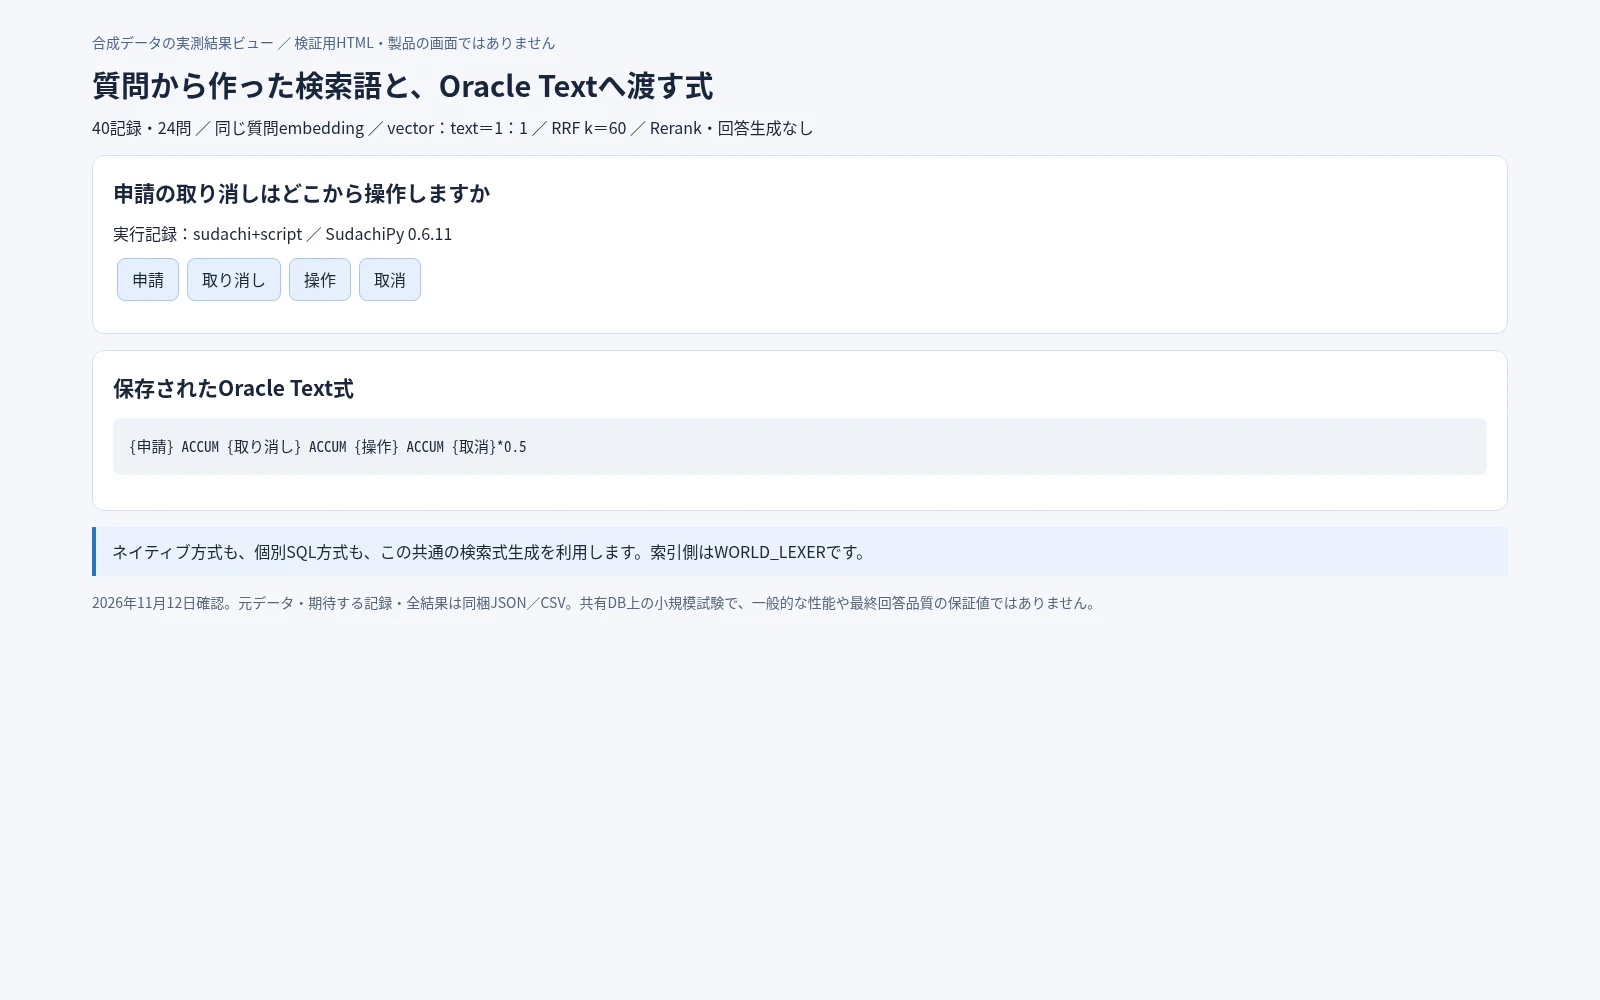
質問:申請の取り消しはどこから操作しますか

申請 / 取り消し / 操作 / 取消
これはLLMが検索文を作り直した結果ではありません。現在のtokenizerが作る検索語です。
Oracle Textへは、語をACCUMで結んだ重み付きの式を渡します。使用する式やtokenの取捨選択は、今回の記録にも保存しています。
索引側のlexerはWORLD_LEXERです。SudachiがDBの索引を作り直す実装ではありません。
ベクトル検索と全文検索を並行に実行する
ベクトル側はVECTOR_DISTANCEによる検索、全文側はCONTAINSを使います。実装の形は次のようになります。
vector_hits, keyword_hits, citation_hits = await asyncio.gather(
    self.vector_search(embedding, top_k, filters, query=query),
    self.keyword_search(query, top_k, filters),
    self.citation_label_search(query, filters),
)
引用ラベルの検索も製品にはありますが、今回の合成CSVには該当するラベルを持たせていません。主にベクトルと全文の2経路を比較します。
それぞれの経路で候補を取り、chunk IDをキーにまとめ、RRFで順位を融合します。
raw scoreを足すのではなく、順位を使う
コサイン類似度とOracle Textのスコアは尺度が違います。そこで、検索の順位を使います。
RRFの寄与 = 経路の重み / (k + 経路内の順位)
今回の比較は、ベクトルと全文を1:1、k=60へそろえました。
ネイティブ方式と個別SQL方式では、返すスコアの正規化や、同点順位の表し方が同じとは限りません。そのため、方式間のraw scoreの大小を正解率のようには比較していません。正解記録が何番目に返るかを比べます。
4. 同じ合成データで比較する
40件の記録と24問を先に固定する
合成CSVには、1記録ずつ別の資料IDを持たせました。
- 型番の似た機器:
AX-410とAX-401 - 設定値の異なる版:
v2.4とv2.5 - 表記の違い:取り消し/取消、プリンタ/プリンター
- 意味による言い換え:大きなファイルを相手へ渡したい、消したファイルを戻したい
- 近い語を使う別の内容:監視のmonitorと画面のmonitor
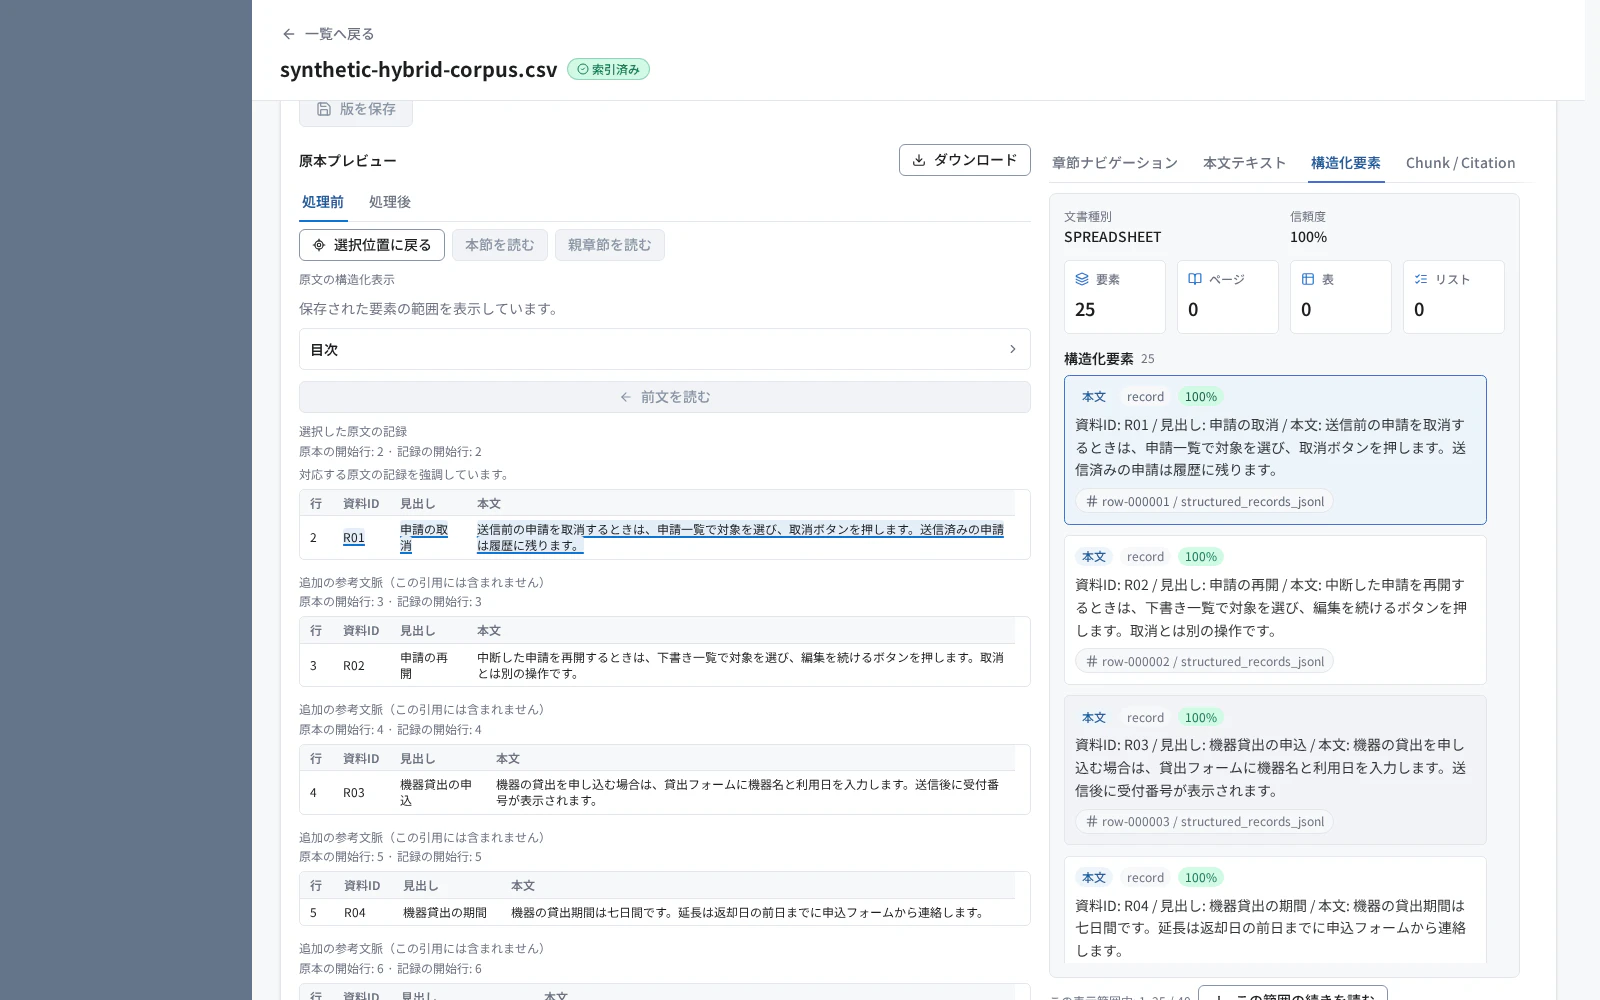
24問と期待する資料IDは、検索結果を見る前に固定しました。各問の正解は1記録です。
| 質問の区分 | 件数 | 見ること |
|---|---|---|
| 型番・版・識別子など | 8 | 似た文字列を区別できるか |
| 日本語の表記違い | 8 | 分割・表記の違いを含む質問で届くか |
| 意味による言い換え | 8 | 原文と異なる表現から届くか |
比較条件
| 条件 | 今回の指定 |
|---|---|
| 資料と質問 | 40記録、24問。両方式で同じものを使用 |
| 検索範囲 | 今回の文書・KBと、content_kind=record
|
| Embedding | Cohere Embed v4、1536次元。質問vectorは保存して共用 |
| 各経路の取得件数 | 10件。比較する最終順位は両方式とも上位10件へ統一 |
| 融合 | ベクトル:全文=1:1、RRFのk=60
|
| コサイン類似度の下限 | 0.2 |
| ベクトル検索の目標accuracy | 100。厳密検索を保証する指定ではない |
| ネイティブの小範囲分岐 | 既定50,000件。補助確認だけ0を指定 |
| 主比較 | 各24問を1回ずつ。最大2検索を同時実行 |
| 別の処理 | LLMによる検索文の生成、Rerank、回答生成は対象外 |
| SudachiPy | 0.6.11。実行記録はsudachi+script
|
実環境の融合比率は10:1ですが、今回は経路を比べるために1:1へ固定しました。個別SQL経路のrawな融合は等重みのRRFで、ネイティブ経路も1:1に合わせています。これはオンライン回答全体の既定設定をそのまま比較した結果ではありません。
比較ではOracleClient.hybrid_searchを直接呼び出しました。オンラインのRAG検索やChatの全工程を通した比較ではありません。
全体の検索設定は保存・変更していません。Settings.model_copy(...)で、比較用のOracleClientにだけ設定を渡しています。
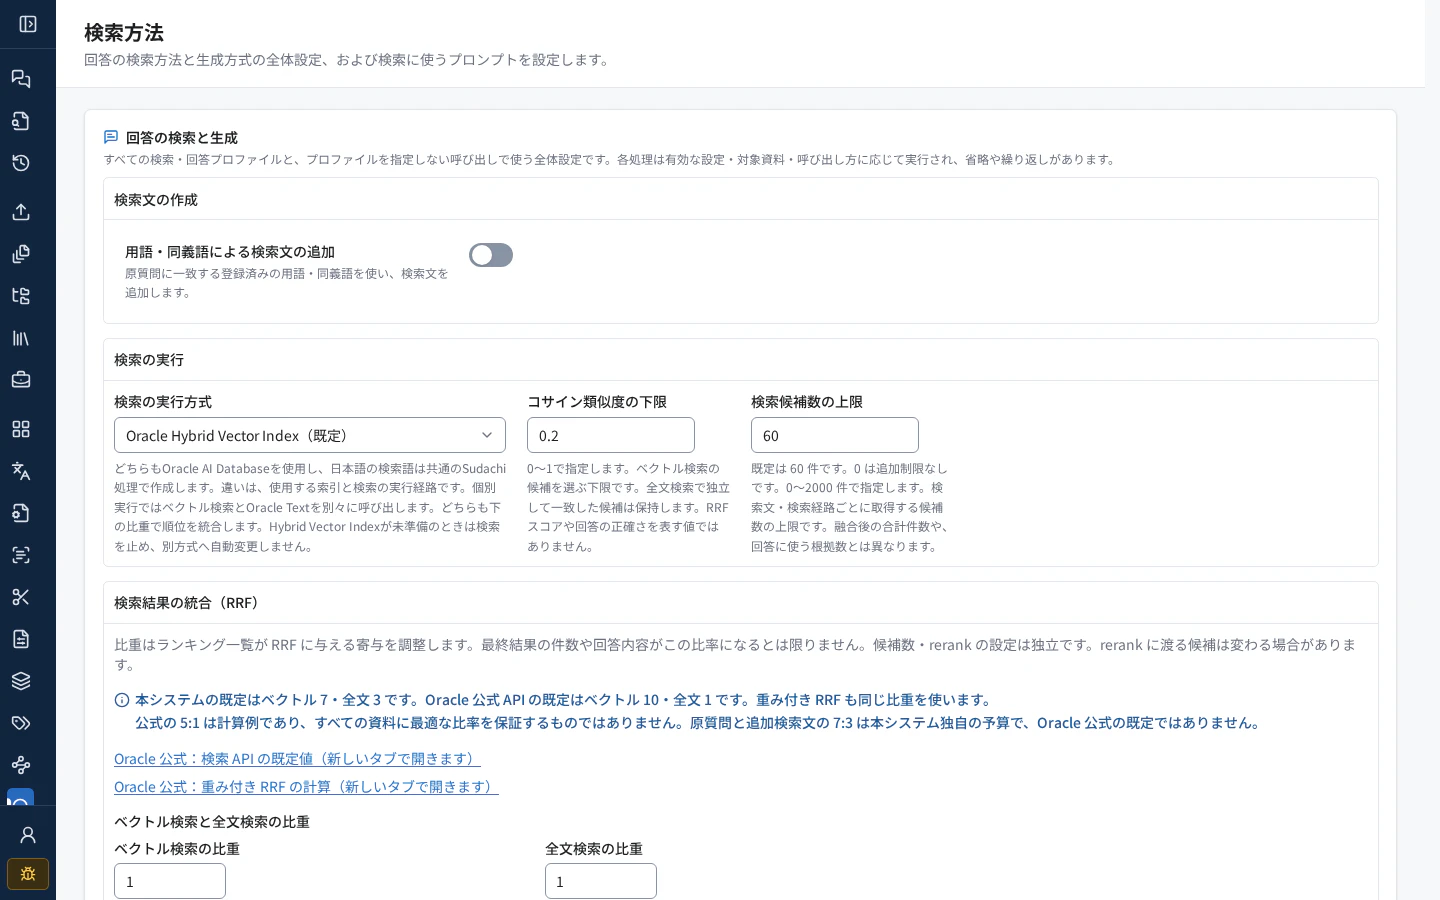
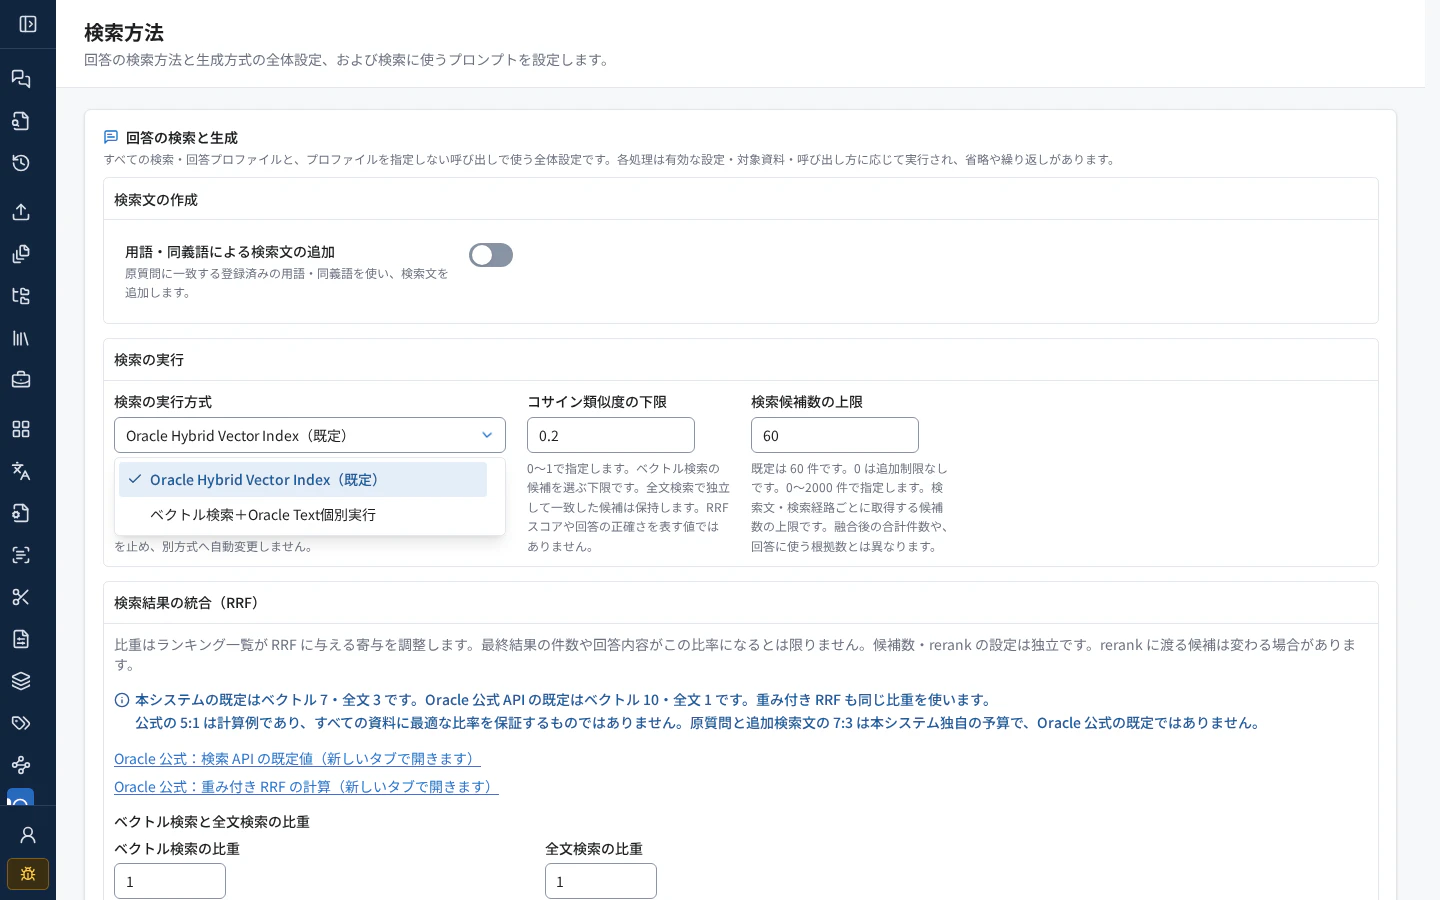
設定画面の選択肢は「Oracle Hybrid Vector Index(既定)」と「ベクトル検索+Oracle Text個別実行」です。検索語の生成が共通であることを説明し、索引・検索経路の違いを名前にしています。内部の設定値もoracle_hybrid_indexとoracle_separate_sqlへ統一しています。
次の2枚は改修版の画面を合成APIで確認した画像です。表示値は試験用で、実環境の設定を変更した画像ではありません。本文の検索比較は前述の実Oracle・OCIによる計測結果です。
付録の実測JSONは測定時の記録を保つため、backend列に当時の識別子oracle_nativeとsudachiが残っています。それぞれ現在のoracle_hybrid_indexとoracle_separate_sqlに対応します。再実行スクリプトは現在の設定値を使います。
今回は、回答の作文を比べない
質問のembeddingを一度作って保存し、両方式へ同じvectorを渡します。質問のLLMによる書き換え、Rerank、回答生成は比較に含めません。
文書要約も順位へ混ぜず、40件のrecordだけに検索範囲を固定しました。
ここで測るのは「回答が上手だったか」ではなく、根拠にする記録が、どの順位で取れたかです。
指標
| 指標 | 意味 |
|---|---|
| Hit@1 | 正解記録が1位にある質問の割合 |
| Hit@5 | 正解記録が5位以内にある質問の割合 |
| MRR@10 | 正解の順位の逆数を平均。10位以内にない場合は0 |
各問の正解を1件にした小規模テストなので、この結果だけで一般的な優劣は決めません。
5. 実測結果
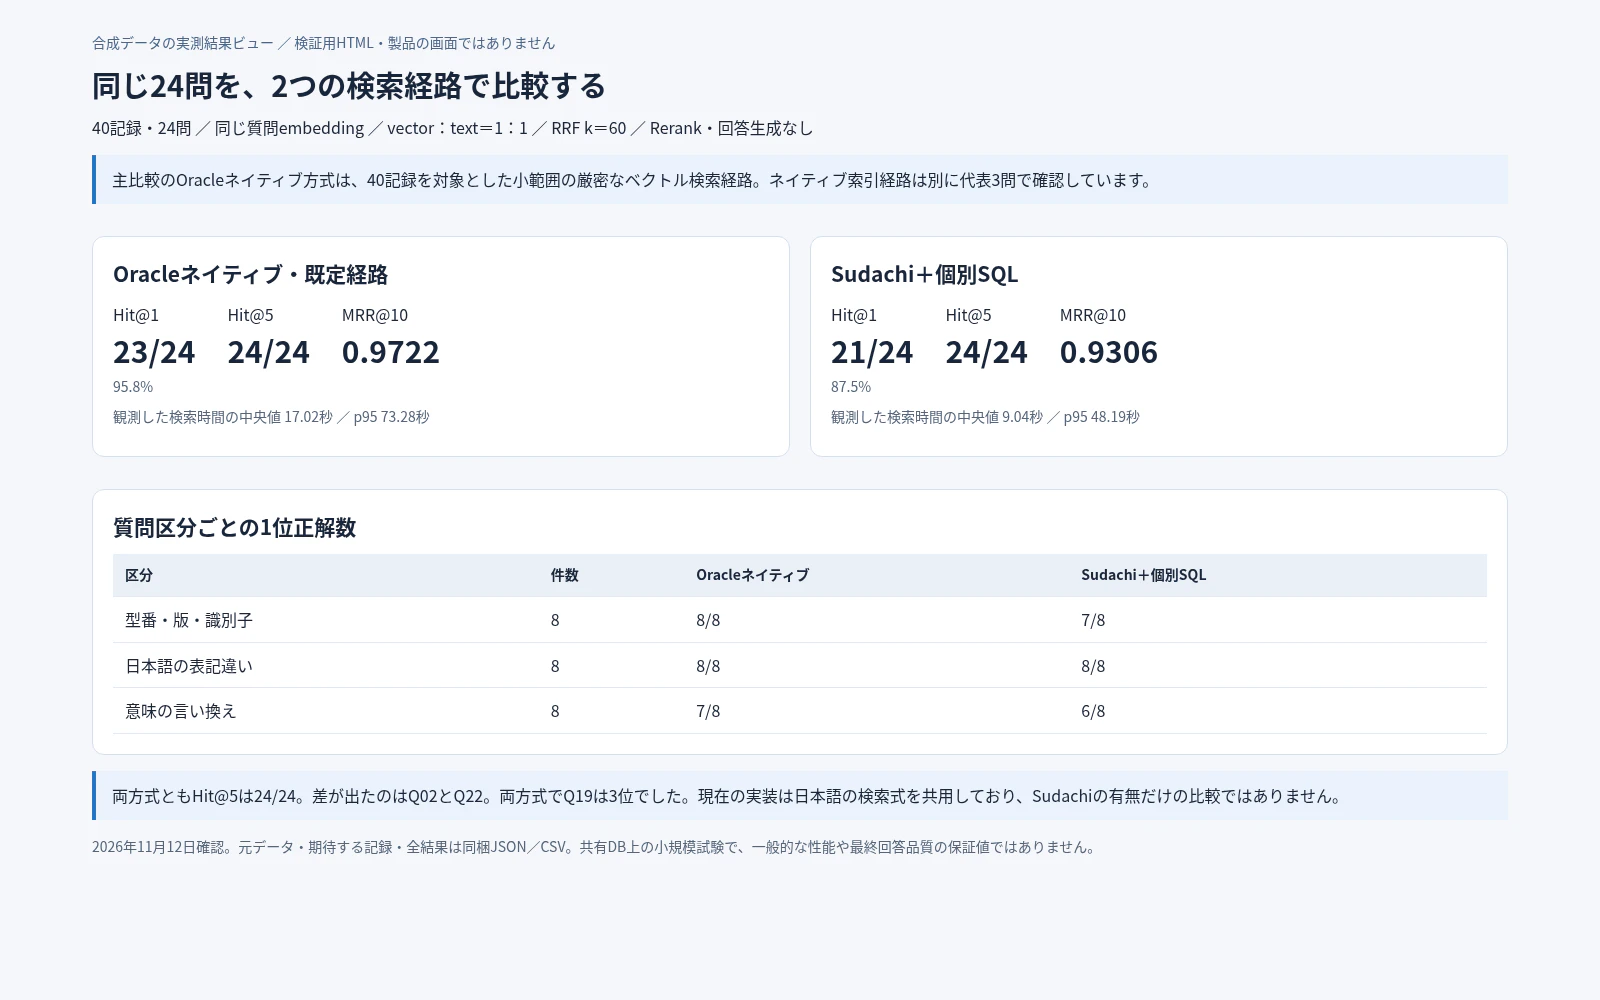
| 方式 | Hit@1 | Hit@5 | MRR@10 |
|---|---|---|---|
| Oracleネイティブ・既定経路 | 23/24(95.8%) | 24/24(100.0%) | 0.9722 |
| Sudachi+個別SQL | 21/24(87.5%) | 24/24(100.0%) | 0.9306 |
ネイティブの既定経路は1位に正解がある質問が2問多い結果でした。ただし、どちらも24問すべてで5位以内に正解がありました。
以下の比較用ビューは、実測JSONを表示した検証用HTMLです。製品にこの比較画面があるという意味ではありません。
質問区分ごとの結果
| 区分 | 件数 | ネイティブ Hit@1 | 個別SQL Hit@1 | ネイティブ MRR@10 | 個別SQL MRR@10 |
|---|---|---|---|---|---|
| 型番・版・識別子 | 8 | 8/8 | 7/8 | 1.0000 | 0.9375 |
| 日本語の表記違い | 8 | 8/8 | 8/8 | 1.0000 | 1.0000 |
| 意味の言い換え | 8 | 7/8 | 6/8 | 0.9167 | 0.8542 |
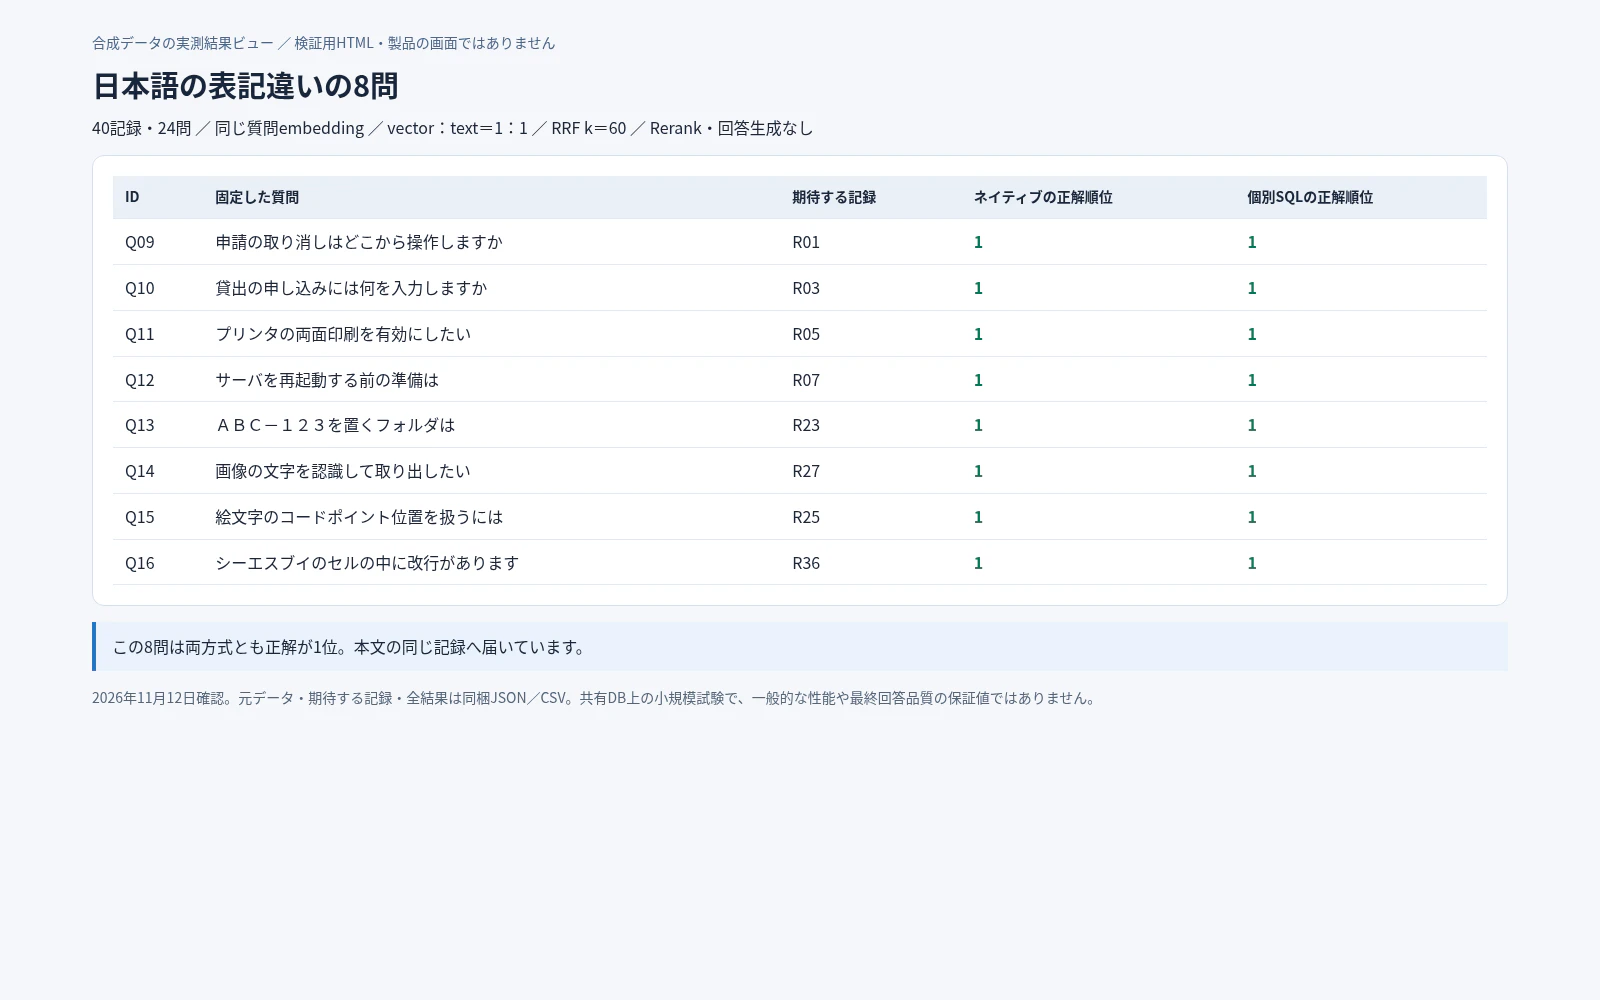
表記違いの8問は、両方式とも1位が8/8でした。両方が同じSudachi処理を使う実装であることも踏まえ、形態素解析器そのものの優劣とは解釈しません。
実際の順位を比べる
差が出た2問と、両方で1位にならなかった1問を見ます。全24問の順位は結果CSVにも入れています。
| 質問 | 正解 | ネイティブの順位 | 個別SQLの順位 |
|---|---|---|---|
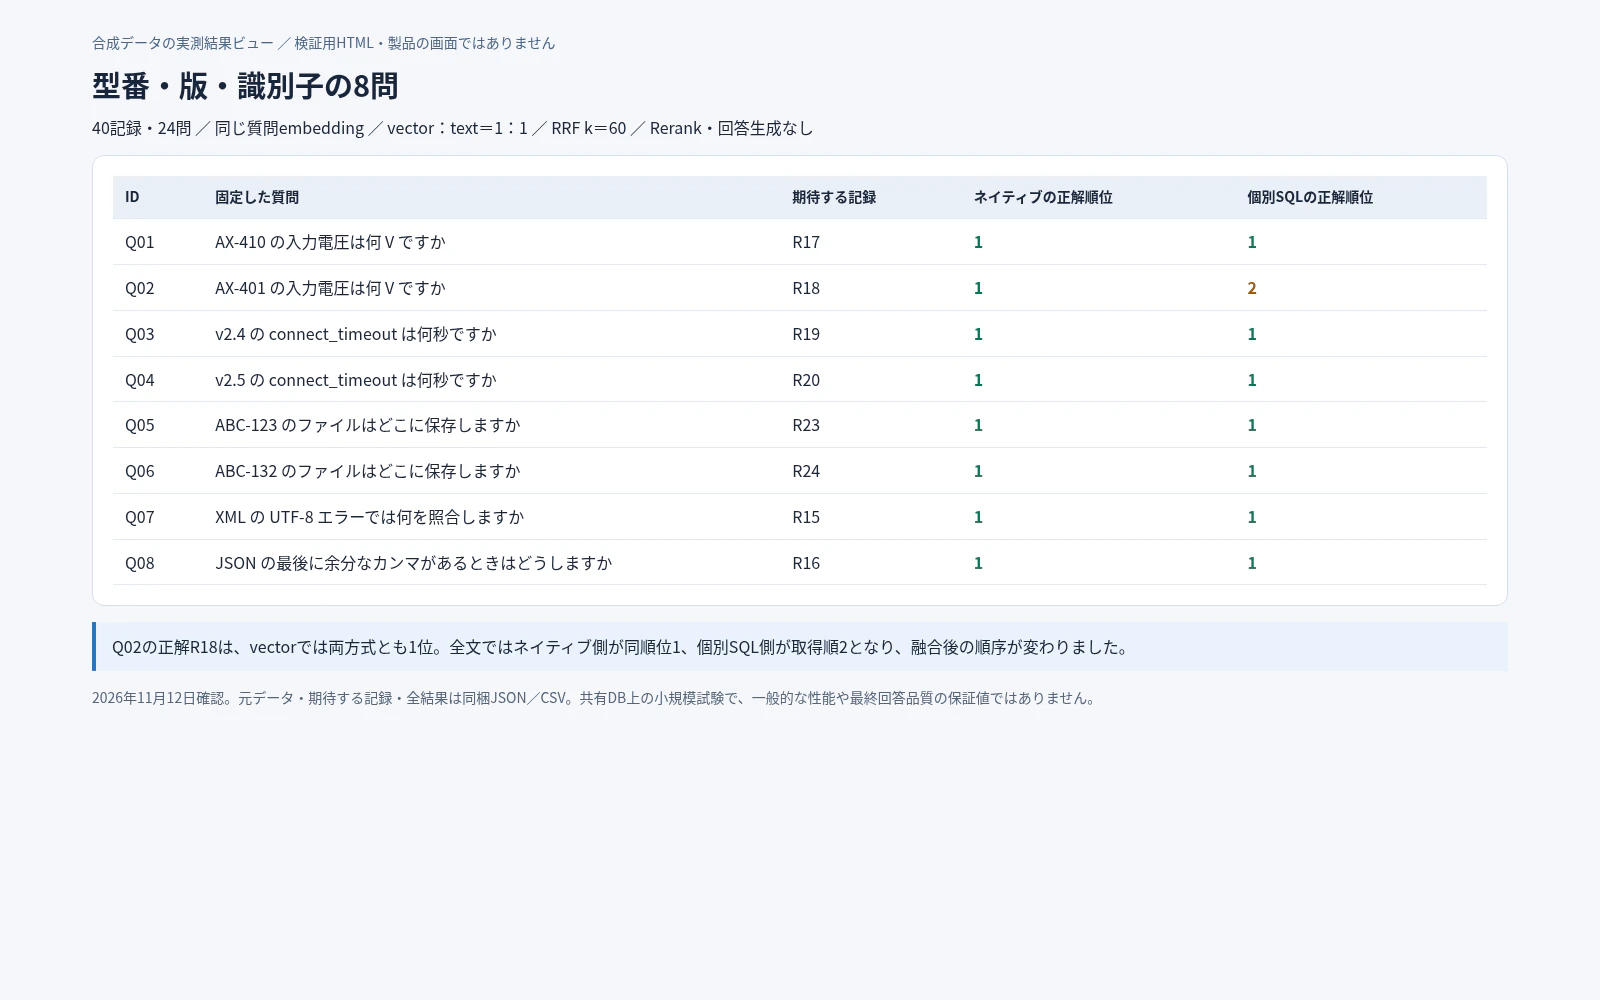
| Q02:AX-401の入力電圧 | R18 | 1 | 2 |
| Q22:保存用ドライブの空きがほぼない | R32 | 1 | 2 |
| Q19:ログインの秘密の文字列を忘れた | R11 | 3 | 3 |
Q02:同点の全文順位が、融合後に効いた
合成資料にはAX-410とAX-401の両方を含む記録があります。この質問では、ベクトル側は両方式とも正解R18を1位にしました。
一方、ネイティブ側の全文順位はR18とR17がともに1位、個別SQL側では取得順のR17が1位、R18が2位でした。個別SQL側は、ベクトル1位・全文2位のR18と、ベクトル2位・全文1位のR17がRRFで同点になり、最終的にR17が先になりました。
つまり、この差は「Sudachiが型番を分割できなかった」ことを示すものではありません。全文の同点順位をどう受け取り、どう融合するかが効いた例です。
Q22:ベクトル1位でも、全文順位で順序が変わる
正解R32は両方式のベクトルで1位でした。全文側ではネイティブの順位が3位、個別SQL側が5位になり、1:1の融合で最終順位に差が出ました。
ここでも、ネイティブ側で同点となる全文順位と、個別SQL側での取得順の扱いを確認できます。
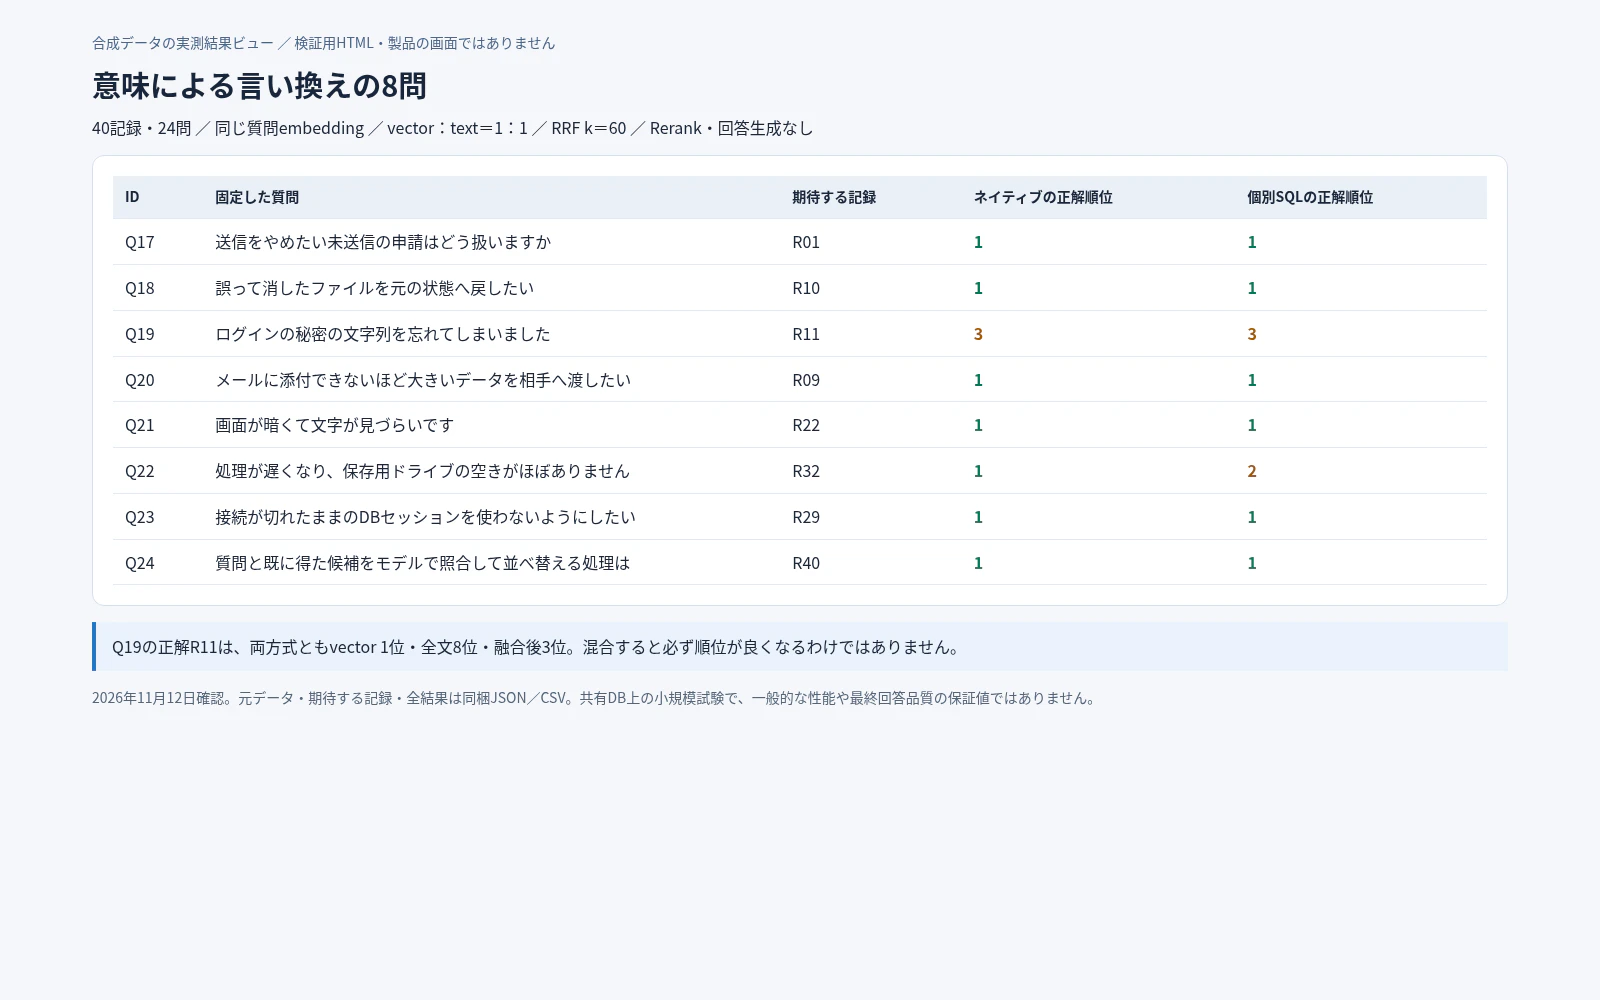
Q19:混ぜることで、正解が1位から下がる例もあった
正解R11は「パスワードの初期化」の記録です。両方式ともベクトル側では1位でしたが、全文側では8位で、融合後は3位になりました。
上位には、パスワードの長さやUTF-16の文字位置など、質問中の語に関連する別の記録も入りました。混合検索だから必ずベクトル単独より良くなるわけではありません。今回の1:1を、最適な重みとして勧める結果でもありません。
ベクトルだけ・全文だけでも確かめる
型番、表記違い、言い換えの各区分の先頭1問を使い、両方式のベクトルだけ・全文だけの結果も追加確認しました。これは代表3問の診断であり、24問全体の分岐別評価ではありません。
| 質問 | 方式 | ベクトルのみの正解順位 | 全文のみの正解順位 | 混合の正解順位 |
|---|---|---|---|---|
| Q01 | Oracleネイティブ・既定経路 | 1 | 1 | 1 |
| Q01 | Sudachi+個別SQL | 1 | 1 | 1 |
| Q09 | Oracleネイティブ・既定経路 | 1 | 2 | 1 |
| Q09 | Sudachi+個別SQL | 1 | 2 | 1 |
| Q17 | Oracleネイティブ・既定経路 | 1 | 1 | 1 |
| Q17 | Sudachi+個別SQL | 1 | 1 | 1 |
検索語とOracle Text式の例も保存しています。ネイティブ側の全文式にも同じ共通処理を使うことが、追いやすくなります。
ネイティブ索引の経路も、代表3問で確認する
| 質問 | ネイティブ索引経路の正解順位 | 記録されたvector経路 |
|---|---|---|
| Q01 | 1 | native_index |
| Q09 | 1 | native_index |
| Q17 | 1 | native_index |
検証用の設定で小範囲の厳密検索分岐を無効にし、3問ともnative_indexの経路と正解1位を確認しました。これは主比較の後に行った3問だけの確認です。24問の結果や主比較の時延と同条件の統計としては扱いません。DB内部の各SQL実行計画を取得した試験でもありません。
時間の読み方
| 方式 | 観測数 | 中央値 | p95 |
|---|---|---|---|
| Oracleネイティブ・既定経路 | 24 | 17.02秒 | 73.28秒 |
| Sudachi+個別SQL | 24 | 9.04秒 | 48.19秒 |
この共有環境・最大2検索の実行条件では、個別SQL方式の中央値が短い結果でした。ネイティブ方式には、範囲の解決や準備確認などのSQLもあります。方式名だけから「ネイティブなら常に1回のSQLで速い」とは判断できません。
同時実行や共有DBの負荷、実行順、キャッシュの影響を切り離した性能評価ではありません。24件から求めたp95にも大きな不確かさがあり、一般的なレイテンシの保証値にはできません。
検索範囲は40記録ですが、物理的な索引は他の文書も入る共有DB上にあります。専用DBに40件だけを入れたマイクロベンチマークではありません。
また、ここでの時間には、DBへの往復、範囲の解決、索引の準備確認、token化、順位処理などを含みます。保存済みembeddingを使用したため、質問embeddingの生成時間は含みません。
6. この比較から、どう選ぶか
今回の小規模テストでは、ネイティブの既定経路はHit@1が2問多く、個別SQL経路は観測した時間の中央値が短い結果でした。Hit@5は同じでした。
その差を追うと、形態素解析器だけでは説明できません。全文の同点順位、融合比率、ネイティブの小範囲分岐といった製品側の条件も結果に関わっています。
ネイティブ索引を利用する場合は、索引と同期の準備、許可範囲の指定、どのvector経路が実行されたかを確認します。個別SQL経路では、全文・ベクトルの各候補と、融合後の順位をそれぞれ追います。
今回は小さい固定セットなので、大規模データでの優劣、索引作成・更新コスト、最終回答の品質は別の検証が必要です。
方式を変える前に、最低限、次を同じにして比べると見やすくなります。
- 同じ資料・同じchunk・同じ検索範囲
- 同じ質問と期待する根拠
- 同じembeddingと類似度の下限
- 同じ取得件数と融合の比率
- Rerankや回答生成を含めるかどうか
後からRerankを追加して確認する場合も、まず今回のような検索候補の記録を残しておくと、どの段で順位が変わったかを追えます。
手元で確認するためのコマンド
索引の準備を読む
既存の環境では、まず読み取りで状態を確認します。
SELECT index_name, index_type, status, domidx_status, domidx_opstatus
FROM user_indexes
WHERE index_name IN (
    'RAG_CHUNKS_HYBRID_IDX',
    'RAG_CHUNKS_TEXT_IDX',
    'RAG_CHUNKS_EMBEDDING_HNSW_IDX'
);

SELECT trigger_name, status
FROM user_triggers
WHERE trigger_name = 'RAG_CHUNKS_HYBRID_SYNC';
今回の3索引はVALIDでした。準備不足を検索結果0件と混ぜず、エラーとして分けることも大切です。
付録の比較スクリプト
付録の比較スクリプトは、索引済みの合成文書だけを対象に検索します。全体設定を保存せず、同じ質問vectorを両方式で使います。
付録のコードとデータを、それぞれのファイル名・ディレクトリ構成で保存してrepository直下のtmp/qiitas/rag-hybrid-comparison-20261112/へ置き、合成CSVを今回と同じく1記録1chunkで取り込んだ場合の例です。既存のbackend依存関係とOracle/OCIの設定がある管理端末で実行します。
cd rag/backend
PYTHONPATH=. uv run python \
  ../../tmp/qiitas/rag-hybrid-comparison-20261112/scripts/run_comparison.py \
  --document-id '<合成文書ID>' \
  --knowledge-base-id '<合成KBのID>' \
  --queries ../../tmp/qiitas/rag-hybrid-comparison-20261112/data/queries.json \
  --output ../../tmp/qiitas/rag-hybrid-comparison-20261112/rerun \
  --concurrency 2
results.json、results.csv、summary.jsonと、共用する質問vectorのキャッシュを出力します。質問・モデルの異なるキャッシュは再利用しません。
ネイティブ索引経路の代表3問だけを別に確認する場合は、出力先を分け、次を追加します。
--native-index-only --query-ids Q01 Q09 Q17
公開用スクリプトは構文と引数表示を確認しました。実測は同じ検索クライアントを呼ぶ作業用の計測スクリプトで行い、範囲・SQLの回数・実行経路も記録しています。
実装の参照先
まとめ
今回の24問では、Oracleネイティブの既定経路はHit@1が23/24、Sudachi+個別SQLは21/24でした。Hit@5はどちらも24/24です。
実装上は、どちらもOracle AI Databaseを使い、現在は日本語の検索式も共通です。違いは、利用する索引と検索の入口、経路順位や同点をどう受け取り、融合するかにあります。
検索方式の名前だけで選ぶより、固定した質問と期待する根拠を用意し、経路別の順位と実行記録まで見ると、結果の理由を説明しやすくなります。
付録:比較データと再実行スクリプト
以下を開き、見出しに示したファイル名で保存できます。
appendix-corpus
合成CSV(data/synthetic-hybrid-corpus.csv)を開く
資料ID,見出し,本文
R01,申請の取消,送信前の申請を取消するときは、申請一覧で対象を選び、取消ボタンを押します。送信済みの申請は履歴に残ります。
R02,申請の再開,中断した申請を再開するときは、下書き一覧で対象を選び、編集を続けるボタンを押します。取消とは別の操作です。
R03,機器貸出の申込,機器の貸出を申し込む場合は、貸出フォームに機器名と利用日を入力します。送信後に受付番号が表示されます。
R04,機器貸出の期間,機器の貸出期間は七日間です。延長は返却日の前日までに申込フォームから連絡します。
R05,プリンターの両面印刷,プリンターで両面印刷するには、印刷設定の両面を有効にして長辺とじを選びます。
R06,印刷ジョブの削除,印刷が止まった場合は、印刷キューから対象ジョブを削除して送り直します。両面設定の変更は不要です。
R07,サーバーの再起動,サーバーを再起動する前に利用者へ通知し、処理中のジョブを終了します。操作は管理画面の再起動から行います。
R08,サーバーのバックアップ,サーバーのバックアップは毎日午前三時に実行します。保存世代は七世代です。
R09,大容量ファイルの転送,大容量ファイルは転送画面へアップロードし、発行された共有リンクを相手へ送ります。メールにはファイル本体を添付しません。
R10,削除ファイルの復元,誤って削除したファイルは、ごみ箱から元に戻すを選ぶと復元できます。保管期限を過ぎた項目は対象外です。
R11,パスワードの初期化,パスワードを忘れた場合は、ログイン画面の再設定を選び、登録済みメールで本人確認して新しいパスワードを設定します。
R12,パスワードの長さ,パスワードは十二文字以上にし、他のサービスと同じ文字列を使わないでください。
R13,無線ルーターの警告ランプ,無線ルーターの警告ランプが赤く点灯した場合は、回線ケーブルを確認してから診断を実行します。
R14,無線ルーターの有線ポート,無線ルーターの有線ポートは四つです。プリンターを接続する場合はLAN側のポートを使います。
R15,XMLの文字コード,XMLを読み込むときに文字コードエラーが出る場合は、宣言と実際のバイト列がUTF-8で一致していることを確認します。
R16,JSONの末尾カンマ,JSONの読込エラーでは、最後の要素の後ろに余分なカンマがないかを確認します。XML宣言は使用しません。
R17,AX-410の入力電圧,合成機器AX-410の入力電圧は24 Vです。AX-401とは異なる機器です。
R18,AX-401の入力電圧,合成機器AX-401の入力電圧は12 Vです。AX-410とは異なる機器です。
R19,v2.4の待ち時間,合成ツールv2.4の接続タイムアウトは30秒です。設定名はconnect_timeoutです。
R20,v2.5の待ち時間,合成ツールv2.5の接続タイムアウトは60秒です。設定名はconnect_timeoutです。
R21,監視アラート,システム監視のmonitorが異常を検知したら、状態画面で対象サービスと時刻を確認します。
R22,画面の明るさ,ディスプレイのmonitorが暗いときは、表示設定の明るさを調節します。システム監視とは別です。
R23,ABC-123の保存場所,識別子ABC-123の合成ファイルは、共有領域の検証フォルダーへ保存します。
R24,ABC-132の保存場所,識別子ABC-132の合成ファイルは、端末の一時フォルダーへ保存します。
R25,Unicodeの文字位置,絵文字を含む原文の文字位置はUnicode codepointで数えます。JavaScriptではArray.fromで文字単位に分けます。
R26,UTF-16の文字位置,JavaScriptの通常の文字列indexはUTF-16の単位です。絵文字ではPythonの文字数と一致しない場合があります。
R27,画像の文字認識,画像だけの文書から文字を取り出すには、OCRによる文字認識を使います。認識結果は元画像と照合します。
R28,テキストPDFの抽出,文字情報を持つPDFは、まず埋め込まれた文字を抽出します。画像だけのページではOCRを検討します。
R29,DB接続プールの再取得,切断されたDB接続を使い続けないよう、接続プールから新しい接続を借り直します。失敗理由を記録して有限回だけ再試行します。
R30,TLS証明書の信頼,ブラウザの証明書認証局エラーでは、証明書の有効期間と信頼チェーンを確認します。DB接続の再取得では直りません。
R31,通信帯域の制限,ネットワークが混雑した場合は、転送速度と同時接続数を確認します。帯域の上限設定があるかも調べます。
R32,ディスク容量の不足,ディスクの空き容量が不足した場合は、大きな一時ファイルを確認し、保管期限と所有者を確認して整理します。
R33,FAQの除外例,FAQの答えを当てたくない質問は、除外する質問の例として登録します。類似する否定の質問との混同を確認します。
R34,FAQの追加,FAQを追加するには、質問と回答を入力し、公開するナレッジベースの範囲を選びます。
R35,JSONLの記録境界,構造化JSONLの分割は、記録の境界を保ちます。一つの記録を誤って複数の項目へ混ぜないようにします。
R36,CSVのセル内改行,CSVのセル内改行は、引用符で囲まれた一つのフィールドとして読みます。物理行とレコード数を区別します。
R37,日時の表示,利用者への日時表示では、利用者のタイムゾーンを使います。保存したUTCの値と表示時刻を区別します。
R38,日付の部分一致,ファイル名に含まれる日付文字列だけで、原文の版や現在有効な文書かを決めないでください。
R39,RRFの順位融合,RRFは検索結果の順位を使って候補を融合します。順位定数と経路の重みを固定して比較します。
R40,Rerankの再順位付け,Rerankは質問と取得済み候補の関連度をモデルで比較し、候補の順を並べ直します。候補にない資料は追加できません。
appendix-queries
24問と期待する資料ID(data/queries.json)を開く
[
  {
    "id": "Q01",
    "group": "literal",
    "question": "AX-410 の入力電圧は何 V ですか",
    "relevant_ids": [
      "R17"
    ]
  },
  {
    "id": "Q02",
    "group": "literal",
    "question": "AX-401 の入力電圧は何 V ですか",
    "relevant_ids": [
      "R18"
    ]
  },
  {
    "id": "Q03",
    "group": "literal",
    "question": "v2.4 の connect_timeout は何秒ですか",
    "relevant_ids": [
      "R19"
    ]
  },
  {
    "id": "Q04",
    "group": "literal",
    "question": "v2.5 の connect_timeout は何秒ですか",
    "relevant_ids": [
      "R20"
    ]
  },
  {
    "id": "Q05",
    "group": "literal",
    "question": "ABC-123 のファイルはどこに保存しますか",
    "relevant_ids": [
      "R23"
    ]
  },
  {
    "id": "Q06",
    "group": "literal",
    "question": "ABC-132 のファイルはどこに保存しますか",
    "relevant_ids": [
      "R24"
    ]
  },
  {
    "id": "Q07",
    "group": "literal",
    "question": "XML の UTF-8 エラーでは何を照合しますか",
    "relevant_ids": [
      "R15"
    ]
  },
  {
    "id": "Q08",
    "group": "literal",
    "question": "JSON の最後に余分なカンマがあるときはどうしますか",
    "relevant_ids": [
      "R16"
    ]
  },
  {
    "id": "Q09",
    "group": "variant",
    "question": "申請の取り消しはどこから操作しますか",
    "relevant_ids": [
      "R01"
    ]
  },
  {
    "id": "Q10",
    "group": "variant",
    "question": "貸出の申し込みには何を入力しますか",
    "relevant_ids": [
      "R03"
    ]
  },
  {
    "id": "Q11",
    "group": "variant",
    "question": "プリンタの両面印刷を有効にしたい",
    "relevant_ids": [
      "R05"
    ]
  },
  {
    "id": "Q12",
    "group": "variant",
    "question": "サーバを再起動する前の準備は",
    "relevant_ids": [
      "R07"
    ]
  },
  {
    "id": "Q13",
    "group": "variant",
    "question": "ABC-123を置くフォルダは",
    "relevant_ids": [
      "R23"
    ]
  },
  {
    "id": "Q14",
    "group": "variant",
    "question": "画像の文字を認識して取り出したい",
    "relevant_ids": [
      "R27"
    ]
  },
  {
    "id": "Q15",
    "group": "variant",
    "question": "絵文字のコードポイント位置を扱うには",
    "relevant_ids": [
      "R25"
    ]
  },
  {
    "id": "Q16",
    "group": "variant",
    "question": "シーエスブイのセルの中に改行があります",
    "relevant_ids": [
      "R36"
    ]
  },
  {
    "id": "Q17",
    "group": "paraphrase",
    "question": "送信をやめたい未送信の申請はどう扱いますか",
    "relevant_ids": [
      "R01"
    ]
  },
  {
    "id": "Q18",
    "group": "paraphrase",
    "question": "誤って消したファイルを元の状態へ戻したい",
    "relevant_ids": [
      "R10"
    ]
  },
  {
    "id": "Q19",
    "group": "paraphrase",
    "question": "ログインの秘密の文字列を忘れてしまいました",
    "relevant_ids": [
      "R11"
    ]
  },
  {
    "id": "Q20",
    "group": "paraphrase",
    "question": "メールに添付できないほど大きいデータを相手へ渡したい",
    "relevant_ids": [
      "R09"
    ]
  },
  {
    "id": "Q21",
    "group": "paraphrase",
    "question": "画面が暗くて文字が見づらいです",
    "relevant_ids": [
      "R22"
    ]
  },
  {
    "id": "Q22",
    "group": "paraphrase",
    "question": "処理が遅くなり、保存用ドライブの空きがほぼありません",
    "relevant_ids": [
      "R32"
    ]
  },
  {
    "id": "Q23",
    "group": "paraphrase",
    "question": "接続が切れたままのDBセッションを使わないようにしたい",
    "relevant_ids": [
      "R29"
    ]
  },
  {
    "id": "Q24",
    "group": "paraphrase",
    "question": "質問と既に得た候補をモデルで照合して並べ替える処理は",
    "relevant_ids": [
      "R40"
    ]
  }
]
appendix-results
全24問の検索結果(data/results.csv)を開く
query_id,group,question,backend,expected,ranked_ids,first_relevant_rank,hit1,hit5,mrr10,elapsed_seconds
Q02,literal,AX-401 の入力電圧は何 V ですか,sudachi,R18,"R17,R18,R03,R34",2,0,1,0.5,28.277
Q01,literal,AX-410 の入力電圧は何 V ですか,oracle_native,R17,"R17,R18,R03,R34",1,1,1,1.0,49.976
Q03,literal,v2.4 の connect_timeout は何秒ですか,oracle_native,R19,"R19,R20,R29,R17,R18,R31,R30,R04",1,1,1,1.0,54.633
Q04,literal,v2.5 の connect_timeout は何秒ですか,sudachi,R20,"R20,R19,R17,R29,R18,R30,R31,R04",1,1,1,1.0,36.6
Q06,literal,ABC-132 のファイルはどこに保存しますか,sudachi,R24,"R24,R23,R08,R10,R09,R32,R38,R37",1,1,1,1.0,52.326
Q05,literal,ABC-123 のファイルはどこに保存しますか,oracle_native,R23,"R23,R24,R08,R10,R09,R38,R32,R37,R03,R25",1,1,1,1.0,83.665
Q07,literal,XML の UTF-8 エラーでは何を照合しますか,oracle_native,R15,"R15,R16,R26,R30,R27,R25,R38,R32,R39,R31",1,1,1,1.0,73.283
Q08,literal,JSON の最後に余分なカンマがあるときはどうしますか,sudachi,R16,"R16,R35,R36,R15,R06,R26,R07,R32,R20,R01",1,1,1,1.0,48.187
Q10,variant,貸出の申し込みには何を入力しますか,sudachi,R03,"R03,R04,R34,R01,R17,R02,R18,R32,R29,R28",1,1,1,1.0,28.026
Q09,variant,申請の取り消しはどこから操作しますか,oracle_native,R01,"R01,R02,R07,R06,R10,R03,R33",1,1,1,1.0,47.336
Q12,variant,サーバを再起動する前の準備は,sudachi,R07,"R07,R08,R29,R01,R04,R11,R02,R40,R30,R06",1,1,1,1.0,27.713
Q11,variant,プリンタの両面印刷を有効にしたい,oracle_native,R05,"R05,R06,R14,R07,R30,R38",1,1,1,1.0,45.911
Q14,variant,画像の文字を認識して取り出したい,sudachi,R27,"R27,R28,R25,R26,R15,R38,R12,R16,R36,R21",1,1,1,1.0,15.118
Q13,variant,ABC-123を置くフォルダは,oracle_native,R23,"R23,R24,R38,R18,R10,R32,R17,R08,R03,R25",1,1,1,1.0,25.826
Q16,variant,シーエスブイのセルの中に改行があります,sudachi,R36,"R36,R07,R02,R26,R35,R16,R25,R15,R06,R30",1,1,1,1.0,12.424
Q15,variant,絵文字のコードポイント位置を扱うには,oracle_native,R25,"R25,R26,R15,R27,R28,R12,R24,R36,R38,R39",1,1,1,1.0,21.977
Q18,paraphrase,誤って消したファイルを元の状態へ戻したい,sudachi,R10,"R10,R01,R09,R32,R38,R11,R35,R02,R21,R23",1,1,1,1.0,11.541
Q17,paraphrase,送信をやめたい未送信の申請はどう扱いますか,oracle_native,R01,"R01,R02,R03,R06,R07,R09,R31,R40,R33,R32",1,1,1,1.0,22.625
Q19,paraphrase,ログインの秘密の文字列を忘れてしまいました,oracle_native,R11,"R12,R26,R11,R25,R38,R29,R30,R15,R07,R27",3,0,1,0.3333333333333333,21.229
Q20,paraphrase,メールに添付できないほど大きいデータを相手へ渡したい,sudachi,R09,"R09,R11,R31,R32,R10,R07,R34,R12,R40",1,1,1,1.0,10.722
Q22,paraphrase,処理が遅くなり、保存用ドライブの空きがほぼありません,sudachi,R32,"R07,R32,R08,R37,R23,R24,R31,R06,R09",2,0,1,0.5,9.651
Q21,paraphrase,画面が暗くて文字が見づらいです,oracle_native,R22,"R22,R11,R26,R25,R13,R32,R27,R12,R15,R28",1,1,1,1.0,16.571
Q23,paraphrase,接続が切れたままのDBセッションを使わないようにしたい,oracle_native,R29,"R29,R19,R20,R30,R31,R06,R12,R14,R07,R35",1,1,1,1.0,15.383
Q24,paraphrase,質問と既に得た候補をモデルで照合して並べ替える処理は,sudachi,R40,"R40,R39,R33,R34,R27,R07,R38,R06,R28,R01",1,1,1,1.0,8.86
Q01,literal,AX-410 の入力電圧は何 V ですか,sudachi,R17,"R17,R18,R03,R34",1,1,1,1.0,8.073
Q02,literal,AX-401 の入力電圧は何 V ですか,oracle_native,R18,"R18,R17,R03,R34",1,1,1,1.0,16.465
Q03,literal,v2.4 の connect_timeout は何秒ですか,sudachi,R19,"R19,R20,R17,R29,R18,R31,R30,R04",1,1,1,1.0,8.342
Q04,literal,v2.5 の connect_timeout は何秒ですか,oracle_native,R20,"R20,R19,R29,R17,R18,R30,R31,R04",1,1,1,1.0,12.8
Q06,literal,ABC-132 のファイルはどこに保存しますか,oracle_native,R24,"R24,R23,R08,R10,R09,R38,R32,R37",1,1,1,1.0,13.915
Q05,literal,ABC-123 のファイルはどこに保存しますか,sudachi,R23,"R23,R24,R08,R10,R09,R38,R32,R37,R03,R25",1,1,1,1.0,9.188
Q07,literal,XML の UTF-8 エラーでは何を照合しますか,sudachi,R15,"R15,R16,R26,R30,R27,R25,R38,R32,R39,R31",1,1,1,1.0,8.883
Q08,literal,JSON の最後に余分なカンマがあるときはどうしますか,oracle_native,R16,"R16,R35,R36,R15,R06,R26,R07,R32,R20,R01",1,1,1,1.0,12.631
Q10,variant,貸出の申し込みには何を入力しますか,oracle_native,R03,"R03,R04,R34,R01,R17,R18,R02,R32,R29,R28",1,1,1,1.0,11.809
Q09,variant,申請の取り消しはどこから操作しますか,sudachi,R01,"R01,R02,R07,R06,R10,R03,R33",1,1,1,1.0,7.494
Q11,variant,プリンタの両面印刷を有効にしたい,sudachi,R05,"R05,R06,R14,R07,R30,R38",1,1,1,1.0,7.751
Q12,variant,サーバを再起動する前の準備は,oracle_native,R07,"R07,R08,R29,R01,R04,R11,R02,R40,R30,R06",1,1,1,1.0,17.465
Q13,variant,ABC-123を置くフォルダは,sudachi,R23,"R23,R24,R38,R18,R10,R32,R17,R08,R03,R25",1,1,1,1.0,7.522
Q14,variant,画像の文字を認識して取り出したい,oracle_native,R27,"R27,R28,R25,R26,R15,R38,R12,R16,R36,R21",1,1,1,1.0,17.639
Q16,variant,シーエスブイのセルの中に改行があります,oracle_native,R36,"R36,R07,R26,R02,R35,R16,R25,R15,R06,R30",1,1,1,1.0,15.527
Q15,variant,絵文字のコードポイント位置を扱うには,sudachi,R25,"R25,R26,R15,R27,R12,R28,R24,R39,R23,R36",1,1,1,1.0,8.599
Q17,paraphrase,送信をやめたい未送信の申請はどう扱いますか,sudachi,R01,"R01,R02,R03,R06,R07,R09,R31,R40,R33,R32",1,1,1,1.0,6.887
Q19,paraphrase,ログインの秘密の文字列を忘れてしまいました,sudachi,R11,"R12,R26,R11,R25,R29,R38,R15,R30,R07,R27",3,0,1,0.3333333333333333,7.21
Q18,paraphrase,誤って消したファイルを元の状態へ戻したい,oracle_native,R10,"R10,R01,R32,R09,R38,R35,R11,R02,R23,R24",1,1,1,1.0,16.302
Q22,paraphrase,処理が遅くなり、保存用ドライブの空きがほぼありません,oracle_native,R32,"R32,R07,R08,R37,R23,R24,R31,R06,R09",1,1,1,1.0,7.155
Q20,paraphrase,メールに添付できないほど大きいデータを相手へ渡したい,oracle_native,R09,"R09,R11,R31,R32,R10,R07,R34,R12,R40",1,1,1,1.0,9.07
Q21,paraphrase,画面が暗くて文字が見づらいです,sudachi,R22,"R22,R11,R25,R13,R26,R27,R32,R12,R15,R28",1,1,1,1.0,5.601
Q23,paraphrase,接続が切れたままのDBセッションを使わないようにしたい,sudachi,R29,"R29,R30,R19,R20,R31,R06,R12,R14,R07,R35",1,1,1,1.0,7.932
Q24,paraphrase,質問と既に得た候補をモデルで照合して並べ替える処理は,oracle_native,R40,"R40,R39,R33,R34,R27,R07,R38,R06,R28,R01",1,1,1,1.0,10.526
Q01,literal,AX-410 の入力電圧は何 V ですか,oracle_native_index,R17,"R17,R18,R03,R34",1,1,1,1.0,7.602
Q09,variant,申請の取り消しはどこから操作しますか,oracle_native_index,R01,"R01,R02,R07,R06,R10,R03,R33",1,1,1,1.0,7.152
Q17,paraphrase,送信をやめたい未送信の申請はどう扱いますか,oracle_native_index,R01,"R01,R02,R03,R06,R07,R09,R31,R40,R33,R32",1,1,1,1.0,7.56
appendix-script
比較スクリプト(scripts/run_comparison.py)を開く
"""索引済みの合成CSVだけを対象に、同じ質問vectorで検索経路を比較する。"""
from __future__ import annotations
import argparse
import asyncio
import csv
import json
import re
import statistics
import time
from pathlib import Path

def metrics(ids: list[str], expected: list[str]) -> dict[str, float]:
    positions = [rank for rank, value in enumerate(ids[:10], 1) if value in expected]
    first = min(positions, default=0)
    return {"hit1": float(first == 1), "hit5": float(0 < first <= 5), "mrr10": 1 / first if first else 0}

async def run(args: argparse.Namespace) -> None:
    from app.clients.oci_genai import OciGenAiClient
    from app.clients.oracle import OracleClient
    from app.config import get_settings
    from app.rag.request_context import AuditRequestContext, reset_audit_request_context, set_audit_request_context
    from app.schemas.search import SearchMode
    from rag_engine.retrieval.text_search_tokenizer import text_search_tokenizer_name
    questions = json.loads(args.queries.read_text(encoding="utf-8"))
    if args.query_ids:
        questions = [q for q in questions if q["id"] in args.query_ids]
    if not questions:
        raise ValueError("比較する質問がありません。")
    args.output.mkdir(parents=True, exist_ok=True)
    cache = args.output / "query_vectors.json"
    settings = get_settings()
    base = settings.model_copy(update={"rag_rrf_method_ratio": (1.0, 1.0), "rag_rrf_k": 60,
        "rag_min_similarity": 0.2, "oracle_vector_target_accuracy": 100, "rag_domain_keywords": []})
    if text_search_tokenizer_name() != "sudachi+script":
        raise RuntimeError("Sudachi辞書を利用できる環境で実行してください。")
    texts = [q["question"] for q in questions]
    if cache.exists():
        stored = json.loads(cache.read_text())
        if stored["questions"] != texts or stored["model"] != settings.oci_genai_embedding_model:
            raise ValueError("vectorのキャッシュが質問・モデルと一致しません。出力先を分けてください。")
        vectors = stored["vectors"]
    else:
        vectors = await OciGenAiClient(settings).embed(texts, input_type="SEARCH_QUERY")
        cache.write_text(json.dumps({"questions": texts, "model": settings.oci_genai_embedding_model, "vectors": vectors}))
    context = set_audit_request_context(AuditRequestContext(
        allowed_document_ids=frozenset([args.document_id]),
        allowed_knowledge_base_ids=frozenset([args.knowledge_base_id])))
    filters = {"document_id": args.document_id, "knowledge_base_id": args.knowledge_base_id, "content_kind": "record"}
    semaphore = asyncio.Semaphore(args.concurrency)
    rows: list[dict[str, object]] = []
    async def query(q: dict[str, object], vector: list[float], backend: str) -> None:
        overrides: dict[str, object] = {"rag_hybrid_search_backend": backend}
        if backend == "oracle_hybrid_index" and args.native_index_only:
            overrides["rag_native_vector_exact_max_chunks"] = 0
        client = OracleClient(base.model_copy(update=overrides))
        async with semaphore:
            started = time.perf_counter()
            hits = await client.hybrid_search(str(q["question"]), vector, 10, SearchMode.HYBRID, filters)
            elapsed_ms = (time.perf_counter() - started) * 1000
        if getattr(hits, "failure", None):
            raise hits.failure
        ids = []
        for hit in hits[:10]:
            if hit.document_id != args.document_id:
                raise RuntimeError("指定した文書の範囲を確認できません。")
            match = re.search(r"資料ID\s*:\s*(R\d{2})\b", hit.text)
            if not match:
                raise ValueError("同梱の合成記録に対応しない検索結果です。")
            ids.append(match.group(1))
        rows.append({"query_id": q["id"], "group": q["group"], "backend": backend,
            "elapsed_ms": elapsed_ms, "ranked_ids": ids,
            **metrics(ids, q["relevant_ids"])})
        print(q["id"], backend, "完了", flush=True)
    async def pair(i: int, q: dict[str, object], vector: list[float]) -> None:
        order = ["oracle_hybrid_index", "oracle_separate_sql"] if i % 2 == 0 else ["oracle_separate_sql", "oracle_hybrid_index"]
        for backend in order:
            await query(q, vector, backend)
    try:
        await asyncio.gather(*(pair(i, q, v) for i, (q, v) in enumerate(zip(questions, vectors, strict=True))))
    finally:
        reset_audit_request_context(context)
        (args.output / "results.json").write_text(json.dumps(rows, ensure_ascii=False, indent=2))
    with (args.output / "results.csv").open("w", encoding="utf-8", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=["query_id", "group", "backend", "elapsed_ms", "hit1", "hit5", "mrr10", "ranked_ids"])
        writer.writeheader()
        writer.writerows(rows)
    summary = {}
    for backend in ["oracle_hybrid_index", "oracle_separate_sql"]:
        values = [r for r in rows if r["backend"] == backend]
        summary[backend] = {key: statistics.mean(r[key] for r in values) for key in ["hit1", "hit5", "mrr10"]}
    (args.output / "summary.json").write_text(json.dumps(summary, ensure_ascii=False, indent=2))
    print(json.dumps(summary, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--document-id", required=True)
    parser.add_argument("--knowledge-base-id", required=True)
    parser.add_argument("--queries", type=Path, required=True)
    parser.add_argument("--output", type=Path, required=True)
    parser.add_argument("--concurrency", type=int, choices=[1, 2], default=2)
    parser.add_argument("--native-index-only", action="store_true", help="原生方式の小範囲の厳密検索分岐を無効にする")
    parser.add_argument("--query-ids", nargs="*")
    asyncio.run(run(parser.parse_args()))