
はじめに
RAG の回答モデルを新しいものへ変えると、回答はどのくらい良くなり、待ち時間はどのくらい短くなるのでしょうか。
モデル名の数字だけで決める前に、同じ資料と同じ質問を渡して確認してみました。今回は OCI Enterprise AI の Responses API から、Grok 4.3・4.6・4.7 の3モデルを実際に呼び出し、日本語の根拠付き回答と応答時間を比較します。
検証日は 2026年11月5日です。先に結果を示すと、今回の小さな基本問題セットでは、3モデルとも定型チェックを全件通過しました。一方、完了時間の中央値は4.7が最短で、公開単価からの費用試算は4.3が最小でした。
| モデル | 基本5項目が満点の回数 | 最初の回答テキストまでの中央値・秒 | 完了時間の中央値・秒 | 完了時間 min–max・秒 | reasoning token 中央値 |
|---|---|---|---|---|---|
| xai.grok-4.3 | 15/15 | 6.068 | 6.904 | 3.777–10.605 | 288 |
| xai.grok-4.6 | 15/15 | 3.464 | 4.248 | 3.211–4.808 | 191 |
| xai.grok-4.7 | 15/15 | 2.766 | 3.364 | 2.700–4.689 | 182 |
これは「Grok 4.7 はあらゆる RAG で最強」という結論ではありません。 今回の入力・設定・実行時間帯における、少数試行の観測結果です。回答の難度、推論量、キャッシュ、出力の長さも含めて読み解きます。
1. 今回、RAG のどの部分を比べるのか
RAG は、質問に関連する資料を検索し、その資料をモデルへ渡して回答を作る仕組みです。モデルを比べたいのに検索結果まで毎回違うと、回答の差が検索器と LLM のどちらから生じたのか分かりにくくなります。
そこで今回は 検索結果を固定し、回答生成部分を比較しました。検索エンジン、embedding、rerank の性能を測る実験ではありません。検索の時間も含めません。
Oracle の公式資料には、3モデルとその対応する機能・地域が掲載されています。4.7 の推論設定は既定が high で、無効化できないことも記載されています。今回は既定値をそのまま比べず、3モデルとも reasoning.effort=low を指定しました。同じ low でも内部の推論量が同じになる保証はないため、返された reasoning token も記録します。Grok 4.3、Grok 4.6、Grok 4.7
2. 比較条件をそろえる
| 項目 | 今回の設定 |
|---|---|
| 実行環境 | Python 3.12 / HTTPX / Pydantic v2 |
| 接続 | 既存 .env と model-settings.json のプライマリ接続を読取専用で使用 |
| API | 同じ OCI 公式 endpoint・同じ Project・POST /openai/v1/responses
|
| モデル ID |
xai.grok-4.3 / xai.grok-4.6 / xai.grok-4.7
|
| 入力 | 同じ合成日本語資料48件・同じ質問・同じ資料順 |
| 出力 | 同一 JSON Schema、説明は日本語の1文 |
| 推論 | low |
| 出力上限の要求 | 主試験 max_output_tokens=2048
|
| 保存・外部ツール |
store=false、Web 検索や Function Calling は不使用 |
| 回数 | 5題×3モデル×3回=45回、別に短い事前確認3回 |
| 呼び出し順 | 逐次実行。質問と反復ごとにモデル順を循環させる |
| リトライ | 自動リトライなし。要求の間に約1秒待機 |
| サービス層 | Priority は要求せず、全主要応答で service_tier=default を確認 |
同じクライアント endpoint でも、推論基盤の物理配置まで同じとは確認していません。Oracle の地域表では Grok の提供形態に External Calls の注記があります。今回は OCI の API 経由の応答時間として測定し、「すべてが OCI 内部の同一サーバーで実行された」とは扱いません。Oracle: Models by Region
既存の製品設定ファイルは変更していません。接続情報は既存 JSON から読み、比較対象の3モデル ID はベンチマーク側で指定します。製品に4.6や4.7を登録しなくても、この独立コードから同じ接続へ要求できます。実際に呼べるかは事前確認で検査し、今回は3モデルとも成功しました。
3. 日本語の5題と採点基準
再現と公開ができるよう、実業務のデータを使わず、技術的な合成資料を作りました。中心となる資料8件と、質問に答える情報を定義しない参考記録40件です。
| 種類 | 質問の内容 | 期待する結果 | 必要な根拠 |
|---|---|---|---|
| 事実抽出 | ノード A の接続上限 | 120 |
D01 |
| 複数資料の統合 | グループ B 全体の接続上限 | 120 + 80 = 200 |
D01・D02・D03 |
| 例外条件 | debug モードのログ保存日数 | 通常14日より例外の 3 日を優先 |
D05。D04の併記は許容 |
| 資料の矛盾 | 同日・同優先度の異なるサイズ |
conflict、値は null
|
D06・D07 |
| 根拠不足 | 資料にない鍵更新周期 |
insufficient、値は null
|
D08 |
採点基準と期待値は実行前に dataset.json へ固定し、その SHA-256 を実行記録へ保存しました。後から答えに合わせて正解を変えていません。
定型チェックは次の5項目で、各1点です。
- 定義した JSON Schema と型を満たす
- 回答状態が正しい
- 確定値、または
nullが正しい - 必要な資料 ID を含む
- 許容されない資料 ID や重複がない
この5点は、説明文の全主張を自動で検証する指標ではありません。 全45回答の説明文も Codex が合成資料と読み合わせ、補足所見を manual-review.json に残しています。独立した人間の採点ではなく、別の採点 API を追加で呼んだ結果でもありません。
4. .env と JSON を使って呼び出すコード
ZIP に benchmark.py、dataset.json、採点・SSE の局所テスト、集計・証跡検査のコードを入れています。
秘密情報の設定例です。
PLATFORM_MODEL_SETTINGS_FILE=model-settings.json
PLATFORM_OCI_ENTERPRISE_AI_API_KEY=<your-api-key>
モデル JSON では接続を指定します。実際の URL と Project OCID は自分の値に置き換えます。相対的な JSON パスは .env の場所を基準に解決し、環境変数は .env より優先します。
{
  "version": 6,
  "enterprise_ai": {
    "api_path": "/responses",
    "connections": [{
      "connection_id": "primary",
      "endpoint": "https://inference.generativeai.<region>.oci.oraclecloud.com/openai/v1",
      "project_ocid": "<your-project-ocid>"
    }],
    "text_payload_template": ""
  }
}
このコードは同じ接続で3モデルを比較する実験用であり、製品の Settings 全体を再実装するものではありません。独自 payload template は対象外です。利用できる endpoint と認証の前提は OCI Responses API の公式説明 も確認してください。
出力には、次の型を使います。これにより、確定値の比較や引用 ID の確認をコードで実行できます。
from typing import Literal
from pydantic import BaseModel, ConfigDict

class Answer(BaseModel):
    model_config = ConfigDict(extra="forbid", strict=True)
    status: Literal["answered", "conflict", "insufficient"]
    value: str | None
    citations: list[str]
    explanation: str
LLM への指示は、資料の読取り、根拠からの判断、結果出力の3つの Step に分けています。正答はモデルへ渡しません。value と資料 ID の形式検査は Pydantic と Python 側で行います。
body = {
    "model": model_id,
    "input": [
        {"role": "system", "content": instructions_and_fixed_documents},
        {"role": "user", "content": question},
    ],
    "reasoning": {"effort": "low"},
    "max_output_tokens": 2048,
    "store": False,
    "stream": True,
    "text": {"format": {
        "type": "json_schema",
        "name": "grounded_answer",
        "strict": True,
        "schema": Answer.model_json_schema(),
    }},
}
TTFT の計測で注意したいのは、最初の SSE イベントを回答開始としないことです。response.created や推論用のイベントが先に届いても、利用者向けの回答本文はまだありません。
完全版では SSE の各イベントを読み、最初の非空 response.output_text.delta が到着した時間を記録します。出力は JSON なので、ここでいう「最初の回答テキスト」は JSON 本文の最初の文字です。
if event.get("type") == "response.output_text.delta" and event.get("delta"):
    if first_answer_seconds is None:
        first_answer_seconds = time.perf_counter() - started
    answer_parts.append(event["delta"])
完了時間は HTTP ストリームを読み終えるまでです。最終イベントから status と usage も取得し、途中終了した短い応答を成功扱いしないようにしています。
実行手順
uv venv --python 3.12
uv pip install --python .venv/bin/python -r requirements.txt
cp .env.example .env
cp model-settings.example.json model-settings.json
# 自分の接続と秘密情報を設定する
.venv/bin/python -m unittest -v test_benchmark.py
.venv/bin/python benchmark.py --env-file .env --output results-new
.venv/bin/python summarize.py --results results-new --output summary-new.json
実測では既存の Python 環境を使い、次のコマンドを実行しました。
rag/backend/.venv/bin/python tmp/grok-rag-comparison/benchmark.py --env-file platform/.env --output tmp/grok-rag-comparison/results
実行ログの最初の主要要求は次のとおりでした。読みやすさのためメトリクスだけを抜き出しています。元の行は execution.log にあります。
model=xai.grok-4.3 case=fact repeat=1 HTTP=200 score=5
TTFT=3.3690s total=3.7767s
input_tokens=2882 cached_tokens=128 output_tokens=272 reasoning_tokens=223
--output は存在しないディレクトリを指定します。同梱の results/ は実測記録として残し、上書きしないようにしました。
5. 回答能力:基本問題では差が付かなかった
3モデルとも主要15回を完了し、定型チェックは15/15回で満点でした。矛盾する資料から勝手に値を選ばず、情報不足の場合に架空の周期を作らないことも確認できました。
Grok 4.7 が矛盾の質問に返した実回答の一つです。
{
  "status": "conflict",
  "value": null,
  "citations": ["D06", "D07"],
  "explanation": "D06とD07は同一日付・同一優先度でバッファXを100 MiBと180 MiBと示し、優先する記録が定義されていないため確定できない。"
}
ただし、引用の出し方には細かな差がありました。例外条件の質問で、4.6 と4.7は通常規則の D04 と例外の D05 を3回とも引用しました。4.3は3回とも D05 のみを引用し、そのうち2回答は説明文の中で D04 にも言及していました。
D05だけでも「3日」という答えを支えられるので、事前の定型採点では満点です。それでも、説明で参照した資料をすべて引用欄にそろえたい UI では、引用一覧の整合性に追加の検査が必要と分かります。この所見を、後から採点基準を変えて順位付けする材料にはしません。
今回の問題は、短い事実、簡単な加算、明示的な例外・矛盾・欠落です。重要資料も冒頭に置いています。長文の中間に埋もれた根拠、複雑な表や画像、曖昧な問い、権限別検索、悪意ある資料、実業務での網羅性は試していません。このセットだけでは、3モデルの RAG 能力の上限は区別できません。
6. 速度:今回の中央値は4.7が最短
質問の種類ごとに、3回の完了時間の中央値を比較しました。単位は秒です。
| 質問の種類 | Grok 4.3 | Grok 4.6 | Grok 4.7 |
|---|---|---|---|
| 事実抽出 | 4.859 | 3.374 | 2.711 |
| 複数資料の統合 | 6.458 | 4.147 | 4.073 |
| 例外条件 | 7.134 | 4.626 | 3.610 |
| 資料の矛盾 | 8.069 | 4.400 | 3.505 |
| 根拠不足 | 6.904 | 4.036 | 3.212 |
今回の各カテゴリでは4.7が最短でした。ただし、資料統合は4.6が4.147秒、4.7が4.073秒で、差は小さいものでした。小数の差をそのまま安定した優位性とは扱いません。
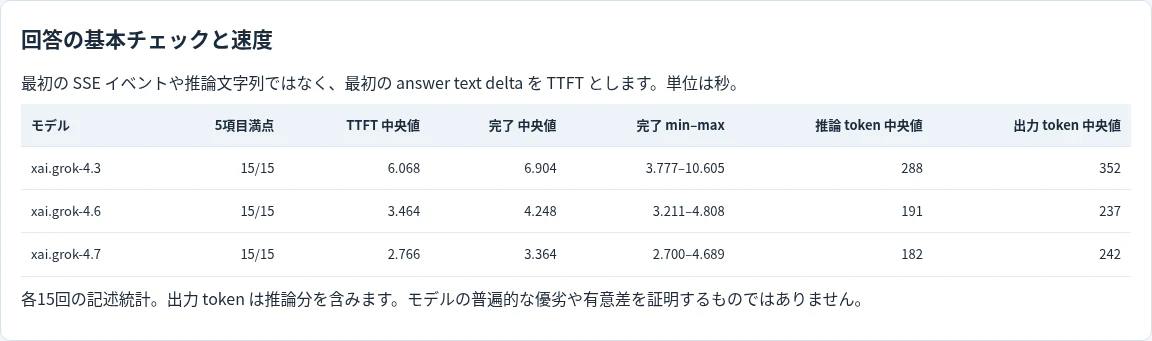
画像は、実測 JSON から生成したローカル HTML を Playwright で開いて撮影しました。OCI コンソールの画像ではありません。
入力テキストはモデル間で完全に同じことをハッシュで確認しましたが、API が返す入力 token 数の中央値は4.3が2,883、4.6が2,945、4.7が3,981でした。tokenizer や内部の入力表現などが異なる可能性があり、理由までは特定していません。
出力 token 数の中央値も4.3は352、4.6は237、4.7は242で、推論分も同じではありません。同じ low を指定した条件下の利用者向け待ち時間を比べた結果であり、同一 token 数の純粋な計算速度を測った結果ではありません。
初回と再送で分ける
Prompt Caching の影響を隠さないよう、各質問の初回5件と再送10件を分けました。
| モデル | 区分 | 件数 | 完了時間中央値・秒 | 入力全量のうち cached |
|---|---|---|---|---|
| xai.grok-4.3 | 初回 | 5 | 6.120 | 4.44% |
| xai.grok-4.3 | 再送 | 10 | 6.984 | 88.34% |
| xai.grok-4.6 | 初回 | 5 | 4.400 | 3.48% |
| xai.grok-4.6 | 再送 | 10 | 4.197 | 70.00% |
| xai.grok-4.7 | 初回 | 5 | 3.653 | 28.94% |
| xai.grok-4.7 | 再送 | 10 | 3.227 | 64.32% |
キャッシュ比率は、それぞれの区分で合計した cached_tokens / input_tokens です。初回にもキャッシュがあり、再送でも命中しない場合があります。キャッシュを強制消去する操作は行っていないため、「初回=完全なコールド」「再送=完全なウォーム」とは呼びません。
4.3は再送の方が中央値が長くなりました。キャッシュが増えても、推論量や応答の長さ、混雑などで完了時間が短くなるとは限らないことが、この小さな実験でも分かります。キャッシュの因果効果や有意差の検定は行っていません。
7. OCI の価格と、今回の費用試算
2026年11月5日に Oracle Cloud Price List と 公式価格 JSON を確認しました。USD、Pay As You Go、標準・短いコンテキスト、100万 tokens あたりの単価です。
| モデル | 普通入力 | キャッシュ入力 | 出力 | 主要15件の試算 |
|---|---|---|---|---|
| Grok 4.3 | US$1.25 | US$0.20 | US$2.50 | US$0.039494 |
| Grok 4.6 | US$2.00 | US$0.50 | US$6.00 | US$0.080088 |
| Grok 4.7 | US$2.00 | US$0.50 | US$6.00 | US$0.093744 |
計算は、返された usage に対して次を適用しています。
費用の試算 =
  (input_tokens - cached_tokens) × 普通入力単価 / 1,000,000
  + cached_tokens × キャッシュ入力単価 / 1,000,000
  + output_tokens × 出力単価 / 1,000,000
推論 token は output_tokens に含まれるため、もう一度加算しません。4.6と4.7は公開単価が同じでも、実測入力・出力・キャッシュ量が違うため、この試算額も同じにはなりません。
この条件では、4.3は待ち時間が最長でしたが、費用試算は最小でした。単純に最新モデルへ統一するより、必要な回答品質、待ち時間、費用を一緒に見る判断材料になります。
主試験45回と事前確認3回を合わせ、キャッシュ割引を適用しない保守的な公開単価の試算は US$0.327418 で、事前に決めたUS$5の予算内でした。上表の費用は事前確認3回を含まず、実測キャッシュ量を適用した値です。いずれも請求書の照合結果ではなく、税・契約割引・換算・追加サービス料金は含みません。
主要要求は約2,900〜4,000入力 tokensで、長いコンテキスト向け料金の境界から十分離れています。Priority を指定した場合や長文の場合には別の単価になり得るため、そのまま外挿しないでください。Oracle: Grok 4.6 の料金とサービス層の説明
8. 再現性を確認する
局所テスト14件で、型の不正、架空の引用 ID、重複、根拠不足時の値、推論イベントと回答イベントの区別などを検査しました。これはサービス性能の証明ではなく、測り方と採点の境界の確認です。
実測記録は audit_results.py で、入力ハッシュ、同じ質問での同じコンテキスト、45件の得点の再計算、SSE イベントからの TTFT、公開価格のスナップショットとの一致を確認できます。
.venv/bin/python audit_results.py
.venv/bin/python make_report.py
audit_results.py は同梱した45件の証跡を検査する専用コードです。新規実行が失敗した際の結果まで、自動的に同じ条件を満たすと扱うものではありません。
全45回の実測値
| 順 | モデル | 質問 | 回 | 点/5 | TTFT・秒 | 完了・秒 | 入力 | cached | 出力 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | xai.grok-4.3 | fact | 1 | 5 | 3.369 | 3.777 | 2882 | 128 | 272 |
| 2 | xai.grok-4.6 | fact | 1 | 5 | 3.074 | 3.374 | 2942 | 128 | 210 |
| 3 | xai.grok-4.7 | fact | 1 | 5 | 3.073 | 3.325 | 3978 | 1152 | 245 |
| 4 | xai.grok-4.6 | fact | 2 | 5 | 2.920 | 3.211 | 2942 | 128 | 215 |
| 5 | xai.grok-4.7 | fact | 2 | 5 | 2.155 | 2.700 | 3978 | 1152 | 178 |
| 6 | xai.grok-4.3 | fact | 2 | 5 | 4.441 | 4.859 | 2882 | 2816 | 271 |
| 7 | xai.grok-4.7 | fact | 3 | 5 | 2.367 | 2.711 | 3978 | 3968 | 185 |
| 8 | xai.grok-4.3 | fact | 3 | 5 | 4.999 | 5.486 | 2882 | 2816 | 275 |
| 9 | xai.grok-4.6 | fact | 3 | 5 | 3.203 | 3.691 | 2942 | 2816 | 196 |
| 10 | xai.grok-4.6 | multi_hop | 1 | 5 | 3.769 | 4.486 | 2945 | 128 | 299 |
| 11 | xai.grok-4.7 | multi_hop | 1 | 5 | 3.369 | 4.073 | 3981 | 1152 | 242 |
| 12 | xai.grok-4.3 | multi_hop | 1 | 5 | 6.497 | 7.625 | 2884 | 128 | 352 |
| 13 | xai.grok-4.7 | multi_hop | 2 | 5 | 3.981 | 4.689 | 3981 | 3968 | 239 |
| 14 | xai.grok-4.3 | multi_hop | 2 | 5 | 4.736 | 5.523 | 2884 | 2816 | 300 |
| 15 | xai.grok-4.6 | multi_hop | 2 | 5 | 3.253 | 4.147 | 2945 | 2944 | 226 |
| 16 | xai.grok-4.3 | multi_hop | 3 | 5 | 5.793 | 6.458 | 2884 | 128 | 402 |
| 17 | xai.grok-4.6 | multi_hop | 3 | 5 | 3.084 | 3.893 | 2945 | 128 | 223 |
| 18 | xai.grok-4.7 | multi_hop | 3 | 5 | 2.608 | 3.364 | 3981 | 1152 | 240 |
| 19 | xai.grok-4.7 | exception | 1 | 5 | 2.956 | 3.610 | 3982 | 1152 | 273 |
| 20 | xai.grok-4.3 | exception | 1 | 5 | 4.102 | 5.005 | 2885 | 128 | 279 |
| 21 | xai.grok-4.6 | exception | 1 | 5 | 4.265 | 4.626 | 2946 | 128 | 291 |
| 22 | xai.grok-4.3 | exception | 2 | 5 | 6.068 | 7.187 | 2885 | 2816 | 397 |
| 23 | xai.grok-4.6 | exception | 2 | 5 | 3.935 | 4.650 | 2946 | 2944 | 236 |
| 24 | xai.grok-4.7 | exception | 2 | 5 | 2.710 | 3.242 | 3982 | 1152 | 263 |
| 25 | xai.grok-4.6 | exception | 3 | 5 | 3.436 | 4.380 | 2946 | 2944 | 233 |
| 26 | xai.grok-4.7 | exception | 3 | 5 | 3.702 | 4.231 | 3982 | 1152 | 284 |
| 27 | xai.grok-4.3 | exception | 3 | 5 | 6.279 | 7.134 | 2885 | 2816 | 312 |
| 28 | xai.grok-4.3 | conflict | 1 | 5 | 8.963 | 10.605 | 2883 | 128 | 426 |
| 29 | xai.grok-4.6 | conflict | 1 | 5 | 3.721 | 4.400 | 2945 | 128 | 333 |
| 30 | xai.grok-4.7 | conflict | 1 | 5 | 2.928 | 3.653 | 3981 | 1152 | 289 |
| 31 | xai.grok-4.6 | conflict | 2 | 5 | 3.953 | 4.808 | 2945 | 128 | 311 |
| 32 | xai.grok-4.7 | conflict | 2 | 5 | 2.139 | 2.950 | 3981 | 1152 | 172 |
| 33 | xai.grok-4.3 | conflict | 2 | 5 | 6.188 | 7.064 | 2883 | 2816 | 408 |
| 34 | xai.grok-4.7 | conflict | 3 | 5 | 2.719 | 3.505 | 3981 | 3968 | 287 |
| 35 | xai.grok-4.3 | conflict | 3 | 5 | 7.015 | 8.069 | 2883 | 2816 | 388 |
| 36 | xai.grok-4.6 | conflict | 3 | 5 | 3.811 | 4.248 | 2945 | 2944 | 345 |
| 37 | xai.grok-4.6 | unanswerable | 1 | 5 | 2.989 | 3.745 | 2943 | 0 | 237 |
| 38 | xai.grok-4.7 | unanswerable | 1 | 5 | 3.415 | 4.067 | 3979 | 1152 | 250 |
| 39 | xai.grok-4.3 | unanswerable | 1 | 5 | 5.611 | 6.120 | 2883 | 128 | 310 |
| 40 | xai.grok-4.7 | unanswerable | 2 | 5 | 2.639 | 3.164 | 3979 | 3968 | 190 |
| 41 | xai.grok-4.3 | unanswerable | 2 | 5 | 6.284 | 6.904 | 2883 | 2816 | 368 |
| 42 | xai.grok-4.6 | unanswerable | 2 | 5 | 4.303 | 4.651 | 2943 | 2816 | 294 |
| 43 | xai.grok-4.3 | unanswerable | 3 | 5 | 6.418 | 7.184 | 2883 | 2816 | 379 |
| 44 | xai.grok-4.6 | unanswerable | 3 | 5 | 3.464 | 4.036 | 2943 | 2816 | 258 |
| 45 | xai.grok-4.7 | unanswerable | 3 | 5 | 2.766 | 3.212 | 3979 | 3968 | 226 |
おわりに
今回の基本問題では、3モデルとも正答・状態判定・必要な引用を返せました。回答能力の差を大きく評価できるほど難しいテストではなかった一方、待ち時間と費用には実用上の比較材料が得られました。
この条件で待ち時間を重視するなら4.7が候補、公開単価の費用試算を重視するなら4.3が候補です。4.6はその間の結果でした。採用前には、実際の資料を匿名化した評価セット、必要な引用の厳密さ、応答時間の分布を使って改めて確認したいところです。