
初めに
RAG を試していると、資料は取得できているのに、回答が合わないことがあります。
検索で見つからないのであれば、取り込みや検索の仕組みを調べます。
ただ、正しい原文が回答の根拠に入っていても、条件の適用を間違えたり、計算できる値を「資料にありません」と返したりすることがありました。
そこで今回は、検証用の日本語資料と質問を用意し、回答モデルを gpt-oss-120b から grok-4.3 に切り替えて比較しました。
本比較のために、モデルの切替に合わせてプロンプトを書き換えることはしていません。
実際の画面を操作して、検索とチャットをそれぞれ3回ずつ試しています。
この記事では、差が分かりやすかった次の2ケースを、実際のスクリーンショットと結果の両方で見ていきます。
- 「2営業日前まで」という条件を、前営業日の質問に正しく当てはめられるか
- 資料の単価と質問の数量から、合計額を計算できるか
資料はすべて今回作成した架空のデータです。実在する組織の規則や実務上の判断を扱ったものではありません。
先に結果
今回の2ケースでは、条件の適用と根拠から計算結果を出す挙動に、回答モデルによる実用上の差が見られました。
| 確認した内容 | gpt-oss-120b | grok-4.3 |
|---|---|---|
| 前営業日の取消しを50%と回答 | 4/6件 | 6/6件 |
| 1,200円×2時間を2,400円と回答し、予約期限も説明 | 3/6件 | 6/6件 |
各ケースの6件は、検索3回とチャット3回の合計です。
この表は、主要な結論を原本と人手で照合した件数です。自動評価器のスコアや、モデル全般の性能ランキングではありません。
gpt-oss-120b にも正答した実行があり、grok-4.3 にも補足手順を省略した回答がありました。その点も後で整理します。
1. 検証では何をそろえたか
日本語の資料を3形式で用意した
| 形式 | 資料 | 内容 | 索引に登録されたブロック数 |
|---|---|---|---|
| HTML | 検証用ラボ利用案内 | 開館時間、休館日、予約期限 | 4 |
| CSV | 検証用会議室一覧 | 定員、時間単価、設備 | 3 |
| 検証用キャンセル規則 | 取消しの期限、割合、手続き | 4 | |
| 合計 | 3ファイル | 同じKBに所属 | 11 |
HTML は Unstructured、CSV は CSV→JSONL と構造化レコード解析、PDF は Docling で処理しました。索引を作った後は、モデルごとに資料を作り直していません。
5問を同じ順序で送った
| 番号 | 質問の内容 | 確認したいこと |
|---|---|---|
| Q1 | 開館時間と休館日 | HTMLの事実を読み取れるか |
| Q2 | 会議室Aの定員・単価・設備 | CSVの項目を取り違えないか |
| Q3 | 前営業日に取り消す場合の割合と手続き | PDFの期間条件を適用できるか |
| Q4 | 会議室Aを2時間使う料金と予約期限 | 計算と複数資料の参照ができるか |
| Q5 | 会員割引は何%か | 記載のない割合を作らないか |
1モデルにつき、5問×検索・チャットの2経路×3回で、30回です。
2モデルを合わせて60回実行しました。
チャットは各回で新しい会話を作り、その中でQ1からQ5を順番に送りました。Q3だけを毎回独立した会話に送った試験ではありません。
変更したのはテスト用Profileの回答モデル
同じKBと検索・回答Profileを使い、Profileの answer_model_id を切り替えました。他のProfile設定と全体のモデル設定は、切替前後で一致することを確認しています。
| 項目 | 設定・確認内容 |
|---|---|
| 比較したモデルID |
openai.gpt-oss-120b / xai.grok-4.3
|
| 資料・KB・質問・順序 | 共通 |
| モデル切替に合わせたプロンプト変更 | なし |
| 登録設定の reasoning_effort | どちらも low
|
| 登録設定の最大出力トークン数 | どちらも32,768 |
| 実行方法 | 実際のUIから検索・送信 |
| 実際に使ったモデル | 保存された実行履歴で確認 |
| 判定方法 | 原本・期待する回答・実際の回答を人手で照合 |
| 検証日 | 2026年11月4日 |
なお、モデル別の最大入力設定は128,000と256,000で異なり、画像対応設定も異なります。試験時にすべての送信入力を固定したわけではありません。ただし後から保存診断を確認すると、ここで掲載する2組の対照例では、生成段階のアプリケーション側SystemとUserがそれぞれバイト単位で一致していました。HTTP要求全体やschemaまで同一と確認したわけではありません。
2. ケース1:根拠には「2営業日前」とある。それでも0%と答える
元の規則と正解
PDFには次のように書きました。
利用日の2営業日前の午後5時までの取消しは無料です。
上記の期限後から利用開始時刻までの取消しは、予約料金の50%です。
連絡のない不使用は、予約料金の100%を請求します。
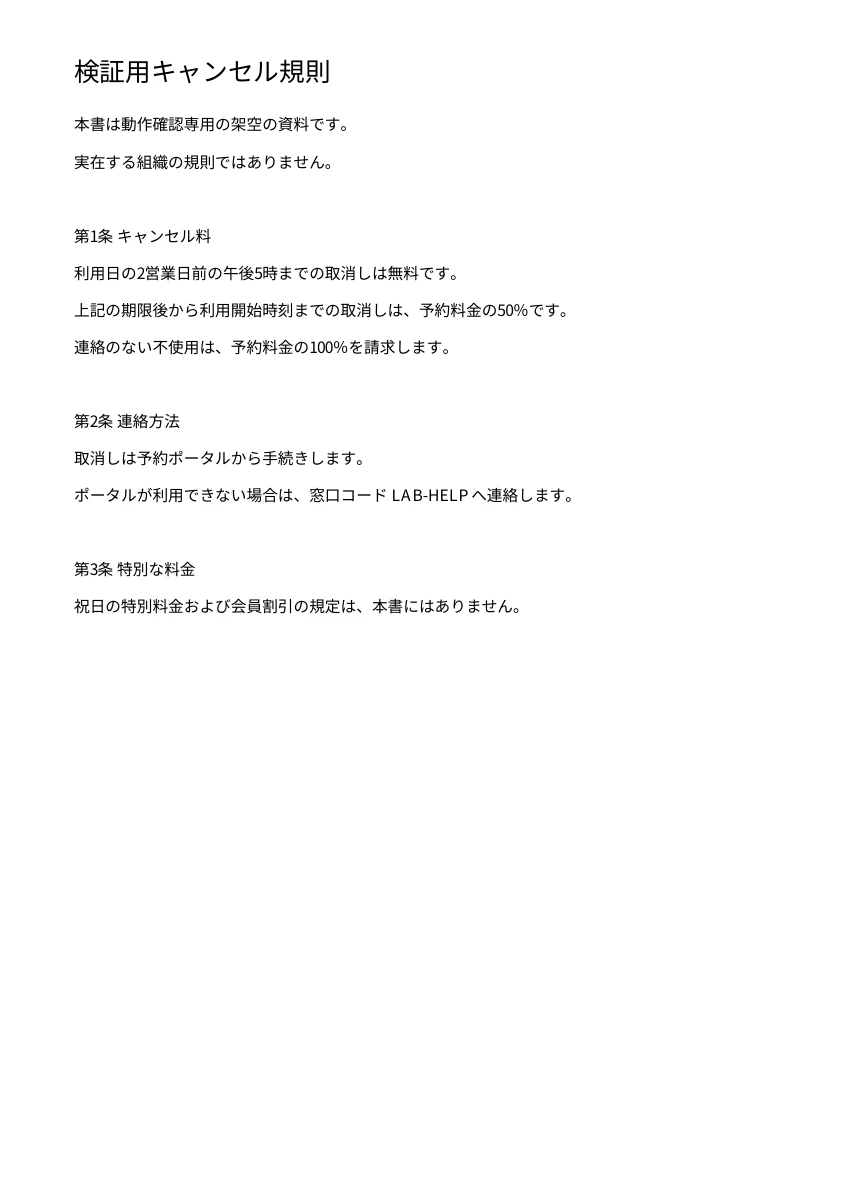
図1:検証に使ったPDFの表示画像。無料になる境界は「2営業日前」です。
質問は次です。
利用日の前営業日に予約を取り消した場合、キャンセル料は予約料金の何%ですか。手続き方法も教えてください。
前営業日は、2営業日前の期限を過ぎています。
したがって、正解は 50% です。手続きは予約ポータルから行い、ポータルが利用できない場合には LAB-HELP に連絡する、という補足も資料にあります。
gpt-oss-120b:原文を引用していても、当てはめがずれる
2回目のチャットでは、次の回答になりました。
利用日の前営業日に予約を取り消した場合、キャンセル料は無料(0%)です。

図2:gpt-oss-120b、チャット2回目。無料になる原文の条件を説明しながら、質問に対しては0%と答えています。会話上部のタイトルは最初の質問のままですが、吹き出しに表示されているのが今回の対象質問です。
ここで確認したかったのは、検索の失敗かどうかです。
保存された引用本文には、正しい「2営業日前」と「期限後は50%」が入っていました。PDFの取り込みで条件が消えたわけでも、必要な規則を検索できなかったわけでもありません。
この実行では、条件を質問へ当てはめるところで誤りが起きています。
引用元へのリンクがあることだけでは、結論の正しさまで保証できないことが分かります。
grok-4.3:期限の境界を保って50%と回答
同じ質問を送ったgrok-4.3の2回目のチャットです。
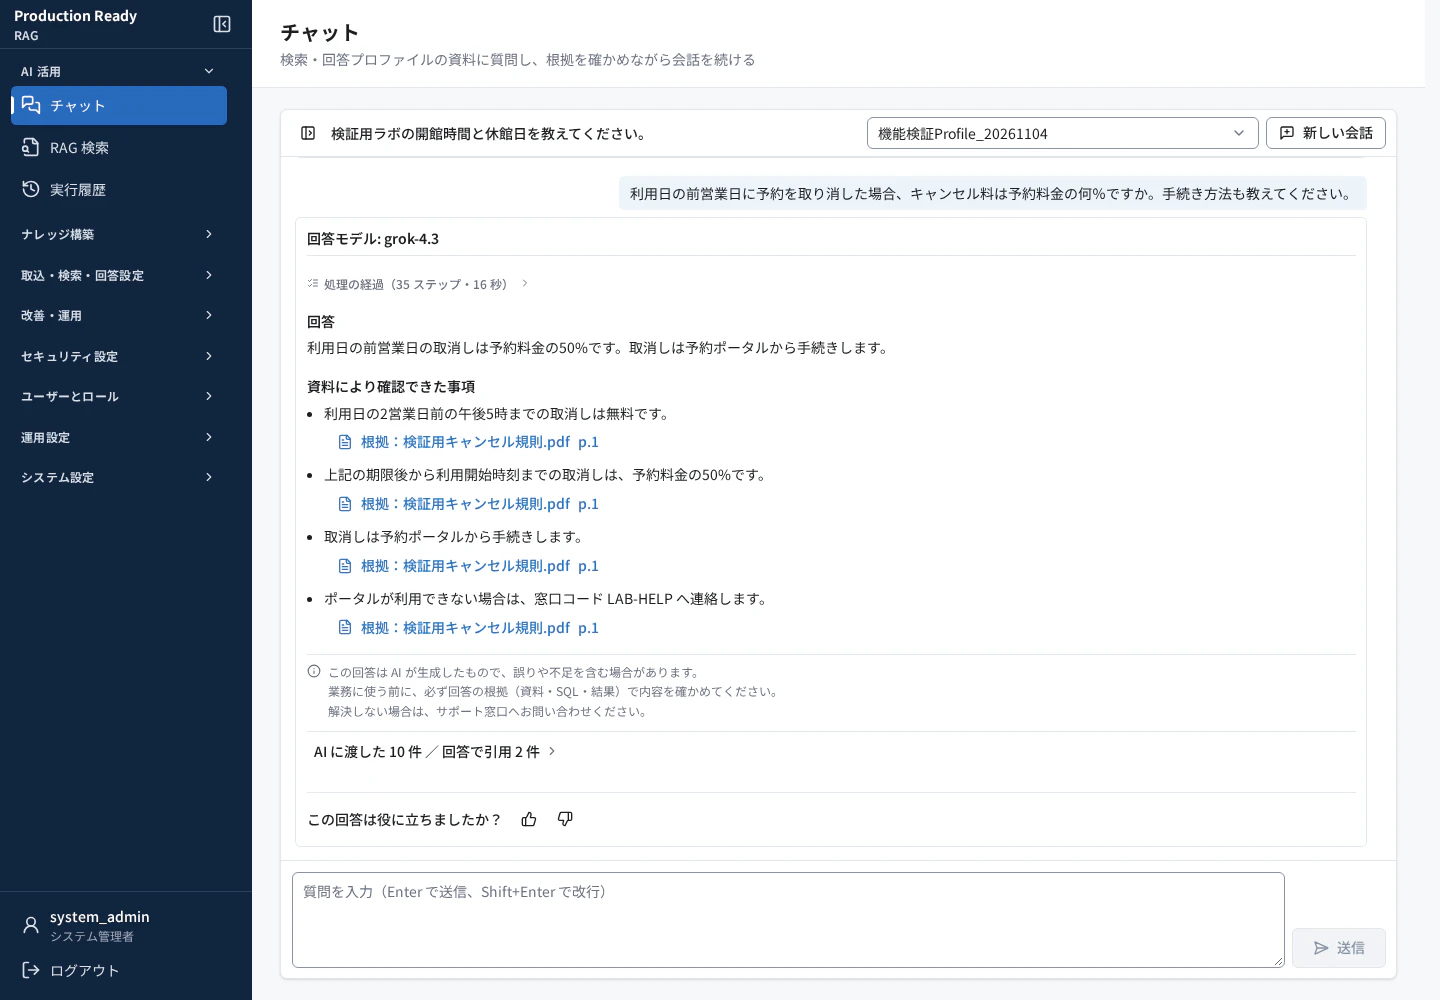
図3:grok-4.3、チャット2回目。2営業日前までの無料条件と、その後の50%を示したうえで、前営業日の取消しを50%と回答しています。
この回は、通常の取消方法と、ポータルを利用できない場合の連絡先まで説明していました。
3回ずつ見ると、失敗の出方が分かる
| 経路・モデル | 1回目 | 2回目 | 3回目 |
|---|---|---|---|
| 検索 / gpt-oss-120b | 50% | 50% | 50% |
| チャット / gpt-oss-120b | 0%・誤り | 0%・誤り | 50% |
| 検索 / grok-4.3 | 50% | 50% | 50% |
| チャット / grok-4.3 | 50% | 50% | 50% |
gpt-oss-120bも、チャットの3回目には正答しています。

図4:gpt-oss-120b、チャット3回目の正答。失敗した画面だけでは、この変動は見えません。
今回観測した差は、条件の適用結果をどれくらい安定して返せたか、という点です。
ただし、チャットでだけ誤りが出た理由や、会話文脈と生成過程のどちらが強く影響したかは、まだ確定していません。
3. ケース2:1,200円×2時間を「資料にない」と返す
必要な値は、すでにそろっている
CSVの該当する行は次です。
会議室,定員(人),1時間の料金(円),設備
会議室A,8,1200,プロジェクター
HTMLには予約期限を書きました。
会議室の予約は利用日の前営業日の午後5時までに申請します。1回の予約は最大2時間です。
質問は次です。
会議室Aを2時間利用すると料金はいくらですか。予約申請の締切も教えてください。
期待する回答は、次の2点です。
- 合計料金は
1,200円/時間 × 2時間 = 2,400円 - 申請は利用日の前営業日の午後5時まで
この合成データには、追加料金や割引の条件は設定していません。
gpt-oss-120b:合計額の直接記載を要求してしまう
3回目の検索では、単価と予約期限は説明できました。
一方、合計については次のように返しました。
2時間利用時の合計料金は資料に記載がありません。

図5:gpt-oss-120b、検索3回目。単価1,200円は取得できていますが、2時間分の計算結果を返していません。
これも、単価を検索できなかった事例ではありません。
保存された引用には1時間の料金があり、質問には2時間という数量があります。
資料の記述をそのまま答えることと、資料と質問から結果を導くことの境界で、回答が止まっています。
grok-4.3:原文の値と計算結果を分けて説明
同じ3回目の検索で、grok-4.3は次のように回答しました。
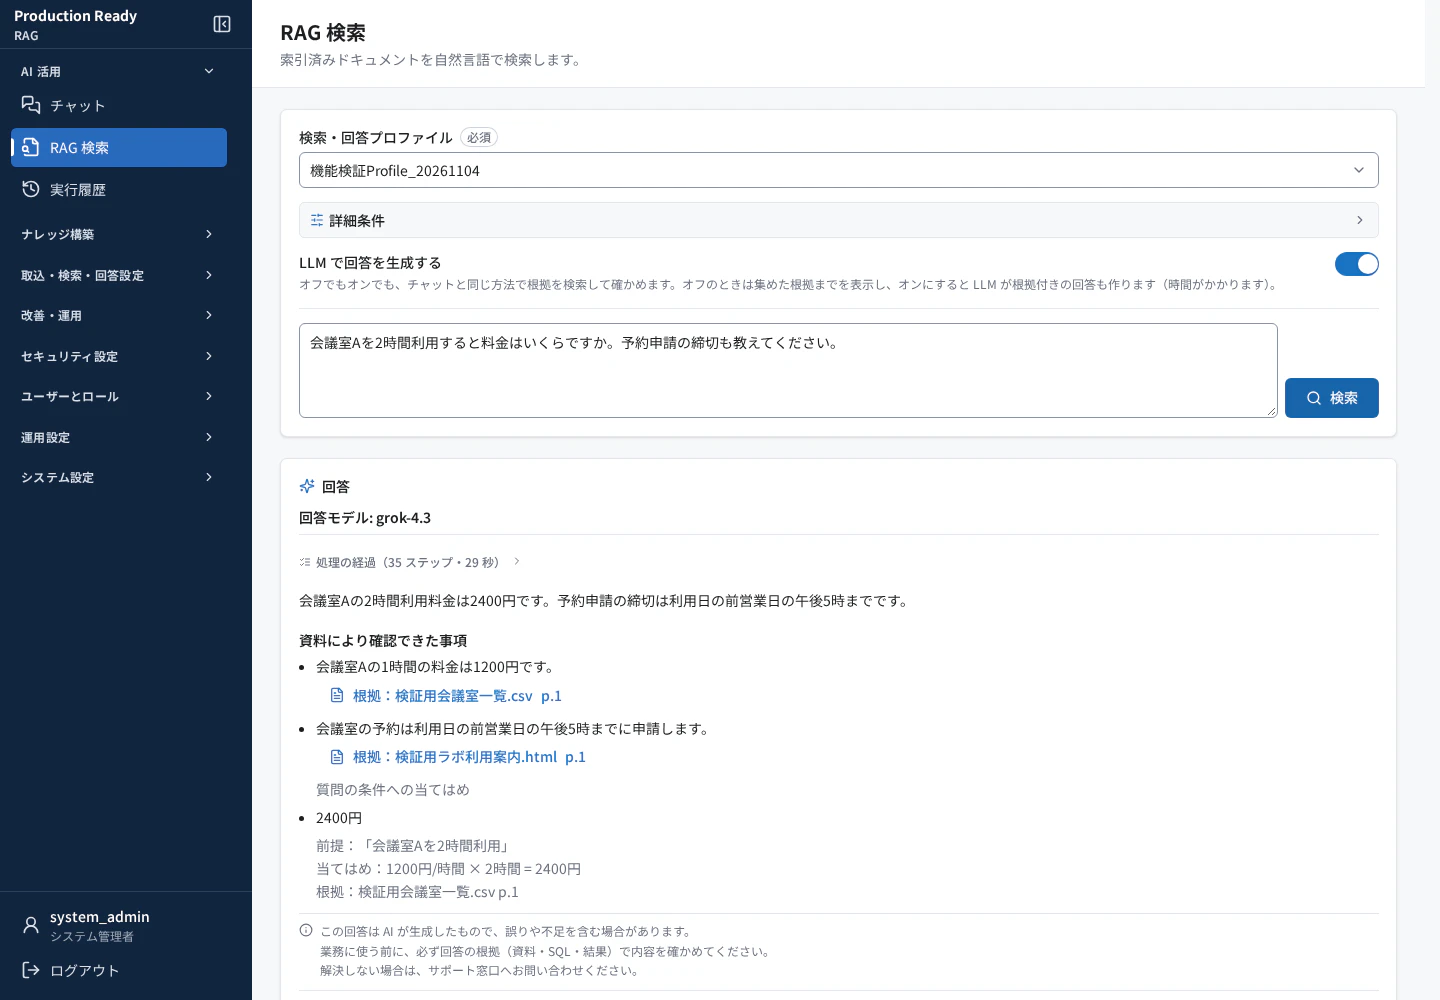
図6:grok-4.3、検索3回目。資料の単価と予約期限を示し、「質問の条件への当てはめ」として2,400円を出しています。
この表示では、資料に書かれていた1,200円と、そこから計算した2,400円を分けて確認できます。
今回の質問では、このような根拠付きの導出が必要でした。
こちらも、1回の正答だけでは判断できない
| 経路・モデル | 1回目 | 2回目 | 3回目 |
|---|---|---|---|
| 検索 / gpt-oss-120b | 2,400円+期限 | 合計を回答せず | 合計を回答せず |
| チャット / gpt-oss-120b | 2,400円+期限・注意表示あり | 2,400円+期限・注意表示あり | 合計を回答せず |
| 検索 / grok-4.3 | 2,400円+期限 | 2,400円+期限 | 2,400円+期限 |
| チャット / grok-4.3 | 2,400円+期限 | 2,400円+期限 | 2,400円+期限 |
gpt-oss-120bは、検索の最初の1回だけなら正答です。
繰り返して初めて、計算結果を返す場合と、資料不足とする場合があることを確認できました。
4. 数値の正しさと、回答の完全性は分けて見た
全5問についても確認しました。
| 確認項目 | gpt-oss-120b | grok-4.3 |
|---|---|---|
| 実行が完了した件数 | 30/30 | 30/30 |
| 主要な事実・結論が正しい件数 | 25/30 | 30/30 |
| 事前の標準回答に含めた要点まで満たした件数 | 25/30 | 27/30 |
grok-4.3の差分3件は、取消手続きの次の補足です。
ポータルが利用できない場合は、窓口コード LAB-HELP へ連絡します。
1回目の検索、1回目のチャット、3回目のチャットでは、50%という割合と予約ポータルでの手続きは説明しましたが、この代替連絡方法を省略しました。
質問は「手続き方法も教えてください」で、ポータルが利用できない場合まで明示的に尋ねてはいません。したがって、この3件は事前の標準回答に対する補足要点の未充足として分けています。主要な結論が誤っていた3件、という意味ではありません。
また、記載のない会員割引を尋ねるQ5では、両モデルとも数値を作りませんでした。grok-4.3の一部は「回答できません」という形ではなく、「本書に規定がありません」と直接説明していました。
実行履歴に「完了」と出ること、主要な結論が合うこと、説明が十分であることは、別々に確認する必要があります。
5. モデルの能力差として、どこまで言えるか
今回の観測では、grok-4.3は次の2点を安定して行いました。
- 資料に書かれた期間の境界を、質問の条件へ当てはめる。
- 資料にある単価と質問にある数量から、計算結果を導く。
モデル切替に合わせて指示を調整せず、この2ケースの結果が改善したことは、モデル選択が回答品質に影響した証拠の一つです。
一方、「grok-4.3は常に優れている」「原因はすべてモデルで、プロンプトには問題がない」とまでは言えません。
今回そろえたのは、資料、KB、保存済みのProfile設定、質問と順序、アプリケーションの構成です。検索結果の並びや生成途中の判断を含め、モデルへ送るすべての入力を固定した試験ではありません。モデル別の登録設定や画像対応も同じではありません。
さらに、検索とチャットには経路の違いがあり、チャットにはそれ以前の質問の文脈があります。各経路3回の結果から、一般的な正答率や失敗率を推定することもできません。
今回言えるのは、このRAG構成と合成の2ケースでは、grok-4.3の方が条件適用と計算結果の回答を安定して返した、という範囲です。
プロジェクトのプロンプトにも問題があるのか
その可能性は残ります。
同じプロジェクトの指示でも、モデルによって解釈や従い方が異なります。grok-4.3が正答したことだけで、現在のプロンプトが十分に明確だとは確認できません。
保存された入力を取り出すと、Systemの冒頭には「summaryとitemsは原文に明示された内容だけ」とあり、後段には「計算はapplicationsに書き、派生結果をsummaryに含めてよい」とありました。計算を全面的に禁止しているわけではありませんが、広い禁止と後段の例外を使い分ける必要があります。現在の51項目に利用者のカスタム上書きはなく、選んだ過去のSystemも現在のデフォルトと一致しました。
費用ケースでは、gpt-oss-120bの追加生成が2400円を算出した事実も見つかりました。ただし計算をapplicationsではなく証拠本文のitemsへ書き、最終回答にはその結論が採用されていませんでした。どの分岐で候補が採用されなかったかは未確定です。「掛け算ができない」とまとめると、実際の中間出力を見落とします。
一方、grok-4.3の費用回答はapplicationsへ計算を記述していました。この例では最初の通信が停止し、再試行で成功しています。最終回答の正しさと、最初の呼び出しでの成功は分けて読む必要があります。
補足手順の省略は、質問の範囲や期待する回答の定義にも左右されます。LAB-HELPの省略だけから、能力不足や指示の不具合とは決められません。
同じ保存入力で結果が違ったことは確認できました。ただし、モデルと提示文をそれぞれ変えた対照実験や、同一候補の後処理の再生はまだ行っていません。モデルの差と、指示・構造・最終採用の差を分けて検証する余地があります。
6. 実装側にも残る課題
モデルを切り替える比較は、問題の切り分けに役立ちました。
同時に、モデルが変わるだけで結果が揺れる部分を、どこまで実装で支えるかも見えてきます。
| 観測した問題 | 実装で検討したいこと |
|---|---|
| 引用はあるが期間の適用を誤る | 規則の対象、期限、質問の条件、適用結果を対応付けて検証する |
| 値がそろっていても計算しない | 値・単位・式を構造化し、確定的に処理できる計算をコードへ渡す |
| 合計額が原文にないと止まる | 原文の引用と、根拠付きで導いた結果を区別する |
| 補足手順が抜ける | 主要な結論と、求める説明の要点を別に評価する |
今回、これらの実装修正を行ったわけではありません。
モデルを変えて正答したことと、仕組みとして不具合を解消したことも分けて扱っています。
7. 次の検証で確かめたいこと
さらに能力差とシステム側の影響を切り分けるなら、次の比較が必要です。
- 同じ根拠テキストと同じ指示を固定して、モデルだけを変える。
- 単独質問と、前の会話がある質問を分ける。
- 「1営業日前」「2営業日前」「3営業日前」など、条件の境界を増やす。
- 単価や数量が欠ける問題も入れ、計算すべき場合と保留すべき場合を分ける。
- 実行回数を増やし、回答の正しさ、完全性、所要時間を別々に測る。
今回は、その前段階として、実際のUIで起きた差を記録した検証です。