
情報理論の勉強ノート
情報理論の目的から、情報量・エントロピー・相対エントロピー・相互情報量・通信路容量までを整理します。
情報理論は、「情報」を数学的に扱い、情報の圧縮と通信の限界を明らかにする学問です。
まずは、それぞれの概念が何を表しているのかという直感を理解し、その後に数式と定義を押さえる構成にします。
1. 情報理論の目的
情報理論は、1948年にクロード・シャノンが発表した論文を起点として発展した分野です。
情報理論が明らかにしようとしていることは、大きく2つあります。
① 究極のデータ圧縮とは何か?
データをどこまで小さく圧縮できるのか?
例えば、ある情報源から大量のデータが生成されるとします。
- データの性質を利用して圧縮する。
- 情報を失わずに圧縮できる限界を明らかにする。
- その限界に近づく圧縮方法を考える。
この限界を考えるうえで重要になるのが、情報源エントロピーです。(後述)
② 通信の究極の伝送レートとは何か?
通信路を使って、どれくらいの速度で情報を伝えられるのか?
- 通信路にはノイズが存在する。
- ノイズによって情報が正しく伝わらないことがある。
- それでも誤り率を限りなくゼロに近づけながら通信できる限界を明らかにする。
この限界を表すのが、通信路容量です。(後述)
2. 情報量(自己情報量)
2.1 情報量とは?
情報量を数学的に定義するにあたって、まずは「情報」に求めたい性質を考えます。
直感的には、以下の4つの性質を満たしてほしいところです。
① 珍しい情報ほど、情報量が大きい
- 明日、太陽が東から昇る。
- 明日、隕石が自宅に落ちてくる。
後者のほうが珍しい出来事なので、知ったときの情報量は大きいはずです。
つまり、発生確率が低い事象ほど情報量が大きくなってほしい。
② 確実に起こる出来事の情報量はゼロ
確率100%で起こることは、知る前から予測できています。
新しく得られる情報はありません。
③ 独立した情報の情報量は足し算できる
例えば、互いに独立した2つのニュースを知った場合、それぞれの情報量を足したものが全体の情報量になってほしい。
④ 情報量は常に0以上
何かを知ることで、得られる情報量がマイナスになることはないと考えます。
2.2 情報量の定義
上記の性質を満たす情報量として、事象 I(x) の自己情報量を次のように定義します。
$$
I(x) = -\log_2 P(x)
$$
自己情報量(Self-information)
- $I(x)$:事象 $x$ の情報量
- $P(x)$:事象 $x$ が発生する確率
- $\log_2$:底が $2$ の対数
- 単位:bit(ビット)
この式によって、先ほどの4つの性質を表現できます。
| 性質 | 数学的な表現 |
|---|---|
| 珍しいほど情報量が大きい | 確率 $P(x)$ が小さいほど $-\log_2 P(x)$ が大きい |
| 確実な事象の情報量はゼロ | $-\log_2 1 = 0$ |
| 独立した情報は足し算 | $-\log_2(p_1 p_2) = -\log_2 p_1 - \log_2 p_2$ |
| 情報量は0以上 | $0 < P(x) \le 1$ より $I(x) \ge 0$ |
※発生確率が0の事象は実際には起こらないため、通常の自己情報量の対象から除外します。
2.3 具体例:コインとサイコロ
公平なコインを投げたとき、表が出る確率は 1/2 です。
$$
\begin{aligned}
I(\text{表}) &= -\log_2 \frac{1}{2} \
&= \log_2 2 \
&= 1.0 \text{ bit}
\end{aligned}
$$
つまり、コインで表が出たという情報量は 1 bit です。これが情報量の最も基本的な単位となります。
一方、公平な6面サイコロを振ったとき、1が出る確率は 1/6 です。
$$
\begin{aligned}
I(1) &= -\log_2 \frac{1}{6} \
&= \log_2 6 \
&\approx 2.585 \text{ bit}
\end{aligned}
$$
つまり、サイコロで1が出たという情報量は約2.585 bitです。
コイン(確率1/2)よりもサイコロ(確率1/6)のように、確率が低い(珍しい)出来事ほど、発生したときの内容(情報量)が大きくなることが分かります。
2.4 対数を使う理由
ここは重要なポイントです。
対数を使うことで、独立した事象の情報量を足し算で表現できます。
独立した事象 $A, B$ について、その同時確率は次のようになります。
$$
P(A, B) = P(A)P(B)
$$
したがって、情報量は次のように展開できます。
$$
\begin{aligned}
I(A, B) &= -\log_2 (P(A)P(B)) \
&= -\log_2 P(A) - \log_2 P(B) \
&= I(A) + I(B)
\end{aligned}
$$
確率の掛け算を、情報量の足し算に変換できる。
これが対数を使う大きな理由です。
3. 情報源エントロピー(Shannon Entropy)
3.1 情報源エントロピーとは?
自己情報量は、ある事象が実際に発生したときの情報量でした。
一方、情報源エントロピーは、**ある情報源から得られる情報量の期待値(平均値)**です。
例えば、サイコロを振る前に考えてみます。
- 1が出る確率:1/6
- 2が出る確率:1/6
- ...
- 6が出る確率:1/6
実際にどの目が出るかは分かりません。
そこで、それぞれの事象の情報量を確率で重み付けして平均します。
3.2 情報源エントロピーの定義
離散確率変数 X のエントロピーは次の式で定義されます。
$$
H(X) = -\sum_{x} P(x) \log_2 P(x)
$$
- $X$:情報源を表す確率変数
- $x$:確率変数 $X$ が取り得る具体的な値
- $P(x)$:値 $x$ が出現する確率
- $H(X)$:情報源の平均情報量(エントロピー)
自己情報量との関係
各事象の自己情報量 $I(x) = -\log_2 P(x)$ の期待値(平均値)として表すことができます。
$$
H(X) = E[I(X)]
$$
つまり、自己情報量の期待値です。
3.3 具体例:公平なコインとサイコロ
① 公平なコインの場合
すべての出来事が等確率で起こる場合、エントロピーは自己情報量と一致します。
表と裏が出る確率がそれぞれ $1/2$ のとき、シャノンエントロピーは次のようになります。
$$
\begin{aligned}
H(X) &= -\sum_{i=1}^{2} \frac{1}{2} \log_2 \frac{1}{2} \
&= - \left( \frac{1}{2} \log_2 \frac{1}{2} + \frac{1}{2} \log_2 \frac{1}{2} \right) \
&= \log_2 2 \
&= 1.0 \text{ bit}
\end{aligned}
$$
公平なコインを1回投げるときに得られる平均情報量は 1.0 bit です。
② 公平なサイコロの場合
同様に、サイコロの各目(1〜6)が出る確率はすべて $1/6$ なので、シャノンエントロピーは次のようになります。
$$
\begin{aligned}
H(X) &= -\sum_{i=1}^{6} \frac{1}{6} \log_2 \frac{1}{6} \
&= \log_2 6 \
&\approx 2.585 \text{ bit}
\end{aligned}
$$
公平なサイコロを1回振るときに得られる平均情報量(エントロピー)は約 2.585 bit です。
3.4 エントロピーの直感的な意味
エントロピーは、情報源が持つ「不確実性(予測のつかなさ)」の大きさと考えると理解しやすいです。
以下の3つの情報源(サイコロ)を比較することで、その違いがはっきりと分かります。
① 情報源A:必ず「1」が出るサイコロ(決定論的)
出る目が完全に確定しているため、不確実性はまったくありません。
$$
H(X) = -1 \log_2 1 = 0 \text{ bit}
$$
- 状態: 不確実性なし(サプライズゼロ)
- 解説: 結果を振る前から知っているため、実際にサイコロを振っても新しい情報は何も得られません。そのためエントロピーは $0 \text{ bit}$ になります。
② 情報源B:特定の目が出やすいサイコロ(偏りあり)
例えば、「1」が出る確率が $1/2$($50%$)で、残りの目(2〜6)がそれぞれ $1/10$($10%$)の確率で出るようなイカサマサイコロの場合を考えます。
$$
\begin{aligned}
H(X) &= - \left( \frac{1}{2} \log_2 \frac{1}{2} + 5 \times \left( \frac{1}{10} \log_2 \frac{1}{10} \right) \right) \
&= - \left( \frac{1}{2}(-1) + \frac{1}{2}(-3.322) \right) \
&= 0.5 + 1.661 \
&\approx 2.161 \text{ bit}
\end{aligned}
$$
- 状態: 不確実性は中程度
- 解説: 「まぁまぁの確率で1が出るだろう」という予測が立つため、次に紹介する完全に公平なサイコロよりも予測がイージーになり、不確実性(エントロピー)は減少します($2.585 \to 2.161 \text{ bit}$)。
③ 情報源C:公平な6面サイコロ(完全にランダム)
すべての目が等確率($1/6$)で出る、最も予測が難しいサイコロです。
$$
H(X) = \log_2 6 \approx 2.585 \text{ bit}
$$
- 状態: 不確実性が最大
- 解説: どの目が評価されるか全く見当がつかないため、不確実性が最も高い状態です。6面サイコロが持ち得る最大のエントロピーがこの $2.585 \text{ bit}$ になります。
📊 まとめ:不確実性とエントロピーの関係
| サイコロの状態 | 予測のしやすさ | エントロピーの大きさ |
|---|---|---|
| 必ず1が出る | 完全に予測できる | $0 \text{ bit}$(最小) |
| 1が出やすい | ある程度予測できる | $\approx 2.161 \text{ bit}$(中) |
| 完全に公平 | まったく予測できない | $\approx 2.585 \text{ bit}$(最大) |
3.5 エントロピーとデータ圧縮の関係
ここが情報理論の重要なポイントです。
情報源エントロピーは、情報源を損失なく(可逆)圧縮するときの平均符号長の理論的な下限になります。
情報源が1文字あたり平均 $H(X)$ bit の情報を持つなら、平均符号長をそれより小さくすることはできません。これをシャノンの情報源符号化定理と呼びます。
💡 具体例:Yes/No クイズ(質問ゲーム)で考える
データ圧縮とは、コンピューターに対して「次に来る文字は何?」という Yes / No の質問(1ビット分)を繰り返し、最も少ない質問回数で正解にたどり着くゲームのようなものです。
いま、A, B, C, D の4つの文字だけを送信する情報源を考えます。
パターン1:どの文字も同じ確率(25%ずつ)で出る場合(エントロピー大)
すべての文字が等確率 $P(x) = 1/4$ でランダムに出現するとき、最も効率的な質問は「候補を常に半分に絞り込む」方法です。
- 「AかBですか?」 $\to$ Yes / No (1回目)
- 「Aですか?(NoならCですか?)」 $\to$ Yes / No (2回目)
どの文字を当てるにも、絶対に2回の質問(2ビット)が必要です。
このとき、情報源エントロピー $H(X)$ を計算すると次のようになります。
$$
\begin{aligned}
H(X) &= -\sum_{i=1}^{4} \frac{1}{4} \log_2 \frac{1}{4} \
&= -\sum_{i=1}^{4} \frac{1}{4} (-2) \
&= 2.0 \text{ bit}
\end{aligned}
$$
つまり、エントロピーが $2.0 \text{ bit}$ ということは、「平均して2回質問しないと絶対に正解を特定できない情報源」であることを意味します。したがって、これより短い平均符号長(例えば 1.5ビットなど)に圧縮することは数学的に不可能です。
パターン2:ほとんど「A」ばかり(約84.4%)出る場合(エントロピー小)
もし、出現確率に大きな偏りがあり、次のような確率分布だったとします。
- $P(\text{A}) = 27/32 \approx 0.844$
- $P(\text{B}) = 1/8 = 0.125$
- $P(\text{C}) = 1/64 \approx 0.016$
- $P(\text{D}) = 1/64 \approx 0.016$
この場合、先ほどと同じ質問の仕方は損をします。一番よく出る A を最優先で狙うのが賢い戦略です。
- 「Aですか?」 $\to$ Yesなら終了!(わずか1回の質問で 84.4% の確率でゲームクリア)
- Noだった場合、次に確率が高い
Bを狙って「Bですか?」と聞く。 - それでもNoなら、最後に「Cですか?」と聞く。
この戦略(ハフマン符号化の考え方)をとると、それぞれの文字を特定するのに必要な質問回数(符号長 $L_x$)は次のようになります。
-
A:1回(1ビット) -
B:2回(2ビット) -
C:3回(3ビット) -
D:3回(3ビット)
これらが発生する確率を踏まえて、1文字あたりの「平均質問回数(平均符号長 $\bar{L}$)」を計算すると、次のようになります。
$$
\begin{aligned}
\bar{L} &= (1 \times 0.844) + (2 \times 0.125) + (3 \times 0.016) + (3 \times 0.016) \
&= 0.844 + 0.250 + 0.048 + 0.048 \
&= 1.190 \text{ bit}
\end{aligned}
$$
なんと、平均して約1.19回の質問で済むようになり、2ビットよりもはるかに小さく圧縮できました。
このとき、情報源エントロピー $H(X)$ を計算すると 約0.81 bit になります。
定理が示す通り、偏りがあるおかげで平均符号長をぐっと小さくできましたが、本質的な不確実性の限界値であるエントロピーの下限($0.81 \text{ bit}$)を決して下回ることはできないのです。
$$
\boxed{\bar{L} \ge H(X)}
$$
- $\bar{L}$:1記号(1文字)あたりの平均符号長
- $H(X)$:情報源エントロピー
適切な符号化(ハフマン符号や算術符号など)を行えば、長い系列に対する平均符号長をエントロピーに限りなく近づけることができます。
つまり、エントロピーが小さい(不確実性が低く、偏りがある)情報源ほど、効率よく小さく圧縮できるということを意味しています。
4. 相対エントロピー(KL Divergence)
4.1 相対エントロピーとは?
相対エントロピーは、2つの確率分布がどれくらい異なっているかを表す指標です。KLダイバージェンスとも呼ばれます。
例えば、以下の2つの確率分布を考えます。
- $P$:実際の確率分布(真の分布)
- $Q$:予測やモデルが想定している確率分布(近似分布)
実際の確率分布 $P$ に対して、誤った分布 $Q$ を使って情報を表現(符号化)すると、どれくらい無駄(余計)な情報量が必要になるのか? を表すのが相対エントロピーの本質です。
4.2 相対エントロピーの定義
$$
D_{\mathrm{KL}}(P \parallel Q) = \sum_x P(x) \log_2 \frac{P(x)}{Q(x)}
$$
- $D_{\mathrm{KL}}(P \parallel Q)$:分布 $Q$ の分布 $P$ に対するKLダイバージェンス
- $P(x)$:基準となる実際の確率分布
- $Q(x)$:比較対象(予測モデルなど)の確率分布
4.3 相対エントロピーの性質
① 必ず0以上になる(非負性)
$$
D_{\mathrm{KL}}(P \parallel Q) \ge 0
$$
これを**ギブスの不等式(Gibbs' inequality)**と呼びます。
② 2つの確率分布が一致するときのみ0になる
$$
P(x) = Q(x) \ \Longrightarrow \ D_{\mathrm{KL}}(P \parallel Q) = 0
$$
2つの分布がすべての $x$ において完全に一致していれば、分布間の無駄な情報量はゼロになります。
③ 対称性を持たない(非対称性)
$$
D_{\mathrm{KL}}(P \parallel Q) \neq D_{\mathrm{KL}}(Q \parallel P)
$$
ここは非常に重要なポイントです。$P$ から見た $Q$ のズレと、$Q$ から見た $P$ のズレは等しくありません。そのため、相対エントロピーは数学的な意味での**「距離(Distance)」の要件を満たさず**、あくまで「隔たり(Divergence)」と呼ばれます。
4.4 相対エントロピーの直感的な意味
例えば、実際のデータの出現確率が $P$、予測モデルの出現確率が $Q$ だったとします。
- モデルが優秀な場合: 実際の分布を正しく捉えているため、KLダイバージェンスは $0$ に近くなります。
- モデルが未熟な場合: 実際の分布と予測モデルの分布が大きく異なっているため、KLダイバージェンスは大きくなります。
この性質があるため、機械学習(特に分類問題のクロスエントロピー誤差の最小化や、生成モデルの学習など)では、「予測モデルの確率分布を実際のデータの分布に極限まで近づけるための損失関数」として利用されています。
5. 相互情報量(Mutual Information)
5.1 相互情報量とは?
相互情報量は、ある確率変数が、別の確率変数についてどれくらいの情報を持っているかを表す指標です。
例えば、次の2つの確率変数を考えます。
- $X$:天気
- $Y$:傘を持っているかどうか
天気が分かれば、傘を持っているかどうかをある程度予測できます。つまり、$X$ の情報を知ることで $Y$ の不確実性が減少します。
このような、2つの確率変数の間に存在する情報の共有量を表すのが相互情報量です。
5.2 相互情報量の定義
$$
I(X; Y) = H(X) - H(X|Y)
$$
- $H(X)$:$Y$ を知る前の $X$ の不確実性(エントロピー)
- $H(X|Y)$:$Y$ を知った後に残る $X$ の不確実性(条件付きエントロピー)
言葉で表すと、次のようになります。
$$
\boxed{ \text{相互情報量} = \text{知る前の不確実性} - \text{知った後の不確実性} }
$$
5.3 相互情報量の別の表現
相互情報量には、ベン図の重なり(共通部分)から分かるように、いくつかの等価な表現があります。
$$
\boxed{I(X; Y) = H(X) - H(X|Y)}
$$
$$
\boxed{I(X; Y) = H(Y) - H(Y|X)}
$$
$$
\boxed{I(X; Y) = H(X) + H(Y) - H(X, Y)}
$$
確率分布(同時確率と周辺確率)を使って表すと、次のようになります。
$$
I(X; Y) = \sum_{x, y} P(x, y) \log_2 \frac{P(x, y)}{P(x)P(y)}
$$
5.4 相互情報量と相対エントロピーの関係
ここは非常に重要なポイントです。相互情報量は、実は相対エントロピー(KLダイバージェンス)の特殊なケースとしてスッキリ表せます。
$$
\boxed{ I(X; Y) = D_{\mathrm{KL}} \left( P_{XY} \parallel P_X P_Y \right) }
$$
- $P_{XY}$:$X$ と $Y$ の実際の同時確率分布
- $P_X P_Y$:$X$ と $Y$ が完全に独立だと仮定した場合の確率分布
つまり、「$X$ と $Y$ の実際の関係が、もし2つが完全に無関係(独立)だった場合の分布からどれくらいズレているか」を表しています。
5.5 相互情報量の性質
① 必ず0以上になる(非負性)
$$
I(X; Y) \ge 0
$$
② 完全に独立している場合は0になる
$$
X \perp Y \ \Longrightarrow \ I(X; Y) = 0
$$
$X$ を知っても $Y$ について何も情報が得られない(完全に無関係な)場合、共有している情報量はゼロになります。
③ 対称性がある
$$
I(X; Y) = I(Y; X)
$$
$X$ から見た $Y$ の情報量と、$Y$ から見た $X$ の情報量は常に同じです。ただし、これは「天気が傘に影響を与えている」といった因果関係の向きを表しているわけではない点に注意が必要です。
📊 エントロピーと相互情報量の関係(ベン図)
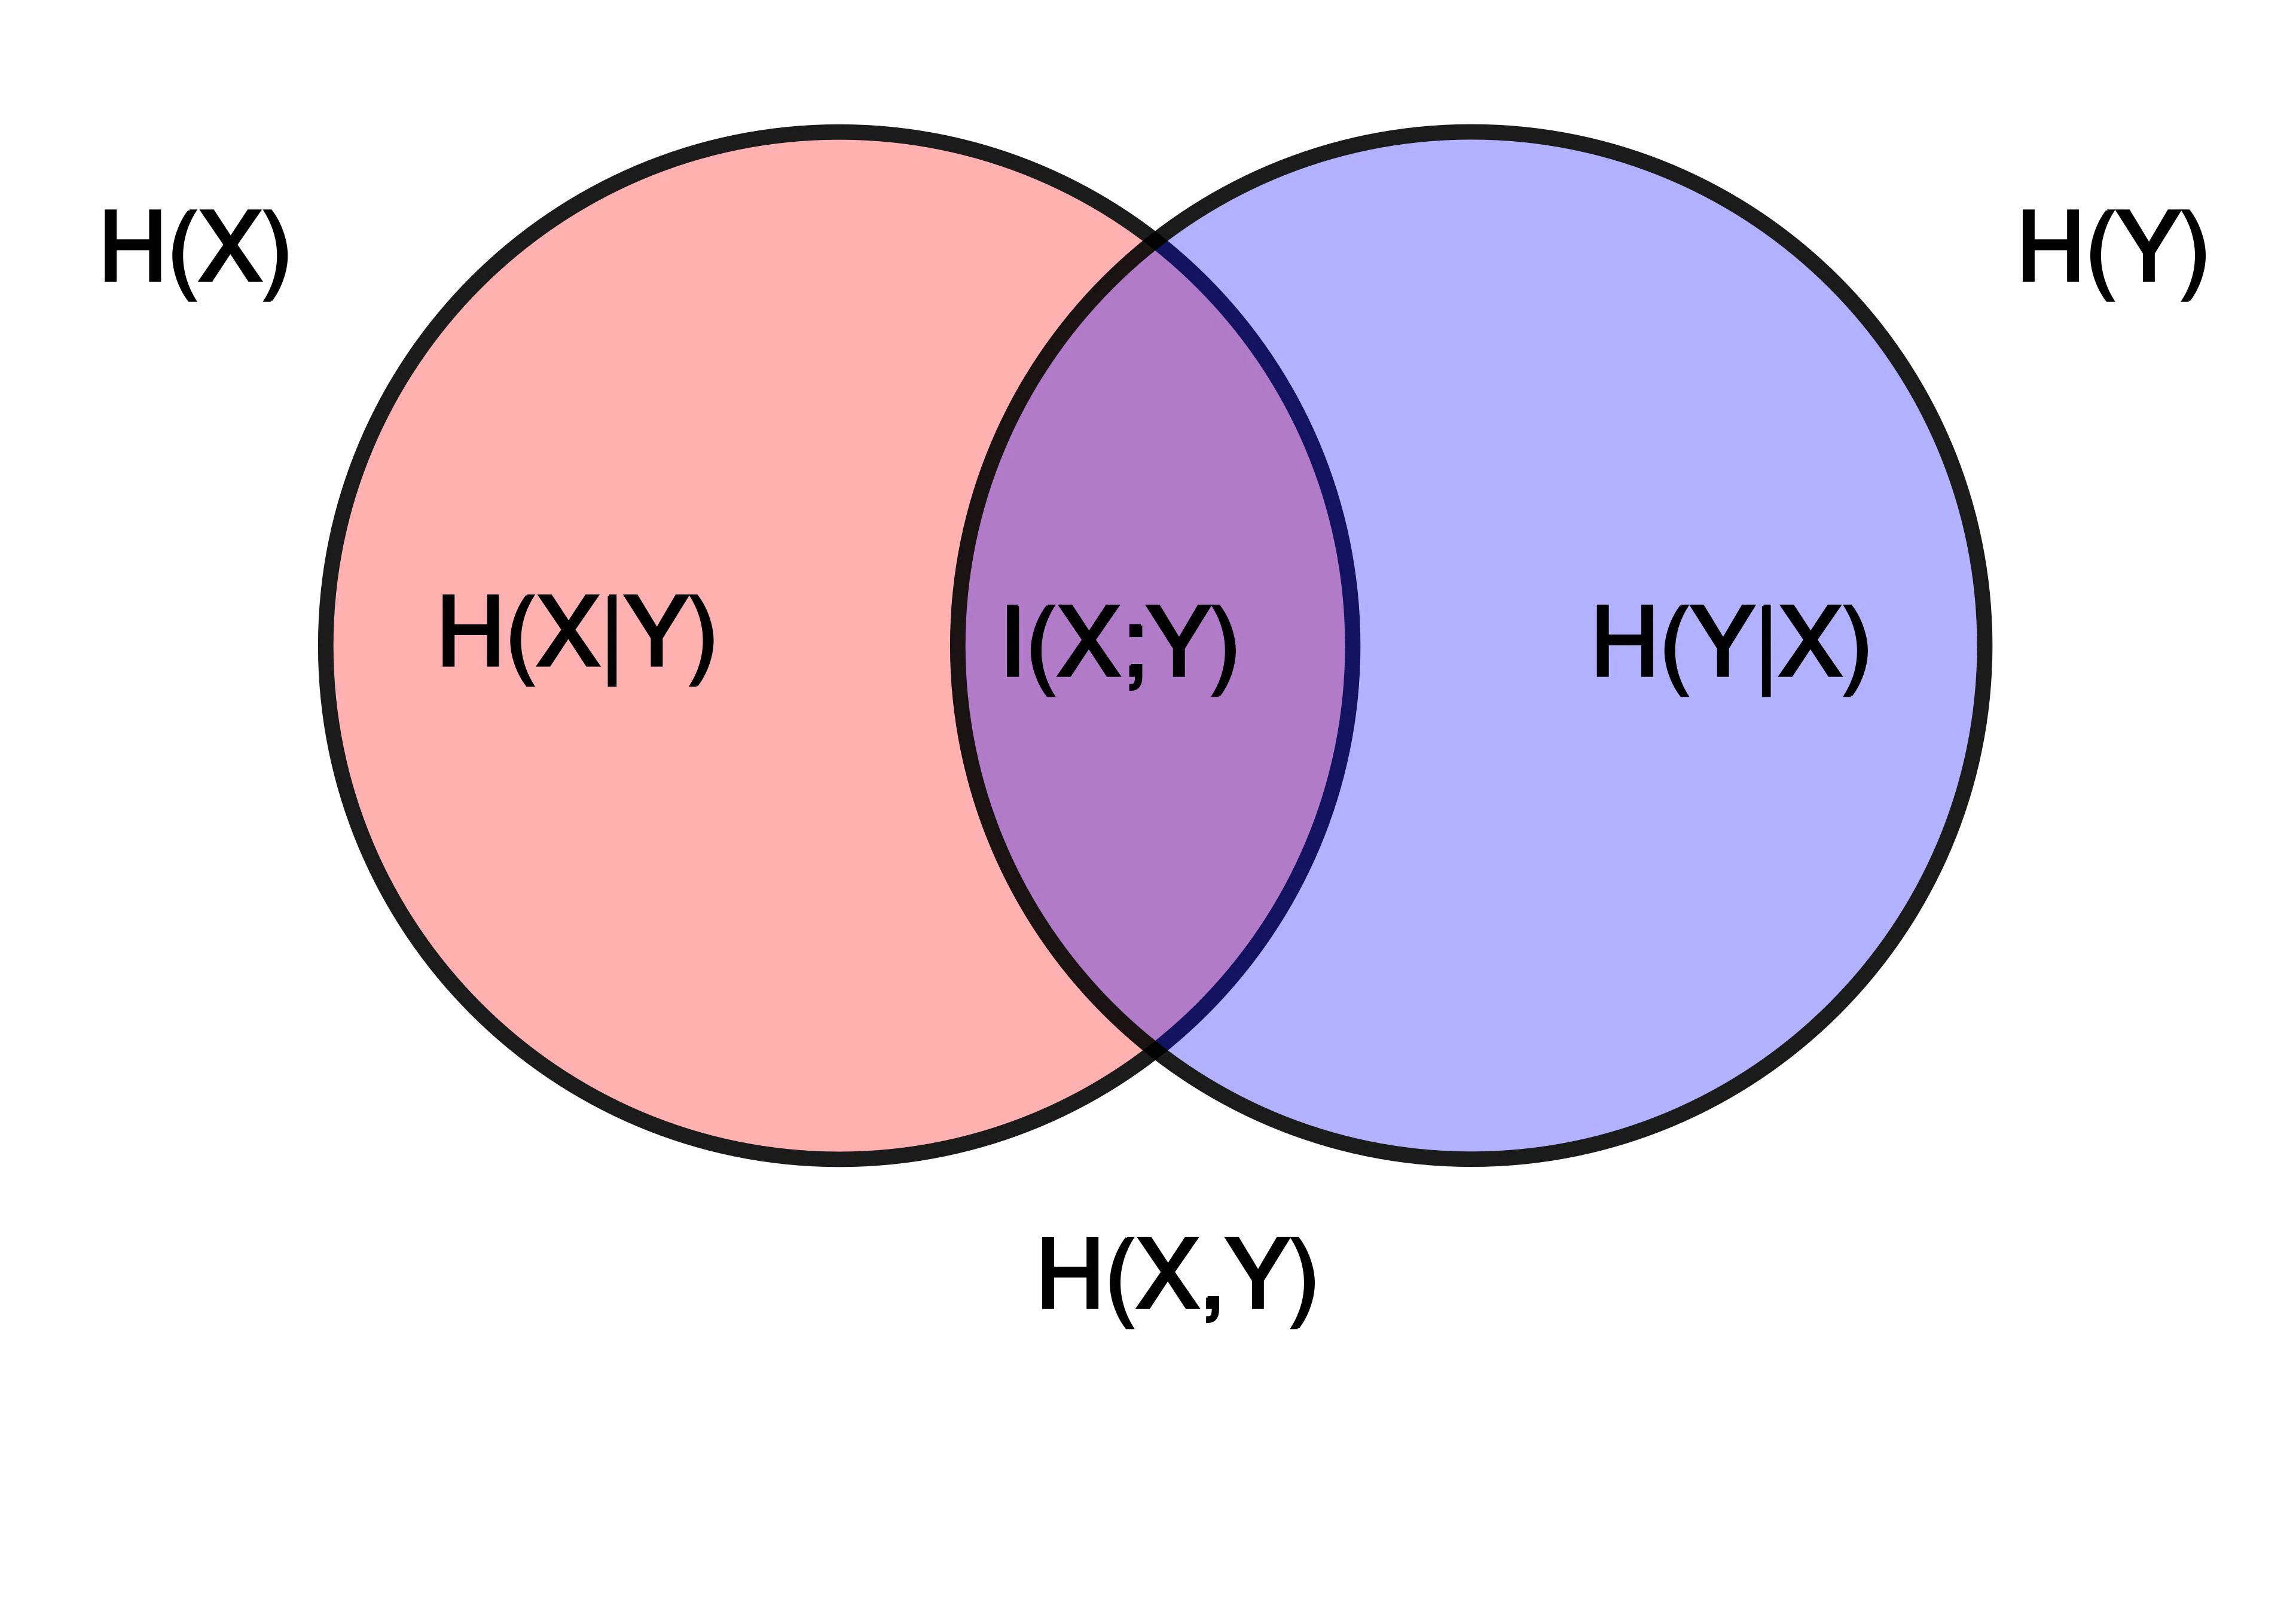
情報を集合の重なりとして考えると、相互情報量は $X$ と $Y$ が共有する情報量(共通部分)に相当することが一目で分かります。
$$
H(X) = I(X; Y) + H(X|Y)
$$
6. 通信路容量(Channel Capacity)
6.1 通信路容量とは?
通信路容量とは、通信路を通じて誤り率を限りなくゼロに近づけながら伝送できる情報量の理論的な最大値です。
どのような通信路にも、大なり小なりノイズが存在します。例えば、送信側が「0」を送ったとしても、ノイズの影響で受信側が「1」と認識してしまう可能性があります。
そこで、通信路のノイズ特性を考慮したうえで、**「どれくらいの情報量までなら正しく伝送できるか」**の限界を考えたものが通信路容量です。
6.2 通信路容量の定義
通信路容量は、送信側の確率変数 $X$ と受信側の確率変数 $Y$ の相互情報量を最大化したものです。
$$
C = \max_{P(X)} I(X; Y)
$$
- $C$:通信路容量
- $X$:送信側の入力(送信信号)
- $Y$:受信側の出力(受信信号)
- $I(X; Y)$:送信側と受信側の相互情報量
- $\max_{P(X)}$:入力の確率分布 $P(X)$ を変えて相互情報量を最大化する
つまり、**「通信路の性能を最大限に引き出すような、最も効率の良いデータの送り方(入力確率分布)を探す」**ということを意味しています。
6.3 通信路容量の直感的な意味
通信路容量が大きいほど、ノイズのある環境でも多くの情報を正確に伝えられます。
**シャノンの通信路符号化定理(シャノンの第二定理)**によると、次のことが数学的に証明されています。
- 通信速度 $R < C$ の場合: 適切な符号化(エラー訂正符号など)を行うことで、データの誤り率を限りなく $0$ に近づけることができる。
- 通信速度 $R > C$ の場合: どのような符号化を行っても、誤り率を限りなく $0$ にすることは絶対にできない。
つまり、通信路容量 $C$ は、ノイズがある世界で**「100% 正確に通信できる絶対的な理論限界」**を示しています。
6.4 具体例:2元対称通信路(BSC)
送信したビット(0または1)が、確率 $p$(※画像内の $\varepsilon$)で反転して相手に届くような、最も基本的なノイズモデルを考えます。

この通信路の容量 $C$ は、次のシンプルな式で計算できます。
$$
\boxed{C = 1 - H_b(p)}
$$
ここで、$H_b(p)$ は二項エントロピー関数と呼ばれ、次のように定義されます。
$$
H_b(p) = -p \log_2 p - (1 - p) \log_2 (1 - p)
$$
🧮 実際の計算例
例えば、ビットが反転するエラー確率が $p = 0.1$($10%$)の場合:
$$
H_b(0.1) \approx 0.469 \text{ bit}
$$
$$
C = 1 - 0.469 = 0.531 \text{ bit/回}
$$
したがって、この通信路の容量は約 $0.531 \text{ bit/回}$ になります。
これは、「$10%$ の確率でデータが化ける部屋で通信する場合、1回ボタンを押すごとに最大で約 $0.531 \text{ bit}$ 分の情報をエラーなし(高信頼)で送り届けることができる」という理論上の限界を表しています。
※この例では、1回の通信(1ビット送信)を1チャネル使用として計算しています。
7. ここまでの概念の関係性
ここまで学んだ5つの概念は、実は密接につながっています。
| 概念 | 何を表すか | 重要な公式 |
|---|---|---|
| 自己情報量 | ある事象が持つ情報量 | $I(x) = -\log_2 P(x)$ |
| 情報源エントロピー | 平均的な情報量・不確実性 | $H(X) = -\sum_x P(x) \log_2 P(x)$ |
| 相対エントロピー | 2つの確率分布の違い | $D_{\mathrm{KL}}(P \parallel Q) = \sum_x P(x) \log_2 \frac{P(x)}{Q(x)}$ |
| 相互情報量 | 2つの確率変数が共有する情報量 | $I(X; Y) = H(X) - H(X|Y)$ |
| 通信路容量 | 通信路で伝送できる情報量の最大値 | $C = \max_{P(X)} I(X; Y)$ |
🗺️ 概念のつながりを整理(ロードマップ)
【自己情報量】
$$I(x) = -\log_2 P(x)$$
個々の事象が持つ情報量↓ 確率変数全体の期待値(平均)を取る
【情報源エントロピー】
$$H(X) = E[I(X)]$$
情報源が持つ平均的な情報量(不確実性)―― 一方、確率分布同士の違いを測る指標として以下を定義 ――
【相対エントロピー(KLダイバージェンス)】
$$D_{\mathrm{KL}}(P \parallel Q)$$
2つの確率分布の違い↓ 「実際の同時分布 $P_{XY}$」と「独立だと仮定した分布 $P_X P_Y$」を比較する
【相互情報量】
$$I(X; Y) = D_{\mathrm{KL}}(P_{XY} \parallel P_X P_Y)$$
2つの確率変数が共有する情報量↓ 通信路における相互情報量を最大化(入力を最適化)する
【通信路容量】
$$C = \max_{P(X)} I(X; Y)$$
その通信路が100%正確に伝えられる情報量の限界値
8. 公式一覧(復習用)
最後に、今回登場した重要な公式をまとめます。
| No. | 公式 | 意味 |
|---|---|---|
| 1 | $I(x) = -\log_2 P(x)$ | 自己情報量 |
| 2 | $H(X) = E[I(X)]$ | エントロピー(定義) |
| 3 | $H(X) = -\sum_x P(x) \log_2 P(x)$ | エントロピーの展開式 |
| 4 | $D_{\mathrm{KL}}(P \parallel Q) = \sum_x P(x) \log_2 \frac{P(x)}{Q(x)}$ | 相対エントロピー(KLダイバージェンス) |
| 5 | $I(X; Y) = H(X) - H(X|Y)$ | 相互情報量(エントロピーによる表現) |
| 6 | $I(X; Y) = D_{\mathrm{KL}}(P_{XY} \parallel P_X P_Y)$ | 相互情報量(相対エントロピーによる表現) |
| 7 | $C = \max_{P(X)} I(X; Y)$ | 通信路容量 |
| 8 | $\bar{L} \ge H(X)$ | 無損失圧縮における平均符号長の下限 |
9. 参考文献
① 情報理論 基礎と広がり
情報理論 -基礎と広がり- (Amazon)
情報理論の名著。
大学時代の教授からも、この本の1・2章が情報理論の本質だと教わりました。
② マルチメディア時代の情報理論
改訂 マルチメディア時代の情報理論 (Amazon)
大学時代に読んだ本で、自分が読んだの改定前でした。
『情報理論 基礎と広がり』が分厚く難しく感じたため、こちらを読みました。
数式や定義について、その意味やモチベーションが丁寧に説明されており、理解しやすかったです。