
講演やパネルディスカッションの録画をテキストにして残したい、という要件はわりとよくある。検索できない動画を検索できる形にしておきたい、という動機だ。
このとき「要約ツール」と呼ばれるものをそのまま信用すると、だいたいどこかで詰まる。詰まる箇所は素材側にあって、ツール側にはない。以下、実際に手を動かして分けた整理を残しておく。
アプローチは 2 系統ある
動画からテキストを得る経路は大きく 2 つ。
-
字幕を読む:YouTube の字幕トラック(手動または自動生成)を取得して、それを要約する。
-
音声を認識する:音声トラックを文字起こしして、そこから要約する。
ほとんどの要約サービスは 1 の経路を通っている。実装が軽く、字幕さえ取れれば精度も高い。ただしこの経路は、字幕が存在しない動画では成立しない。録画、会場収音、複数人の議論、非公開に近い素材。要するに「要約したい場面」のかなりの部分がここに落ちる。
2 の経路は計算量が増えるが、素材を選ばない。どちらを選ぶかは、手持ちの動画に字幕があるかではなく、「字幕がない素材を扱う予定があるか」で決めたほうがいい。
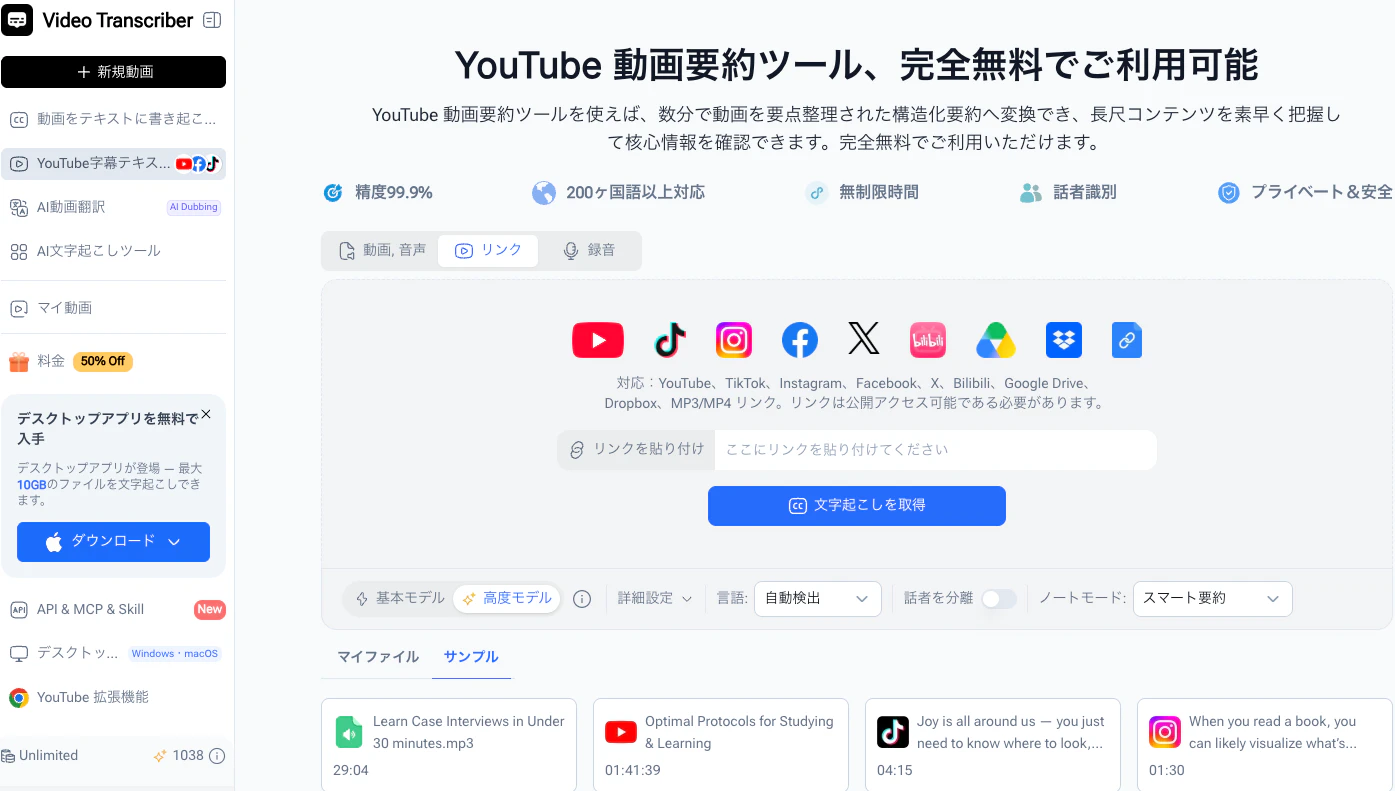
自前で組む前に前提を整理しておくと、素材が公開リンクで手に入るなら YouTube 動画要約ツール(Video Transcriber AI)のように音声から処理する経路を採っているサービスを使う手もある。以降は、自前で組む場合に何で詰まるかを先に書く。
前処理:音声を 16 kHz モノラルに落とす
音声認識を通す場合、元の動画ファイルをそのまま渡すより、音声だけを取り出して整えたほうが安定する。コンテナとサンプルレートの揺れで落ちることがあるためだ。
# 音声トラックだけを取り出す(再エンコードしない)
ffmpeg -i input.mp4 -vn -acodec copy audio.m4a

# 認識系に渡すなら 16 kHz モノラル wav が無難
ffmpeg -i input.mp4 -vn -ar 16000 -ac 1 -c:a pcm_s16le audio.wav

# 長尺を分割する(例:10 分ごと)
ffmpeg -i audio.wav -f segment -segment_time 600 -c copy part_%03d.wav
-ar 16000 -ac 1 は多くの音声認識系が想定している条件に近い。ステレオのまま渡すと、話者分離の精度が落ちることがあるので、モノラルに落としておくほうが安全側。
長尺を分割する意味は、失敗時の再実行範囲を狭めることと、メモリ上限に当たるのを避けること。1 時間超を一括で投げて途中で落ちるより、10 分単位で結果を連結したほうが復旧が楽。
詰まるポイント 5 つ
1. 字幕の有無で挙動が変わる
先に書いた通り。字幕前提の実装は、字幕がないときにエラーではなく「それらしい要約」を返すことがある。自動字幕は専門用語をもっともらしい別の語に置き換えるので、気づかないまま誤った要約を採用しうる。素材を選ぶ前に、字幕の有無を確認する工程を入れておく。
2. 収音環境
会場の後ろのマイク、反響、空調のノイズ。この条件では認識率が落ちるのは避けられない。動画側を選べるなら、配信元の公式チャンネルのものを優先する。選べないなら、要点だけ拾えれば十分、と期待値を下げておく。
3. 話者分離
複数人の議論では「誰が言ったか」が要約の価値を決める。話者分離に対応していない出力だと、全員の発言が混ざった一枚のテキストになり、後から使えない。話者認識の有無は、機能一覧の地味な項目だが、実用上の差は大きい。
4. 言語設定の自動判定
日本語と英語が混ざる動画では、自動判定が途中で切り替わることがある。言語を明示できるなら明示したほうがよい。多言語対応を謳う実装でも、混在素材では判定が揺れる。
5. 要約と全文テキストを混同しない
「文字起こし」までで止めると、読む量は減らない。目的が「内容を把握すること」なら要約まで、「正確に引用すること」なら全文テキストまで、と出口を先に決めておく。この 2 つを同じ工程で満たそうとすると、どちらも中途半端になる。
自前で組まずに済ませる場合
ここまでを全部自前で組むのは、用途に対して重い。音声抽出、分割、認識、話者分離、要約、と工程が 5 段ある。
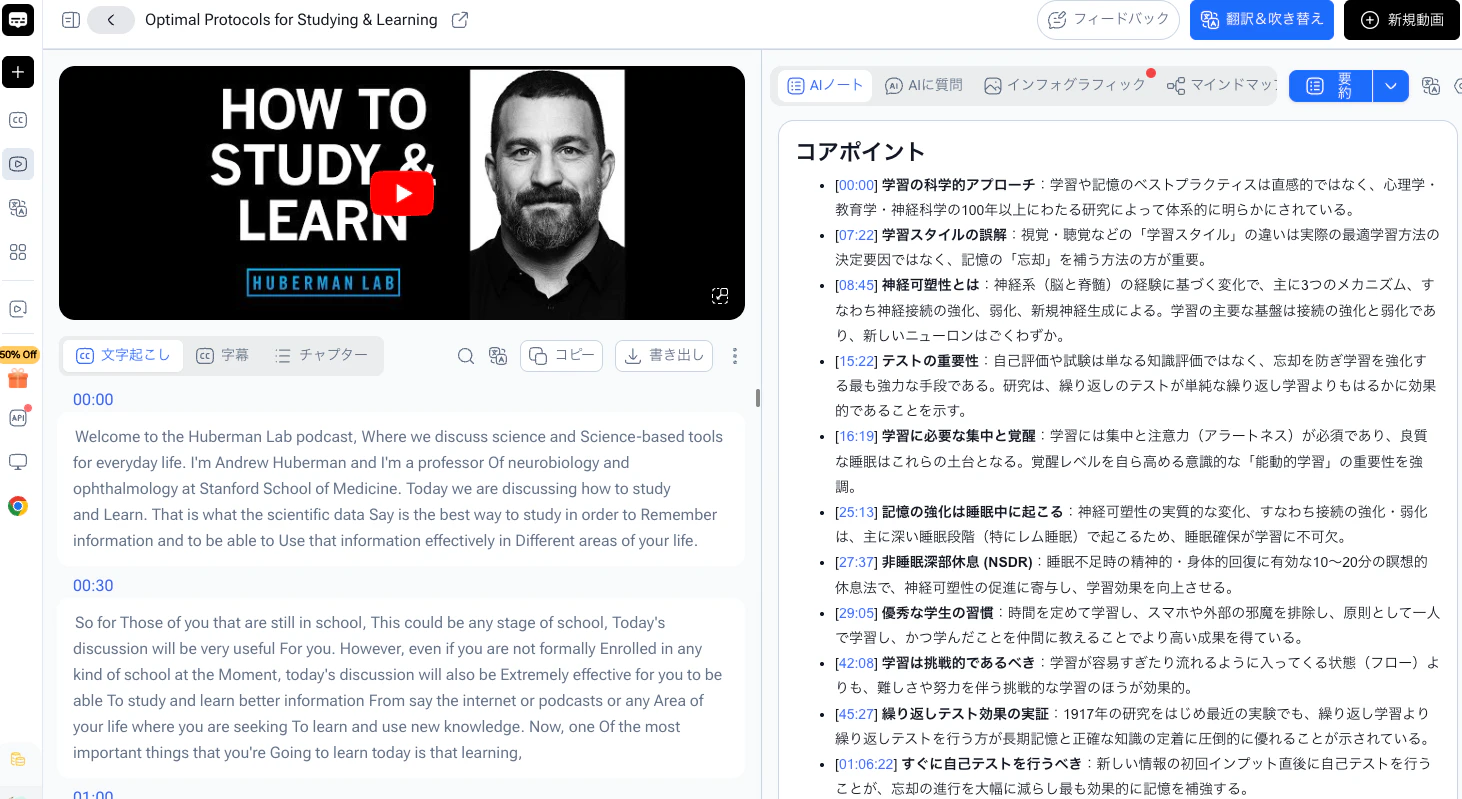
素材が公開リンクで入手できるなら、この工程をまとめて引き受けてくれるサービスに投げるほうが早い。YouTube 動画要約ツール(Video Transcriber AI)は字幕ではなく音声を処理する経路を採っているため、字幕のない録画でもそのまま通る。リンクを貼るだけで、文字起こしから要約まで一続きで出力される。
対応範囲も YouTube に限らず、TikTok、Instagram、Facebook、X、Bilibili、Google Drive、Dropbox、MP3 / MP4 のリンクを受け付ける。話者認識と言語指定もあり、200 以上の言語に対応する。公開リンクである必要がある点だけは制約として残る。
まとめ
- 動画からテキストを得る経路は「字幕を読む」と「音声を認識する」の 2 系統で、後者は素材を選ばない
- 音声を渡すなら 16 kHz モノラルに落とし、長尺は分割しておくと復旧が楽
- 詰まるのは字幕の有無、収音環境、話者分離、言語判定、そして要約と全文の取り違え
- 引用が目的なら元動画に戻って確認する工程は残す
自前で組むか外部に投げるかの判断は、「字幕のない素材を継続的に扱うか」で決まる。扱うなら、音声から処理する経路を最初から選んでおいたほうが、後で組み直す羽目にならない。