

はじめに
この記事を読んでわかること
- Bedrock Knowledge Basesで利用できる各データストア(OpenSearch、Aurora、Kendra、S3 Vectors、Redshift/Glue、Neptune)の特徴や検索特性
※ Knowledge BasesではPineconeなどのサードパーティ製ベクトルストアも選択可能ですが、本記事ではAWSネイティブサービスのみを取り上げます
想定読者
- RAGやBedrock Knowledge Basesの仕組みを知っている
- Knowledge Basesで利用できるデータストアやその特性を知りたい
※出典元を明記している画像を除いて、本記事で使用している画像は生成AIによって生成した画像です。
Amazon Bedrock Knowledge Bases の概要
Knowledge BasesはBedrockの機能の一つで、マネージドなRAGを構築/運用することができます。登場時にはベクトルストアとして AuroraやOpenSearchが選択できましたが、その後の機能拡張により選択肢が増えています。本記事では、それぞれのデータストアの特性を整理したいと思います。

出典: Amazon Bedrock ナレッジベースの仕組み
Knowledge Basesで構築できるRAG
Knowledge Basesでは複数のデータストアが選択でき、ユースケースに応じて性質の異なるRAGを構築できます。独自に構築したデータベースも一部サポートされていますが、今回はKnowledge Basesがサポートしている以下のAWSサービスについて整理します。
- OpenSearch Service
- Aurora PostgreSQL
- Kendra GenAI Index
- S3 Vector
- Redshift/Glue Catalog(非ベクトルストア)
- Neptune
OpenSearch Service:高機能ベクトルストア
OpenSearch ServiceはKnowledge Bases登場時から選択可能であったベクトルDBの一つです。ServerlessとManaged Clusterの2種類がデプロイできます。
OpenSearchは全文検索やスコアリングを得意とするOSSベースの検索エンジンとして提供されており、そこにk-NN/ANNベースのベクトル検索機能が追加されました。RAGにおいて重要なランキング・Top-K 検索・スコアリングを前提とした検索が可能なため、多くのケースで高い検索精度が期待できます。
k-NN: クエリに最も近いk個のベクトルを集合の中から探索する手法

出典: OpenSearch における 10 億規模のユースケースに適した k-NN アルゴリズムの選定
その他、OpenSearch Serviceで構築するRAGには以下のような特徴があります
- Knowledge Basesで唯一バイナリベクトルをサポート
→ データ量が圧縮され使用するメモリ・ディスクを削減 - 日本語形態素解析器
kuromojiプラグイン利用可能- Managed Clusterの場合、
Sudachiプラグインやカスタムパッケージ機能(辞書、シノニム)も利用可能
- Managed Clusterの場合、
- ベクトル検索+全文検索のハイブリッド検索も可能
- 分散インデックス設計により格納するデータ数が増えても性能が落ちにくい
Aurora PostgreSQL: 拡張型ベクトルストア
Aurora PostgreSQLはマネージドなリレーショナルデータベースですが、pgvector拡張を利用することでベクトル検索を可能にしています。現在、Aurora PostgreSQLもKnowledge Basesのベクトルストアとして、serverlessとclusterがデプロイ可能です。
リレーショナルデータベースのため、ユークリッド距離(2つのベクトル間の最短距離)による順位付けとSQL条件によるメタデータフィルタリングを組み合わせて、関連するデータを検索する点が特徴になります。
ベクトル検索+全文検索のハイブリッド検索も可能ですが、OpenSearchと比較するとベクトル検索に関する機能がシンプルなため、リレーショナルDBをRAGとしても使用したいユースケースに向きます。
S3 Vectors:フルマネージド型ベクトルストア
S3 Vectorsではベクトルデータをベクトルインデックスで管理し、データに対してベクトル距離(ユークリッド or コサイン)にもとづく類似検索を実行できます。

出典: Amazon S3 Vectors の紹介:ネイティブベクトルを大規模にサポートする最初のクラウドストレージ (プレビュー)
S3ベースのサービスのためインフラの管理は不要で、コストを最適化するために自動でベクトルデータが調整されます。他のベクトルストアと比較して料金単価も低いため、コストや運用負荷を抑えたい場合の利用に向いています。
Kendra GenAI Index:マネージド検索エンジン搭載
Kendra GenAI Indexは単なるベクトルストアではなく、検索エンジンとして設計されたRAG向けインデックスです。意味ベースのセマンティック検索、ハイブリッド検索が可能です。
高度なセマンティック検索モデルがマネージドに提供されており、チューニング不要で一定の精度が期待できます。また40以上のデータソースコネクターがサポートされており、複数のデータソースに接続しやすい特徴があります。(Knowledge BasesがサポートするデータソースはS3など5種類+カスタムコネクタ)
Amazon Redshift/AWS Glue: 構造化データRAG
Knowledge Basesでは構造化データを対象としたRAGもサポートしています。データのEmbeddingは行わず、自然言語の問い合わせをSQLクエリに変換(NL2SQL) して、構造化データをクエリ対象としている点が特徴です。
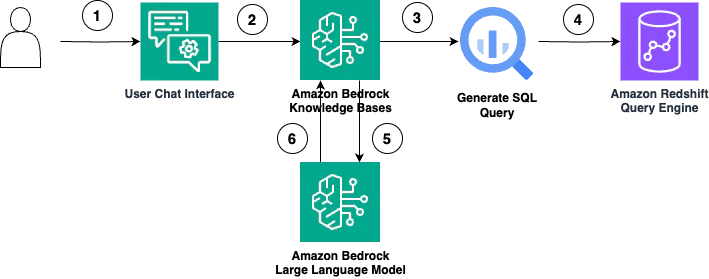
出典: Build conversational interfaces for structured data using Amazon Bedrock Knowledge Bases
現在、クエリの生成・実行を担うクエリエンジンとしてRedshift(ServerlessまたはProvisioned)がサポートされており、以下のデータを検索可能です。
- Amazon Redshift (Redshiftにネイティブに保存されているデータ)
- AWS Glue Data Catalog
データレイク/DWHと連携したRAGを構築したい場合や、RAG検索の回答として数値・集計結果を含む回答を生成したい場合などがユースケースとして考えられます。
Neptune Analytics: グラフRAG
Neptune Analyticsはグラフデータ分析エンジンで、グラフストアおよびベクトルストアとしてKnowledge Basesに組み込むことで、グラフRAGを構築することができます。グラフRAGでは、まず類似度検索によって問い合わせに関連するドキュメントを特定し、そのドキュメントとグラフデータの関係性から周辺情報を収集します。
関係性に基づいた情報検索を行うことで、ベクトル検索では見落とすような情報にもリーチできます。そのため、複雑な関係や論理構造を持つドキュメント検索やQAに対しても高い精度で回答できる傾向があります。

依存関係・因果関係を重視するデータを扱う場合や関係性を可視化したい場合の利用に向いています。
まとめ
Knowledge Basesでは、ベクトル検索・全文検索・構造化データ・グラフ検索など、さまざまな検索アプローチを選択できます。本記事が、ユースケースに合ったデータストア選択の参考になれば幸いです。
| データストア | 主な特長 | 類似度検索の指標 | ハイブリッド検索 | メタデータ付与 |
|---|---|---|---|---|
| OpenSearch Service | RAG最適化機能が豊富(バイナリベクトル、形態素解析プラグイン等) | Cosine / Euclidean (L2) / Binary (Hamming) |
◯ BM25(キーワード) + セマンティック |
◯ |
| Aurora PostgreSQL | RDBを拡張しているため、業務DBとRAGを一体化しやすい | Euclidean | ◯ フルテキスト+セマンティック *1 |
◯ custom_metadata 列としてメタデータを追加 |
| Kendra GenAI Index | セマンティック検索特化。検索品質をマネージドで提供 | 非公開 (Kendra内部実装) |
◯ キーワード + セマンティック |
◯ |
| S3 Vectors | 軽量・低コスト。RAG専用ベクトルストア | Cosine / Euclidean | × 非対応 |
◯ |
|
Redshift / Glue Catalog (構造化データ) |
自然言語で構造化データを直接クエリ | - ベクトル検索なし |
× 非対応 |
◯ 構造化データストアからメタデータにアクセスしSQLクエリを生成 |
| Neptune Analytics | グラフ + ベクトルにより関係性データも踏まえた検索が可能 | 内部実装 (Vector検索+Graph検索 ) |
△ Cognee, Zep,Mem0 との統合により、グラフ+ベクトル+キーワード検索が可能 |
◯ |
*1 Aurora PostgreSQLのハイブリッド検索については、@moritalous さんの記事で動作検証されているので是非こちらもご参照ください
📝 BedrockナレッジベースでAuroraを使ったハイブリッド検索サポート!日本語でもいけるの??