
生成AIのセキュリティにおいて、プロンプトインジェクションや有害なコンテンツを防ぐ「ガードレール(Guardrail)」の重要性が急速に高まっています。
本記事では、TypeSafe社の Jev を、AIエージェントにプロンプトが届く前にスクリーニングするガードレールとして使用し、公開されているレッドチーミング用ベンチマークを用いてその性能(速度、コスト、精度)を実証検証した結果をまとめます。
本記事のサマリー
- Jevは既存のLLM(GPT-5-mini, Claude Haiku 4.5)と比較して約6倍高速で、最大27分の1のコストを実現。
- ブロック精度は85.5% を記録し、比較対象のLLMやタスク特化型オープンソースモデルの多くを上回る性能を発揮。
- 本番環境での数百万回規模のセキュリティチェックにおいて、サブ200ミリ秒のレイテンシは「インライン検査」を実現するための決定的な優位性となる。
1. 検証の概要
今回、Jevの性能を測定するために、以下の条件でテストを実施しました。
- 評価データ: 公開されているジャイルブレイク(Jailbreak)、プロンプトインジェクション、有害コンテンツのベンチマークから抽出した 1,580件のレッドチーミング用プロンプト
-
比較対象:
- OpenAI
GPT-5-mini - Anthropic
Claude Haiku 4.5 - ガードレール専用に構築された3つのオープンソースモデル
- OpenAI
2. 速度とコストの比較
AIセキュリティにおいて、速度とコストはスケーラビリティを決定づける最重要要素です。1,580件のプロンプトを分類した結果は以下の通りでした。
⚡ 速度(レイテンシ)
- Jev: 中央値 0.17秒 (95パーセンタイル: 0.26秒)
- GPT-5-mini: 1.00秒
- Claude Haiku 4.5: 0.89秒
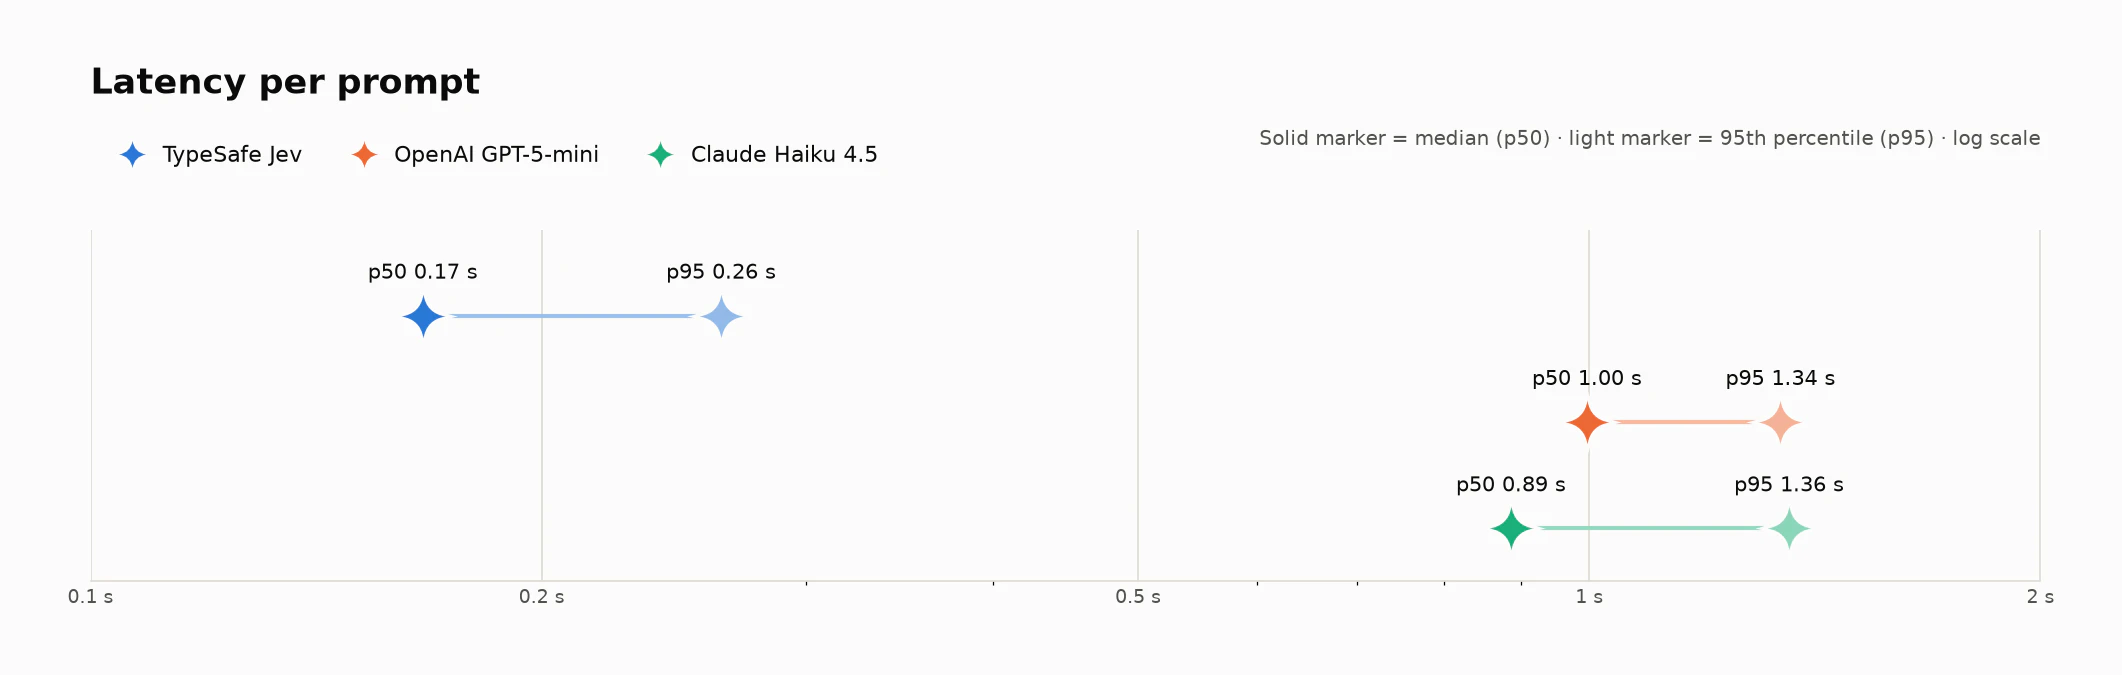
JevはGPT-5-miniの約6倍、Claude Haiku 4.5の5倍以上の速度を記録しました。
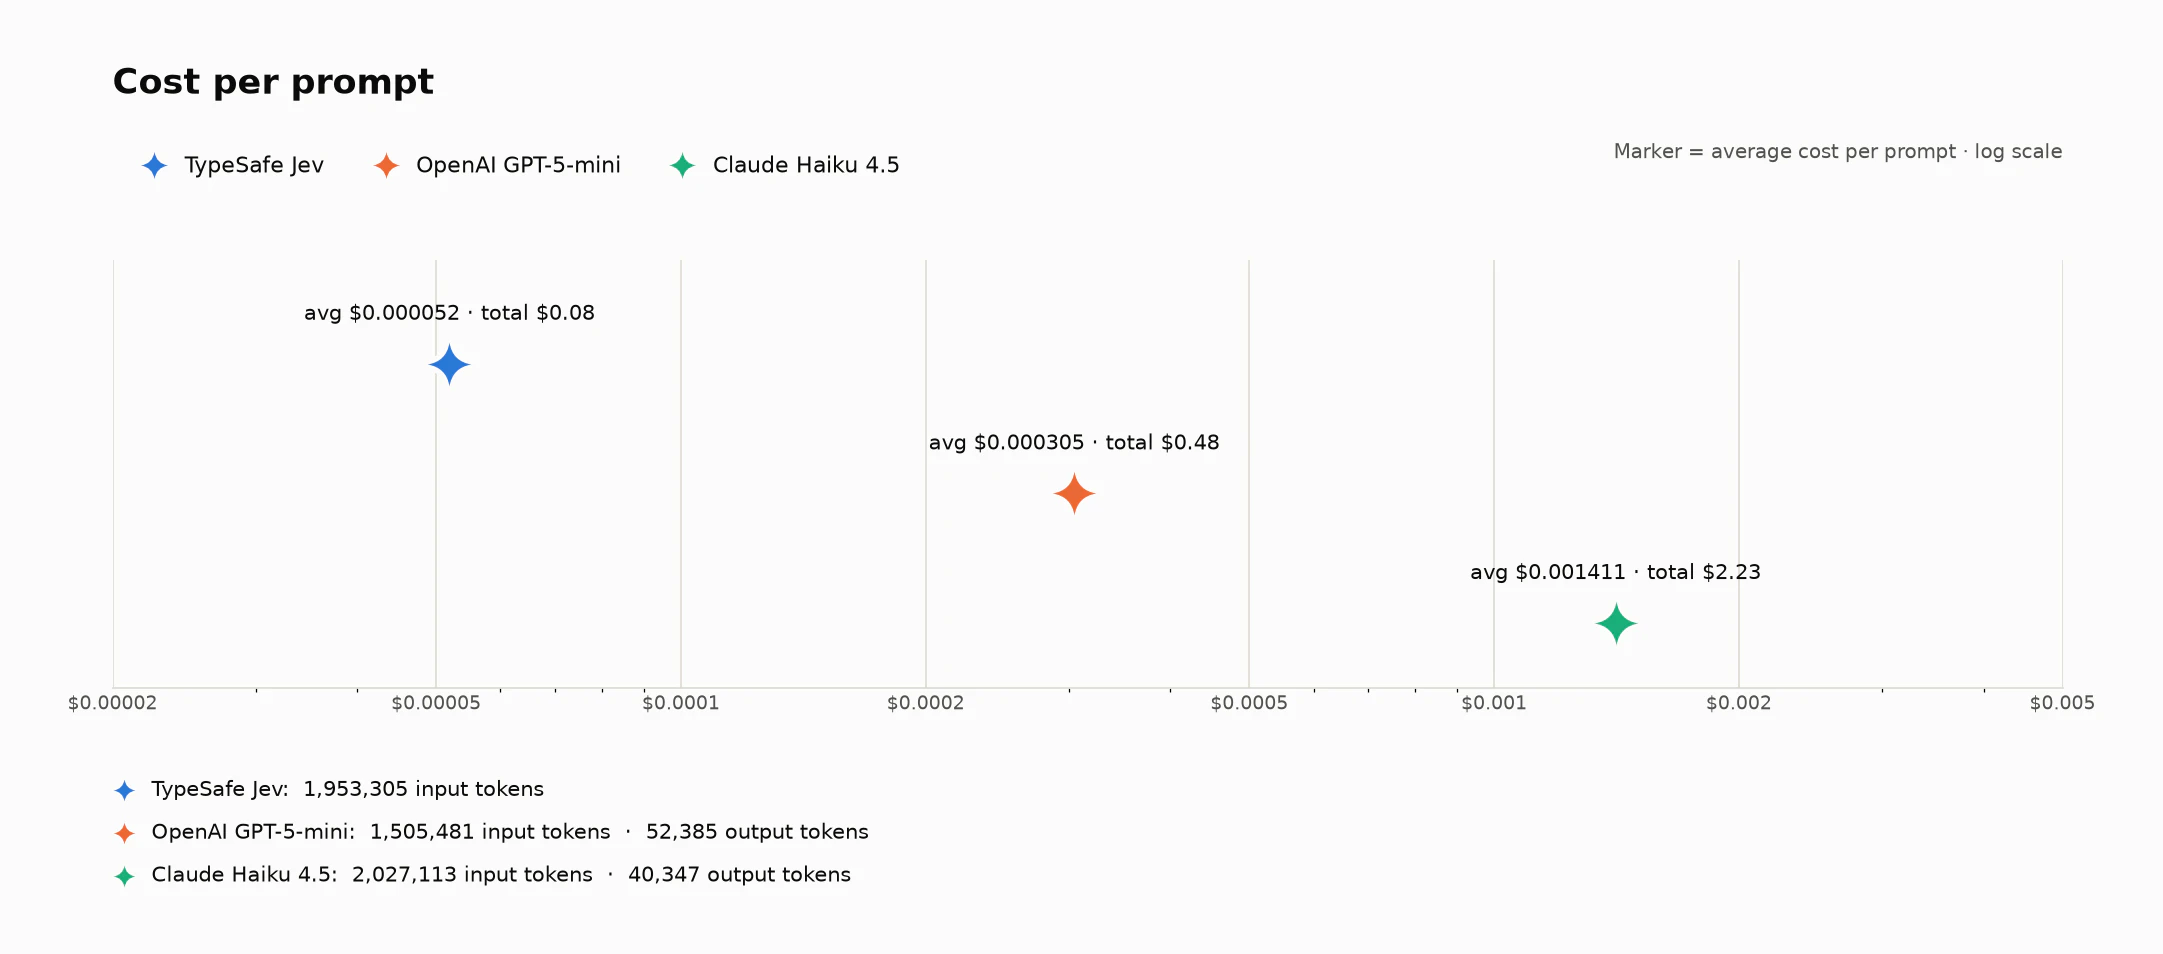
💰 コスト
- Jev: $0.08
- GPT-5-mini: $0.48
- Claude Haiku 4.5: $2.23
リスト価格換算で、JevはGPT-5-miniの約6分の1、Claude Haiku 4.5の約27分の1という圧倒的なコストパフォーマンスを実現しています。
3. 精度(Quality)の評価
速度とコストが優れていても、判定精度が低ければ意味がありません。以下の指標で評価を行いました。
| 評価指標 | Jev | GPT-5-mini | Claude Haiku 4.5 |
|---|---|---|---|
| ブロック精度 (有害性を正しく検知) | 85.5% | 84.1% | 80.1% |
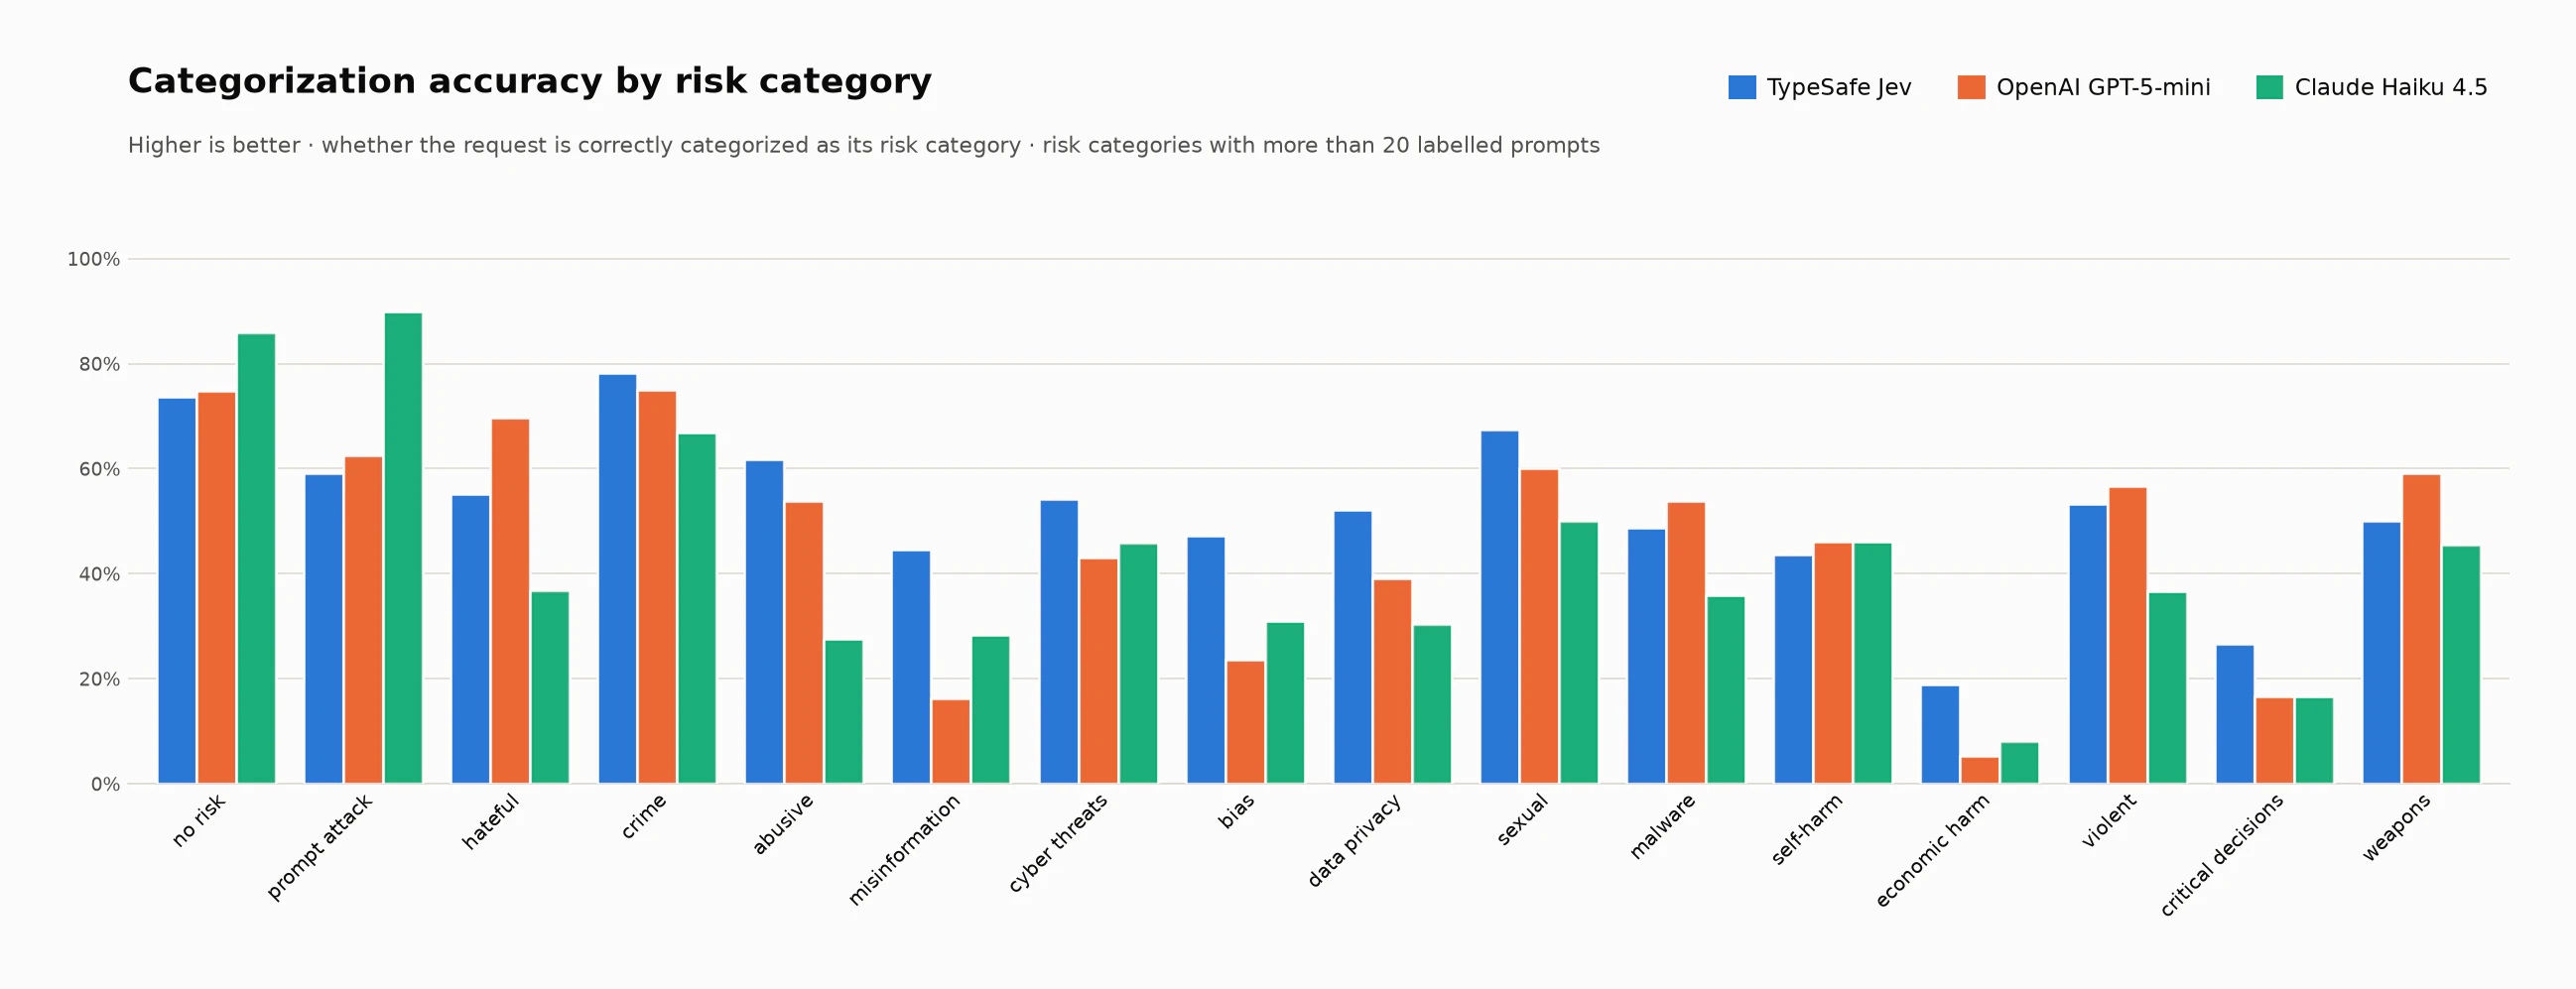
| カテゴリ特定精度 (24のリスクカテゴリから正解) | 58.0% | 56.0% | 55.4% |
| Macro-F1スコア (全カテゴリを均等に重み付け) | 46.5% | 41.7% | 38.1% |
Jevはすべての精度指標において、比較対象の汎用LLMを上回る結果を示しました。
4. タスク特化型オープンソースモデルとの比較
さらに、ガードレール専用に構築された3つのオープンソースモデル(ProtectAI, Qwen3Guard, Prompt Guard 2 など)とも比較を行いました。これらは24のリスクカテゴリには対応していないため、「ブロック精度」のみで比較しています。
結果として、Jevは9つのベンチマークグループのうち8つで、タスク特化型モデルと同等またはそれ以上のスコアを記録しました。
- 明確なリード: 直接プロンプトインジェクション(95%)、サイバー攻撃支援(83%)、有害な指示・安全でないアドバイス(49%)、間接プロンプトインジェクション(77%)
- 僅差のリード: 有害な指示(92%)、複合セキュリティスイート(47%)
- 同等: 自動ジャイルブレイク(96%)、過剰な拒否(Over-refusal)(72%)
- 僅差で後退: ジャイルブレイクプロンプトコレクション(Qwen3Guardが93.3%、Jevが92.9%)
特に、ツールレスポンスに隠された間接プロンプトインジェクションの検知において、Jevは他モデルを大きく引き離す結果となりました。
5. エンタープライズにおける意義
多くの組織において、AIセキュリティのコストを押し上げているのは「単一のモデル呼び出し」ではなく、「すべてのリクエスト」「エージェントのすべてのステップ」「評価実行のすべてのテストケース」に対して呼び出しが発生する累積コストです。
本番エージェントの前に配置されるガードレールは、月間数百万回実行される可能性があります。また、開発中はプロンプトやモデルの変更ごとに数千件のケースを再スコアリングする評価スイートが常に稼働します。
このような環境下では、「1秒かかるLLMの判定」と「200ミリ秒未満で完了するJevの判定」の差は単なる誤差ではありません。この差は以下の意思決定を分けます。
- セキュリティチェックをインライン(同期) で実行できるか、それともサンプリング(非同期/一部)に頼らざるを得ないか。
- 評価をすべての変更に対して実行できるか、それとも週に1回のバッチ処理に留めるか。
実際に、OptiXを通じてJevで評価ワークロードを実行している顧客は、パフォーマンスを同等以上に維持したまま、評価コストの削減とレイテンシの改善を実証しています。
6. まとめ
今回のレッドチーミング検証により、Jev は以下の点で本番環境のAIエージェント用ガードレールとして非常に有望であることが示されました。
- ✅ 圧倒的な速度: サブ200ミリ秒のレイテンシでインライン検査を実現
- ✅ 低コスト: 既存LLMの最大1/27のコストで大量のリクエストを処理可能
- ✅ 高い精度: 汎用LLMやタスク特化型オープンソースモデルを凌駕、または同等のブロック精度を実現
AIエージェントの安全性を確保しつつ、ユーザー体験(UX)と開発速度を犠牲にしたくないエンジニアリングチームにとって、Jevのような最適化されたガードレールモデルの導入は有力な選択肢となるでしょう。