
1. はじめに(TL;DR)
Kaggle の RSNA Knee Abnormality Detection にソロで参加し、6,299 チーム中 67 位で銀メダルを取りました。最終順位を決める Private LB の macro AUC は 0.949 で、金メダルの線の 0.954 には届いていません。

この記事の全体像
膝 MRI から 12 の所見の有無を予測するコンペですが、学習データの大半には正解がなく、読影レポートの文章しか付いていません。そのレポートも、テストの正解とは基準の違う文章です。しかもテストには画像しか付かないので、レポートを使えるのは学習用のラベルを作る段だけでした。参加してすぐ、ラベルの質が画像モデルの成績を大きく左右すると測れたので(2 節)、解法の中心をラベル作りに置いています。
具体的には、レポートを LLM に読ませて、所見ごとの陽性の確率を出させました。この確率を中心に教師ラベルを作り、画像だけを見る生徒モデルを学習します。0/1 に丸めない確率のラベル(ソフトラベル)で教える、知識蒸留の形です。
- ラベル:レポートの書き写しではなく、「専門医が画像を見たら陽性と付けるか」を LLM に確率で答えさせました。これを中心に教師を作り直すと、同じ生徒モデルで Private LB は 0.931 → 0.935、Public LB は 0.948 → 0.950 でした。
- 推論:学習し直さずに、所見ごとに関係する領域(内側・外側の半分など)とスライスの集め方を変える後処理を足しました。同時に入れた骨挫傷の補正と合わせると、重みの違う 4 通りすべてで上がりました。Public LB は +0.005〜+0.007、Private LB でも +0.004〜+0.005 です。
- 検証:モデルを 1 本足すか替えるだけの差は、Public LB の表示の刻み 0.001 より小さいと見ていました。そこで結果を見る前に差の予測を書いて提出し、終盤の 44 件では、この予測のほうが表示の上下より Private LB に合っていました。
- 反省:Public LB では一時 4 位まで上がりましたが、Private LB では 67 位でした。選んだ 2 つの提出の 0.949 は最後に出した 200 件の中の最高と同じで、順位を下げたのは選び方ではなく解法の中身です。
上位 3 チームの Private LB は 0.959〜0.960 です。3 チームともに、LLM にレポートと MRI の画像の両方を読ませてラベルを作りました。レポートの文章しか読ませなかったこの解法との最大の違いは、そこにあったと考えています。私も LLM に画像を読ませてはみました。ただ、58 件を 20 分足らずで読む小さな試しの結果だけで、この方向を見切っています(11 節)。
以下では解法を工程ごとに述べ、最後にこの違いを中心に上位解法と比べます。工程ごとに、そのとき何を見て、なぜその手を選んだかも、当時の記録から書きます。日付はすべて UTC です。
この記事で扱うこと
- 正解ラベルがほとんど無い医用画像で、読影レポートを LLM に読ませて学習ラベルを作る方法(ソフトラベル・知識蒸留)
- 1 検査に多数のシリーズとスライスがある膝 MRI を、検査単位のラベルだけで学ぶ MIL モデルと、9 時間の推論制限の中での工夫
- 学習し直さずに効いた推論の後処理(所見ごとの pooling と TTA)
- Public LB の小さな差を信じすぎないための検証の仕方と、効かなかった手
- 1〜3 位の公開解法との比較(LLM に画像まで読ませたかどうか)
膝の図はすべて手で描いた模式図です。コンペのデータは規約で転載できないため、実際の MRI 画像は載せていません。
2. コンペの概要:ラベルのほとんどが文章で与えられる
このコンペでは、膝 MRI の検査ごとに 12 所見の有無を予測します。ところが学習データ 4,407 件のうち、専門医が画像を読んで付けたラベルがあるのは 58 件だけです(以下、正解 58 件)。残る 4,349 件には、読影レポートの文章しか付いていません。テストの正解も、58 件と同じ手続きで画像から付けられています(主催者の回答)。そしてテストに付くのは画像だけです(図1)。

図1:学習とテストで使えるもの(模式図)
採点は所見ごとの ROC AUC の平均(macro AUC)です。検査の並び順だけが問われ、陽性の少ない所見もほかと同じ重みを持ちます。レポートを使えるのは学習用のラベルを作る段だけなので、レポートを画像の読影に近いラベルへ変えることが、この課題の中心になりました。
データの形
- 単位は検査(スタディ)で、学習データは 4,407 件
- 1 検査には、同じ撮り方・同じ向きで続けて撮った断面画像の一式(シリーズ)が、中央値で 5 つ入る。1 つのシリーズは多くが 20〜45 枚
- 向きは 3 つで、どの検査にもそろう。膝を横から見る矢状断、正面から見る冠状断、脚を輪切りにする軸位断(図2)
- レポートは英語やスペイン語など 9 言語の自由記述
- テストは約 1,300 件の隠しデータで、検査の ID と画像しか付かない
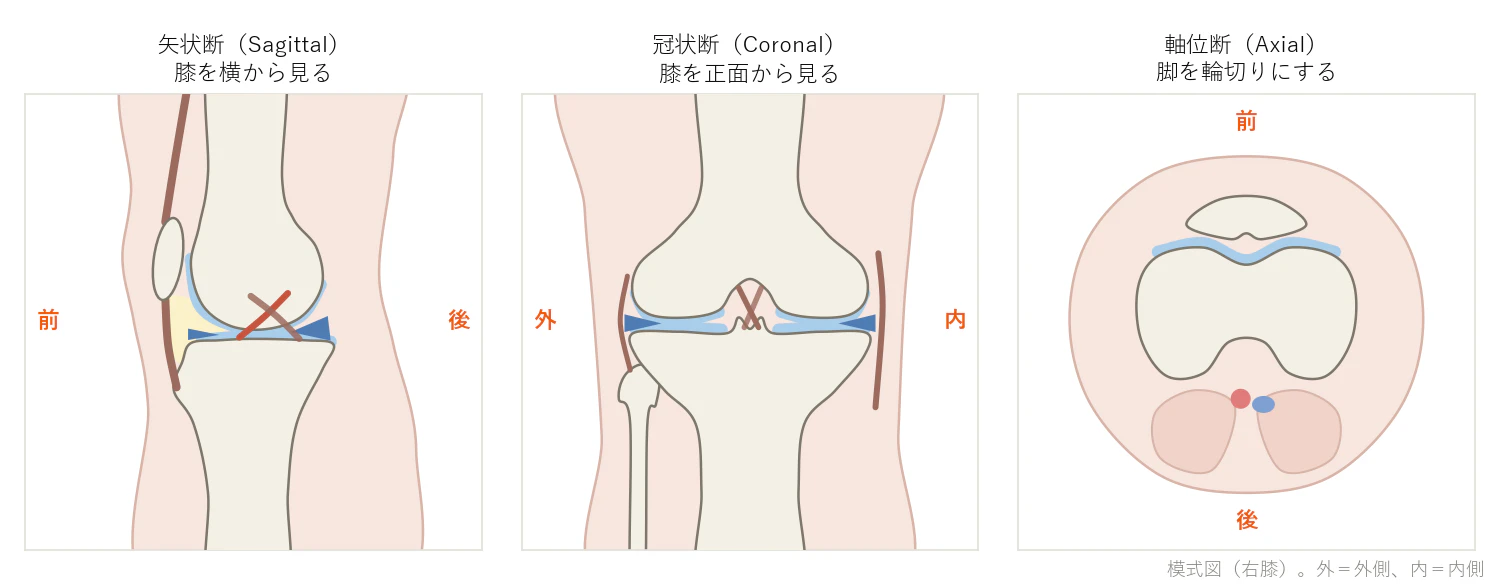
図2:1 つの検査に含まれる 3 つの向き(右膝の模式図)
同じ向きでも、撮り方の違うシリーズが入ります。水が白く写るように脂肪の信号を抑えた撮り方では、関節液貯留や骨挫傷のむくみ、断裂が白く浮かびます。
表1:予測する 12 所見
| 英名 | 日本語名 | 区分 |
|---|---|---|
| ACL | 前十字靭帯断裂 | 外傷 |
| MCL | 内側側副靭帯断裂 | 外傷 |
| Contusion | 骨挫傷 | 外傷 |
| Fracture | 骨折 | 外傷 |
| Medial Meniscus | 内側半月板断裂 | 変性 |
| Lateral Meniscus | 外側半月板断裂 | 変性 |
| Medial OA | 内側の変形性関節症 | 変性 |
| Lateral OA | 外側の変形性関節症 | 変性 |
| PF OA | 膝蓋大腿関節の変形性関節症 | 変性 |
| Effusion | 関節液貯留 | その他 |
| Synovitis | 滑膜炎 | その他 |
| Baker's | ベーカー嚢腫 | その他 |
※ 英名は提出ファイルの列名です。区分は主催者のものではなく、8 節の補正に合わせた自前の分け方です。
正解はレポートより厳しい基準で付く
正解は、画像だけを読んで、レポートより厳しい基準で付けられています。筋骨格が専門の放射線科医 2 人が別々に読み、意見が割れた検査は 3 人目が決めました。主催者が公開した主な基準は次のとおりです(主催者の説明)。
- 判断に迷う境界の所見は、特異度を優先して陰性
- ACL:完全な断裂か、線維の半分を超える断裂を陽性
- MCL と骨折:急性のものだけを陽性。古い損傷は陰性
- 半月板:表面に達する異常な信号が、2 枚以上の画像で見えるものを陽性
- 関節液貯留とベーカー嚢腫:中等量以上を陽性
- OA:軟骨の厚みの半分を超える欠損が、1cm ほど以上の範囲にあるものを陽性
一方、レポートは 1 人の放射線科医が診療のために書いた文章です。複数の読み手が画像の厳しい基準で付けた正解とは食い違って当然だ、と主催者も答えています(主催者の回答)。
では、レポートの言葉は正解とどれくらいずれるのでしょうか。所見ごとのキーワードと否定語の正規表現でレポートを読む規則(以下、ルール)を作り、正解 58 件と照らしました。検査 1 件の所見 1 つを 1 組と数えます(図3)。ルールで陽性と読んだ組のうち、32.2% は正解では陰性でした。逆に陽性と読まなかった組でも、13.8% は陽性です。関節液貯留は中等量以上が陽性なので、「少量」や「微量」と書かれた検査の約 7 割は陰性でした。

図3:ルールで読んだレポートと正解 58 件の食い違い
このままラベルにすると、正解では陽性の組の約 4 分の 1 を、陰性として画像モデルに教えることになります。陽性と読んだ組の 3 分の 1 は、その逆の誤りです。
初日に見たことが計画を決めた
この食い違いに最初に気づいたのは、参加した初日の 8月8日です。正解 58 件のレポートを、1 件ずつラベルと読み比べました。ある検査は「少量の関節液貯留」と書かれて関節液貯留が 0 で、レポートに一言もない滑膜炎が 1 でした。「滑膜炎と大量の関節液貯留」と書かれた別の検査も、滑膜炎は 0 です。書き写しの誤りにしては系統立っていたので、レポートは正解ではなく、画像の読影を近似する雑音の多い手がかりだと考えました。主催者も、58 件は「食い違うときは画像のラベルが正しい」と気づかせるために付けたと答えています。
同じ日に、思い込みを 1 つ捨てています。最初の 20 件では骨挫傷と骨折が同時に陽性の検査がなく、骨折のまわりのむくみは骨折のほうに数えられるのだと考えかけました。58 件すべてで数えると 10 件で両方が陽性で、この見立ては外れでした。
一方で当時の私は、レポートから作るラベルはもう頭打ちで、これ以上磨いても画像モデルには効かないと考えていました。ルールで読んだラベル(以下、ルールのラベル)に LLM の答えを混ぜても、LLM 側の改良では正解 58 件の 0.82 前後から動かなかったからです。ただ、これは安い実験で確かめられます。画像モデルの設定はすべてそろえ、学習ラベルだけを替えました。比べたのは、ルールのラベルだけと、それに手元の LLM の答えを半々に混ぜたラベルです。LLM は Qwen2.5-7B-Instruct で、その答えを以下、7B のラベルと呼びます。
画像モデルの正解 58 件での macro AUC は、ルールのラベルだけで 0.707、混ぜたラベルで 0.757 でした。6 エポックのどの時点でも、混ぜた側が上です。見立ては外れていて、ラベルの質の差は画像モデルの差にそのまま出ていました。これで、解法の中心をラベル作りに置くと決めました。当時の記録には、間接の証拠で結論せず、安い入れ替え実験で確かめるという教訓を残しています。
コードコンペの制約
コードコンペなので、推論はネット接続のない Notebook で、CPU・GPU とも 9 時間以内に終える必要があります。最終提出の 2 つは、締切の 10月22日までに選ぶ決まりです。外部データと事前学習モデルも、公開されているものなら使えます。
推論時間も採点に入れる効率部門もありました。8月下旬の見積もりでは、こちらの作りは DICOM の読み込みだけで約 26 分かかる計算でした。当時の効率部門 3 位の参加者は、推論全体を約 25 分で終えていると書いています。3 位以内に入るには、読み込みから作り直す必要があると分かりました。効率向けの提出や高速化の調べは 10月まで続けましたが、最終の 2 つは AUC だけで選んでいます。
Public LB と Private LB、差を測る物差し
Public LB は隠しテストのうち約 390 件だけで採点されます。Private LB は全提出を残る約 910 件で採点し、最終順位には選んだ 2 つの提出のうち良いほうが使われます。
差を測る物差しは次の 3 つで、どれにも弱みがありました。
- 正解 58 件:テストと同じ付け方の正解。ただし 58 件と少なく、外傷の所見がある膝に偏る(LLM でレポートを読むと 58 件の 64%、残る 4,349 件では 25%)
- CV:fold 0 の 870 件で測る macro AUC。件数は多いが、正解の側もレポートから作るので、ラベルの良し悪しは映りにくい
- Public LB:専門医が画像を読んだ正解の約 390 件。表示される値(以下、表示値)は小数 3 桁の切り捨てで、提出は 1 日 5 回まで
8月22日ごろまでの記録では、0.004 ほどの差を見分けられるのは Public LB だけだと考えていました。ところが締切後に Private LB と照らすと、Public LB で読めていたのは 0.005 以上の差だけでした(10 節)。以下で Public LB の +0.002〜+0.003 が出てきたら、この線より小さい差です。CV と正解 58 件の差は、seed 間の揺れ(2σ)を目安に読みました。seed だけを変えた 2 本の差の標準偏差の 2 倍で、CV では 0.0054、正解 58 件では 0.0129 です。
3. 結果と順位の推移
伸びが止まるたびに、何が詰まっているかを測り直し、直す段を次へ移しました。 Public LB が大きく伸びたのは、そうして新しい種類の手を入れたときです(図4、表2)。解法は教師ラベル・生徒モデル・推論の 3 段に分かれ、ほかの段を据え置いて 1 段ずつ替えたので、どの手が効いたかを見分けられました。

図4:Public LB の推移
※ 点は提出ごとの Public LB、線はその時点の最高、菱形は Private LB の最終スコアです。
表2:Public LB の節目
| 日付 | スコア | 順位/チーム数 | 主な手 |
|---|---|---|---|
| 8/11 | 0.854 | – | 最初の提出 |
| 8/16 | 0.910 | – | 画像の中心から 100mm 四方を切り出す |
| 8/29 | 0.943 | 34/2,664 | モデルの本数と TTA の回数を 9 時間に配分 |
| 9/14 | 0.944 | 84/3,755 | 停滞:本数・TTA・教師を替えても伸びず |
| 9/29 | 0.953 | 43/4,552 | 教師の作り直し |
| 10/8 | 0.957 | 42/5,486 | 4 本のアンサンブル |
| 10/9 | 0.962 | 11/5,598 | 所見ごとに pooling を変える後処理と骨挫傷の補正 |
| 10/11 | 0.964 | 4/5,773 | TTA と後処理の調整 |
| 10/19 | 0.964 | 19/6,223 | 停滞:生徒を足したアンサンブル |
| 最終(Public) | 0.965 | 30/6,299 | 17 本のアンサンブル |
| 最終(Private) | 0.949 | 67/6,299 | Public とは別の約 910 件で採点 |
※ 順位はその日に保存した LB の値で、9/29 の 0.953 は 9/24 に出した提出です。

図5:Public LB の順位の推移
※ 縦軸は対数で、上ほど上位です。線上の点は LB を保存した時刻です。参加チームは 8/16 の 1,630 から最終の 6,299 まで増えました。
順位は、スコアが止まるたびに下がりました(図5)。参加チームが増え続け、その中から伸びてきたチームに抜かれるからです。8月22日から 26日には、0.935 のまま 44 位から 293 位まで落ちました。公開ノートを写したとみられる 0.936 のチームが、1 日足らずで 81 も増えた日もあります。このころは、止まっていれば銀メダル圏までの余裕が 1 日に 5 位ずつ減ると見積もっていました。
8月:ラベル、切り出し、推論の予算
8月前半は、参加直後の測定を受けてラベルの作り方を優先しました。画像側では空振りが続いたあと、100mm 四方の切り出しで初めて Public LB が動いています。8月下旬は、9 時間の推論枠に入れるモデルの本数と TTA(入力を変えて予測を重ねる推論)の回数を詰めました。それまでの提出が、推論時間の見積もりで黙って本数や回数を削られていたと分かったからです。
9月前半の停滞:効く手がなかった
8月29日に 0.943 を出したあと、9月18日に 0.945 が出るまで約 3 週間かかりました。その間に採点された 63 件は、最高でも 0.944 です。私は初め、Public LB では小さな差を見分けられないのだと考えていました。ところが同じ構成を 2 度出すと、Public LB はほぼ同じ値でした。採点はぶれていないと見て、9月11日には、動かないのは効く手を入れていないからだと考え直しています。TTA の回数を増やしても、8月22日から教師ラベルを 17 通り作り替えても、記録は超えていません。
抜け出すきっかけは、9月15日に CV を検査ごとの寄与に分け、1 つの施設の偏りを見つけたことでした(7 節)。その施設の教師ラベルだけを直すと、教師の修正としては 8月17日以来はじめて Public LB が動き、CV は逆に下がりました。教師の良し悪しは CV には映らないと考え、9月の残りは、教師だけを替えた単独の生徒を Public LB で比べています。
9月後半:直す相手を教師ラベルへ
ここからは施設と言語の補正、学習の延長、バックボーンの変更、LLM で読み直したラベルを 1 つずつ積みました。9月24日には単独の生徒で 0.953 に届き、それまでのアンサンブルの最高 0.950 を超えました。
10月:推論だけで 4 位へ、そして最後の停滞
10月8日に 4 本のアンサンブルで 0.957 まで来たところで、改良案を洗い出し、効き目を 1 つずつ見積もりました。いちばん効くと出たのは、学習し直さずに所見ごとに集め方を変える後処理と、骨挫傷の補正です。出すと Public LB は 0.962 に上がり、順位は 51 位から 11 位になりました。続けて TTA と後処理を詰め、10月11日には 0.964 で 4 位に届きました。
その後、締切までに出した 51 件のうち、記録を超えたのは 0.965 の 1 件だけです。当時の私は、教師ラベルは十分に磨けていて、単独モデルのスコアも上位に負けていないと見ていました。そこで、残る差は推論とモデルの側にあると考えました。推論の工夫と、作り方の違う教師で学んだ生徒の追加を重ねましたが、順位は最終の Public LB で 30 位まで下がっています。振り返ると、上位との差は教師ラベルの作り方にありました(11 節)。
4. 解法の全体像
解法は知識蒸留の形で、教師ラベルを作る・生徒モデルを学習する・推論する、の 3 段に分かれます(図6)。読影レポートから作ったソフトラベルが教師ラベルで、これを画像だけを見る生徒モデルに学ばせます。生徒の OOF(学習に使っていない fold での予測)は、7 割の重みで教師ラベルに混ぜて戻しています。テストで MRI を見るのは、生徒だけです。
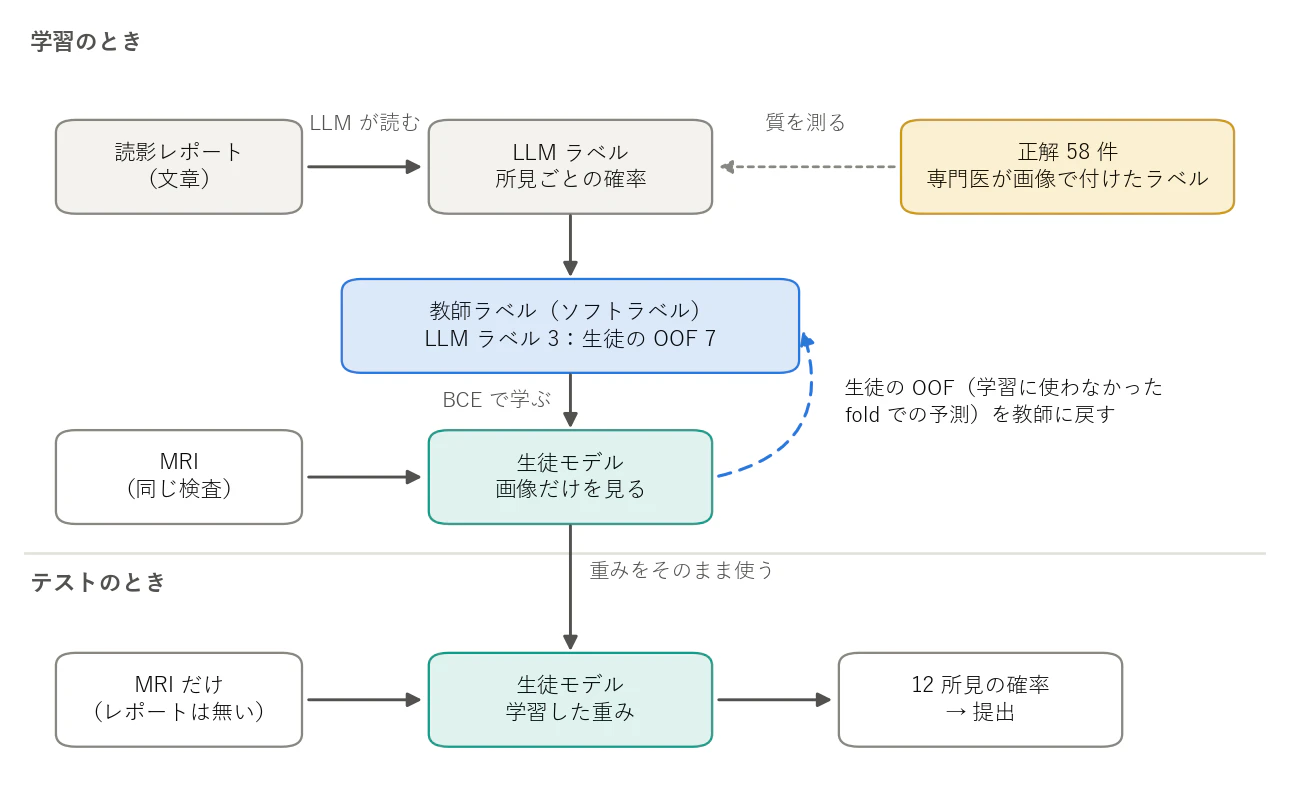
図6:知識蒸留の流れ(模式図)
なぜこの形にしたか
初日にデータを見て、この課題は「多言語の文章からラベルを作り、画像だけのモデルを学習する」問題だと考えました。正解 58 件だけで 12 所見を学ぶには、数が足りません。2 つのラベルを混ぜる重みを所見ごとに 1 つ選ぶだけでも、1 件ずつ抜いて確かめると、半々の決め打ちに負けたほどです。58 件はラベルの質を測れる唯一の物差しでもあるので、ラベルの作り方を比べるのに使いました。
ラベルを替えるだけで画像モデルの成績が変わることは、参加直後の入れ替え実験で確かめていました(2 節)。伸ばす余地はラベルにあると見て、教師ラベルに手をかける設計にしました。
ラベルは 0 と 1 に丸めず、確率のまま使います。7B のモデルに 4 段階で答えさせると同点が多く、順位で決まる AUC の上限を下げたからです。確率のままなら、並びが良くなった分がそのまま生徒の学ぶ信号に届きます。
生徒の OOF を教師に戻すループは、8月半ばの測定がきっかけです。それまでは、教師より弱い生徒から良い教師は作れないと考えていました。ところが、単独では教師ラベルより弱い画像モデルでも、その予測をテキストのラベルに混ぜると AUC が上がりました。正解 58 件で測ると、試した 21 本のすべてで上がっています。効いていたのは強さではなく、誤る場所の違いでした。画像モデルは、レポートが触れていない所見を画像から見ています。逆に、テキストを外して生徒の OOF だけで作った教師は、生徒の設定が同じでも Public LB が 0.005 下がりました。そこで、教師にはテキストも残しました。締切後に取った Private LB でも 0.003 下がっています。
3 段の中身
図7:解法の全体像(模式図)
図7 の 17 本は、最終提出の 2 つのうち Public LB が高いほうのアンサンブルです。EfficientNetV2-S を中心に、ConvNeXt-T 2 本と TResNet-M 1 本を加えました。推論の段の「所見ごとの pooling」は推論時の後処理で、学習済みの重みは変えません。所見ごとに、pooling する領域(内側・外側の半分など)とスライスの集め方を変えます。教師を替えるたびに、点線のループで生徒を学習し直す必要があります。pooling は学習済みの重みにそのまま掛けられるので、効き目を早く測れました。
1 か所だけ変えた提出の対
1 か所だけ違う 2 つの提出(以下、提出の対)で Public LB の差を比べ、工程ごとに並べたのが図8 です。
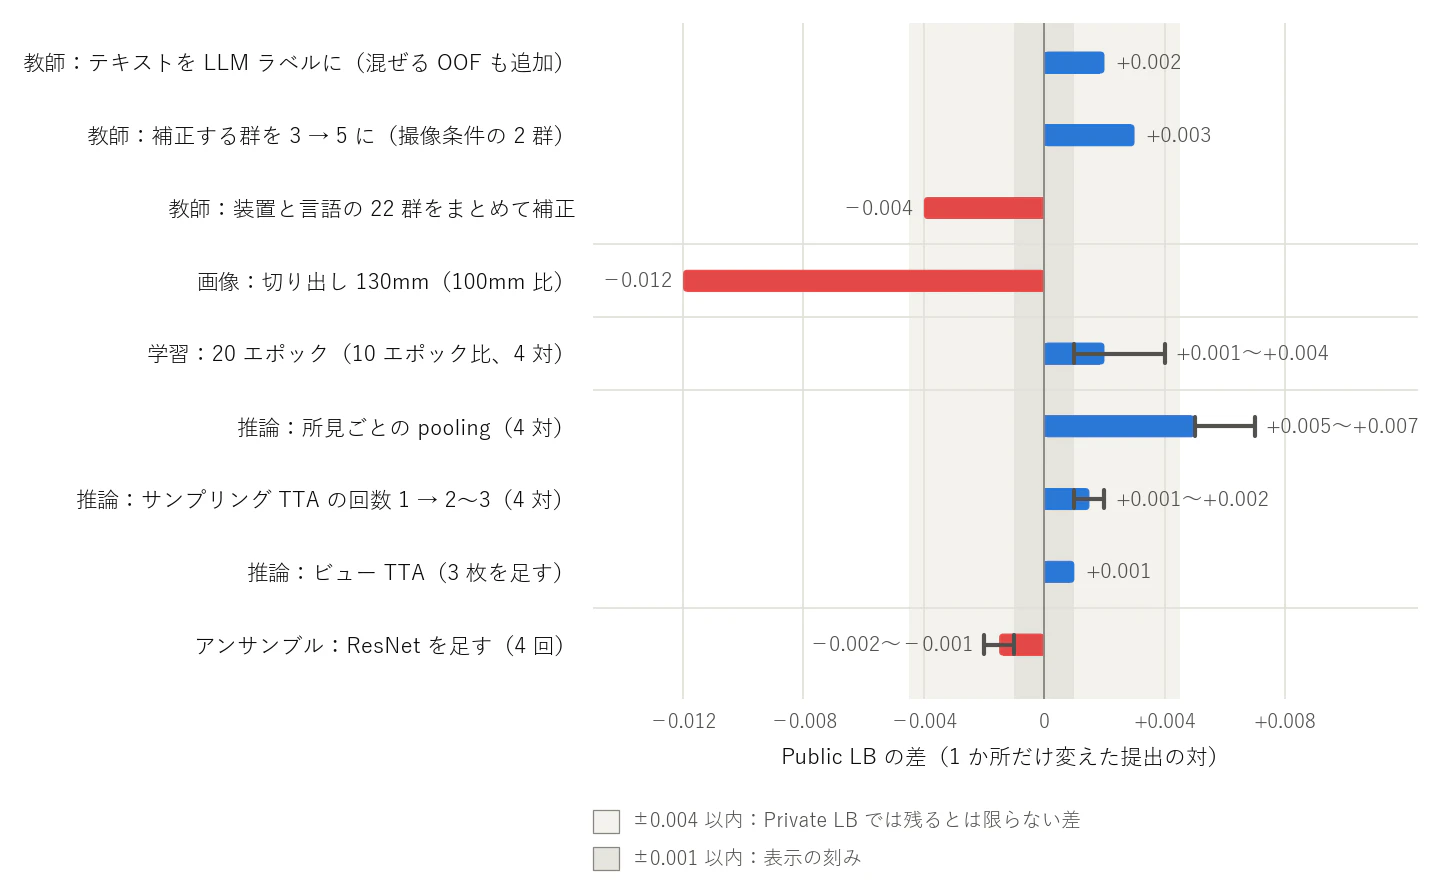
図8:1 か所だけ変えた提出の対の Public LB の差
※ 対が複数ある項目は、棒が中央値でひげが範囲です。所見ごとの pooling の棒は、骨挫傷の補正を含みます。
差が 0.005 以上あったのは、切り出しの幅と所見ごとの pooling だけで、この 2 つは Private LB でもほぼ同じだけ動きました。薄い帯の中の ±0.004 以内の差は、Public LB だけでは良し悪しを決められません(10 節)。教師の作り直しを表す上の 2 つの棒も、この帯の中にあります。Private LB での答え合わせは、表6 に載せました。
LLM と外部データの使い方
LLM を使ったのは、学習ラベル作りだけです。レポートを外部の LLM の API に送ってラベルを抜き出すことは、主催者がディスカッションで認めていました。外部の膝 MRI データは使っていません。登録制の OAI(Osteoarthritis Initiative)は、全参加者が等しく入手できるとは言い切れません。ほかの候補にはレポートが無く、12 所見のラベルを作れませんでした。
5. 読影レポートを LLM で読み、ソフトラベルにする
LLM ラベルは、レポートの書き写しではなく、専門医が画像を見て下す判定を Claude Fable に予測させたものです。所見ごとに陽性と付く確率を答えさせ、二値に丸めずにソフトラベルのまま教師ラベルの材料にしました。正解 58 件での macro AUC は 0.9017 で、それまでの 4 つのラベルを順位平均した旧ラベルの 0.8816 を上回りました(表3)。
表3:レポートから作ったラベルと、正解 58 件での macro AUC
| ラベル | 作り方 | macro AUC |
|---|---|---|
| ルールのラベル | 所見ごとのキーワードと否定語の正規表現 | 0.754 |
| 7B のラベル | Qwen2.5-7B-Instruct(4 ビット)が 4 段階で答える | 0.758 |
| ルール+7B | 2 つの順位を所見ごとに半々で平均 | 0.824 |
| Claude 2 種 | Opus と Fable が 7B のモデルと同じ 4 段階で答える | 0.864・0.861 |
| 旧ラベル | ルールのラベル・7B のラベル・Claude 2 種を順位平均 | 0.8816 |
| LLM ラベル | Fable が画像での判定を確率で予測 | 0.9017 |
※ 上の 4 行は測った当時の 3 桁。7B のラベルの基準と LLM ラベルの指示書は正解 58 件を見て調整したので、58 件での値は甘めの可能性があります。
ルールのラベルと 7B のラベルは、得意な所見が違います。判断の要る半月板は 7B のラベル、キーワードで決まる骨挫傷はルールのラベルが勝ち、順位を半々で平均するだけで両方を上回りました。7B のモデルを手元の GPU で動かしたのは、正規表現が 9 言語の否定の多い文章で取りこぼすからです。例を見せずに答えさせたのは、正解 58 件が唯一の物差しで、例に使えば測る相手がなくなるからでした。
書き写しから、画像での判定の予測へ
旧ラベルまでの抽出器は、どれもレポートに何が書いてあるかを答えていました。7B のモデルへの指示も「Judge only what this report states」です。8月中旬に主催者の基準を読み込み、採点されるのは基準を満たす所見が画像にあるかどうかだと確かめました。私の抽出器は、レポートが触れたかという別の問いに答えていたのです。
基準に合わせてルールのラベルを切り直す最初の手当ては、逆効果でした。軽度や少量と書かれた所見を陰性側へ倒すと、正解 58 件で 0.036 下がっています。58 件で数えると、関節液貯留の「少量」は多くが陰性でしたが(2 節)、ほかの所見ではおおむね逆でした。軽度と書かれた所見のほうが、言及のない所見より画像で陽性の割合が高かったのです。1 つの所見で見えた傾向を、規則で全所見に広げたのが誤りでした。
旧ラベルの Claude 2 種の答えも、4 段階のせいで値が 4 種類しかなく、検査の大半が同じ値に並んでいました。そこで 9月2日に指示書を書き直し、問いそのものを替えました。指示書には、正解の作られ方と主催者の基準を書いています。そのうえで 9 言語のレポートを訳さずに読ませ、専門医が画像で陽性と付ける確率を Fable に予測させます。
指示書(コード1)の工夫は 2 つです。1 つは 7 つの規則で、どれも前の抽出器で見つけた失敗から作りました。たとえば規則 4 は、前の読み手で最も多かった「悪い膝では全部を陽性にする」癖への手当てです。もう 1 つは出力の形で、レポートの記述の段階 S と、画像で陽性と付く確率 PP(%)を分けて答えさせます。S ごとの出発点(図9)から、レポート全体の文脈で PP を ±10 ほど動かさせるためです。
※ (...) は省略、行末の括弧は注、S の行は原文の定義を縮めたもの。
For EACH report you output your prediction of what a panel of radiologists who
read THE IMAGES (not the report) recorded for 12 findings.
(...) your number is a probability, not a transcription.
## Seven rules (each one is a measured failure of previous readers) (...)
4. DO NOT SMEAR. (...)            (悪い膝でも全部を陽性にしない)
7. SILENCE != ABSENCE. (...)      (言及がなくても陰性とは限らない)
## Output: one line per report, EXACTLY this shape
i=<index> acl=S:PP mcl=S:PP (...) frx=S:PP
S  = what the report STATES: 0 normal / 1 not mentioned / 2 borderline / 3-5 present
PP = two digits 01..99: your probability that the image panel scored POSITIVE.
## Anchor grid: start from these PP values, then adjust (typically +-10) (...)
        S=0  S=1  S=2  S=3  S=4  S=5
eff       5   25   32   40   70   92     (関節液貯留の行。全所見は図9)

図9:S ごとの PP の出発点(指示書のアンカー表)
どの所見でも、S=1(言及なし)の出発点を S=0 より上に置いています。言及のない所見の約 1 割は画像で陽性だと、規則 7 にも書きました。
指示書を正解 58 件で直す危うさ
指示書は、正解 58 件を含む 150 件の試行で本番前に 1 度直しました。最初の版は滑膜炎を関節液貯留からの式で決めさせていて、2 所見の順位相関が 0.98 になりました(正解では 0.40)。2 版目では式をやめ、膝全体の様子から判断させています。速く読ませる指示も足したので、58 件で 0.015 以上は下がらないことを、読ませる前に合格の条件として決めました。
ただ、58 件を見て直すほど、その 58 件での値は当てにならなくなります。9月30日には、正解 58 件と画像モデルの予測を見て規則を 4 つ直した 3 版目も作りました。ところが教師に混ぜる形で測ると、58 件を半分ずつに分けたどちらでも下がりました。58 件から作った規則がその 58 件でさえ効かなかったので、指示書は 2 版目のままにしています。
25 件ずつのバッチを、サブエージェントに読ませる
全 4,407 件は 25 件ずつ 177 個のバッチに分け、Claude Code のサブエージェントに並列で読ませました(図10)。サブエージェントにしたのは、どの読み手も前の文脈を持たず、指示書と自分のバッチだけを読む状態にするためです。正解を見られない読み手でなければ、58 件で測る値に意味がありません。1 バッチは約 3 分、約 8.5 万トークンでした。全件を Claude に読ませても数時間で済むと、8月に見積もれていました。7B のモデルを追加学習で鍛える案を採らなかったのは、そのためです。
正解 58 件もほかの検査と同じバッチに散らし、58 件の値で質の低下を見張りました。バッチを大きくするほど、長い入力の中で質が黙って落ちるおそれがあるからです。1 バッチの件数は、試行の 15 件から本番で 25 件に増やしています。決まった形で返らない行が出たバッチは、丸ごと読み直させました。
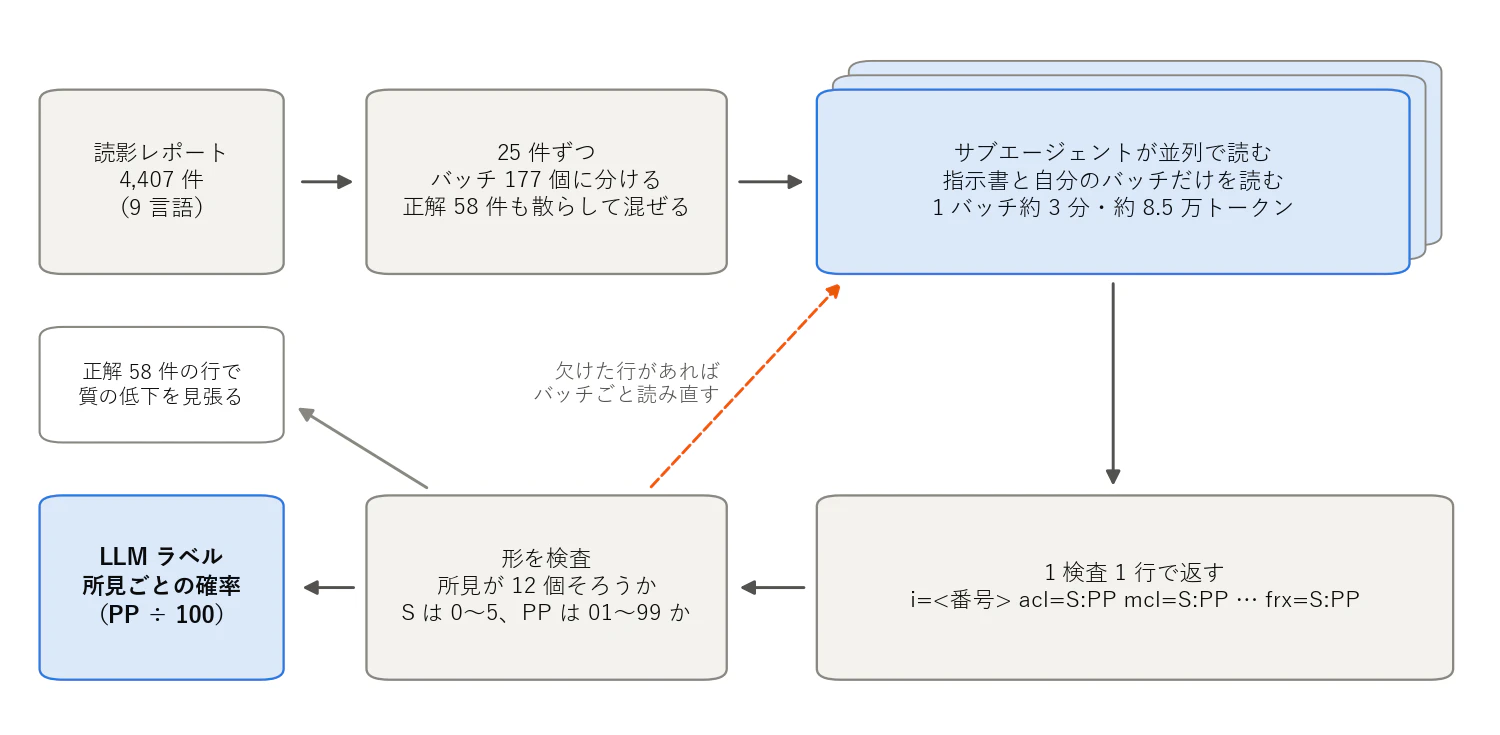
図10:LLM ラベルを読ませた流れ(模式図)
効いたのは、何をどう問うか
旧ラベルとの差が最も開いたのは、レポートが触れていない所見です。ルールのラベルを作る正規表現で、記述を陽性・否定・言及なしに分けると、LLM ラベルはどの群でも上回りました。言及なしの 203 組では、AUC が 0.697 から 0.856 に上がっています。言及がなくても一律に陰性とせず、S=1 の出発点から文脈で PP を動かさせたことが効いたと考えています。
どの Claude に読ませるかは、ほとんど効いていません。9月30日には、同じ指示書で Claude Opus にも全件を読ませ直しました。58 件では 0.9046 で、Fable とほぼ同じです。2 つの答えを平均しても、教師はほぼ変わりませんでした。一方、同じ Fable でも、4 段階で答えさせた旧ラベルの答えは 0.861 です(図11)。
ただ、問いの中身がどこまで効いたかは分けきれていません。9月2日には、旧ラベルの Opus の指示に「値を細かく散らせ」という 1 段落だけを足して、58 件を読み直させました。それだけで、58 件での値は 0.864 から 0.900 に上がっています。Fable の最初の試行との差の 9 割近くが、この 1 段落で埋まった計算です。確率で答えさせれば、この細かさは初めから付いてきます。

図11:正解 58 件での macro AUC(ラベルの作り方別)
文書と正解が食い違う課題では、文書を書き写させるより、正解を付けた人の判定を確率で予測させるほうが近道です。 指示には、その人たちの基準と正解の作られ方まで書きます。
作ってから 3 週間、教師に入れなかった
作った LLM ラベルは、すぐには教師に入りませんでした。全件を読ませる作業は、9月初めに 4,149 件で止まっています。同じころ私は、当時の教師の作り方では、読み手で上げた分が生徒には 0.05 倍ほどしか届かないと計算していました。読み直しの方向は、ここで一度閉じたのです。9月24日に教師を部品に分けて測り直すと、残る余地はテキストの質だけでした。残り 258 件を読み足し、教師に入れたのはこのときです(7 節)。この 0.05 倍は当時の教師で測った値で、テキストを丸ごと替える場合は測っていませんでした。
7B のモデルで学んだ出力の形
7B のモデルでは、出力の形が精度を決めました。生成を減らして速く回そうと、全所見の値を数字だけ 1 列に並べて答えさせたところ、列の後ろの所見ほど同じ値に崩れたのです。正解では約 2 割が陽性のベーカー嚢腫も、ほぼ全件が「なし」でした。所見名を添えた key=value に替えると、macro AUC は 0.630 から 0.758 に上がっています。構造化した出力では値ごとに名前を付け、作ったラベルは中身を読む前に所見ごとの値の分布を数えるべきです。
6. 生徒モデル:縮尺を揃え、推論を 9 時間に収める
画像側で最も効いたのは、モデルの変更ではなく縮尺を揃えたことでした。 中心から 100mm 四方を切り出し、1 画素を 0.39mm に揃えました。Public LB は、全体を縮小したときの 0.889 から 0.910 に上がっています(表4)。推論の 9 時間は、見積もりではなく実際にかかった時間で配りました。
1 画素を 0.39mm に揃える
8月10日に正解 58 件で、生徒と教師ラベルを所見ごとに比べると、はっきり 2 つに分かれました。関節液貯留のように広く写る所見では生徒が上回り、半月板や靭帯のような小さな所見では大きく負けています。初めは、スライスの枚数が足りないのだと考えました。
ところが 40 シリーズの DICOM から撮像範囲を測ると、足りないのは画素のほうでした。中央値 160mm の撮像範囲を 256px に縮めると、1 画素は 0.63mm です。4mm の半月板の断裂は、6 画素ほどにしかなりません。撮像範囲は検査ごとに違うので、1 画素の大きさも揃っていませんでした。
切り出しの最初の試しは、不具合のせいで負けに見えていました。8月14日に公開ノート 8 件を読むと、どれも一定の大きさの四角を mm 単位で切り出してから縮めていました。公開ノートに多い 130mm に私も揃えてみたのが、その最初の試しです。続いていた負けを 1 つの仕組みで説明できる案として、いちばん期待した手です。ところが正解 58 件で下がり、周りを切り落とした損だと説明をつけて負けと記録しました。翌日コードを監査すると、切り出しの指定が前処理に届いておらず、学習した画像は全体を縮めたものと同じでした。
作り直して画像の中心から 100mm 四方を切り出し、どの検査も 1 画素 0.39mm に揃えたのが図12 です。今度は学習の前に、切り出した画像を目で確かめています。それまでに試した画像側の 24 の変更は、どれもはっきりとは勝てていません。画像側の変更で Public LB を動かしたのは、これが初めてでした。
関節の位置は検出していません。後で測ると、写った組織の重心は画像の中心から標準偏差で 7〜8mm ほどしかずれていませんでした。組織の中央に合わせる切り出しは、Public LB で 0.006 下がっています(表9)。
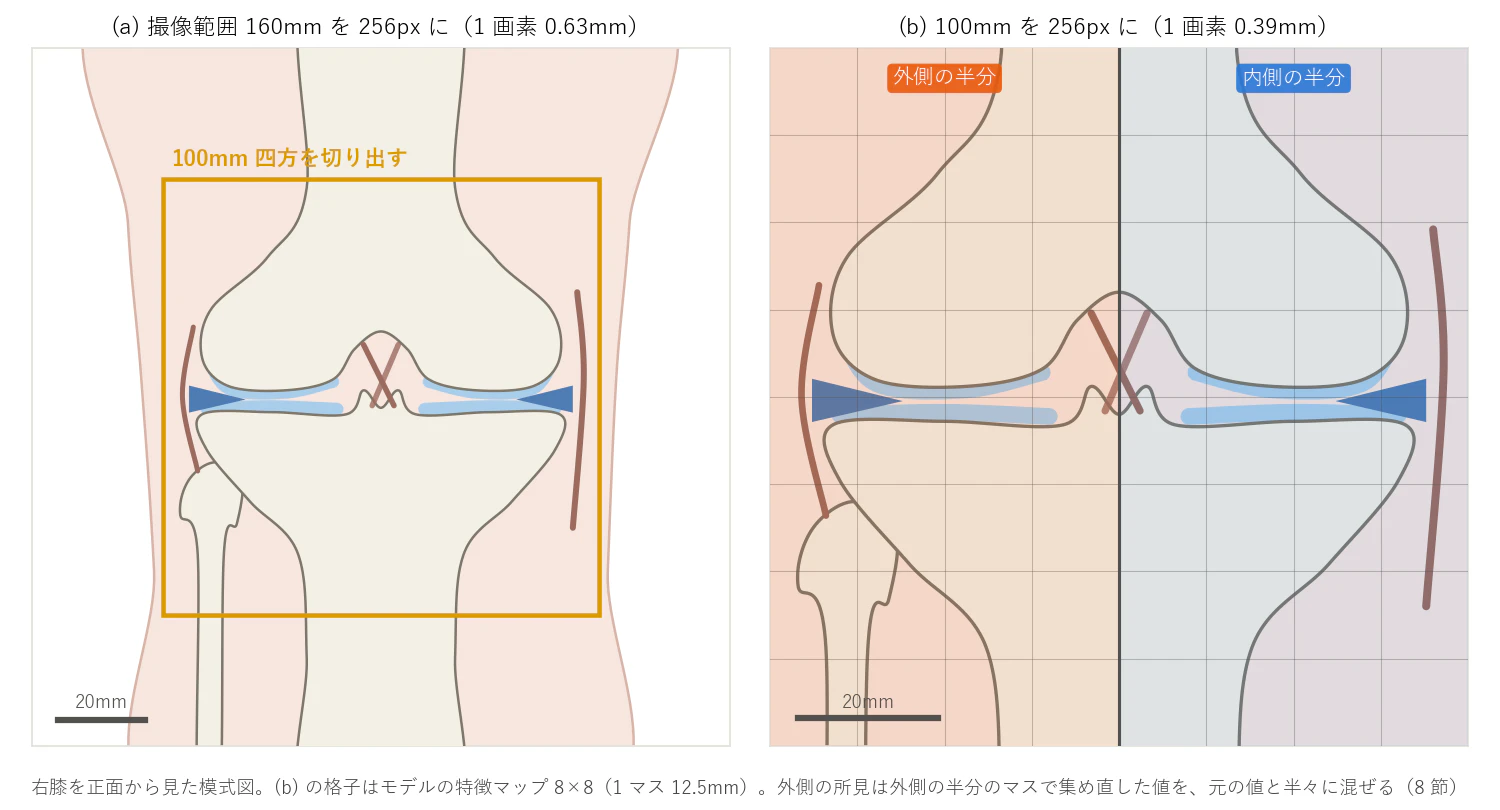
図12:100mm 四方の切り出し(右膝の冠状断の模式図)
表4:切り出し幅と 1 画素の大きさ(基準との差)
| 切り出し(入力) | 1 画素 | 基準 | CV | Public LB |
|---|---|---|---|---|
| 100mm(256px) | 0.39mm | 全体を縮小(160mm で 0.63mm) | +0.0060 | +0.021 |
| 80mm(256px) | 0.31mm | 全体を縮小 | −0.0084 | — |
| 130mm(256px) | 0.51mm | 100mm | −0.0083 | −0.012 |
| 150mm(384px) | 0.39mm | 100mm | +0.0005 | −0.003 |
※ Public LB は同じラベルで学んだ提出どうしの差で、全体の縮小は 4 件の平均です。
表4 で効いていたのは、幅ではなく 1 画素の大きさです。1 画素が 0.39mm のままなら、150mm に広げても CV は 100mm と並びました。Public LB の差も、単独モデルのばらつきの範囲に収まっています。0.39mm から粗くしても細かくしても下がりました。100mm の伸びは、独立した fold 1 でも同じく出ています。公開ノートで複数のチームが行き着いた 130mm・336px の設定も、1 画素は 0.387mm です。
100mm が効いたので、もっと狭く切ればさらに効くと考えて 80mm も試しました。両方の顆と内外の区画が画面に残ることは、学習の前に 6 例で目で確かめてあります。それでも CV は下がりました。
今は、撮像そのものの細かさで説明できると考えています。8月24日に 288 シリーズの DICOM を読むと、PixelSpacing の多くは装置が補間した後の値でした。実際に撮った間隔は、中央値で 0.50mm です。0.39mm より細かく撮ったシリーズは 1 割ほどなので、それより細かい画素では情報が増えず、視野だけが削られます。逆に 130mm の 0.51mm は中央値より粗く、半分ほどのシリーズで細部を削ります。この測定で、0.39mm よりさらに細かい画素が要る、という数週間の見立ても閉じました。
小さい病変を当てる課題では、モデルを替える前に縮尺を mm で揃えるほうが効きます。どこまで細かくするかの目安は、PixelSpacing ではなく撮像そのものの細かさです。
モデルと学習
生徒は検査単位のラベルだけから学ぶ MIL(多重インスタンス学習)のモデルです。ラベルは検査ごとにしか無く、所見がどのシリーズのどのスライスに写るかは分かりません。そこで 5 シリーズ × 16 枚をまとめて入れ、スライスごとに 2D バックボーンを通します。得た 8×8 の特徴マップを、面内の pooling とスライス・シリーズの attention で 12 所見にまとめます(図13)。

図13:生徒モデルの構成(模式図)
面内の pooling は、8月10日の分析を受けて足したものです。標準の全域平均では、画像の 0.055% しか占めない半月板の病変が背景に薄まるからです。最初は attention で重みを付けて集める形でした。ところが後で測ると、出力は全域平均と相関 0.93 で、ほぼ平均として働いていました。そこで、64 マスの平均と値の大きい 8 マスの平均を合わせる形に替えています。これも全域平均とほとんど同じ働きでした(2 つの平均どうしの相関は 0.99 前後)。この集め方を、重みはそのままに推論時に所見ごとに変えたのが、所見ごとの pooling です(8 節)。
バックボーンは 8月の RegNetY-016 から、9月に EfficientNetV2-S へ替えています(表5)。8月には DINOv2 などへの変更がどれも CV で負け、替えても勝てないと結論づけていました。ところが 9月13日に見直すと、どの重みも画素値を 255 で割っただけで学習していました。事前学習の重みが前提とする正規化をしていなかったのです。正規化を入れた EfficientNetV2-S は、同じ教師の RegNetY-016 を 3 つの提出の対すべてで上回りました。差はどれも Public LB で 0.001〜0.002 と小さいものの、以後はこれを主力にしました。のちに ConvNeXt-T も加えています。
表5:10月の主な学習設定
| 項目 | 設定 |
|---|---|
| 入力 | 5 シリーズ × 16 枚、100mm 四方を 256px |
| 学習 | 30 エポック、バッチ 2 × 勾配蓄積 2、lr 3e-4(OneCycle) |
| 損失 | 教師のソフトラベルへの BCE |
| 正則化 | 回転・拡大・平行移動・ガンマ(強さ 0.5)、drop path 0.1、10/11 からは低解像度化とノイズも |
| 規模 | 借りた GPU と手元の RTX 4070 SUPER、重み 1,379 個(9/29 時点) |
※ 最終の 17 本の多くがこの設定です(3 本は 20 エポック)。
9 時間の枠は、実際にかかった時間で配る
隠しテストの推論は 9 時間で打ち切られ、超えた提出にはスコアが付きません。8月12日に CPU で出した提出は、Notebook の見積もりが 225 分のところ、実際は 420 分かかりました。低く外すとスコアごと失うので、提出用の Notebook は見積もりを高めに取ります。見積もりが予算を超えると、モデルの本数や TTA の回数を自動で減らして走ります。
この自動の縮小には、効く手を効かないと見せる落とし穴がありました。8月24日に、TTA の回数を 3 回に増やした提出と、seed 違いの 2 本を平均した提出を出しています。CV では回数を増やすと上がっていたのに、Public LB はどちらも元の提出と同じ 0.932 でした。私は、回数も seed の平均も効かないと結論づけました。効率部門に向けて、回数を 1 回に減らして推論時間を 3 分の 1 にする案まで書いています。
ところが後で Notebook のログを読むと、2 件とも 1 本 × 1 回に削られていました。元の提出とまったく同じ計算です。CPU では 1 本 × 3 回でも、見積もりが 9 時間を超えていたためです。8月27日の提出からは、試走で実際に走った本数と回数を説明文に自動で書き足しています。GPU(T4)で測り直すと、回数を 2〜3 回に増やした提出の対は 4 つとも上がりました。差は Public LB で 0.001〜0.002 です。
見積もりの式も、高いほうへ大きく外れていました。9月半ばまでは、この見積もりのとおり、9 時間に入るのは本数 × 回数で 24 ほどまでだと思い込んでいたのです。12 本 × 2 回と 24 本 × 1 回を、同じ計算量の 2 案として比べる提出まで出しています。9月14日に、前日の試走で測った 14 の値と並べると、本数の多い構成ほど見積もりが膨らんでいました。19 本では 441 分の見積もりに対し、試走から伸ばした値は 77 分です(図14)。

図14:本数ごとの推論時間、見積もりと試走の実測
原因は、1 本ずつ計った 1 検査 1.01 秒を、本数の分だけ足していたことです。この時間の大半は DICOM の読み込みと前処理で、前処理が同じなら何本でも 1 度で済みます。1 本足して増えるのは推論の約 0.12 秒だけでした。式を直した 9月14日から締切まで、9 時間を超えた提出はありません。
最終の 17 本の提出では、Notebook の見積もりより、実際にかかった時間を信じました。見積もりは 1,529 分と 9 時間を大きく超えていました。ただしこれは、T4 2 枚で走る推論を、1 枚で公開テストの 3 件だけ計って伸ばした値です。一方、同じ回数で 14 本の提出は 315 分以内に終わっていたので、17 本なら 383 分ほどと見込みました。T4 の 2 枚目が途中で落ちれば、9 時間を超えてしまいます。それでも予算の設定値をわざと 2,600 分と大きく取り、構成が自動で削られないようにしました。採点は 6.1 時間以内に終わっています。
7. 教師ラベルを直すループ
レポートから作ったラベルに、画像を見た生徒の OOF を混ぜて教師ラベルを作り直し、施設や言語ごとの偏りも均しました。教師だけを替えた比較では、Private LB が 0.931 から 0.935 に上がっています(表6)。ただ、混ぜ続けた教師は 10月にはほとんど動かなくなりました。
混ぜて並べ直し、値の分布は保つ
所見ごとに、レポートから作ったラベルの値 $t$ と生徒の OOF の百分位 $q$ を、$0.3,t + 0.7,q$ で混ぜました(図15)。レポートが触れない所見にも、画像から検査ごとの差を付けるためです。
3:7 の比は、正解 58 件で混ぜ方を交差検証して選びました。画像の重みは 0.6〜0.7 のあたりが最もよく、その間はほとんど差がありません。LLM ラベルに替えた後に測り直しても、最良の比は変わりませんでした。Public LB でも確かめました。テキストを 0.9 まで重くした教師では、同じ生徒の Public LB が 0.005 下がっています。
この形で作り直す前の教師と比べると、3 通りの生徒すべてで Public LB が 0.002 上がりました。1 対ずつなら、Public LB では読めない大きさです。それでも 3 対とも向きがそろい、Private LB も 3 対とも上がっています。
AUC は並びだけで決まりますが、生徒は BCE で教師の値そのものを学びます。並びが同じでも、値の分布が変われば学び方が変わります。実際、並びを保って値の分布だけを LLM ラベルの確率に替えると、CV は 0.8924 から 0.8863 に下がりました。そこで混ぜた値は順位にだけ使い、値は元の教師の分布から順位どおりに割り当てます(コード2 の最終行。変数名は変更)。ただ、この分布は LLM ラベル以前の教師から受け継いだもので、Public LB で確かめた提出の対はありません。
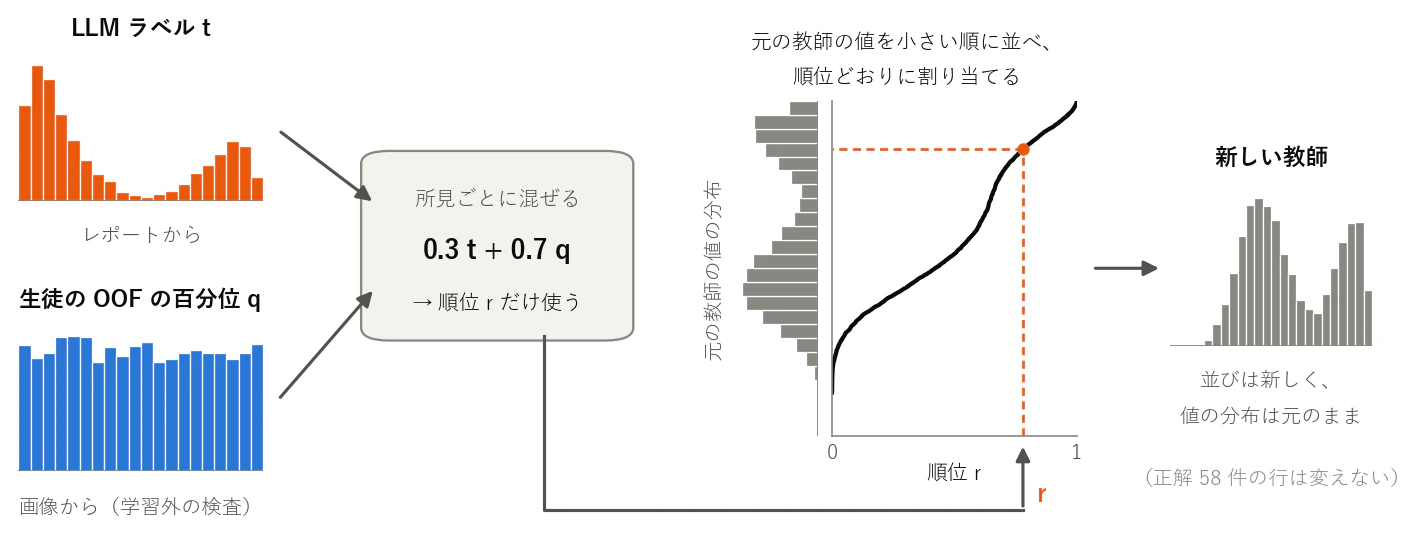
図15:教師ラベルの作り方(模式図)
for c in FINDINGS:  # 正解 58 件の行は変えない
    base = teacher.loc[~is58, c].to_numpy()
    t, q = text[c].to_numpy(), oof_pct[c].to_numpy()
    mix = np.where(np.isfinite(q), 0.3 * t + 0.7 * q, base)
    rank = pd.Series(mix).rank(pct=True).to_numpy()
    teacher.loc[~is58, c] = np.interp(rank, np.linspace(0, 1, len(base)), np.sort(base))
群ごとの偏りを均す
施設や言語でレポートの書き癖が違うため、教師の値の水準も群(施設・言語・撮像条件などのまとまり)ごとにずれます。これに気づいたのは、Public LB が止まっていた 9月前半の停滞の中でした。最初は 9月9日で、Philips の装置で STIR(脂肪を抑える撮り方の 1 つ)を撮る施設です。このときは急性の 5 所見だけを、教師の側で直しました。
9月15日には、設定を変えて出す前に、どの検査で点を落としているかを調べています。CV を検査ごとの寄与に分け、装置やスライス数などの属性で切ってみました。すると 1 つの施設だけが、独立に学習した 4 本のモデルでそろって低く出ました。
その施設(129 件)は Toshiba の Vantage で撮っていました。レポートは英語の箇条書きで長く、「likely due to」のような、あいまいな書き方が目立ちます。旧ラベルで陽性とした所見は 1 検査あたり 3.99 個で、ほかの施設の 2.29 個を大きく上回りました(図16 の左)。
原因は 2 つ考えられました。この装置の画像が読みにくいのか、レポートの書き方で陽性が立ちすぎているのかです。CV の正解も同じレポートから作るので、CV ではどちらか区別できません。レポートの側を調べると、4 通りの抽出器のどれでも、この施設の陽性はほかより多く出ていました。抽出器どうしの食い違いも少なかったので、抽出の誤りではなく施設の書き方だと判断しました。
この偏りは教師に移り、12 所見中 11 で値が高くなっていました。図16 の右は、最も大きくずれた滑膜炎です。生徒もその傾きを覚え、この施設の検査を高めに予測していました(予測の平均百分位 0.647、ほかは 0.493)。施設の中の並びが正しくても、施設ごと上にずれた分だけ全体の AUC は下がります。
直すのは教師の側にしました。推論の後で施設ごとに値をずらしても、学んでしまった傾きの一定分を剥がすだけで、歪みそのものは残ると考えたからです。所見ごとに、群の中と外の値を Mann–Whitney の U 検定で比べます。|z| が 3 以上の所見だけ、群の中の値を順位を保ったまま外の分布に写します(コード3。変数名は変更)。規則は固定し、変えるのは直す群の選び方だけにしました。群は 1 つずつ Public LB で確かめてから足しています。
g = np.linspace(0, 1, 501)
for c in FINDINGS:  # 群の中と外(正解 58 件は除く)
    src, dst = teacher.loc[inside, c].to_numpy(), teacher.loc[outside, c].to_numpy()
    if abs(mwu_z(src, dst)) >= 3.0:
        teacher.loc[inside, c] = np.interp(src, np.quantile(src, g), np.quantile(dst, g))

図16:Vantage の施設の偏り(左:旧ラベルの陽性、右:滑膜炎の教師の値)
Vantage の群を直すと、Public LB は 0.938 から 0.941 に上がり、CV は逆に下がりました。CV が下がって見えることは、提出の前に予想して書いておきました。締切後に取った Private LB でも、差は同じ 0.003 です。
同じときに、施設は全体の 2.9% なので、Public LB は上がっても +0.0014 までと見積もっています。結果はそれを超えたので、傾きが施設の外の検査にも漏れていた可能性を考え、ほかの群も同じ手順で洗いました。この洗い直しで STIR の施設に残っていた 3 所見とクロアチア語のレポートも直し、Vantage と合わせた 3 群を基本にしました。
この補正には行き過ぎもあります。群の本当の有病率がほかと同じだと仮定しているからです。たとえば、レポートに「Joint effusion」とある検査でも、関節液貯留の値が 0.78 から 0.48 に下がりました。Public LB の +0.003 は、こうした行き過ぎを差し引いた後の値です。
Private LB で消えた +0.003
表6:教師だけを替えた比較
| 教師のテキスト | 補正した群 | Public LB | Private LB |
|---|---|---|---|
| 旧ラベル | 3 群 | 0.948 | 0.931 |
| LLM ラベル | 3 群 | 0.950 | 0.935 |
| LLM ラベル | 5 群(+装置とスライス間隔) | 0.953 | 0.935 |
※ 生徒は EfficientNetV2-S・20 エポックで共通。Private LB は締切後に API で取得。
テキストを LLM ラベルに替えた 2 行目の差は、テキストの重みが 3 割しかないのに、Private LB にも残りました。ただし、テキストだけの効果は分けられていません。この行では、混ぜる生徒の OOF も 1 種類増えています。この OOF だけを旧ラベルの教師に足すと、Public LB は下がりました。ただ、LLM ラベルと合わさって初めて効いた可能性もあります。
補正を 5 群に広げた 3 行目の +0.003 は、Private LB で消えました。当時はこの差を本物と考え、補正をさらに広げた教師を 4 通り作りました。Public LB ではどれも 0.953 に届かなかったので、5 群で止めています。ところが Private LB では、そのうち 3 つが 3 行目を上回りました。ただし最も高い 0.939 の 1 つは、学習も 30 エポックと長くしています。
3 行目の 0.953 そのものも、教師だけが違う単独 11 本の中の上振れでした(10 節)。0.004 以下の Public LB の差で補正の範囲を決めたのは、どちらの向きにも根拠が弱かったと考えています。
ループの行き着く先
10月5日からは、教師を少しずつ更新するループに切り替えました。学習データを 20 に分け、新しい生徒が学習に使わなかった 5% の検査を予測します。その予測で、教師の該当する行の画像の部分を置き換えていきます。最初は、今の教師を 8 割残して混ぜる形を考えていました。ところが同じ日のうちに、行を少しずつ置き換える形に決め直しています。置き換えた行では、画像の部分を丸ごと生徒の予測に替えます。置き換えが進むほど、元の教師は残らなくなる作りでした。
その結果、教師は 9月の LLM ラベルの教師から離れていきました(図17)。ここで言う 9月の教師は、表6 の 3 行目の教師です。順位相関は 0.989 から 0.953 まで下がりました。10月10日に全行を置き換え終えた後は、更新の前後の順位相関も 0.999 を下回りません。教師はそこで止まりました。

図17:置き換えた行が増えるほど、教師は 9月の教師から離れた
この間の教師で学んだ同じ作りの生徒 2 本でも、Public LB は 0.955 から 0.953 へ同じ向きに下がりました。ただ Private LB はどちらも 0.935 で、この差は読めません。
生徒の予測は、学んだ教師よりも、教師に混ぜた OOF のほうに近い順位になっていました。自分の予測が教師に入っていない生徒 16 本で確かめると、15 本がそうでした。生徒は教師を写すというより、混ぜた OOF の側へ引き戻されていたのです。振り返ると、画像の部分を生徒の OOF で置き換えた教師は、提出の対で一度も Public LB を上げていません。
10月18日、私はループが 9月の教師から漂ったと判断しました。そこで、9月の教師の画像の部分を 8 割残す形で教師を作り直しました(図17 の星)。この寄せ戻した教師の系統で学んだ生徒 2 本と、画像の部分を古い生徒の OOF だけで作った教師の生徒 1 本が、最終の 17 本に入っています。
テキストと生徒の予測を混ぜるだけでは、両方がそろって外す所は直りません。 ループの行き着く先は混ぜた OOF そのもので、先へ進むには材料から替える必要があります(11 節)。今なら 9月の教師を錨として残し、更新のたびにその教師との順位相関を見ます。
8. 推論時の所見ごとの pooling と TTA
10月に Public LB を 0.957 から 0.964 まで上げたのは、重みを変えない推論の変更でした(表8)。10月9日に改良案を洗い出して見積もると、学習を変える 26 案は、確かめた後もどれも ±0.0005 ほどにとどまりました。いちばん大きく見えたのが、同じ重みのまま推論で集め方だけを替える手です。
局所の証拠が平均で薄まる
6 節のモデルは、面内・スライス・シリーズの 3 段をほぼ平均でまとめます。そのため片側の半月板の断裂のように、数枚のスライスの一角にしか写らない証拠ほど薄まります。スライスの attention は 12 所見で共有されていて、16 枚のうち 10〜12 枚ほどに重みが散っていました。面内の pooling も、64 マスの平均と値の大きい 8 マスの平均から作ります。どのマスが内側かという位置は使いません。
外側の所見の予測が内側の所見につられることは、8月下旬から気になっていました。そのときは内側と外側を分けて集める構造を学習で試しましたが、差は対照の seed 違い 2 本の幅の内側でした。特徴を調べると、内外の区別は残っていました。ただ、特徴の上で分類器を学習し直しても、モデル自身の出力を超えません。そこで、ヘッドの側に取り戻せる余地は無いと結論し、この方向を閉じています。
10月に、学習済みの重みのまま面内の半分だけで集め直してみました。冠状断と軸位断で逆の側の半分を使うと、半分を割り当てた 8 所見すべてで下がりました。合う側の半分なら 6 所見で上がります(正解 58 件、1 本のモデル)。内外の証拠は特徴に残っていて、平均で薄まっていただけだと考えました。
学習し直さずに、所見ごとに集め直す
学習し直さずに集め方を変えられたのは、モデルの最後の層が線形だからです。 スライスとシリーズの attention はどちらも重み付き平均なので、所見の値はスライスごとの寄与の重み付き平均に分けられます。寄与は、そのスライスの特徴に最後の層を掛けた値です。12 所見は attention を共有していて、違うのは最後の層の 1 行だけでした。そこで寄与の作り方と集め方を、所見ごとに替えました(図18)。
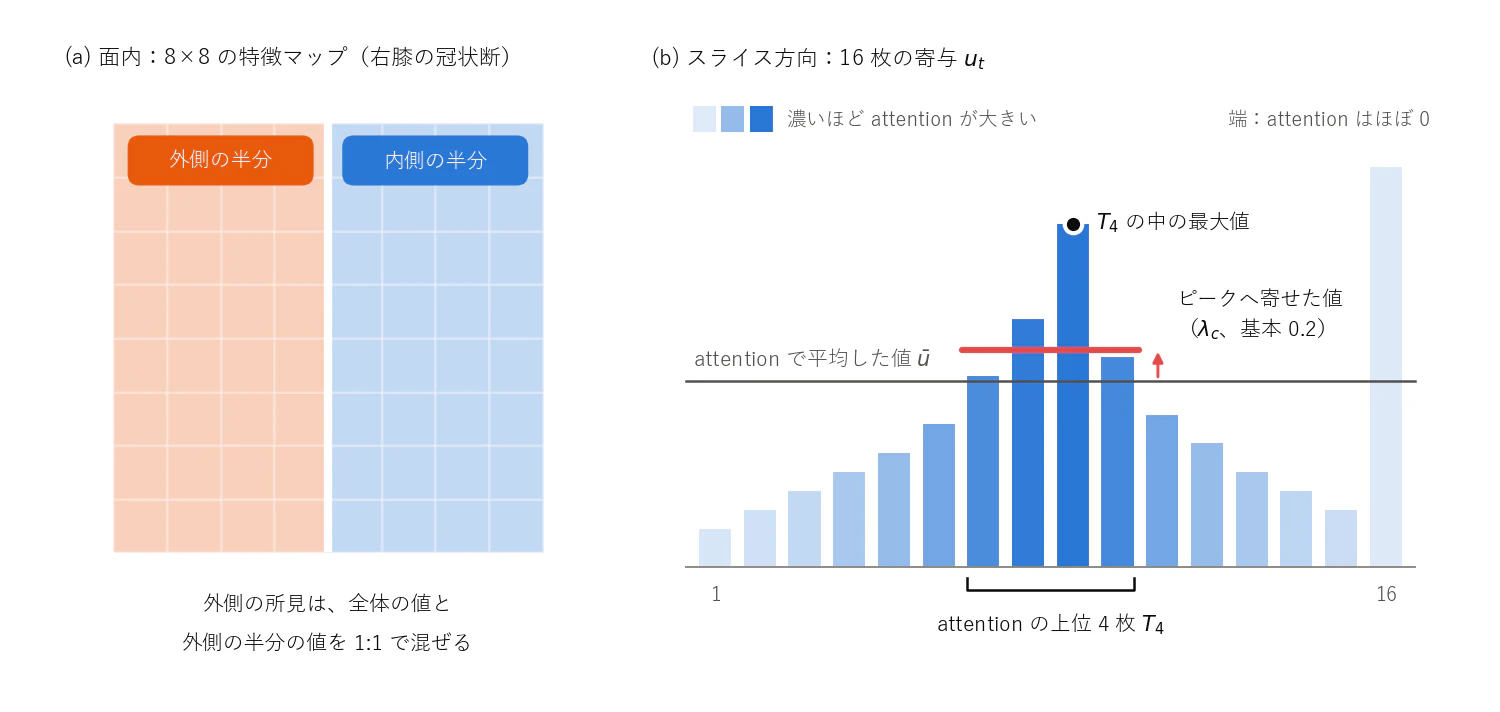
図18:所見ごとの pooling(模式図)
※ (b) の棒の高さと色の濃さは、説明のための架空の値です。
面内では、冠状断と軸位断の 8×8 の特徴マップを内側と外側の半分に分けます(図12 の (b))。軸位断は、前と後ろの半分にも分けます。所見に関係する半分だけで寄与を集め直し、元の寄与と 1:1 で混ぜました。外側が画像のどちら側に来るかは、左右の膝で逆です。左右の膝は DICOM の Laterality タグで決めました。タグが無ければ、画像の中心が体の左右どちらにあるかで決めます(タグのある 300 件で 99.3% 一致)。
スライス方向では、attention で平均した寄与 $\bar{u}c$ を、ピークの値へ $\lambda_c$ だけ寄せました(スライス方向のピーク)。ピークは attention の上位 4 枚 $T_4$ の中の最大値で、$u{tc}$ はスライス $t$ の寄与、$\lambda_c$ は所見ごとの重みです。
\mathrm{score}_c = \bar{u}_c + \lambda_c \bigl( \max_{t \in T_4} u_{tc} - \bar{u}_c \bigr)
16 枚全体の最大値にすると、attention がほぼ 0 の端のスライスを拾って下がったので、上位 4 枚に絞りました。面内でも、各スライスの寄与を値の大きい 4 マスの平均へ 0.2 だけ寄せています(面内のピーク)。
自前の計算を見張る
所見ごとの pooling はモデルの集め方を自前で書き直した計算なので、安全装置を付けました。各モデルの最初のバッチで、所見ごとの変更をすべて外した結果を、モデル自身の出力と比べます。ロジットで 0.05 を超えてずれたら、推論を止めます。形の違うモデルを後から足すと、書き直した計算が黙ってずれるからです。わざとずらすと止まることも確かめました。最終の 17 本でもずれは最大 0.0026 で、変更でロジットが動く幅(平均 0.35〜0.82)より 2 桁小さく収まっています。
骨挫傷を変性から切り離す
骨挫傷だけは、集め方ではなく所見どうしの結びつきを直しました。きっかけは 8月下旬に、モデルの誤り 72 件を画像で見直していて気づいた教師の癖です。表1 の外傷 4 所見と、OA 3 所見・ベーカー嚢腫の順位相関が、教師では +0.40 でした(図19)。正解 58 件では −0.49 と逆向きです。急性の外傷を負う膝は若く OA が少ない、という臨床の知識とも合います。ただ正解 58 件は外傷の膝が多めで、選び方の偏りも入ります。教師を 0/1 に丸めて点検すると +0.01 になるため、それまで見えていませんでした。

図19:外傷と変性の所見の結びつき(8月下旬)
8月には、予測から全所見の平均を一律に引く補正を試しましたが、どの重みでも下がりました。そのときは後から引いても直らないと考え、教師の側で直しています。10月に所見ごとに分けて調べ直すと、変性を引いて上がるのは骨挫傷だけで、ACL・MCL・骨折は 0 か負でした。所見をまとめて扱っていたので、骨挫傷だけの効き目が隠れていたのです。
画像では、変性した膝の軟骨下の骨髄浮腫が、外傷の骨挫傷と似て見えます。教師には生徒の OOF を 7 割混ぜるので、この取り違えが教師に入り、ループで生徒に戻ると考えました。骨挫傷は、表1 で変性とした 5 所見のどれを引いても上がりました。そこで CSV を書く直前に、5 つの平均を引きます。$z$ はテスト全体で所見ごとに標準化したロジットです。
z'_{\text{骨挫傷}} = z_{\text{骨挫傷}} - 0.3\,\bar{z}_{\text{変性}}
この補正は、骨格も教師も違う 15 系統のモデルすべてで、学習に使っていない検査の AUC を上げました。似た引き算はほかに約 690 通り試しましたが、確かめを通ったものはありません。所見どうしの結びつきの大半は本当に一緒に起きるもので、引くと下がります。引き算は、向きを医学の知識で決められる所見に限るべきです。
サンプリング TTA とビュー TTA
モデルに入るのは、1 検査 5 シリーズ・各 16 枚までです。そこで推論のたびにシリーズとスライスを選び直し、予測を重ねました(サンプリング TTA)。回数は 2〜3 回までは増やすほど上がり、その先は平らでした。最終提出の 8 回は、終盤に GPU 2 枚で時間が空いたので増やしたものです。回数だけを 5 回から 8 回にした提出は、表示値が同じ 0.964 でも、提出の選択画面では上に並びました。丸める前の値が上がったと読み、並びの上がらなかった 10 回ではなく 8 回にしています。
重ねた予測のまとめ方は、公開ノートの表を出発点に所見ごとに決めました(表7)。その表では内側半月板も最大値でしたが、正解 58 件で下がったので平均に戻し、のちに上位 2 回の平均にしています。
さらに 1 回目の入力から、ぼかした 1 枚と、少し回転・拡大・平行移動した 2 枚を作って足しました(ビュー TTA)。サンプリングの回の一部をこの 3 枚に置き換える形は学習に使っていない検査で負け、足す形だけが効きました。ぼかしは学習時の拡張に無かったので、10月11日からは学習にも低解像度化とノイズを加えています。
所見ごとの設定
表7:最終提出の所見ごとの設定
| 面内で使う半分 | TTA を最大値でまとめる所見 | TTA を上位 2 回の平均でまとめる所見 |
|---|---|---|
| 外側 | 外側半月板 | 外側 OA |
| 内側 | — | 内側半月板・内側 OA・MCL |
| 前 | — | 膝蓋大腿 OA・関節液貯留 |
| 後ろ | ベーカー嚢腫 | — |
| 全体 | 骨挫傷・骨折 | ACL・滑膜炎 |
※ TTA はサンプリング TTA 8 回とビュー TTA 3 枚の計 11 回分です。
面内の半分は、所見の現れる場所から決めました。内側・外側の名が付く所見と MCL はその側、膝蓋大腿 OA と関節液貯留は膝蓋骨のある前、ベーカー嚢腫は膝の裏です。滑膜炎は、矢状断の前の半分に当てると正解 58 件で下がり、後ろの半分なら上がりました。結果を見てからの発見なので採らず、全体のままにしています。
$\lambda_c$ は 0.2 を基本にし、膝全体に広がる関節液貯留と滑膜炎は 0 にしました。ピークの高さだけで並べると、関節液貯留の AUC は 0.41 と逆向きだったからです。骨折だけは 0.4 です。選ぶのに使っていないモデル 3 本でも、正解 58 件でも 0.4 のほうが良く出ました。
Public LB の刻みを越えたのは所見ごとの pooling だけ
表8:4 本のアンサンブルに推論の変更を段ごとに足した結果
| 段 | 足した変更 | Public LB | Private LB |
|---|---|---|---|
| 0 | 土台(サンプリング TTA 4 回) | 0.957 | 0.940 |
| 1 | +所見ごとの pooling と骨挫傷の補正 | 0.962(+0.005) | 0.944 |
| 2 | +拡張ありで学んだ 2 本は、学習時の補間のぼけに合わせ入力を 1/4 画素ずらす | 0.962(±0) | 0.945 |
| 3 | +ビュー TTA 3 枚 | 0.963(+0.001) | 0.946 |
| 4 | +6 所見の TTA のまとめ方を平均から上位 2 に・骨折の $\lambda_c$ を 0.4 に・MCL にも同じ補正(重み 0.1) | 0.963(±0) | 0.946 |
| 5 | +面内のピークを所見ごとの重みに・骨挫傷の TTA のまとめ方を上位 2 に | 0.964(+0.001、当時 4 位) | 0.947 |
| 参考 | 段 1 だけを、重みの違う 3 通り(EfficientNetV2-S 4 本・同 1 本・ConvNeXt-T 1 本〔TTA 2 回〕)に | +0.005〜+0.007 | +0.004〜+0.005 |
※ 4 本は EfficientNetV2-S 3 本と TResNet-M 1 本です。括弧内は前の段との差です。
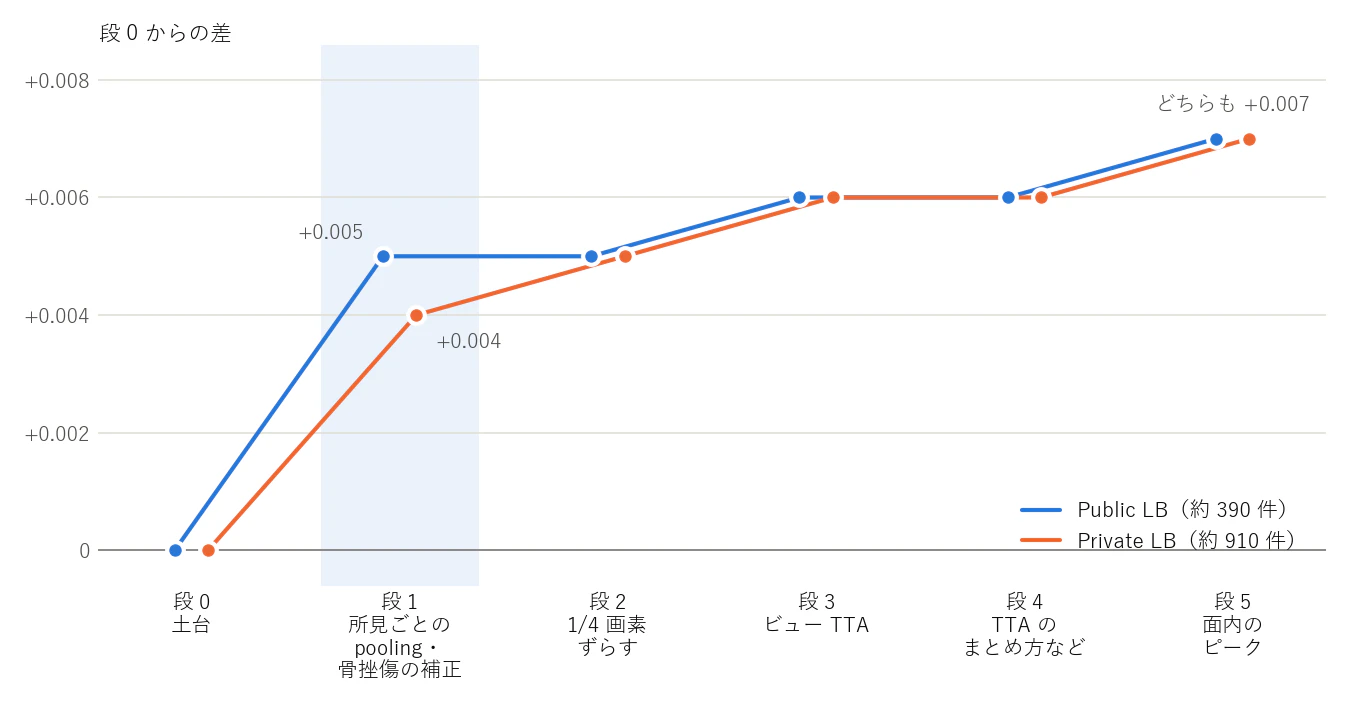
図20:推論の変更を段ごとに足したときの LB の伸び
Public LB の表示の刻み 0.001 を大きく越えたのは、所見ごとの pooling と骨挫傷の補正を入れた段 1 だけでした(図20)。重みの違うどのモデルでも、Public LB と Private LB の両方が上がっています。先に書いた予測は +0.0013(帯 −0.001〜+0.003)でしたが、結果は +0.005 で帯の上端も越えました。ほかの段の差は刻み 1 つ以内で、Public LB では見分けられない大きさです(10 節)。それでも Private LB は、段を足すたびに同じか上がっています。
+0.005 を見て、私は調整すればまだ伸びると考えました。そこでピークの重み・半分の切り方・結びつきの引き算など約 250 通りを、選ぶモデルと確かめるモデルを分けて測りました。通ったのは面内のピークだけで、得は +0.0001〜+0.0002 です。外側の端の列や上下 1/4 のような細かい領域も、0 か負でした。
最終の 17 本では、段 5 の 2 つの変更を戻しました。面内のピークの重みを所見ごとに選ぶと、選ぶのに使った 12 本では一律 0.2 より上でした(AUC の上がり幅 +0.0010 対 +0.0006)。ところが使っていない 12 本では逆で、一律が +0.0008、所見ごとが +0.0004 です。測る前に決めておいた基準どおり、一律 0.2 に戻しました。骨挫傷の TTA のまとめ方も、使っていないモデルで差が無かったので最大値に戻しています。所見ごとに選んだ値は、選ぶのに使っていないモデルで一律の値と比べてから出すべきです。
9. 効かなかった工夫
効かなかった手の採否は、正解 58 件・CV・Public LB のどれを信じるかで分かれました。正解 58 件でだけ良く見えた変更は、どれも Public LB で上がっていません。効かなかった手の多くは、次の 3 つの型にまとまります(表9)。
- ① 正解 58 件でだけ良く見えた変更:130mm と組織の中央での切り出し、公開のレポートラベル表
- ② 小さい病変に向けて細かくした変更:FPN・U-Net・384px 入力
- ③ 凝った組み合わせ:所見ごとの振り分け、GBDT のスタッキング、seed 違いの重みの平均
表9:効かなかった工夫
| 試したこと | 比較対象 | 指標 | 差 | Private LB の差 |
|---|---|---|---|---|
| ① 正解 58 件でだけ良く見えた | ||||
| 130mm で切り出す | 100mm | Public LB | −0.012 | −0.010 |
| 組織の中央で切り出す | 画像の中心 | Public LB | −0.006 | ±0 |
| 公開のレポートラベル表 5 つの平均を教師に | 自前の教師 | Public LB | −0.030 | −0.026 |
| ② 小さい病変に向けて細かくした | ||||
| FPN | 基準の構造 | 正解 58 件 | −0.0112 | — |
| U-Net | 基準の構造 | 正解 58 件 | −0.0650 | — |
| 384px 入力(バッチ 1 と交絡) | 256px | 正解 58 件 | −0.0484 | — |
| ③ 凝った組み合わせ | ||||
| 所見ごとにモデルを振り分ける | 順位平均 | CV | −0.0054 | — |
| GBDT のスタッキング | 使わない | 5 分割の OOF | −0.0085 | — |
| seed 違いの重みそのものを平均 | 元の 1 本 | CV | −0.0263〜−0.0473 | — |
| 言い切れないまま外した | ||||
| 装置と言語の 22 群も補正 | Vantage と STIR の 2 群 | Public LB | −0.004 | +0.002 |
| 冠状断と軸位断で左膝を反転 | しない | CV | +0.0010 | — |
※ 差は「試したこと − 比較対象」。Public LB の行は 1 か所だけ違う提出の対で、公開ラベル表の行だけはほかに 2 設定も違います。
差の大きさは、seed 間の揺れ(2σ)と比べて読みました。この揺れは 9月14日に、設定が同じで seed だけが違うモデルの差を 246 対集めて求めています。件数の少ない正解 58 件では、揺れが CV の 2.4 倍あります。図21 の灰色の帯の内側は、seed を変えただけでも出る差です。

図21:効かなかった手の差と seed 間の揺れ(2σ)
※ 130mm の CV は、Public LB に出した 2 本で測った値です。表4 の −0.0083 は、8月の別の学習で測りました。
① 正解 58 件を信じすぎた
9月下旬まで、私は CV と正解 58 件の和で採否を決めていました。組織の中央に合わせた切り出しは、58 件で +0.0172 と揺れを超えて上がり、CV は揺れの内側でした。ところが Public LB では 0.006 下がっています。それでも当時の私は、スコアの低い単独モデルどうしなら話は違うと考えました。58 件でだけ上がった差も、Public LB に出るかもしれないという見立てです。
そこで、130mm の切り出しと seed だけを変えた対を、予測と読み方を先に書いてから提出しました。130mm は 58 件で +0.0210 上がっていましたが、Public LB では 0.012 下がりました。seed だけの対は 58 件で +0.0172 動いたのに、Public LB は同じ値のままです。正解 58 件でだけ上がった差は、本物の改善の印ではなく、むしろ外れの印でした。9月下旬からは、正解 58 件だけでは採否を決めず、ほかの指標と同じ向きかを見る材料の 1 つに下げました。
公開のレポートラベル表も、同じ型の失敗です。9月10日に公開の表を集めて正解 58 件で並べると、自前の表は 12 表中 6 位でした。レポートから LLM で作られた 5 表の平均は、自前の表を 0.0133 上回ります。そこで、これを教師にして生徒を学習させました。ところが、その生徒は Public LB で 0.030 下がっています。表としての良さは、生徒を学習させて比べるまで分かりません。
② 細かくした変更は確かめ切れていない
2 つ目の型は、効かなかったというより確かめ切れていません。8月10日に、小さい病変で生徒が教師に大きく負けているのを見ました(6 節)。そこで画素が足りないと考え、384px 入力と、細かい特徴を拾う FPN・U-Net を試しています。
U-Net と 384px の負けは揺れを大きく超え、FPN は揺れの内側です。前提の「画素が足りない」は、8月24日に撮像そのものの細かさを測って捨てました。それまでの数週間、前提を測らないまま手を重ねていたことになります。ただし 3 つの負けは、事前学習に合わせた画素の正規化を入れる前の測定です。9月下旬からは教師ラベルの改善に絞ったので、測り直していません。
③ 凝った組み合わせは単純な相手に負けた
3 つ目の型の手は、どれも順位平均や元の 1 本といった単純な相手に負けました。所見ごとにモデルを振り分ける手は、個々のモデルと比べると +0.0127 上がって見えました。ところが同じモデルの順位平均と比べると、CV を半分ずつに分けた 100 回で 1 度も勝ちません。選ぶ手順そのものも偶然を拾い、学習ノイズしか違わない 4 本に当てても見かけの得が +0.0044 出ます。
GBDT のスタッキングは、5 分割の OOF で何もしないより 0.0085 下がりました。12 所見の出力を線形に組み直しても +0.0027 しか上がらない所に、木の階段状の出力が同点を増やしたためです。順位しか見ない AUC では、同点はそのまま損になります。
seed 違いの重みの平均は、8月27日に最優先で試しました。公開ノートの 28 系統が重みを平均しており、追加の GPU も要らないからです。ただ、公開ノートが平均していたのは、同じ学習の続くエポックの重みでした(図22)。seed の違う 2 本の重みは相対 L2 で 0.22 離れており、平均すると谷と谷の間の損失の高い所に落ちます。予測ではなく重みそのものを平均したので、3 通りとも元の 1 本より 0.026〜0.047 下がりました。

図22:重みの平均と損失の谷(模式図)
言い切れないまま外した 2 件
表9 の最後の 2 行は、どちらも読み切れない大きさの差で外した手です。22 群まで広げた補正は、Public LB で 0.004 下がったので外しました。ところが Private LB では 0.002 上がっています。0.004 は、Public LB で読める 0.005 に届かない差です。
左膝の反転は、公開ノートの 20 件中 19 件が入れていた処理です。最初の CV は −0.0096 でしたが、採点の側で左膝を反転していない値でした。直すと +0.0010 で揺れの内側でした。推論側への実装も要るので、Public LB には出していません。上位 3 チームはどれも左右か向きを揃えており(11 節)、1 回の比較で退けたのは早すぎました。
振り返ると、表9 の失敗に共通するのは、1 つの数字や前提を、別の測り方で確かめる前に信じたことです。10月中旬からは、合わせ込んでいない複数の物差しが揃って上がる手だけを採るようにしました。
10. 評価の設計と、Public LB・Private LB の差
小さな差の採否は、表示値の上下より、結果を見る前に書いた予測に従うほうが確かでした。 締切後に、最後に出した 200 件(9月6日 17時以降)の Private LB を Kaggle の API で取り直し、Public LB や先に書いた予測と照らし合わせました。
予測を先に書くようになったわけ
8月から9月上旬にかけては、Public LB の動きを、結果が出てから解釈していました。そのせいで、判断を誤ったり、根拠の弱い決め方をしたりしています。1 つは 8月で、構成が自動で削られて同じ中身になった 2 つの提出を比べ、効く手を効かないと結論づけました(6 節)。もう 1 つは 9月上旬です。表示値が 0.001〜0.002 上がった提出の対が 3 つそろったのを根拠に、サンプリング TTA の回数を決めていました。向きはそろっていても、1 対ずつは表示の刻み 1〜2 つ分の差です。約 390 件への合わせ込みと区別できない決め方でした。9月9日に振り返ると、提出の説明文のうち 16 件が、Public LB の値 2 つ以上を判断の根拠にしていました。そこで、Public LB は決めた後の答え合わせに使い、選ぶためには見ないことにしました。
それからは、前の提出との差の予測と、表示値の出方ごとの次の手を、提出の説明文に先に書いています。予測は、自分の思い込みに気づくきっかけにもなりました。9月30日、教師を替えた単独モデル 2 つが、そろって予測の帯を下回ったのです。調べると、帯の中心に置いていた 0.953 の 1 本が、教師だけが違う単独 11 本の中で突出していました。ほかの 10 本はどれもこれより低く、11 本の平均は 0.9510 です。この 1 本の Private LB は 0.935 で、11 本の平均 0.9355 と変わりません(表6 の 3 行目)。
Public LB で見分けられたのは 0.005 以上の差
10月上旬には、Public LB の 0.004 未満の差では何も決めない、という線も先に引いていました。Private LB で答え合わせすると、境目はもう 1 刻み上の 0.005 にあったことになります。図23 に並べた提出の対のうち、Public LB を 0.005 以上動かした変更は 5 つです。そのうち 4 つは、Private LB でもほぼ同じだけ動いています。外れたのは、写った組織の中央で切り出す変更だけです。0.004 以下の差には、Private LB でそのまま出たものも、消えたものも、逆になったものもあります。
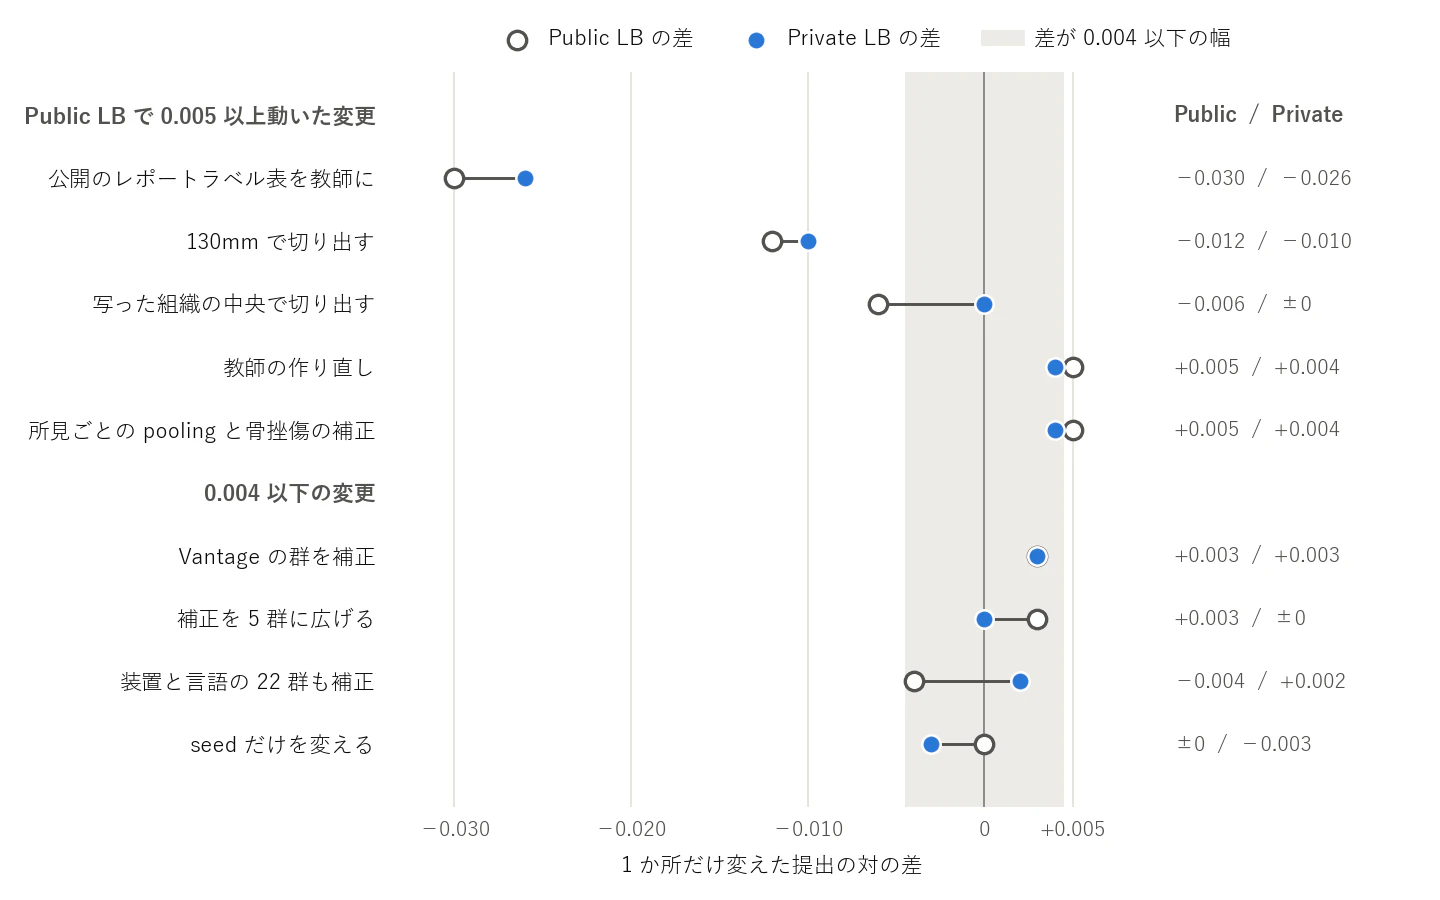
図23:1 か所だけ変えた提出の対の差(Public LB と Private LB)
判断に使ったほかの指標も、上位どうしの小さな差は見分けられませんでした(表10)。
表10:判断に使った指標と、LB との順位相関(スピアマン)
| 指標 | 照らし合わせた LB | スコアどうし | 前後の差どうし |
|---|---|---|---|
| CV | Public LB | −0.38 | +0.43 |
| 正解 58 件 | Public LB | — | +0.02 |
| 表示値 | Private LB | 0.979 | 0.12 |
| 先に書いた予測 | Private LB | — | 0.40 |
※ スコアどうし:提出ごとのスコアの並びの順位相関。CV は上位の単独 7 本、表示値は 200 件で求めました。
※ 前後の差どうし:1 か所だけ変えた前後の差の並びの順位相関。上 2 行は単独モデルの 26 対、下 2 行は終盤の 44 対です。
CV は教師の良し悪しが映りにくいうえ(7 節)、上位の単独モデルの並びも Public LB と逆向きでした。正解 58 件は、差の向きも追えません。表示値も、Private LB と合うのは大まかな並びまでです。終盤にモデルを足すか替えた 31 件では、表示値が 10 件で下がったのに、Private LB は 1 件も下がっていません。
予測は表示値より Private LB に合った
1 本を足すか替えるだけの差は、表示の刻み 0.001 より 1 桁小さいと見積もっていました。表示値の上下では決められないので、先に書いた予測と次の手(コード4)で採否を決めています。LB の順位は切り捨てる前の値で並ぶので、表示値が同じでも、同点で上にいたチームを抜けば上がったと分かります。これは、表示値が変わらないのに順位が上がったのを見て気づいたことです。
予測(先に書く):前の提出との差 +0.0003(範囲 −0.0002〜+0.0006)
表示値の見込み:0.964 が 40%、0.963 が 55%、0.962 以下が 5%
結果ごとの次の手(先に決める):
  0.964 以上 → 次の提出の元にする
  0.963 で上のチームを抜く → 元にする
  0.963 で順位も動かない → 見分けられない。学習に使っていない検査で測った差を根拠に元にする
  0.962 以下 → 害とみなし、前の提出に戻す
中身:前の提出と同じ重みに後処理を 2 つ足す(表8 の段 5)
この提出の表示値は 0.964 で、決めておいたとおり次の元にしました(当時 4 位)。
終盤に予測を書いた 44 件を答え合わせすると、予測は表示値より Private LB とよく合います。予測で +0.0005 以上の得を見込んだ 16 件では、表示値は 2 件上がって 2 件下がりました。Private LB は 10 件上がり、1 件も下がっていません。実際の差が予測した差の何倍になったか($k$)も、表示の切り捨てを織り込んだ最尤推定で求めました。予測が大きさまで当たれば $k$ は 1、結果と無関係なら 0 です。表示値では $k$ が 0 と区別できず、Private LB では 0.70(95% 区間 0.40〜1.00)でした。
最終の 2 つの選び方
最終提出には、2 つのアンサンブルを選びました。Public LB が最も高い 17 本のものと、中身の違いを優先した 19 本のものです。Public LB の最高は、多くの候補から選んだ分だけ上振れしやすいと考えていたので、片方は違う形に賭けました。
この考えの裏づけは、10月8日の提出です。Public LB で選んだ 2 本のアンサンブルは 0.956 でした。一方、Public LB で選んでいない新しい 2 本のアンサンブルは 0.953 で、先に書いた帯を下回りました。先に決めていた次の手に従い、最終は本数を増やして運を均す方針にしています。この 2 つのアンサンブルは、Private LB ではどちらも 0.937 でした。17 本のものも、締切の前日には表示値 0.965 に並ぶ 9 チームの最後にいて、切り捨てる前の値は境目のすぐ上とみていました。
19 本のものは、17 本からほぼ同じ教師で学んだ 7 本を外し、新しい教師の 9 本を足したものです。教師どうしの順位相関の平均は 0.951 から 0.921 に下がり、中身の違いが広がりました。結果は 2 つとも Private LB 0.949 で、200 件の中の最高(23 件が並ぶ)と同じでした。17 本のものを少しずつ変えた 10 件も、表示値はどれも 0.964 に下がっています。それでも Private LB は、どれも 0.949 のままです。
Public LB から Private LB への下げ幅
Private LB で順位を下げた原因は、選び方ではなく解法の中身にあります。200 件の Public LB と Private LB の順位相関は 0.979 で、並びはほぼ保たれていました(図24)。ただ、どの提出も 0.012 以上、平均 0.017 下がっています。1〜3 位の下げ幅は、そろって 0.009 でした。

図24:最後の 200 提出の Public LB と Private LB
11. 上位解法との比較と、次にやること
上位解法といちばん違ったのはラベルの作り方で、1〜3 位はどれも LLM に画像まで読ませて教師を作っていました。正解 58 件で測ると、レポートだけから作ったラベルは 2 チームとも 0.90 前後にとどまります。見たい画像を LLM に求めさせたラベルと、全スライスを渡したラベルは、0.94 前後に届いていました(表11・図25)。
表11:LLM に読ませたものと、正解 58 件での macro AUC
| チーム | 読ませたもの | AUC |
|---|---|---|
| この解法 | レポート | 0.9017 |
| 2 位 | レポート | 0.899 |
| 1 位 | レポート+決まった 21 スライス | 0.874〜0.909 |
| 1 位 | レポート+一覧とツールで求めた画像 | 0.936 |
| 2 位 | レポート+全スライスと拡大図 | 0.942 |
| この解法 | 画像だけ(約 50〜70 スライス) | 0.7290 |
※ LLM も指示もチームごとに違います。1 位の 21 スライスの行は、3 種の LLM の幅です。

図25:LLM に渡したものごとの、正解 58 件での macro AUC
画像を添えても、決まった 21 スライスだけではレポートだけと大差がありません。0.94 前後に届いたのは、見せる画像を決まった枚数に絞らなかった 2 つの形でした。
表12:上位解法との比較
| チーム | LLM が画像も読む | 左右・向き | 外部データ | Private LB |
|---|---|---|---|---|
| この解法 | いいえ | そのまま | なし | 0.949 |
| 1 位 | はい | 左膝を反転 | 記載なし | 0.960 |
| 2 位 | はい | 左膝を反転 | fastMRI・OAI | 0.960 |
| 3 位 | はい | 向きを揃える | OAI | 0.959 |
| 14 位 | いいえ | 姿勢を揃える | fastMRI・OAI | 0.956 |
画像を読ませなかった 14 位の著者も、真っ先に直すのはラベルだと書いています。自分より上位で解法を公開した 10 チームのうち、9 チームが画像まで読ませたラベルを使っていたからです。
小さな予備実験で方向を捨てない
予備実験で外れた方向も、伏せたレポートや絞ったスライスを本番の条件に戻し、1 度は試してから捨てるべきでした。 表11 の最後の行が、私がこの方向を捨てた試しです。
10月初めの時点で、残る失点は、教師と生徒が同じ所で外すものに集まっていました。伸びしろが残るとすれば、画像を読んで作る新しいラベルしかない、というのが当時の見立てです。そこで 10月5日、Claude に MRI を読ませ、ラベルの材料になるかを正解 58 件で確かめました(図26)。
知りたかったのは、画像がレポートとは別のラベル源になるかです。そこでレポートも正解も伏せ、画像だけを読ませました。1 件ごとに見せたのは、スライスを並べた一覧画像 6 枚(約 50 スライス)です。前半 30 件の結果から判定の基準を決めて書き留め、後半 28 件は拡大 3 枚を足して読ませました。1 件 15〜20 秒、58 件で 18 分ほどの小さな試しです。

図26:10月5日の試しと、2 位の本番の違い(模式図)
結果は macro AUC 0.7290 でした。LLM ラベルと生徒を上回ったのは骨折だけで、0.941 対 0.888・0.893 です。外側半月板・外側 OA・滑膜炎は 0.52〜0.60 で、偶然に近い値です。私はここから、画像を読ませても新しいラベル源にはならないと結論し、画像からラベルを作る方向ごと見切りました。その後の伸びは、推論の工夫で取りに行っています(8 節)。
振り返ると、試しの条件は本番と 2 点で違いました。レポートを外したことと、スライスを一覧の数十枚に絞ったことです。2 位も、134 スライス中 44 枚だけを見せた最初の試しでは「画像は効かない」と出ました。そこで止めずに、レポートと全スライス・拡大図の約 277 枚を一緒に読ませ直し、0.942 を得ています。1 位も、決まった一覧では答えの出ない所見があるとして、LLM が見たい画像を求める形に移りました。
次にやること
同じ種類の課題にもう一度取り組むなら、変えることは 3 つです。
- LLM にレポートと MRI を枚数を絞らずに読ませ、見たいスライスを求められる形でラベルを作ります。2 位の場合、この工程は月 200 ドルの定額プランの利用枠 2 週分ほどでした。
- 膝の左右と向きを揃え、主催者の基準を満たすと確かめられる公開の膝 MRI で事前学習します。fastMRI は申請に所属機関が要るので、可否を先に主催者に確かめるつもりです。
- CV の正解も、画像まで読ませたラベルに替えます。レポートから作った正解の CV は、上位の単独モデルの並びを当てられませんでした(10 節)。
おわりに
この解法の進め方のうち、医用画像の外でも使えそうなのは次の 3 つです。
- 文書から LLM でラベルを作り、少数の正解で質を測る
- 決まった時間に収まるよう、推論を実測で組む
- 差の予測を先に書いてから、小さな差の採否を決める
主催の RSNA と Kaggle、正解を付けた放射線科医の方々、解法やノートを公開した方々に感謝します。初期の教師には公開のレポートラベル表とノートの OOF 予測を使わせていただきました。似た課題に取り組む方の参考になれば幸いです。