
例外もログも出ないまま、外部 API の結果が「0件」になり続けていたことはありますか。
日本株のAI銘柄スクリーニング&継続学習端末「ALPHA FORGE(アルファフォージ)」を個人で開発・運用しています(開発には Claude Code を使っています)。ニュースの取得には yfinance を使っていますが、あるとき全銘柄でニュースが0件になっていることに気づきました。この記事では、原因になった2つの問題(応答の形の変化と、アクセス遮断時の空リスト)と、その対策をまとめます。
【要約】
- yfinance の
Ticker(...).newsの各アイテムで、titleなどが直下からcontentの中へ移っていた。item.get("title", "")が空文字を返し、全件が捨てられていた - 対策は、ニュース1件の読み取りを取り出し関数にまとめ、新旧どちらの形でも読めるようにすること。両方の形をテストで固定した
- Yahoo が HTTP 999 で遮断すると、yfinance は例外を出さず空リストを返す。ERROR ログを
logging.Handlerで検知して専用の例外にし、「取得失敗」と「0件」を区別した
※本記事はnote連載[ALPHA FORGE 開発秘話 #07] の技術的な部分を、エンジニア向けに再構成したものです。
環境
| 項目 | 内容 |
|---|---|
| OS | Windows 11 |
| 開発 | Claude Code(CLI) |
| バックエンド | Python 3.11 / FastAPI / Celery + Redis |
| データ取得 | yfinance(ニュース・株価) |
問題1:全銘柄でニュースが0件になっていた
何が起きたか
時系列は次のとおりです。
- 9/18 朝:ニュース見出しを LLM に読ませて、ポジティブ/ネガティブと影響度をスコア化する機能を追加した
- 同日:テストのあと実データで動かしたところ、全銘柄でニュースが0件だった。1銘柄ならまだしも、全銘柄が0件なのは不自然
- 同日:AI(Claude Code)が応答を1件ずつ調べ、yfinance の応答の形が変わっていることを突き止めた。修正と新機能を同じ日に反映した
以前からあったキーワード方式のニュース分析も、同じ理由で材料が無い状態でした。例外もログも出ていなかったため、いつから0件だったのかはわかっていません。
原因:フィールドが content の中へ移っていた

データの形が変わり、エラーも出ないまま全銘柄が「ニュース0件」になっていた
{"title": "...", "publisher": "...", "link": "...", "providerPublishTime": 1760000000}
{
    "content": {
        "title": "...",
        "provider": {"displayName": "..."},
        "canonicalUrl": {"url": "..."},
        "pubDate": "2026-09-18T08:00:00Z",
    }
}
取得処理は旧形式の場所を見ていたので、タイトルは常に空文字になり、「タイトルが無いニュースは使わない」というルールで全件が捨てられていました。
for item in raw_news[:max_items]:
    title = item.get("title", "")
    if not title:
        continue
dict.get(key, "") の既定値と「空なら捨てる」の組み合わせは、上流の形が変わったときに例外ではなく静かな0件になります。「値が空」と「項目がそもそも無い」を区別できない点に注意してください。
対策:取り出し関数で新旧両方を読む
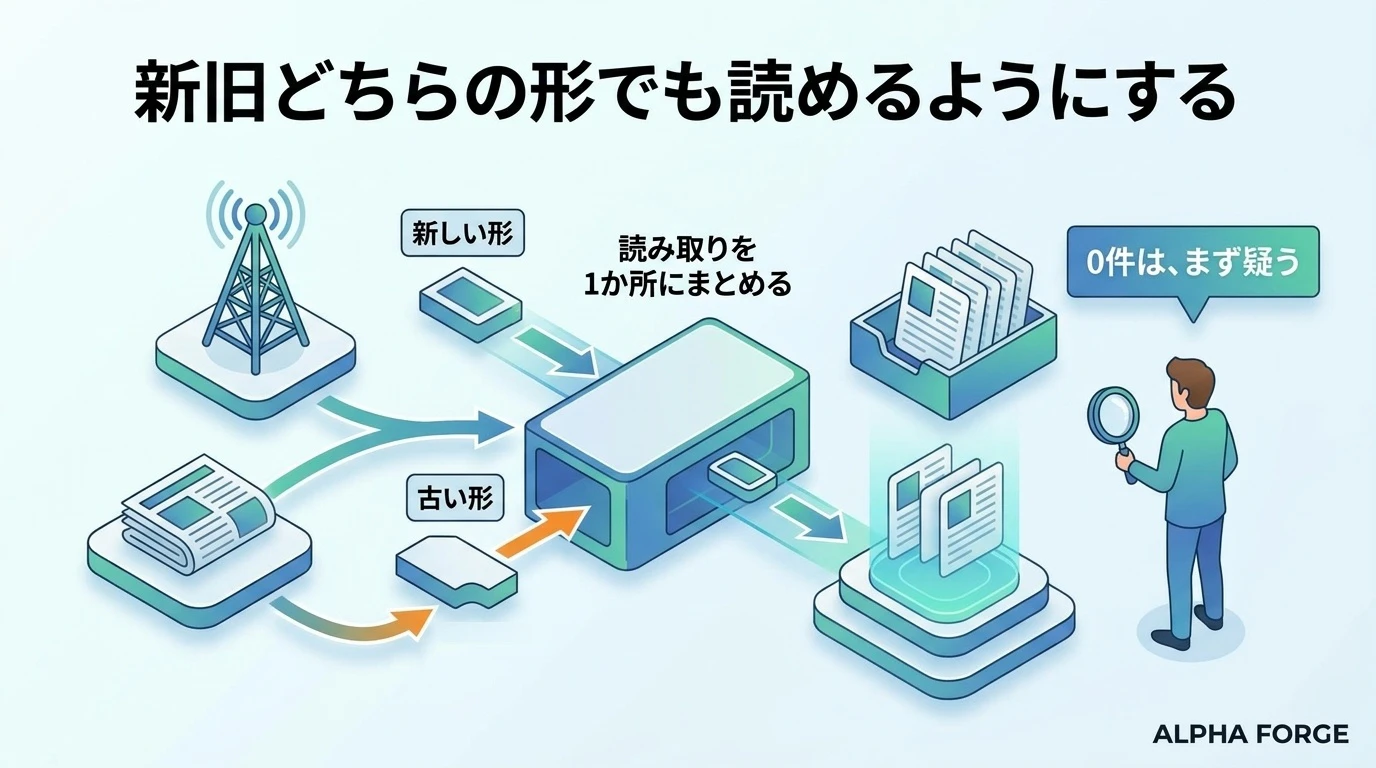
読み取りを1か所にまとめ、新旧どちらの形でも読めるようにした
ニュース1件の読み取りを小さな関数に集め、新形式を先に、無ければ旧形式を読むようにしました(実際のコミットからの抜粋)。
def _extract_content(item: dict[str, object]) -> dict[str, object]:
    """yfinance ニュース1件の実データを取り出す(新形式は `content` にネスト、旧形式は直下)."""
    content = item.get("content")
    return content if isinstance(content, dict) else item


def _extract_source(content: dict[str, object]) -> str:
    provider = content.get("provider")
    if isinstance(provider, dict):
        name = provider.get("displayName")
        if isinstance(name, str) and name:
            return name
    publisher = content.get("publisher")
    return publisher if isinstance(publisher, str) else ""


def _extract_published(content: dict[str, object]) -> str:
    pub_date = content.get("pubDate")
    if isinstance(pub_date, str) and pub_date:
        try:
            parsed = datetime.datetime.fromisoformat(pub_date.replace("Z", "+00:00"))
        except ValueError:
            pass
        else:
            return parsed.strftime("%Y-%m-%d %H:%M")
    pub_ts = content.get("providerPublishTime") or content.get("publishedTime")
    if isinstance(pub_ts, (int, float)) and not isinstance(pub_ts, bool):
        return datetime.datetime.fromtimestamp(pub_ts, tz=datetime.UTC).strftime("%Y-%m-%d %H:%M")
    return ""
呼び出し側は、ループの先頭で item = _extract_content(raw_item) とするだけです。URL も canonicalUrl.url → clickThroughUrl.url → link の順に読んでいます。
ポイントは次の3つです。
- 読み取りを1か所に集める:外部データの形の知識をあちこちに散らさない。形が変わったときに直す場所が1つで済む
- 旧形式を捨てない:ライブラリのバージョンや取得経路によって、どちらの形が返ってきても動くようにする
-
isinstanceで型を確かめる:dict[str, object]のまま受け、strやdictであることを確かめてから使う。想定外の型は空文字として扱う
テストは、新形式のデータで件数・配信元・URL・日時が取れることと、旧形式のデータでも取れることの両方を用意しています。
def test_get_news_sentiment_supports_legacy_flat_format(monkeypatch: pytest.MonkeyPatch) -> None:
    """🔧 旧フラット形式(`content` ネスト無し)も引き続き解釈できること(後方互換)."""
    news: list[dict[str, object]] = [
        {"title": "増益で急騰、最高値更新", "publisher": "X", "link": "u1", "providerPublishTime": 1_760_000_000}
    ]

    class FakeTicker:
        def __init__(self, _s: str) -> None:
            self.news = news

    monkeypatch.setattr(sa.yf, "Ticker", FakeTicker)
    monkeypatch.setattr(sa.stock_cache, "get_json", lambda _k: None)
    monkeypatch.setattr(sa.stock_cache, "set_json", lambda *_a, **_k: None)

    out = sa.get_news_sentiment("7203")
    assert out["total"] == 1
    assert out["news"][0]["source"] == "X"
    assert out["news"][0]["url"] == "u1"
問題2:遮断されると空リストが返り、「0件」として記録された
何が起きたか
9/26、特徴量を日付ごとに記録する台帳(予測時点で確定していた情報だけを残すためのもの)に、ニュース件数0の行が大量に書かれていることがわかりました。
待ち時間なしで全銘柄のニュースを取りに行ったところ、約200銘柄目から Yahoo が HTTP 999(Request denied)を返すようになっていました。このとき yfinance は例外を投げず、ERROR ログを出して空リストを返します。そのため、「取得に失敗した」が「ニュースは0件だった」として記録されていました。
対策:ログを検知して専用の例外にする
class NewsFetchError(RuntimeError):
    """ニュースを取得できなかった(「ニュースが 0 件だった」とは区別する)."""


class _NewsFailureDetector(logging.Handler):
    """このスレッドで出た yfinance のニュース取得失敗ログを検知する."""

    def __init__(self) -> None:
        super().__init__(level=logging.ERROR)
        self._thread_id = threading.get_ident()
        self.detected = False

    def emit(self, record: logging.LogRecord) -> None:
        if record.thread == self._thread_id and _YF_NEWS_FAILURE_MARKER in record.getMessage():
            self.detected = True


def _fetch_raw_news(jt: str) -> list[dict[str, object]]:
    """yfinance からニュースを取得する。例外・遮断応答はどちらも `NewsFetchError` にする."""
    yf_logger = logging.getLogger("yfinance")
    yf_logger.disabled = False
    detector = _NewsFailureDetector()
    yf_logger.addHandler(detector)
    try:
        raw_news: list[dict[str, object]] = yf.Ticker(jt).news or []
    except Exception as e:
        raise NewsFetchError(f"{jt}: {e}") from e
    finally:
        yf_logger.removeHandler(detector)
    if detector.detected:
        raise NewsFetchError(f"{jt}: Yahoo がニュース要求を拒否しました(非 JSON 応答)")
    return raw_news
ハマりどころは2つありました。
-
スレッドで絞る:FastAPI からは
asyncio.to_threadで並行に呼ぶため、ロガーに差し込んだハンドラには他のスレッドのログも届きます。record.threadで自分のスレッドのログだけを見ています -
無効化されたロガーを戻す:Alembic の
env.pyなどが呼ぶlogging.config.fileConfigは、既定で既存のロガーを無効化します(disable_existing_loggers=True)。無効化されたロガーはハンドラを一切呼ばないので、検知が黙って効かなくなります。そのためyf_logger.disabled = Falseで戻しています
ライブラリが例外を出さずに空の結果を返す場合、呼び出し側からは「失敗」と「0件」が区別できません。ログを検知する方法は最後の手段ですが、fileConfig によるロガーの無効化や、並行実行時のログの混ざりに気をつけてください。
呼び出し元ごとに扱いを変える
get_news_sentiment に strict 引数を足し、呼び出し元によって扱いを分けました。
| 呼び出し元 | strict |
取得失敗時の扱い |
|---|---|---|
| 画面表示・銘柄抽出 |
False(既定) |
止めずに「ニュース0件・中立」として扱う |
| 台帳への収集処理 | True |
NewsFetchError を受け取り、その銘柄の行を書かない |
収集処理には、あわせて次の安全策も入れました。
- 銘柄間に0.5秒の待ち時間を入れる(設定値で変更可能)
- 連続20件の失敗で収集を打ち切る
- 失敗した件数・打ち切ったかどうかをタスクの結果に含める
汚れてしまった過去の行は、500銘柄ごとに「ニュースがあった件数」を日付どうしで比べて範囲を特定しました。取り直せる日は修正後のコードで取り直し、過去のニュースを遡って取れない日は削除しています。削除するかどうかは、AI が調べた範囲をもとに人間が決めました。
「0件」を見たら、まず疑う
2つの問題はどちらも、例外もテストの失敗も出ませんでした。見つかったきっかけは、実データで動かして、数字の不自然さに気づいたことです。
- 新機能はテストのあと、必ず実データで動かして数字を目で見る
- 「0件」「全部同じ値」「全部中立」は、まず疑う
- 外部データの読み取りは1か所にまとめて、形の変化を吸収する
- 「取れなかった」と「0件だった」は別の値(例外)で表す
まとめ
- yfinance のニュース応答は
contentの中へネストされる形に変わっていた。getの既定値と「空なら捨てる」の組み合わせで、全件が静かに捨てられた - 取り出し関数で新旧どちらの形も読めるようにし、両方の形をテストで固定した
- HTTP 999 で遮断されると yfinance は空リストを返す。ERROR ログを検知して
NewsFetchErrorを出し、「失敗」と「0件」を区別した - 記録に残すデータでは、失敗を0件として書かない
ニュースを材料に加えると決めたのは人間、データの形の変化を突き止めて直したのは AI、「実際に何件取れている?」と数字を疑い続けるのは人間、という分担でした。
次回は、LLM に「3つの価格」を決まった形で答えさせる、強制ツール呼び出しとサーバー側の検証について書きます。
☕ note.comで開発秘話と毎朝の検証ログを連載中
note.comでは、ALPHA FORGE の開発秘話と、毎朝のアルゴリズム検証ログを公開しています。
👉 元記事(note連載第7話):
【ALPHA FORGE 開発秘話 #07】ニュースが全銘柄0件だった日 ― APIの静かな仕様変更
免責事項
本記事は個人開発およびAIエージェントを活用したシステム開発の技術記録です。特定の銘柄の売買推奨や投資助言を行うものではありません。本ツールは証券会社等への発注機能を持ちません。記事中のコードは抜粋であり、パスや環境固有の値は省略しています。外部ライブラリの仕様は記事作成時点のものです。
⚠️ 【システム検証記録に関する免責事項・注意事項】
- 本記事は、独自開発アルゴリズム「ALPHA FORGE」の動作検証およびデータ分析過程を公開する技術・運用の個人的な記録ログです。
- 掲載されているすべてのデータ(各スコア、基準観測値、統計的変動上限、シナリオ無効化水準など)は、過去の市場データに基づき数式(ATR等)により機械的に算出されたバックテスト・シミュレーション用のパラメータであり、特定の有価証券の売買勧誘、取引の推奨、投資助言・代理行為を目的としたものではありません。
- また、将来の株価変動や運用成果を保証するものではありません。実際の投資判断および最終決定は、必ずご自身の責任と判断において行っていただけますようお願いいたします。