
バックテストの成績が良すぎるとき、まず疑うのは「過去のデータに、未来の情報が混ざっていないか」です。この種の間違いはエラーになりません。コードは普通に動き、検証の成績はむしろ良くなります。
日本株のAI銘柄スクリーニング&継続学習端末「ALPHA FORGE(アルファフォージ)」を個人で開発・運用しています(開発には Claude Code を使っています)。この記事では、学習に財務やニュースの情報を足そうとして、上書き更新されるデータが先読みの偏り(lookahead bias)を起こす構造に気づき、ポイント・イン・タイム(PIT)台帳と pandas.merge_asof で防いだ件をまとめます。
【要約】
- 上書き更新される銘柄メモを、過去の日付の学習行へそのまま結び付けると、未来の情報が混ざる。エラーにならず、検証の成績はむしろ良く見える
- 「その日に分かっていた値」を日付つきで積み上げる台帳を別に持ち、結合は
merge_asofのdirection="backward"に任せて、未来の記録が結び付くこと自体をできなくした。テストでも固定した - 台帳を学習に使い始める条件は、被覆率ゲート(120営業日・70%)と opt-in(既定 OFF)で決めた。足したデータが効くかは、ソースアブレーションで測る
※本記事はnote連載[ALPHA FORGE 開発秘話 #10] の技術的な部分を、エンジニア向けに再構成したものです。
環境
| 項目 | 内容 |
|---|---|
| 開発 | Claude Code(CLI) |
| バックエンド | Python 3.11 / FastAPI / Celery + Redis |
| データ処理・学習 | pandas 3.0 / XGBoost |
| 保存先 | SQLite + Alembic |
| 学習の単位 | 日付×銘柄コードの行(断面パネル) |
何が問題だったか
ALPHA FORGE の機械学習モデルは、毎日の予測と、その後の実際の値動きを材料に学び直しています。ただ、学習に使っていた特徴量は、株価から計算するテクニカル指標だけでした。銘柄ごとの財務の数値や、ニュースの良し悪しは、手元のメモ(Obsidian の銘柄ノート)にそろっているのに、学習には入れていなかったのです。
9月18日の朝、Claude Code にこう頼みました(要旨)。
この実装にくわえ、銘柄のニュースや四季報の情報などを組み合わせて、モデル学習で精度をあげていきたい。実装との突き合わせを行い、ドキュメントを更新して、実装プランを考えてください
突き合わせで分かったことは3つです。
- 学習に使う特徴量は、テクニカル指標だけだった
- 予測を記録するとき、判断の材料にした生の数値を残していなかった
- 銘柄ノートは、新しい決算が出るたびに上書き更新される。過去のある日に、どんな値が書かれていたかを復元できない

上書き更新されるメモを過去の日付の行に結び付けると、その時点ではまだ知らなかった値が混ざる
3つ目が問題です。学習では「3か月前のこの日に、この銘柄はこうだった。そのあと株価はこう動いた」という行をたくさん作ります。ここへ銘柄ノートの財務の数値を結び付けると、3か月前の行に「今日の時点の数値」が入ります。その数値には、3か月前にはまだ発表されていなかった決算が反映されているかもしれません。
先読みの偏りのやっかいな点は、コードが普通に動くことです。検証の成績はむしろ上がるので、気づかないまま本番に出すと、「検証では良かったのに」という形で表に出ます。
対処1:PIT 台帳で「その日の値」を積み上げる
上書きされるメモとは別に、「その日に分かっていた値」を日付つきで積み上げる台帳を作りました。財務の数値とニュースの良し悪しを、毎日その日の日付で記録し、上書きはしません。
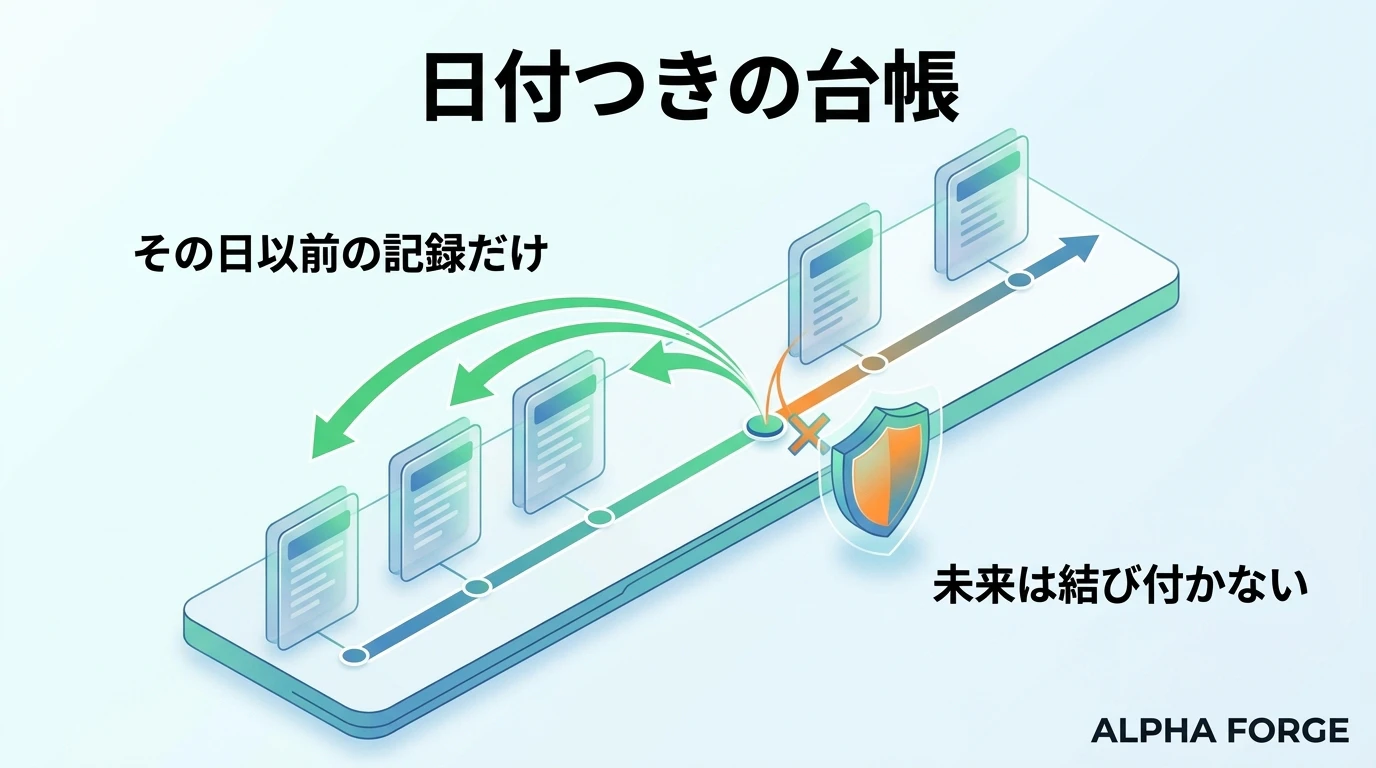
日付つきで値を積み上げる台帳を作り、学習する日より前の記録だけを結び付けるようにした
台帳に持たせている財務の値は、たとえば次の列です(FUNDAMENTAL_VALUE_COLS)。
FUNDAMENTAL_VALUE_COLS: tuple[str, ...] = (
    "per_forecast",
    "pbr",
    "roe",
    "equity_ratio",
    "dividend_yield_forecast",
    "eps_forecast",
    "bps",
    "market_cap_oku",
)
対処2:結合は merge_asof に任せる
台帳の値を学習の行へ結び付けるとき、独自の突き合わせを書くと、日付の比較を1か所でも間違えれば未来が混ざります。そこで、pandas.merge_asof の direction="backward" を必ず使うことにしました。backward は、左側の日付を超える右側の行とはマッチしないことをライブラリが保証します。
モジュールの説明にも、「この結合の唯一かつ絶対の不変条件」として、snapshot_date <= date の直近の行だけを結合してよいことを書いています。
merged = pd.merge_asof(
    left,
    right[["_snapshot_ts", "code", *value_cols]],
    left_on="_date_ts",
    right_on="_snapshot_ts",
    by="code",
    direction="backward",  # 🔒 未来の snapshot と絶対にマッチしない(本モジュールの核心不変条件)
    tolerance=pd.Timedelta(days=_tolerance_calendar_days(tolerance_bdays)),
)
補足です。
-
merge_asofは、左右のキーがソート済みであることを前提にします。実装ではmergesortで並べ直し、結合後に_row_posで元の行順へ復元しています -
toleranceは「何日前までの記録なら結び付けてよいか」の上限で、設定は営業日5日(PIT_ASOF_TOLERANCE_BDAYS)です。merge_asofは暦日でしか指定できないため、営業日を暦日に少し多めに換算しています。古すぎる記録を弾き損ねる方向にだけ働き、未来を跨ぐ方向には働きません - 結合した行には、記録が何日前のものかを示す
staleness_daysと、結合できたかの 0/1 フラグ(has_pit_*)を付けます。欠損そのものも情報として、XGBoost が使えるようにしています
この不変条件は、テストで固定しました。
await _upsert_fund(snapshot_date="2026-01-10", code="7203", per_forecast=99.0)  # 未来(学習行より後)

panel = _panel([("2026-01-05", "7203")])
out = await pfs.attach_pit_fundamental_features(panel, tolerance_bdays=_TOLERANCE)

assert out.loc[0, "has_pit_fundamental"] == 0
assert pd.isna(out.loc[0, "per_forecast"])
学習行(1月5日)より後の日付にしか記録が無ければ、結合されず欠損のままです。「気をつける」ではなく、「間違えられない」形にしました。
この結合は先読みを防ぎますが、台帳の値が正しいことまでは保証しません。値が間違って書かれる事故は、別の方法で防ぐ必要があります(後述)。
足したデータが効いているかを測る
情報源を足したとき、それが精度に効いているかを測る仕組みも入れました。情報源のグループを1つずつ外して学習し直し、ホールドアウトの成績がどれだけ変わるかを比べる、ソースアブレーション評価です(ablation_service の run_source_ablation)。足したデータが効いていなければ、効いていないと分かります。
使い始める条件:被覆率ゲート
台帳は、作ってすぐには役に立ちません。値が貯まるまで待つ必要があるため、「どれだけ貯まったら学習に使い始めるか」の基準を決めました。
| 項目 | AIの推奨 | 採用した値 |
|---|---|---|
| 必要な営業日数 | 60営業日 | 120営業日 |
| 欠けていない割合 | 50%以上 | 70%以上 |
最初に学習へ入れるデータは安定したものにしたかったため、人間の判断で厳しくしました。学習への投入自体も、明示的に有効にするまで動かないようにしています。
# 学習パネルへの PIT 列投入そのものの opt-in(既定 OFF、台帳が貯まるまで明示的に有効化しない)。
pit_features_enabled: bool = Field(default=False, validation_alias="PIT_FEATURES_ENABLED")
pit_min_coverage_days: int = Field(default=120, validation_alias="PIT_MIN_COVERAGE_DAYS", ge=1)
pit_min_coverage_ratio: float = Field(default=0.7, validation_alias="PIT_MIN_COVERAGE_RATIO", ge=0.0, le=1.0)
ニュースの良し悪しを集める範囲も、AI の推奨は「候補になりそうな銘柄と保有銘柄に絞る」でしたが、東証の全銘柄に広げました(PIT_SENTIMENT_SCOPE の既定は universe)。取得先の制限にかかる心配はあっても、学習に使える銘柄が多いほうを選びました。
後日談:台帳には「間違った値を混ぜない」ことも必要だった
全銘柄に広げた判断は、のちに事件につながりました。取得先から一時的にアクセスを断られ、「取れなかった」が「ニュースは0件」として台帳に書き込まれていたのです。学習にはまだ使っていなかったので実害はなく、台帳の一部を消して取り直しました。
台帳は、「未来を混ぜない」だけでなく、「失敗を正常値として書かない」ことも守る必要があります。取得に失敗したのか、本当に0件だったのかを、区別して記録する設計が要ります。
いまも、台帳の値は学習に入れていません。120営業日分が貯まるのを待っている状態です。
プロンプトの学び:「作って」の前に「突き合わせて」
最初の依頼に「実装との突き合わせを行い、ドキュメントを更新して、実装プランを考えて」と入れたのが効きました。いきなり「ニュースと財務も学習に入れて」と頼んでいたら、Claude Code は素直に、銘柄ノートの今の値を学習の行へ結び付けるコードを書いたかもしれません。コードは動き、検証の成績は上がり、誰も気づかなかったでしょう。
新しいデータを足すときは、次の3つを1つの依頼に入れています。
- 実装との突き合わせ(今どうなっているかを先に調べさせる)
- ドキュメントの更新(見つけたことを設計書に残させる)
- 実装プラン(作る前に、作り方の案を出させる)
まとめ
- 上書き更新される情報を、過去の日付の学習行へそのまま結び付けると、未来の情報が混ざる。エラーにならず、検証の成績はむしろ良く見える
- 「その日に分かっていた値」を日付つきで積み上げる台帳を別に持つ
- 結合は
merge_asofのdirection="backward"に任せ、未来の記録が結び付かないことをテストで固定する - 使い始める条件(被覆率ゲート)と opt-in を決め、貯まるまでは学習に入れない。足したデータが効くかはソースアブレーションで測る
- 結合は値の正しさを保証しない。取得失敗を0件として書く事故は、別途防ぐ
ニュースと財務の情報を足したいという方針、被覆率ゲートを厳しくすること、集める範囲を全銘柄に広げることを決めたのは人間です。実装と突き合わせて上書きによる穴を見つけ、台帳・結合・評価を設計・実装したのは Claude Code でした。
次回は、四季報の自動取得を「辞退」した話です。技術的にできることと、やってよいことは別だった、という話を書きます。
☕ note.comで開発秘話と毎朝の検証ログを連載中
note.comでは、ALPHA FORGE の開発秘話と、毎朝のアルゴリズム検証ログを公開しています。
👉 元記事(note連載第10話):
【ALPHA FORGE 開発秘話 #10】「未来のカンニング」を構造で防ぐ ― ポイント・イン・タイム台帳
免責事項
本記事は個人開発およびAIエージェントを活用したシステム開発の技術記録です。特定の銘柄の売買推奨や投資助言を行うものではありません。本ツールは証券会社等への発注機能を持ちません。記事中のコードは抜粋であり、パスや環境固有の値は省略しています。紹介した方法は、あらゆるデータの偏りを防げることを保証するものではありません。
⚠️ 【システム検証記録に関する免責事項・注意事項】
- 本記事は、独自開発アルゴリズム「ALPHA FORGE」の動作検証およびデータ分析過程を公開する技術・運用の個人的な記録ログです。
- 掲載されているすべてのデータ(各スコア、基準観測値、統計的変動上限、シナリオ無効化水準など)は、過去の市場データに基づき数式(ATR等)により機械的に算出されたバックテスト・シミュレーション用のパラメータであり、特定の有価証券の売買勧誘、取引の推奨、投資助言・代理行為を目的としたものではありません。
- また、将来の株価変動や運用成果を保証するものではありません。実際の投資判断および最終決定は、必ずご自身の責任と判断において行っていただけますようお願いいたします。