
AIが読める情報を全部記事にしてはいけない――Obsidianから公開できるナレッジだけを切り出した話
昨日、私は実際のObsidian VaultをAIに確認してもらい、そこに蓄積している記録からQiitaの記事を作りました。
公開したのは、次の記事です。
AIとの会話を流さない――Obsidianへ蓄積した自分のナレッジを記事にする
記事では、総合ハブ、AIごとの進捗ノート、日々メモ、inboxなど、私が実際に使っている記録の構造を紹介しました。
ただし、Obsidianの中には公開してよい情報だけが入っているわけではありません。共通のナレッジと、個別の案件に関する記録が、同じVaultの中にあります。
AIがファイルを読める状態だからといって、その内容を記事に使ってよいとは限りません。
今回は、昨日の記事制作で実際に行った確認を振り返りながら、AIがアクセスできる情報から、公開できるナレッジだけを切り出した方法を記録します。
「読める」と「公開してよい」は別だった
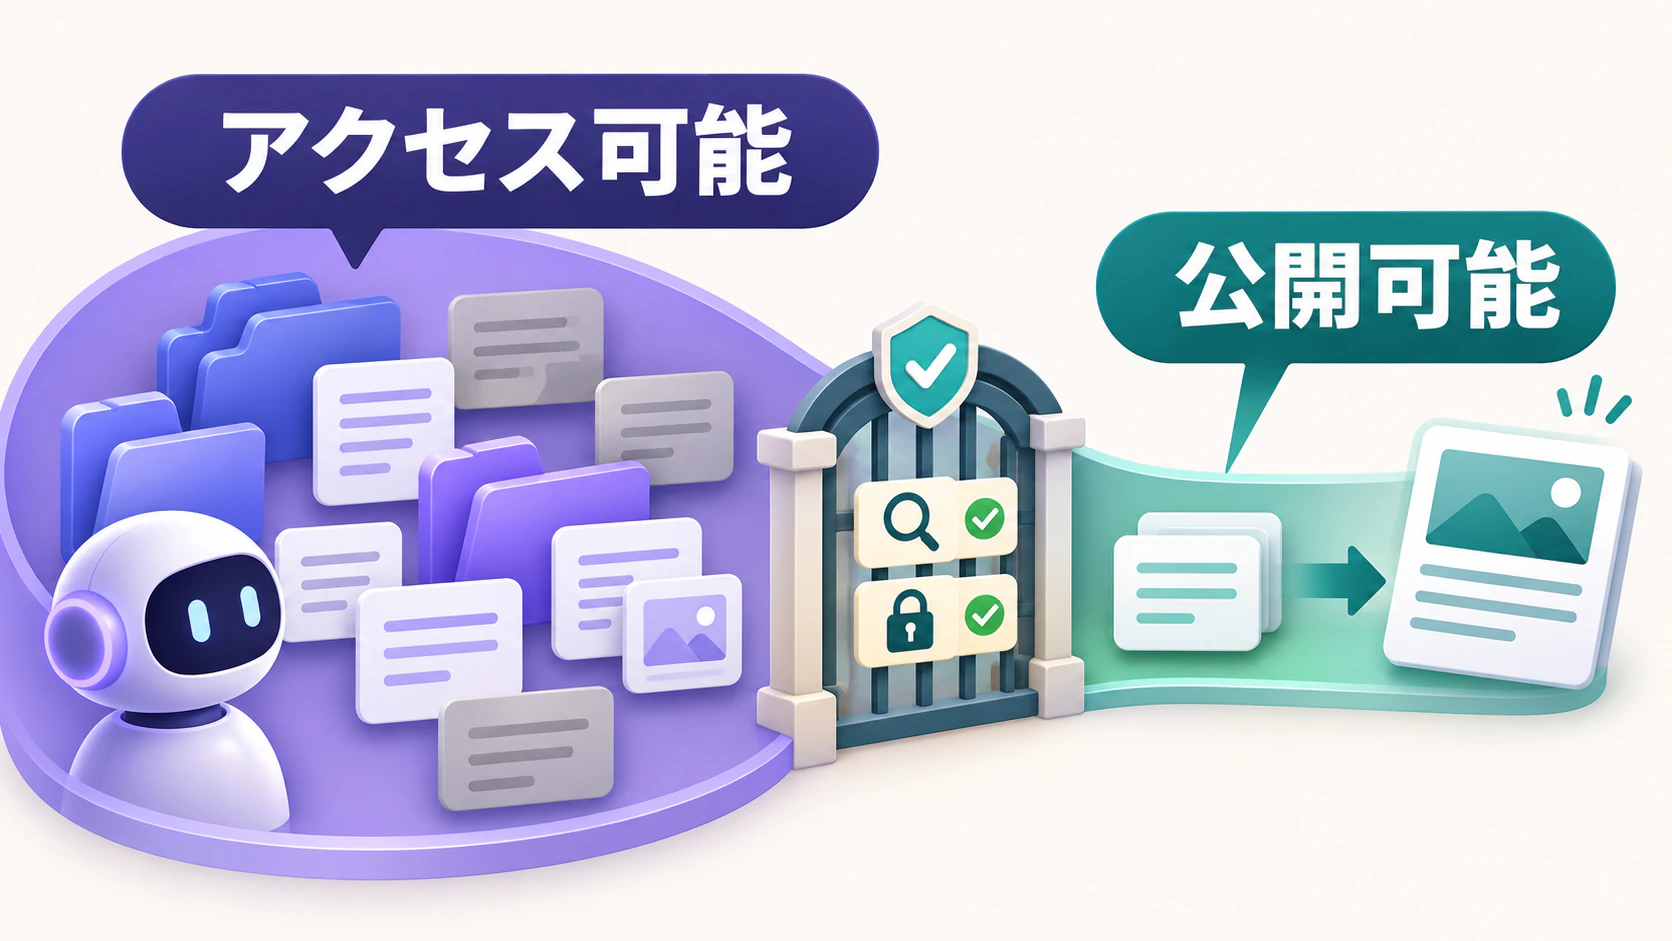
昨日、AIは最初にObsidianの全体構造を確認しました。
そこで分かったのは、記事のテーマに使える共通ノートだけでなく、記事へ持ち出してはいけない個別情報も同じVaultに存在することです。
ここで、次の2つを分ける必要がありました。
AIが技術的にアクセスできる
AIが記事制作に使ってよい
この2つは同じではありません。
ファイルを開けることは、公開の許可ではありません。自分のObsidianであっても、個別案件、会話の記録、認証に関わる情報、公開前の判断などは、そのまま外へ出せません。
昨日の記事で必要だったのは、個別の内容ではなく、記録を残している構造でした。
そのため、AIが見つけた情報をすべて材料にするのではなく、テーマに必要な共通部分へ範囲を狭めました。
先に「何を記事にするか」を決めた
今回の境界を作るうえで役立ったのは、ファイルを読む前に記事のテーマが決まっていたことです。
昨日のテーマは、次の内容でした。
AIとの会話や進捗をObsidianへどう残しているか
その記録を自分のナレッジとしてどう記事にするか
このテーマなら、必要なのは個別案件の成果や詳しい進捗ではありません。
必要なのは、次のような共通構造です。
- Vault全体の入口
- AI共通の進捗共有
- AIごとの管理ノート
- 更新日や状態を持つプロパティ
- 日付ごとのメモ
- 未整理情報を一時的に置くinbox
テーマを先に決めることで、「興味深いから読む」ではなく、「記事に必要だから確認する」という選び方ができました。
これは、情報を隠すためだけの作業ではありません。記事の焦点を保つための作業でもありました。
実際に使ったのは共通ノートと構造だけ
昨日の記事で確認した主な範囲は、総合ハブとAI共通用ナレッジ、日々メモの入口です。
記事へ使ったのは、次のような事実でした。
| 確認したもの | 記事へ使った情報 |
|---|---|
| 総合ナレッジハブ | どの入口へ移動できるか |
| 進捗共有ノート | 全体の現在地をどう残すか |
| AIごとの進捗ノート | 担当、状態、更新日の持ち方 |
| Basesの設定 | 更新日の差を一覧で見る構造 |
| 日々メモ | 日付ごとの記録が存在すること |
| inbox | 未整理情報の受け皿が存在すること |
反対に、個別案件の内容、成果、数値、会話記録は記事の材料にしませんでした。
ここで意識したのは、内容ではなく構造を使うことです。
たとえば、進捗ノートから「どの案件がどこまで進んだか」を取り出すのではなく、次の項目があることだけを確認しました。
type: ai-status
agent: AIの名前
role: 担当する役割
updated: 最終確認日
status: 現在の状態
これなら、Obsidianでどのように記録を整理しているかは説明できますが、個別の仕事の中身は公開しません。
アクセス・引用・公開を3段階に分けた

昨日の作業を振り返ると、情報の扱いには3つの段階がありました。
1. アクセスできる
AIがファイルの存在や内容を確認できる状態です。
これは技術的な範囲を示すだけで、記事への使用許可を意味しません。
2. 記事制作の参考にできる
記事のテーマに必要で、公開ルールにも反しない情報です。
ただし、参考にできても、その文章をそのまま引用するとは限りません。構造や更新日のように、必要な事実だけを抜き出す場合もあります。
3. 公開できる
Markdownの原稿へ入り、最終的に誰でも読める状態へ出せる情報です。
ここでは、個別情報が混ざっていないか、事実として確認できるか、本人が公開してよいと判断したかを確認します。
この3段階を同じものとして扱うと、AIは「見つけた情報」をそのまま「使える情報」だと解釈しやすくなります。
アクセス可能
  ↓  テーマとルールで絞る
記事制作の参考
  ↓  公開前に人が確認する
公開可能
AIに伝えるときも、「Vaultを読んで記事を書いて」だけでは範囲が広すぎます。
昨日の実態に近い依頼は、次の形です。
この記事のテーマは、AIとの記録をObsidianへ蓄積する方法です。
共通ノートの構造、プロパティ、更新日の事実だけを確認してください。
個別案件の内容、会話、成果、数値は記事へ使わないでください。
確認できない運用は、実施済みとして書かないでください。
公開してよい情報を4つの質問で絞った

昨日の作業を、今回あらためて4つの質問に整理しました。
質問1:この記事のテーマに必要か
テーマと関係がなければ、公開できる情報であっても使いません。
情報を増やすほど記事が詳しくなるとは限りません。関係のない事実が増えると、何を伝えたい記事なのかが分かりにくくなります。
質問2:個別の内容ではなく、共通化できる知識か
昨日の記事では、個別案件の進捗ではなく、進捗を残す項目やノートのつながりを使いました。
使わない:誰のどの仕事がどこまで進んだか
使う:担当・状態・更新日を持つノート構造
質問3:公開してはいけない情報を含まないか
原稿には、個別案件の固有名詞、認証情報、個人情報を入れません。
「一部をぼかせばよい」と判断する前に、その情報が記事に本当に必要かを考えます。必要でなければ、言い換えて残すのではなく、材料から外します。
質問4:実際に確認できた事実か
ノートに方針が書かれていても、実行されたとは限りません。
昨日の記事では、ファイルの存在、リンク構造、プロパティ、更新日は確認済みの事実として書きました。一方、すべてのAI会話が保存されていることや、inboxの内容が自動整理されていることは確認できなかったため、実施済みとは書きませんでした。
公開原稿をもう一度機械的に確認した
今日の記事を書く前に、昨日公開したMarkdownをもう一度確認しました。
プロジェクトのルールで公開を禁止している個別案件の固有名詞と、認証情報を示す語が、原稿へ残っていないかを検索しました。
確認結果は、どちらも0件でした。
個別案件の固有名詞:0件
認証情報を示す語:0件
もちろん、単語検索だけで安全性を完全に証明できるわけではありません。
名前を出さなくても、詳しい状況や数値の組み合わせから内容が推測できる場合があります。そのため、機械的な検索の前に、そもそも個別案件の内容を材料へ入れないという判断が必要です。
今回の順番は次のとおりです。
テーマを決める
共通ノートへ範囲を絞る
構造と確認済み事実だけを使う
個別情報を原稿へ入れない
最後に単語検索で取りこぼしを確認する
人が原稿を読んで公開を承認する
検索は最後の安全網であって、公開可否を決める唯一の方法ではありません。
AIに任せた部分と、人が決めた部分
昨日の記事制作では、AIに次の作業を任せました。
- Vaultの入口と共通ノートを探す
- ノート同士のリンクを整理する
- プロパティと更新日を比較する
- 記事に使える確認済み事実を抜き出す
- Markdownの下書きを作る
- 公開前の形式を検査する
一方、AIだけに任せなかったのは次の部分です。
- どの経験を記事のテーマにするか
- どこまでを自分のナレッジとして公開するか
- 個別情報を材料から外すこと
- 原稿が日々の実態に合っているか
- Qiitaへ全体公開してよいか
AIは、多くのファイルから共通点を見つける作業が得意です。しかし、アクセス権があることと、公開する意味があることは判断軸が違います。
最後の境界は、人が決める必要があります。
最初にAIへ渡す短い依頼文
Obsidianなどの個人用ナレッジから記事を作るなら、最初は次のように頼めます。
この記録から、今日の記事の材料を探してください。
テーマに必要な共通の方法と、確認済みの事実だけを使います。
個別案件、個人情報、認証情報、公開前の内容は使わないでください。
読める情報と公開してよい情報を分け、原稿へ入れた根拠を示してください。
最後の公開は、私が全文を確認してから行います。
大切なのは、AIへ「秘密を書かないで」とだけ伝えることではありません。
何をテーマにし、どの種類の情報だけを使い、何を材料から外すかまで伝えることです。
まとめ
昨日、Obsidianの記録から記事を作って分かったのは、AIが読める範囲と、公開してよい範囲は一致しないということです。
実際に行ったことは次のとおりです。
- 記事のテーマを先に決めた
- Vault全体から共通ノートへ範囲を絞った
- 個別の内容ではなく、ノートの構造とプロパティを使った
- 確認済みの事実と、文書に書かれただけの方針を分けた
- 個別案件の内容、成果、数値、会話記録を使わなかった
- 公開原稿に禁止対象の固有名詞や認証情報がないことを検索した
- 最後は人が全文を確認し、公開を承認した
AIへ広い範囲を見てもらうと、埋もれていた自分の経験を見つけやすくなります。
その一方で、見つけた情報を全部使う必要はありません。
最初の一歩は、AIへ記録を渡すときに、次の一文を加えることです。
読める情報と、記事として公開してよい情報を分けてください。
ナレッジを記事へ変える作業は、情報を増やすことだけではありません。公開しない情報を選び、残った事実に自分の経験として意味を与える作業でもあります。