
こんにちは! この記事は 前回 の続編です。
はじめに
前回 ESPERiC のデータ処理エンジンに Polars を使って ESPERiC データ処理エンジン と同等のことができないか? を 技術的な観点で PoC (実証実験) しました。その結果 ESPERiC データ処理エンジンには Polars にない機能があり、ESPERiC データ処理エンジンを Polars で完全に置き換えることはできませんでしたが、主要な機能は Polars で代替可能であることが分かりました。
本記事は 代替可能な範囲 (同じことが実現できる機能同士) で ESPERiC データ処理エンジン と Polars の データフレーム処理 の性能 (処理時間) 比較の結果と その評価です。
ベンチマーク
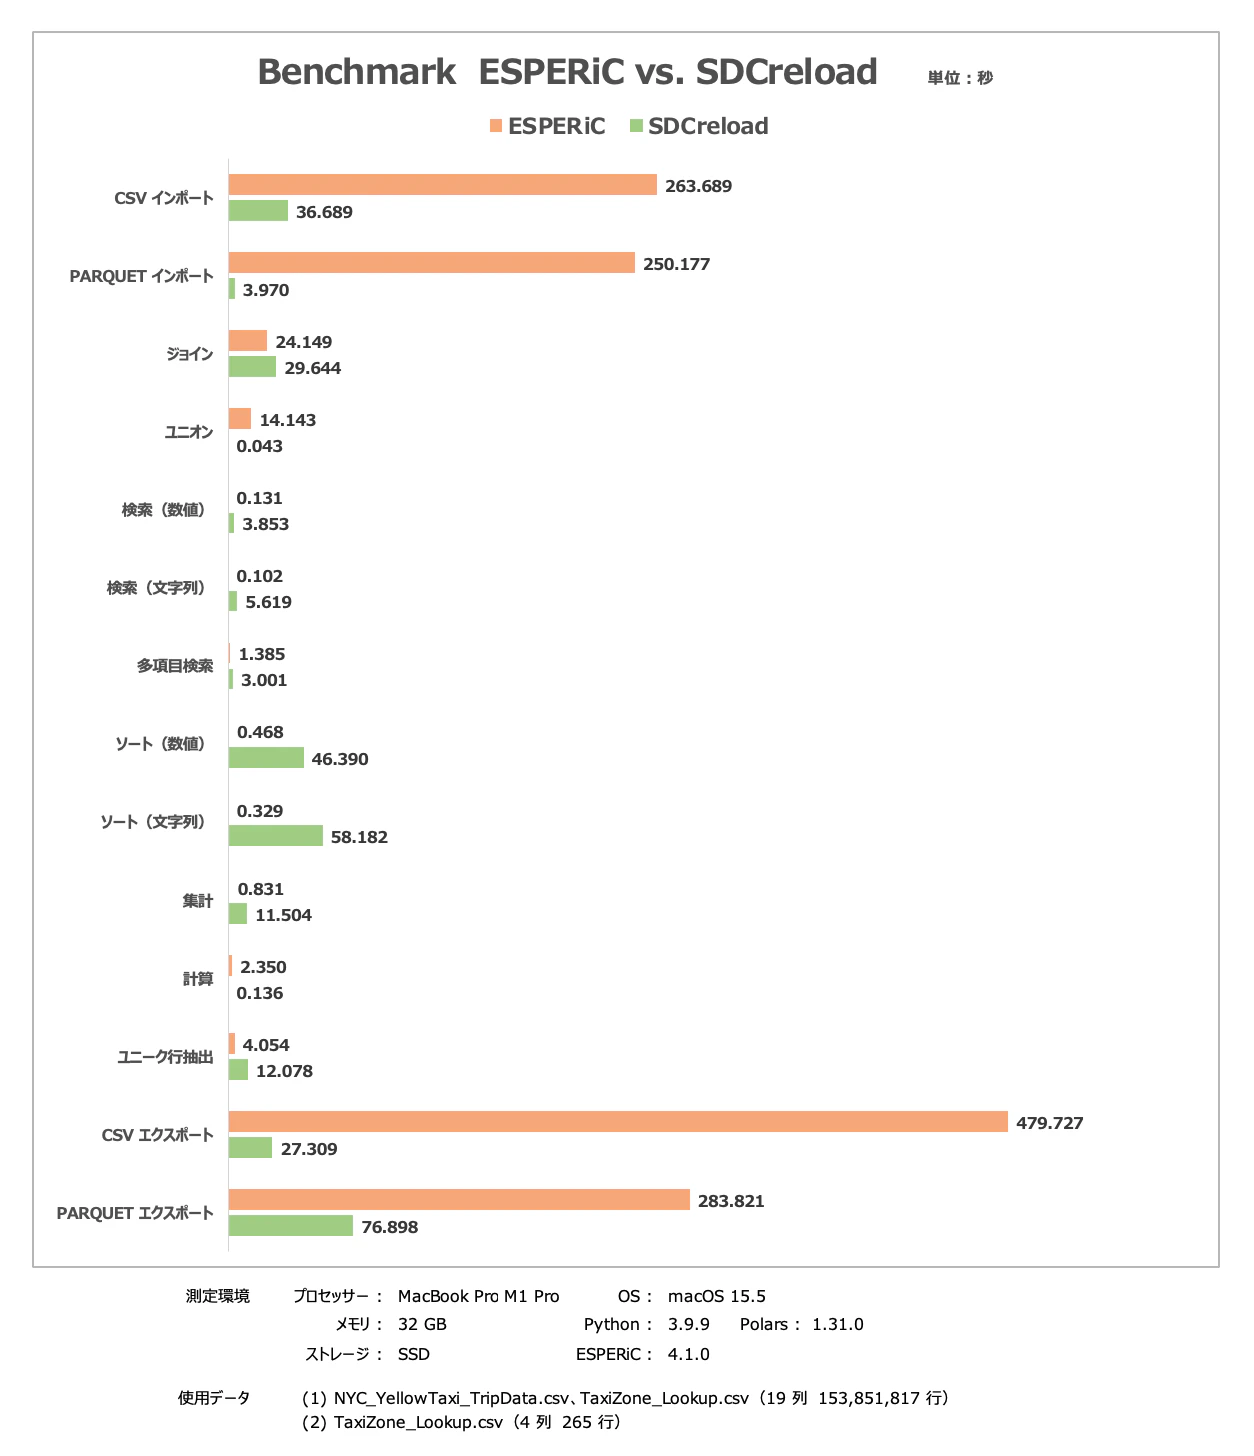
性能測定は ESPERiC 4.11 と SDCreload2 を使用しました。処理時間は 各機能の処理時間を3回測定し その平均値を採用しています。
性能測定の結果を下記のグラフで示します。 ESPERiC データ処理エンジン と SDCreload (Polars) が使用している技術の違い (後述) から 大まかな 傾向として...
- ESPERiCはインポートに時間がかかるが その後の処理は速い
- SDCreload はインポートは速いが その後の処理に時間がかかる
ESPERiCのデータ構造と速さの秘密
ESPERiC データ処理エンジン は「成分分解法」と呼ぶ 独自な技術を使用しており データインポート時に 表データを 下記の3つの1次元配列からなる テーブルを作成します。
-
数値データ/文字列データ
配列名 内容 備考 OrderSet 元データの並び順を表す順序集合 テーブル毎に1つ作成 VNo (ValueNumber) 値番号 (値リストの位置情報) カラム毎に作成 VL (ValueList) 値リスト (ユニーク、昇順) カラム毎に作成
データのタイプが異なる (数値/文字列) 場合でもテーブル構造は同じです。
大部分の機能は VNo (値番号) を操作するだけで良いので 処理時間が短くて済みます。さらに VL(値リスト) にはユニークな値のみ格納するので カーディナリティが低いデータは テーブルサイズが小さくなり 昇順にソートされているので 処理時間に良い影響を与えます。なお NULL (欠損値) は 特別な値 infinity が割り当てられ 値リストに格納されます。
上記グラフで ESPERiCの CSV エクスポートが PARQUETの 1.7倍 時間がかかっていますが 理由がわからず 説明できません。PARQUETで書き出す方が 時間はかかるはずです。
SDCreload (Polars) のデータ構造
SDCreload (Polars) のデータ構造は「Apache Arrow フォーマット」のテーブル (データフレーム) です。データタイプが数値か 文字列か によって 構造が 一部 異なっています。
下記に示す 1次元配列で 64バイト境界に配置し 64バイトの倍数になっています。これは 64ビットCPU での高速にアクセス と SIMD (Single Instruction Multiple Data) を活用するためです。また 欠損値を表す Validity bitmap があります。各ビットが対応する配列要素の有無を表しており 1 が値あり 0 が欠損値を表します。これは ESPERiC データ処理エンジン と 大きな違いです。
-
数値データ
配列名 内容 備考 Validity bitmap 欠損値を表すビット配列 カラム毎に作成 値配列 固定長の数値配列 (欠損値を含む) カラム毎に作成 -
文字列データ
配列名 内容 備考 Validity bitmap 欠損値を表すビット配列 カラム毎に作成 オフセット配列 連結済み文字列要素へのオフセット値 カラム毎に作成 文字配列 文字列データを連結したもの カラム毎に作成
Apache Arrow テーブル (データフレーム) は immutable (不変) であり 下記の特徴があリます。
- メモリ上に1つだけインスタンスを作っておき 参照だけで使い回せば良く コピーする必要がない
- 並列処理において 複数スレッドから同じインスタンスを参照しても競合が起きない
- 更新が多い処理には あまり 向いていない
上記グラフで SDCreload の ユニオン の時間が短いのは immutable の効果と思われます。
まとめ
ESPERiC データ処理エンジン と SDCreload (Polars) が使用している技術の違いが 各機能の性能 (処理時間) に大きく関係していることが分かりました。
ESPERiC データ処理エンジンは データインポートにコストをかけてでも 後の処理を速くする。爆速に近い。SDCreload (Polars) は インポートは速く 後の処理も そこそこ 速い。
今回 1億5,000万行のベンチマークデータを使用したので 性能差が顕著に出た可能性があります。通常の業務で使用する規模のデータであれば 操作上 目立つことはないと思います。
最後に 今回 性能測定項目に入れた「テーブルの全データを対象にしたソート機能は 使い途あり?」と疑問視しています。ソートが必要になるのは 例えば 下記の様な 抽出結果を取り出すケースで ソート対象のデータは多くない。
SELECT * FROM employees WHERE emp_no >= 10032 ORDER BY emp_no;
全データを対象にしたソート機能は 磁気テープ3を使用してデータ処理 (突き合わせ等) を行なっていた時代の名残りではないだろうか。
今回で PoC 記事は終わりです。最後まで お読み頂き ありがとうございました。