
こんにちは!
今回 初めて AIエージェントによるアプリの自動生成 (バイブコーディング) を試みたので その内容を記事にしました。今回は どの様なコードが生成されるか? の調査が主目的です。生成されたアプリが正しく実行されるか? までは 試していません。
はじめに
バイブコーディングするのは 以前の記事 PoC : Polarsでビッグデータハンドリングアプリ で 次の目標として掲げた「Polars + クールな GUI で データハンドリングアプリの製品化」を実現するための データラングリングアプリ です。名前は POLCA (POLars Cool Application) で 試用するAIエージェントは下記の2つです。
- Claude Code
- Vercel v0 (gpt-5 model)
Claude Code はプログラミング用の汎用AIアシスタントであるのに対し Vercel v0 は特定の技術スタック内でのUI生成とフロントエンド開発に特化したツールとのことです。
いずれも 無償で使える範囲で試しています。
本記事では AIエージェントの思考プロセスで出力されるメッセージを ほぼそのまま転記しています。転記部分は 文字が明るい茶色 です。また 長文は 折りたたんで タイトルだけ表示しています。 ▶︎ タイトルをクリックすれば 展開・折りたたみ できます。ブラウザーで 英文を日本語に翻訳しているので おかしな表現もありますが ご容赦下さい。
POLCA の機能要件
POLCA は フルスタックアプリで 機能要件は下記の通りです。
データ処理エンジンにPolarsを使用した クールなGUIの ビッグデータハンドリングアプリであり アプリ名は POLCA とする。
処理するデータは構造化されたもので 内容を高機能データグリッドライブラリで表示し オブジェクト指向のメニューからデータハンドリング操作を指示する。
フロントエンド (GUI) は ReactとTypescriptを使用し バックエンドはRust-Polarsを使用します。
実装する機能は以下のもの。
- CSVファイルのインポート/エクスポート
- Parquet ファイルのインポート/エクスポート
- ソート(昇順/降順)
- 検索/抽出
- 集計
- ジョイン(inner join/outer join)
- ユニオン
- 計算関数
- ピボットテーブル
- データプロファイリング
- サンプリング(25% 50% 75%)
Claude Code
サインイン後の 最初のプロンプトで POLCA の機能要件を入力します。Vercel v0 と同じ内容です。
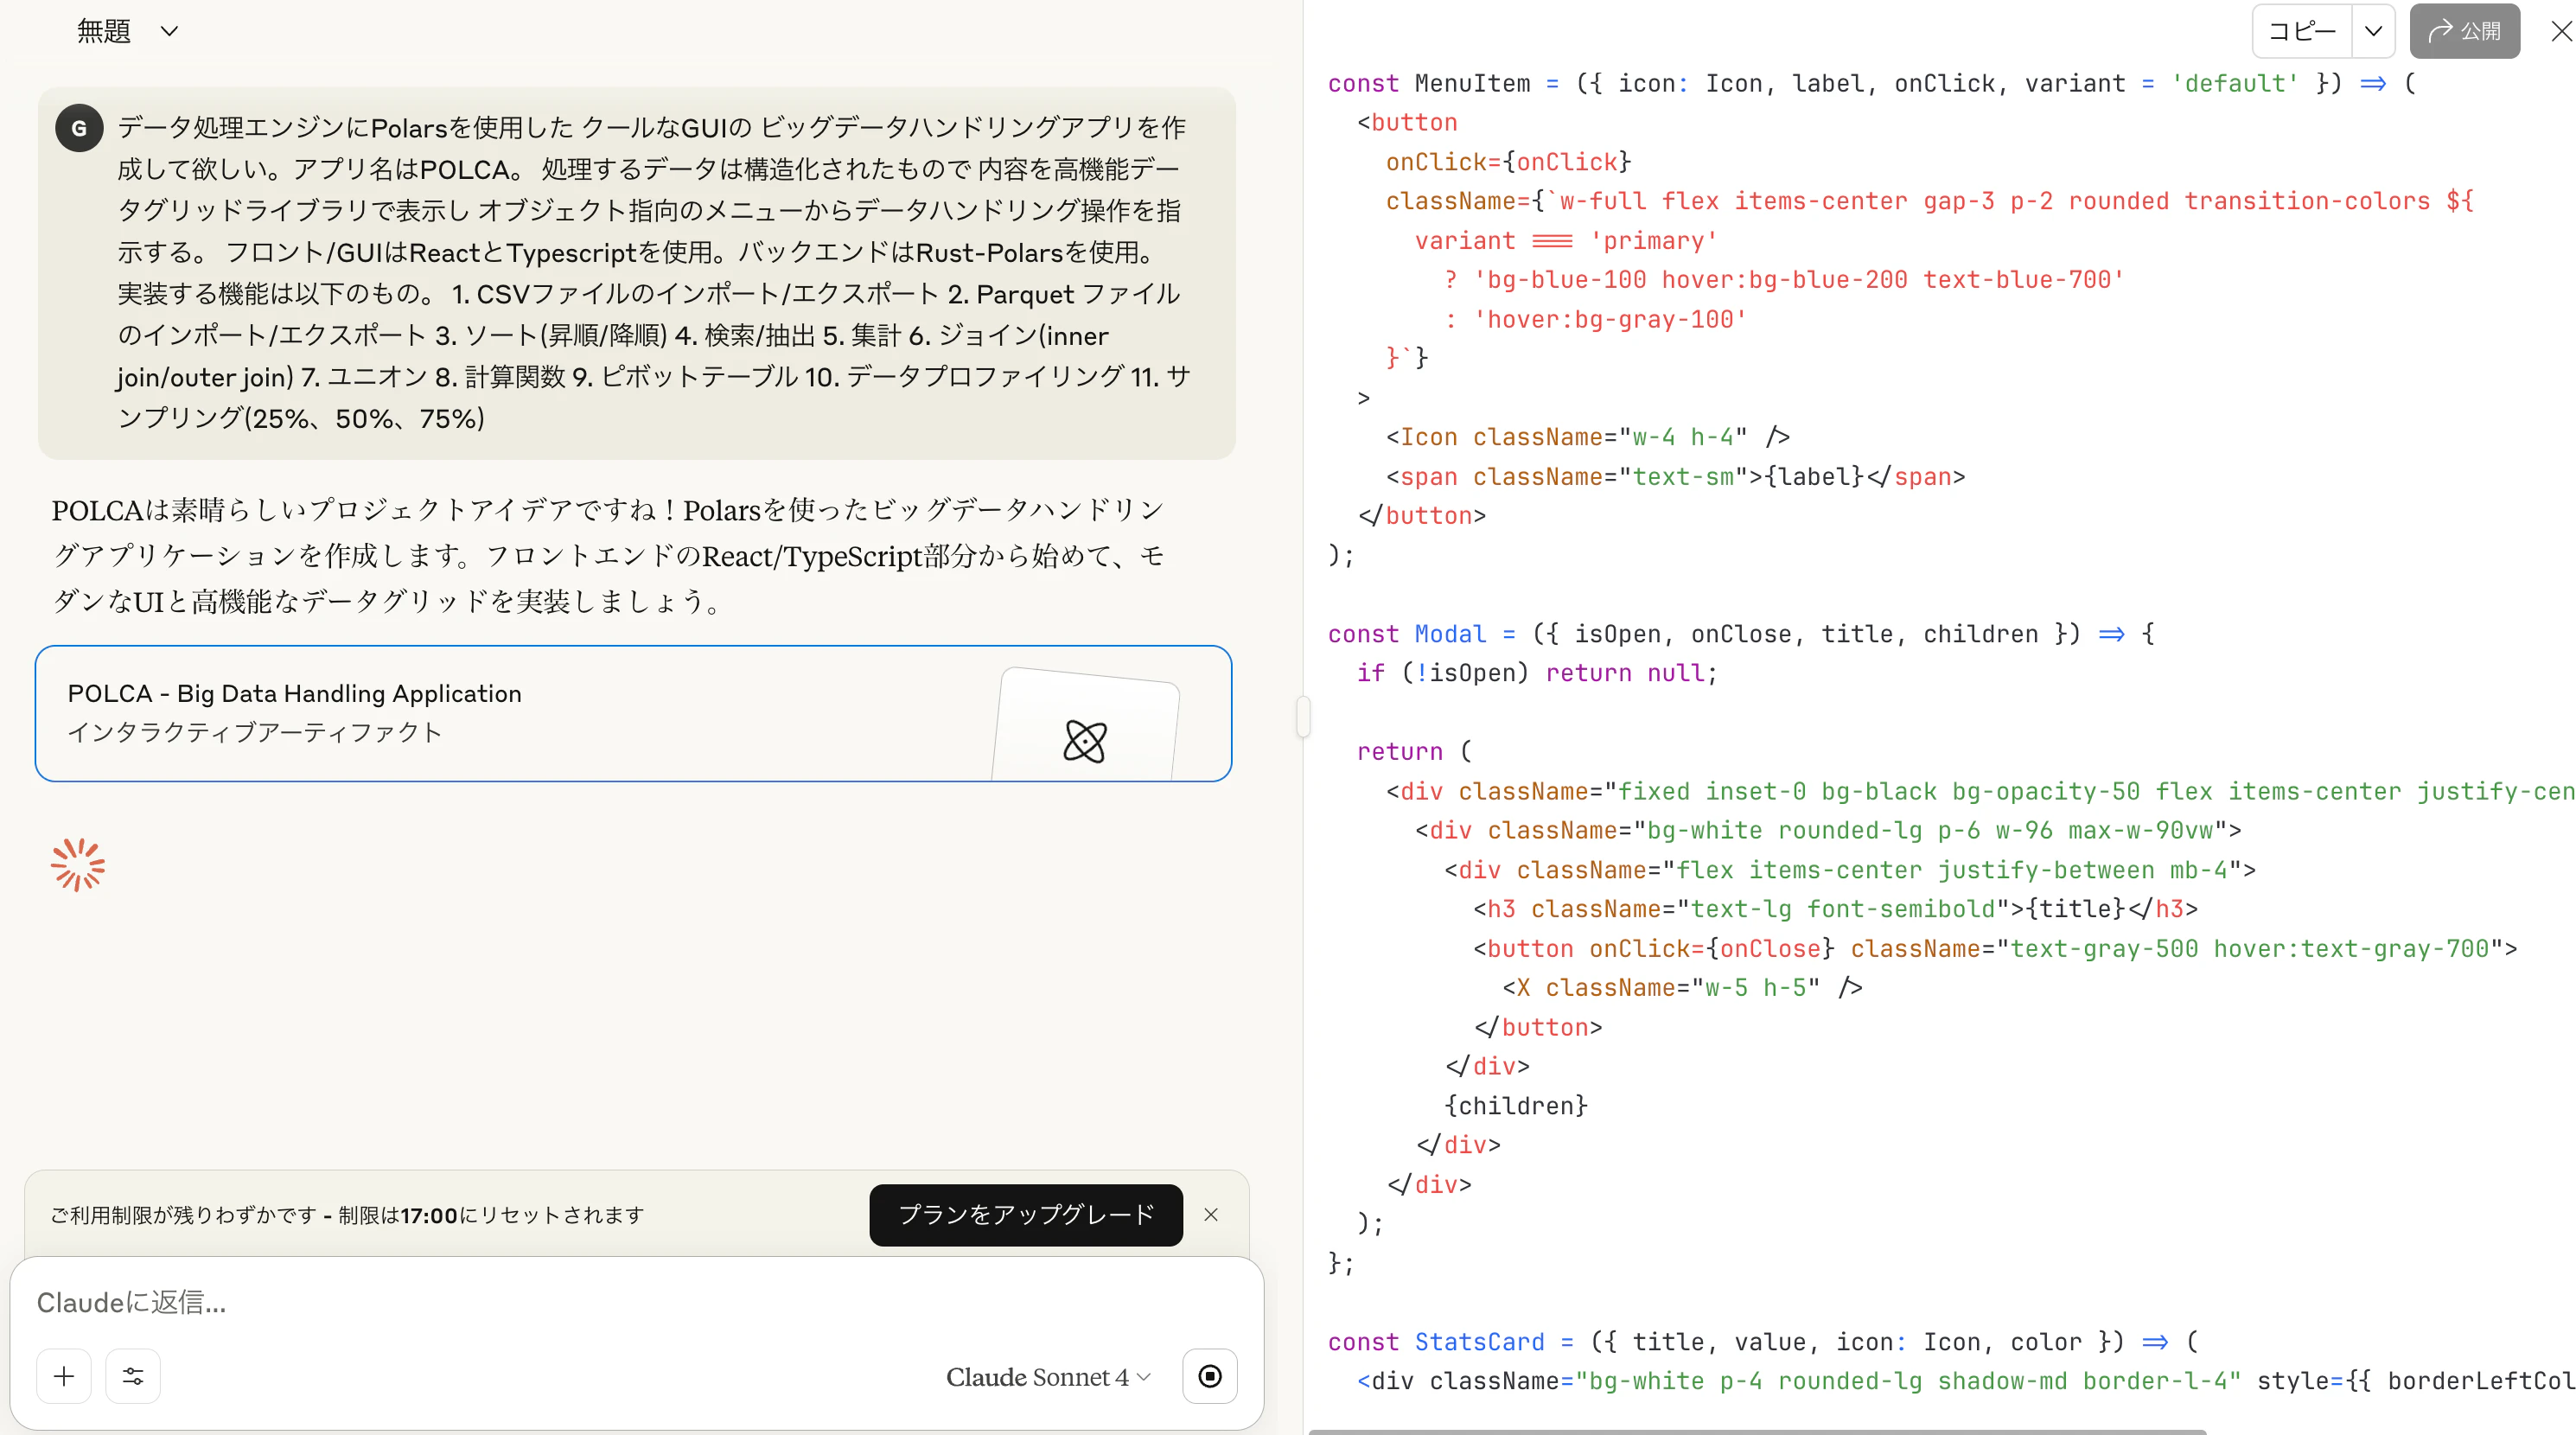
下記の様な画面で 左側に思考プロセスが 右側にコードが表示され 画面がスクロールしながら フロントエンドの生成処理が進みます。
フロントエンドの生成が完了すると POLCA の操作画面が表示されます。何種類かの画面パターンが用意されている様です。また この時点では 一部の機能のみ実装されており Claude Code と会話を繰り返ししながら 実装機能を追加してゆく必要がありそうです。

🚀 主要機能
データ処理機能
インポート/エクスポート: CSV・Parquetファイル対応
ソート機能 : 昇順/降順でのデータ並び替え
検索/抽出 : リアルタイム全文検索
集計機能 : 数値データの合計・平均・最小・最大値
ジョイン・ユニオン : データ結合操作
計算関数 : カスタム計算処理
ピボットテーブル: 動的クロス集計
データプロファイリング : 統計情報の自動生成
サンプリング : 25%/50%/75%/100%での抽出
UI/UXの特徴
モダンデザイン : ダークテーマ + グラデーション
高機能データグリッド : ソート可能なテーブル表示
オブジェクト指向メニュー : アイコン付き直感的操作
レスポンシブ対応 : 様々な画面サイズに適応
リアルタイム更新 : データ変更の即座反映
技術スタック
フロントエンド : React + TypeScript
スタイリング : Tailwind CSS
アイコン : Lucide React
状態管理 : React Hooks
🎯 実装済み機能
✅ CSVインポート/エクスポート (UI実装済み)
✅ Parquetインポート/エクスポート (UI実装済み)
✅ ソート機能 (昇順/降順)
✅ 検索/抽出機能
✅ 集計機能 (グループ化 + 統計)
✅ 計算関数 (新規カラム作成)
✅ サンプリング (25%、50%、75%)
✅ データプロファイリング
🔄 Join機能 (UI準備済み、実装可能)
🔄 Union機能 (UI準備済み、実装可能)
🔄 ピボットテーブル (UI準備済み、実装可能)
🛠 次のステップ
バックエンドのRust-Polars統合のために、以下の実装が推奨されます:
WebAssembly統合 : Polars-rsをWASMでコンパイル
API設計 : RESTful APIでフロント・バック連携
ファイルアップロード : 実際のCSV/Parquetファイル処理
パフォーマンス最適化 : 大容量データの遅延読み込み
このフロントエンドは既にPolarsの概念(DataFrame、カラム型、操作履歴など)に基づいて設計されているため、バックエンド統合時の移行がスムーズに行えます。
🎯 使用方法
データ表示: メインのデータグリッドでテーブル形式表示
検索: 上部の検索バーで全文検索
ソート: カラムヘッダーをクリックで並び替え
サンプリング: 25%〜100%の範囲でデータ抽出
プロファイル: データ統計情報の詳細表示
ピボット: カスタムクロス集計テーブル生成
現在はサンプルデータで動作していますが、実際の使用時にはRust-Polarsバックエンドと連携してより高速な大規模データ処理が可能になります。
アプリの見た目や機能について、さらなる改良をお望みでしたらお聞かせください!
2回目のプロンプトで バックエンドコードの追加 を指示します。
思考プロセスと コードが表示され 画面がスクロールしながら バックエンドの生成処理が進みます。
これで、POLCA(Polars-Powered Big Data Handler)の完全なシステムが完成しました!
🎉 完成したPOLCAシステムの概要
🏗️ アーキテクチャフロントエンド : React + TypeScript + Tailwind CSS
バックエンド : Rust + Polars + Axum
データベース : PostgreSQL(メタデータ管理)
キャッシュ : Redis(セッション・キャッシュ)
監視 : Prometheus + Grafana
ストレージ : MinIO(S3互換)
🚀 実装済み機能
データ処理エンジン(Rust + Polars)✅ CSV/Parquetファイルのインポート・エクスポート
✅ 高速ソート(昇順・降順)
✅ 柔軟な検索・抽出機能
✅ リアルタイム集計処理
✅ データジョイン・ユニオン
✅ 動的ピボットテーブル
✅ データプロファイリング
✅ サンプリング(25%/50%/75%/100%)
✅ 計算関数・カスタム式
高機能GUI(React)
✅ モダンなダークテーマデザイン
✅ インタラクティブデータグリッド
✅ リアルタイム検索機能
✅ ドラッグ&ドロップファイルアップロード
✅ レスポンシブ対応
✅ オブジェクト指向メニュー
エンタープライズ機能
✅ バッチ処理システム
✅ WebSocketリアルタイム通知
✅ メトリクス・監視(Prometheus)
✅ ヘルスチェック・システム情報
✅ セキュリティ(CORS・レート制限)
✅ エラーハンドリング・ロギング
運用・保守
✅ Docker化(開発・本番環境)
✅ 自動バックアップ・復元
✅ パフォーマンステスト
✅ CI/CDパイプライン対応
✅ 設定管理・環境変数
🛠️ 使用方法
開発環境起動
bash# バックエンド起動
make dev
フロントエンド起動(別ターミナル)
npm start
全サービス起動(Docker)
make docker-run
本番環境デプロイ
bash# 設定ファイル編集
cp .env.example .env

#### 本番デプロイ
make deploy-prod
データ操作例
typescript// APIクライアント使用例
const client = new POLCAApiClient();

// CSVインポート
const dataset = await client.importCSV(file);

// データクエリ
const result = await client.queryDataset(dataset.id, {limit: 100});

// ソート・フィルター
await client.sortDataset(dataset.id, {column: 'age', ascending: false});
await client.filterDataset(dataset.id, {column: 'department', value: 'Engineering', operation: 'eq'});

// ピボットテーブル
const pivot = await client.createPivotTable(dataset.id, {
  index: 'department',
  columns: 'city',
  values: 'salary',
  aggregate_function: 'mean'
});
🔧 技術的特徴
超高速処理 : Polarsによる並列データ処理
スケーラブル : Rustの安全性とパフォーマンス
リアルタイム : WebSocketでのライブ更新
監視可能 : Prometheusメトリクス完備
本格運用対応 : Docker、バックアップ、ヘルスチェック
このPOLCAシステムにより、ビッグデータを直感的なGUIで高速処理できる本格的なアプリケーションが完成しました! さらなる機能拡張やカスタマイズについて、何かご質問があればお聞かせください。
Claudeは現在、生成したコードを実行する機能を持っていません。
Claudeは間違えることがあります。回答内容を必ずご確認ください。
Claude Codeで 生成されたコードは こちら で参照できます。
Vercel v0
サインイン後の 最初のプロンプトで POLCA の機能要件を入力します。Claude Codeと同じ内容です。
POLCA を構築します: React + TypeScript フロントエンドと Rust + Polars バックエンドを備え、データ処理に Polars を使用するクールな SPA スタイルのビッグデータ GUI。
11 個の機能を実装: CSV/Parquet のインポート/エクスポート、並べ替え、検索/フィルター、集計、結合、ユニオン、計算関数、ピボット、プロファイリング、サンプリング。
高機能なデータグリッドとオブジェクト指向の操作メニューで優れた UX を提供します。
下記の様な画面で 左側に思考プロセスが 右側にコードが表示され 画面がスクロールしながら フロントエンドの生成処理が進みます。

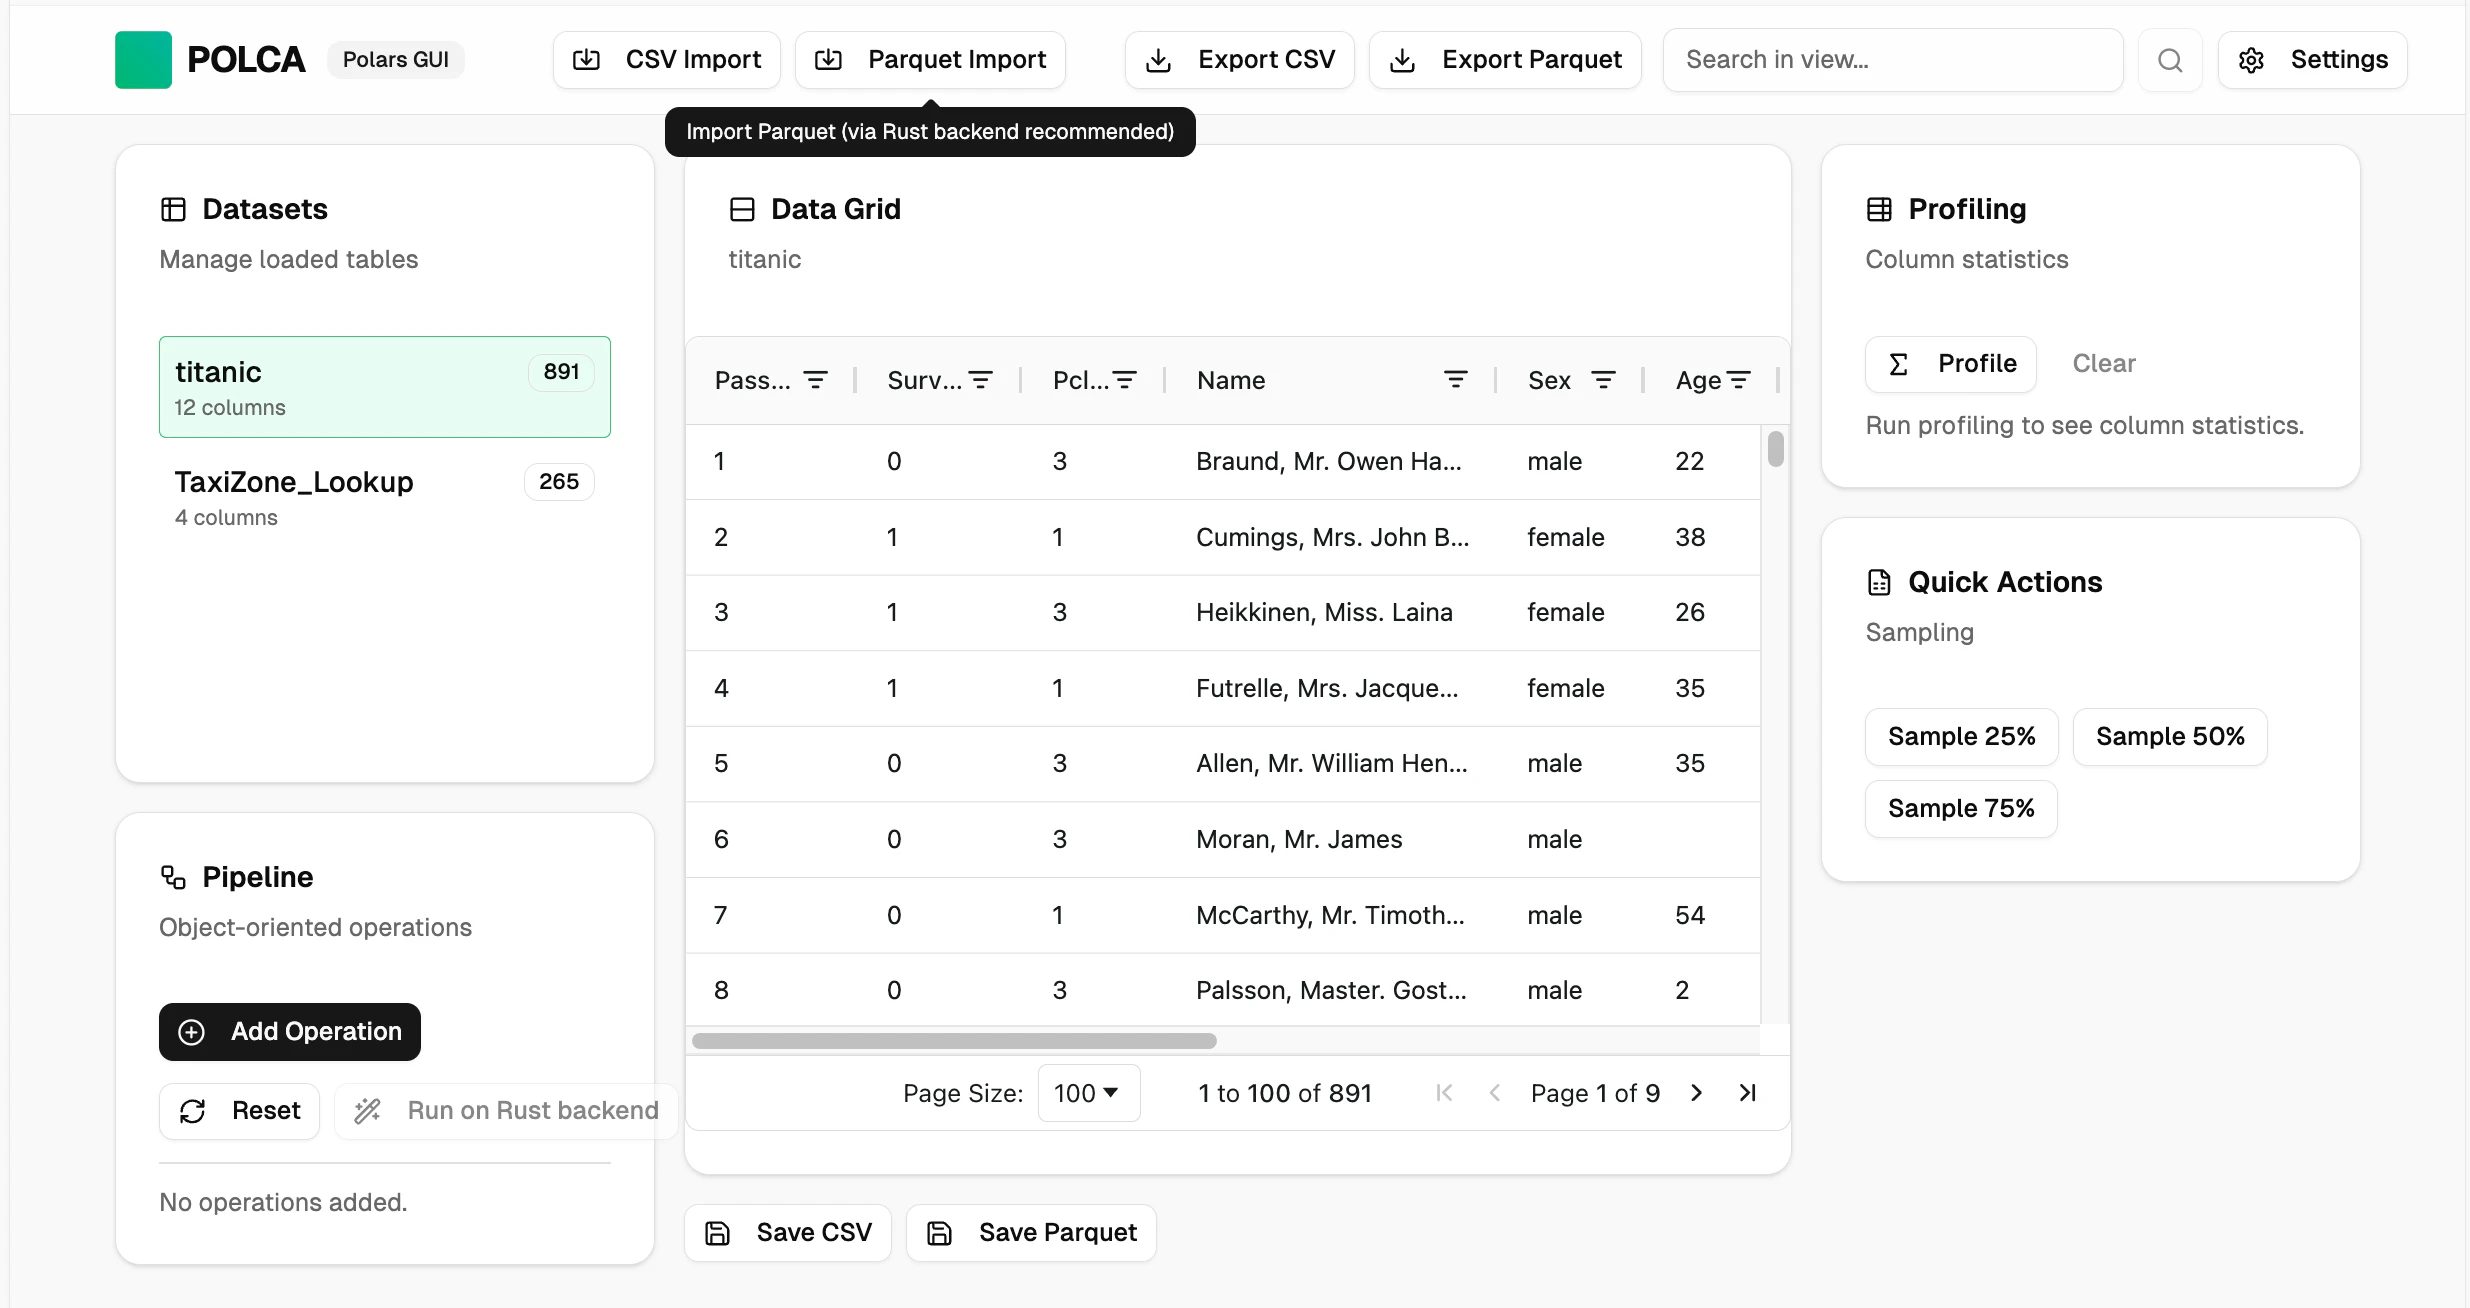
フロントエンドの生成が完了すると POLCA の操作画面が表示されます。この時点では 一部の機能のみ実装されており Vercel v0 と会話を繰り返ししながら 実装機能を追加してゆく必要がありそうです。
デザイン画面 (画面左側) に切り替えると フォントスタイルや色など 画面のデザインが変更できます。

制約とアプローチ
v0はブラウザ内のNext.jsランタイムでのみ実行されるため、ネイティブRustやNode.jsのネイティブアドオンは実行できません。公式Polars npmパッケージはネイティブバインディングを使用しているため、ここでは実行できません。
プレビューを完全にインタラクティブにするには、次の操作を行います。
GUI 全体と「エンジン アダプター」の抽象化を実装します。
Arquero (JS データ フレーム) を搭載した完全に機能するブラウザー内フォールバック エンジンを提供するため、すべての操作がクライアント側で機能します (ブラウザー内での Parquet のインポート/エクスポートを除く)。
プロキシ ルートと、個別に実行できる完全な Rust + Axum + Polars バックエンド参照 (コード スニペットとして) を提供します。UI は、[設定] で構成可能なベース URL を介してこれにポイントできます。
これにより、POLCAをすぐに開発、テスト、デモできます。デプロイ時には、フォールバックをRust Polarsバックエンドに置き換えることで、パフォーマンスとParquetのサポートを最大限に高めることができます。
このアプリは、Next.js App Routerとクライアントサイドのデータ処理を用いたSPAのようなパターンを採用しています。Next.jsはSPAをサポートし、必要に応じてサーバー機能のプログレッシブエンハンスメントを可能にします。
デザインのハイライト
データ グリッド : AG グリッド コミュニティ (仮想化、大規模データ、グリッド レベルでの並べ替え、フィルタリング)。
オブジェクト指向メニュー:型とパラメータを保持するコマンドオブジェクト。パイプラインは操作のリストを保持します。UIを使用して、操作を順番に追加、編集、実行できます。
複数のデータセット : 複数の CSV を名前付きテーブルとして読み込み、それらの間の結合/結合を実行します。
プロファイリング : 列ごとの統計、データ型の推論、カーディナリティ、欠損率、数値統計、上位 K カテゴリ。
サンプリング : 25/50/75% のクイック サンプリング。
CSV エクスポート : 常に利用可能。Parquet エクスポート: Rust バックエンド経由。
Parquet インポート : Rust バックエンド経由 (プレビューではブラウザ内フォールバックの通知が表示されます)。
プロキシ ルート : 構成されている場合にパイプラインの実行を Rust サービスに転送する Next.js ルート ハンドラー (オプションのブラウザー内フォールバックは残ります)。
注意事項と警告
ブラウザ内フォールバックではPolarsではなくArqueroを使用します(そのため、v0内ですべてをプレビューできます)。真のPolarsコンピューティングとParquet IOを利用するには、Rustバックエンドに切り替えてください。
このセッションには環境変数はありません。バックエンド URL はアプリの設定パネルで設定できます。
デフォルトでアクセス可能: セマンティック コンテナー、代替テキスト、可能な場合はキーボードで入力可能なメニュー。
gpt-5 model では バックエンドまで 一気にコードが生成されます。所用時間は 約10分です。
以下は、別途実行できるRustバックエンドのリファレンスです。エンジンを「Rust Polars」に切り替え、バックエンドURLを設定すると、フロントエンドから呼び出すことができます。使い方
「CSV インポート」をクリックし、CSV ファイルを読み込んでデータセットを作成します。
追加操作を使用して、並べ替え、フィルター、集計、結合、ユニオン、計算、ピボットを追加するか、サンプリング ボタンを使用します。
プロファイルを使用して、列ごとの統計を計算して表示します。
現在のビューから直接 CSV をエクスポートします。
Parquet のインポート/エクスポートまたは Rust-Polars コンピューティングの場合 :
提供されている Rust バックエンド (cargo run) を実行します。
設定を開き、エンジンを Rust Polars に設定し、バックエンド URL (例: http://localhost:8080 ) を入力します。
Parquet のインポートまたはエクスポートを使用するか、Rust バックエンドで実行します。
なぜNext.jsなのか
このアプリはSPAスタイルのインターフェースで、すべてのインタラクションはクライアント側で行われるため低レイテンシです。オプションでプログレッシブサーバー機能(Rustバックエンド)も利用できます。Next.jsはSPAをサポートしており、プロジェクトの拡大に合わせてサーバー機能(ルートハンドラー、ストリーミング、サーバーアクションなど)を追加できます。
インストールのヒント
v0では、「コードをダウンロード」をクリックしてこのプロジェクトをインストールしてください。フロントエンドはVercelに簡単にデプロイできます。Rustサービスは任意の環境にデプロイし、URLで参照できます。
Vercel v0 (gpt-5 model) で 生成されたコードは こちら で参照できます。
まとめ
今回 フルスタックアプリの開発を目的に 2つの AIエージェント に同じ機能要件で コードを生成させました。最初に述べた 機能要件のアプリが 10分程度で完成するのは 驚きです。実は その後 動作させるまでの作業が大変なのだが...
- Claude Code
- Vercel v0 (gpt-5 model)
今回 無償で使える範囲で試したので 無償版の制限に引っ掛かり 再開始を1日待たされることもありましたが、両方とも 期待通りのコードが生成されています。自分の様に React や Rust に対して 生かじりの知識・技術しか持たない者にとって React、Typescript、Rust、Polars でのコーディング手法を習得するには良いツールだと感じました。
Claude Code はコードが一部省略されている箇所があり (無償版だから?) 少し 物足りなく感じました。Vercel v0 は ビッグデータが扱える AG グリッドの採用やパイプラインでの操作リストの保持など 自分好みの実装です。
AIエージェントは 日々 進化している最中のようで Vercel v0 は 本記事を執筆中に gpt-5 model バージョンがリリースされ アプリを生成し直しました。
ウォーターフォール 開発で 最初にアプリの要件定義をキッチリ行なってから 開発に着手するような開発手法に AIエージェントを利用するは 少し不安に感じていますが 開発効率は確実に良くなります。また おぼろげなアイデアを AIエージェント と会話しながら 作業を進めてゆくような開発手法に適していると感じます。自分だけでは出てこないアイデアを AIエージェント が提示してくれそうです。
今回 バイブコーディングを体験してみて 優秀なプログラマーを部下に持った感じです。ただ 部下に言う事を聞かせるのは 難しい。
最後まで お読み頂き ありがとうございました。