
顧客リストの重複削除は、set() に入れれば終わりそうに見えます。ところが実際のリストでは、同じ人の2回目の登録がまったく同じ行になることはまずありません。購入日が違う、引っ越して都道府県が変わった、2回目はアドレスを全角で打った。こうした行を同じ人とみなすかどうかはデータ自体からは決まらず、何をキーにして比べるかで決まります。そしてそのキーの決め方次第で、何行消えるか、どの行が残るか、何を失うかが全部変わります。
この記事では、412行の表示例のリストを使って、その判断をひとつずつPythonで確かめます。答え合わせには、デスクトップアプリ osFoundry の表計算エディターにある Remove Duplicates(重複の削除)を使います。このコマンドは、キーの選択を入力欄ひとつで指定させる作りになっています。
使うリスト
デモ用に生成したリストです。列は メール・氏名・都道府県・最終購入日 の4つで、顧客は374人。そこに、すでにいる人のメールアドレスを繰り返す行が38行混ざっています。重複行の購入日はどれも元の行と違い、3行に1行は都道府県を引き直してあります。メールアドレスで数えると、2回以上出てくる人は31人(2回が25人、3回が5人、4回が1人)です。
import openpyxl

ws = openpyxl.load_workbook("ja-customers.xlsx").active
header, *rows = [tuple(str(c) for c in r) for r in ws.iter_rows(values_only=True)]
len(rows)  # 412
キーを引数にした関数ひとつ
以下の比較はすべて同じループで、キーだけを差し替えています。キーごとに最初に出てきた行を残し、keep="last" なら同じ位置を後の行で上書きします。
def dedupe(rows, key, keep="first"):
    seen, out = {}, []
    for r in rows:
        k = key(r)
        if k in seen:
            if keep == "last":
                out[seen[k]] = r
            continue
        seen[k] = len(out)
        out.append(r)
    return out
1行につき辞書の検索が1回なので線形時間で、残した行の順番も元のままです。pandasなら df.drop_duplicates(subset=[...], keep="first") が同じ動きをします。
行全体で比べるか、キーで比べるか
同じ412行を、3種類のキーで比べた結果です。
| キー | 残った行 | 消えた行 |
|---|---|---|
| 行全体 | 412 | 0 |
| メール | 374 | 38 |
| メール+都道府県 | 386 | 26 |
行全体をキーにすると、1行も消えません。多くの「重複の削除」ボタンの初期設定はこれで、このリストでは何もしないまま終わります。重複行の購入日が元の行と一致しないからです。メールだけをキーにすれば38行すべて消えます。メール+都道府県だと26行が消え、都道府県が違う同じ人の12行が残ります。配送先の一覧ならこれが正解で、人の一覧なら間違いです。
表計算エディターでは、この選択が Remove Duplicates ダイアログの「Columns (blank = all, e.g. A,C)」という欄ひとつに集約されています。空欄が行全体、A がメールをキーにする指定です。
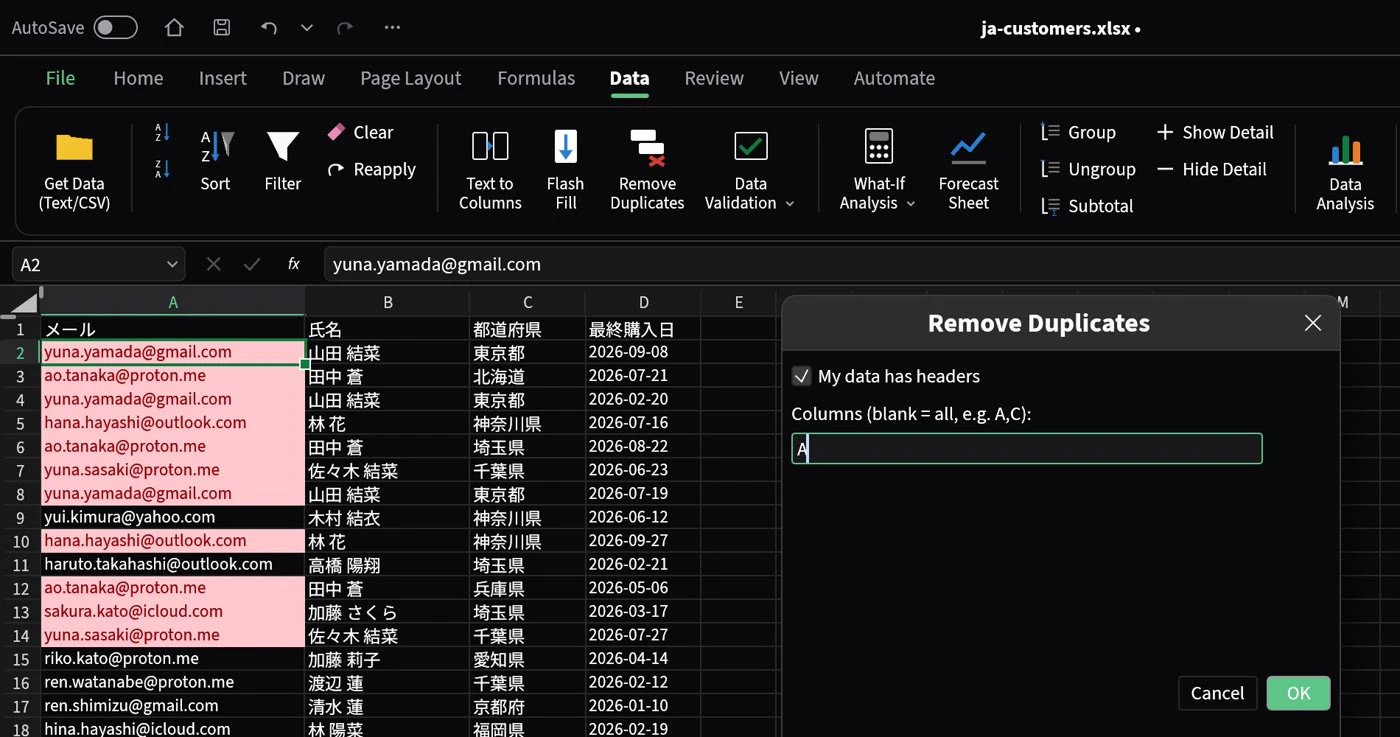
A で実行すると、A列のステータスバーの Count は413から375になります。メール374件と見出し1行で、Python版で残った行数と一致します。
どの行が残るか
最初の行を残すのはExcelでもpandasでもこのエディターでも共通の約束ですが、データの中身から見れば根拠のない選び方です。このリストでは、重複していた31人のうち22人について、残る最初の行が最新の購入ではありませんでした。また31人中11人は、行によって都道府県が食い違っています。最初の行を残す方式だと、この11人は最初に入力された都道府県のまま残ります。
新しい行を残したいなら、重複を消す前に並べ替えます。Pythonのソートは安定ソートで、2026-09-08 のような日付は文字列のままで正しく並ぶので、これだけで済みます。
latest = dedupe(sorted(rows, key=lambda r: r[3], reverse=True), key=lambda r: r[0])
len(latest)  # 374。どの人も最新の購入の行が残る
表計算なら、最終購入日の列で新しい順に並べ替えてから重複の削除を実行するのと同じです。
日本語のリストでハマる、全角と半角
表示例のリストのアドレスはきれいですが、フォームから集めたリストはそうはいきません。日本語入力のまま打たれたアドレスや、全角スペースが紛れ込んだセルは日常的にあります。そこでリストのコピーを作り、重複の38行だけを、ありがちな5通りの打ち方に順番に書き換えました。全角英数字(yuna.yamada@gmail.com)、末尾に全角スペース、すべて大文字、先頭に半角スペース、全角の大文字です。各顧客の最初の行はそのままにしてあります。
import unicodedata

def email_key(e):
    return unicodedata.normalize("NFKC", e).strip().lower()
| キー | 残った行 | 消えた行 |
|---|---|---|
| そのまま | 410 | 2 |
strip() |
396 | 16 |
strip().lower() |
389 | 23 |
NFKC + strip().lower()
|
374 | 38 |
そのまま比べて消えた2行は、同じ人の2回目と3回目がたまたま同じ打ち方だっただけで、元の行とは一致していません。strip() は全角スペース(U+3000)も取り除くので、末尾の全角スペースはこれで片づきます。lower() で大文字が揃い、残る全角英数字はNFKC正規化で半角になって、ようやく38行すべてがそろいます。
正規化した値は、あくまで比較用のキーです。残る行のアドレスは入力されたままにしておきます。表示・保存用の元の文字列と、照合用の正規化した文字列を分けて持つ、という形です。
会社名は、NFKCだけでは名寄せできない
BtoBのリストで名寄せのキーになりがちなのが会社名です。同じ会社が9通りに書かれている表示例で、正規化をひとつずつ足していくとキーの種類がどう減るかを数えました。対象は 株式会社ヤマダ商事、(株)ヤマダ商事、(株)ヤマダ商事、㈱ヤマダ商事、ヤマダ商事株式会社、ヤマダ商事(株)、株式会社 ヤマダ商事、ヤマダ商事、有限会社ヤマダ商事 です。
| 処理 | キーの種類 |
|---|---|
| そのまま | 9 |
| NFKC | 7 |
| NFKC + 空白除去 | 6 |
| NFKC + 空白除去 + 法人格を削除 | 1 |
| NFKC + 空白除去 + 略称を正式名に展開 | 4 |
NFKCは ㈱ を (株) に、全角かっこの (株) も (株) に、半角カナの ヤマダ を ヤマダ にしてくれます。㍿ は 株式会社 になります。ただし (株) と 株式会社 を同じものにはしません。ここから先は辞書や正規表現の仕事です。
落とし穴は、法人格をまるごと削除するやり方です。キーは1種類になってきれいに見えますが、有限会社ヤマダ商事 まで同じ会社にまとまってしまいます。別の法人である可能性が高いものを、黙って1行に潰すことになります。(株) → 株式会社 のように略称を正式名に展開するだけにすると、キーは4種類(前株、後株、法人格なし、有限会社)に分かれて残ります。前株と後株を同じ会社とみなすかどうかは、人が判断するところです。確実に名寄せしたいなら、13桁の法人番号をキーにするのがいちばん確かです。
NFKCが揃えないもの
便利なNFKCにも、揃えないものと、揃えすぎるものがあります。Python 3.12で確かめた結果です。
>>> unicodedata.normalize("NFKC", "03-1234-5678")  # 全角ハイフンマイナス
'03-1234-5678'
>>> unicodedata.normalize("NFKC", "03−1234−5678")   # マイナス記号 U+2212
'03−1234−5678'
>>> unicodedata.normalize("NFKC", "03ー1234ー5678")  # 長音符
'03ー1234ー5678'
>>> unicodedata.normalize("NFKC", "①")
'1'
電話番号の区切りは、全角の - だけが半角になり、マイナス記号 − や、変換ミスで入る長音符 ー はそのまま残ります。電話番号をキーにするなら、NFKCのあとに数字以外を全部落とすほうが確実です。逆に ① は 1 になるので、丸数字に意味がある列をNFKCで上書きすると情報が消えます。ここでも、正規化するのは比較用のキーだけにしておくのが安全です。
正規化のコスト
表示例のリストを繰り返して作った100万件のメールアドレスから、キーの集合を作る時間を測りました。Python 3.12、Apple M1、5回の中央値です。
| キー | 時間 |
|---|---|
| そのまま | 6 ms |
strip().lower() |
95 ms |
NFKC + strip().lower()
|
134 ms |
時間のほとんどは正規化にかかっていますが、それでも100万件で0.1秒ほどです。速度を理由に省く必要はありません。
手順の順番
まず色を付けて見て、それから消します。キーの列に重複のハイライトを付けると(エディターなら Conditional Formatting → Highlight Cells Rules → Duplicate Values。最初の1行にも色が付きます)、消す前にグループが見えます。家族で共有しているアドレスのように、まとめてはいけないものに気づけるのはこの段階です。そのうえでキーを決め、どの行を残すかを決めて並べ替え、人が入力したデータならキーを正規化し、最後に件数で確かめます。
この記事の数字はすべて、openpyxl と標準ライブラリだけのスクリプトで出しています。表計算エディターは自分のパソコン上で動き、その考え方は osFoundryのローカルファーストの設計 のページにあります。アプリは osFoundryのダウンロードページ から無料で入手できます。