
新しいAIモデルが公開されると、議論は一つの数字に集約されがちだ。総合スコア、コーディングベンチマーク、コンテキスト長。だが、Grok 4.7を理解するうえで本当に有用な問いは、首位を取ったかどうかではない。
コーディングエージェントが標準で選ぶモデルになれるか。
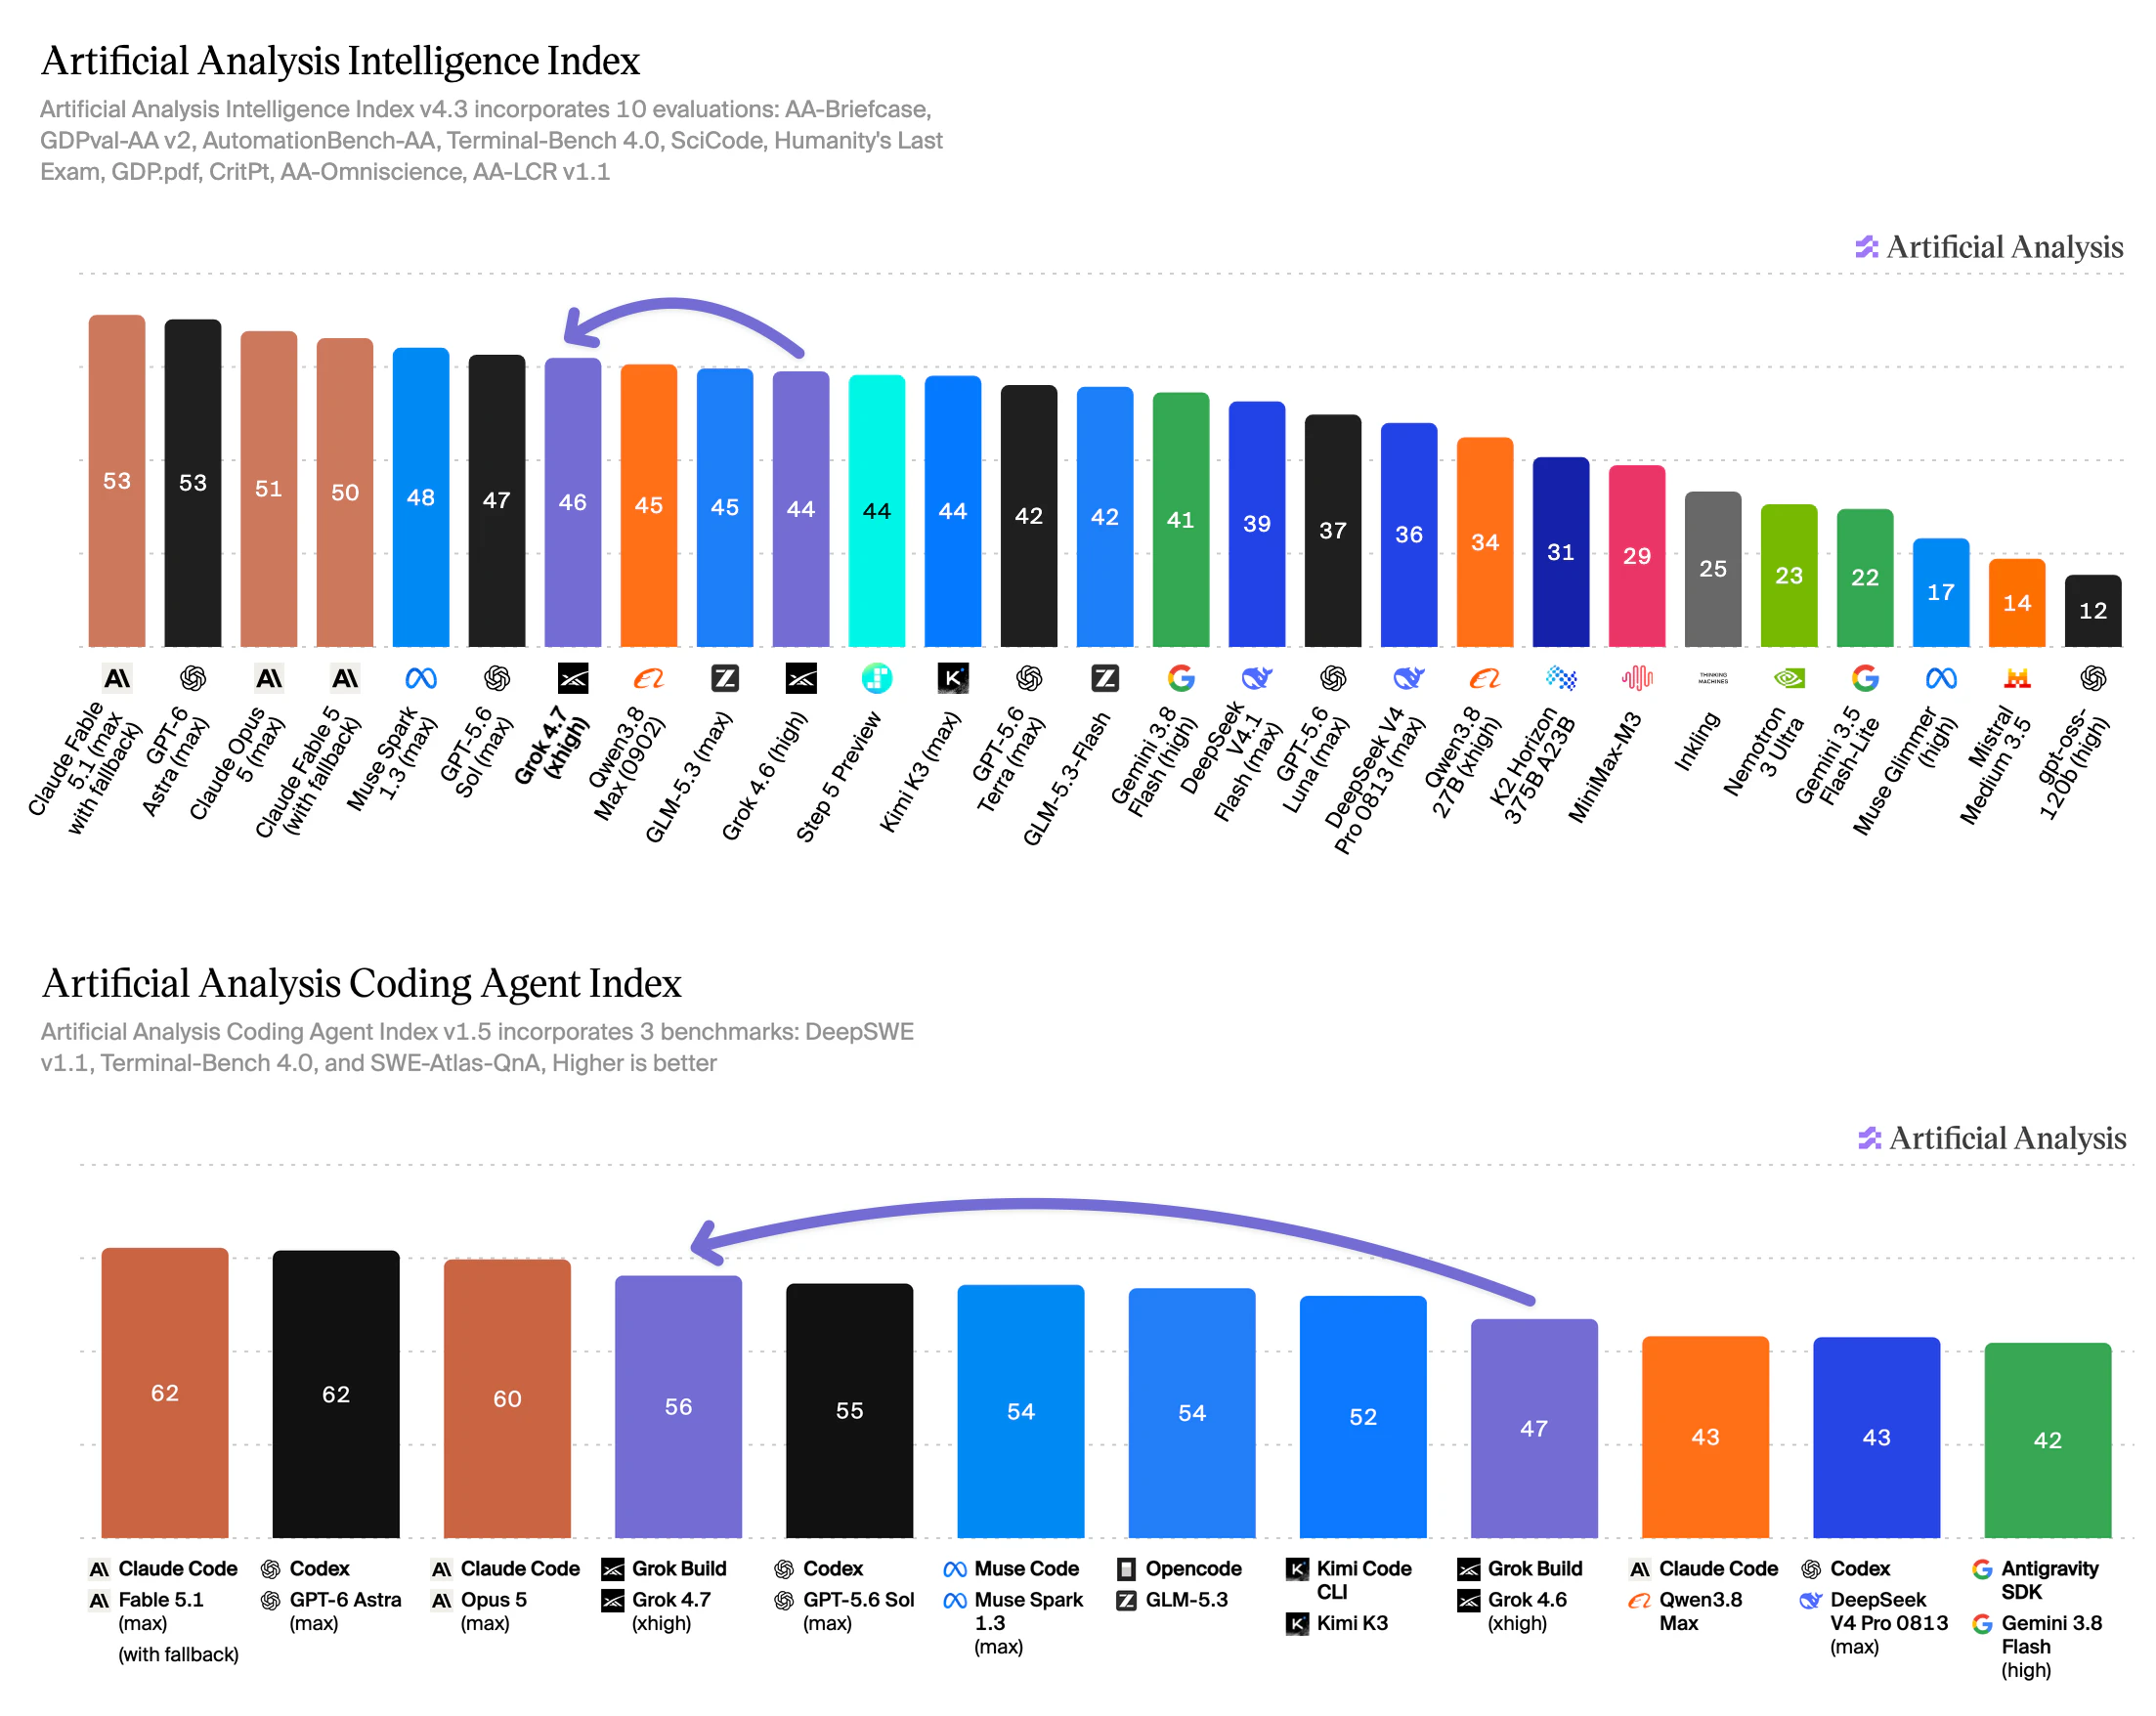
xAIは2026年9月21日にGrok 4.7を公開した。Artificial AnalysisのIntelligence Indexでは、xhigh設定で46。Grok 4.6 highから2ポイント上昇した一方、首位の53には届いていない。総合指標だけを見れば、明快なトップ交代ではない。
ところが、実際に使われるエージェント環境に視点を移すと印象が変わる。Grok Buildと組み合わせたCoding Agent Indexは、Grok 4.6の47から56へ上昇した。さらにxAI API、Cursor、Grok Buildに加え、GitHub Copilotやサードパーティーのゲートウェイでも展開が進む。
今回の更新はチャット性能の改善だけにとどまらない。xAIはGrok 4.7をエージェントの実行経路に組み込み、開発者が最初に検討するモデルにしようとしている。
Grok 4.7の基本仕様
Grok 4.7は、コーディング、エージェント実行、長時間の知識労働を主な対象とする推論モデルだ。現行のAPIドキュメントでは、次の仕様が公開されている。
- モデルID:
grok-4.7 - 500Kトークンのコンテキストウィンドウ
- テキストと画像を入力し、テキストを出力
-
low、medium、high、xhighの推論レベル - Responses APIとChat Completions APIに対応
- APIドキュメント上の知識カットオフは2026年5月
公式発表では、より大きなベースモデル、長期化した強化学習、自己検証能力、そして数時間に及ぶ難しいタスクへの最適化が強調されている。独立評価で大きく伸びた領域も、短い一問一答ではない。計画を維持し、ツールを操作し、失敗から復帰して成果物を完成させる仕事だ。
CursorとGrok Buildには高速版も用意されている。同じGrok 4.7をより高速に提供する代わりに、トークン単価はおよそ2倍となる。現時点ではxAIの公開APIからは利用できない。
評価すべき対象は「モデル + ハーネス」
Artificial Analysisの結果には、対照的な二つの数字がある。
- Intelligence Index:46。Grok 4.6 highから2ポイント増
- Grok Build利用時のCoding Agent Index:56。Grok 4.6から9ポイント増
この差は誤差ではなく、今回のリリースを理解する核心だ。
コーディングエージェントはモデル単体ではない。少なくとも以下の要素で構成される。
モデル + システムプロンプト + ツール定義 + リポジトリ文脈 + 計画ループ + エラー復旧 + 検証ポリシー
ハーネスが変われば、結果も変わる。良いコンテキストを与えられるか、ツールを正しく呼べるか、途中で諦めずに続けられるか、提出前に自分の作業を検証できるか。これらはすべて実行結果に影響する。
出典:Artificial Analysis「Benchmarking Grok 4.7」
したがって、「Grok 4.7のTerminal-Benchスコアはいくつか」という質問だけでは不十分だ。
同じTerminal-Benchに三つの数字がある理由
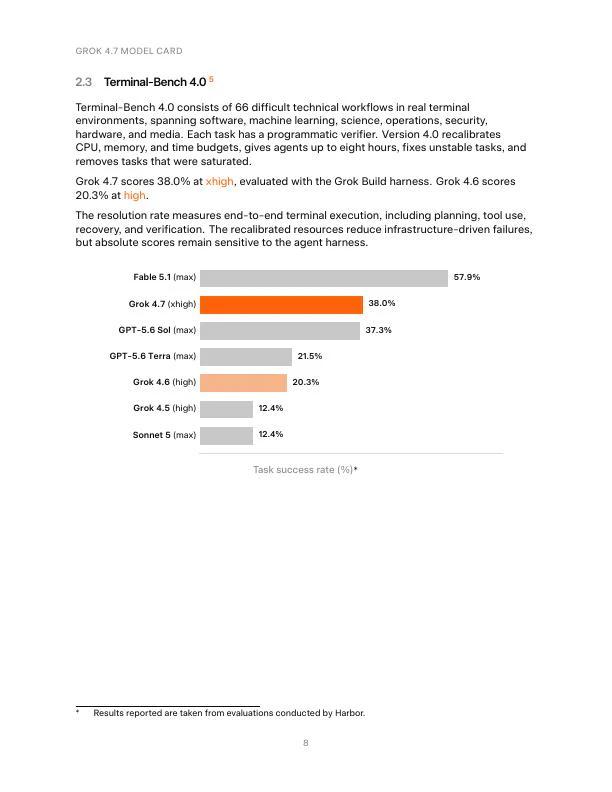
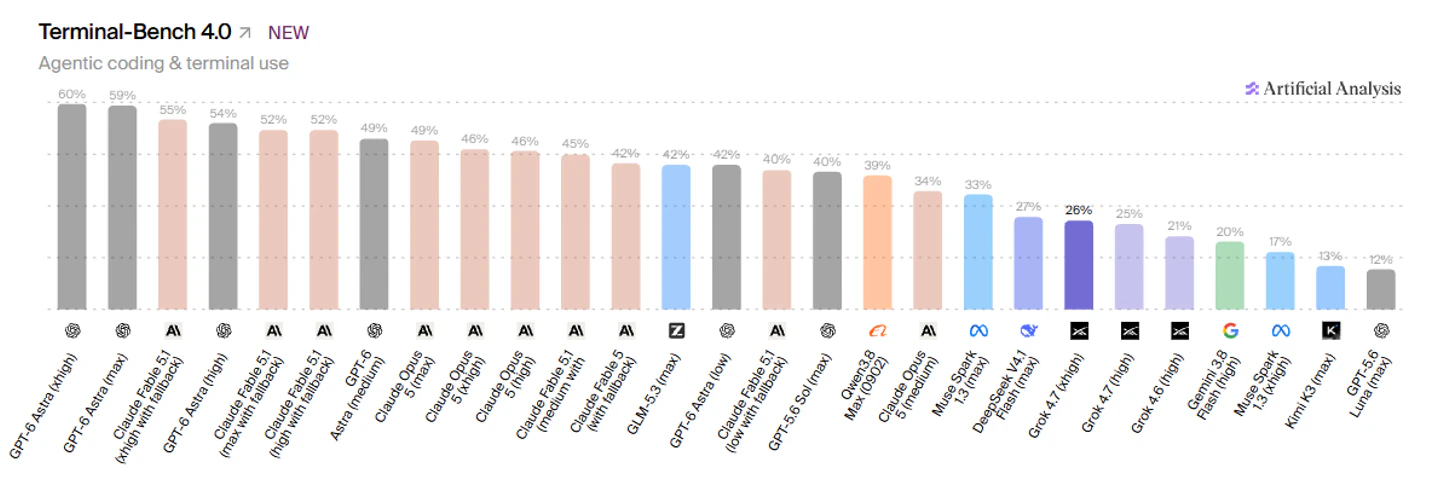
Grok 4.7については、Terminal-Bench 4.0の結果として少なくとも三つの数字が流通している。
- 38.0%:xAIのモデルカード。Grok Buildハーネスを使用し、評価結果はHarborによるもの
- 33%:Artificial AnalysisのCoding Agent Index。ネイティブのGrok Build構成
- 約26%:Artificial AnalysisのIntelligence Indexで使われる標準化ハーネス
数字が違うのは、測っている対象が違うからだ。
38%と33%は、Grok 4.7を自社のエージェント基盤と組み合わせたとき、製品全体として何ができるかに近い。標準化された結果は、各社固有の足場をそろえたうえで、モデル自体を比較する目的に近い。
ネイティブハーネスの結果には製品評価としての価値があり、標準化結果にはモデル比較としての価値がある。どちらも必要だが、ハーネス名を伏せたまま同じランキングに並べるべきではない。
出典:Artificial AnalysisのデータをThe Decoderが掲載
開発者が取るべき方針は明確だ。本番で使う構成そのものを評価する。Cursor、Grok Build、OpenCode、自社ツールループのいずれを使う場合でも、モデル単体のスコアだけでシステム全体は予測できない。
実際に伸びたのは長時間の実務
Grok 4.7の改善が最も目立つのは、長い作業工程を必要とするタスクだ。
実務的な成果物を評価するAA-Briefcaseでは1657 Eloを記録し、Grok 4.6 highから111ポイント上昇した。GDPval-AAでは1695 Eloで、90ポイントの改善となる。これらは回答を選ぶだけのテストではない。文書、表計算、プレゼンテーションなど、実際に利用できる成果物の作成が求められる。
Grok Buildと組み合わせたCoding Agent Indexでも、三つの構成指標がすべて改善した。
- DeepSWE:65% → 73%
- Terminal-Bench 4.0:18% → 33%
- SWE-Atlas-QnA:58% → 63%
AA-Omniscienceでは、ハルシネーション率が34%から**29%**に低下した一方、正解率はほぼ横ばいだった。ここから言えるのは、この評価条件では不確かな内容を生成する傾向が弱まったということだ。ハルシネーション全般が解決したという意味ではない。

優先的に試す価値があるのは、次のようなワークロードだ。
- リポジトリ全体を扱う実装やデバッグ
- 計画、ツール利用、障害復旧を伴うターミナル作業
- 最終的に構造化された成果物を要求する調査
- 文書、表計算、プレゼンテーションの作成
- 大きなコンテキストと明示的な検証工程を持つワークフロー
これは各用途でGrok 4.7が必ず最良だという証明ではない。どこから自社評価を始めるべきかを示す材料だ。
見落としやすい変数は出力トークン量
xAIの標準リスト価格は、長文コンテキストのしきい値未満で入力100万トークン当たり2ドル、キャッシュ入力0.50ドル、出力6ドル。200Kトークンを超える場合、公開されている入力と出力の価格は4ドルと12ドルになる。
単価には競争力がある。しかし、本番コストは単価だけでは決まらない。
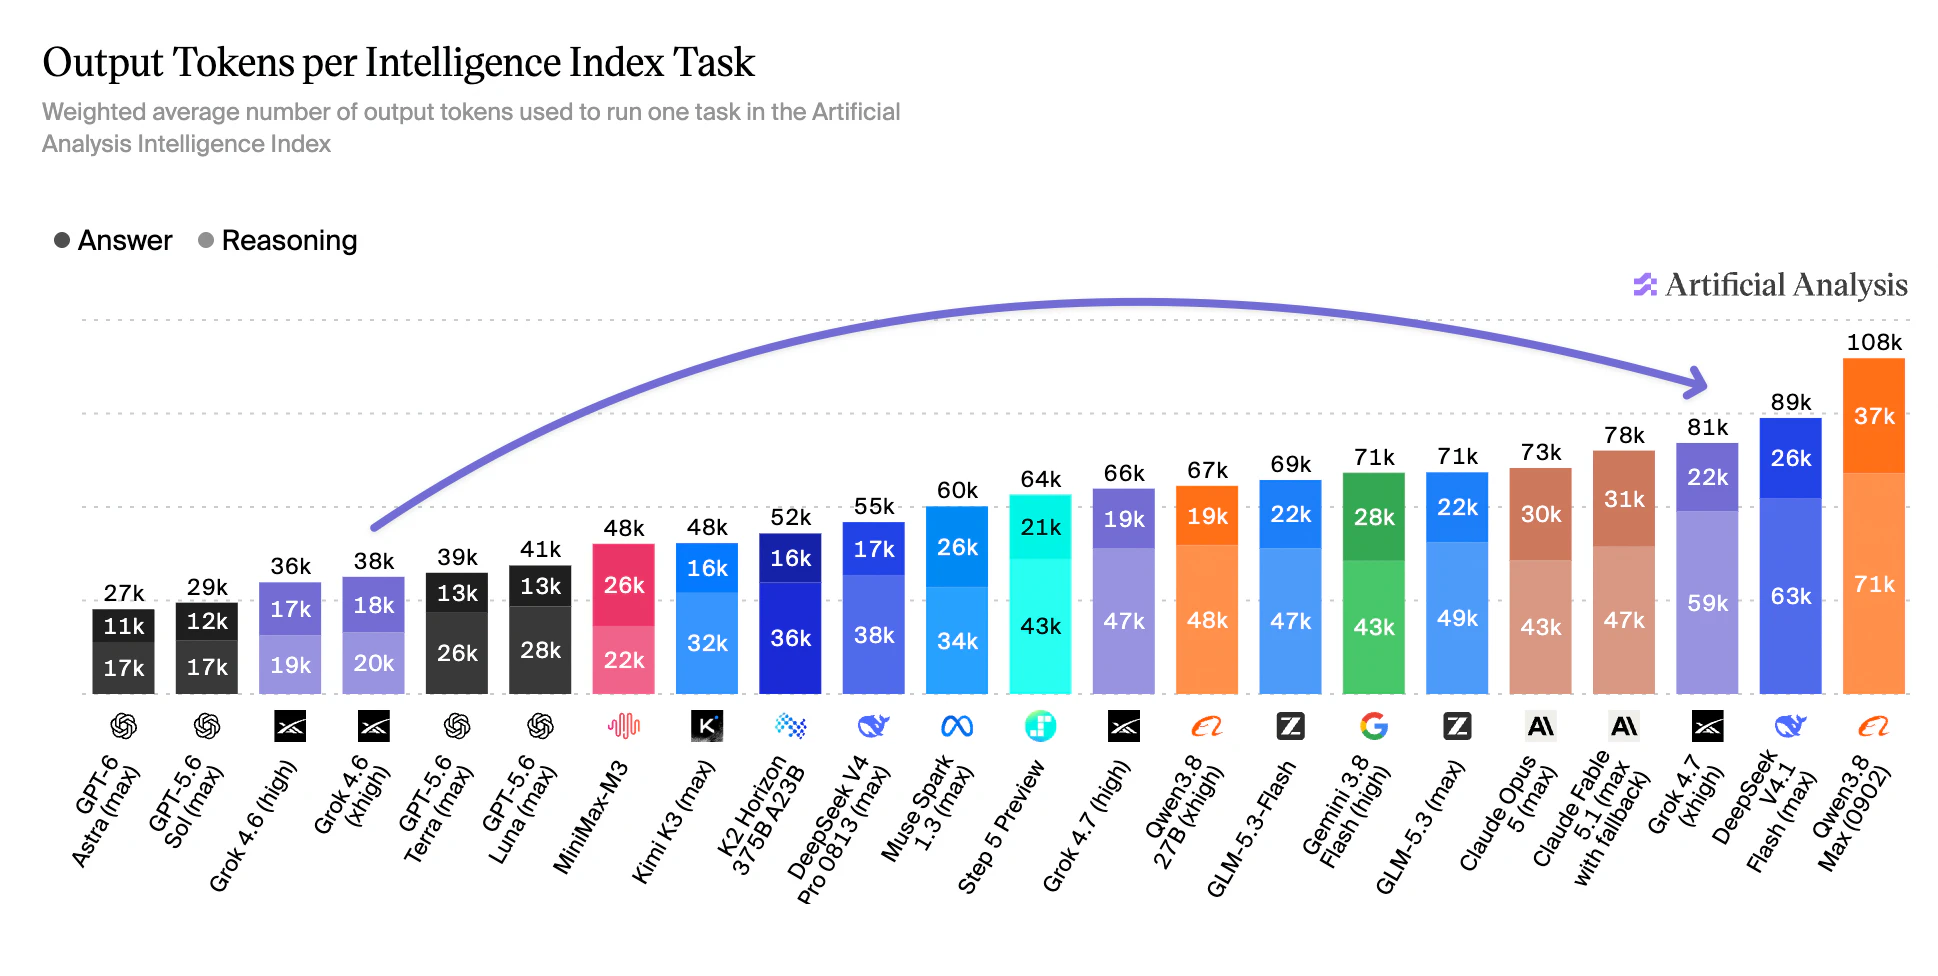
Artificial Analysisによると、Grok 4.7のxhigh設定は、Intelligence Indexの1タスク当たり約81K出力トークンを使った。同じ記事ではGrok 4.6 highが36K、グラフ上のGrok 4.6 xhighが38K、GPT-6 Astra maxが約27Kとなっている。
したがって、見るべき分母は「100万トークン」よりも、受け入れ基準を満たした1タスクだ。
合格タスク当たりのコスト = 全試行の総コスト ÷ 受け入れテストを通過した成果物数
ここには推論トークン、再試行、タイムアウト、ツール呼び出し、失敗した出力も含まれる。トークン単価が低くても、ループや冗長な出力、再試行が多ければ高くつく。単価が高いモデルでも、一度で完了すれば総額で勝つ可能性がある。
BeatAPIを使った場合の価格
同じ公開モデルgrok-4.7を互換APIで試したいチーム向けに、BeatAPIは現在、対応する料金項目を**xAI公式リスト価格の35%**に設定している。
| 料金項目 | xAI公式リスト価格 | BeatAPI価格 | 公式価格に対する比率 |
|---|---|---|---|
| 200K未満の入力 | $2.00 / 1M | $0.70 / 1M | 35% |
| 200K未満のキャッシュ入力 | $0.50 / 1M | $0.175 / 1M | 35% |
| 200K未満の出力 | $6.00 / 1M | $2.10 / 1M | 35% |
| 200K以上の入力 | $4.00 / 1M | $1.40 / 1M | 35% |
| 200K以上の出力 | $12.00 / 1M | $4.20 / 1M | 35% |
対応する公式料金行から見ると65%低い。ただし、すべての業務タスクが65%安くなるわけではない。出力長、再試行率、キャッシュヒット、成功率を含めた合格タスク当たりのコストで判断する必要がある。
この表では、両方の料金ページで公開されている項目だけを比較している。BeatAPIは現時点で200K以上のキャッシュ入力について独立した料金行を掲載していない。xAIでは、プロンプトが200Kトークンに達すると、そのリクエスト内の全トークンに長文コンテキスト料金が適用される。
BeatAPIでは、OpenAI Responses、Chat Completions、Anthropic Messages、Gemini互換の各形式からGrok 4.7を呼び出せる。既存システムがいずれかの形式に対応していれば、主な変更点はAPIキーとBase URLになる。
最新の料金とリクエスト仕様:BeatAPIのGrok 4.7 API
本番導入前に行うべき評価
公開チャートだけでデフォルトモデルを変更すべきではない。自社の現行モデルとGrok 4.7を、小規模かつ制御された条件で比較する。
1. 実タスクから評価セットを作る
実際のバックログから20〜50件を抽出し、簡単なもの、標準的なもの、失敗しやすいものを含める。秘密情報や顧客データは除去するが、難しさを生む構造は残す。
2. ハーネス条件を固定する
システムプロンプト、ツール定義、リポジトリのスナップショット、タイムアウト、最大ターン数、受け入れテストを固定する。ネイティブハーネス同士を比べる場合は別実験として明記する。
3. xhighだけで判断しない
xhighは難しいタスクに向くが、本番の標準設定として常に最適とは限らない。少なくともhighとxhigh、簡単なルーティングではmediumも比較し、追加の推論がトークンと遅延に見合う成功率向上を生むか確認する。
複数ターンのエージェントループでは、xAIが推奨する安定したprompt_cache_keyを設定する。Chat Completionsではx-grok-conv-idを利用できる。設定しない場合、関連リクエストがキャッシュのないサーバーに送られ、入力全体が通常料金になる可能性がある。長時間かつツール利用の多いセッションでは、Context Compactionも別条件で評価したい。
4. タスク台帳を残す
各試行について、以下を記録する。
- 成果物が受け入れ基準を満たしたか
- 入力、キャッシュ入力、出力トークン
- 実行時間
- ツール呼び出しと再試行の回数
- 失敗分類
- 人間によるレビュー時間
- 最終的なドルコスト
5. 合格した成果物当たりのコストで比較する
最も成功率が高いモデル、あるいは最もトークン単価が安いモデルが、そのまま勝者とは限らない。必要な品質を満たしたうえで、コスト、遅延、運用時の予測しやすさを比べる。
Grok 4.7を今すぐ試す価値があるチーム
次の条件に当てはまるなら、Grok 4.7を評価候補に加える価値が高い。
- 長時間のコーディングやターミナル作業が多い
- Cursorを利用している、またはGrok Buildを試したい
- エージェントが文書、分析、表計算、プレゼンを作成する
- 500Kのコンテキストが実際の業務で役立つ
- 感覚ではなく受け入れ基準で完了品質を測定できる
一方、現行モデルがすでに合格タスク当たりのコストで勝っている場合、標準化評価でより高い性能が必要な場合、あるいは出力長の予測可能性を重視する場合は、リリース直後という理由だけで切り替える必要はない。
結論
Grok 4.7は、あらゆるベンチマークで首位に立つモデルではない。それでも、コーディングや知識労働のエージェントで第一候補になる可能性を十分に示した。
評価すべき根拠は単一の総合点ではない。ネイティブハーネスで改善したコーディング性能、長時間タスクでの成果物品質、開発者向けの広い配布経路、そして競争力のあるAPI価格の組み合わせだ。同時に、xhighでは出力トークンが大きくなるという注意点も明確に存在する。
実際に使うシステム全体を評価し、ハーネスを明記する。合格した成果物を数え、再試行と推論トークンも記録する。そのうえで、Grok 4.7を第一候補にする価値があるかを決めたい。
公式リスト価格をそのまま支払わずに比較評価を始めたい場合、BeatAPIでは現在、Grok 4.7の対応トークン料金をxAI公式価格の35%で提供している。