
1. はじめに
2026 年 11 月 6 日に公開された ClickHouse 26.10 のリリースブログ1で、JOIN の ON 句に任意の条件を書けるようになったことが紹介されました。26.10 では、等号も不等号の組も無い条件を、すべての行の組を調べる block nested loop join(以下 block nested loop)というアルゴリズムで実行します。ブログはこのアルゴリズムの性質を次のように書いています。
can be as slow as a cross join and is used as a last resort
CROSS JOIN と同じくらい遅くなることがあるので、ほかのアルゴリズムで実行できないときの最後の手段として使う、という説明です。
OLAP で等号の無い JOIN といえば、範囲で突き合わせる JOIN です。たとえば、注文にその時点で有効だった価格を付ける処理や、アクセスログの IP アドレスにそれを含む範囲の国を付ける処理です。ただ、公式 Docs2 を読むと、デフォルトの設定では BETWEEN のような不等号 2 つの条件は ie_join という別のアルゴリズムで実行され、block nested loop で実行されるのはそれ以外の条件だけです。26.10 で新しく入ったのは、それ以外の条件の実行のしかたです。読者に関係するのは「同じ突き合わせでも、ON 句の書き方によってどのアルゴリズムで実行され、どれだけ時間が違うか」のほうだと考え、手元の PC で 26.10 を動かして試してみました。
同じ JOIN の SQL を ClickHouse の 6 つのビルド(24.8〜26.10.3.7)で実行して成否・時間・メモリを比べた先行の検証3があります。不等号の組の JOIN が 26.8 からデフォルトで ie_join の候補に入ったこと、関数のような任意の式を書いた LEFT JOIN は 26.8 まではエラーで 26.10 で実行できるようになったことは、そちらでバージョンごとに確かめられています。この記事ではバージョンを比べず、26.10 の 1 つのビルドで、範囲の JOIN のよくある使い方ごとに「書き方 → アルゴリズム → 時間」を見ます。
この記事で使う用語を先に決めておきます。
| 用語 | 意味 |
|---|---|
| ファクト表 | 範囲で突き合わせる側の表(注文・アクセスログ)。FROM に書く表で、LEFT JOIN では行を残す側。どれも 1,000 万行 |
| ディメンション表 | 1 行が 1 つの範囲を持つ表。今回は価格の有効期間の表(価格表)と、IP アドレスの範囲の表(IP 範囲の表)。大きさは行数で書く |
| ie_join | 不等号 2 つの条件を、ソートを使って突き合わせる結合のアルゴリズム。表の下で説明する |
| CROSS JOIN+フィルタ | ファクト表とディメンション表のすべての行の組を作ってから、ON の条件で絞る実行のしかた。実行計画では Type: cross と出る |
ie_join は、ON 句に 2 つの表の列どうしを比べる不等号が 2 つある JOIN を、ソートを使って突き合わせるアルゴリズムです。不等号の JOIN を速くするために論文で提案された IEJoin4 を実装したもので、すべての行の組を調べる block nested loop と違い、両方の入力をソートしてから突き合わせます。公式 Docs5 によると、ie_join はデフォルトの join_algorithm の候補の並びで最後にあるので、等号の条件があると hash join が先に選ばれ、ie_join は等号の条件が無いときだけ使われます。
1.1. 結論(先出し)
- JOIN のアルゴリズムは
ON句の書き方で決まった。デフォルトの設定では、商品 ID の等号+有効期間の範囲は hash join、BETWEENだけなら ie_join、関数で判定すると INNER は CROSS JOIN+フィルタ、LEFT は 26.10 で入った block nested loop になる - ファクト表 1,000 万行(合成データ)で、ディメンション表を 1 万〜100 万行にしても、等号+範囲は 0.33〜1.04 秒、
BETWEENは 0.7 秒前後だった。Dictionary では、IP の範囲(ip_trie)が同じ行数・同じ結合の種類の ie_join より約 2.4〜5 倍速かった。有効期間の価格(range_hashed)は区間の両端を含んでおり、終わりの時刻を 1 秒前にして作らないと境界の注文に前の期間の価格が付いた - ie_join は、ディメンション表の行数が少ないと遅かった(ディメンション表 10 行で約 40 秒)。
join_algorithm = 'hash'で ie_join を候補から除くとディメンション表 10 行で 0.10〜0.18 秒になった。ie_join のほうが速くなるディメンション表の行数は、この PC・ファクト表 1,000 万行では INNER で 200〜500 行、LEFT で 500〜1,000 行の間だった - 関数で書くとディメンション表 1,000 行で 50〜85 秒かかり、1 万行では 300 秒で打ち切った。同じアルゴリズムでも、条件を整数の比較(
BETWEEN)にするとディメンション表 100 行で INNER は約 12 倍、LEFT は約 20 倍速かった
1.2. 検証ゴール
| # | 確かめること | 確認できれば OK の条件 |
|---|---|---|
| 1 | 同じ突き合わせでも、ON 句の書き方によってどのアルゴリズムで実行されるか |
有効期間・BETWEEN・関数の 3 つの書き方の INNER と LEFT(6 通り)で、実行計画に出たアルゴリズム名が分かっている |
| 2 | ディメンション表を大きくしたとき、時間がどう伸びるか。Dictionary と比べてどうか | 価格表と IP 範囲の表をそれぞれ 1 万・10 万・100 万行にして時間が取れ、Dictionary と件数・合計値が一致したうえで並べられる |
| 3 | ディメンション表の行数が少ないとき、BETWEEN の時間がどう変わるか。ie_join を候補から除くとどうなるか |
ディメンション表を 10〜1,000 行にして ie_join と ie_join を除いた場合の時間が取れ、どの行数で速さが入れ替わるかが分かっている |
| 4 | 関数で書いて、すべての行の組を調べる実行のしかたになったとき、ディメンション表の行数でどれだけ時間が伸びるか | ディメンション表の行数を増やしながら 300 秒で止まる手前までの時間が取れ、BETWEEN の書き方との倍率が分かっている |
2. 検証環境
| 項目 | 内容 |
|---|---|
| ClickHouse | 26.10.2.103(GitHub Releases の単体バイナリ。clickhouse server を 1 台) |
| 実行場所 | 手元の PC の WSL2(Ubuntu)、16 コア、メモリ 7.6 GiB |
join_algorithm |
direct,parallel_hash,hash,ie_join(デフォルトのまま) |
allow_block_nested_loop_join |
1(デフォルトのまま) |
| データ | 乱数で作った合成データ。ファクト表はどれも 1,000 万行 |
26.10.2.103 は 2026 年 11 月 8 日の時点で GitHub Releases の最新の安定リリースでした。先行の検証が使った 26.10.3.7 は、この時点の Releases の一覧にありませんでした。
join_algorithm は、どの結合のアルゴリズムを候補にするかを並べる設定です。公式 Docs5 はデフォルトを direct,hash,ie_join と書いていますが、このビルドの system.settings では parallel_hash が入っていました。以下の結果はこのビルドのデフォルトでの値です。
データは実データではなく、値を乱数で作った合成データです。範囲の重なりや偏りが無い形なので、時間の絶対値より、書き方による違いと、行数を増やしたときの伸び方を見てください。突き合わせる表は次の 2 組です。作り方は 7.1 章に書きました。
| ファクト表 | ディメンション表 | 突き合わせ |
|---|---|---|
orders(注文。sku・ts・qty) |
prices(価格表。sku・valid_from・valid_to・price) |
商品 ID が等しく、注文の時刻が有効期間に入るか |
access_log(アクセスログ。ip・bytes) |
ip_ranges(IP 範囲の表。範囲の始まりと終わりの整数 ip_from・ip_to、1.0.0.0/24 のような CIDR の文字列 cidr、country) |
IP アドレスが範囲に入るか |
3. ON 句の書き方とアルゴリズムの対応
ON 句の 3 つの書き方を、INNER と LEFT でそれぞれ実行し、EXPLAIN PLAN actions = 1 に出たアルゴリズムを並べると次のとおりです。
| 書き方 |
ON 句 |
INNER | LEFT |
|---|---|---|---|
| 等号+範囲(有効期間の価格) | o.sku = p.sku AND o.ts >= p.valid_from AND o.ts < p.valid_to |
hash join のあとに範囲のフィルタ | hash join(範囲は結合の中で判定) |
| 範囲だけ(IP 範囲の表) | l.ip BETWEEN r.ip_from AND r.ip_to |
ie_join | ie_join |
| 関数で判定 | isIPAddressInRange(IPv4NumToString(l.ip), r.cidr) |
CROSS JOIN+フィルタ | block nested loop |
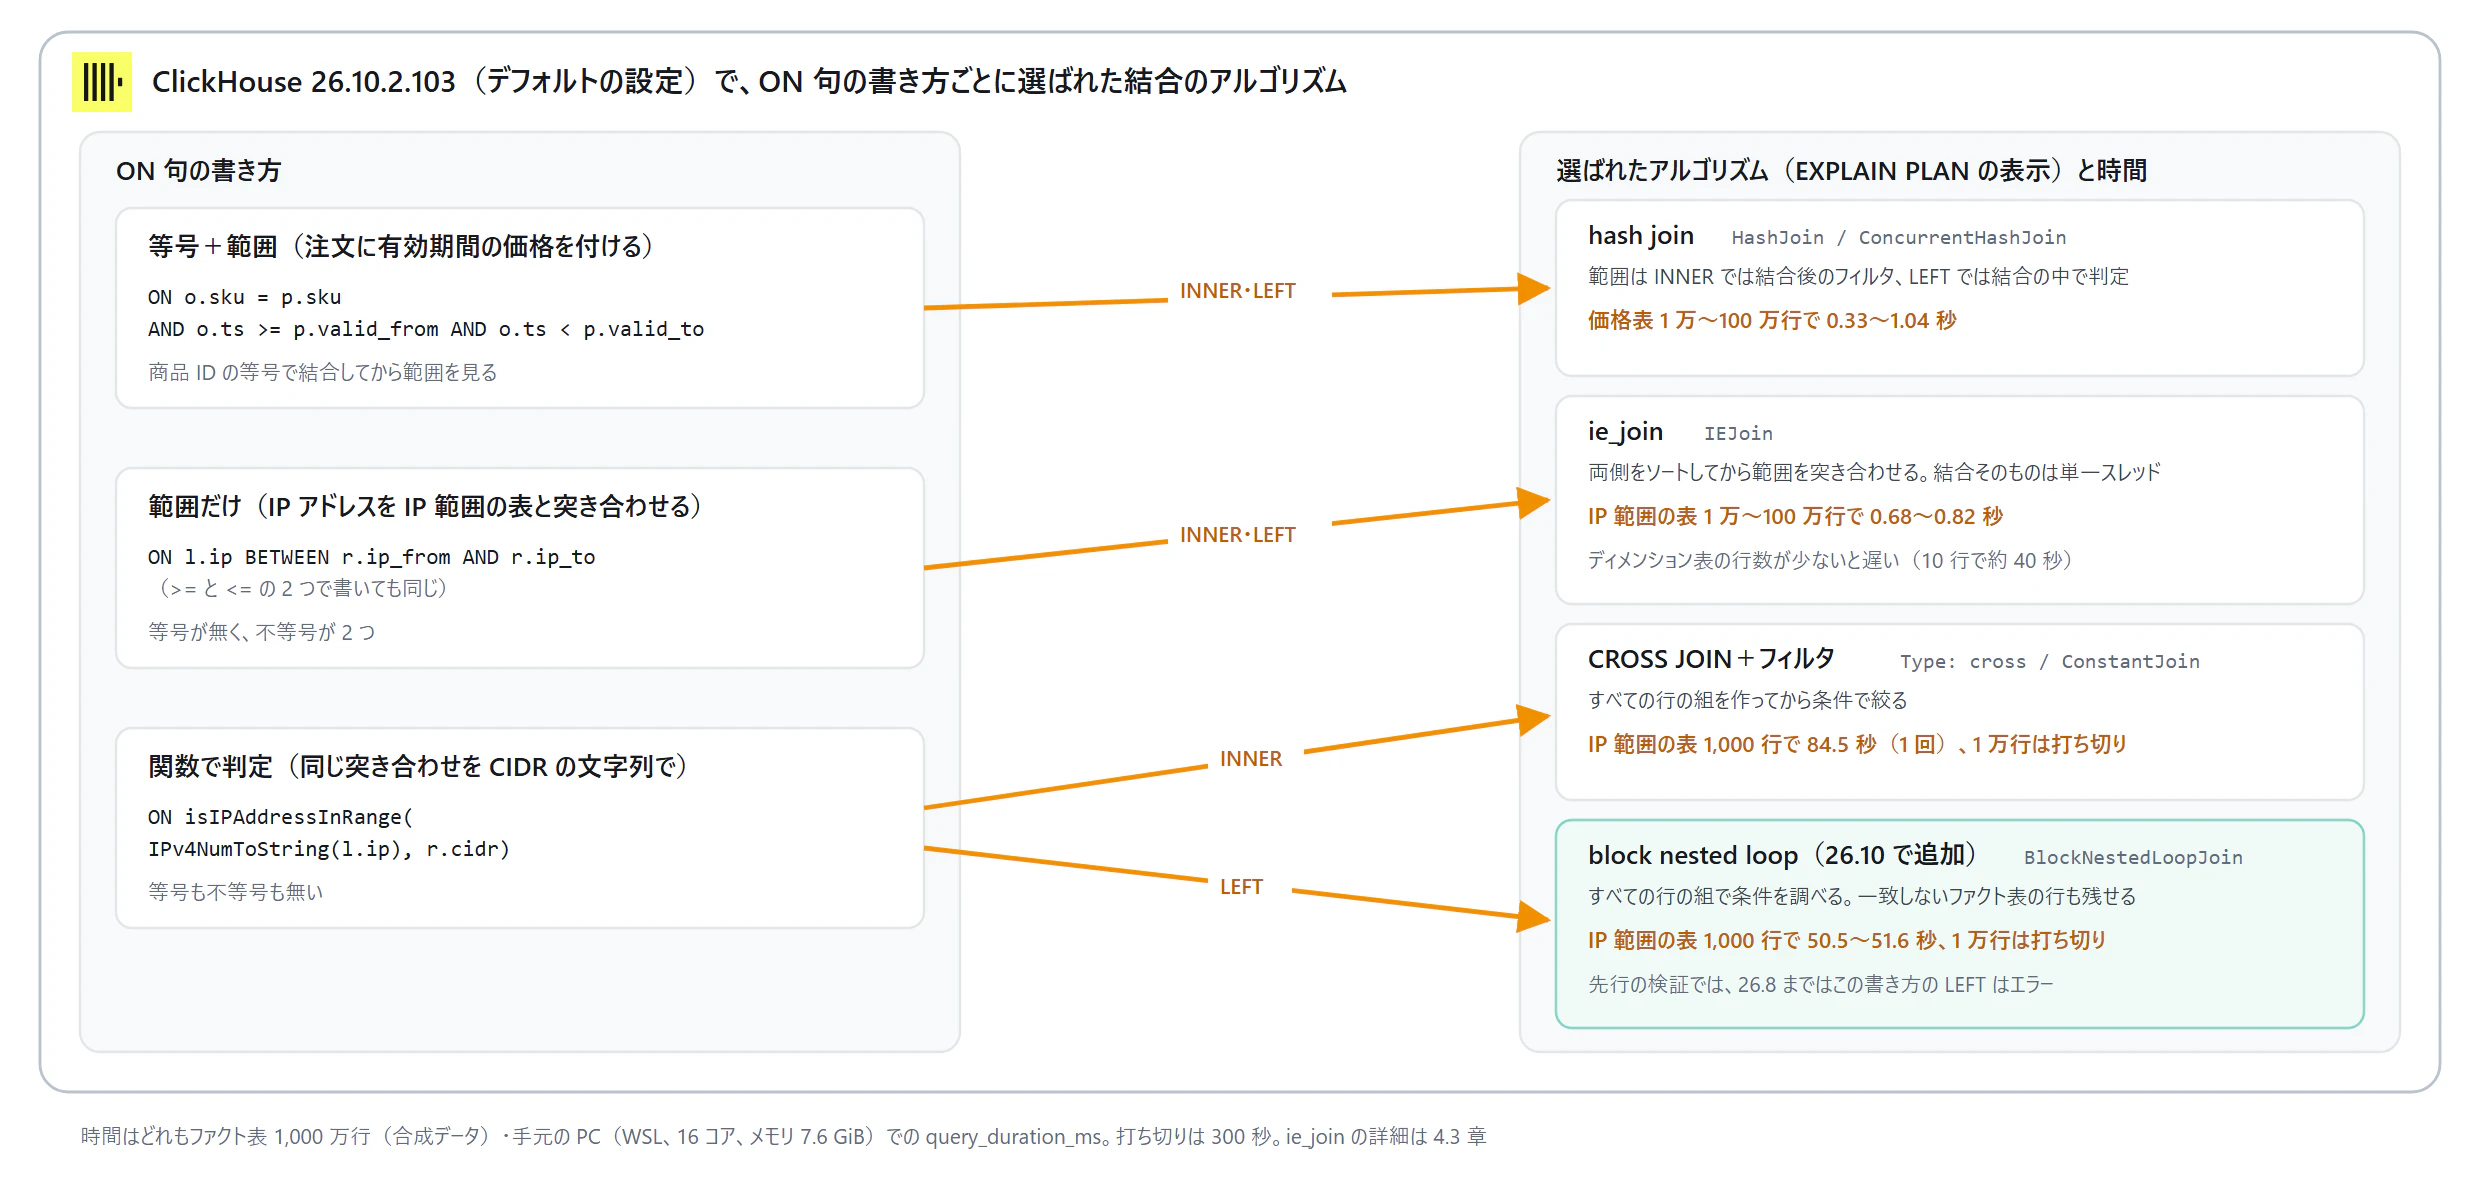
図 1: ON 句の書き方ごとに選ばれた結合のアルゴリズム
今回の等号+範囲の書き方は、範囲の条件が付いていても hash join で実行されました。等号が無く不等号が 2 つの書き方は ie_join です。BETWEEN でなく >= と <= の 2 つで書いても同じでした。
関数で判定する書き方は、INNER と LEFT で経路が分かれました。INNER は 26.10 で入った block nested loop ではなく、すべての行の組を作ってから関数で絞る形(Type: cross、Algorithm: ConstantJoin)です。block nested loop になったのは LEFT だけでした。allow_block_nested_loop_join = 0 にすると、6 通りのうちエラーになるのもこの LEFT だけです。
Code: 403. DB::Exception: Received from localhost:19000. DB::Exception: Cannot determine join keys in JOIN ON expression isIPAddressInRange(IPv4NumToString(__table1.ip), __table2.cidr), set allow_block_nested_loop_join = 1 to execute it as a block nested loop join. (INVALID_JOIN_ON_EXPRESSION)
実行計画では、アルゴリズムの名前が次のように出ます(数十行の最小のデータで取った抜粋)。
-- 等号+範囲の INNER
└──Filter (Post Join Actions)
   │  Filter column: ts >= valid_from AND ts < valid_to
   └──Join (JOIN FillRightFirst)
      │  Type: inner | Strictness: all | Algorithm: SpillingHashJoin(HashJoin)

-- 範囲だけの LEFT
└──IEJoin
   │  Type: LEFT
   │  Conditions: __table1.ip >= __table2.ip_from AND __table1.ip <= __table2.ip_to

-- 関数で判定する LEFT
└──BlockNestedLoopJoin
   │  Type: LEFT
   │  Strictness: ALL
   │  Condition: isIPAddressInRange(IPv4NumToString(ip), cidr)
hash join は、価格表が 10 万行以上になると ConcurrentHashJoin(並列の hash join。system.query_log では PARALLEL_HASH)に変わりましたが、ほかのアルゴリズムはディメンション表の大きさで変わりませんでした。
なお、system.query_log の used_join_algorithms 列には、hash join・ie_join・CROSS JOIN+フィルタはそれぞれ HASH(または PARALLEL_HASH)・IE_JOIN・CONSTANT と出ますが、block nested loop のときは空の配列で、used_number_of_joins も 0 でした。block nested loop で実行されたかどうかは、実行計画で確かめる必要があります。
4. 場面ごとの結果
よくある 2 つの使い方(有効期間の価格・IP の範囲)を、デフォルトの設定で実行した結果から見ていきます。そのあと、遅くなる 2 つの場面(ディメンション表の行数が少ないとき・関数で書いたとき)と、Dictionary から取り出す場合を見ます。全サイズの表は 7 章の付録にまとめました。
4.1. 有効期間の価格を注文に付けるとき
注文 1,000 万行に、商品ごとに有効期間が重ならない 5 つの価格を持つ価格表を突き合わせました。
SELECT count() AS cnt, sum(p.price * o.qty) AS revenue, countIf(p.sku = 0) AS unmatched
FROM orders AS o
LEFT JOIN prices AS p
  ON o.sku = p.sku AND o.ts >= p.valid_from AND o.ts < p.valid_to
価格表を 1 万・10 万・100 万行と大きくしても、INNER で 0.37〜0.89 秒、LEFT で 0.33〜1.04 秒でした。メモリは 30〜172 MiB で、価格表が大きいほど増えます。商品 ID の等号で hash join を行い、そのあとに範囲を見る形です。1 つの商品に一致する価格は 5 行だけです。
LEFT で範囲の条件を ON に書いても、hash join のまま実行されました。価格の無い注文(約 1.5%)を含めた件数・合計は、7.3 章で照合しています。
4.2. IP の範囲を BETWEEN で突き合わせるとき
アクセスログ 1,000 万行に、/24 の IP 範囲の表を突き合わせました。ログの 99% はどれかの範囲に入り、1% はどの範囲にも入らない IP です。
SELECT count() AS cnt, sum(l.bytes) AS total_bytes, countIf(r.cidr = '') AS unmatched
FROM access_log AS l
LEFT JOIN ip_ranges AS r
  ON l.ip BETWEEN r.ip_from AND r.ip_to
この PC・ファクト表 1,000 万行・偏りの無い合成データでは、IP 範囲の表を 1 万・10 万・100 万行にしても、時間は INNER で 0.68〜0.82 秒、LEFT で 0.68〜0.74 秒とほとんど変わりませんでした。
メモリはディメンション表の行数に関係なく 472〜510 MiB でした。公式 Docs5 には、ie_join は両方の入力をメモリに溜めてから結合すると書かれています。
4.3. ディメンション表の行数が少ないとき
4.2 章と同じ形でディメンション表の行数を 10〜1,000 行に減らして測ると、行数が少ないほど ie_join は遅くなり、10 行では約 40 秒かかりました(行数ごとの値は 7.5 章)。7.5 章のディメンション表 100 行の回で CPU 時間を見ると 5.4〜5.6 秒で、経過時間(4.65〜4.85 秒)と同じくらいでした。公式 Docs5 には、ie_join の結合そのものは単一スレッドで、並列に動くのは前段のソートだけと書かれています。
そこで、join_algorithm = 'hash' で ie_join を候補から除いて実行しました。
SELECT count() AS cnt, sum(l.bytes) AS total_bytes, countIf(r.cidr = '') AS unmatched
FROM access_log AS l
LEFT JOIN ip_ranges AS r
  ON l.ip BETWEEN r.ip_from AND r.ip_to
SETTINGS join_algorithm = 'hash'
公式 Docs5 には、ie_join が候補に無いとき、不等号だけの INNER JOIN はフィルタ付きの CROSS JOIN で、それ以外の結合の種類は block nested loop で実行すると書かれています。今回も実行計画は、INNER が CROSS JOIN+フィルタ(Type: cross)、LEFT が BlockNestedLoopJoin でした。
ファクト表 1,000 万行で、ie_join と ie_join を除いた場合を同じ回に測ると次のとおりです。
| ディメンション表の行数 | ie_join INNER | ie_join を除いた INNER(CROSS JOIN+フィルタ) | ie_join LEFT | ie_join を除いた LEFT(block nested loop) |
|---|---|---|---|---|
| 10 行 | 40.58〜42.25 秒 | 0.15〜0.18 秒 | 37.44〜38.56 秒 | 0.10〜0.11 秒 |
| 100 行 | 4.33〜4.41 秒 | 0.54〜0.56 秒 | 4.28〜4.36 秒 | 0.20〜0.23 秒 |
| 200 行 | 2.59〜2.76 秒 | 1.97〜2.55 秒 | 2.54〜2.56 秒 | 0.31〜0.35 秒 |
| 500 行 | 1.36〜1.40 秒 | 2.28〜2.38 秒 | 1.39〜1.55 秒 | 0.64〜0.74 秒 |
| 1,000 行 | 0.99〜1.06 秒 | 9.32〜10.46 秒 | 1.01〜1.17 秒 | 1.26〜1.35 秒 |

図 2: ディメンション表の行数が少ないときの ie_join と、ie_join を除いた場合(縦軸は対数目盛り)
ディメンション表 10 行では、ie_join を除くと INNER が約 220〜280 倍、LEFT が約 340〜390 倍速くなりました。メモリも 21 MiB 以下に下がります。
ただ、ie_join を除いた側は、ディメンション表の行数が増えると時間が伸びました(INNER の 200 行から 500 行は横ばい)。ie_join のほうが速くなったのは、INNER で 200〜500 行の間、LEFT で 500〜1,000 行の間でした。これはこの PC・ファクト表 1,000 万行での目安で、ファクト表の行数や PC が違う場合の境目は測っていません。どちらもすべての行の組を調べますが、LEFT の block nested loop は INNER の CROSS JOIN+フィルタより伸びが緩く、1,000 行で 1.26〜1.35 秒と 9.32〜10.46 秒の差がありました。
どのディメンション表の行数でも、ie_join と ie_join を除いた場合の件数・合計・一致しなかった件数は一致しました。
4.4. 関数で書いたとき
4.2 章と同じ突き合わせを、CIDR の文字列と isIPAddressInRange で書きました。IP の範囲を CIDR の文字列で持っている表で使える書き方です。
SELECT count() AS cnt, sum(l.bytes) AS total_bytes, countIf(r.cidr = '') AS unmatched
FROM access_log AS l
LEFT JOIN ip_ranges AS r
  ON isIPAddressInRange(IPv4NumToString(l.ip), r.cidr)
次の表の BETWEEN の 2 列は関数の書き方と同じ回に測った値です。
| ディメンション表の行数 | 関数・INNER(CROSS JOIN+フィルタ) | 関数・LEFT(block nested loop) |
BETWEEN・INNER(ie_join) |
BETWEEN・LEFT(ie_join) |
|---|---|---|---|---|
| 100 行 | 6.52〜6.73 秒 | 4.32〜4.35 秒 | 4.46〜4.54 秒 | 4.48〜4.53 秒 |
| 1,000 行 | 84.55 秒(1 回) | 50.52〜51.56 秒 | 0.99〜1.11 秒 | 1.03〜1.10 秒 |
| 1 万行 | 300 秒で打ち切り | 300 秒で打ち切り | 0.75〜0.95 秒 | 0.74〜0.78 秒 |
この表の計測では捨てる回を設けず、60 秒を超えたものは 1 回だけにしました(7.2 章)。

図 3: 関数で書いた場合と BETWEEN で書いた場合(縦軸は対数目盛り)
ディメンション表 1,000 行で、関数の書き方は BETWEEN と比べて INNER どうしで約 76〜85 倍、LEFT どうしで約 46〜50 倍かかり、1 万行ではどちらも 300 秒の上限(max_execution_time)で止まりました。ディメンション表 100 行では、BETWEEN の書き方と件数・合計・一致しなかった件数が一致しています。
条件の式による違いを見るため、4.3 章の ie_join を候補から除いた BETWEEN と、同じディメンション表 100 行・同じデータで比べました。
| アルゴリズム | 条件が BETWEEN
|
条件が関数 |
|---|---|---|
| CROSS JOIN+フィルタ(INNER) | 0.54〜0.56 秒 | 6.52〜6.73 秒 |
| block nested loop(LEFT) | 0.20〜0.23 秒 | 4.32〜4.35 秒 |
同じアルゴリズムでも、条件を整数の比較にすると INNER で約 12 倍、LEFT で約 20 倍速くなりました。関数の書き方では、すべての組(ディメンション表 100 行なら 10 億組)について、文字列への変換と isIPAddressInRange を含む条件の式を評価します。
CIDR の文字列しか無い表でも、範囲の始まりと終わりの列を作っておけば BETWEEN で書けます。今回の IP 範囲の表は先頭アドレスとプレフィックス長から IPv4CIDRToRange で始まりと終わりの列を作りました(7.1 章)。
4.5. Dictionary から取り出すとき
ClickHouse には参照用の表をメモリに載せ、関数で値を取り出す Dictionary があります。公式 Docs6 は参照表との JOIN より、Dictionary と関数を使うほうが簡単で効率的だとしています。範囲の突き合わせにはキー+範囲で取り出す range_hashed7 と、CIDR で取り出す ip_trie8 が使えます。
ディメンション表を大きくしたときの LEFT JOIN と、Dictionary で同じ結果を出すクエリ(LEFT 相当)の時間を図 4 に示します。値と INNER の結果は 7.4 章にあります。

図 4: ディメンション表を大きくしたときの LEFT JOIN と Dictionary(LEFT 相当)
IP の範囲(ip_trie)は IP 範囲の表 1 万〜100 万行で 0.14〜0.29 秒でした。同じ行数・同じ結合の種類の ie_join(0.68〜0.82 秒)と比べて約 2.4〜5 倍速く、クエリのメモリは 1 MiB 未満です。ただし Dictionary そのものが別にメモリを使います(IP 範囲の表 100 万行で 40 MiB)。4.3 章のディメンション表 10〜100 行でも、ip_trie から取り出すと 54〜91 ミリ秒で、件数・合計・一致しなかった件数は JOIN と一致しました(7.6 章)。
CREATE DICTIONARY d_ip (cidr String, country String)
PRIMARY KEY cidr
SOURCE(CLICKHOUSE(TABLE 'ip_ranges'))
LAYOUT(IP_TRIE) LIFETIME(0);

SELECT count() AS cnt, sum(bytes) AS total_bytes,
       countIf(NOT dictHas('d_ip', tuple(toIPv4(ip)))) AS unmatched
FROM access_log;
有効期間の価格(range_hashed)は、価格表 1 万行では 0.17〜0.19 秒と hash join(0.33〜0.46 秒)より速かったものの、10 万行で同程度、100 万行では 1.07〜1.23 秒と hash join(0.85〜1.04 秒)より遅くなりました。
26.10.2.103 の実測では、range_hashed は区間の両端を含んでいました。そのため valid_to をそのまま Dictionary にすると、境界の時刻の注文に前の期間の価格が付きました。
| 注文の時刻 | JOIN(ts < valid_to)の価格 |
Dictionary(valid_to そのまま)の価格 |
|---|---|---|
| 2026-02-01 00:00:00 | 110.5(2 月の価格) | 100.5(1 月の価格) |
| 2026-04-01 00:00:00 | 無し(期間外) | 220.5(3 月の価格) |
2 月 1 日 0 時の注文は 1 月と 2 月の 2 つの期間に一致し、デフォルトの range_lookup_strategy(min)で前の期間が返りました。公式 Docs7 には、端を含むかどうかは書かれていませんでした(2026 年 11 月時点)。有効期間を「終わりの時刻を含まない」形で持つ表から作るときは、終わりの時刻を 1 秒前にして Dictionary を作ると、JOIN と結果が一致しました(DateTime 型の場合)。
CREATE DICTIONARY d_price (sku UInt64, valid_from DateTime, valid_to DateTime, price Decimal(10,2))
PRIMARY KEY sku
SOURCE(CLICKHOUSE(QUERY 'SELECT sku, valid_from, valid_to - 1 AS valid_to, price FROM prices'))
LAYOUT(RANGE_HASHED())
RANGE(MIN valid_from MAX valid_to)
LIFETIME(0);
5. 考察
26.10 で新しく入ったのは block nested loop です。ClickHouse のソースでは、block nested loop の実行部分(BlockNestedLoopJoinStep)と設定 allow_block_nested_loop_join は 26.10.2.103 のタグにあり、26.9.9.28 のタグにはありません9。hash join・ie_join・Dictionary は 26.10 より前からある実行のしかたです。今回の結果を場面ごとにまとめ、26.10 で新しく入ったものがどこで使われたかを並べると次のとおりです。時間はどれもこの PC・ファクト表 1,000 万行での値です。
| 場面 | 書き方 | アルゴリズム | 今回の時間 | 26.10 で新しく入ったもの |
|---|---|---|---|---|
| 等号のキーがある(商品ごとの有効期間) | 等号+不等号をそのまま ON に書く |
hash join | 0.33〜1.04 秒(価格表 1 万〜100 万行) | なし |
| 等号が無く、ディメンション表の行数が多い |
BETWEEN で書く |
ie_join | 0.68〜0.82 秒(ディメンション表 1 万〜100 万行) | なし |
| 等号が無く、ディメンション表の行数が少ない |
BETWEEN + join_algorithm = 'hash'
|
CROSS JOIN+フィルタ(INNER)/block nested loop(LEFT) | 0.10〜0.56 秒(ディメンション表 10〜100 行) | LEFT の block nested loop |
| ディメンション表を Dictionary にして取り出す | Dictionary(ip_trie・range_hashed) | JOIN を使わない | 0.05〜1.23 秒 | なし |
| IP の範囲を CIDR の文字列で持っている | 始まりと終わりの列を作って BETWEEN で書く |
ie_join | 0.99〜1.11 秒(ディメンション表 1,000 行) | なし(関数で判定した LEFT は block nested loop で 50.52〜51.56 秒) |
block nested loop で実行されたのは、関数で判定した LEFT と、ie_join を候補から除いた BETWEEN の LEFT の 2 つでした。関数で判定した LEFT は先行の検証3で 26.8 まではエラーだった書き方で、26.10 では結果を返すようになりました。ただ、すべての行の組を調べるので、組の数と 1 組ごとの条件の式の重さで時間が伸び、ディメンション表 1,000 行で 50.52〜51.56 秒かかりました。同じ突き合わせを BETWEEN に直すと、ie_join で 1.03〜1.10 秒です。この点はブログの「最後の手段」という説明と合います。
一方で、ie_join を候補から除いた BETWEEN の LEFT は、ディメンション表の行数が少ないときに ie_join より速くなりました(ディメンション表 10 行で 0.10〜0.11 秒と 37.44〜38.56 秒)。今回の測定では、26.10 の block nested loop は、関数で書いた範囲 JOIN を速くしたのではなく、ディメンション表の小さい不等号の LEFT JOIN で ie_join より速い実行のしかたになりました。
6. まとめ
ClickHouse 26.10.2.103 で、同じ範囲の突き合わせを ON 句の 3 つの書き方で実行し、選ばれるアルゴリズムと時間を測りました。等号+範囲は hash join、BETWEEN は ie_join、関数は INNER が CROSS JOIN+フィルタ、LEFT が 26.10 で入った block nested loop になりました。この PC・ファクト表 1,000 万行・偏りの無い合成データでは、BETWEEN はディメンション表 1 万〜100 万行で 0.7 秒前後でしたが、10 行では約 40 秒かかり、ie_join を候補から除くと 0.10〜0.18 秒になりました。関数で書いた条件はディメンション表 1,000 行で 50 秒を超え、Dictionary は ip_trie が ie_join より約 2.4〜5 倍速く、range_hashed は区間の終わりを 1 秒前にして作る必要がありました。どのアルゴリズムで実行されたかは EXPLAIN PLAN actions = 1 で確かめられます。
7. 付録(データ・計測の方法と全データ)
7.1. データの作り方
どの表も MergeTree で、値は rand() で作りました。同じ値を複製して行数を増やすことはしていません。
| 表 | 行数 | 内容 |
|---|---|---|
prices(価格表) |
1 万・10 万・100 万行 | 商品数は行数の 5 分の 1。各商品に、2026 年内で重ならず隙間の無い 5 つの期間と価格 |
orders(注文) |
1,000 万行 | 商品 ID は商品数の 1.01 倍の範囲から一様(約 1% は価格表に無い商品)。時刻は 2026 年内、約 0.5% は 2027 年(期間外) |
ip_ranges(IP 範囲の表) |
10 行〜100 万行 | 1.0.0.0 から連続する /24。先頭アドレスとプレフィックス長から IPv4CIDRToRange で始まりと終わりの整数の列を作り、CIDR の文字列の列も持つ |
access_log(アクセスログ) |
1,000 万行(7.5 章の一部は 10 万・100 万行) | 99% は IP 範囲の表のどれかの範囲に入る IP、1% はどの範囲にも入らない IP。IP 範囲の表の行数ごとに作る |
価格表と注文は、価格の無い注文が約 1.5%(商品が無い約 1%+期間外の約 0.5%)になるようにしました。LEFT と INNER で件数が変わるようにするためです。
7.2. 計測の方法
時間は system.query_log の query_duration_ms、メモリは同じ行の memory_usage です。クライアント側の --time も記録し、両者が合っていることを確かめました。どのクエリにも max_memory_usage = 5000000000 と max_execution_time を付け、基本は 1 回実行して捨て、続けて 3 回実行しました。表ごとの違いは次のとおりです。
| 載せた表 | 捨てる回 | max_execution_time |
|---|---|---|
| 7.4 章・7.5 章(4.1・4.2・4.5 章の値と、4.3 章の CPU 時間) | あり | 600 秒 |
| 4.3 章・7.6 章 | あり | 300 秒 |
4.4 章の最初の表(関数の書き方と、同じ回に測った BETWEEN) |
なし(60 秒を超えたものは 1 回だけ) | 300 秒 |
同じ条件でも、表によって最大 1 割強違います(ディメンション表 100 行の ie_join の INNER で、7.5 章は 4.65〜4.85 秒、4.3 章は 4.33〜4.41 秒)。
時間を並べる前に、同じデータで JOIN と Dictionary(または別のアルゴリズム)の件数・合計・一致しなかった件数を照合しました(7.3 章)。
7.3. 結果の照合
有効期間の価格(価格表 100 万行)と IP の範囲(IP 範囲の表 100 万行)の例です。ほかのサイズもすべての組み合わせで一致しました。
| 書き方 | 件数 | 合計 | 一致しなかった件数 |
|---|---|---|---|
| 価格・INNER JOIN | 9,851,986 | 27,110,131,366.53 | 0 |
| 価格・LEFT JOIN | 10,000,000 | 27,110,131,366.53 | 148,014 |
| 価格・range_hashed Dictionary(LEFT 相当) | 10,000,000 | 27,110,131,366.53 | 148,014 |
| IP・INNER JOIN | 9,899,612 | 495,112,102,993 | 0 |
| IP・LEFT JOIN | 10,000,000 | 500,131,995,817 | 100,388 |
| IP・ip_trie Dictionary(LEFT 相当) | 10,000,000 | 500,131,995,817 | 100,388 |
range_hashed が区間の両端を含むこと(4.5 章)は、この照合の前に、数十行の最小のデータで JOIN と Dictionary の件数を比べたときに見つかりました(INNER JOIN が 36 件、Dictionary が 37 件)。
7.4. ディメンション表の大きさと時間(4.1・4.2・4.5 章)
ファクト表 1,000 万行、3 回の最小〜最大です。列の 1 万・10 万・100 万はディメンション表(価格表・IP 範囲の表)の行数です。
| パターン | 1 万 | 10 万 | 100 万 | メモリ |
|---|---|---|---|---|
| 価格・INNER(hash join) | 0.37〜0.46 秒 | 0.46〜0.54 秒 | 0.85〜0.89 秒 | 45〜172 MiB |
| 価格・LEFT(hash join) | 0.33〜0.38 秒 | 0.41〜0.42 秒 | 0.98〜1.04 秒 | 30〜135 MiB |
| 価格・range_hashed Dictionary(INNER 相当) | 0.19 秒 | 0.42〜0.44 秒 | 1.15〜1.23 秒 | 1 MiB 未満 |
| 価格・range_hashed Dictionary(LEFT 相当) | 0.17〜0.18 秒 | 0.32〜0.34 秒 | 1.07〜1.08 秒 | 1 MiB 未満 |
| IP・INNER(ie_join) | 0.73〜0.82 秒 | 0.68〜0.69 秒 | 0.69〜0.70 秒 | 472〜487 MiB |
| IP・LEFT(ie_join) | 0.71〜0.73 秒 | 0.68〜0.69 秒 | 0.71〜0.74 秒 | 487〜510 MiB |
| IP・ip_trie Dictionary(INNER 相当) | 0.18 秒 | 0.19〜0.23 秒 | 0.29 秒 | 1 MiB 未満 |
| IP・ip_trie Dictionary(LEFT 相当) | 0.14〜0.16 秒 | 0.19 秒 | 0.28〜0.29 秒 | 1 MiB 未満 |
Dictionary のメモリはクエリの memory_usage で、Dictionary そのもの(system.dictionaries の bytes_allocated)は含みません。Dictionary そのものは価格表 100 万行で 138 MiB、IP 範囲の表 100 万行で 40 MiB でした。
7.5. ファクト表の行数・ディメンション表の行数と ie_join の時間(4.3 章)
ディメンション表の行数を変えずにファクト表を減らした行も含みます。範囲 1 つあたりの一致行は、ディメンション表の 1 行(範囲 1 つ)に入るファクト表の行数で、ファクト表の行数 × 0.99 ÷ ディメンション表の行数で出した値です。
| ディメンション表の行数 | ファクト表の行数 | 範囲 1 つあたりの一致行 | INNER | LEFT |
|---|---|---|---|---|
| 10 行 | 1,000 万 | 約 99 万 | 40.03〜41.65 秒 | 39.92〜40.47 秒 |
| 50 行 | 1,000 万 | 約 19.8 万 | 8.51〜8.60 秒 | 8.42〜8.57 秒 |
| 100 行 | 1,000 万 | 約 9.9 万 | 4.65〜4.85 秒 | 4.54〜4.73 秒 |
| 200 行 | 1,000 万 | 約 4.95 万 | 2.62〜2.66 秒 | 2.57〜2.67 秒 |
| 500 行 | 1,000 万 | 約 1.98 万 | 1.42〜1.62 秒 | 1.41〜1.46 秒 |
| 1,000 行 | 1,000 万 | 約 9,900 | 1.03〜1.05 秒 | 1.03〜1.10 秒 |
| 100 行 | 100 万 | 約 9,900 | 0.09〜0.10 秒 | 0.09〜0.10 秒 |
| 100 行 | 10 万 | 約 990 | 7〜8 ミリ秒 | 8〜10 ミリ秒 |
| 10 行 | 10 万 | 約 9,900 | 11〜13 ミリ秒 | 10〜11 ミリ秒 |
範囲 1 つあたりの一致行を約 9,900 にそろえた 3 点(ファクト表 10 万・100 万・1,000 万行)は、約 0.01 → 0.1 → 1 秒と伸びました。メモリはファクト表 1,000 万行のとき、ディメンション表の行数に関係なく 466〜496 MiB でした。
7.6. ie_join を候補から除いた場合と Dictionary(4.3・4.5 章)
ファクト表 1,000 万行、3 回の最小〜最大です。Dictionary はディメンション表 200 行以上では測っていません。
| ディメンション表の行数 | ie_join INNER | ie_join を除いた INNER | Dictionary(INNER 相当) | ie_join LEFT | ie_join を除いた LEFT | Dictionary(LEFT 相当) |
|---|---|---|---|---|---|---|
| 10 行 | 40.58〜42.25 秒 | 0.15〜0.18 秒 | 55〜84 ミリ秒 | 37.44〜38.56 秒 | 0.10〜0.11 秒 | 54〜59 ミリ秒 |
| 50 行 | 7.93〜8.02 秒 | 0.32〜0.33 秒 | 76〜82 ミリ秒 | 8.10〜8.28 秒 | 0.16〜0.18 秒 | 75〜86 ミリ秒 |
| 100 行 | 4.33〜4.41 秒 | 0.54〜0.56 秒 | 84〜91 ミリ秒 | 4.28〜4.36 秒 | 0.20〜0.23 秒 | 82〜90 ミリ秒 |
| 200 行 | 2.59〜2.76 秒 | 1.97〜2.55 秒 | 未計測 | 2.54〜2.56 秒 | 0.31〜0.35 秒 | 未計測 |
| 500 行 | 1.36〜1.40 秒 | 2.28〜2.38 秒 | 未計測 | 1.39〜1.55 秒 | 0.64〜0.74 秒 | 未計測 |
| 1,000 行 | 0.99〜1.06 秒 | 9.32〜10.46 秒 | 未計測 | 1.01〜1.17 秒 | 1.26〜1.35 秒 | 未計測 |
参考
ClickHouse、ClickHouse のロゴ、および関連するマークは、ClickHouse, Inc. またはその関連会社の商標または登録商標です(clickhouse.com)。
-
ClickHouse release 26.10(ClickHouse 公式ブログ、2026-11-06。JOINs with arbitrary conditions の節) ↩
-
JOIN Clause(ClickHouse の公式 Docs。JOIN with inequality conditions for columns from different tables・JOIN with an arbitrary ON condition の節) ↩
-
workload/join-across-versions: the same JOIN SQL on six ClickHouse builds(litkhai/clickhouse-hols の PR #105。同じ JOIN の SQL を 24.8〜26.10.3.7 の 6 ビルドで比べた検証) ↩ ↩2
-
Lightning Fast and Space Efficient Inequality Joins(Khayyat ほか、PVLDB Vol. 8。IEJoin を提案した論文で、公式 Docs の join_algorithm の説明からリンクされている) ↩
-
JOIN settings(ClickHouse の公式 Docs。join_algorithm の ie_join の説明。候補に無いときの実行のしかた・入力をメモリに溜めること・単一スレッドで結合すること) ↩ ↩2 ↩3 ↩4 ↩5
-
CREATE DICTIONARY(ClickHouse の公式 Docs。冒頭の説明に Dictionary と JOIN の比較) ↩
-
range_hashed dictionary layout types(ClickHouse の公式 Docs。キー+範囲で取り出す Dictionary と range_lookup_strategy) ↩ ↩2
-
allow_block_nested_loop_join の定義(ClickHouse のソース、v26.10.2.103-stable の Settings.cpp。v26.9.9.28-stable の Settings.cpp には無く、
src/Processors/QueryPlan/BlockNestedLoopJoinStep.cppも 26.10 のタグにだけある) ↩