
第11回 EVO-X2(Ryzen AI Max+ 395 / 128GB)+ Qwen3.8-Flash-Next用のllama.cpp改造でベースを入れ替えてMTPを調査した話 の続き。
第11回では、MTPを入れたらTGが遅くなるという本末転倒な現象を修正した。
今回は、llama.cpp改造をはじめる前から気になっていた「MTPを入れるとPPが遅くなる」現象について調べた。
第11回の最初にもベースのllama.cppを公式(upstream)の最新版(当時)に入れ替えたが、今回も最初にベース入れ替え→第11回とそれ以前に入れた高速化パッチを移植してから本題をスタートしている。
本題の調査を始めた後も番外編6で書いたP-MODEボタンの罠にハマったりして、色々迷走している。
そろそろ「ベース入れ替え→過去の高速化パッチ移植→動作確認→速度チェック」ぐらいまでは自動化したい気もする。まだ手動でポチポチしている原始人です(笑)
以降、Prompt Processing(入力を読み込む処理)をPP、Token Generation(出力生成)をTGと表記する。どちらも単位はtok/sで、高いほど速い。
結論
MTPのPP低下には、Draft側で出力が不要なのに通常のAttentionなどが実行されていたことが関係していた。そこで、DraftのK/V cache更新に必要な計算だけを行う専用経路を作ったところ、PPが改善した。
- Stage B(DraftのKV-only経路):r5のP-MODE固定後の比較で、64k +3.59%、128k +6.71%
-
mtp_eh_projflatten:Stage Bを有効にした状態から、さらに64k +1.39%、128k +1.40%
その後、upstreamを入れ替えた統合版(r6)でもVulkanでのPP改善を再確認した。統合版のMTP OFF/ON比較では、64k・128kともMTP ONのPPがMTP OFFを上回る数値も得られた。
検証環境
| 項目 | 内容 |
|---|---|
| PC | GMKtec NucBox EVO-X2 |
| APU | AMD Ryzen AI MAX+ 395 / Radeon 8060S |
| RAM | 128GB UMA |
| UMA Frame Buffer | 96GB |
| OS | Windows 11 Pro 26H2 Build 26300.9550 |
| モデル | Unsloth Qwen3.8-Flash-Next UD-IQ3_XXS |
| モデル配置 | PLE16変換版 |
| MTP Draft | Unsloth Q8_0、DraftMax=2 |
| KV cache | f16(Target / Draft) |
| Backend | Vulkan |
| Vulkan compiler | LLVM / Clang 20.1.8 |
バックエンドについて: Stage A・Stage B・flattenはVulkan専用の実装ではなく、ROCmでも軽く動作確認を行っている。ただし、段階ごとの詳しい速度比較やRGPを使ったGPU処理の調査はVulkanを中心に実施したため、この記事に掲載する性能測定結果はVulkanに限定する。ROCmでも同じだけ高速化することを確認したわけではない。
ソース、Windowsビルド、検証スクリプトなどはここで公開している。
https://github.com/ariera-j/llama.cpp-evox2-windows
今回の主な実装・調査はinvestigation/r5-mtp-*系のブランチで行い、その後統合版(r6)にも移植した。統合版はmainブランチに公開しているが、最適化フラグは原則としてデフォルトOFFの実験機能である。
MTPを入れたらPPが遅くなるのは仕方がないのか?
MTP(Multi-Token Prediction)は、次のトークンを1個ずつ生成する代わりに、Draftモデルに複数トークンを予測させ、Targetモデルでまとめて検証することでTGを高速化する仕組み。
ただし、出力生成前の長い入力も、Targetモデルだけが読み込めばよいわけではない。今回のQwen3.8-Flash-Nextの構成では、Targetから渡されたhidden stateに対応するよう、Draft側でも入力トークン列に対する状態を更新する(catch-up処理)。
Draftモデル分の処理が増えるからPPが遅くなる、というのは直感的にも理解できる。
けど、理解できるのと許容できるのは別で、MTPオンのときにもう少しPPが速くなってほしいと以前から思っていた。特に長文入力では、TGを数秒短くするためにPPが数十秒増えると、全体では遅くなることもある。
ベースの速度:MTP ONで何秒増える?
今回の出発点の速度はこちら。upstreamを入れ替えたllama.cpp(r5 b11560)をビルドして、いつもの日本語論文データをllama-cliに入力して、MTP ON/OFFの差を測った。
PPのt/sだと大差ないようにも見えるけど、時間差にすると結構違う。
| context | MTP OFF PP | MTP ON PP | ONによるPP低下 | 増えたPP時間 |
|---|---|---|---|---|
| 64k | 361.52 | 334.00 | −7.61% | +14.08秒 |
| 128k | 335.46 | 303.97 | −9.39% | +38.99秒 |
どこで時間がかかっているかを調べる:phase trace
まずllama.cppを改造して、処理の境界ごとにCPU側の経過時間を出すphase traceを入れた。
具体的には、Targetのprompt処理、speculative wrapper、Draftのprocess()、llama_get_embeddings_nextn()によるhidden取得、Draftのllama_process()などを分けて記録する。
改造後のllama-cliを使って、64kと128kでMTP OFF/ONを比較した結果は次の通り。
※ログ出力のオーバーヘッドがあるのでPP速度と時間の絶対値はベース計測値とは異なる。
| trace対象 | 64k | 128k |
|---|---|---|
| MTP OFFのPP時間 | 171.12秒 | 382.97秒 |
| MTP ONのPP時間 | 181.31秒 | 420.91秒 |
| MTP ONの増加分 | +10.19秒 | +37.94秒 |
| ON時のspeculative wrapper | 87.12秒 | 200.24秒 |
└ hidden getter(llama_get_embeddings_nextn()) |
78.44秒 | 178.30秒 |
└ Draft llama_process()
|
6.76秒 | 20.02秒 |
この表の下3行は入れ子になっているCPU wall time。
GPU処理は非同期でキューに投入される。hiddenを取得する際の同期によって、それ以前に投げたTarget側GPU処理の完了待ちがこのgetter llama_get_embeddings_nextn()にまとめて現れることがある。CPU側で待っていた場所と、GPU側で実際に時間を使った演算は別物ということ。
一方、Draftのllama_process()はKVが長くなるほど時間が増える傾向があり、128kのfull batch群ではKV深度との相関が約r=0.998だった。Draft側の長文Flash Attention処理が怪しいけど、PP速度低下の原因と断定はできない。
Stage A:不要な出力を捨てれば速くなる?
Draftのcatch-up中には、基本的にTargetからhiddenが渡される。けど、この区間ではDraftから最終的なtoken出力を取り出したいわけではない。それなら通常のDraft計算を途中で切り上げて、K/V cacheの更新だけ残せばよいのでは?
最初のStage Aでは、通常のAttention処理を組み立てた後、出力・FFN・NextNなどが不要なところで早期returnする方法を試した。グラフ上の計算量がかなり減るはず、と思ったけど、期待したほど効果がなかった。
原因を調べるためactive graphの演算ノードを数えてみると、こうなっていた。
| グラフ | ノード数 | Flash Attention | MoE matmul | FFN系 | 一般matmul |
|---|---|---|---|---|---|
| 通常のDraft catch-up | 133 | 1 | 3 | 11 | 22 |
| Stage A | 44 | 1 | 0 | 0 | 6 |
ノード数は133→44に減っている。MoEやFFNも消えている。それなのに、一番消したかったFlash Attentionが残っている。
llama.cppの共通build_attn_mha()の中でggml_build_forward_expand()が呼ばれ、Attentionの出力が既にグラフのrootとして登録されていた。後から別のところでearly returnしても、一度root化されたFAは消えないらしい。
単に「不要な結果を使わない」だけでは不十分だった。
Stage B:最初からK/Vだけを計算する
Stage AでFAが残る理由が分かったので、今度は通常のAttention経路を途中まで流用するのをやめた。
Qwen4ExpのMTP Draftで、出力が不要なcatch-upに限って動く専用のKV-only経路を追加する。
K/V projection、K normalization、RoPEなどのモデル固有変換、K/V cacheへの書き込み、必要なrecurrent copyは残す。一方で、Q projection、Flash Attention、attention output、WO、FFN、NextN output、logitsは作らない。
この機能は環境変数LLAMA_MTP_DRAFT_PREFILL_KV_CROPでON/OFFできるようにした。
ここまで実装して再度演算ノードを数えてみたら、やっと狙ったグラフになった
| グラフ | ノード数 | Flash Attention | MoE matmul | FFN系 | matmul | K/V write |
|---|---|---|---|---|---|---|
| 通常 | 133 | 1 | 3 | 11 | 22 | あり |
| Stage A | 44 | 1 | 0 | 0 | 6 | あり |
| Stage B | 31 | 0 | 0 | 0 | 5 | KとVを各1つ |
速度計測
計算グラフの確認ができたので、速度を測ってみた。
この計測中に謎のWindows再起動とEvo-X2のP-MODEボタンでハマったのだけど、その話は番外編6に書いたので、ここでは諸々解決後の計測結果だけを載せる。
| context | Stage B OFF PP | Stage B ON PP | PP改善率 | PP短縮時間 | ベース MTP OFF PP | ベース MTP ON PP |
|---|---|---|---|---|---|---|
| 64k | 333.495 | 345.460 | +3.588% | 約6.42秒 | (361.52) | (334.00) |
| 128k | 300.930 | 321.130 | +6.713% | 約26.39秒 | (335.46) | (303.97) |
Stage BのOFFとONを比べると、Draftの不要な処理を削った結果として速くなっている。
llama-cliで出力されるログを確認すると、入力の後ろの方ほど改善が大きい傾向も見えた。例えば64kの4–8k区間では約1.7%、49–61k区間では約4.6%の時間短縮だった。
でも、計測日とllama-cliのビルドが違うので参考値だけど、最初に測ったベースの計測値と比べると、MTP OFFの速度には到達できていない。
(Stage B OFFとベース MTP ONがほぼ同条件)
残っているDraftのどこが重い?
Stage BでPPはだいぶ速くなったけど、MTP OFFよりはまだ遅い。他にどこで時間がかかっているのかを調べるためにRadeon Developer Panel / Radeon GPU Profiler(RGP)を使った。使い方の詳細は第10回で書いたので、ここでは省略する。
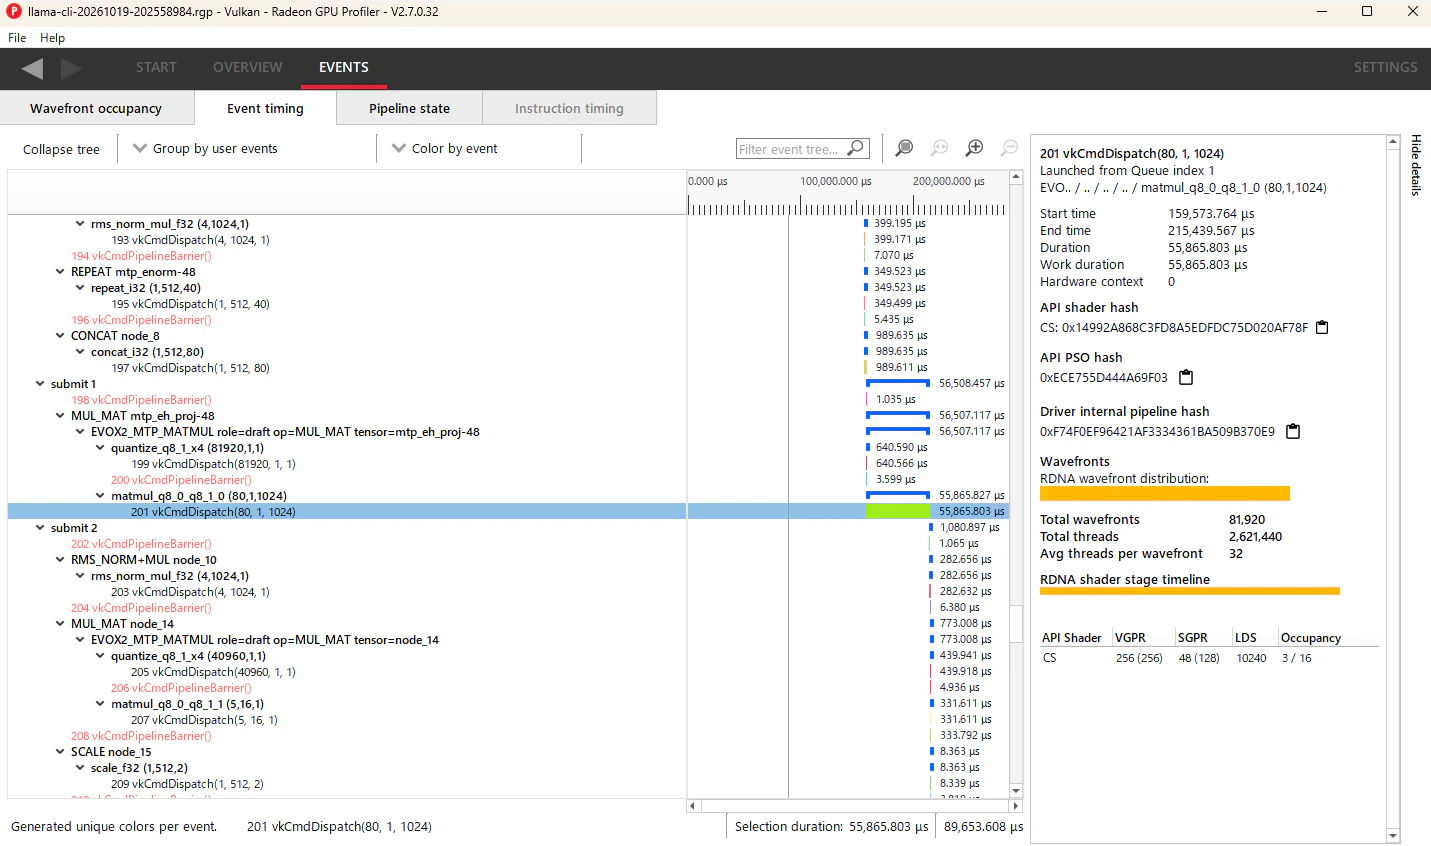
Vulkanの64k入力で、promptが約51〜53kまで進んだところの1,024トークン分のDraft catch-upグラフを2回キャプチャして、GPUのEvent timingとPipeline stateを見た。Stage BでFAは消えていたが、代わりに目立ったのが**mtp_eh_projという射影のQ8 matmul**だった。
flatten前の代表的なグラフでは、Draft全体が約62msなのに、このmatmulだけで約56〜59ms。グラフの大半を1つの演算が使っている。
RGP上のVulkan kernelはmatmul_q8_0_q8_1_0 (80,1,1024)で、理論occupancyは3/16 wavefronts/SIMD、VGPRは256/256。要するに、演算自体よりGPUに渡している計算の形が効率の悪い形になっているのではないか、と考えた。
ここで気になったのは、mtp_eh_projが各tokenやhyper-connectionに独立に適用される線形射影である点。行列の数や値を変えずに、入力テンソルの見せ方だけを変えられそうだった。
mtp_eh_proj flatten:計算は同じで形だけ変える
元のmtp_eh_proj入力は、概念的には[5120, 4, 1024](特徴次元 × hyper-connection × token)。Vulkanからは、幅の狭い行列を1,024バッチ処理する形に見えていた。
そこでggml_reshape_2d()でhyper-connectionとtokenの軸をまとめ、射影後にggml_reshape_3d()で元の形に戻すよう変更した。
// e_norm / h_norm はそれぞれ [n_embd, hc, n_tokens]
ggml_tensor * eh_in = ggml_concat(ctx0, e_norm, h_norm, 0);
if (mtp_eh_proj_flatten) {
    eh_in = ggml_reshape_2d(ctx0, eh_in, 2*n_embd, hc*n_tokens);
    res_hc = build_lora_mm(layer.nextn.eh_proj, eh_in);
    res_hc = ggml_reshape_3d(ctx0, res_hc, n_embd, hc, n_tokens);
} else {
    res_hc = build_lora_mm(layer.nextn.eh_proj, eh_in);
}
1,024トークンのときのGEMMの形は以下のようになる。
| M | N | K | batch | |
|---|---|---|---|---|
| flatten OFF | 2560 | 4 | 5120 | 1024 |
| flatten ON | 2560 | 4096 | 5120 | 1 |
掛け算の対象や論理的な出力順序は同じで、GPUに与える行列形状だけを変えたことになる。
この機能は環境変数LLAMA_MTP_EH_PROJ_FLATTENでON/OFFできるようにした。
Stage BがONで、該当するzero-output Draft経路のときだけ有効になる。
速度計測結果
Stage BをONにしたまま、flattenだけをON/OFFに切り替えて計測した。
| context | flatten OFF PP | flatten ON PP | PP改善率 | PP短縮時間 |
|---|---|---|---|---|
| 64k | 344.615 | 349.390 | +1.386% | 約2.45秒 |
| 128k | 319.605 | 324.070 | +1.397% | 約5.44秒 |
1.4%程度というと小さく見えるが、長文PPでは2〜5秒の差になっている。
まだMTP OFFよりは遅いが、だいぶマシになった。
RGPで確認
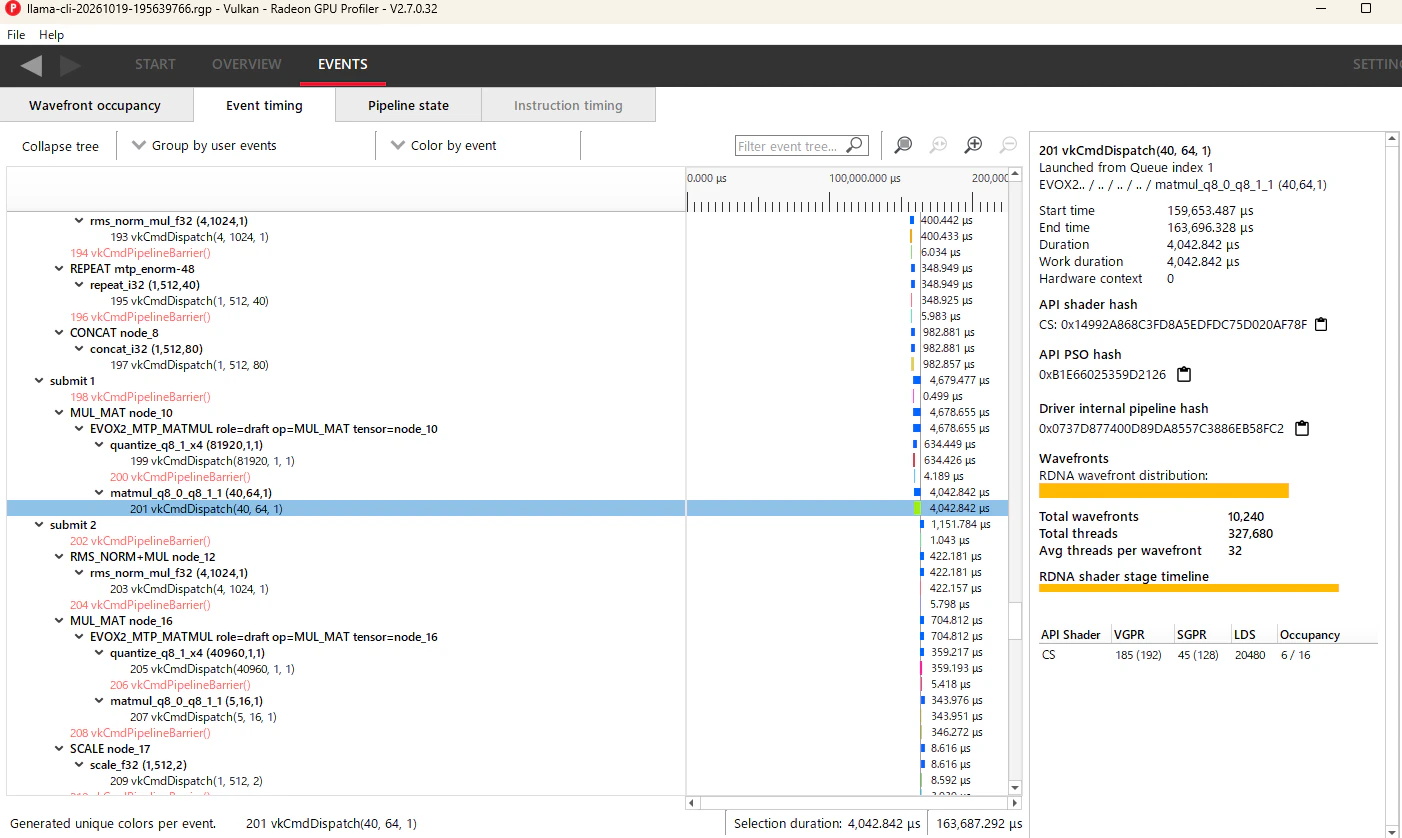
RGPでflatten ON/OFF両方の、約51〜53kの対応するDraftグラフをキャプチャしてみると、次のようになった。
| 1024-token Draft graphのGPUイベント | flatten OFF | flatten ON |
|---|---|---|
| Draftグラフ全体(inclusive) | 約61.0〜63.9ms | 約9.24〜9.37ms |
mtp_eh_proj周辺 |
約56.5〜59.1ms | 約4.68〜4.75ms |
| 主なQ8 matmul kernel | 約55.9〜58.5ms | 約4.04〜4.05ms |
matmul単体では約13.8〜14.5倍、Draftグラフ全体でも約6.6〜6.8倍の短縮。
flatten ONの実際のkernelはmatmul_q8_0_q8_1_1 (40,64,1)。理論occupancyは6/16に増えた。対応するグラフのdispatch数は両方20で、単にdispatchが減ったわけではなく、主にmatmulの形と実行時間が変わったと考えられる。occupancyだけが改善原因だと断定できるわけでもない。
一方で、llama-cliのPP全体は約**+1.4%**。当たり前だけど、1つの演算が14倍速くなっても処理全体が14倍速くなるわけではない。
※RGPのオーバーヘッドがあるので、PP速度、時間の絶対値は参考値として主に比率を見ている。
upstream再入れ替え後の計測結果
後日、ベースの公式(upstream)llama.cppを入れ替えて、今までに効果があった高速化パッチをすべて移植して統合版(r6)を作成した。その時に、Stage Bとflattenの効果を再確認した。
以下はベースのllama.cppが変わっているだけでなく、他の高速化パッチも入れた状態で計測している。
flattenはOFF**に固定し、Stage Bだけを切り替えた結果
| context | Stage B OFF PP | Stage B ON PP | PP改善率 | TG改善率 |
|---|---|---|---|---|
| 64k | 336.990 | 352.665 | +4.65% | +1.97% |
| 128k | 297.845 | 318.320 | +6.87% | +2.94% |
※TGにも少し改善効果があったので参考までに改善率だけ載せておく
Stage BをONに固定してflattenのみ切り替えた結果
| context | flatten OFF PP | flatten ON PP | PP改善率 |
|---|---|---|---|
| 64k | 352.803 | 358.365 | +1.58% |
| 128k | 318.900 | 323.070 | +1.31% |
統合版(r6)でMTP OFFと比べると?
Stage B、flatten含む自作高速化フラグを、利用可能な条件ではすべてONにした状態で、MTP ONとOFFの差を比べてみた。256kのみMTP OFFでの計測をしていなかったのでONの値のみ載せる。
| context | MTP OFF PP | MTP ON PP | ONとOFFの差 | MTP OFF TG | MTP ON TG |
|---|---|---|---|---|---|
| 64k | 350.59 | 358.29 | +2.20% | 26.07 | 33.90 |
| 128k | 311.75 | 322.98 | +3.60% | 24.03 | 30.49 |
| 256k | — | 301.30 | — | — | 25.08 |
ベースを入れ替えた効果なのか、統合版ではMTP ONの方がPPもTGも速くなった。これでMTP ONを常用設定として使えそう。
参考までに、自作高速化フラグをオフにした状態だとこうなった。
高速化を入れないと、MTP ONで約8%遅くなる傾向は残っている。
| context | MTP OFF PP | MTP ON PP |
|---|---|---|
| 64k | 346.05 | 319.31 |
| 128k | 270.79 | 248.01 |
まとめ
- Stage Aではグラフのノード数を大きく減らしたのに、FAをrootから外せず、PPはほとんど改善しなかった
- Stage Bでは必要なK/V更新を直接組み立ててFAを消し、128kでMTP PP追加コストの約7割を削減できた
- RGPで残る重い
mtp_eh_projを見つけ、flattenによってGPU内部では大幅な短縮、PP全体でも約1〜2%の短縮になった
しばらくお出かけしたり、違うことにハマったりして、今回の内容は記事化まで2週間ぐらいかかってしまった。
最近は高速化をいったんお休みして、番外編4、番外編5で調べた入力による違いや、モデルの量子化による違いを調べているので、次回はそのあたりの記事になる予定。
付録
ベースのllama.cppを入れ替えて、前回の高速化パッチを入れたときの速度
upstreamのllama.cppde7fa0a3c6a2e1b4cd9f22eb8d6bf5b12dbdb63bをビルドして、Unsloth IQ3(Ple16テーブル変換なし)で計測
| context | r5 clean PP | r5 clean TG |
|---|---|---|
| 64k | 269.24 | 25.31 |
| 128k | 179.51 | 23.67 |
| 256k | 135.41 | 20.02 |
upstreamに今までのパッチ(Ple16変換対応、QSA unionなど)を入れた後、第11回で入れた高速化(DENSEとNOOP)の移植効果を計測
| context | DENSE OFF→ON TG | 改善率 | NOOP OFF→ON TG | 改善率 |
|---|---|---|---|---|
| 64k | 29.275→31.270 | +6.81% | 31.385→32.045 | +2.10% |
| 128k | 23.420→27.055 | +15.52% | 26.960→28.775 | +6.73% |
| 256k | 15.490→21.100 | +36.22% | 21.075→24.110 | +14.40% |
長文要約テストのコマンド例
以下は普段の長文要約を行うときの一例。本文のABBAはtemp=0、seed=1234、512トークン出力など条件を固定した別の計測なので、このまま実行した結果と表の数値は直接比較できない。MTPの有無と専用環境変数も、比較時には別途切り替えている。
.\llama-cli.exe `
    -m "(モデルのパス)" `
    -c (コンテキスト長) `
    -ngl 999 `
    -ncmoe 0 `
    -t 4 `
    -tb 4 `
    -b 2048 `
    -ub 1024 `
    -fa 1 `
    -ctk f16 `
    -ctv f16 `
    --temp 0.2 `
    --top-k 20 `
    --top-p 0.8 `
    --min-p 0.05 `
    --jinja `
    --single-turn `
    --reasoning off `
    -f 入力ファイルのパス `
    -n 1024 `
    -lv 4
テストデータについて
今回も前回までと同じ長文入力を使用した。実入力トークン数は以下。
| context | 実入力 |
|---|---|
| 64k | 61,789 tokens |
| 128k | 126,253 tokens |
| 256k | 255,181 tokens |
256kでは要求context 262,144の約97.3%まで入力している。前回までの記事と同じものなので詳細は省略する。
詳細な検証環境
Hardware
- Device: NucBox_EVO-X2
- CPU / APU: AMD Ryzen AI MAX+ 395 with Radeon 8060S
- CPU clock displayed by Windows: 3.00 GHz
- Installed memory: 128 GB / UMA Frame Buffer: 96 GB
- GPU: AMD Radeon 8060S Graphics
OS
- Windows 11 Pro 26H2 / OS Build 26300.9550
- Update: 2026-10-08
llama.cppのベース
- r5 clean upstream: b11517、pinned source
de7fa0a3c6a2e1b4cd9f22eb8d6bf5b12dbdb63b - r5 Stage B測定: Vulkan b11618
- r5 flatten測定: Vulkan b11659
- r6 upstreamベース: b11870(pinned source
74bca3950054eed1795f525cb9cf06bfe796492d) - r6 Stage B: b11903、r6 flatten: b11906、r6統合版: b11908
Vulkan
- Compiler: LLVM / Clang 20.1.8
- Vulkan SDK: 1.4.357.0
使用したモデル
- Repository:
unsloth/Qwen3.8-Flash-Next-GGUF - URL: https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
- Quantization:
UD-IQ3_XXS - File size reported by llama.cpp: 76.32 GiB
- BPW: 3.71
- Model params: 176.94B
- 上記モデルのオリジナルと、LaurentZuijdwijkのStrix Halo専用fork内の
gguf-py/gguf/scripts/gguf_split_ple_heads.pyで変換したPLE16モデルを用途に応じて使用 - MTP ON時は対応するUnsloth Q8_0 Draftを併用