
第1回「EVO-X2(Ryzen AI Max+ 395 / 128GB)でQwen3.8-Flash-Nextを動かした話」
第2回「EVO-X2(Ryzen AI Max+ 395 / 128GB)でQwen3.8-Flash-Nextを高速化した話」
第3回「EVO-X2(Ryzen AI Max+ 395 / 128GB)でQwen3.8-Flash-Nextの高速化の続き」
の続き。
前回は、llama.cppをunslothのb10715-mix-86bd2d3に変えて、MTPを入れたらdecodeが2倍近く速くなったけどprefillはちょっと遅くなったのを確認した。
すごく速いわけではないけど、実用許容範囲になってきたので、今回は長文要約&チャットを試すつもりで、念のため 前回使ったUnsloth版llama.cppの配布元 をチェックしたら、b10798-mix-659e406に更新されていたので、軽く確認。
のつもりだったけど、ちょっとビックリな結果だったので、もう少し詳しく測ってみた。
以降、Prompt Processing(入力を読み込む処理)をPP、Token Generation(出力生成)をTGと表記する。どちらも単位はtok/sで、高いほど速い。
結論
今回の b10798-mix-659e406 + ROCmでは、前回使った b10715-mix-86bd2d3 よりPP、TGの両方が速くなった。
32k、MTPなしでのPP/TGは、今回のb10798-mix-659e406が256.14/20.52、前回のb10715-mix-86bd2d3が223.74/17.21、前々回のb10679が215.36/14.91で、MTPありでの今回のb10798-mix-659e406は最速値で240.11/29.42だった。
PPは同条件でMTPを入れるとやはり少し落ちるが、それでも前回のMTPなしより速い。
個人的にローカルLLMで一番よく使うのは長文要約や長文の読解支援なので、今回はdecodeだけではなくprefillまで速くなったのがかなり嬉しい。
今回新しくダウンロードしたもの
llama.cpp Unslothが公開しているこちらのプレビルド版
app-b10798-mix-659e406-windows-x64-rocm-gfx1151.zip
app-b10798-mix-659e406-windows-x64-vulkan.zip
をダウンロードして適当なフォルダに展開するだけ。
lama.cpp本家もv0.4.0が出ているし、llama.cppは一度も自分でビルドしたことがないので、ビルドも試してみたいけど、高速化できる可能性はあまり高くなさそうなので今回は見送る。
第3回と同じように両方起動してみたが、ROCm版は正常動作、Vulkan版は今回もモデルロード後の推論でクラッシュした。なので、Vulkan版については早々に諦めて、以降はROCm版だけを使っている。
追記(2026-09-06) クラッシュについては後日解決してVulkan版でも動作するようになっている
モデルとは前回と同じなので新規ダウンロードはなし。
Qwen3.8-Flash-Next UD-IQ3_XXSmtp-Qwen3.8-Flash-Next-Q8_0.ggufmtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf
長文要約テスト、まず32Kで軽く確認
前回と同じ日本語文書を要約してもらうプロンプトとllama-cliを使って、32kでの速度を測ってみた。
最初は本当にこれだけやって長文の出力品質チェックに進む予定だった。
MTPなし
| llama.cpp | PP | TG | graph splits |
|---|---|---|---|
| b10679(前々回) | 215.36 | 14.91 | 27 |
| b10715-mix(前回) | 223.74 | 17.21 | 26 |
| b10798-mix(今回) | 256.14 | 20.52 | 2 |
思ったより差がある。graph splitsについては後で説明する。
この時点でちょっと面白くなってきたので、MTPありでも試してみた。
MTPあり
| llama.cpp | draft model | Run | PP (tok/s) | TG (tok/s) | draft acceptance | graph splits |
|---|---|---|---|---|---|---|
| b10715-mix(前回) | Q8_0 | 1 | 213.91 | 25.64 | 70.2% | 2 |
| b10798-mix(今回) | Q8_0 | 1 | 239.27 | 27.24 | 64.5% | 2 |
| b10798-mix(今回) | Q8_0 | 2 | 240.11 | 29.42 | 71.9% | 2 |
MTPありでも速くなった。計測順はb10798-mix 初回→b10715-mix→b10679→b10798-mix 2回目で、推論を繰り返していると熱の影響で速度が落ちる可能性があるので最初と最後に同じデータを測った。
その結果、なぜか2回目の方が速い。acceptanceも64.5%と71.9%で違っていたので、結構変動幅が大きいのかもしれない。
それでも、前回、前々回より速くなっているとは言えそう。
前々回のb10679(本家llama.cpp)はMTPドラフトモデルの読み込みに失敗したため、MTPありの速度計測はできていない。
ついでに、前回最後に測定したMTPドラフトモデル(shared版のQ8_0)でも測ってみた。
| llama.cpp | draft model | PP (tok/s) | TG (tok/s) | draft acceptance | graph splits |
|---|---|---|---|---|---|
| b10798-mix(今回) | shared Q8_0 | 291.97 | 29.68 | 71.2% | 2 |
なんかこっちのほうが速い気もするのだけど、前回のb10715-mix、32kの計測ではあまり変わらない結果だったので、今回のb10798-mixとの組み合わせで速くなったのか、変動幅が大きいだけなのかはよく分からない。
ここでMTPモデルを切り替えると今まで測ったものが全部やり直しになるので、shared版は参考値として残しておいて、今回は深追いしないことにする。
長文要約テスト、64K、128Kでも試す
32kで結構速くなっていたので、長文になってもその速さは維持されるのか気になって64Kと128Kでも試してみた。
まずMTPなし
b10715が前回、b10798が今回。
*は前回の記事の値。
| Context | Prompt tokens | b10715 PP | b10798 PP | PP差 | b10715 TG | b10798 TG | TG差 |
|---|---|---|---|---|---|---|---|
| 32K | 29,557 | 223.74 | 256.14 | +14.5% | 17.21 | 20.52 | +19.2% |
| 64K | 61,789 | 170.98* | 245.62 | +43.7% | 12.25* | 14.70 | +20.0% |
| 128K | 126,253 | 118.12* | 137.92 | +16.8% | 8.22* | 9.93 | +20.8% |
TGが32K、64K、128Kで全部ほぼ+20%なのが分かりやすい。
PPはなぜか伸び率が一定ではない。
MTPあり
| Context | Prompt tokens | b10715 PP | b10798 PP | PP差 | b10715 TG | b10798 TG | TG差 | acceptance |
|---|---|---|---|---|---|---|---|---|
| 32K (初回) | 29,557 | 213.91 | 239.27 | +11.9% | 25.64 | 27.24 | +6.2% | 64.5% |
| 32K (2回目) | 29,557 | 213.91 | 240.11 | +12.2% | 25.64 | 29.42 | +14.7% | 71.9% |
| 64K | 61,789 | 164.20* | 233.99 | +42.5% | 19.15* | 22.13 | +15.6% | 68.3% |
| 128K | 126,253 | 112.65* | 171.24 | +52.0% | 13.77* | 16.34 | +18.7% | 約70% |
こちらもPP、TGともに速くなっている。
特に128KではPPが112.65 → 171.24 tok/sになった。
前回はMTPを入れるとTGは速くなる代わりにPPが少し落ちる、というトレードオフだった。今回は、128kでは逆にMTPなし→MTPありでPPも速くなっている。
128Kの同じ長文要約タスクの所要時間も、
- 前回:約19分20秒
- 今回:約12分52秒
になった。
64Kと128Kの間も気になったので96Kを追加
ここまで測って、今度はPPの数字が気になった。
MTPなしで、
- 32K:256.14
- 64K:245.62
- 128K:137.92
なので、64Kから128Kの間でかなり落ちている。
途中で急に遅くなる地点があるのか気になったので、最後に96Kを追加した。
結果は、
| Context | Prompt tokens | PP | TG |
|---|---|---|---|
| 32K | 29,557 | 256.14 | 20.52 |
| 64K | 61,789 | 245.62 | 14.70 |
| 96K | 94,021 | 205.57 | 11.84 |
| 128K | 126,253 | 137.92 | 9.93 |
だった。
これだけ見ると、96K以降で少し落ち方が大きく見える。
ログにはprompt処理中の経過時間も約2K tokensごとに出ていたので、各区間の局所PPも計算してみた。
MTPなし 32k/64k/96k/128kの局所PP

MTPあり 32k/64k/128kの局所PP

※局所PPは、llama-cliのログから2048 tokenごとの区間について、2048 tokenごとの区間について、token数と経過時間の差分から計算した。末尾には2048 token未満の端数区間が含まれるため、chunkサイズを揃えて比較する目的でそれらはグラフから除外した。
※横軸のmaxがMTPなしは128k、MTPありは256kのため、縦に並べて比較できるようにグラフの幅を変えている
※MTPあり256Kのみ mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf を使用しているため、32K~128Kとはdraft modelが異なる。256Kの線は厳密な同条件比較ではなく、長context時の局所PPの傾向を見るための参考値として掲載している。
どちらも、96k以降のどこか1点で突然ガクッと遅くなるというより、長くなるにつれて徐々に落ちているように見える。
MTPなしだとコンテキスト長64kだけ異常に速く、MTPありだとコンテキスト長32kだけ異常に遅いようにも見えるが、深追いすると複数回測って分散を見るとか、次は80k、112kを測るとか、無限に測り始めそうなので、今回はここまでにする。
256kでも動くかを確認
速度がだいぶ速くなってきたので、Qwen3.8-Flash-Nextの最大context長262,144(256k)付近でも、まともに動作するかをチェックしてみた。32k~128kと同分野の長文を要約してもらった。
今までの計測結果から見て、1時間以内に終わることを期待。
MTPはshared版を使用
128Kを動かしていたとき、Task Manager上ではこんな感じでDedicated GPU memoryが60GBを超えていた。

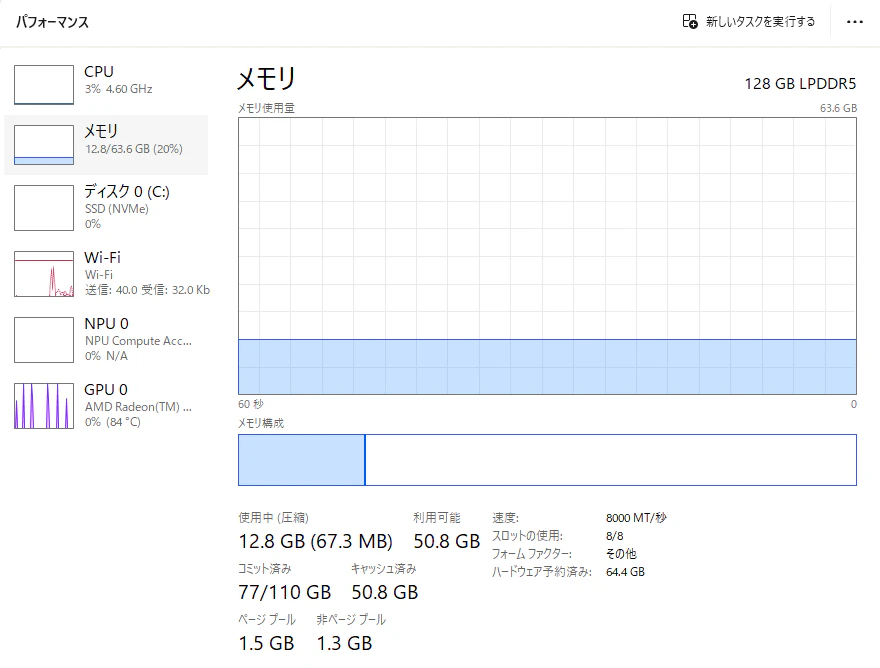
VRAM 64GB設定なのでちょっと怖い。
ということで256Kだけは念のため、mtp-Qwen3.8-Flash-Next-shared-Q8_0.ggufを使った。
shared版はtarget modelと重複するtensorを共有する版で、通常Q8_0よりdraft model側のメモリ使用量を減らせる。
ログでも、
borrow_shared_tensor: tensor token_embd.weight taken from the target model
borrow_shared_tensor: tensor output.weight taken from the target model
と出ていた。
256Kの結果
| 項目 | 結果 |
|---|---|
| Context | 262,144 |
| Prompt tokens | 255,181 |
| MTP | shared Q8_0 |
| PP | 97.66 tok/s |
| TG | 8.86 tok/s |
| Generation | 511 tokens |
| draft acceptance | 67.2% |
| graph splits | 2 |
| Total | 約44分31秒 |
| truncated | 0 |
40分以上かかったけど、普通に最後まで読んで日本語で要約を返して終了した。始める前に期待した1時間以内の目標も達成している。
日常的に使える速度かは微妙だけど、とりあえず「最大context付近 + MTP」でも動くことは確認できた。
前々回、256kの文書を読めるかチェックしたときには、同じ文書で末尾だけ要約依頼ではなく受信確認出力のプロンプトのものをb10679で処理して、PPは75.50 tok/sだった。
今回は97.66 tok/sなので、約29%速い。
前々回は「受信確認」だけ返させたテストなので、TG 3.62 tok/sの方は今回とは比較しない。
256Kのメモリ使用量
前回128Kのメモリ使用量を記録していたので、今回の256Kを1列追加した。
| 項目 | 128K MTPなし | 128K MTP Q8_0 | 256K shared Q8_0 |
|---|---|---|---|
| Used RAM | 10.01 GiB | 11.33 GiB | 16.23 GiB |
| Free RAM | 53.64 GiB | 52.32 GiB | 47.42 GiB |
| Commit | 63.9% | 69.8% | 76.3% |
| llama Private | 51.91 GiB | 57.28 GiB | 66.13 GiB |
| llama GPU Total Committed | 57.37 GiB | 62.63 GiB | 68.05 GiB |
| Adapter Dedicated | 56.26 GiB | 60.51 GiB | 62.42 GiB |
| Adapter Shared | 1.66 GiB | 2.67 GiB | 6.50 GiB |
| Adapter Total Committed | 58.09 GiB | 63.35 GiB | 68.97 GiB |
128KではDedicatedがかなり上限に近かったけど、256KではShared側も使いながら約69GiBのTotal Committedで完走した。
実際には通常Q8_0でも入りそうな余裕はあった。でも、もう1回測るとまた1時間近くかかるので、今回はやめておく。
※EVO-X2はUMAなので、WindowsのDedicated / Shared GPU memoryは、dGPUの「物理VRAM」と「普通のRAM」が完全に分かれている環境と同じ意味ではない。
※256Kだけshared版MTPなので、128Kとの完全な同条件比較でもない。
何で速くなったのか少し調べてみる
以下ほとんどチャッピー様の受け売り。
チャッピー様によると、b10715からb10798までには多数の変更が入っているので、今回の高速化を1つの変更だけの効果と断定することはできませんという注釈付きで、graph splitsとtop-kが関係するのではないか、ということ。
graph splitsって何?
llama-cli.exeのログに
graph splits = 2
みたいな感じで出てくる値が、
b10679(前々回)     : 27
b10715-mix(前回) : 26
b10798-mix(今回) : 2
で大きく違っている。
これは何かというと、「計算グラフ」の分割数で、「計算グラフ」とは行列演算をする、Attentionを計算する、値の上位何個かを選ぶ といった多数の計算処理のつながりのことらしい。
llama.cppでは、計算グラフの各処理をGPUやCPUに割り当てて実行していて、ある処理だけGPUで実行できずCPUへ回す必要がある、といった場合には、計算グラフを途中で分割する必要があり、GPU処理の途中にCPU処理が挟まる場合
GPUで計算
    ↓
CPUへデータを渡す
    ↓
CPUで計算
    ↓
結果をGPUへ戻す
    ↓
GPUで続きを計算
という移動が発生する。
計算グラフの分割数が少ないということは、このGPU⇔CPUの移動が減ったということ。これで速くなるというのは直感的にも何となく分かる。
計算グラフの分割数が減った原因はtop-kかも?
top-kとは「大量の値の中から、大きい方からk 個を選ぶ処理」の、いくつ選ぶかのkの値のこと。
ちょっと紛らわしいのが、llamaの起動オプションにある --top-k 20 は回答tokenを選ぶsamplingのtop-kのことで、今気にしているtop-kはそれとは別で、Qwen3.8-Flash-Nextのモデル内部でAttention Indexerが使うtop-k のこと。ログでは
qwen4exp.attention.indexer.top_k = 2048
という感じで出てくる。長いコンテキストの「どこを見るか」の候補を絞るところで、この処理を使っているらしい。
llama.cppでは2026/8/31に ROCm: add radix TOP_K for long rows #27466 がマージされていた。
これはROCmで、1024要素を超える長いTOP_KをGPUで処理できるようにする変更のようで、今までCPUに回さないといけなかった処理が、GPUでできるようになったので、計算グラフがGPU→CPU→GPUと何度も分割されることがなくなった可能性がありそう。
今回使ったb10798-mixのベースのb10798は#27466がマージされた後のものなので、当然この修正も入っているはず。
ただ、チャッピー様には、「原因はこれ」と断定してはダメ、としつこいぐらいに言われていて、b10798-mixのrelease noteにある avoid direct ROCm_Host compute on HIP integrated GPUs や、その他のメモリコピーやcontext tensorの扱いも関係するかも、ということなので、素人の考察はこのぐらいにしておく。
まとめ
長文要約&チャットを詳細に試す前にllama.cppだけ新しくしておこう、ぐらいのつもりだったけど、結局かなり測ることになった。
前回はMTPでdecodeが速くなったのが一番大きな収穫だった。
今回はprefillも速くなったのが個人的にはかなり嬉しい。
次回は長文要約&チャットの出力品質メインの検証をする予定。間をあけずに続けてやらないとまた同じことになって先に進めなくなりそうなので、早めにやろう。
長文要約テストのコマンド例
.\llama-cli.exe `
    -m "(モデルのパス)\Qwen3.8-Flash-Next-UD-IQ3_XXS-00001-of-00003.gguf" `
    -md "(モデルのパス)\mtp-Qwen3.8-Flash-Next-Q8_0.gguf" `
    --spec-type draft-mtp `
    -c 32768 `
    -ngl 999 `
    -ncmoe 0 `
    -t 4 `
    -tb 4 `
    -b 2048 `
    -ub 1024 `
    -fa 1 `
    -ctk f16 `
    -ctv f16 `
    --spec-draft-n-max 2 `
    --spec-draft-p-min 0 `
    --temp 0.2 `
    --top-k 20 `
    --top-p 0.8 `
    --min-p 0.05 `
    --jinja `
    --single-turn `
    --reasoning off `
    -f (入力ファイルのパス) `
    -n 1024 `
    -lv 4
検証環境
Hardware
- Device: NucBox_EVO-X2
- CPU / APU: AMD Ryzen AI MAX+ 395 with Radeon 8060S
- CPU clock displayed by Windows: 3.00 GHz
- Installed memory: 128 GB
- Windows usable memory: 63.6 GB
- UMA Frame Buffer: 64 GB
- GPU: AMD Radeon 8060S Graphics
OS
- Windows 11 Pro
- Version: 25H2
- OS Build: 26200.9168
- Installed: 2025-10-24
- Windows Feature Experience Pack: 1000.26100.344.0
llama.cpp
今回:
b10798-mix-659e406- build: 10798
- Windows x64 ROCm gfx1151
- Unsloth team build
比較:
b10715-mix-86bd2d3- upstream
b10679
EVO-X2にインストール済みのHIP SDK
- HIP SDK: 7.2.60201-38d754472
- HIP compiler: clang 21.0.0git
- HIP target: gfx1151
使用したモデル
Target model
- Repository:
unsloth/Qwen3.8-Flash-Next-GGUF - Quantization: UD-IQ3_XXS
- llama.cpp metadata:
IQ3_XXS - 3.0625 bpw - llama.cpp上のfile size: 76.32 GiB
- Model params: 176.94B / A3B
MTP draft model
32K~128K:
mtp-Qwen3.8-Flash-Next-Q8_0.gguf
256K:
mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf