

はじめに
どうも、そらです。
前回は、Databricksを初めて触る人向けに、Excelデータの取込から、Deltaテーブルの作成、可視化、View作成までを実施しました。
今回はその続きとして、作成したデータを監視・自動実行する方法を試します。
実施する内容は次の3つです。
- SQLアラートでデータの異常を検知する
- Lakeflowジョブで複数のNotebookを順番に実行する
- LakeflowパイプラインでBronze、Silver、Goldを作成する
今回使用するカタログとスキーマです。
カタログ:test
スキーマ:handson
Databricksの画面言語は日本語にしています。環境や権限によって、表示されるメニューや配置が一部異なる場合があります。
今回使用する元データ
前回作成した次の2テーブルを使用します。
test.handson.sales_raw
test.handson.product_master
sales_rawには、品質確認用として意図的に次の問題を入れています。
- order_idの重複
- customer_idのNULL
- quantityの負数
- region末尾の全角スペース
今回の全体像です。
SQLアラート
  └─ sales_rawの不正件数を監視

Lakeflowジョブ
  品質確認 → 整形 → 月次集計 → 出力検証

Lakeflowパイプライン
  Bronze → Silver → Gold
1. SQLアラートを作成する
SQLアラートとは
SQLアラートは、SQLを定期実行し、結果が設定した条件を満たした場合に通知する機能です。
今回は、次の問題件数を合計したerror_countを作り、1件以上の場合に発報させます。
WITH duplicate_stats AS (
  SELECT
    COALESCE(SUM(row_count - 1), 0) AS duplicate_order_count
  FROM (
    SELECT
      order_id,
      COUNT(*) AS row_count
    FROM test.handson.sales_raw
    GROUP BY order_id
    HAVING COUNT(*) > 1
  )
),
base_stats AS (
  SELECT
    COUNT(*) AS raw_count,
    COUNT_IF(customer_id IS NULL) AS customer_id_null_count,
    COUNT_IF(quantity <= 0) AS invalid_quantity_count,
    COUNT_IF(
      region <> regexp_replace(region, '[  ]+$', '')
    ) AS region_trailing_space_count
  FROM test.handson.sales_raw
)
SELECT
  b.raw_count,
  d.duplicate_order_count,
  b.customer_id_null_count,
  b.invalid_quantity_count,
  b.region_trailing_space_count,
  d.duplicate_order_count
    + b.customer_id_null_count
    + b.invalid_quantity_count
    + b.region_trailing_space_count AS error_count
FROM base_stats AS b
CROSS JOIN duplicate_stats AS d;
結果を1行にしている理由は、アラートの条件を単純に設定するためです。
画面からアラートを作成する
左側メニューから次の順に選択します。
アラート
  → アラートの作成
クエリエディターへSQLを貼り付け、コンピュートでSQLウェアハウスを選択して実行します。
公式ドキュメントの画面例です。画像は英語ですが、操作名は日本語画面に読み替えています。
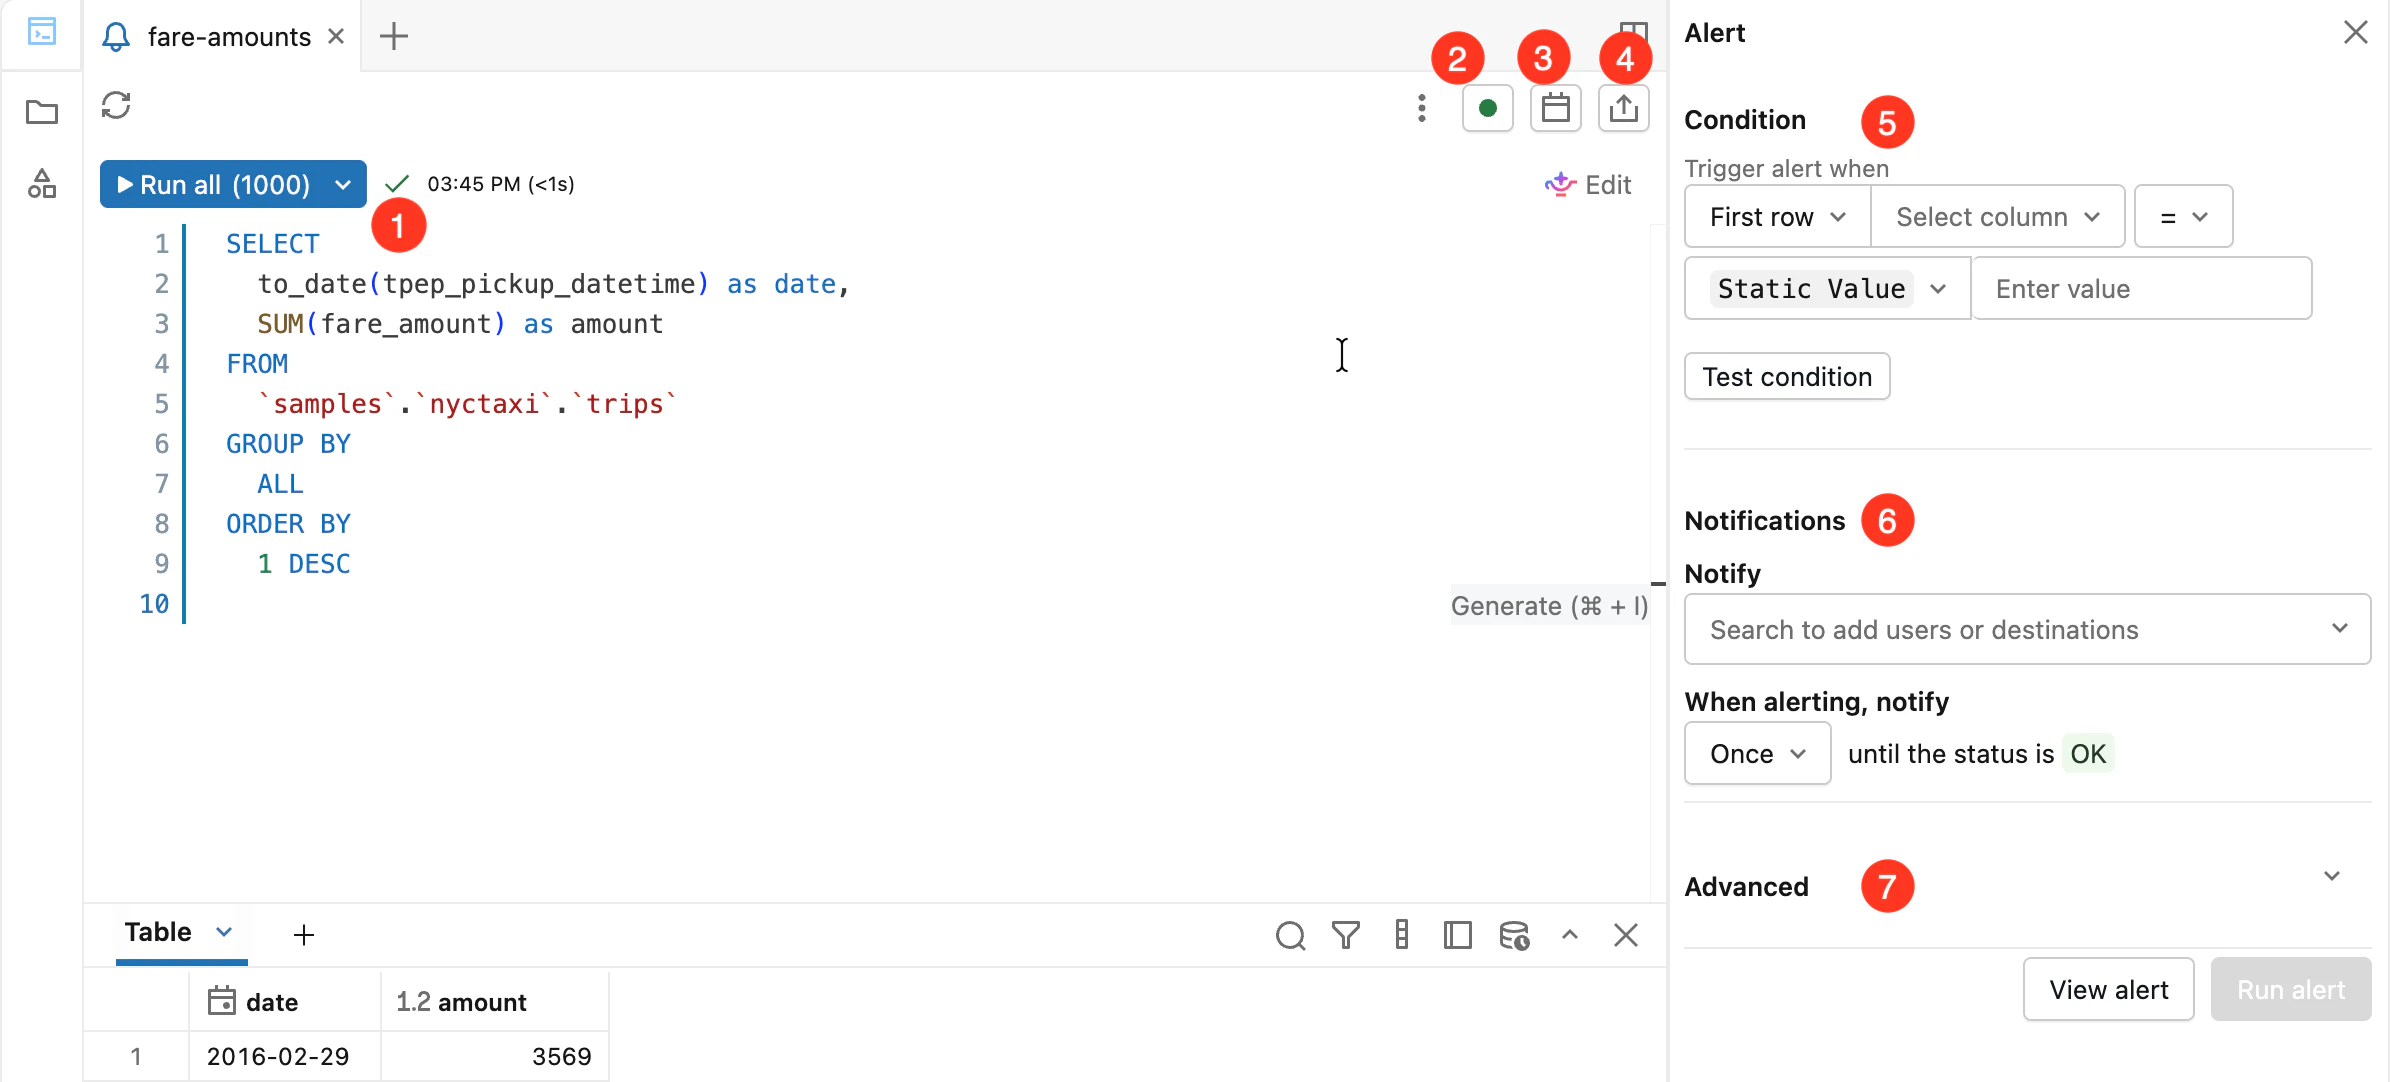
条件は次のように設定します。
| 項目 | 設定 |
|---|---|
| 対象列 | error_count |
| 演算子 | > |
| しきい値 | 0 |
クエリ結果が1行なので、対象行は最初の値または合計のどちらでも同じ結果になります。
条件をテストを選択すると、今回のデータではトリガー済みになる想定です。
通知には最初は自分だけを設定し、スケジュールは1時間ごとにしました。
アラート名は次のようにしました。
handson_sales_data_quality_alert
確認後、今すぐ実行を選択すると、アラート履歴と通知を確認できます。
OK状態も確認する
元データを変更せず、しきい値だけ一時的に次へ変更します。
error_count > 100
この状態で条件をテストすると、通常はOKになります。
確認後はerror_count > 0へ戻します。
2. Lakeflowジョブを作成する
Lakeflowジョブとは
Lakeflowジョブは、Notebook、SQL、パイプラインなどの処理を、依存関係付きで実行する機能です。
今回は次の4タスクを作ります。
01_quality_summary
        ↓
02_build_sales_clean
        ↓
03_build_monthly_sales
        ↓
04_validate_outputs
各処理を何度実行しても同じ状態へ戻しやすいように、集計ログ以外はCREATE OR REPLACE TABLEで作成します。
1つ目:品質チェック結果を記録する
品質確認結果を履歴テーブルへ保存します。
CREATE TABLE IF NOT EXISTS test.handson.sales_quality_run_log (
  checked_at                  TIMESTAMP,
  raw_count                   BIGINT,
  duplicate_order_count       BIGINT,
  customer_id_null_count      BIGINT,
  invalid_quantity_count      BIGINT,
  region_trailing_space_count BIGINT,
  error_count                 BIGINT
)
USING DELTA;
INSERT INTO test.handson.sales_quality_run_log
WITH duplicate_stats AS (
  SELECT
    COALESCE(SUM(row_count - 1), 0) AS duplicate_order_count
  FROM (
    SELECT
      order_id,
      COUNT(*) AS row_count
    FROM test.handson.sales_raw
    GROUP BY order_id
    HAVING COUNT(*) > 1
  )
),
base_stats AS (
  SELECT
    COUNT(*) AS raw_count,
    COUNT_IF(customer_id IS NULL) AS customer_id_null_count,
    COUNT_IF(quantity <= 0) AS invalid_quantity_count,
    COUNT_IF(
      region <> regexp_replace(region, '[  ]+$', '')
    ) AS region_trailing_space_count
  FROM test.handson.sales_raw
)
SELECT
  CURRENT_TIMESTAMP(),
  b.raw_count,
  d.duplicate_order_count,
  b.customer_id_null_count,
  b.invalid_quantity_count,
  b.region_trailing_space_count,
  d.duplicate_order_count
    + b.customer_id_null_count
    + b.invalid_quantity_count
    + b.region_trailing_space_count
FROM base_stats AS b
CROSS JOIN duplicate_stats AS d;
2つ目:整形済みテーブルを作成する
主な処理です。
- order_id単位で重複除去
- customer_idがNULLの行を除外
- quantityが0以下の行を除外
- region末尾の空白を除去
- 商品マスタを結合
- 売上金額と粗利を計算
CREATE OR REPLACE TABLE test.handson.sales_clean_job
USING DELTA
AS
WITH ranked AS (
  SELECT
    *,
    ROW_NUMBER() OVER (
      PARTITION BY order_id
      ORDER BY order_date DESC, product_code, customer_id
    ) AS row_num
  FROM test.handson.sales_raw
),
valid AS (
  SELECT
    order_id,
    CAST(order_date AS DATE) AS order_date,
    customer_id,
    regexp_replace(region, '[  ]+$', '') AS region,
    channel,
    product_code,
    CAST(quantity AS INT) AS quantity,
    CAST(unit_price AS DECIMAL(12, 2)) AS unit_price,
    CAST(discount_rate AS DECIMAL(5, 4)) AS discount_rate,
    status
  FROM ranked
  WHERE row_num = 1
    AND order_id IS NOT NULL
    AND customer_id IS NOT NULL
    AND quantity > 0
)
SELECT
  s.order_id,
  s.order_date,
  s.customer_id,
  s.region,
  s.channel,
  s.product_code,
  p.product_name,
  p.category,
  s.quantity,
  s.unit_price,
  s.discount_rate,
  s.status,
  CAST(p.cost AS DECIMAL(12, 2)) AS cost,
  ROUND(
    s.quantity * s.unit_price * (1 - s.discount_rate),
    0
  ) AS sales_amount,
  ROUND(
    s.quantity * s.unit_price * (1 - s.discount_rate)
      - s.quantity * CAST(p.cost AS DECIMAL(12, 2)),
    0
  ) AS gross_profit,
  CURRENT_TIMESTAMP() AS processed_at
FROM valid AS s
LEFT JOIN test.handson.product_master AS p
  ON s.product_code = p.product_code;
3つ目:月次集計テーブルを作成する
CREATE OR REPLACE TABLE test.handson.monthly_sales_job
USING DELTA
AS
SELECT
  DATE_TRUNC('MONTH', order_date) AS sales_month,
  region,
  category,
  SUM(sales_amount) AS sales_amount,
  SUM(gross_profit) AS gross_profit,
  COUNT(DISTINCT order_id) AS order_count,
  CURRENT_TIMESTAMP() AS processed_at
FROM test.handson.sales_clean_job
WHERE status = '完了'
GROUP BY
  DATE_TRUNC('MONTH', order_date),
  region,
  category;
4つ目:出力を検証する
条件を満たさない場合に、ジョブを成功扱いにしないための確認です。
WITH checks AS (
  SELECT
    (
      SELECT COUNT(*)
      FROM test.handson.sales_clean_job
    ) AS clean_count,
    (
      SELECT COUNT(*)
      FROM test.handson.sales_clean_job
      WHERE order_id IS NULL
         OR customer_id IS NULL
         OR quantity <= 0
    ) AS invalid_clean_count,
    (
      SELECT COUNT(*)
      FROM test.handson.monthly_sales_job
    ) AS monthly_count
)
SELECT
  assert_true(
    clean_count > 0,
    'sales_clean_jobが0件です'
  ),
  assert_true(
    invalid_clean_count = 0,
    'sales_clean_jobに不正データが残っています'
  ),
  assert_true(
    monthly_count > 0,
    'monthly_sales_jobが0件です'
  )
FROM checks;
画面からジョブを作る
左側メニューから次の順に選択します。
ジョブとパイプライン
  → 作成
  → ジョブ
最初のタスクでノートブックを選びます。
ジョブ名です。
handson_sales_batch_job
2つ目以降は、タスクグラフのタスクの追加から作成します。
| タスク | 依存先 | 依存関係の場合に実行 |
|---|---|---|
| 01_quality_summary | なし | ― |
| 02_build_sales_clean | 01_quality_summary | すべて成功しました |
| 03_build_monthly_sales | 02_build_sales_clean | すべて成功しました |
| 04_validate_outputs | 03_build_monthly_sales | すべて成功しました |
依存関係は画面上で線として表示されます。
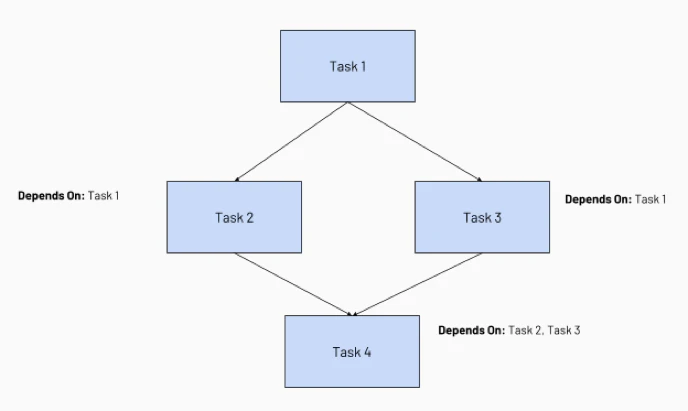
今すぐ実行を選択すると、タスクが上から順番に実行されます。
失敗通知を設定する
ジョブの詳細にあるジョブ通知から、次を設定しました。
宛先:自分のメールアドレス
イベント:失敗
テスト段階では、開始や成功の通知まで有効にすると通知数が増えるため、失敗だけにしています。
意図的に失敗させて修復する
最後のNotebookへ、一時的に次を追加します。
SELECT assert_true(
  false,
  'ハンズオン用に意図的な失敗を発生させました'
);
再実行すると、4つ目だけが失敗します。
コードを元に戻した後、失敗した実行の詳細画面で実行の修復を選択します。
成功済みの上流タスクを再実行せず、失敗タスクと必要な下流タスクだけを再実行できました。
なお、INSERT処理が途中まで成功したジョブを修復する場合は、同じデータが重複しない設計になっているか確認する必要があります。
3. Lakeflowパイプラインを作成する
Lakeflowパイプラインで作る構成
sales_bronze_pipeline
        ↓
sales_silver_pipeline
        ↓
monthly_sales_gold_pipeline
今回は、ストリーミングではなくマテリアライズドビューを使います。
理由は、既存のDeltaテーブルを元に、まずはパイプラインの依存関係とデータ品質機能を理解することを優先したためです。
パイプラインを作成する
左側上部から次の順に選択します。
新規
  → ETLパイプライン
設定です。
| 項目 | 設定 |
|---|---|
| パイプライン名 | handson_sales_medallion_pipeline |
| カタログ | test |
| スキーマ | handson |
| コンピュート | サーバーレス |
公式ドキュメントのパイプラインエディター画面です。
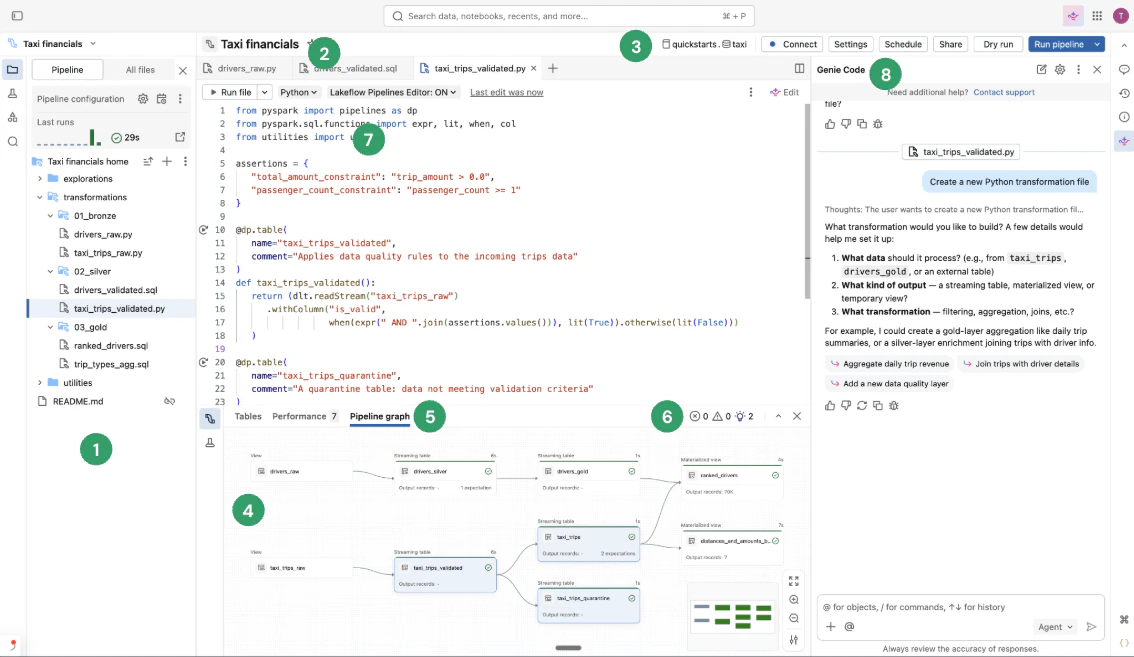
SQL変換ファイルを作り、次のコードを貼り付けます。
Bronze
CREATE OR REFRESH MATERIALIZED VIEW sales_bronze_pipeline
AS
SELECT
  order_id,
  CAST(order_date AS DATE) AS order_date,
  customer_id,
  region,
  channel,
  product_code,
  CAST(quantity AS INT) AS quantity,
  CAST(unit_price AS DECIMAL(12, 2)) AS unit_price,
  CAST(discount_rate AS DECIMAL(5, 4)) AS discount_rate,
  status,
  CURRENT_TIMESTAMP() AS loaded_at
FROM test.handson.sales_raw;
Silver
Silverでは、エクスペクテーションを設定します。
CREATE OR REFRESH MATERIALIZED VIEW sales_silver_pipeline (
  CONSTRAINT valid_order_id
    EXPECT (order_id IS NOT NULL)
    ON VIOLATION DROP ROW,

  CONSTRAINT valid_customer_id
    EXPECT (customer_id IS NOT NULL)
    ON VIOLATION DROP ROW,

  CONSTRAINT valid_quantity
    EXPECT (quantity > 0)
    ON VIOLATION DROP ROW,

  CONSTRAINT product_found
    EXPECT (product_name IS NOT NULL)
    ON VIOLATION DROP ROW
)
AS
WITH ranked AS (
  SELECT
    *,
    ROW_NUMBER() OVER (
      PARTITION BY order_id
      ORDER BY order_date DESC, product_code, customer_id
    ) AS row_num
  FROM sales_bronze_pipeline
)
SELECT
  s.order_id,
  s.order_date,
  s.customer_id,
  regexp_replace(s.region, '[  ]+$', '') AS region,
  s.channel,
  s.product_code,
  p.product_name,
  p.category,
  s.quantity,
  s.unit_price,
  s.discount_rate,
  s.status,
  CAST(p.cost AS DECIMAL(12, 2)) AS cost,
  ROUND(
    s.quantity * s.unit_price * (1 - s.discount_rate),
    0
  ) AS sales_amount,
  ROUND(
    s.quantity * s.unit_price * (1 - s.discount_rate)
      - s.quantity * CAST(p.cost AS DECIMAL(12, 2)),
    0
  ) AS gross_profit,
  CURRENT_TIMESTAMP() AS processed_at
FROM ranked AS s
LEFT JOIN test.handson.product_master AS p
  ON s.product_code = p.product_code
WHERE s.row_num = 1;
Gold
CREATE OR REFRESH MATERIALIZED VIEW monthly_sales_gold_pipeline
AS
SELECT
  DATE_TRUNC('MONTH', order_date) AS sales_month,
  region,
  category,
  SUM(sales_amount) AS sales_amount,
  SUM(gross_profit) AS gross_profit,
  COUNT(DISTINCT order_id) AS order_count,
  CURRENT_TIMESTAMP() AS processed_at
FROM sales_silver_pipeline
WHERE status = '完了'
GROUP BY
  DATE_TRUNC('MONTH', order_date),
  region,
  category;
パイプラインを実行する
右上のパイプライン実行を選択します。
コードの記述順だけではなく、データセットの参照関係から次のグラフが作られました。
sales_bronze_pipeline
        ↓
sales_silver_pipeline
        ↓
monthly_sales_gold_pipeline
元データを変更していない場合、件数は次の想定です。
| データセット | 件数 |
|---|---|
| sales_bronze_pipeline | 124 |
| sales_silver_pipeline | 121 |
Silverで減った3件の内訳です。
重複除去:1件
customer_idがNULL:1件
quantityが0以下:1件
region末尾の空白は、行を削除せず文字列を補正しています。
エクスペクテーションの結果を確認する
パイプライングラフでsales_silver_pipelineを選び、データ品質を開きます。
今回の想定違反件数です。
| エクスペクテーション | 想定違反件数 |
|---|---|
| valid_order_id | 0 |
| valid_customer_id | 1 |
| valid_quantity | 1 |
| product_found | 0 |
ON VIOLATION DROP ROWを指定しているため、不正行はSilverへ書き込まれませんが、違反件数は画面上で確認できます。
DROP ROWとFAIL UPDATEの違いを試す
valid_quantityを一時的に次へ変更します。
CONSTRAINT valid_quantity
  EXPECT (quantity > 0)
  ON VIOLATION FAIL UPDATE
元データには負数のquantityがあるため、パイプライン更新が失敗します。
確認後はDROP ROWへ戻し、再度実行します。
この違いは、実務で不正データを発見した際に、
- 不正行だけ除外して処理を続けるか
- データセット全体の更新を止めるか
を判断するために重要です。
4. 3機能の違い
今回触った3機能を整理します。
| 機能 | 役割 | 今回の利用方法 |
|---|---|---|
| SQLアラート | SQL結果をしきい値で監視 | 不正件数が1件以上なら通知 |
| Lakeflowジョブ | 複数処理の実行順序を制御 | 品質確認、整形、集計、検証 |
| Lakeflowパイプライン | データセットの依存関係と品質を管理 | Bronze、Silver、Gold |
実務では、次のように組み合わせられます。
Lakeflowパイプラインでデータを生成
        ↓
Lakeflowジョブで実行時刻や後続処理を管理
        ↓
SQLアラートでデータの異常を通知
つまずいた点
SQLアラートが表示されない
ワークスペースの機能設定や権限によって、アラートメニューが表示されない場合があります。
SQLウェアハウスを使用できるか、管理者へ確認します。
ジョブの依存先が表示されない
ジョブにタスクが1つしかない段階では表示されません。
2つ目以降のタスクを作成すると設定できます。
パイプラインの出力先が想定と違う
パイプライン名の横にあるカタログとスキーマを確認します。
今回の設定は次です。
test.handson
エクスペクテーションの違反件数が見つからない
パイプライングラフで、エクスペクテーションを設定したsales_silver_pipelineを選択し、データ品質を確認します。
修復実行でデータが重複する可能性がある
修復実行は失敗タスクを最初から実行します。
追記だけを行う処理は、同じデータが再登録されない設計にする必要があります。
まとめ
今回は、前回作成した売上データを使い、Databricks上で監視、自動実行、データ品質管理までを試しました。
特に理解しやすかったのは、3機能がそれぞれ別の範囲を担当している点です。
SQLアラート
  = データの状態を監視する

Lakeflowジョブ
  = 処理の実行順序を管理する

Lakeflowパイプライン
  = データの依存関係と品質を管理する
NotebookでSQLを実行するだけの段階から、異常検知、定期実行、失敗時の再実行まで進めたことで、実務で必要になる運用の流れを一通り確認できました。
次に進める場合は、Volumeへファイルを追加し、Auto Loaderを使ったストリーミングテーブルとファイル到着トリガーを組み合わせると、より実務に近い構成になります。