
2026-10-11 時点の情報です。Claude Code の記録の形式や Claude のデスクトップ版の仕様が変わると、ここに書いた挙動も変わる可能性があります。
Claude Code のセッションを複数並べて走らせると、5時間枠の残りが気づかないうちに減っていることがあります。どのセッションが食っているのか、サブエージェントが何体動いているのか、コンテキストがどこまで膨らんでいるのか。それを ~/.claude の記録から一覧にする macOS アプリ「Agent Atlas」を作りました。
この記事は、Agent Atlas が何を読み取り、どう推定し、何を見せないかをまとめたものです。
TL;DR
- 起動中の Claude Code セッションとサブエージェントを、親子関係のツリーと並列実行のタイムラインで見せる。設定なしで、開くだけ
- 各エージェントのコンテキスト量と、その内訳(ツール結果・出力・入力など)を出す。内訳は文字数から 3.5文字=1トークンで換算した推定値
- compact を勧めるセッションと、モデルが仕事に対して軽すぎる/重すぎる可能性を、記録から目安として出す。閾値はどれも公式の値ではなく筆者が決めた目安
- 集計は
~/.claudeの読み取りだけで行い、集計内容を外部へ送らない - 5時間枠・7日枠の使用率は記録に残らないので、取得は任意機能(status line の中継か、
claude -pの最小呼び出し)。どちらも画面で承認してから動く
画面の構成
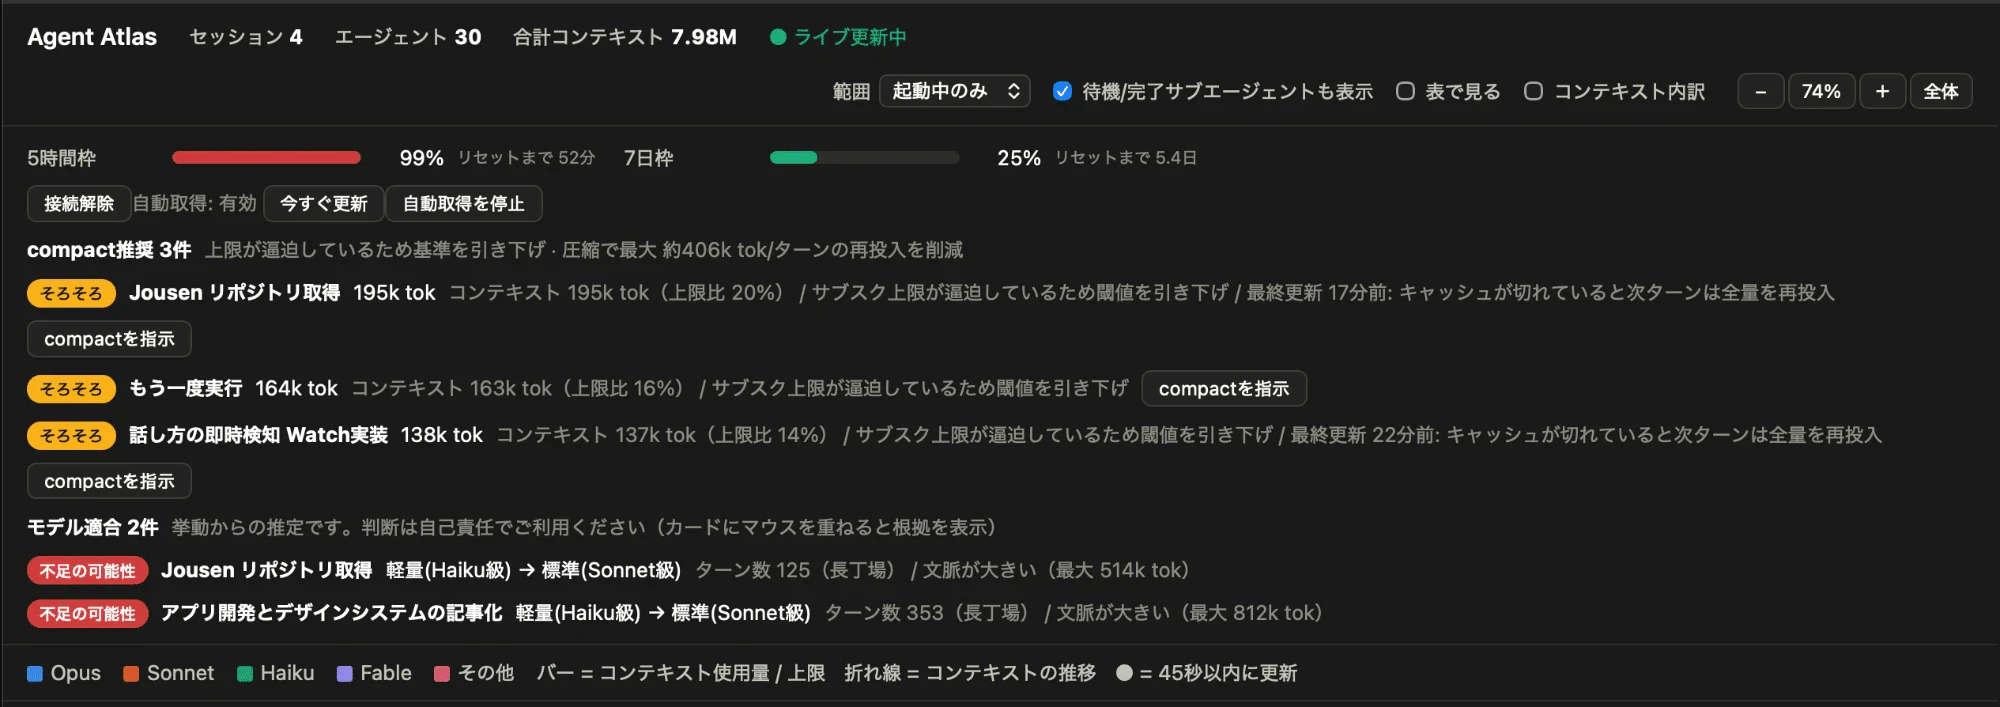
アプリを起動すると、起動中のセッションが自動で並びます。画面上部に出るのは次の4つです。
- セッション数・エージェント数・合計コンテキスト
- 5時間枠と7日枠の使用率(取得できている場合)
- compact を勧めるセッションの一覧
- モデルが合っていない可能性があるエージェントの一覧
その下に、セッションからサブエージェントへ伸びるツリー図があります。
| 表示 | 意味 |
|---|---|
| カードの色 | モデルの系統(Opus・Sonnet・Haiku・Fable) |
| バー | コンテキストの使用量を、上限に対する割合で表したもの |
| 稼働中の印 | 45秒以内に更新があったもの |
画面の注記では、数値の定義を次のように書いています。
- コンテキストは、直近ターンの入力トークン(input + cache read + cache create。advisor 分は除外)
- 上限は公開仕様表の値。上限は transcript には記録されない
- モデルはターンごとに変わりうるので、直近ターンのモデルを表示する
ツリー図とタイムライン
親子関係(誰が誰を起動したか)は、そのままツリーにします。Workflow のように並列で動くものは、タイムラインにまとめます。
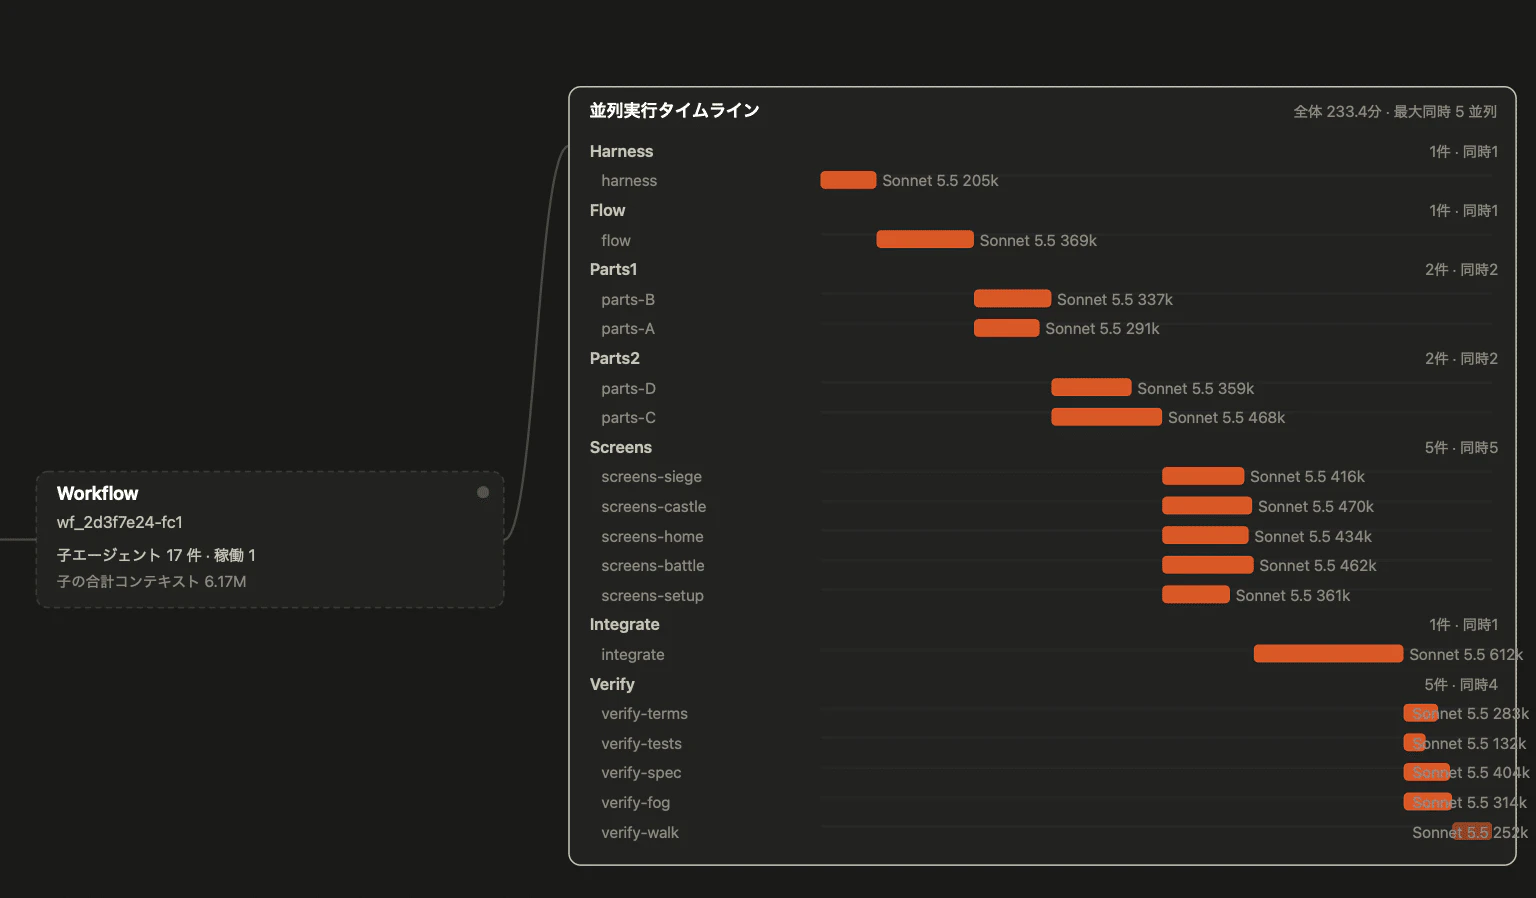
タイムラインでは、各エージェントがいつ始まり、いつまで動いたかが横棒でわかります。同時に何本走っていたか、どのフェーズで詰まったかを、あとから見返せます。
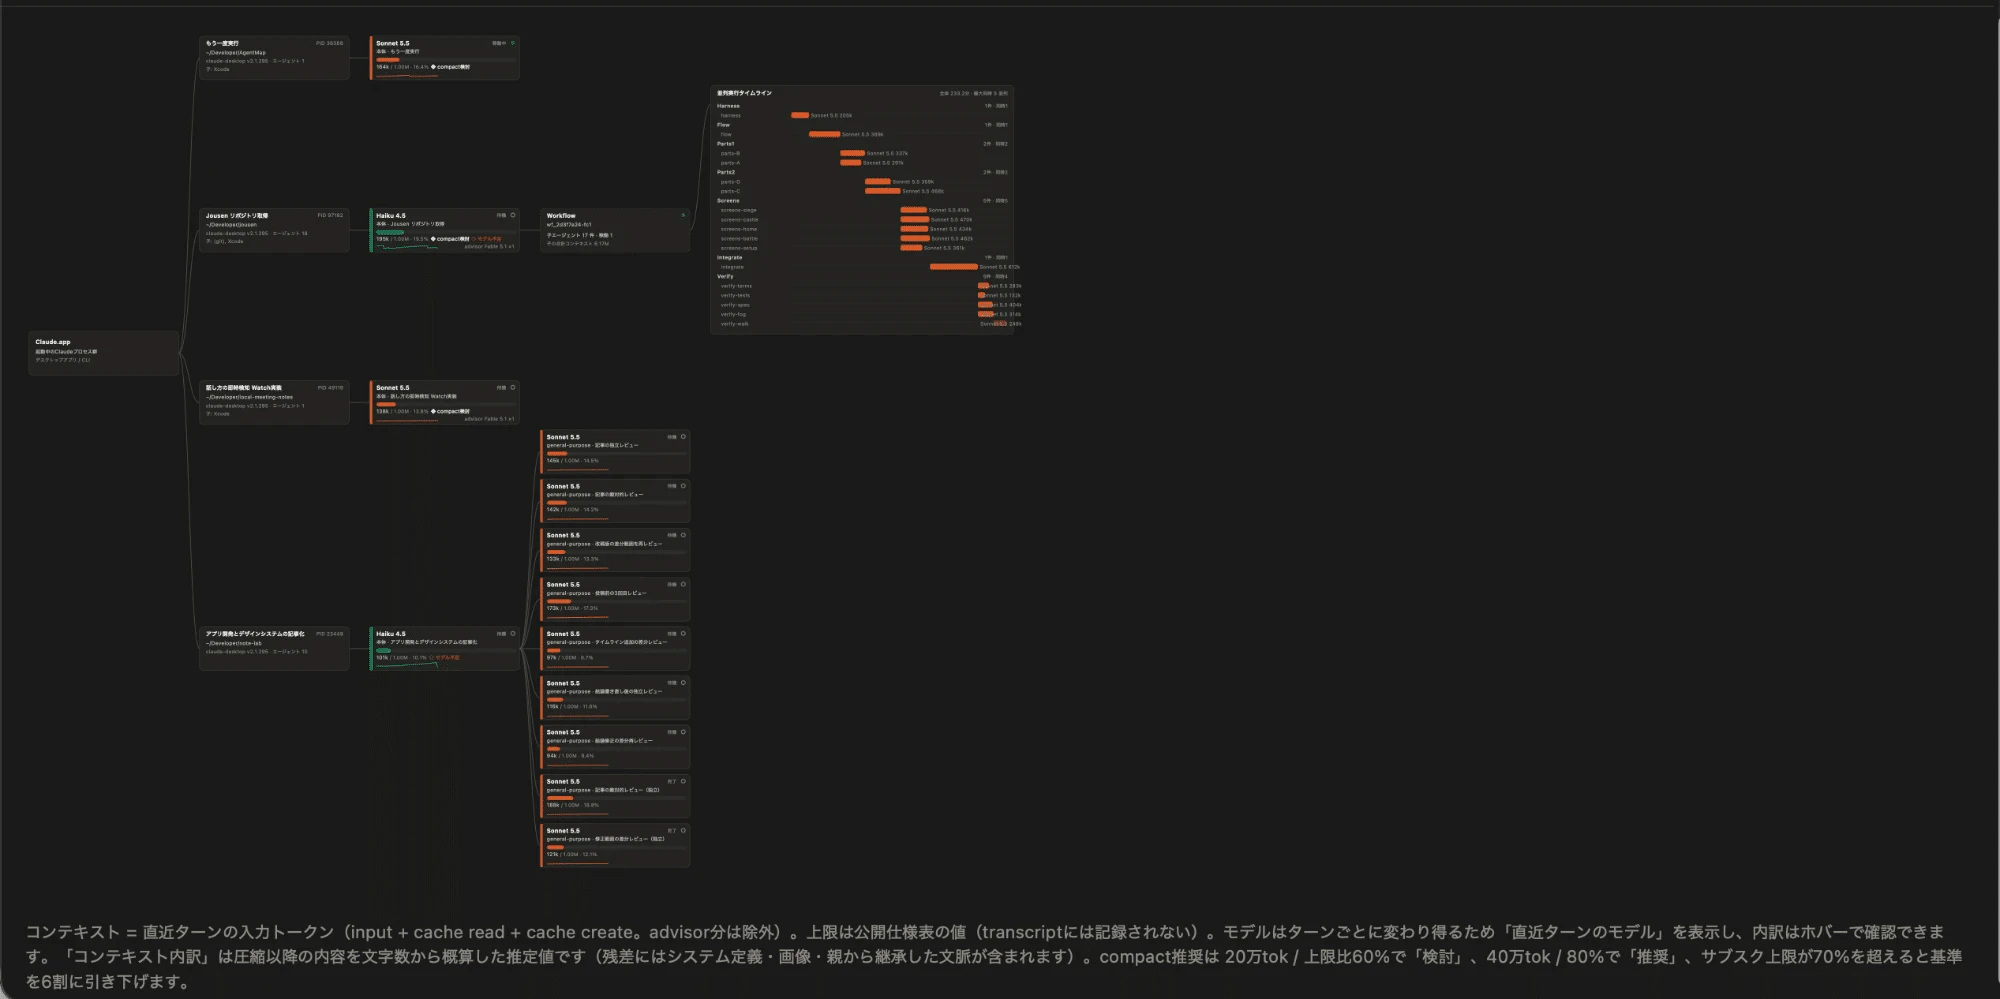
セッションが増えると図は大きくなるので、表示の倍率を変えられます。
| 操作 | 内容 |
|---|---|
| 右上の「全体」 | 全部が画面に収まる倍率にする |
| 拡大縮小の範囲 | 15%〜250% |
| キーボード | ⌘+ / ⌘- / ⌘0 |
| トラックパッド | ピンチ |
コンテキストの内訳(推定)
コンテキストの合計だけでは、何を削ればよいかわかりません。そこで、圧縮(compact)以降の内容を次の項目に分けて出します。
- ツール結果(ツールごと)
- アシスタントの出力・思考
- ユーザー入力
- ツール呼び出し
- システムが注入した指示
- 圧縮後の基底
あわせて、大きかったツール結果の上位5件を、ファイル名やコマンドと一緒に出します。
肥大化の原因は、「長い会話」よりも「大きなツール結果」であることが多い。
これは筆者の手元のセッションから見た印象で、公式に明記されたものではありません。内訳を出すと、この見立てが自分のセッションでも当てはまるかを確かめられます。
内訳は、文字数から 3.5文字=1トークン で換算した推定値です。システム定義、画像、親から継承した文脈は「残差」にまとまります。「どのツール結果が大きいか」を見るには足りますが、正確なトークン数の集計には使えません。
compact を勧める条件
閾値は次のとおりです。公式の値ではなく、筆者が決めた目安です。環境によって合わないことは十分にありえます。
トークン数か上限比の、どちらかに達すると出ます。
| 段階 | トークン数 | 上限比 |
|---|---|---|
| そろそろ | 20万 | 60% |
| 推奨 | 40万 | 80% |
| サブスク上限が 70% 以上のとき(基準を6割に引き下げ) | 12万 / 24万 | 36% / 48% |
勧める理由も一緒に出ます。たとえば、最終更新から5分以上たち、コンテキストが10万トークンを超えているセッションには「キャッシュが切れていると、次のターンで全量を再投入することになる」という注記が付きます(この因果は筆者の整理です)。
compact の指示の送り方
「compact を指示」を押すと、送る文面を編集できます。既定の文面は、内訳で最も大きかったツール結果を要約する形で自動で組み立てます。送り方はセッションの種類で変わります。
| セッション | 送り方 |
|---|---|
| CLI(Terminal.app / iTerm2) | 送信前に確認を出したうえで、該当タブへ入力する |
| CLI(タブを特定できない、または他のターミナル) | 文面のコピーで終わる |
| Claude のデスクトップ版 | 文面をコピーし、対象セッションを前面に出して、貼り付けと実行を試みる。アクセシビリティの許可と、確認ダイアログの承認が必要 |
デスクトップ版のセッションに外部から文字を送る方法は、公式ドキュメントでは見つけられていません。この経路は画面操作を使った補助です。筆者の環境では、実際の送信まで動作を確認できていません。デスクトップ版の仕様が変わると動かなくなる可能性もあります。確実なのは、コピーして自分で貼り付ける方法です。
モデルが仕事に合っているかの目安
記録から次の行動を数えて、仕事の重さを推定します。
- 編集したファイル数・編集回数
- ターン数・コンテキストの最大値
- 思考量・ツールのエラー回数
- 統括しているサブエージェントの数
判定の考え方は次のとおりです。
| 状況 | 出る判定 |
|---|---|
| 編集がなく、読み取りと検索が中心 | 軽量なモデルで足りる可能性 |
| 長丁場で大きな文脈を抱えているのに、軽量なモデル | 不足の可能性 |
| 作業量が多いだけ | 上位モデルが必要とは判定しない(作業量に加えて、思考量・エラー・統括のいずれかの兆候があるときだけ出す) |
| 3ターン未満 | 判定不可 |
これはモデルの優劣を測るものではありません。「仕事の重さに対して、モデルが軽すぎる/重すぎるかもしれない」という目安です。判定基準も筆者が決めたもので、公式の基準ではありません。
サブスク上限(5時間枠・7日枠)の取得
5時間枠と7日枠の使用率は、記録のファイルには残りません。取得方法は2つあり、どちらも任意で、画面で承認してから実行されます。
| 方法 | 仕組み | 書き換える・呼ぶもの | 既定 |
|---|---|---|---|
| 1. status line と連携 |
~/.claude/settings.json の statusLine.command を Agent Atlas 経由に書き換える。元のコマンドはそのまま中継し、変更前のバックアップも作る。画面の「接続解除」でいつでも戻せる |
~/.claude/settings.json と ~/.agentmap 以下(アプリ本体のコピーと取得した値) |
― |
2. claude -p で取りに行く |
デスクトップ版だけを使っている場合向け。上限の値が10分以上古いときに、最小の呼び出しを1回だけ実行する | Claude 自身の API(実行のたびに少量のクォータを消費) | 無効(有効化時に確認が出る) |
仕様と、向いていない場面
仕様として決まっていること:
- 読み取り先は
~/.claude。集計内容を外部へ送らない(方法2を有効にした場合は、Claude 自身の API を呼ぶ) - Apple Silicon と Intel の両方に向けて、macOS 12 以降を対象にビルドしている。動作を確認できているのは筆者の環境(Apple Silicon)だけで、Intel と macOS 12 は未確認
- 対象は起動中のセッション。「直近6時間」「24時間」「7日」に切り替えて過去分も見られる
- 巨大な記録は、末尾の約 6MB だけを集計する
向いていない場面:
| やりたいこと | 理由 |
|---|---|
| トークン数を正確に集計したい | 内訳は推定値 |
| Windows や Linux で使いたい | macOS 専用 |
| モデルの性能を評価したい | 判定は、行動の記録から見た目安 |
まとめ
- Agent Atlas は、起動中の Claude Code セッションとサブエージェントを、構造(ツリー・タイムライン)とコンテキストの両面から一覧にする
- 内訳・compact の目安・モデル適合は、記録から推定した値。閾値は公式ではなく筆者が決めた目安なので、数字の読み方を知ったうえで使う
- 設定の書き換えや上限の取得は、すべて画面で承認してから実行される。記録は読み取りだけで、集計内容は外部へ送らない
参考
※本記事は、アプリの実装に基づく仕様の解説で、公式ドキュメントを参照して書いたものではありません。数値の閾値(20万/40万トークン、60%/80%、70%)、コンテキスト内訳の換算、モデル適合の判定基準は、筆者(本アプリの作者)の目安です。