
Qoder の詳細はこちら
Qoder を体験する — オールインワン AI コーダー
Qoder エンジニアリング実践シリーズ:エージェントの境界が「ツール呼び出し」であるなら、クラウド利用(Cloud Use)の境界は「クラウドネイティブな実行」です。前者は AI が人間のソフトウェア操作を支援しますが、後者はエージェントを一種の新しいクラウドワークロードへと変容させます。この記事を読み終える頃には、「クラウド利用」と「通常のツール利用」の違いが、単にエージェントが API を呼び出せるかどうかではなく、管理されたアイデンティティ・資格情報・実行環境・ライフサイクル・監査ログを伴って、実際にクラウドの本番環境へと「入り込む」ことができるかどうかであることが明確になるでしょう。
午前2時——ある越境EC販売業者の新商品が突然注文数の急増に見舞われました。誰も目覚める前に、すでにエージェントが稼働し始めています。一時的なサンドボックスを生成し、在庫・支払いデータを取得し、異常注文を検知し、複数の物流オプションをシミュレートし、関税の影響を計算し、カスタマーサポート向けのレスポンス案を作成し、広告レコメンデーションを調整し、高リスク注文を人間による最終確認へとルーティングしています。コンソールを開いたり、サーバーにログインしたりすることはありませんが、まさに「クラウドを使っている」のです。
その瞬間、次のような問いが緊急かつ不可避になります:
- このエージェントは、在庫システムにアクセスする際に、誰のアイデンティティを使用しているのか?
- エージェントが閲覧した支払いデータは、適切にマスキングされているか?
- クラウドAPIを呼び出すために使用される資格情報(Credentials)はどこに保管されているか?
- リソースの仕様変更を行った場合、誰がそれを承認したのか?
- 40分間実行後にタスクが失敗した場合、その状態は復元可能か?
- すべての操作は監査可能か?
エージェントがクラウドAPIを1回だけ呼び出すことは難しくありません。難しいのは、それが毎日深夜に、複数のシステムをまたいで、許可された権限範囲内で継続的に呼び出され続け、さらにそのすべての呼び出しについて「誰が承認したか」「どの資格情報を使用したか」「どのような操作を行ったか」「リスク制御が発動したか」「結果が再現可能か」を確実に把握できることです。これらこそが、クラウド利用(Cloud Use)が真に答えるべき問いなのです。
クラウドが迎える「第二のユーザー」
20年以上にわたり、クラウドコンピューティングの主なインタラクションモデルは、人間の運用者と決定論的な自動化プログラムという2種類のアクターを中心に構築されてきました。人間はコンソールにログインし、Elastic Compute Service(ECS)インスタンスを作成し、データベースを設定し、ログを読み、アラートに対応します。一方、CI/CD、Terraform、Kubernetes コントローラー、定期実行スクリプトなどは、あらかじめ定義されたルールを実行します。その後、CLI、SDK、Infrastructure as Code(IaC)、およびその他の自動化プラットフォームが登場し、人間の作業負荷を大幅に削減しましたが、根底にある前提は一貫して明確でした:システムを操作するのは、人間か、あるいは決定論的なプログラムのいずれかです。このモデルは安定していました。クラウドプラットフォームは、アカウントシステム、権限モデル、監査ログ、コンソール操作、チケットワークフローを、この前提に基づいて構築してきました。Resource Access Management(RAM)ユーザー、AccessKey、あるいは操作記録は、通常、特定の個人、チーム、またはシステムにトレース可能でした。
エージェントの登場により、この二極の間に「中間領域」が生まれました。エージェントはもはや「このクラウド製品の使い方を教えてください」と答えることや、スクリプトを生成することだけに留まりません。ログを読み、請求書を分析し、CIの問題を診断し、データ処理タスクを検査し、クラウドAPIを呼び出し、マージリクエスト(MR)を送信し、パイプラインをトリガーするようになってきています。言い換えれば、エージェントは「クラウドを理解するアシスタント」から、「クラウドを実際に使うソフトウェア主体(Software Actor)」へと進化しつつあるのです。
クラウドコンピューティングは、長年にわたり人間の運用者と決定論的自動化プログラムを中心に設計されてきました。エージェントは、この枠組みに新たな変数を導入します:推論し、ツールを呼び出し、複数のシステムを横断して行動できるソフトウェア主体です。
その影響は、「もう一つのAIアシスタント」というレベルをはるかに超えています。ユーザーが人間であれば、コンソール、CLI、SDK、IaCはすべて、人間がクラウドを操作するための労力を削減します。決定論的プログラムが作業を行う場合、クラウドプラットフォームはサービスアカウント、ロール、ポリシー、ログを管理します。エージェントはこの二者の中間に位置します:人間の目標理解能力と、プログラムの実行速度・呼び出し頻度を兼ね備えているのです。エージェントにはコンソール、マウス、デスクトップは不要ですが、アイデンティティ、権限、ツール、データ、ランタイム環境、状態管理、コスト記録、障害復旧、監査ログが必要です。この3種類のユーザーを1枚の図で並べると、境界線がより明確になります。
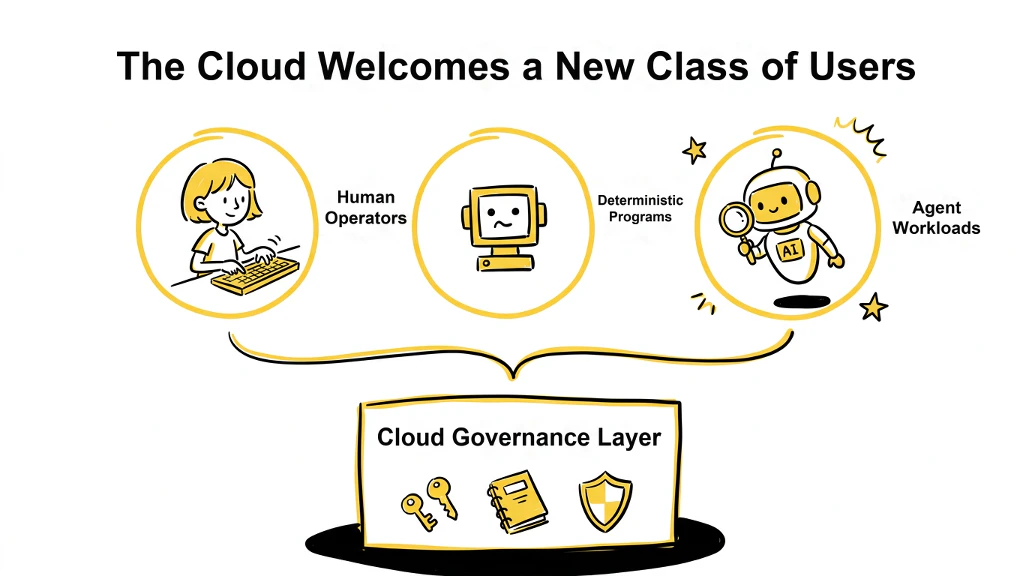
この図において、人間と決定論的プログラムは、クラウドが20年以上かけて洗練してきた「既知のユーザー」です。一方、エージェントはその間に新たに登場した「変数」です:人間のように1回のマウスクリックごとに操作するわけでもなく、スクリプトのようにあらかじめ決められたパスのみをたどるわけでもありません。エージェントは推論を行い、複数のシステムを横断してアクションをつなげます。これを受容するには、クラウドプラットフォームが、同一のガバナンスレイヤー内にエージェント専用の実行パスを提供する必要があります。実際、多くのツール利用(Tool Use)機能のみを持つエージェントは、デモでは機能しているように見えても、本番環境への導入段階で行き詰まってしまいます。ツールは呼び出せますが、クラウドプラットフォームはまだ、それらを「管理可能なソフトウェア主体」として受け入れていないのです。
エージェントがクラウドワークロードとして成立しない理由
私たちはすでに、課題の本質は「モデルの能力不足」ではなく、「今日のエージェントが、クラウドによって真に受容されてこなかった」ことにあり、ということを認識しています。デモでは華々しく見えても、本番環境ではその限界が露呈します。クラウドエージェントのデモは簡単に構築できます:AccessKey ID と AccessKey Secret(AK/SK)を渡し、いくつかのクラウドAPIをツールとしてラップし、プロンプトを書いて「昨日の請求書の異常をチェックしてください」と指示するだけです。十分な能力を持つモデルと、よくラップされたツールがあれば、確かに立派な結果を出せます。初日はすべて順調に見えますが、2日目になると疑問が湧きます:
- この AK/SK は誰のものか?
- 権限は広すぎないか?
- キーがモデルのコンテキストに入ってしまったか?
- ツール呼び出しのログはどこに保存されているか?
- リソースを誤って削除した場合、誰が責任を負うか?
- ユーザーがパソコンの電源を落としても、タスクは継続実行されるか?
- 別のチームメンバーが引き継いだ際、資格情報とコンテキストはどのように再利用されるか?
- セキュリティチームはどのように監査するか?
これらは周辺的な懸念事項ではありません。これらが、エージェントを「デモ」から「本番」へと移行させるか否かを決める鍵となるのです。
ツール利用(Tool Use)のみを持つエージェントは、通常、会話、数個のツール、そして結果という構成で成り立ちます。しばしば、それは「人の影」で動作します:人のパソコン上で実行され、人のアカウントでログインし、人の AK/SK で API を呼び出し、人のオンライン状態に依存してタスクを維持します。これは短時間のタスクや探索的分析には有効ですが、アイデンティティ、資格情報、ランタイム、監査のためのシステムが整っていない限り、エージェントは安定したクラウドワークロードにはなり得ません。クラウド利用(Cloud Use)とは、「エージェントがツールを呼び出せるかどうか」を問うものではありません。ツール利用、ファンクションコール、Model Context Protocol(MCP)などは、すでにその一部を解決しています。クラウド利用は、別の問いに答えます:クラウドがエージェントを、識別可能・承認可能・監査可能・プラットフォーム管理可能な形で、どう受け入れるか。
ツール利用のみのエージェントは「モデルがツールをどう呼び出すか」を扱います。クラウド利用は「クラウドが、ガバナンスされたユーザーとしてエージェントをどう受け入れるか」を扱います。
この区別こそが分水嶺です。議論を「エージェントがどのツールにアクセスできるか」から、「どこで実行されるか、どのようなアイデンティティで実行されるか、資格情報をどう使うか、タスクはどれだけ長く継続可能か、障害から復旧可能か、誰が監査できるか」へと移すのです。
| アスペクト | ツール利用のみ(クラウドプラットフォームのガバナンスなし) | クラウド利用(Cloud Use) |
|---|---|---|
| 実行場所 | ローカルプロセス、ブラウザセッション、または単一チャットのコンテキスト | クラウドセッション。タスクは継続実行・復旧・スケジュール可能 |
| アイデンティティモデル | 人のアカウントを借用、または固定キーを使用 | ガバナンスされたマシンアイデンティティと、タスク単位の承認 |
| 資格情報の使用 | AK/SK やトークンがプロンプト・スクリプト・ログに容易に流出 | Vault を通じて参照で資格情報を使用。モデルコンテキストには一切含めない |
| ツールの境界 | 個別の API をラップ。ガバナンスは実装ごとにばらばら | MCP や同様のツールプロトコルで機能を公開。権限・監査・確認メカニズムがプラットフォーム層で統合 |
| 本番リスク | 資格情報漏洩、過剰な権限、タスク中断、責任の所在不明 | 低リスク操作は自動実行。高リスク操作は確認必須。全プロセスがトレーサブル |
ツール利用のみに依存するエージェントは、あなたの隣に座って手伝ってくれる一時的なアシスタントのような存在です。クラウド利用は、エージェントに社員証を発行し、クラウドの職場へと正式に迎え入れるようなものです——その際、すべてのアクセスチェック、証拠収集ステップ、各アクションが記録されます。
シナリオ比較で見るクラウド利用(Cloud Use)の価値
理論はこれくらいにして、具体的なシナリオで見ていきましょう。これにより、クラウド利用が実際に埋める「本番環境のギャップ」が明確になります。「エージェントはログを照会し、レポートを実行し、API を呼び出せる」という説明だけでは、通常のエージェントとの差はほとんど伝わりません。なぜなら、それらは通常のエージェントでも可能です。真の違いは、作業の性質がどう変わるかにあります:タスクが人のオンライン状態に依存しなくなるか、エージェント自身がクラウド環境へと入り込んで証拠を収集できるか、そのアクションに明確なアイデンティティ・資格情報・監査の境界があるか、です。
1. 定期タスク:「毎日誰かがシステムを開く」から「タスクが自立して起動する」へ

多くのクラウドタスクは複雑ではありませんが、依然として人間の介入に依存しています。冒頭の越境EC販売業者に戻ると、注文急増の翌日には、チームが確認すべき項目が多数あります:在庫は枯渇したか? 支払い失敗率は異常か? 物流コストは急騰したか? カスタマーサポートのチケットは特定地域に集中しているか? 今日では、通常、誰かがBIシステム、クラウド請求書、データプラットフォーム、ログプラットフォームを開き、1つずつクエリを実行し、結果をグループチャットにまとめます。このワークフローは非常に反復的であり、ルールも比較的明確です。問題は難しさではなく、「誰かがそこにいる必要がある」ことです。
通常のエージェントは、この作業の一部を軽減できます。SQL の作成を支援し、異常を説明し、レポートを整えることができます。しかし、ほとんどの場合、タスクの開始、コンテキストの提供、資格情報の確認、結果のコピー&ペーストといったステップは、依然として人が行わなければなりません。エージェントは1工程を高速化するだけで、全体のチェーンは人間に縛られたままです。クラウド利用では、タスクが自立して起動します。
クラウドエージェントは、クラウド上の cron または予期せぬイベントによってトリガーできます。タスク単位のアイデンティティでデータソースやクラウドツールにアクセスし、Vault 経由で制御された資格情報を使用し、MCP を通じて BI、ログ、ストレージ、コンピューティングなどの機能を呼び出します。クエリを実行し、異常を特定し、レポートを生成し、結果をIM、ドキュメント、Webhook、または業務システムへ送信します。誰も毎日同じ時間にページを開く必要はありません。
定期タスクにおける真の変化は、単にレポート作成が速くなることではありません。タスクが特定の人物のオンライン状態に依存しなくなることです。
これは数分の節約以上の意味を持ち、責任の組織化方法そのものを変えます。以前は「誰かが毎日忘れずにやる必要があった」のですが、今では「委任されたタスクがスケジュール通りに実行され、人は例外対応と意思決定のみを担当する」ようになりました。先述の例では、1つのBI分析タスクが111回のツール呼び出しを行い、約21.5分(21分32秒)実行され、途中で0回の人間介入がありました。また、1つのETLタスクは116件のイベントを生成し、cron トリガー後に13分で完了しました。これらの数値は特定のサンプルタスクからのものであり、すべてのシナリオで保証されるSLAではありません。目的は呼び出し回数を誇示することではなく、エージェントがチャットウィンドウ内の「回答者」に留まらない——ライフサイクルを持つクラウドタスクを担えることを示すことです。
2. 診断タスク:「人が資料を渡す」から「エージェントが現場で証拠を集める」へ
CIの失敗、遅いクエリ、本番アラートは、もう一つの典型的なタスクカテゴリです。以前、MR に対する CI が失敗した場合、開発者はパイプラインログを開き、テスト失敗を検査し、最近の依存関係変更を調べ、ビルドイメージを検証し、さらにクラウド上のビルドマシン、キャッシュ、ネットワーク、権限設定を確認する必要がありました。問題自体は必ずしも深くなく、単にコンテキストが多すぎるシステムに散在しているだけです。通常のエージェントもここでは有用です:ログを貼り付ければエラーを要約し、設定を貼り付ければ原因を推定できます。しかし、これは依然として「資料をエージェントに持ち込む」行為に過ぎません。エージェント自身が環境へ入り込み、証拠の連鎖を自ら追跡することはできません。与えられた断片のみを分析するにすぎません。
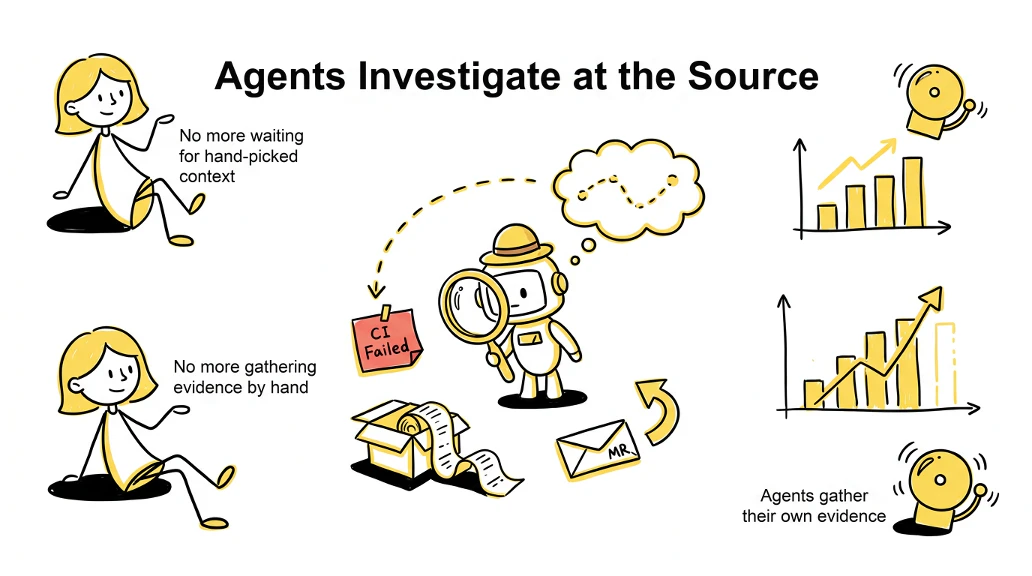
クラウド利用は、診断タスクの実行方法を変革します。CI 失敗イベントが発生すると、クラウド上で直接エージェントAPIがトリガーされます。エージェントはクラウドアイデンティティを使ってパイプラインログを読み、関連する MR を検索し、依存関係の変更を検査し、ビルド環境の状態にアクセスします。必要に応じて、ログ・モニタリングシステムを呼び出し、証拠をつなぎ合わせ、その所見を MR コメント、IM グループ、またはチケットに書き戻します。これは単なる「ログの要約」を超え、「積極的な証拠収集」です。
診断タスクにおける真の変化は、単にエラーの説明が良くなることではありません。エージェントがクラウドの職場そのものへと入り込み、コンテキストを収集し、証拠の連鎖を構築できることです。
ELK による遅いクエリ診断や CI 失敗診断などのシナリオでは、この違いが特に明確です。先述の例では、遅いクエリ診断は2〜5分以内にエンドツーエンドの所見を提示でき、CI 診断は3〜8分以内に分析結果を MR へ投稿できました。実際の所要時間は、システム規模、ツールの応答時間、コンテキストの複雑さに依存します。分単位の数字そのものは意味を持ちません。重要なのは、エージェントが誰かが資料をコピーするのを待つのではなく、イベントを起点に能動的に証拠収集を開始する点です。
3. 実行タスク:「スクリプトによる自動化」から「ガバナンスされた実行」へ
実行タスクは最も誤解されやすい分野です。エージェントが問題を診断できたなら、それを直接修正できるでしょうか? プレビュー環境を作成し、パイプラインをトリガーし、一時リソースをクリーンアップし、設定を調整できるでしょうか? 越境EC販売業者の例では、エージェントは自動的に補充提案を生成し、物流オプションをシミュレートできます。しかし、広告予算の変更、フルフィルメント戦略の変更、高リスク注文の処理については、必ず停止して人間の確認を待たなければなりません。技術的には、十分な権限があれば実行可能ですが、そここそが真のリスクが潜む場所です。
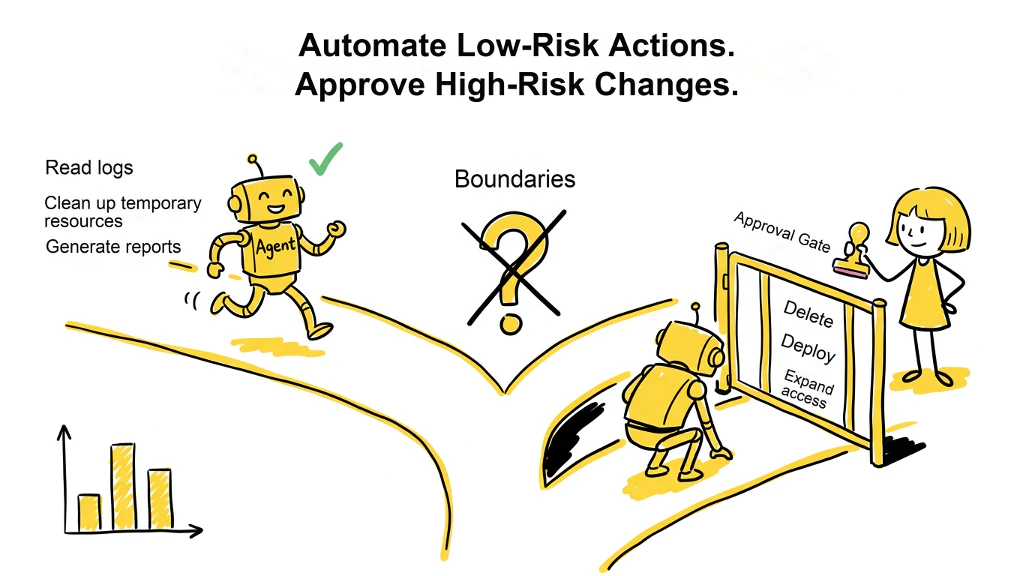
多くのチームはすでにスクリプトによる自動化を導入しています。スクリプトにはキー、権限、スケジュールジョブ、ログがあります。しかし、通常は動的な判断力や横断的なコンテキストに乏しく、結果の説明も苦手です。通常のエージェントは判断力を加えますが、同時にリスクも拡大します:コンテキストに基づいて行動できますが、アイデンティティ・資格情報・権限・監査が追いつかなければ、強力な自動化ほど「爆発半径(Blast Radius)」が大きくなります。
クラウド利用は、エージェントに無制限の自動実行を許可することを目指していません。むしろ、実行を安全に委任できるようにすることを目指しています。低リスク操作(ログの読み取り、レポート生成、一時サンドボックスの作成、期限切れリソースのクリーンアップなど)は自動実行可能です。高リスク操作(本番リソースの削除、権限の拡張、本番設定の変更、ユーザーに影響を与えるリリースのトリガーなど)は、必ず確認を経る必要があります。エージェントは提案と証拠を提供できますが、これらの境界を越えてはいけません。
実行タスクにおける真の変化は、低リスクの自動化、高リスク操作の承認、エンドツーエンドのトレーサビリティ——つまり、人間を完全に置き換える自動化ではありません。
定期タスク・診断タスク・実行タスクを総合すると、エージェントはもはやチャットウィンドウ内のアシスタントではなく、アイデンティティ・境界・ライフサイクルを持つソフトウェア主体という新たな役割を担っています。通常のエージェントによる自動化は、しばしば「信頼」に依存します:プロンプトを信頼し、モデルを信頼し、ツールラッパーを信頼します。クラウド利用は「ガバナンス」に依存します:エージェントのアイデンティティは確立可能、資格情報はエージェントに見えず、権限は取り消し可能、アクションは承認対象、プロセスは監査可能、障害は復旧可能である、という点です。
コーヒーブランドがクラウドエージェントに分析を委任した事例
理論が明確になったら、それを実際のケースで検証し、本当に機能するかを確かめる必要があります。このセクションでは、上記のモデルを、あるコーヒーチェーンのビジネスレビュー会議に適用します。
月曜日の朝9時、コーヒーチェーンのビジネスレビュー会議が始まります。CEOは「全体的に好調」という週次レポートを望んでいません。彼が求めるのは3つの答えです:
- 1平方メートルあたりの1日平均売上が最も高い店舗形式は何か?
- 次の成長ドライバーとして浮上しているカテゴリーは何か?
- 次四半期に新規出店を優先すべき都市はどこか?
杭州、深圳、成都、広州の15店舗のデータは、4つのテーブルと320行のファクトデータに分散しています。大規模な課題ではありませんが、十分に厄介です。従来のワークフローはお馴染みです:事業部門がリクエストを提出 → データアナリストがスケジュールを調整 → 指標定義を合意 → SQL を記述 → MaxCompute やデータウェアハウスでクエリ実行 → テーブルを整理 → ビジネスレポートを作成。最短でも数日、最悪で1〜2週間かかります。アナリストの努力不足ではありません。問題は、こうしたタスクが常に誰かのカレンダー上で「待ち行列」に並ぶ必要があることです。
クラウド利用の魅力は、「エージェントがSQLも書ける」という点にはありません。それは特別なことではありません。真の変化は、この作業をクラウドタスクとして委任できる点にあります。エージェントはチャットウィンドウ内のQ&Aパートナーから、アイデンティティ・資格情報の境界・ランタイム・イベント配信・受理基準を持つソフトウェア主体へと進化します。
コーヒービジネスインテリジェンス(BI)事例の価値は、単にレポートを生成したことではなく、ビジネス質問 → データアクセス → クエリ実行 → 障害復旧 → 結果配信 → 受理証明という完全なチェーンを走らせたことにあります。
このチェーンは、6つのエンジニアリング質問にマッピングできます。これらは製品モジュールの分解ではなく、実際のタスクが前進する過程で乗り越えなければならない6つのハードルです:
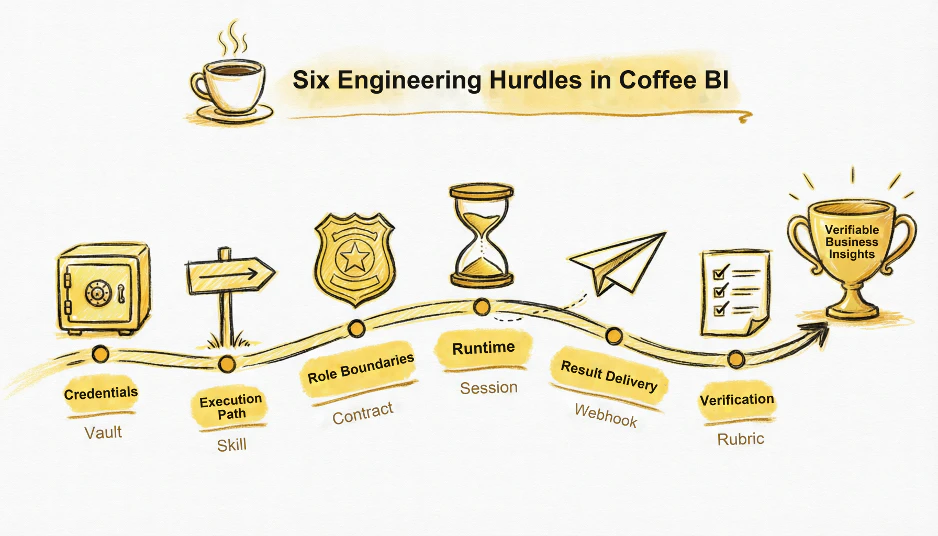
資格情報:プロンプトではなく、Vaultへ
タスク開始時の最初の障壁は、モデルでもSQLでもありません。資格情報です。エージェントはデータウェアハウスをクエリする必要がありますが、最も乱暴な方法は、AK/SK をプロンプトに直接埋め込むことです。迅速ですが、危険です。キーはモデルコンテキストに入り、ツールログに表示され、中間結果によって Webhook ペイロードに運ばれる可能性があります。実際の本番環境では、これはセキュリティ審査を通過しません。
そこで、資格情報はまず Vault へ格納されます。エージェントはプレーンテキストのキーではなく、vault_credential_id といった参照を受け取ります。ランタイムが DataWorks、MaxCompute、その他のクラウドサービスにアクセスする際、プラットフォームまたはツール層が資格情報の交換と制御された注入を処理します。この区別は極めて重要です:エージェントはクラウドを利用できますが、コピー可能なマスターキーを所有してはいけません。
実行パス:スキルが学習した教訓を記録し、再び学び直す必要をなくす
資格情報の問題が解決されると、次の課題が現れます:エージェントはどのパスを選択すべきか? MaxCompute データを分析する必要があることは分かっていても、実際の企業環境では、ODPS SQL を DataWorks 経由で送信すべきであることは分かりません。エージェントは、一見直接的そうなインターフェースを探したり、適用できないAPIを繰り返し試したりするかもしれません。「賢い」モデルほど、一見妥当に見えるが実際には機能しないパスを即座に発明します。ここで「スキル(Skill)」の価値が発揮されます。これは単なるプロンプトテンプレートではなく、組織が血を流して得た教訓の記録です:使わないべきAPI、注意すべきODPS SQL構文の落とし穴、リソースグループがフリーズした際に最初に確認すべき項目、レポートに含めるべきフィールドなど。この事例では、スキルが約13分の誤ったパス探索を回避しました。この数値はこの特定のタスクからのものであり、一般論を保証するものではありません。クラウド利用が再利用すべきは、検証済みの実行パスであり、単発のプロンプトではないことを示しています。
パスが確定したら、話題はロールの境界へと移ります。「あなたはデータアナリストです」という指示はあまりにも曖昧です——曖昧すぎて、エージェントが洗練されたがトレーサブルでないレポートを書く余地を与えてしまいます。クラウドでの実行前に、エージェントの範囲を明確に狭める必要があります:使用可能なツール、従うべき指標定義、独自に復旧可能なエラー、停止を要するアクションなどです。
ロールの境界:「アナリストです」と言うだけでなく、「タスク契約」を書く
簡略化されたタスク契約は以下のようになります:
あなたはシニアデータアナリストです。
DataWorks を通じて ODPS SQL を実行し、MaxCompute データを分析します。
各分析次元について、以下を提供してください:
1. 数値的根拠に基づく結論
2. クエリ結果の表
3. 具体的なビジネス推奨事項
データに関する主張は、証拠に直接トレースできないものであってはなりません。
リソースグループが利用不可の場合、まず利用可能なリソースグループを確認してください。
必要に応じて、事前に定義された復旧計画に従い、一時リソースグループを作成し、その操作を記録してください。
これはプロンプトのトリックのデモンストレーションではありません。むしろ、小さなタスク契約のようなものです:結論には数値を含める、その数値はクエリ結果にトレース可能である、エラー処理は許可された権限を超えてはならない、という点です。
ランタイム:ローカルプロセスではなく、クラウドセッション
タスクが実際に実行され始めると、ランタイムが試されます。この事例では、21分32秒の実行時間で111回のツール呼び出しと312件のイベントが発生し、途中で0回の人間介入がありました。これらの数値は、プラットフォームのSLAでも、すべてのBIタスクに対するパフォーマンス保証でもありません。示したいのは、クラウド利用が、通常のチャット1ターンよりも長いマルチステップタスクをサポートでき、そのプロセスはトレース・再生・業務システムとの統合が可能である、という点です。これは「エージェントをローカルで実行する」ことと「タスクをクラウドに委任する」ことの分岐点です。ユーザーがタスクを開始した後、エージェントはクラウドセッション内で継続実行します。ブラウザを閉じたり、PCをスリープさせたり、チャットウィンドウを切断しても、タスクのライフサイクルには影響しません。
結果配信:正しいイベントを待つ
レポートが生成された後、しばしば軽視されるもう一つの課題があります:結果をどう業務システムへ戻すか? 最終出力がチャットウィンドウ内のテキストに留まるなら、BIデジタルワーカーはまだ業務ワークフローに参入していません。より信頼性の高いアプローチは、業務システムがタスク終了イベントを購読することです——例えば、session.thread_idled が発生した後に完全な結果を取得します。早すぎると未完成の結果を得てしまい、スレッドがアイドル状態になってから取得すれば、結果は安定します。
実用的なコード例の方が、説明よりも明確です:
import hmac
import hashlib
import time

def verify_webhook(secret: bytes, raw_body: bytes, header: str, tolerance: int = 600) -> bool:
    parts = dict(item.split("=", 1) for item in header.split(","))
    timestamp = int(parts["t"])

    if abs(time.time() - timestamp) > tolerance:
        return False

    payload = f"{timestamp}.".encode() + raw_body
    expected = hmac.new(secret, payload, hashlib.sha256).hexdigest()
    return hmac.compare_digest(expected, parts["v1"])

def handle_event(event):
    if event["data"]["type"] == "session.thread_idled":
        session_id = event["data"]["id"]
        enqueue_report_pull(session_id)
コードは短いですが、境界は明確です:Webhookは信頼できるソースからのものであることを検証可能でなければならず、タスク完了はイベント駆動でなければならず、レポート取得は非同期で処理されなければなりません。そうでなければ、エージェントが作業を終えた後も結果が途中で失われる可能性があり、チェーンが不完全になります。
受理(Acceptance):実行可能な評価基準
最後に、エージェントが「完了した」と宣言したからといって、タスクが完了したとは限りません。BIタスクが完了したかどうかは、最後にレポート風のテキストブロックがあるかどうかではなく、ビジネス質問に答えられているかどうかで決まります:
- 1平方メートルあたりの1日平均売上が最も高い店舗形式は何か?
- 成長率が最も高いカテゴリーは何か?
- 新規出店を優先すべき都市はどこか?
- すべての結論に数値が含まれているか?
- その数値はSQLクエリ結果にトレース可能か?
| 受理項目 | 評価基準 |
|---|---|
| データソースへのアクセス | 制御された資格情報を使用し、プレーンテキストのキーは一切使用していないか? |
| クエリ実行 | トレーサブルなSQL文とクエリ結果が生成されたか? |
| 分析の完全性 | 1平方メートルあたりの1日売上、GMV、都市スコアなどのタスク要件が網羅されているか? |
| 結論の品質 | すべての結論に数値が含まれており、それらがトレース可能か? |
| 推奨事項の具体性 | 推奨事項は、抽象的な一般論ではなく、実行可能なビジネスステップに翻訳可能か? |
| 結果配信 | Webhook や業務APIを経由して、結果が下流システムへ到達したか? |
| 障害復旧 | エラー、リトライ、自己復旧パスが記録されたか? |
| 監査可能性 | イベントストリームからプロセスの主要部分を再生可能か? |
最終出力は「分析完了」という単なる宣言ではなく、検査可能なビジネス評価です:ピックアップ店舗の1平方メートルあたり1日平均売上は約¥85+/m²で、旗艦店舗の約¥38/m²の約2.2倍;GMVのうちコーヒーが81.3%を占め、茶飲料は前年比で18.5%、雑貨は45.0%増加;都市展開スコアは杭州が0.92、深圳が0.85、成都が0.78、広州が0.70です。こうした数値こそが、BIエージェントを「レポートを生成できる」から「ビジネス質問に答えられる」へと進化させるものです。
境界、境界、そしてさらに境界!
この事例では、リソースグループが利用不可という状況にも遭遇しました。通常のスクリプトは失敗して終了するだけですが、通常のエージェントは、誰かが介入するまで間違ったパスを繰り返し試すかもしれません。より適切なクラウド利用のアプローチは、スキルに「リソースグループ利用不可」を既知の障害モードとして記録することです:まず利用可能なリソースグループを確認し、必要に応じて事前に承認された範囲内で一時リソースグループを作成し、操作を記録した上で、残りのSQLを実行を継続します。コスト・権限・リソースの制限を超える操作は、依然として人間の確認を要します。このような自己復旧は、「エージェントがクラウドリソースを自由に変更できる」と解釈してはいけません。むしろ、クラウド利用の成熟度とは、「失敗しないこと」ではなく、「失敗した際にガバナンスの境界内で復旧できるか」「復旧できない場合は、どこでクリーンに停止できるか」であることを示しています。
本当に安全に委任できるエージェントは、自ら「完了」と宣言することで完了を確立しません。その完了状態は、イベント・ログ・成果物・受理基準によって共同で証明されます。
振り返ると、コーヒービジネスインテリジェンスのワークフローは、単なる事例研究以上のものです。クラウド利用の理論を具体的な設定に落とし込んでいます:資格情報は暴露してはならない→だからVault;実行パスは推測してはならない→だからSkill;実行は誰かがオンラインであることに依存してはならない→だからSession;結果はチャットウィンドウに留まってはならない→だからWebhook;完了は自己申告に依存してはならない→だからVerification。これは、クラウド利用を「自動化に見える」から「本番導入準備完了」へと進める、重要な一歩でもあります。
クラウドネイティブな実行モデル
コーヒービジネスインテリジェンスの事例から一歩引いて、クラウド利用をより抽象的に定義できます。
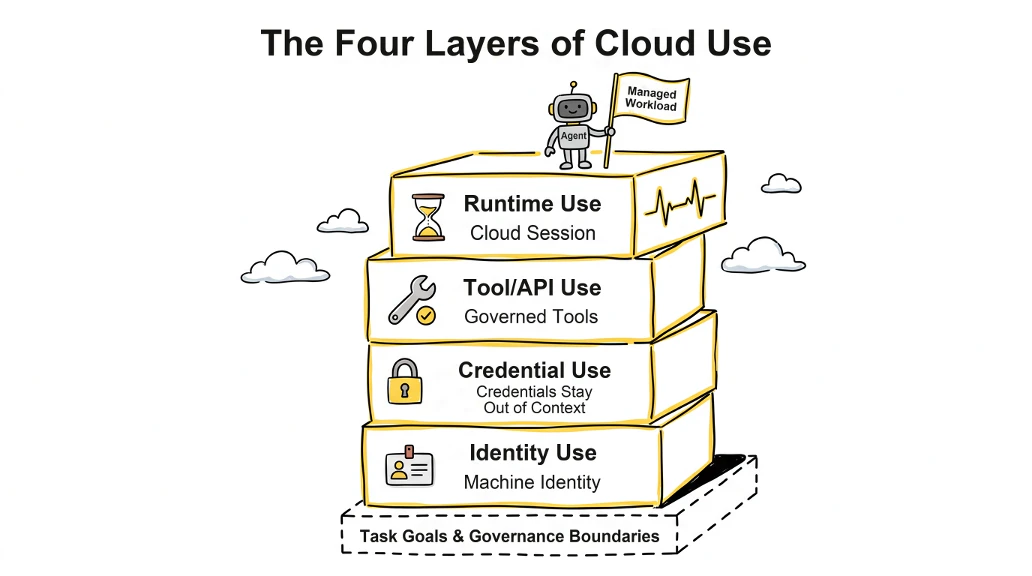
クラウド利用(Cloud Use)とは、エージェントがクラウドのコンピューティング、データ、ツール、アイデンティティ、ランタイムを、制御され、監査可能で、復旧可能な方法で活用し、タスクを完了させる能力のことです。
これらは機能のチェックリストではなく、依存関係のチェーンです:アイデンティティがなければ資格情報はなく、資格情報がなければツールはなく、ツールがなければランタイムはありません。これは単に「入り口の変化」にすぎません。真の変化は、エージェントが「ツールを呼び出すモデル」から、「クラウドプラットフォームがホスト・管理できるソフトウェア主体」へと進化することです。
これには少なくとも4層の能力が必要です。これらも、機能のチェックリストではなく、依存関係のチェーンです:アイデンティティがなければ資格情報はなく、資格情報がなければツールはなく、ツールがなければランタイムはありません。
-
アイデンティティ利用(Identity Use):「誰が行動しているか?」に答える。エージェントは人のアカウントを自分のものとして使い続けることはできませんし、人の AK/SK を保持してはいけません。クラウド上で実行されるソフトウェア主体のすべてのアクションについて、以下の問いに答えられる必要があります:誰がタスクを開始したか? エージェントはどのアイデンティティで実行しているか? 権限はどこから来て、いつ失効するか?
-
資格情報利用(Credential Use):「資格情報がどのように使われるか?」に答える。資格情報は呼び出しに使われることがありますが、プロンプト・ツールログ・エラーのスタックトレース・エージェントが自由に読み取れる一時ファイルなどには絶対に入ってはいけません。Vault、短期間有効なトークン、制御された注入、サーバーサイドプロキシは、すべて同じ根本的な目的を果たします:エージェントが資格情報を「見る」ことなく「使う」ことを可能にする。
-
ツール/API利用(Tool/API Use):「ツールがどのようにガバナンスされるか?」に答える。MCP や同様のプロトコルは、クラウドAPI、社内システム、CI、モニタリング、データベースをエージェントの世界に取り込むことができますが、プロトコル=ガバナンスではありません。権限、パラメーター制約、呼び出し監査、レート制限、リスク確認、エラー復旧は、プラットフォーム層・ゲートウェイ層・エンタープライズのID・アクセス管理(IAM)が共同で処理する必要があります。
-
ランタイム利用(Runtime Use):「タスクがどのように生き続けるか?」に答える。実際のクラウドタスクは、単一の質問と回答ではありません。タスクは10分でも2時間でも実行されるかもしれません。外部システムの応答を待ったり、途中で失敗してリトライしたりすることもあります。クラウドセッション、状態管理、イベントストリーム、キャンセル機構、結果配信が、エージェントが単一のチャットからプラットフォーム管理の実行プロセスへと進化できるかどうかを決定します。
クラウド利用の本質は、エージェントに「もう1つのツール」を与えることではありません。アイデンティティ・資格情報・ツール・ランタイムを提供し、クラウドプラットフォームがホスト・管理できるソフトウェア主体へと育てることです。
これらがなければ、エージェントは依然として会話の中の賢いアシスタントに過ぎません。助けにはなりますが、仕事を委任するのは困難です。
「人がリソースを操作する」から「エージェントがタスクを担う」へ
この4層が整えば、クラウドとそのユーザーの関係は静かに変化しています:人間はもはや唯一のフロントライン運用者ではありません。コンソール、CLI、SDK、IaC はすべて同じ問いに答えます:「人がクラウドリソースをより効率的に操作するにはどうすればよいか?」コンソールはデータセンターをページに変えました。CLI と SDK はページをコマンドとコードに変えました。IaC はリソースの集合を、宣言的・再利用可能・監査可能な設定に変えました。それぞれの進化は、より多くの基盤的詳細を隠し、人がより抽象度の高いレベルでクラウドを操作できるようにしました。
エージェントは、抽象度をもう一段上げるだけではありません。タスクそのものが新しいクラウド抽象概念になることを可能にします。人はもはやリソースを1つずつ操作しません。代わりに、目標・境界・受理基準を定義します。クラウド上で、エージェントは環境を作成し、データにアクセスし、ツールを呼び出し、並列で探索し、結果を検証し、リソースを解放します。これは一種の新しいワークロードに似ています:ライフサイクルは短く、権限は細かく、リソース使用は高度に動的で、振る舞いはトレーサブルでなければなりません。
歴史的に、クラウドの中心的な抽象概念は「リソース」でした。エージェント時代には、クラウドは「タスク」と「ソフトウェア主体」のための新しい抽象概念も必要としています。
これこそが、クラウド利用が古いインターフェースと新しいインターフェースの位置づけを再定義する場所です。コンソール、CLI、SDK、IaC を置き換えるものではありません。むしろ、これらの既存インターフェースがエージェントのツール層になるのです。エージェントはコンソールをクリックする必要はありませんが、制御されたインターフェースを通じてその背後にある操作を実行できます。CLIコマンドを手動でタイプする必要はありませんが、同等のクラウドAPIを呼び出せます。完全なTerraform設定を手書きする必要はありませんが、変更を生成・検証・提出でき、高リスク部分は人間の確認に委ねられます。新しいインターフェースは既存ツールを排除せず、それを実行層に取り込みます。
| クラウドの既存利用方法 | 解決する課題 | エージェント時代の新役割 |
|---|---|---|
| コンソール | 人がクラウドリソースを視覚的に管理できるようにする | 人間によるレビューと視覚的再生のためのインターフェースに |
| CLI / SDK | 人がクラウドリソースをプログラム的に操作できるようにする | エージェントがクラウド機能を呼び出すための基盤実行インターフェースに |
| IaC | リソースの状態を宣言的・バージョン管理可能にする | エージェントが生成・検証・提出する変更のガバナンス対象に |
| クラウド利用(Cloud Use) | エージェントがガバナンス境界内でクラウドタスクを担えるようにする | ソフトウェア主体がクラウドを利用するための新しい方法に |
だからこそ、「完全自動化」よりも「安全に委任可能であること」が重要なのです。
企業は、ブラックボックスのエージェントに自社のクラウドを渡しません。しかし、アイデンティティ・境界・ログ・復旧メカニズム・重大なポイントで明確に停止して人間の確認を待つ能力を持つソフトウェア主体には、仕事を委任する意思があります。 クラウド利用は、盲目的な信頼ではなく、検証可能な信頼を確立しようとしています。
エージェントの障害をどう制御下に置くか?
これまで、パラダイムシフトを説明してきましたが、それは完璧に聞こえるかもしれません。しかし、実際の本番環境は、概念モデルが完成したからといって協力的になるわけではありません。成功事例だけを示すと、クラウド利用は営業トークのように見えてしまいます。真のエンジニアリングの分岐点は、障害発生後に現れます。実際のクラウドタスクは障害に遭遇します:不適切なAPI、不十分な権限、利用不可なリソースグループ、クエリタイムアウト、失われたWebhook、ビジネス基準を満たさない結果など。本番対応の鍵は、障害パスそのものを設計することです——障害を隠したり、より長く推論して回避しようとしたりすることではありません。
クラウド利用が真に確保すべきは、エージェントの障害が観測可能・制御可能・復旧可能であること、そして復旧不可能な場合には明確に停止できることです。「常に成功する」ことが目標だったことは一度もありません。
1. 間違ったパス:エージェントは「一見妥当」だが実際には機能しないAPIを選択する
エージェントの推論能力が強ければ強いほど、一見妥当に見えるが実際には機能しないパスを提案しやすくなります。例えば、MaxCompute データをクエリする必要があると分かっているので、SQLを直接実行するAPIを探します。しかし、実際のクラウド製品のワークフローでは、正しいルートはDataWorks内の一時ワークフロー経由、あるいは指定された実行エントリーポイントであるかもしれません。スキルやツールの境界がなければ、エージェントは間違ったパスに時間を浪費し、何度も試すかもしれません。解決策は、モデルを「少しだけ賢くする」ことではなく、スキルに正しいパスと間違ったパスの両方を記録することです:どのAPIが利用可能か、どのAPIを避けるべきか、特定のエラーコードに遭遇したときにどのようにパスを切り替えるかをエージェントに伝えます。
2. インフラ障害:フリーズしたリソースグループが、即座に人間介入を意味するわけではない
リソースグループのフリーズ、キューの利用不可、一時的に無効な権限は、従来のワークフローでは人間介入のきっかけになります。クラウド利用では、これらを制御された自己復旧パスに変えることができます:まず利用可能なリソースグループを確認し、次に一時リソースグループの作成について事前に承認されたポリシーがあるかを判断します。操作が境界内であれば、グループを作成・バインド・記録します。境界を超える場合は、実行を停止し、人間の確認を要求します。ポイントは「エージェントが自分で直した」ことではなく、「権限を超えていない」ことです。復旧可能なら境界内で復旧し、不可能なら明示的に停止します。
3. 結果配信障害:間違ったイベントを待つと、未完成の結果を得てしまう
クラウドエージェントは実行中に多数のイベントを生成します。業務システムが早すぎると——例えば、ステータス更新を検知した時点でレポートを取得しようとすると——未完成の結果を得てしまうかもしれません。より安全なアプローチは、タスクスレッドがアイドル状態になってから完全な結果を取得すること、およびWebhookに対して署名検証・冪等処理・リトライを適用することです。これらは些細なディテールですが、クラウド利用がデモに留まるか、業務システムと接続可能な本番ワークフローになるかを決定します。
4. 不明確な受理基準:エージェントは「完了したように見える」が、ビジネスには答えがない
エージェントは簡単に「レポート風」のものを生成できます。見出し・表・推奨事項を含むでしょう。しかし、受理基準がなければ、実際の質問には答えられません:
- 1平方メートルあたりの1日平均売上が最も高い店舗形式は何か?
- 成長率が最も高いカテゴリーは何か?
- 新規出店を優先すべき都市はどこか?
- すべての結論に数値が含まれているか?
- その数値はSQLクエリ結果にトレース可能か?
基準が曖昧すぎると、エージェントは簡単に合格してしまいます。逆に詳細すぎると、タスクが何度も修正されることになります。クラウド利用のエンジニアリング能力の一つは、「何が『完了』とみなされるか」を、実行可能・検証可能な基準で定義することです。これは、クラウド利用と通常のエージェントを明確に区別する最も分かりやすい方法の一つでもあります。障害が発生したとき、通常のエージェントはしばしば「もっともらしい説明」を提供します。クラウド利用は、どのステップで失敗したか、権限境界を越えたか、リトライが発動したか、監査イベントが生成されたか、誰が引き継ぐ必要があるかに焦点を当てます。
クラウドエージェントの成熟度は、エラーを「遭遇するかどうか」ではなく、「障害が発生したときにシステムをより悪い状態にしないかどうか」で測られます。
境界:最高リスクのタスクからクラウド利用を始めてはいけない
復旧可能な障害は、「どんなタスクでもすぐにエージェントに任せられる」という意味ではありません。最初に何を委任するかを選ぶことが、「何ができるか?」と問うことよりも重要です。どんな新しいパラダイムも、過大な期待を招きやすいものです。
クラウド利用も例外ではありません。「エージェントが本番クラウド環境を自動で管理する」と言い出せば、技術系の読者は本能的に警戒します。それは正しく、当然の反応です。本番変更、権限拡張、データ削除、請求書操作などは、エージェントが推論できるからといって、自動的に許可されるべきではありません。より現実的な道筋は、リスクが低く、頻繁に行われ、結果が検証可能なタスクから始め、徐々に確認付き実行へと進み、最後に高リスク変更へと至るというものです。この道筋は、3段階の成熟度曲線として描くことができます:
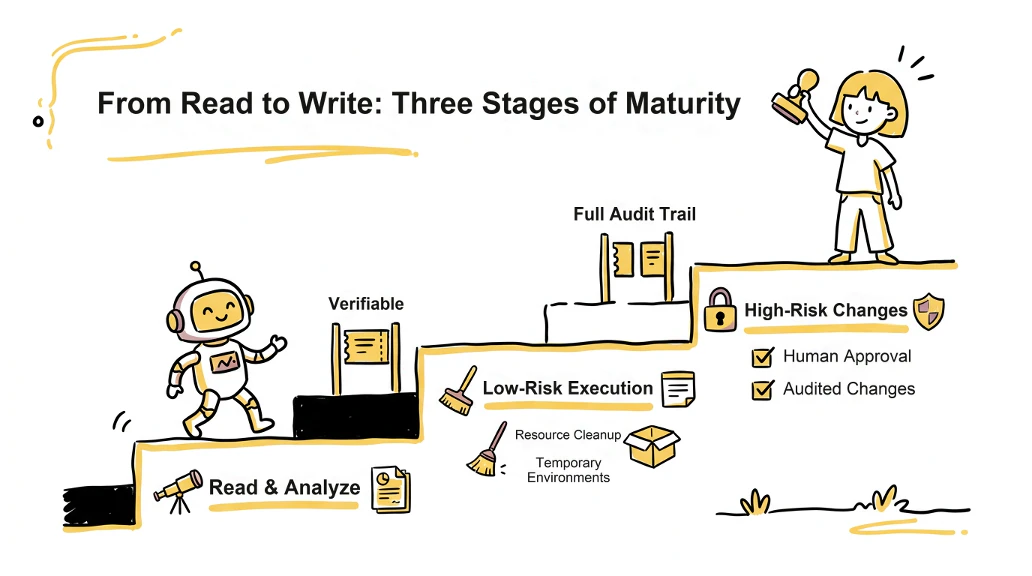
具体的なタスクはこの曲線上に配置できます:定期点検、コスト異常分析、CI失敗診断、ログ中の遅いクエリ分析、一時環境作成、期限切れリソースのクリーンアップ、レポート生成、データタスクのステータス確認など。これらのタスクは共通の特徴を持ちます:書き込みより読み取りが多い、結果が容易に検証可能、障害時に再試行可能、リスク境界が明確です。
これらのタスクが安定して動作するようになったら、徐々に確認を要する実行アクションへと拡大します。例えば、エージェントが修正案を提案し、人間の確認後にパイプラインをトリガーする;IaC変更を生成し、人間のレビュー後にマージする;一時リソースを作成し、期限切れ時に自動的に回収する;コスト異常を検知し、まず通知を送信し、戦略変更の前に人間の承認を待つ、などです。
| 段階 | エージェントに委任可能なタスク | 必ず維持すべき人間の制御ポイント |
|---|---|---|
| 読み取り・分析 | ログ分析、コストレポート、CI診断、日常点検レポート | データアクセス範囲、機密フィールドのマスキング、結果解釈の責任 |
| 低リスク実行 | 一時環境作成、期限切れリソースのクリーンアップ、テストパイプラインのトリガー | リソースクォータ、有効期限ポリシー、障害時のロールバック |
| 高リスク変更 | 本番設定の調整、権限変更、リリース | 人間の確認、変更承認、ロールバック計画、監査ログ |
クラウド利用の成熟度は、「エージェントが人間をバイパスできるかどうか」ではなく、「エージェントがどこで停止して人間の確認を待つべきかを理解しているかどうか」で測られます。
この境界は明確でなければなりません。そうでなければ、クラウド利用は単に「AIがクラウドリソースを自動で操作する」ことと誤解されてしまいます。真の目標は、権限・資格情報・実行を、クラウドプラットフォームがガバナンスできる場所へと戻すこと——単にモデルの権限を無制限に拡大することではありません。
エージェントが真にクラウドを「使う」瞬間
この3段階の道筋は、最終的に単純な問いへと導きます:人がクラウドの唯一のユーザーでなくなったとき、私たちはクラウドを何にしたいのでしょうか? コンソール、CLI、SDK、IaC は「人がクラウドをより効率的に使うにはどうすればよいか?」という問いに答えます。クラウド利用は、それとは異なる問いに答えます:「人がクラウドの唯一のユーザーでなくなったとき、クラウドプラットフォームは、ソフトウェア主体をどう受け入れ、制約し、ホストするか?」これが、通常のエージェントとの根本的な違いです。通常のエージェントは、人が操作を完了するのを支援します。クラウド利用は、エージェントをアイデンティティ・環境・ツール・ライフサイクル・監査ログ・守るべき境界を持つ、新しい種類のクラウドワークロードへと育てることを目指します。
この変化は、一夜にして既存のクラウド利用方法を置き換えるものではありません。コンソール、CLI、IaC は存続しますが、その役割は変わります:人が直接使うインターフェースから、エージェントが操作を呼び出し、変更を検証・提出し、実行を再生するためのツール層へと進化します。クラウド利用の価値は、エージェントにクラウドを「理解させる」ことでも、クラウドAPIを「もう少し多く呼び出せるようにすること」でもありません。真に変えるのは、クラウドとそのユーザーの関係です:エージェントはもはや、単に人のための追加機能ではありません。クラウドプラットフォームが識別・承認・ホスト・監査できるソフトウェア主体へと、進化しつつあるのです。
次に踏み出すべき一歩は、頻繁で、リスクが低く、検証可能なタスクから始めることです:エージェントに定期点検を実行させ、障害を診断させ、コストを分析させ、レポートを生成させ、一時環境を作成させ——そして、すべての高リスクポイントで人間の確認を待つようにします。最高リスクのクラウド操作をいきなりエージェントに任せるのは、スタート地点としては不適切です。この道筋が確実に機能するようになってこそ、クラウドコンピューティングは「人がリソースを操作する」から「エージェントがタスクを担う」へと、真に進化するのです。
Qoder Cloud Agents の「Cloud Use」をご紹介します — ぜひご自身でお試しください。