


登場人物 ホー先輩: 本棚に住みついたフクロウ。答えを言わずに質問で返す 12 年目のエンジニア/チュン: AI にコードを書かせるのが得意な入社 1 年目のスズメ
AI エージェント(Claude Code / Codex など)が書いたリポジトリを読むと、書き方の癖の奥に「設計の判断」が見えてきます。このシリーズは、その判断を 1 つずつ図解して「自分でも設計できる」ようにするノートです。今回は 「良いコード」を測れる 3 つの条件 。レビューで「読みにくい」「保守しづらい」と言われたとき、何を直せばよいかが決まらないのは、「良い」の定義が感覚のままだからです。最初に定義を 3 つの観察に落としておくと、以降の設計の話がすべてこの 3 つに結びつきます。
この記事の位置づけ

縦が開発の工程(上から下へ進む)、横が扱うものの地図です。この記事は、どの工程にも当てはめる「物差し」の話です(図の最上段の黒い札)。以降の記事は、この物差しのどれかを守る技術として読めます。
こう設計されている
TAX_RATE = 0.10  # 税率。変えるのはここだけ


@dataclass(frozen=True)
class MonthlySummary:
    month: str
    net: float
    gross: float


def summarize_monthly(frame: pd.DataFrame, *, month: str) -> MonthlySummary:
    part = frame[frame["month"] == month]
    if part.empty:
        raise ValueError(f"no rows for month={month}")
    net = float((part["price"] * part["qty"]).sum())
    return MonthlySummary(month=month, net=net, gross=round(net * (1 + TAX_RATE), 2))


def test_summarize_monthly() -> None:
    s = summarize_monthly(FRAME, month="2026-01")
    assert (s.net, s.gross) == (200.0, 220.0)
20 行ほどの例ですが、3 条件が全部入っています。関数名と引数名だけで「月を指定して売上をまとめる」と読め(読める)、税率を変えるときに触るのは 1 行だけで(変えられる)、計算を壊せばテストが落ちます(壊れたら分かる)。
まず図で掴む:3 条件はどれも「観察」で確かめられる
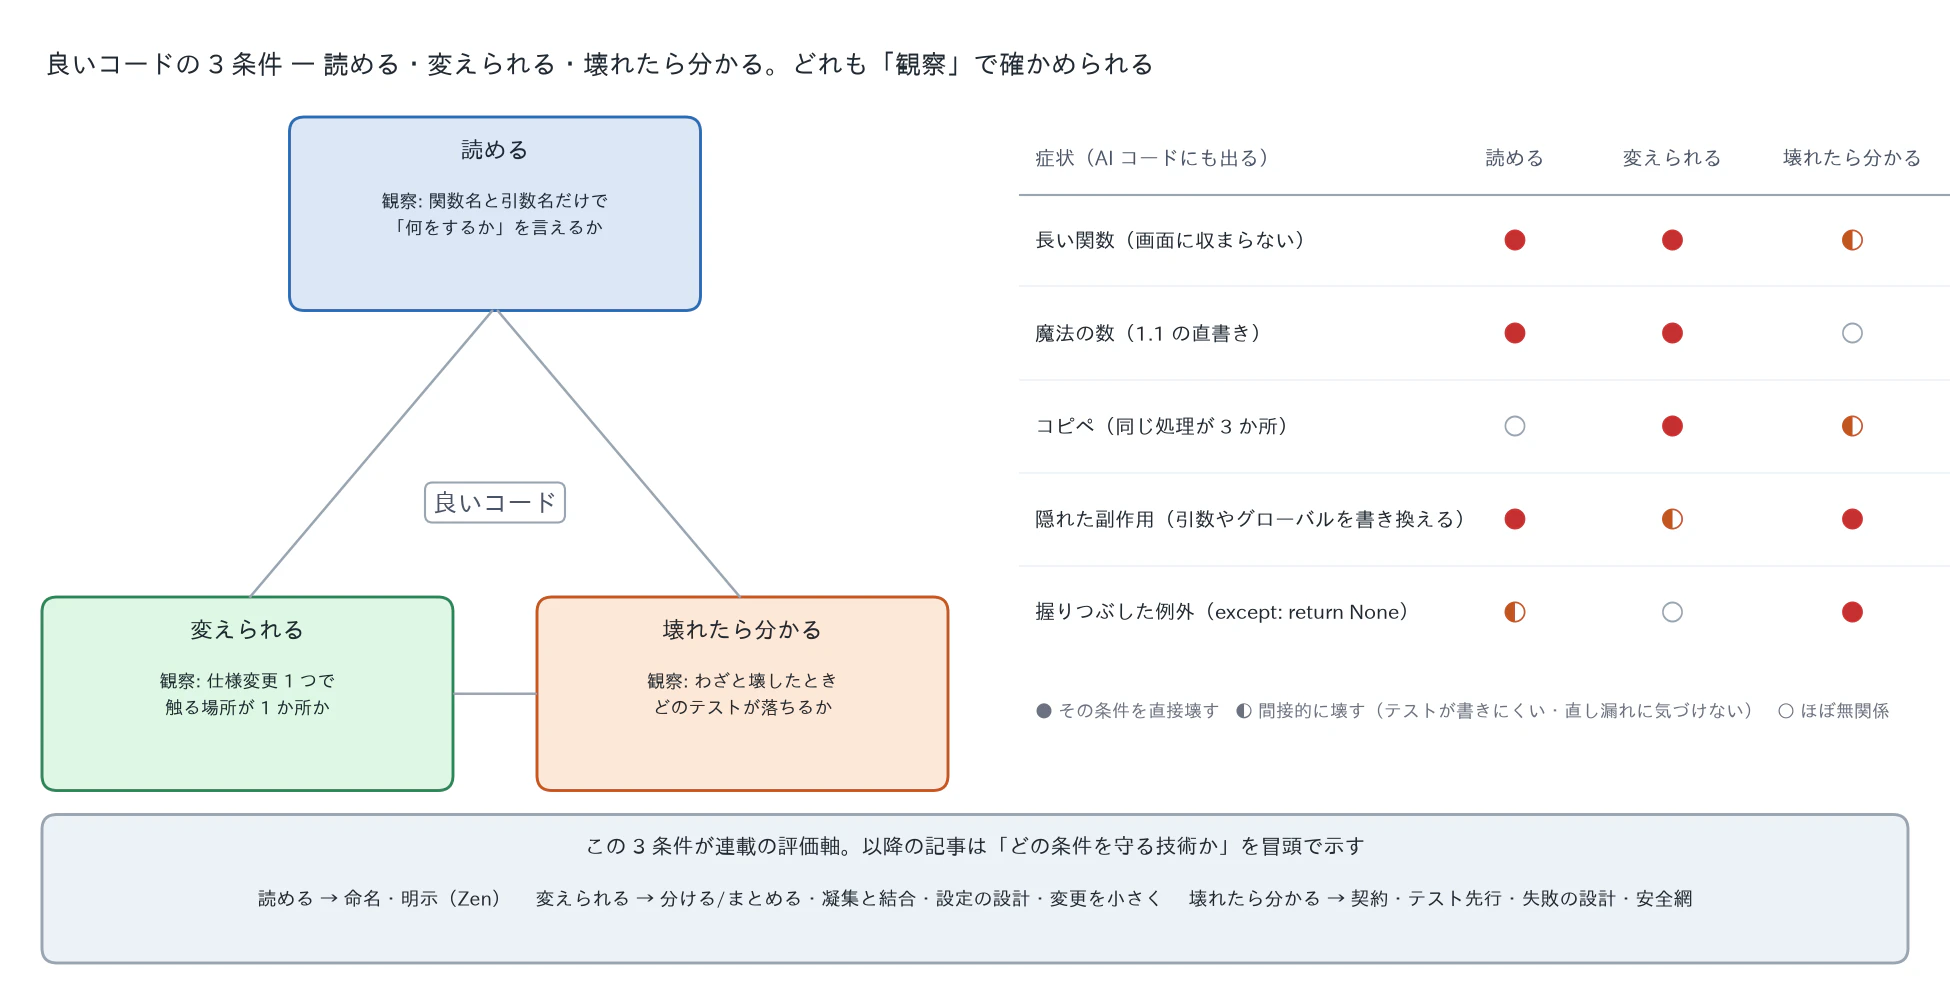
- 左の三角形が 3 条件です。どれも「好き嫌い」ではなく、コードを前にして試せる問いを持っています。
- 右の表は、レビューでよく見る症状が 3 条件のどれを壊すかの対応です。1 つの症状が複数の条件を同時に壊すことが多いので、直す優先順位の根拠になります。
- 下の帯は、この連載の記事がどの条件を守る技術なのかの地図です。
| 条件 | 観察する問い | 満たさないと起きること |
|---|---|---|
| 読める | 関数名・引数名・型だけで「何をするか」を言えるか | 本体を全部読まないと使えない。呼び出し側を直すたびに中身を読み直す |
| 変えられる | 仕様変更 1 つで触る場所が 1 か所か | 直し漏れが出る。同じ値や処理が散らばり、どれが正かが分からなくなる |
| 壊れたら分かる | わざと壊したとき、どのテストが落ちるか | 壊れたことに本番で気づく。リファクタリング(動きを変えずに中身を整えること)が怖くてできない |
3 条件は互いに支え合っています。名前が良ければテストも読みやすく、テストがあれば安心して分割でき、分割されていれば名前が付けやすい、という循環です。逆に 1 つが崩れると他の 2 つも崩れやすくなります。
「読める」は相手次第です。同じチームの人か、半年後の自分か、AI エージェントか、読む相手を決めてから問いに答えます。相手が AI エージェントなら、型とテストがそのまま指示書の役割を果たします。
症状から条件へ
AI が書いたコードは、型注釈や命名規則が機械的に揃っているぶん「一見きれい」に見えます。それでも次の症状は出ます。
| 症状 | 壊す条件 | 見つけ方 |
|---|---|---|
| 長い関数(画面に収まらない) | 読める・変えられる | 空行で区切られた「段落」が 3 つ以上ある |
魔法の数(1.1 の直書き) |
読める・変えられる | 数値リテラルを grep して、名前の無いものを数える |
| コピペ(同じ処理が 3 か所) | 変えられる | 同じ行が 3 か所にあれば、直すとき 3 か所触ることになる |
| 隠れた副作用(引数やグローバルを書き換える) | 読める・壊れたら分かる | 戻り値が無いのに何かが変わる関数 |
握りつぶした例外(except: return None) |
壊れたら分かる |
except Exception の中で return や pass をしている |
解剖図:同じ処理の Before → After

| 番号 | 書き方・置き方 | 設計上の意味(守る条件) |
|---|---|---|
| ① | TAX_RATE = 0.10 |
1.1 に名前を付ける。意味が読め、変更は 1 行で済む(変えられる・読める) |
| ② | class MonthlySummary |
戻り値に名前と型を与える。(t, t * 1.1) のタプルは「2 番目は何か」を本体を読まないと分からない(読める) |
| ③ | summarize_monthly |
calc では何を計算するか分からない。動詞+目的語で責務を言う(読める) |
| ④ | -> MonthlySummary |
戻り値の型を書くと、呼び出し側は中身を見ずに .net を使える(読める・変えられる) |
| ⑤ | raise ValueError |
月が無いとき Before は (0, 0.0) を黙って返す。止めれば、間違った入力がその場で分かる(壊れたら分かる) |
| ⑥ | def test_summarize_monthly |
壊したら落ちるテストを同じ変更で足す。これが無いと ①〜⑤ をいつ壊したか分からない(壊れたら分かる) |
Before のコードは「動く」コードです。動くことと良いことは別で、違いはこの 6 か所に集約されます。
最小再現例
「壊れたら分かる」は実際に壊してみると納得できます。税率を 0.08 にするつもりで 0.8 と書いてしまった、という変更を再現します。
from __future__ import annotations

from dataclasses import dataclass

import pandas as pd

TAX_RATE = 0.10  # 税率。変えるのはここだけ


@dataclass(frozen=True)
class MonthlySummary:
    month: str
    net: float
    gross: float


def load_sales(rows: list[dict]) -> pd.DataFrame:
    frame = pd.DataFrame(rows)
    missing = {"month", "price", "qty"} - set(frame.columns)
    if missing:
        raise KeyError(f"missing columns: {sorted(missing)}")
    return frame


def summarize_monthly(frame: pd.DataFrame, *, month: str) -> MonthlySummary:
    part = frame[frame["month"] == month]
    if part.empty:
        raise ValueError(f"no rows for month={month}")
    net = float((part["price"] * part["qty"]).sum())
    return MonthlySummary(month=month, net=net, gross=round(net * (1 + TAX_RATE), 2))


def test_summarize_monthly() -> None:
    frame = load_sales([{"month": "2026-01", "price": 100, "qty": 2},
                        {"month": "2026-02", "price": 50, "qty": 1}])
    s = summarize_monthly(frame, month="2026-01")
    assert (s.net, s.gross) == (200.0, 220.0), (s.net, s.gross)


# Before 版(比較用): 月が無くても黙って 0 を返す
def calc(data, m):
    r = []
    for d in data:
        if d["month"] == m:
            r.append(d["price"] * d["qty"])
    try:
        t = sum(r)
        return t, t * 1.1
    except Exception:
        return None, None


rows = [{"month": "2026-01", "price": 100, "qty": 2}, {"month": "2026-02", "price": 50, "qty": 1}]
test_summarize_monthly()
print("test: OK")
print(summarize_monthly(load_sales(rows), month="2026-02"))
print("before:", calc(rows, "2026-03"))  # 存在しない月
try:
    summarize_monthly(load_sales(rows), month="2026-03")
except ValueError as e:
    print("after: ValueError:", e)

# 「壊れたら分かる」を確かめる: 税率を間違えて変える(0.08 にしたかった)
TAX_RATE = 0.8
try:
    test_summarize_monthly()
except AssertionError as e:
    print("AssertionError:", e)
出力:
test: OK
MonthlySummary(month='2026-02', net=50.0, gross=55.0)
before: (0, 0.0)
after: ValueError: no rows for month=2026-03
AssertionError: (200.0, 360.0)
存在しない月を渡したとき、Before は (0, 0.0) を返して先へ進みます。After は止まります。税率を間違えたとき、After はテストが (200.0, 360.0) という実際の値つきで落ちます。Before には落ちるものがありません。
判断の基準

上から順に問いをたどり、最初に右へ出たところが今やることです。順番が「テスト → 集める → 名前」なのは、テストがあれば残りの 2 つを、落ちないことを確かめながら直せるからです。
| 場面 | 右へ出る問い | やること |
|---|---|---|
| バグを直す | Q1 | そのバグを再現するテストを先に書く。直した後に同じバグが戻らない |
| 仕様がまだ揺れている | Q2 | 揺れる値(しきい値・税率・ファイル名)を定数や設定に出しておく |
| 他人・未来の自分・AI に引き継ぐ | Q3 | 名前と型を直す。それだけで引き継ぎの文書が減る |
確認問題
問 1(択一) AI エージェントが書いたコードのレビューで「読みにくい」という感想が出た。3 条件に沿った指摘として、そのまま直しに使えるものはどれか。
ア 「もっときれいに書いてください」 イ 「関数名 calc と引数名 m からは、何を計算するのか言えません。月を指定して売上をまとめる関数だと、名前で分かるようにしてください」 ウ 「出力が正しいことは確認したので、このままで問題ありません」 エ 「型注釈と命名規則が揃っているので、『読める』は満たしています」
答えと解説
イ。「関数名と引数名だけで何をするか言えるか」という観察の問いに落としてあるので、直す場所(名前)と直った状態(言えるようになる)が決まります。
ア: 感想のままで、何を直せば終わるのかが決まりません。「税率を変えるのに 3 か所触る」「壊してもテストが落ちない」のように、観察できる形まで降ろすと直せます。
ウ: 動くことと良いことは別です。違いは「読むとき」「変えるとき」「壊れたとき」に出るので、動作確認だけでは見えません。
エ: 命名規則(小文字とアンダースコアなど)を守ることと、名前が責務を語ることは別です。型注釈と命名規則は AI が揃えやすいぶん「読める」に見えやすく、崩れやすいのは残りの 2 つ(テストを緩めて通す・長い関数に足し続ける)なので、レビューではそちらも先に見ます。
問 2(択一) テストが 1 本もない長い関数を直すことになった。3 条件を満たしていく順番として最もよいものはどれか。
ア 名前を整える → 関数を分ける → テストを書く イ テストを書く → 関数を分けて値を集める → 名前を整える ウ 3 つを 1 回の変更でまとめて直す エ 関数を分ける → テストを書く → 名前を整える
答えと解説
イ。先にテストで今の動きを固定すると、分けたり改名したりするたびに、落ちないことで壊していないと確かめられます。Fig 3 の Q1 → Q2 → Q3 の順です。
ア: テストが最後だと、改名や分割のどこかで壊していても分かりません。
ウ: まとめて直すと、テストが落ちたときに、どの変更が原因かを切り分けられません。
エ: 分けた時点ではまだテストがないので、分割で壊したかどうかが分かりません。
問 3(コードを読む) 次のコードは動き、テストも通る。3 条件のどれが崩れているか。どこをどう直すとよいか。
DISCOUNT = 0.9


def apply_discount(price: float) -> float:
    try:
        return round(price * DISCOUNT, 2)
    except Exception:
        return 0.0


def test_apply_discount() -> None:
    assert apply_discount(1000) >= 0
答えと解説
崩れているのは「壊れたら分かる」です。名前と定数は整っている(読める・変えられる)ので、見落としやすい形です。
1 つ目は握りつぶした例外です。apply_discount("1000") のように間違った値を渡しても 0.0 が返り、処理は先へ進みます。try / except を消して、間違いはその場で例外として止めます。
2 つ目は緩いテストです。>= 0 は割引率を 0.09 に壊しても通ります。assert apply_discount(1000) == 900.0 のように値で確かめると、壊したときに落ちます。
おわりに

「良いコード」は感覚ではなく、読める・変えられる・壊れたら分かるの 3 つの観察で確かめられます。直す順番は、テスト → 揺れる値を集める → 名前と型。この連載の以降の記事は、どれもこの 3 つのどれかを守る技術として読めます。
参考
- PEP 8 – Style Guide for Python Code(2026-11-08 確認)
- PEP 20 – The Zen of Python(2026-11-08 確認。Tim Peters)
- Refactoring Catalog(Martin Fowler)(2026-11-08 確認)
- pytest — Get Started(2026-11-08 確認)
この記事は連載「AI が書いたリポジトリの設計を読む」(Qiita 20days challenge)の Day 1-1/全20日です。毎日 2 本ずつ公開しています。