
登場人物 ホー先輩: 本棚に住みついたフクロウ。答えを言わずに質問で返す 12 年目のエンジニア/チュン: AI にコードを書かせるのが得意な入社 1 年目のスズメ
AI エージェント(Claude Code / Codex など)が書いたリポジトリを読むと、書き方の癖の奥に「設計の判断」が見えてきます。このシリーズは、その判断を 1 つずつ図解して「自分でも設計できる」ようにするノートです。今回は 命名 。名前はコードの中で最初に読まれ、最後まで残ります。AI は命名規則を機械的に守るので、文法を知っていれば本体を読む前に「何者か」が分かります。逆に、名前を決める段階で責務と境界が決まるので、命名は設計そのものでもあります。連載の最初に挙げた 3 条件(読める・変えられる・壊れたら分かる)で言えば、主に「読める」を守る技術です。
この記事の位置づけ
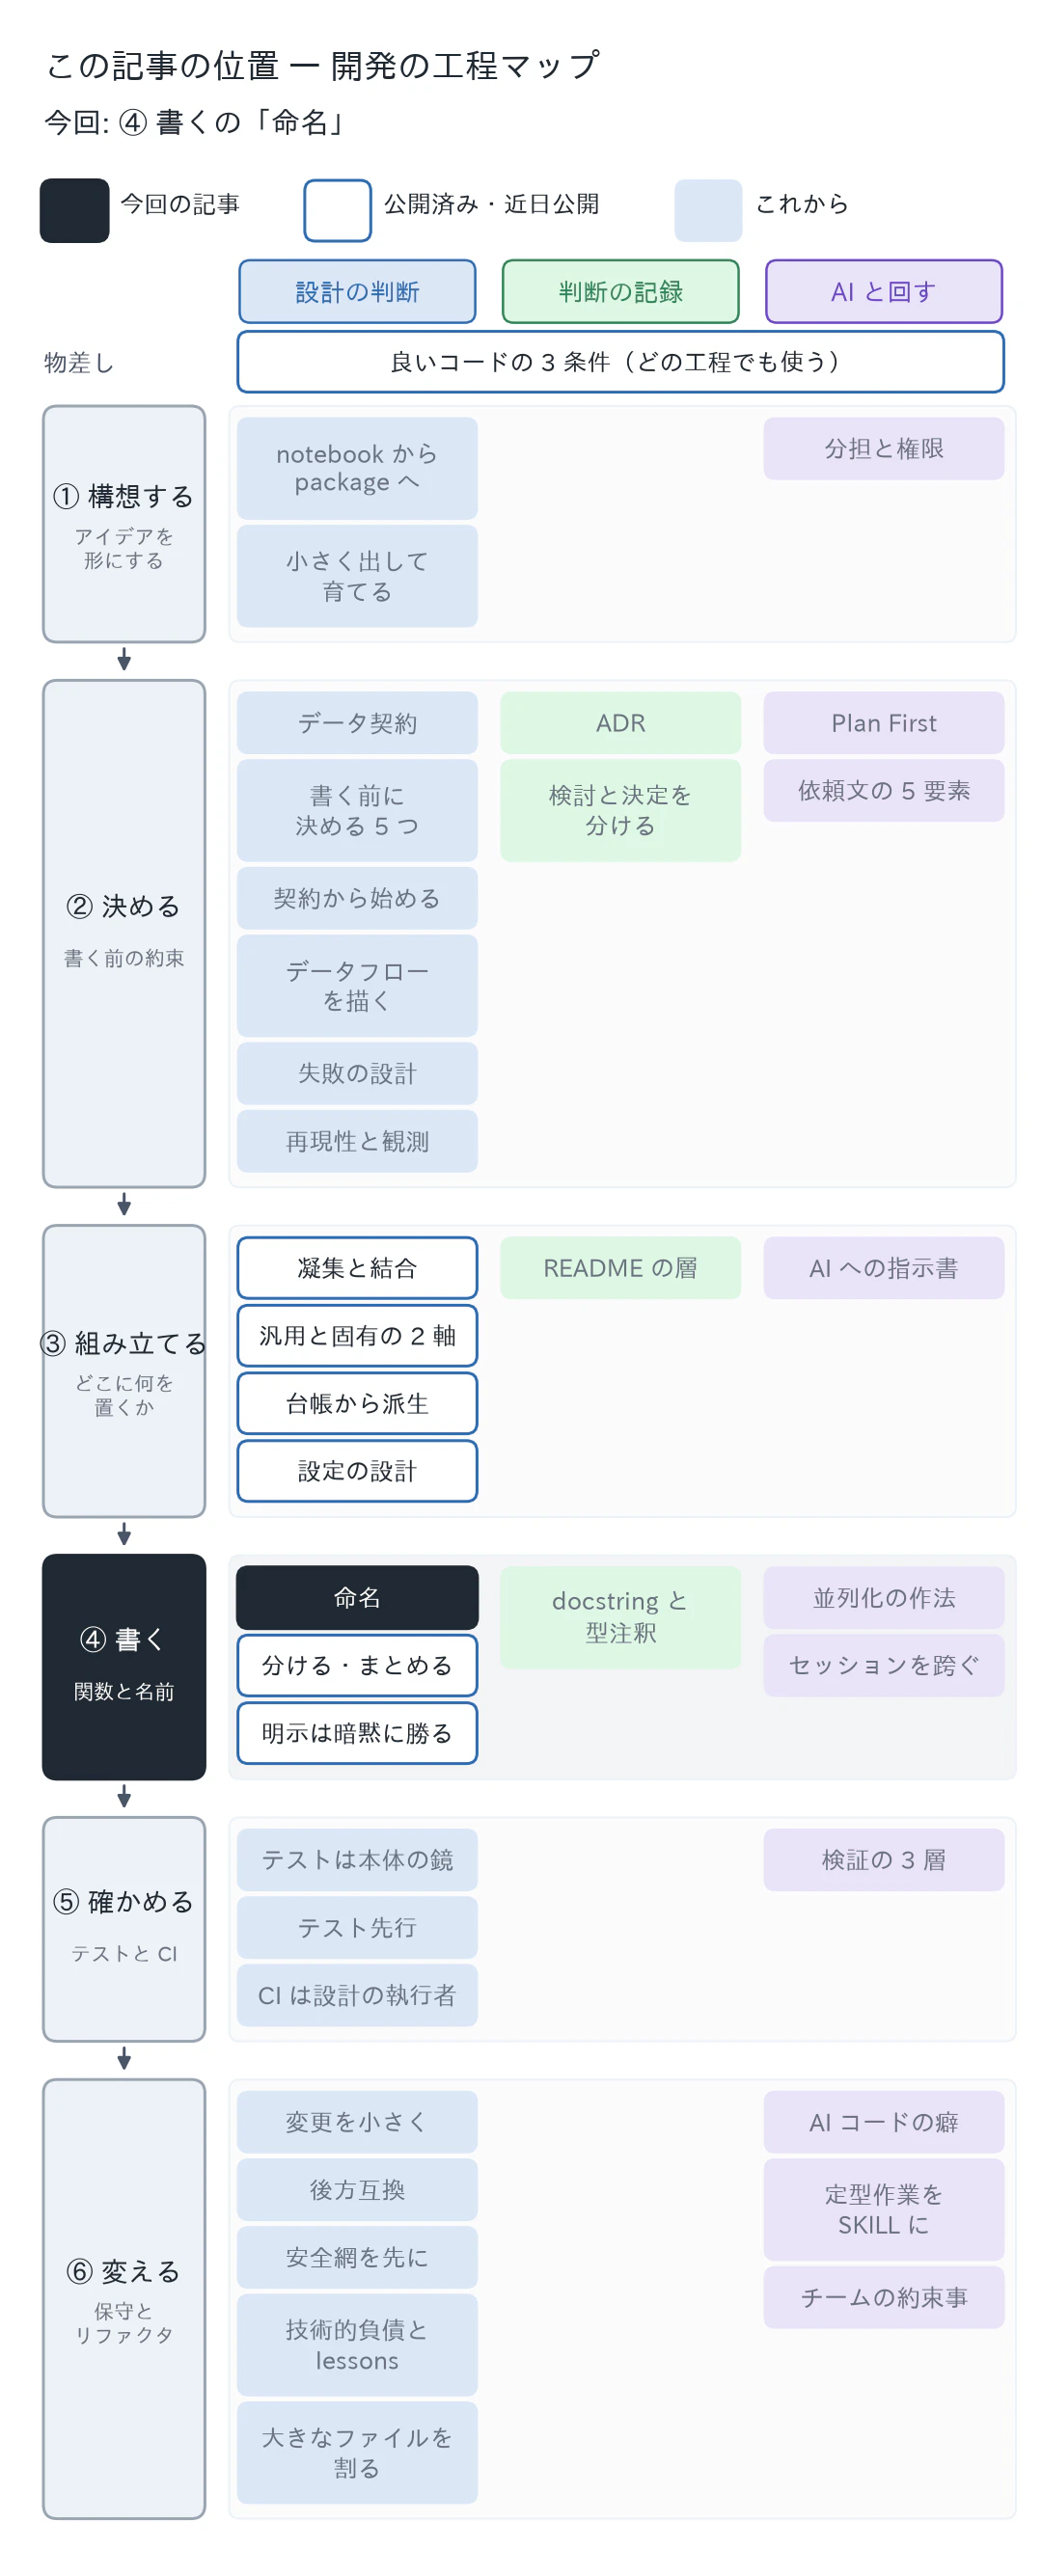
縦が開発の工程(上から下へ進む)、横が扱うものの地図です。この記事は、開発の工程のうち「④ 書く(関数と名前)」で、「設計の判断」を扱う話です(図の黒い札)。
こう設計されている
# output_names.py — 成果物名の台帳。ファイル名の文字列はここにだけ書く
SUMMARY_CSV = "monthly_summary.csv"
FEATURES_PARQUET = "features.parquet"


# run_build_features.py — 工程名 build_features は、設定のセクション名・出力フォルダ名と同じ
def load_sales(path: Path) -> pd.DataFrame: ...                                   # 動詞 + 目的語
def build_features(sales: pd.DataFrame, *, drop_returns: bool) -> pd.DataFrame: ...
def write_summary(summary: pd.Series, out_dir: Path) -> Path: ...


@dataclass(frozen=True)
class FeatureConfig:          # 名詞。値の「箱」
    drop_returns: bool = True  # ブール。if 文で「返品を落とすなら」と読める
    min_qty: int = 1
関数は「何を・どうする」、クラスは「何者か」、ブールは「どんな状態か」、大文字は「ここでだけ決める値」です。この 4 つの形を見分けられると、シグネチャだけで役割が読めます。
まず図で掴む:名前の文法 4 つ
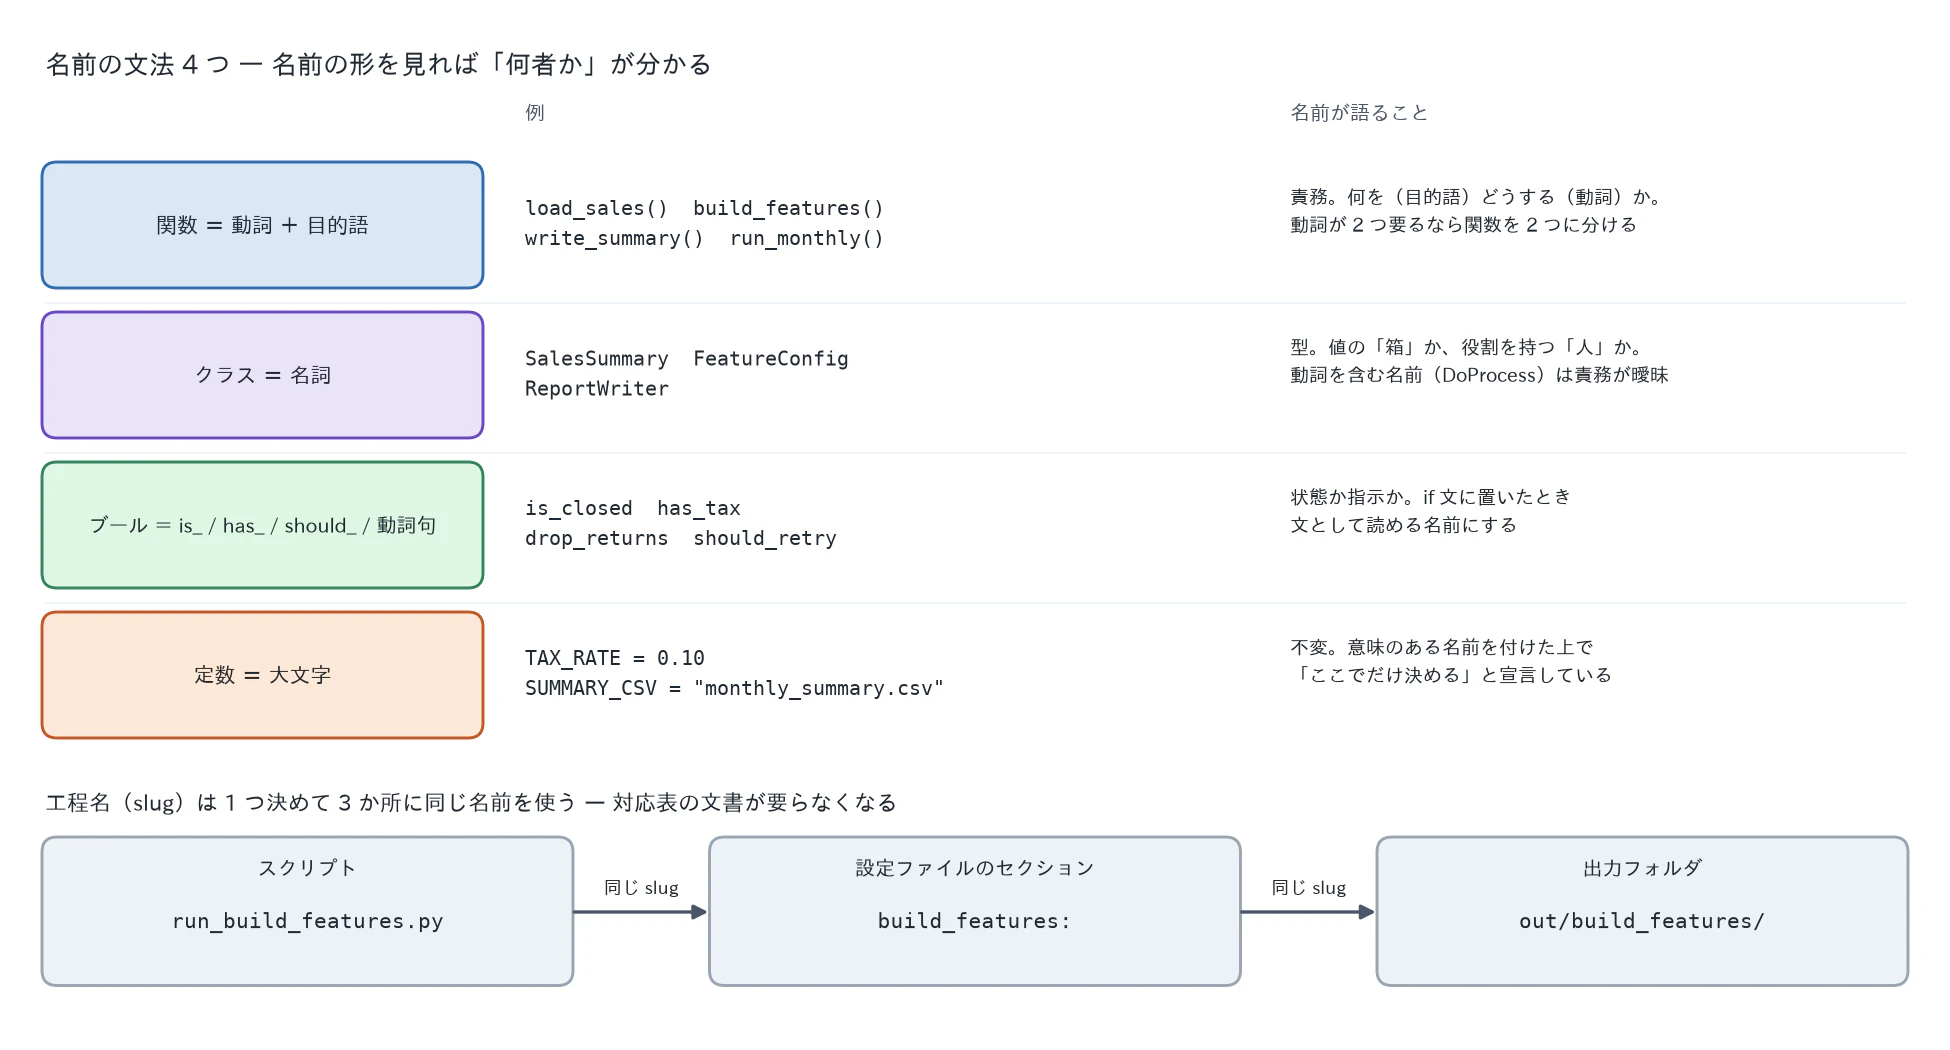
- 上の 4 行が文法です。左の形を見れば、右の「名前が語ること」が決まります。
- 下の帯は工程名(slug。工程を指す英小文字とアンダースコアだけの短い名前)の規則です。1 つの名前をスクリプト・設定・出力フォルダで揃えると、対応表を書かなくても追えます。
- 文法に当てはまらない名前(
proc,data2,flag)は、本体を読まないと分からない名前です。読む側はそこで止まるので、型注釈(-> pd.DataFrameなど)を名前の代わりに読みます。
| 文法 | 例 | 名前が語ること | 読むときの手がかり |
|---|---|---|---|
| 関数 = 動詞 + 目的語 |
load_sales build_features write_summary
|
責務。何を(目的語)どうする(動詞)か | 動詞が 2 つ要る関数は分割候補 |
| クラス = 名詞 |
SalesSummary FeatureConfig ReportWriter
|
型。値の「箱」か、役割を持つ「人」か |
Config / Summary で終わるものは箱、-er で終わるものは人 |
ブール = is_ / has_ / should_ / 動詞句 |
is_closed has_tax drop_returns
|
状態か指示か |
if 文に置いて文として読めるか |
| 定数 = 大文字 |
TAX_RATE SUMMARY_CSV
|
不変。ここでだけ決める | 同じ値が他の場所に直書きされていたら台帳に戻す |
動詞の語彙を固定する
動詞が揺れると、同じことをする関数が get_・fetch_・load_・read_ の 4 通りで書かれ、どれを呼べばよいか分からなくなります。語彙は少なくして役割を分けます。
| 動詞 | 役割 | 対になる動詞 |
|---|---|---|
load |
ファイル → 表・オブジェクト |
write / save
|
parse |
文字列 → 値 | format |
fetch |
ネットワーク → データ |
post / push
|
build |
入力から新しいものを作る | — |
compute |
値から値を計算する(入出力をしない) | — |
run |
工程を 1 つ実行する(入口) | — |
validate / check
|
検証して不正なら止める/結果を返す | — |
解剖図:改名の Before → After
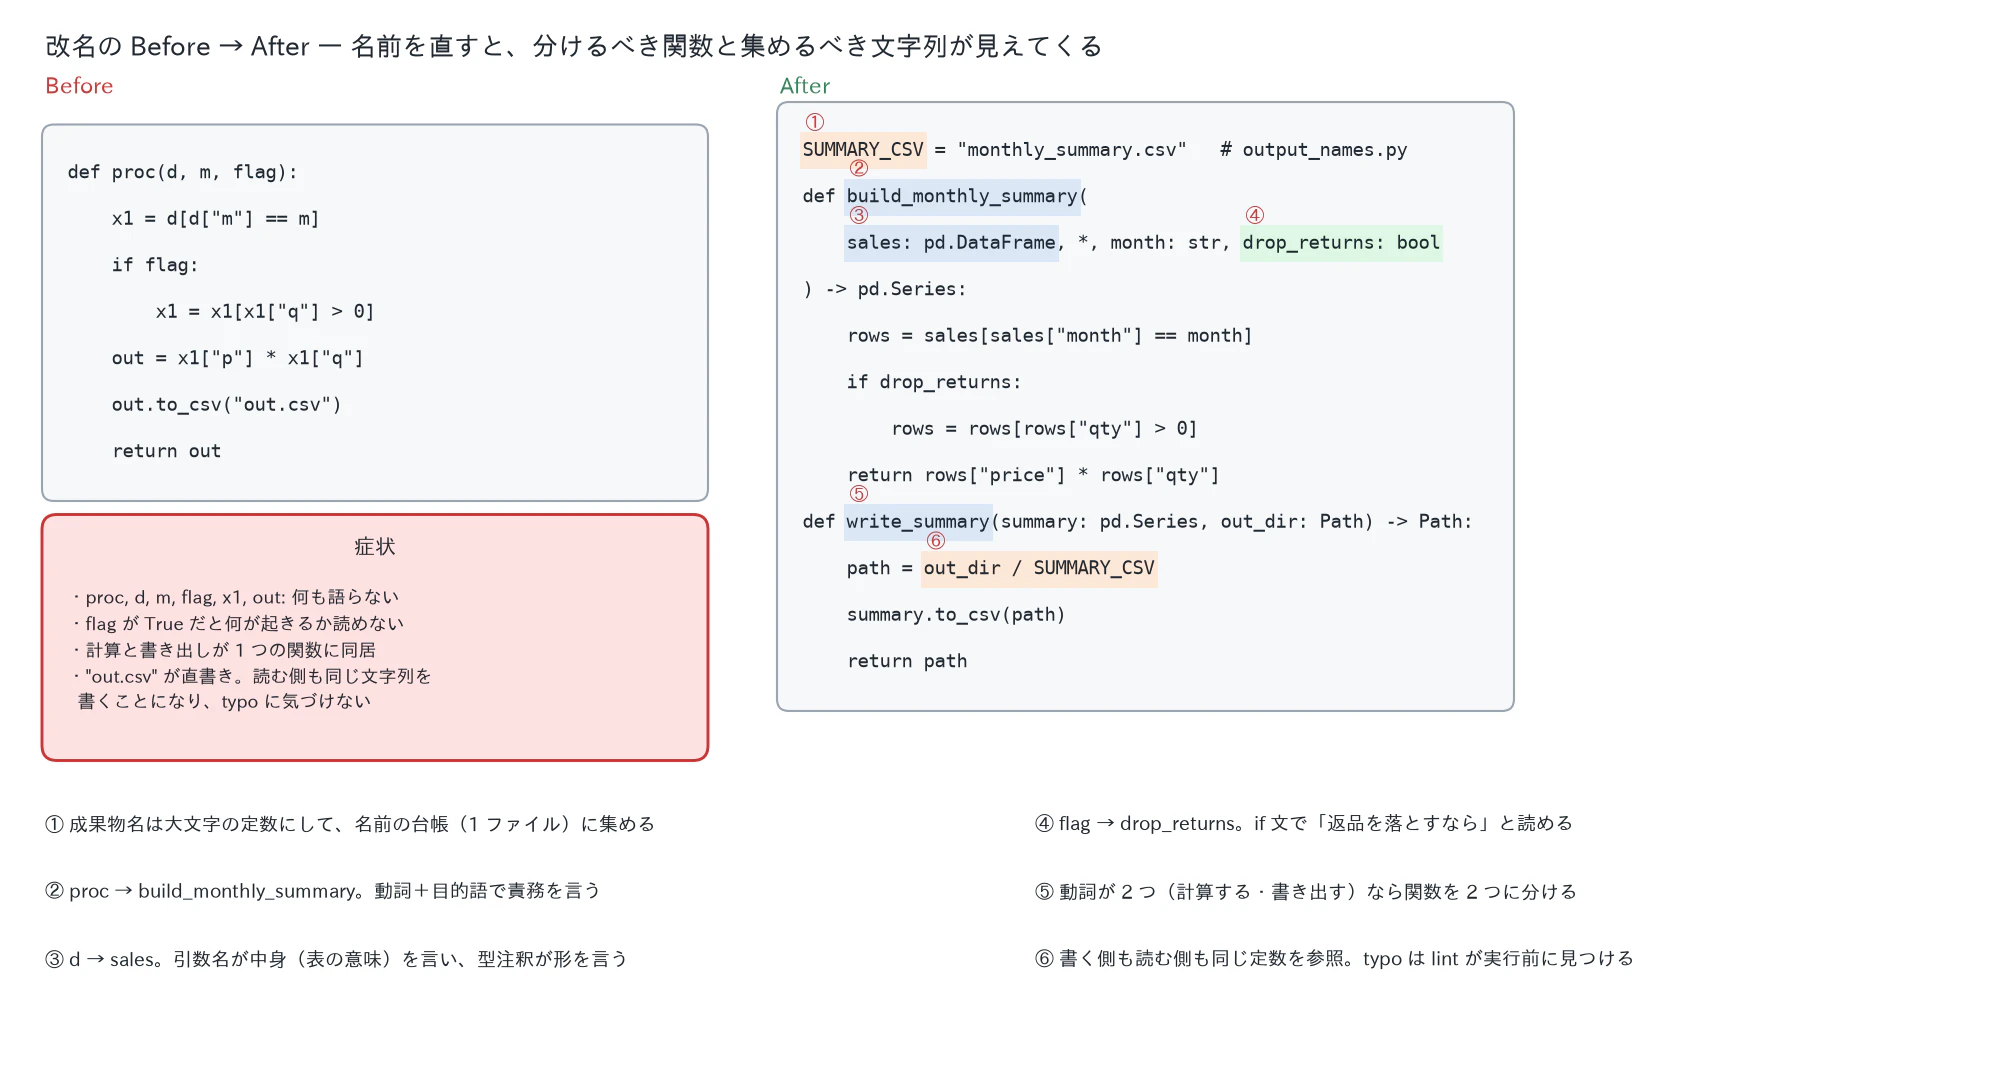
| 番号 | 書き方・置き方 | 設計上の意味 |
|---|---|---|
| ① | SUMMARY_CSV = "monthly_summary.csv" |
成果物名は大文字の定数にして、名前だけを並べた台帳ファイル(output_names.py)に集める。直書き "out.csv" は読む側と二重になる |
| ② | build_monthly_summary |
proc では何をするか分からない。動詞+目的語で責務を言う |
| ③ | sales: pd.DataFrame |
d は中身を語らない。引数名が「何の表か」を言い、型注釈が「形」を言う |
| ④ | drop_returns: bool |
flag は True で何が起きるか読めない。if drop_returns: で「返品を落とすなら」と読める |
| ⑤ | write_summary |
Before は計算と書き出しが同居していた。動詞が 2 つなら関数を 2 つに分ける |
| ⑥ | out_dir / SUMMARY_CSV |
書く側も読む側も同じ定数を参照する。定数名を打ち間違えれば、lint(実行前にコードを検査するツール)が未定義の名前として見つける |
改名をすると、分けるべき関数(⑤)と集めるべき文字列(①⑥)が見えてきます。名前を直すことが、構造を直すことの入口になっています。
名前を 1 か所に集める
成果物のファイル名のような「文字列としての名前」は、書く側と読む側の両方に現れます。直書きすると 2 か所に同じ文字列ができ、片方を変えたとき、もう片方は実行してファイルが無いと分かるまで壊れたことに気づけません。
# 散らばった直書き
summary.to_csv(out_dir / "monthly_summary.csv")        # 書く側
pd.read_csv(out_dir / "monthly_sumary.csv")            # 読む側。typo に気づけない

# 台帳に集める
from output_names import SUMMARY_CSV
summary.to_csv(out_dir / SUMMARY_CSV)
pd.read_csv(out_dir / SUMMARY_CSV)                     # typo は NameError か lint で止まる
集めると 3 つ良いことがあります。名前の変更が 1 行で済む(変えられる)。typo が実行前に lint(未定義名の検出)で見つかる(壊れたら分かる)。grep SUMMARY_CSV で利用箇所が全部出る(読める)。
名前だけで対応が分かる規則
工程が増えると「このスクリプトはどの設定を読み、どこに出力するか」の対応表が必要になります。対応表は書いた瞬間から古くなります。代わりに、1 つの工程名(slug)を 3 か所で使うと決めます(Fig 1 の下の帯)。
run_build_features.py        # スクリプト          run_<slug>.py
config.yaml
└── build_features:          # 設定のセクション    <slug>:
out/
└── build_features/          # 出力フォルダ        out/<slug>/
    └── features.parquet
規則が 1 行で書けるので、文書は「この規則に従う」の 1 文で済みます。AI エージェントに工程を追加させるときも、規則だけ渡せば 3 か所が揃います。
最小再現例
from __future__ import annotations

import tempfile
from pathlib import Path

import pandas as pd

# --- 名前の台帳(output_names.py 相当): 成果物のファイル名はここにだけ書く ---
SUMMARY_CSV = "monthly_summary.csv"


# --- 工程名(slug)から 3 つの名前を導く ---
def names_for(slug: str) -> dict[str, str]:
    return {"script": f"run_{slug}.py", "config_key": slug, "out_dir": f"out/{slug}/"}


for slug in ["load_sales", "build_features"]:
    print(names_for(slug))


# --- 4 つの文法: 動詞+目的語の関数・名詞の引数・is_/drop_ のブール・大文字の定数 ---
def build_monthly_summary(sales: pd.DataFrame, *, month: str, drop_returns: bool) -> pd.Series:
    rows = sales[sales["month"] == month]
    if drop_returns:
        rows = rows[rows["qty"] > 0]
    return rows["price"] * rows["qty"]


def write_summary(summary: pd.Series, out_dir: Path) -> Path:
    path = out_dir / SUMMARY_CSV
    summary.to_csv(path)
    return path


def read_summary(out_dir: Path) -> pd.Series:
    return pd.read_csv(out_dir / SUMMARY_CSV, index_col=0).iloc[:, 0]


with tempfile.TemporaryDirectory() as tmp:
    out_dir = Path(tmp)
    sales = pd.DataFrame({"month": ["2026-01"] * 3, "price": [100, 50, 80], "qty": [2, -1, 1]})
    summary = build_monthly_summary(sales, month="2026-01", drop_returns=True)
    path = write_summary(summary, out_dir)
    print(path.name, read_summary(out_dir).tolist())
    # 直書きの typo は実行してファイルが無いと分かるまで気づけない
    try:
        pd.read_csv(out_dir / "monthly_sumary.csv")
    except FileNotFoundError as e:
        print("literal typo:", type(e).__name__)
    # 定数の typo は NameError で止まる(ruff F821 なら実行前に見つかる)
    try:
        out_dir / SUMMARY_CVS  # noqa: F821
    except NameError as e:
        print("constant typo:", type(e).__name__, "->", e)
出力:
{'script': 'run_load_sales.py', 'config_key': 'load_sales', 'out_dir': 'out/load_sales/'}
{'script': 'run_build_features.py', 'config_key': 'build_features', 'out_dir': 'out/build_features/'}
monthly_summary.csv [200, 80]
literal typo: FileNotFoundError
constant typo: NameError -> name 'SUMMARY_CVS' is not defined
slug から 3 つの名前が機械的に出ること、直書きの typo は実行時に FileNotFoundError になるまで分からないのに対し、定数の typo は NameError で即座に止まる(lint なら実行前)ことが確かめられます。
判断の基準
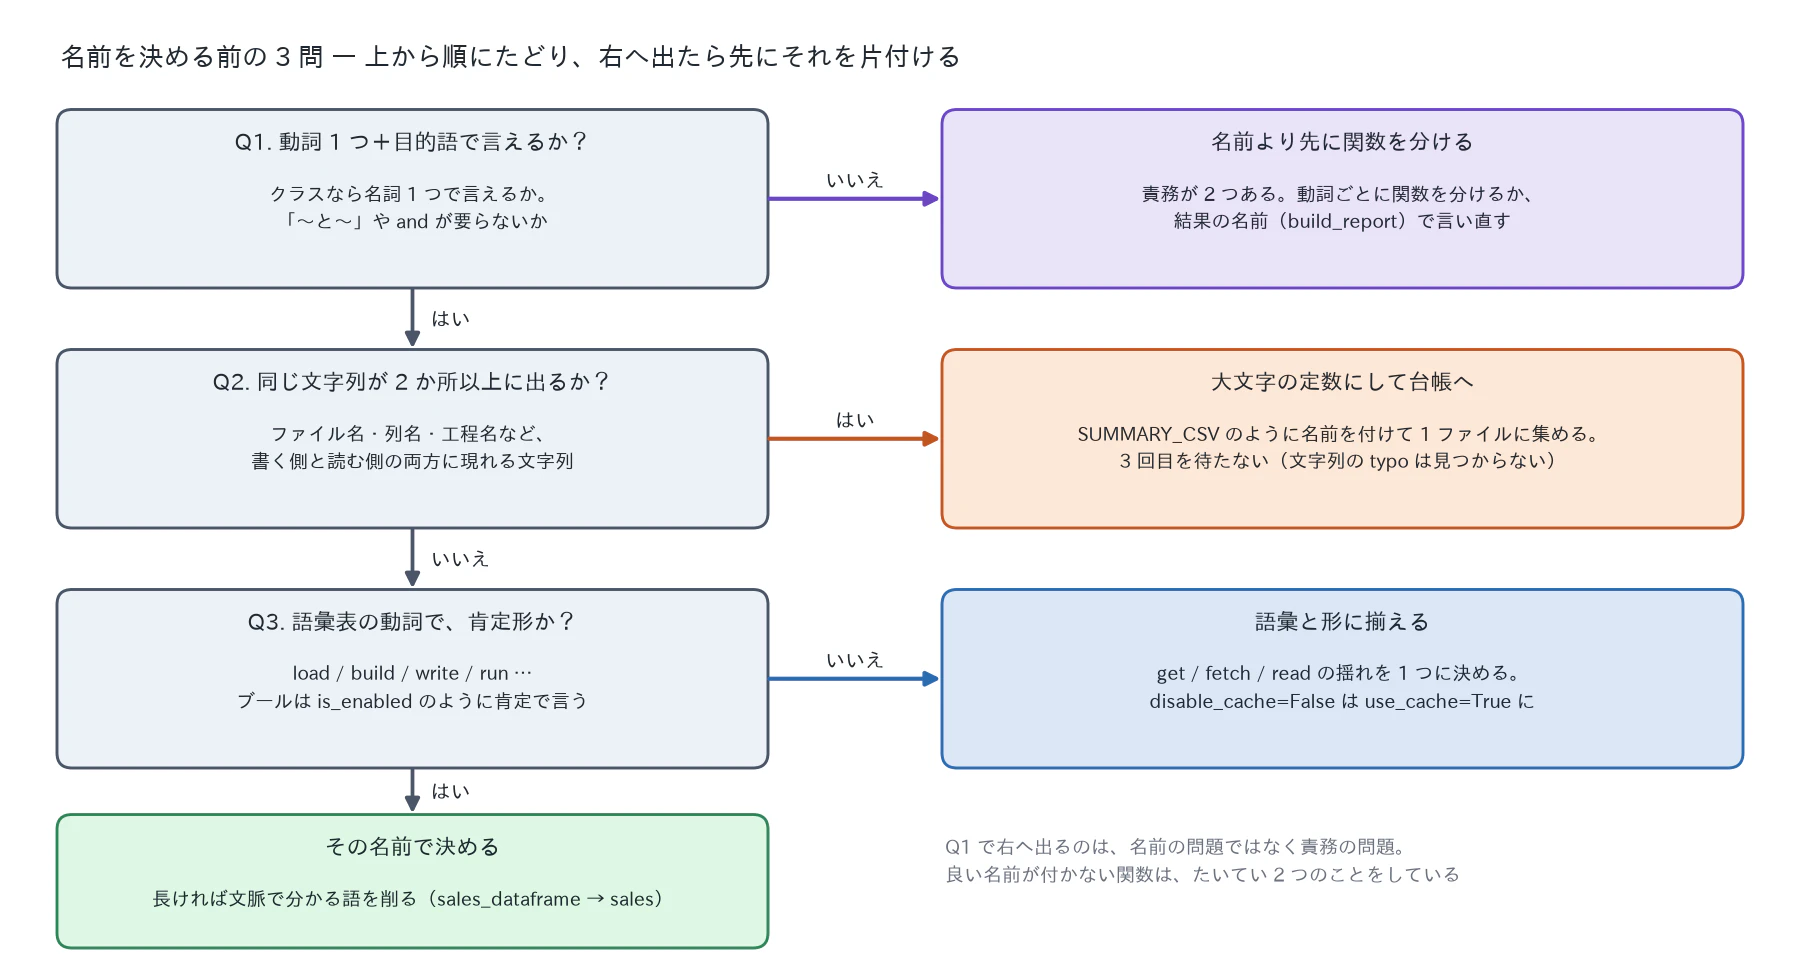
名前で迷ったら、上から 3 問をたどります。Q1 で右へ出るのは名前ではなく責務の問題なので、改名より先に関数を分けます。
確認問題
問 1(択一) 名前についての説明として正しいものはどれか。
ア TAX_RATE = 0.10 のように大文字で書けば、Python は実行時に再代入を止める イ df や i のような略語は、どんな場面でも使わないほうがよい ウ ブールの引数は disable_cache=False のように否定形で持つと、既定値を False に揃えられて読みやすい エ 自分のモジュールの中だけで使う名前は自由に改名できるが、他のパッケージから import されている名前の改名は利用側を壊す
答えと解説
エ。公開されている名前は利用側のコードにも書かれているので、改名すると利用側の import や属性の参照が失敗します。別名を残す・警告を出すといった移行の手順は、連載の後半で扱います。
ア: 大文字は「ここでだけ決める」という約束で、Python は再代入を止めません。typing.Final を付けると型検査器(mypy など)が再代入を指摘しますが、実行時の検査はありません(PEP 591)。
イ: df・cfg・idx・i のように広く通じる略語は構いません。Google の Python スタイルガイドも、ループの i や例外の e のような慣習の 1 文字名は認めています。避けるのは、自分だけが分かる略語(prc, sm2)です。
ウ: disable_cache=False は「キャッシュを無効にしない」で、読むたびに頭の中で反転が要ります。肯定形の use_cache=True で持ち、否定は呼び出し側で not を付けます。
問 2(択一) あるリポジトリでは、ファイルを読んで表にする関数が get_sales・fetch_stock・load_users・read_orders と 4 通りの動詞で書かれていた。どう直すのがよいか。
ア 動詞の選び方は書いた人の好みなので、そのままでよい イ 語彙表で「ファイル → 表」は load と決めて load_sales・load_stock のように揃え、fetch はネットワークから取るときだけに使う ウ 動詞をやめて sales_data・stock_data のように名詞だけにする エ どれにでも使える process_sales・process_stock に揃える
答えと解説
イ。同じ意味には同じ動詞を使うと、名前だけで「ファイルから読むのか、ネットワークから取るのか」が分かります。語彙表に無い動詞は、足す前に既存の動詞で言えないかを考えます。
ア: 動詞が揺れると、呼ぶ側は違いがあるのかを毎回本体で確かめることになります。
ウ: 関数名が名詞だと、値を入れた変数と見分けが付かず、何をするかも語りません。data は result・tmp と同じく、何も語らない語です。
エ: process は「何かをする」としか言っておらず、proc と同じく本体を読まないと分かりません。
問 3(コードを読む) 次の関数は動くが、名前が多くのことを隠している。どの名前をどう直すとよいか。
def check(o: dict, flag: bool = False) -> float:
    if not flag and o["qty"] <= 0:
        raise ValueError("qty must be positive")
    total = o["price"] * o["qty"]
    with open("order_totals.csv", "a", encoding="utf-8") as f:
        f.write(f'{o["id"]},{total}\n')
    return total
答えと解説
check は検証・計算・書き出しの 3 つをしているのに、動詞を 1 つしか言っていません。動詞が 3 つ要るので、validate_order・compute_total・write_total の 3 つの関数に分けます。
o は中身を語らないので order にします。flag は True で何が起きるか読めず、not flag で反転も要るので、肯定形の require_positive_qty: bool = True にします(if require_positive_qty and ... と文で読めます)。
直書きの "order_totals.csv" は、読む側にも同じ文字列が現れます。大文字の定数 ORDER_TOTALS_CSV にして、名前の台帳へ移します。
おわりに
名前は 4 つの文法(関数=動詞+目的語・クラス=名詞・ブール=is_ / has_・定数=大文字)で読み、ファイル名のような文字列は 1 か所に集めます。名前を決めることは責務と境界を決めることなので、名前を整えるだけで設計の半分が片付きます。
参考
- PEP 8 – Naming Conventions(2026-11-08 確認)
- Google Python Style Guide — 3.16 Naming(2026-11-08 確認)
- PEP 591 – Adding a final qualifier to typing(2026-11-08 確認)
- typing.Final(Python 公式)(2026-11-08 確認)
- Ruff — undefined-name (F821)(2026-11-08 確認)
この記事は連載「AI が書いたリポジトリの設計を読む」(Qiita 20days challenge)の Day 1-2/全20日です。毎日 2 本ずつ公開しています。