
はじめに
業務自動化や帳票処理において、非構造化テキストからJSONデータを抽出する際、日本の現場特有の表記揺れに頭を抱えるケースは非常に多いです。
-
日付:
令和8年10月27日、R8.10.27、10月吉日 -
金額:
3百50万円(税抜)、金 参佰伍拾萬圓 也、@1,200 × 50本 -
社名:
(株)サンプル商事 御中、テスト工業(有)、営業部長 田中様 - 表・明細: スペース区切り、結合セル、複数行にわたる注記
これらを正規表現だけで処理しようとすると、例外処理が際限なく増えて破綻してしまいます。
本記事では、PythonとPydantic v2、最新LLMを組み合わせた手法を紹介します。泥臭い日本語業務データを高精度に構造化パースする実践テクニックと実装コードを解説します。
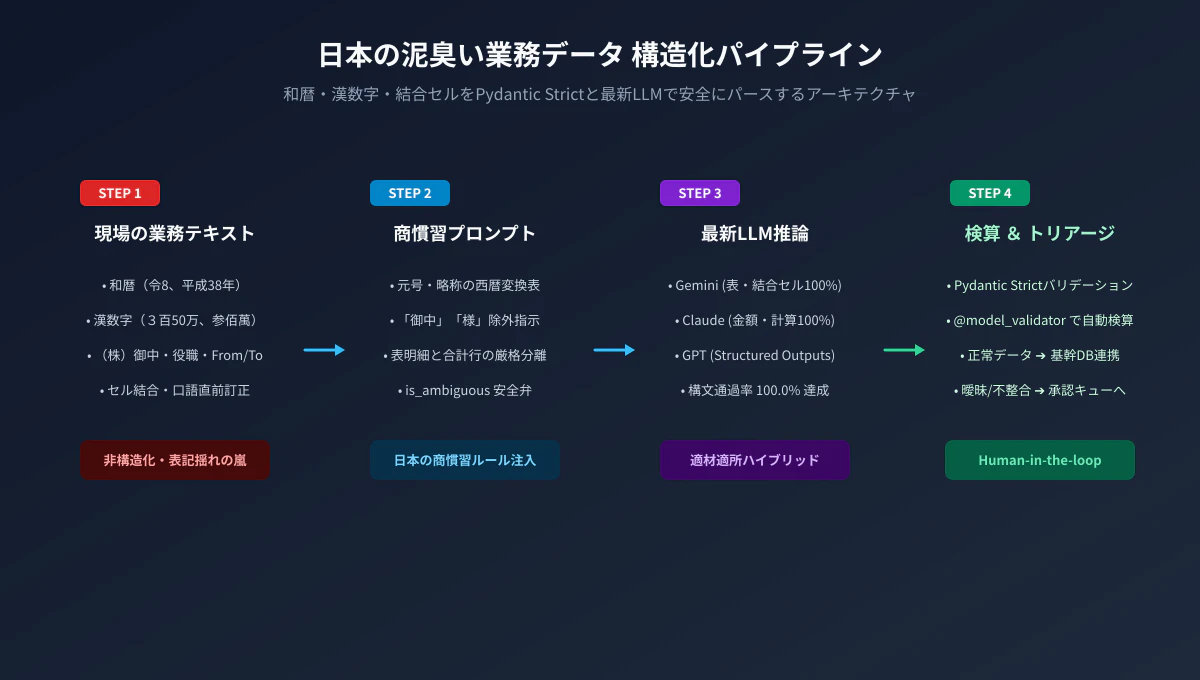
【まず結論】業務データ抽出を成功させる3大原則
100問の実務トラップデータ(和暦・漢数字・結合セル)で最新3モデルを検証した結論からまとめます。
-
構文エラーはPydantic Strictで「100%」防げる:
壊れたJSONはゼロにできます。課題は構文ではなく「文脈の誤読」です。 -
日付の特定不能を許容する
is_ambiguousフラグが必須:
「10月吉日」「来週中」を無理に日付化させず、null+ 曖昧フラグに倒すことでハルシネーションを根絶できます。 -
用途別のモデル使い分けが最大効果を生む:
- 表組み・結合セルの帳票や大量バッチ ➔ Gemini(表で100%満点・最安)
- 漢数字・大字・軽減税率の計算 ➔ Claude(計算で100%満点・最速)
前提環境
- Python: 3.10 以上
-
主要ライブラリ:
pydantic>=2.7.0-
google-genai>=0.1.1(Gemini用) -
anthropic>=0.25.0(Claude用) -
openai>=1.30.0(OpenAI用)
pip install pydantic google-genai anthropic openai
1. 日本の商慣習に耐えうるPydanticスキーマ設計
LLMに渡すJSONスキーマの設計が、抽出精度の8割を決定づけます。
ポイントは、「型による制約」と「曖昧性の受け皿(フラグ)」をモデル側にあらかじめ用意しておくことです。
from datetime import date
from enum import Enum
from typing import Optional
from pydantic import BaseModel, Field


class DocumentType(str, Enum):
    ESTIMATE = "estimate"    # 見積書
    INVOICE = "invoice"      # 請求書
    ORDER = "order"          # 発注書
    INQUIRY = "inquiry"      # 問い合わせ・見積依頼
    UNKNOWN = "unknown"      # 不明


class LineItem(BaseModel):
    item_name: str = Field(
        description="品名・品目(型番や規格を含む正式名称)"
    )
    quantity: float = Field(
        default=1.0, description="数量(数値のみ、単位は除く)"
    )
    unit: Optional[str] = Field(
        default=None, description="単位(個, 式, 本, 台等)"
    )
    unit_price: Optional[int] = Field(
        default=None, description="税抜単価(整数値)"
    )
    line_total: Optional[int] = Field(
        default=None, description="税抜行合計金額(整数値)"
    )
    tax_rate: float = Field(
        default=0.10, description="消費税率(0.10 または 0.08)"
    )


class ExtractionResult(BaseModel):
    document_type: DocumentType = Field(
        description="文書種別"
    )
    issue_date: Optional[date] = Field(
        default=None,
        description="発行日(西暦 YYYY-MM-DD 形式に正規化。和暦は西暦に変換。特定不能時はnull)"
    )
    due_date: Optional[date] = Field(
        default=None,
        description="支払期日・希望納期(YYYY-MM-DD 形式に正規化)"
    )
    vendor_name: Optional[str] = Field(
        default=None,
        description="発行元・販売側企業の正式名称(「(株)」は「株式会社」に正規化し、敬称・役職は除く)"
    )
    client_name: Optional[str] = Field(
        default=None,
        description="宛先・発注側企業の正式名称(敬称「御中」「様」や役職・部署名は除外)"
    )
    line_items: list[LineItem] = Field(
        default_factory=list,
        description="明細行リスト(小計・合計・消費税行は含めない)"
    )
    subtotal_amount: Optional[int] = Field(
        default=None, description="税抜小計(整数値)"
    )
    tax_amount: Optional[int] = Field(
        default=None, description="消費税額(整数値)"
    )
    total_amount: Optional[int] = Field(
        default=None, description="税込合計金額(総合計、整数値)"
    )
    is_ambiguous: bool = Field(
        default=False,
        description="日付や金額に「吉日」「〜程度」などの曖昧な表現が含まれる場合 True"
    )
設計のポイント
-
date型による自動ISO正規化:- Pydanticの
date型を指定すると、日付文字列が自動でPythonのdate型へ変換されます。これにより、不正な日付形式を即座にバリデーションできます。
- Pydanticの
-
is_ambiguousフラグの導入:- 「10月吉日」のように日付が特定できない場合、架空の日付の捏造を防げます。
issue_date = Noneかつis_ambiguous = Trueに落とし込ませる安全弁として機能します。
- 「10月吉日」のように日付が特定できない場合、架空の日付の捏造を防げます。
-
敬称・部署名の除去指示をFieldに明記:
-
client_nameのField(description=...)に「敬称『御中』や部署名は除外」と明記することで、社名抽出のブレを劇的に抑えられます。
-
2. プロンプト設計:日本の商慣習ルール5選
プロンプトには、モデルが日本のビジネスルールを正しく判断できるよう、以下のルールを明示します。
SYSTEM_PROMPT = """\
あなたは日本のビジネス文書・商慣習に精通したデータ抽出の専門家です。
与えられた日本語の業務テキストから情報を読み取り、指定のJSONスキーマに従って厳密に構造化データを抽出してください。

【重要な抽出ルール】
1. 日付の正規化:
   - 令和などの和暦(令和8年、R8.10.27、令8/10/27)はすべて西暦(YYYY-MM-DD)に変換してください。
   - 「吉日」「来週中」など厳密な日付が特定できない場合は null とし、is_ambiguous=true にしてください。
2. 金額の正規化:
   - 「3百50万」「金 参佰伍拾萬圓 也」「@1,200」などの漢数字・全角数字・単価記号を解析し、整数の数値のみに変換してください。
   - 税抜小計、消費税、税込合計を文書内の記述および計算に基づき正確に抽出してください。
3. 会社名の正規化:
   - 「(株)」「(有)」「(合)」は「株式会社」「有限会社」「合同会社」に正規化してください。
   - 「御中」「様」「殿」などの敬称や役職・部署名は会社名から除外してください。
4. 表・明細の分離:
   - 合計行や消費税行は明細リストに含めず、全体の合計フィールドに格納してください。
5. 出力ルール:
   - 指定されたJSONスキーマに厳密に準拠し、余計な解説文やMarkdownタグは出力しないでください。
"""
3. 各モデルでの実装コード(コピペで動く最小スニペット)
(1) Gemini(google-genai SDK / 最安・表に強い)
from google import genai
from google.genai import types

client = genai.Client(api_key="YOUR_GEMINI_API_KEY")

prompt = f"{SYSTEM_PROMPT}\n\n【対象テキスト】:\n{raw_text}"

response = client.models.generate_content(
    model="gemini-2.0-flash",
    contents=prompt,
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=ExtractionResult,
        temperature=0.0,
    ),
)

# Pydanticモデルへパース
result = ExtractionResult.model_validate_json(response.text)
print(result)
(2) OpenAI(Structured Outputs / 定番の安定性)
from openai import OpenAI

client = OpenAI(api_key="YOUR_OPENAI_API_KEY")

completion = client.beta.chat.completions.parse(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"【対象テキスト】:\n{raw_text}"},
    ],
    response_format=ExtractionResult,
    temperature=0.0,
)

result = completion.choices[0].message.parsed
print(result)
(3) Claude(Anthropic SDK / 漢数字・計算に強い)
import json
import anthropic

client = anthropic.Anthropic(api_key="YOUR_ANTHROPIC_API_KEY")

schema_json = json.dumps(ExtractionResult.model_json_schema(), ensure_ascii=False)
prompt = f"{SYSTEM_PROMPT}\n\nJSONスキーマ:\n```json\n{schema_json}\n```\n\n【対象テキスト】:\n{raw_text}"

response = client.messages.create(
    model="claude-3-5-haiku-latest",
    max_tokens=2048,
    temperature=0.0,
    messages=[{"role": "user", "content": prompt}],
)

raw_output = response.content[0].text
# マークダウン記法の除去
clean_json = raw_output.replace("```json", "").replace("```", "").strip()
result = ExtractionResult.model_validate_json(clean_json)
print(result)
4. 現場で陥りがちな落とし穴と回避策
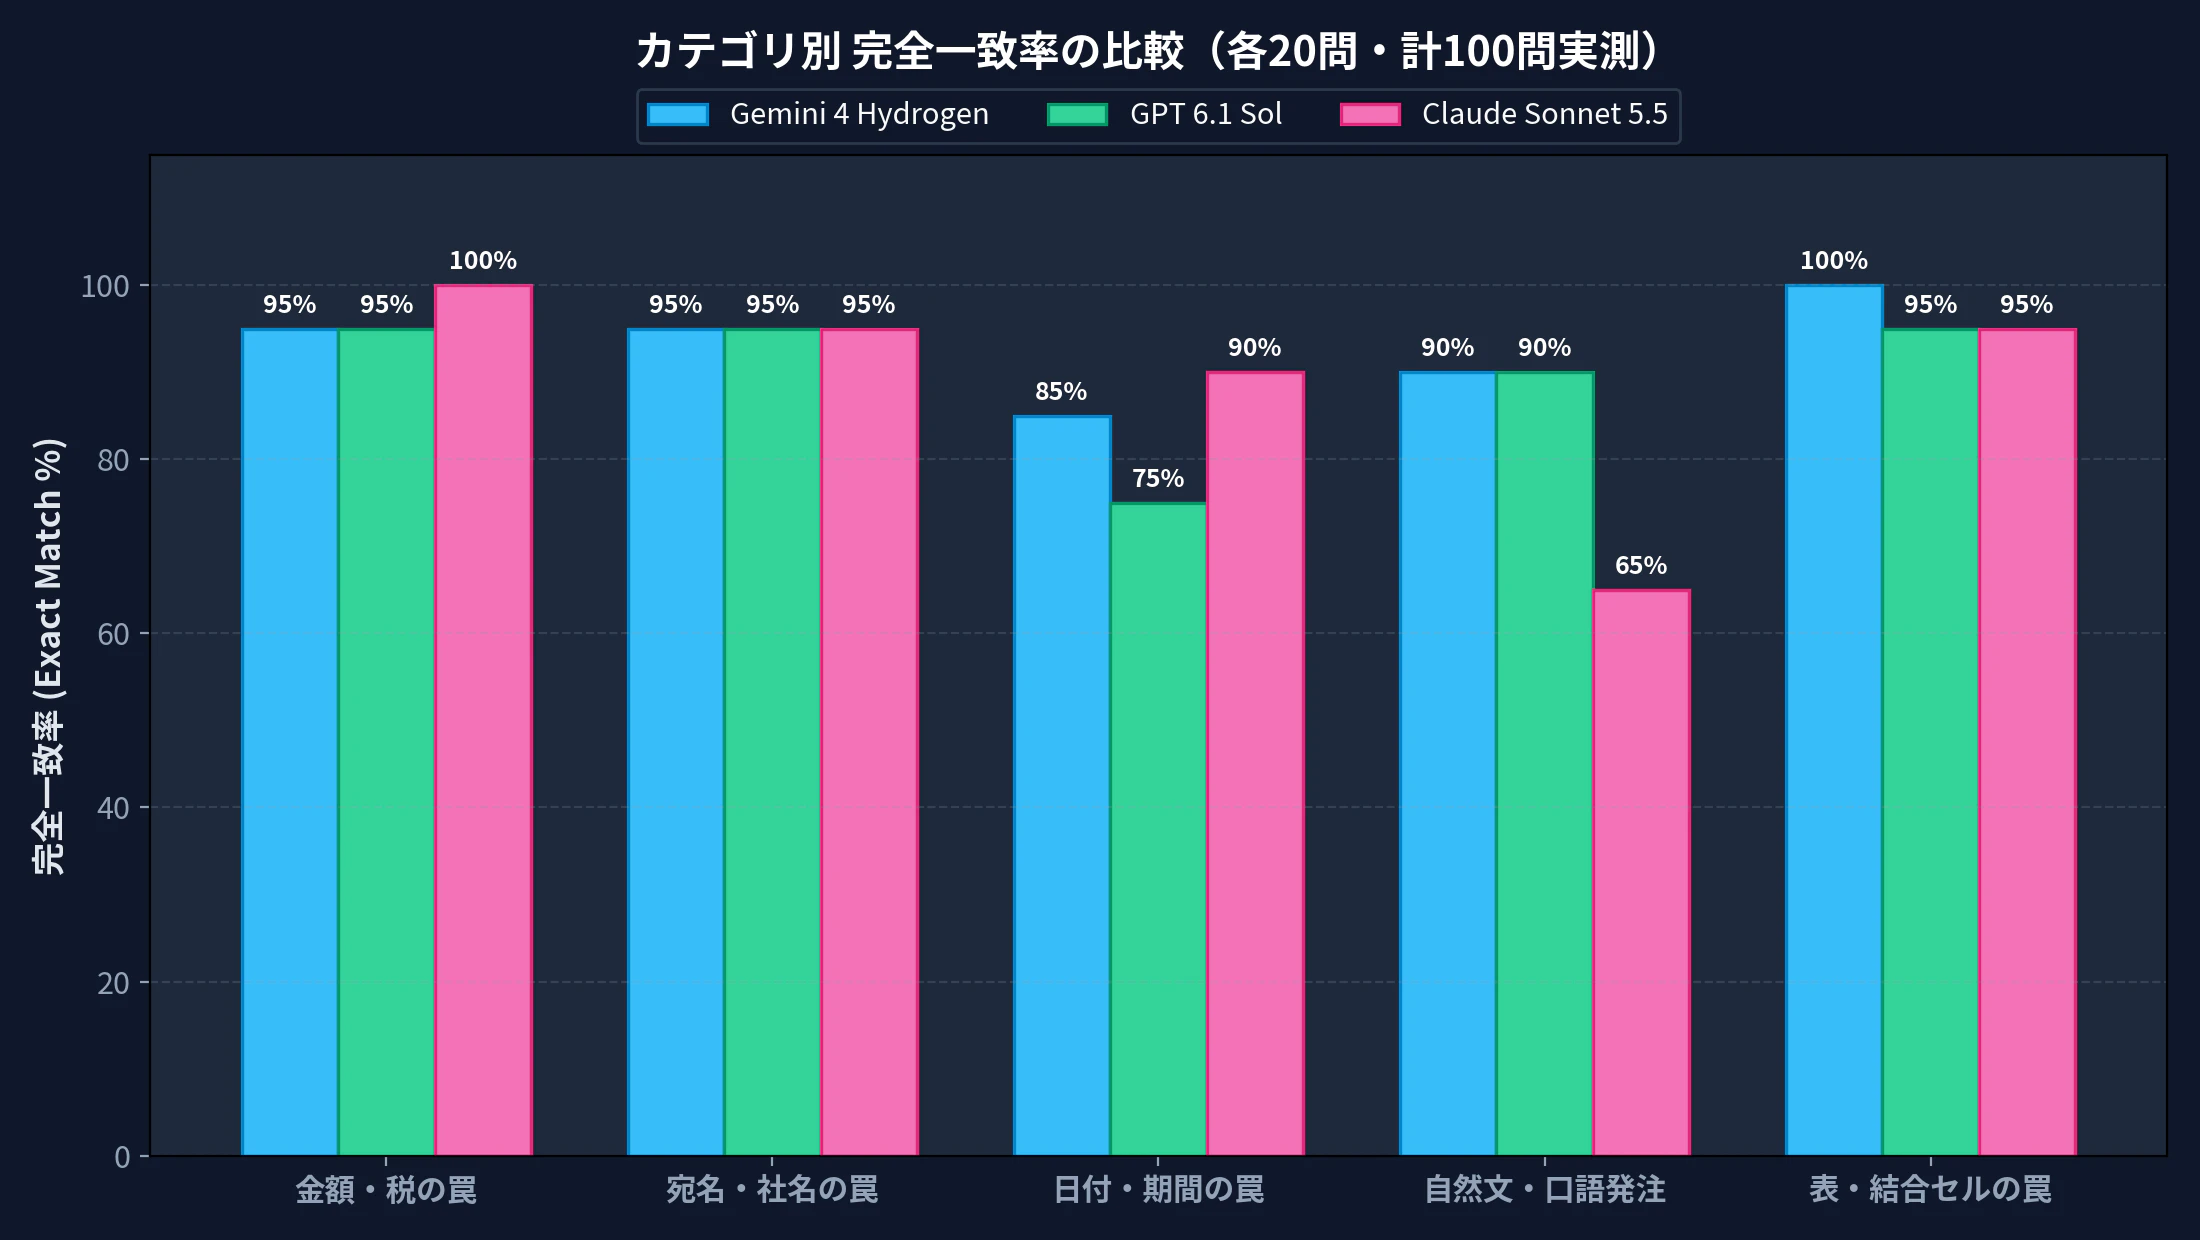
100問のベンチマーク実測において、全モデル構文エラーはゼロだったものの、和暦や口語訂正、期間表記などの現場トラップで不一致が発生しました。現場で特に陥りがちな落とし穴と回避策をまとめます。
落とし穴①:期間表記(「8月10日〜12日」)でのnull落ち
「8月10日〜12日」のような期間表記がある場合、モデルによって「特定の日付ではない」として null に倒す挙動が発生します。
業務要件として「期間の場合は開始日を取得する」と決まっている場合は、システムプロンプトに以下の一文を追加してください。
※日付が期間(例: 8/10〜12日)で指定されている場合は、期間の「開始日」を発行日として設定してください。
落とし穴②:メール・チャットでの「直前訂正」
口語のやり取りで「当初5個とお伝えしましたが、やっぱり3個に変更で」という発注文がある場合、モデルが両方の数値を拾って混乱することがあります。
これに対処するには、プロンプトに以下を追加します。
※文中で数量や金額の訂正(「やっぱり◯個に変更」等)がある場合は、直近の最終確定指示を採用してください。
落とし穴③:計算の検算バリデータ
Pydanticの @model_validator を活用し、「小計 + 消費税 = 合計金額」が一致しているかを自動チェックしておくと、モデルの計算ミスをパイプライン上で検知できます。
from pydantic import model_validator

class ExtractionResult(BaseModel):
    # ...各フィールド...

    @model_validator(mode="after")
    def verify_totals(self):
        if self.subtotal_amount is not None and self.tax_amount is not None and self.total_amount is not None:
            if self.subtotal_amount + self.tax_amount != self.total_amount:
                # 警告ログを出力するか、フラグを立てる
                self.is_ambiguous = True
        return self
まとめ
日本の現場帳票における表記揺れは、LLMの柔軟な言語理解と、Pydanticの厳格なスキーマバリデーションを掛け合わせることで、驚くほど高精度に自動構造化できます。
- 日付や金額の揺れはPydanticの型とField説明で制御する
- 特定できない曖昧なケースは
is_ambiguousで安全弁を作る - 検算バリデータを挟んで異常値を人間へトリアージする
検証用のテストデータセットやベンチマークスクリプト一式は、GitHubリポジトリで公開しています。手元の帳票自動化にぜひ役立ててください。
関連記事・お問い合わせ
-
開発背景・アーキテクチャの解説:
本ツールの設計思想や、3大LLMによる100問実測ベンチマークの詳細は Zennの解説記事 にまとめています。 -
業務導入・受託開発のご相談:
AI Nexusでは、業務効率化ツールの受託開発やAI導入コンサルティングを行っています。詳細は AI Nexus 公式サイト をご覧ください。