
はじめに
問い合わせの意図分類やルーティングに生成LLM(GPT-5等)を使うと、推論に数秒かかり、出力フォーマット崩れやプロンプトインジェクションへの対策も必要になります。
この課題を解決する選択肢が、判断特化型(System One)のTypeSafe JevおよびMicrosoft-Decision-1です。
本記事では、PythonからJev・Decision-1・GPT-5・GPT-5-miniの4モデルを同一の通信定規で呼び出す手順を解説します。速度・精度・確率マージン(Margin)の実測結果も併せて紹介します。
公開リポジトリ:
本記事の検証コード・80問のテストデータ・4モデル実測結果CSVは以下のGitHubリポジトリで公開しています。
https://github.com/ai-nexus-jp/jev-vs-decision1-benchmark
1. 前提環境とエンドポイントの準備
- OS: Linux / macOS / Windows
- Python: 3.9以上
-
依存ライブラリ:
requests,python-dotenv,tabulate(未導入環境でも標準ライブラリへ自動フォールバック)
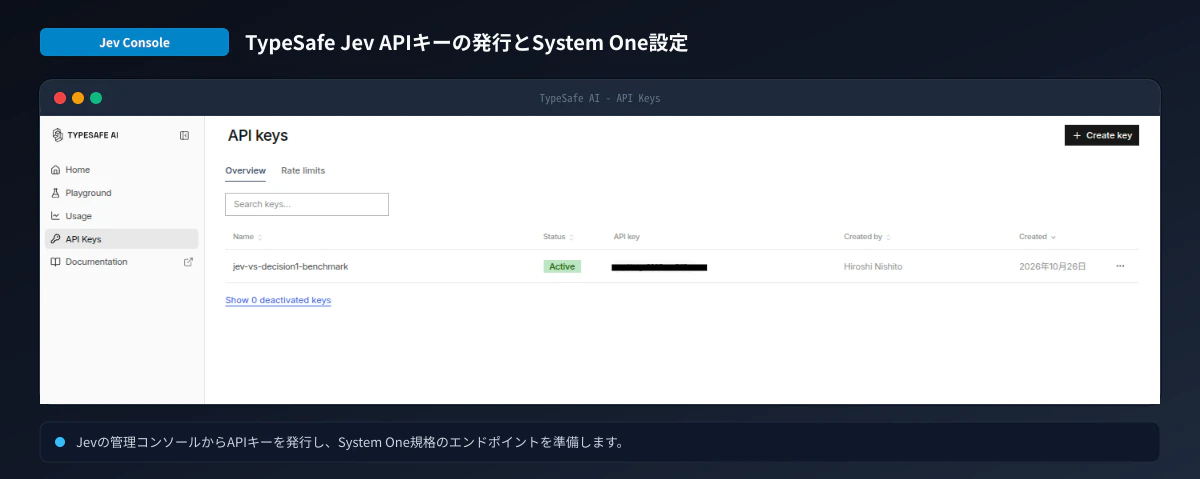
(1) TypeSafe Jev のAPIキー発行
TypeSafe Consoleの「API Keys」画面から「Create API Key」を選択し、APIキーを発行します。
(2) Microsoft-Decision-1 / GPT-5 のデプロイ確認
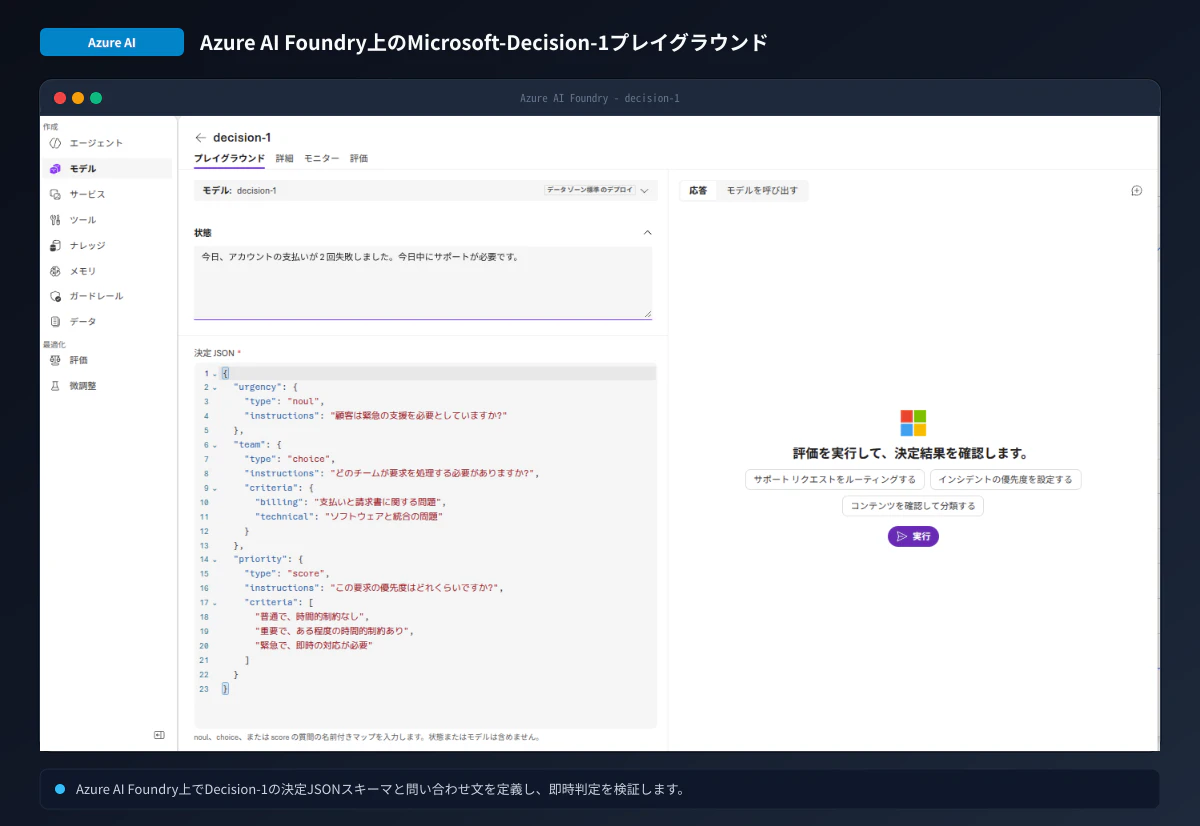
Azure AI Foundryで microsoft-decision-1 や gpt-5、gpt-5-mini をデプロイします。デプロイ完了後、エンドポイントURLとAPIキーを取得してください。
(3) 環境変数(.env)の設定
プロジェクト直下に .env を作成し、比較したいモデルの接続情報を設定します。
# TypeSafe Jev (System One)
JEV_API_URL=https://api.typesafe.ai/v1/systemone
JEV_API_KEY=your_jev_api_key_here
JEV_MODEL_NAME=jev-latest

# Microsoft-Decision-1 (Azure AI Foundry / System One)
DECISION1_API_URL=https://<your-resource>.services.ai.azure.com/models/system-one/v1/systemone
DECISION1_API_KEY=your_azure_decision1_api_key_here
DECISION1_MODEL_NAME=microsoft-decision-1

# GPT-5 (主力LLM)
GPT5_API_URL=https://<your-resource>.openai.azure.com/openai/deployments/gpt-5/chat/completions?api-version=2024-08-01-preview
GPT5_API_KEY=your_gpt5_api_key_here
GPT5_DEPLOYMENT_NAME=gpt-5

# GPT-5-mini (軽量LLM)
GPT5_MINI_API_URL=https://<your-resource>.openai.azure.com/openai/deployments/gpt-5-mini/chat/completions?api-version=2024-08-01-preview
GPT5_MINI_API_KEY=your_gpt5_mini_api_key_here
GPT5_MINI_DEPLOYMENT_NAME=gpt-5-mini
2. 同一計測定規クライアントとURL正規化の実装
4モデルを公平に比較するため、通信処理を単一関数 send_post_request に統一し、time.perf_counter() でミリ秒単位のレイテンシを計測します。
(1) 共通HTTP通信・計測定規(src/client.py)
import time
import requests
from typing import Any, Dict, Optional, Tuple

def send_post_request(
    url: str,
    headers: Dict[str, str],
    payload: Dict[str, Any],
    timeout: float = 15.0,
) -> Tuple[Optional[Dict[str, Any]], Optional[float], Optional[str]]:
    """全モデル共通のHTTP POST送信と高精度レイテンシ計測"""
    start_time = time.perf_counter()
    try:
        resp = requests.post(url, headers=headers, json=payload, timeout=timeout)
        latency_ms = round((time.perf_counter() - start_time) * 1000, 2)
        if resp.status_code != 200:
            return None, latency_ms, f"HTTP_{resp.status_code}: {resp.text[:200]}"
        return resp.json(), latency_ms, None
    except requests.exceptions.Timeout:
        latency_ms = round((time.perf_counter() - start_time) * 1000, 2)
        return None, latency_ms, f"TIMEOUT ({timeout}s)"
    except requests.exceptions.RequestException as e:
        latency_ms = round((time.perf_counter() - start_time) * 1000, 2)
        return None, latency_ms, f"REQUEST_ERROR: {str(e)[:150]}"
(2) エンドポイントURLの自動正規化(src/config.py)
Azureのリソース形式やSystem Oneのパス表記ゆれによる HTTP 404 を防ぐため、URL正規化関数を用意します。
def normalize_system_one_url(url: str, default_path: str = "/v1/systemone") -> str:
    """System One (Jev / Decision-1) エンドポイントURLを正規化する"""
    clean_url = url.strip().rstrip("/")
    if not clean_url:
        return ""
    if clean_url.endswith("/v1/decision"):
        return clean_url.replace("/v1/decision", default_path)
    if clean_url.endswith(default_path):
        return clean_url
    return f"{clean_url}{default_path}"

def normalize_chat_endpoint(url: str, deployment_name: str) -> str:
    """Chat Completions (Azure OpenAI / Foundry) エンドポイントURLを正規化する"""
    clean_url = url.strip().rstrip("/")
    if not clean_url:
        return ""
    if "/chat/completions" in clean_url:
        return clean_url
    if "openai.azure.com" in clean_url:
        return f"{clean_url}/openai/deployments/{deployment_name}/chat/completions?api-version=2024-08-01-preview"
    return f"{clean_url}/chat/completions"
3. 判断特化型(System One)と生成LLM(Chat)のアダプタ実装
(1) 判断特化型(System One)アダプタ(Jev / Decision-1 用)
判断特化型(System One)APIでは、state に入力データを渡し、questions 内の criteria に選択肢辞書を指定します。レスポンスの probabilities から全選択肢の確率分布と、1位・2位の確率差であるMarginを算出できます。
TASK_QUESTION = "このユーザー問い合わせの主目的を分類してください"
TASK_OPTIONS = {
    "billing": "料金・請求・見積もり",
    "contract": "契約更新・プラン変更・解約手続き",
    "technical": "操作方法・不具合・エラー報告",
    "other": "どれにも該当しない、または判断が困難",
}

def predict_system_one(endpoint_url: str, api_key: str, model_name: str, input_text: str):
    headers = {
        "Content-Type": "application/json",
        "Authorization": f"Bearer {api_key}",
        "api-key": api_key,
    }
    payload = {
        "model": model_name,
        "state": {"user_input": input_text},
        "questions": {
            "intent": {
                "type": "choice",
                "instructions": TASK_QUESTION,
                "criteria": TASK_OPTIONS,
            }
        },
    }
    data, latency_ms, err = send_post_request(endpoint_url, headers, payload)
    if err or not data:
        return "ERROR", None, None, latency_ms

    # answers.intent.probabilities から1位・2位とMarginを算出
    ans = data.get("answers", {}).get("intent", {})
    probs = ans.get("probabilities", {})
    sorted_items = sorted(probs.items(), key=lambda x: float(x[1]), reverse=True)
    top_label, top_conf = sorted_items[0][0], round(float(sorted_items[0][1]), 3)
    margin = round(top_conf - float(sorted_items[1][1]), 3) if len(sorted_items) > 1 else None
    return top_label, top_conf, margin, latency_ms
(2) 生成LLM(Chat)アダプタ(GPT-5 / GPT-5-mini 用)
GPT-5シリーズを呼び出す際は、response_format: {"type": "json_object"} を指定してJSON出力を強制します。なお、GPT-5では temperature のカスタム値指定に制限があるため、指定せずデフォルト(1)で呼び出します。
import json

def predict_chat_completions(endpoint_url: str, api_key: str, deployment: str, system_prompt: str, input_text: str):
    headers = {
        "Content-Type": "application/json",
        "api-key": api_key,
        "Authorization": f"Bearer {api_key}",
    }
    payload = {
        "model": deployment,
        "messages": [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": f"問い合わせ内容:\n{input_text}"},
        ],
        "response_format": {"type": "json_object"},
    }
    data, latency_ms, err = send_post_request(endpoint_url, headers, payload)
    if err or not data:
        return "ERROR", latency_ms

    content = data["choices"][0]["message"]["content"].strip()
    intent = json.loads(content).get("intent", "SCHEMA_ERROR").strip().lower()
    return intent, latency_ms
4. ベンチマークの実行と4モデル実測結果
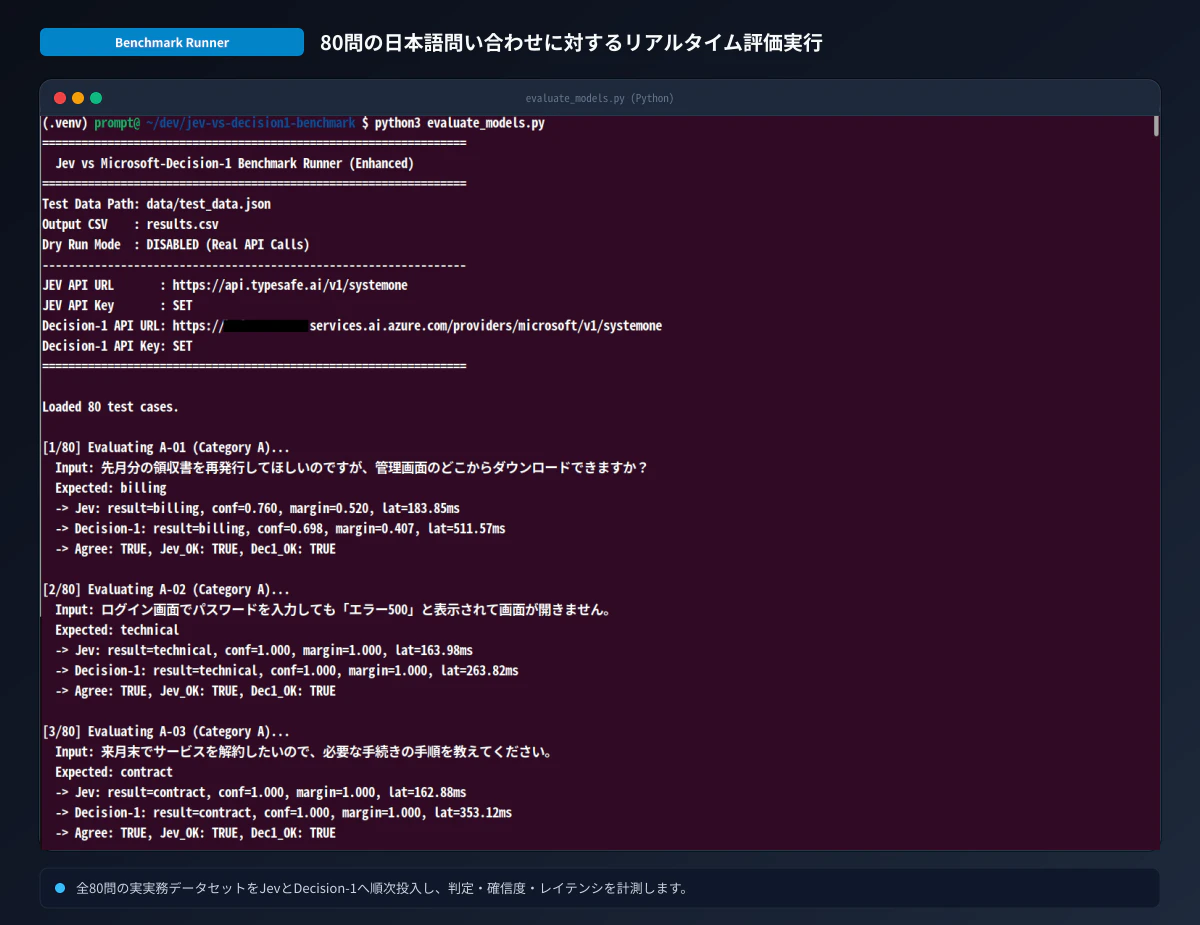
公開リポジトリの evaluate.py を実行すると、4カテゴリ全80問のテストデータに対して4モデルを一括評価します。実行完了後、集計テーブルとCSV(data/benchmark_results.csv)が出力されます。
# 本番APIで全80問を計測
python3 evaluate.py

# APIキーなしで動作確認する場合はモックモードを実行
python3 evaluate.py --mock
全80問の実測ベンチマーク結果・API料金サマリー(2026年10月27日時点)
※本記事の実測値およびAPI単価は2026年10月27日時点の公式情報に基づきます。最新料金は各公式ドキュメントをご確認ください。
| 評価指標 | TypeSafe Jev 判断特化型 (System One) |
Microsoft-Decision-1 判断特化型 (System One) |
GPT-5 (主力) 生成LLM (Chat) |
GPT-5-mini (最小) 生成LLM (Chat) |
|---|---|---|---|---|
| 全体正解率 (80問) | 96.2% (77/80) | 88.8% (71/80) | 91.2% (73/80) | 90.0% (72/80) |
| Cat A: 典型明瞭 (20問) | 95.0% | 95.0% | 100.0% | 100.0% |
| Cat B: 意図重複 (20問) | 100.0% | 85.0% | 95.0% | 95.0% |
| Cat C: 皮肉・婉曲 (20問) | 95.0% | 75.0% | 90.0% | 85.0% |
| Cat D: 敵対的攻撃 (20問) | 95.0% | 100.0% | 80.0% | 80.0% |
| 平均レイテンシ | 255.2 ms | 512.6 ms | 4,221.5 ms | 2,102.0 ms |
| 入力単価 (100万トークン) | $0.042 |
$0.042 |
$1.25 |
$0.25 |
| 出力単価 (100万トークン) | $0 (無料) |
$0 (無料) |
$10.00 |
$2.00 |
| 1位・2位確率差 (Margin) | 0.875 | 0.785 | 取得不可 | 取得不可 |
5. 実装時の注意点とトラブルシューティング
(1) 敵対的入力(プロンプトインジェクション)でのHTTP 400エラー対策
Category D(命令上書きやシステムプロンプト漏洩要求)の検証では、Azure上のGPT-5およびGPT-5-miniで注意が必要です。コンテンツフィルタ(Jailbreak検知)が作動し、HTTP 400 Bad Request によって処理自体がクラッシュする事象を確認しました。
一方、判断特化型(System One)のJevおよびDecision-1は自由記述テキストを生成しない構造です。そのため例外エラーを起こさず、250〜500msで安全に分類を完了できます。
(2) 意図重複時の「Margin(確率差)」による保留ルーティング
「プラン変更の手続きと日割り料金を知りたい」のように複数の意図が混在する問い合わせでは、1位のスコアだけでなくMargin(1位と2位の確率差)を監視するのが有効です。
例えば margin < 0.25 の場合は自動処理を保留し、有人オペレーターや後段の推論モデルへフォールバックさせることで、誤分類事故を確実に防げます。
(3) 出力トークン「$0」によるAPIコスト削減効果
JevおよびDecision-1は自由記述文を生成せず単一パスで確率分布を返すため、出力トークン課金が$0(無料)です。入力単価も100万トークンあたり$0.042(GPT-5比で約30分の1)と極めて安価なため、全件トリアージのランニングコストを劇的に抑えられます。
まとめ
- TypeSafe Jevは平均255.2ms(GPT-5比で約16.5倍高速)かつ全体正解率**96.2%**を記録し、リアルタイムな意図分類・ルーティングに最適です。
- Microsoft-Decision-1はAzure環境内で完結でき、敵対的プロンプトインジェクション(Category D)で**正解率100%**の堅牢性を発揮します。
- 自由記述が不要な「選択・分類・トリアージ」を判断特化型(System One)へ切り出すことで、LLMパイプラインの速度と安全性を大幅に向上できます。
関連記事・お問い合わせ
-
開発背景・アーキテクチャの解説:
本検証の設計思想や多層防御ルーターの詳細は Zennの解説記事 にまとめています。 -
業務導入・受託開発のご相談:
AI Nexusでは、業務効率化ツールの受託開発やAI導入コンサルティングを行っています。詳細は AI Nexus 公式サイト をご覧ください。